DSPyは、データを使って言語モデルのプログラムを改善するPythonフレームワークです。DSPyはModel Context Protocol(MCP)サーバーからエージェントツールを読み込みます。Bright Data MCPサーバーを使うと、エージェントはGoogleで検索し、ページをMarkdownとして読み取り、サーバーがボット対策を処理します。
DSPyのMCPチュートリアルのパターンは、単一のエージェント実行ではうまく機能します。DSPyの評価機能とプロンプトオプティマイザーであるGEPAは、ワーカースレッド上でエージェントを実行しますが、テストでは非同期ツール呼び出しが黙って失敗し、エージェントが記憶から回答していました。
このガイドでは、そのエージェントを構築し、そのツールを並行実行し、ウェブデータが何をもたらすかを測定する方法を示します。
要約
- ウェブデータが正答率を高めました。Bright Data MCPサーバーを使うと、
gpt-5.4-miniは60問中54~58問を正しく回答し、14問から向上し、ナレッジカットオフ後の出来事に関する8問全てに正解し、0問から向上しました。 - 2つのツールを選び、エリシテーションコールバックを追加する。ツールを減らすことでプロンプトを小さく保てます。コールバックは、プロンプトインジェクションの可能性があるとマークされたページを承認します。
- スレッド実行には同期ツールを使う。非同期ツールは
dspy.EvaluateとGEPAで黙って失敗するか、ハングしました。バックグラウンドイベントループで両方とも修正されました。 - まずツールを修正する。GEPAはスコアを上げることなく、学習用の回答を指示文にそのままコピーしました。長いページに関する6つの質問では、
find引数によってプロンプトトークンが半分になりました。
必要なもの
エージェントは、ホスト型のBright Data MCPサーバーであるBright DataのWeb MCPにHTTP経由で接続するため、インストールが必要なランタイムはPythonのみです。このサーバーはWeb Unlocker API上で動作しており、エージェントのためのプロキシローテーションとボット対策を処理します。コードについては、関連のGitHubリポジトリに、評価ステップ用のevaluate.pyとpost_cutoff_questions.csvを含む全てのスクリプトとデータファイルがあります。必要なものは以下の通りです。
- Python 3.10以降、パッケージをインストールするためのuv
- 無料のBright Dataアカウント、およびアカウント設定から取得するそのAPIキー
- OpenAIのAPIキー、または
dspy.LMがツール呼び出しに対応している他のプロバイダーのキー
ユーザーとAPIキータブのAPIキーテーブルからBright Dataのキーをコピーします。
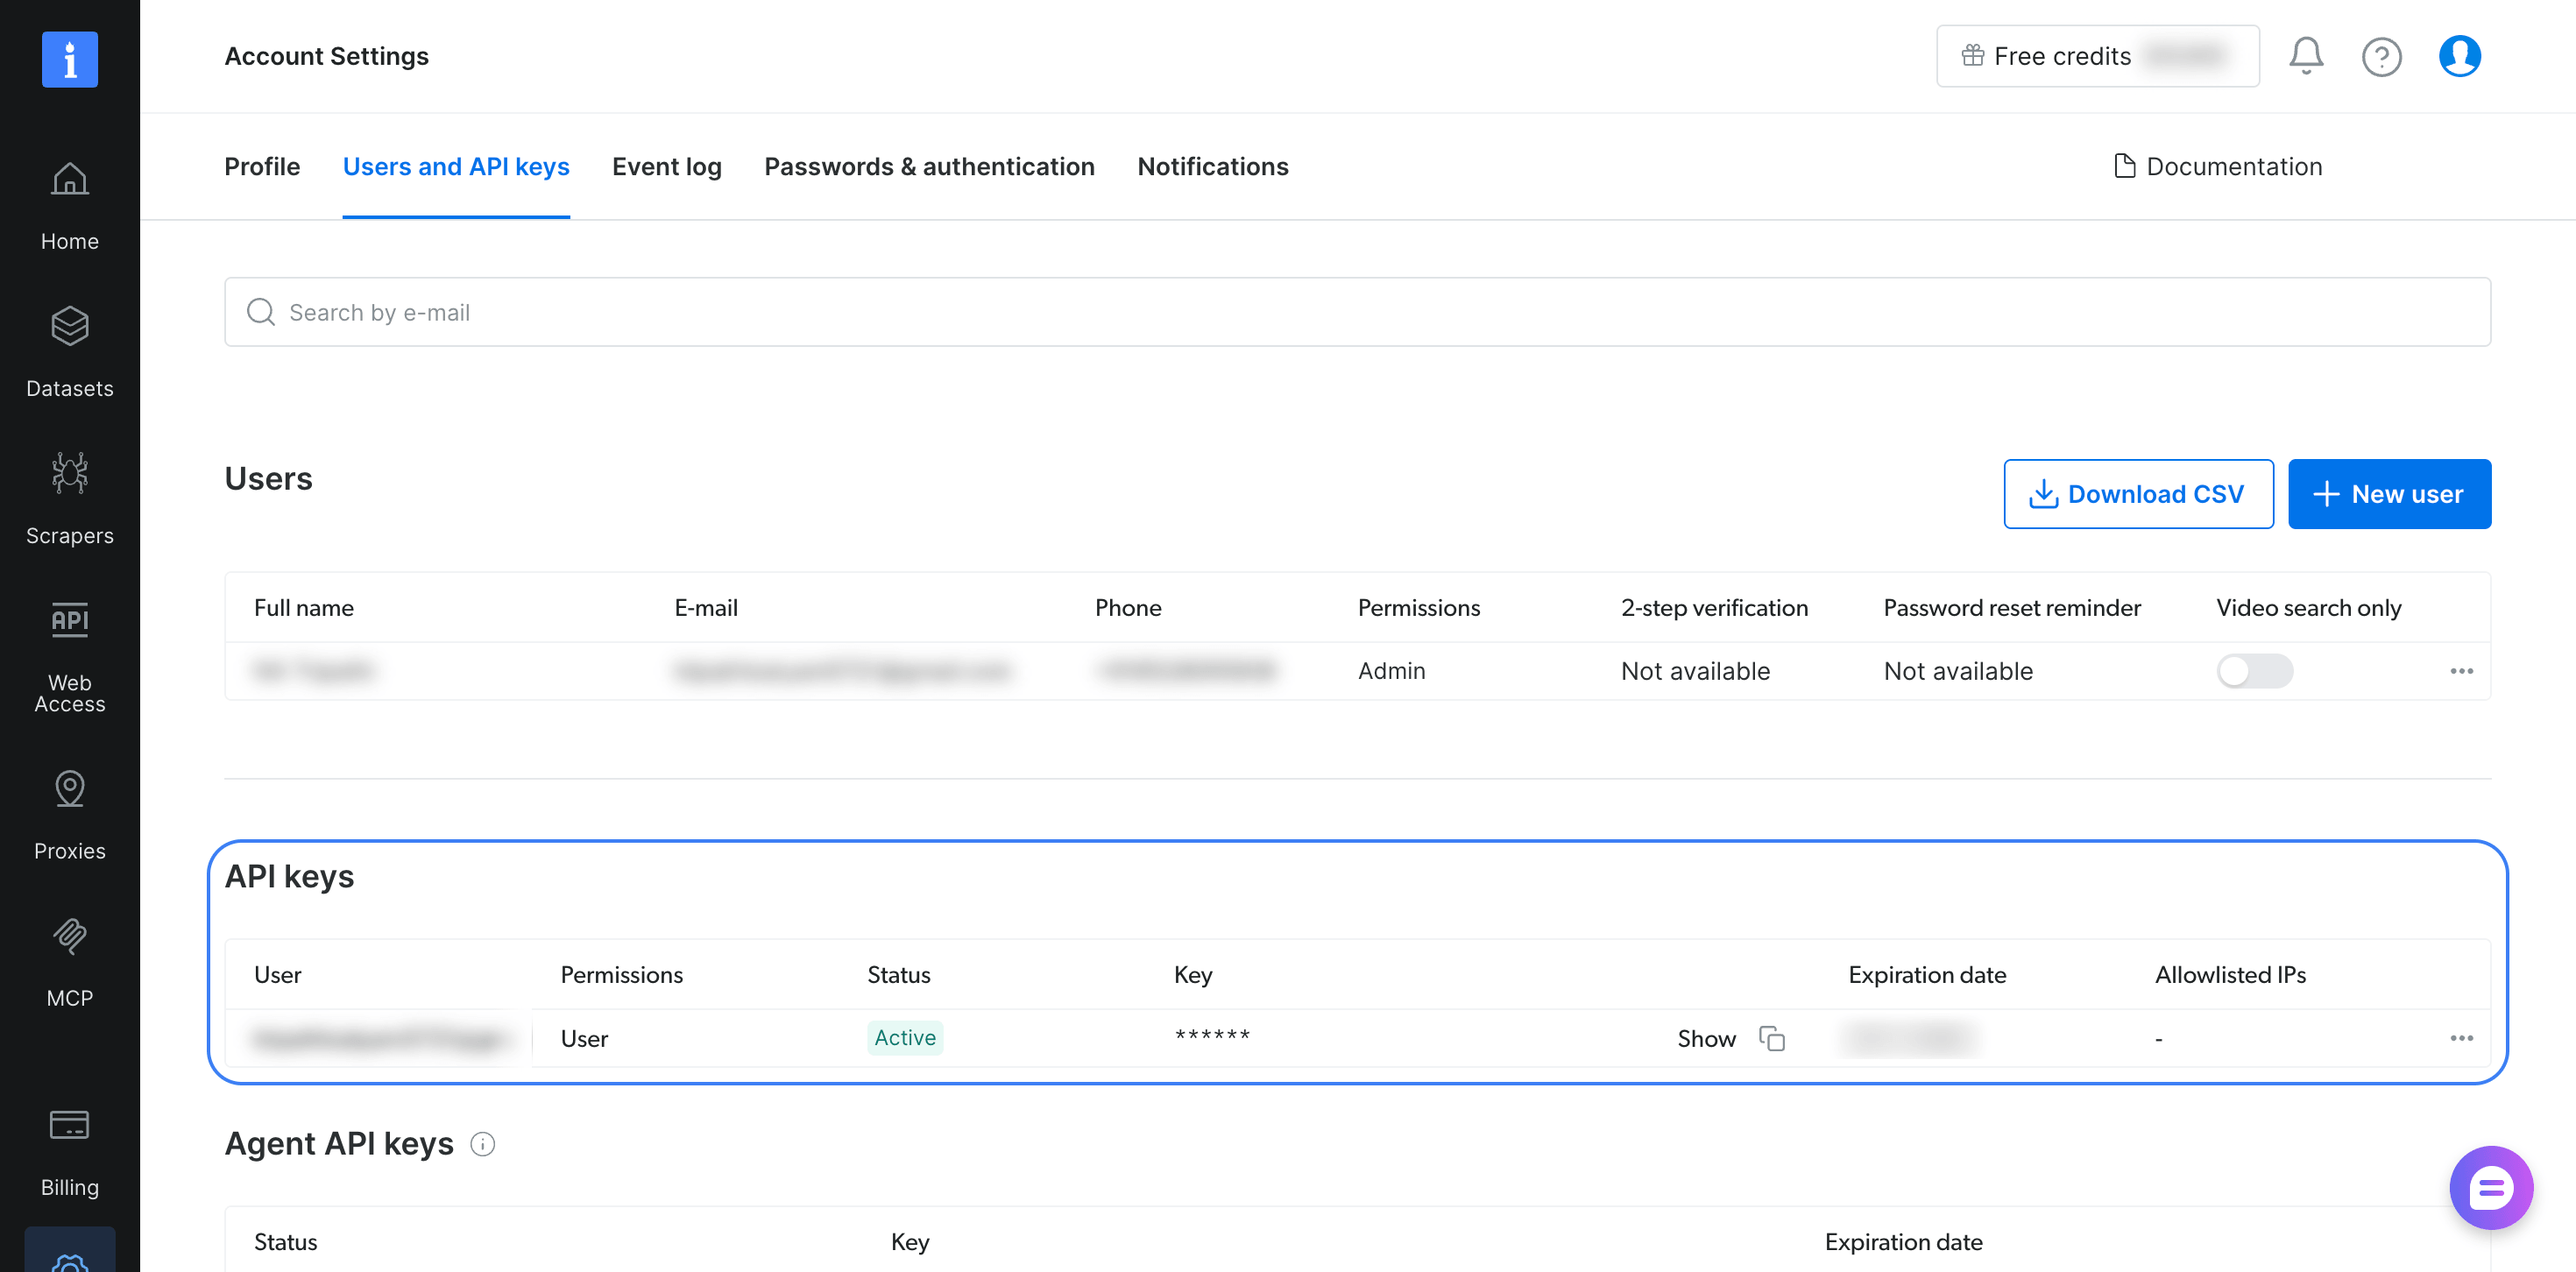
同じキーが、ホスト型サーバーとローカルサーバーの両方で使用できます。
リポジトリをクローンし、テスト済みバージョンに固定したMCPエクストラ付きでDSPyをインストールし、両方のキーをエクスポートします。
git clone https://github.com/triposat/dspy-bright-data-research-agent && cd dspy-bright-data-research-agent
uv venv && source .venv/bin/activate
uv pip install "dspy[mcp]==3.4.1" "mcp==2.3.0"
export BRIGHTDATA_API_TOKEN="your-bright-data-api-key"
export OPENAI_API_KEY="your-openai-api-key"
DSPy 3.4.1のdspy[mcp]エクストラはSDKバージョンを固定していないため、このコマンドはMCP Python SDKをテスト済みの2.3.0リリースに固定します。無料の月間リクエストから始めることができ、MCPサーバーの料金ページで現在の割り当てを確認できます。
Bright Data MCPサーバーをDSPyに接続する
dspy.Tool.from_mcp_toolは、MCPサーバーが一覧表示する各ツールをDSPyツールに変換するため、エージェントは各ツールの名前、説明、引数のスキーマを認識します。以下のスクリプトは、リポジトリ内のagent.pyで、ホスト型のBright Data MCPサーバーに接続し、検索とスクレイピングのツールを読み込みます。その後、モデルのナレッジカットオフ後の出来事について質問します。
import asyncio
import os

import dspy
from mcp import types
from mcp.client import Client
from mcp.client.streamable_http import create_mcp_http_client, streamable_http_client

dspy.configure(
    lm=dspy.LM("openai/gpt-5.4-mini", temperature=1.0, max_tokens=16000),
    adapter=dspy.ChatAdapter(use_native_function_calling=True),
)

SERVER_URL = "https://mcp.brightdata.com/mcp?tools=search_engine,scrape_as_markdown"
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_TOKEN']}"}


async def approve_page(context, params):
    # The server asks before returning a page that contains MCP setup
    # instructions. This agent's tools only read the web, so return it.
    return types.ElicitResult(action="accept", content={"return_content": True})


class ResearchQuestion(dspy.Signature):
    """Answer the question with facts found on the web."""

    question: str = dspy.InputField()
    answer: str = dspy.OutputField(desc="a short, direct answer")
    sources: list[str] = dspy.OutputField(desc="URLs of the pages that support the answer")


async def main():
    async with create_mcp_http_client(headers=HEADERS) as http:
        transport = streamable_http_client(SERVER_URL, http_client=http)
        async with Client(transport, elicitation_callback=approve_page) as client:
            mcp_tools = (await client.list_tools()).tools
            tools = [dspy.Tool.from_mcp_tool(client, t) for t in mcp_tools]
            agent = dspy.ReActV2(ResearchQuestion, tools=tools, max_iters=8)

            question = "Who won the 2026 FIFA World Cup final, and what was the score?"
            pred = await agent.acall(question=question)
            for event in pred.history.messages:
                for call in getattr(event.get("tool_calls"), "tool_calls", []):
                    print(f"{call.name}: {call.args}")
            print("\nAnswer:", pred.answer)
            print("Sources:", pred.sources)


asyncio.run(main())
python agent.pyを実行すると、2回の検索が表示され、その後に最終的なsubmit呼び出しが表示されました。
search_engine: {'query': '2026 FIFA World Cup final winner score', 'engine': 'google', 'cursor': '', 'geo_location': 'us'}
search_engine: {'query': '2026 FIFA World Cup final winner score site:en.wikipedia.org OR site:fifa.com', 'engine': 'google', 'cursor': '', 'geo_location': 'us'}
submit: {'answer': 'Spain won the 2026 FIFA World Cup final, defeating Argentina 1–0 after extra time.', 'sources': ['https://www.fifa.com/en/tournaments/mens/worldcup/canadamexicousa2026/final', 'https://www.fifa.com/en/tournaments/mens/worldcup/canadamexicousa2026/articles/spain-argentina-final-report-highlights']}

Answer: Spain won the 2026 FIFA World Cup final, defeating Argentina 1–0 after extra time.
Sources: ['https://www.fifa.com/en/tournaments/mens/worldcup/canadamexicousa2026/final', 'https://www.fifa.com/en/tournaments/mens/worldcup/canadamexicousa2026/articles/spain-argentina-final-report-highlights']ツールなしでは、gpt-5.4-miniは2026年のワールドカップ決勝がナレッジカットオフ後であると述べました。
このスクリプトは、ローカルのデモサーバーを使用するDSPy MCPチュートリアルをベースにしており、ホスト型サーバー用の設定を3つ追加しています。
APIキーはヘッダーで送信する。create_mcp_http_clientは、全てのリクエストでキーをAuthorizationヘッダーとして送信するため、プロキシやログに記録されるURLにキーが現れません。
エージェントが必要とするツールを選ぶ。Bright Data MCPサーバーは、検索、スクレイピング、バッチジョブ、ブラウザ自動化、およびAmazonやLinkedInなどのサイト向けに構造化されたJSONを返す事前構築済みスクレイパーのツールを提供します。toolsURLパラメータでエージェントが認識するツールを選択し、MCPサーバーのツールリファレンスにはsearch_engine_batchやscraping_browser_navigateなど各名称が一覧表示されています。選択した各ツールのスキーマは全てのモデル呼び出しと共に送信されるため、このエージェントではプロンプトを小さく保つためにsearch_engineとscrape_as_markdownのみを選択します。
サーバーのエリシテーション要求に回答する。Bright Data MCPサーバーにはプロンプトインジェクション対策機能が含まれています。スクレイピングされたページにMCP設定を変更する指示が含まれている場合、サーバーはそのページを返す前に、MCPエリシテーションを通じてクライアントに確認を求めます。DSPyクライアントが回答できるよう、elicitation_callback引数を使ってエリシテーションコールバックをClientに渡します。
approve_pageは、このエージェントがウェブを読み取るだけなので、全てのリクエストを承認します。ファイルを書き込んだり自身の設定を変更したりできるエージェントの場合は、リクエストを人間に送って承認を得てください。
代わりにサーバーをローカルで実行するには、Node.jsをインストールし、同じClientにStdioServerParameters(command="npx", args=["-y", "@brightdata/mcp@latest"], env=...)を渡し、envにAPI_TOKENとTOOLSを指定します。@latestを使うと、npxは起動のたびにlatestタグが指すリリースを取得します。再現可能な評価のためには、これをBright Data MCPリリースからテスト済みのバージョンに置き換えてください。
Jupyterノートブックでは、すでにイベントループが実行されているため、asyncio.run(main())をawait main()に置き換えます。
このスクリプトはdspy.ReActV2を使用しており、DSPy ReActのドキュメントには、DSPy 3.5以降dspy.ReActが使用する実装として記載されており、3.6ではReActV2という名称は削除されています。ReActV2はtrajectoryの代わりにhistoryを返し、submitツールで終了します。アップグレードする際は、dspy.ReActV2をdspy.ReActに変更し、評価を再実行してください。
同じサーバーは、AutoGen、LangGraph、Pydantic AIなど、他のエージェントフレームワークとも動作します。
スレッドとGEPAでDSPy MCPツールを実行する
DSPy 3.4.1では、dspy.Evaluateはワーカースレッド上でプログラムを同期的に実行し、GEPAはそれを使って各候補の指示文を評価します。from_mcp_toolによるツールは非同期関数であり、MCPセッションを開いたイベントループに紐付いています。テストでは、これらを同期ワーカースレッドから呼び出すと、見落としやすい2つの方法で失敗しました。
DSPyのMCPチュートリアル通りにツールを読み込んだ場合、Evaluateは例外を出さずに完了しました。全てのツール呼び出しはサーバーに到達する前に失敗し、Pythonはコルーチンが一度もawaitされなかったという警告のみを出力しました。エージェントは記憶から回答し、それでもEvaluateはスコアを報告しました。DSPyのallow_tool_async_sync_conversion設定を有効にすると、実行はハングし、9分経っても待機し続けていました。
この修正では、単一のMCPセッションをバックグラウンドのイベントループ上で開いたままにし、各呼び出しをそのループに送る同期関数をDSPyに与えます。
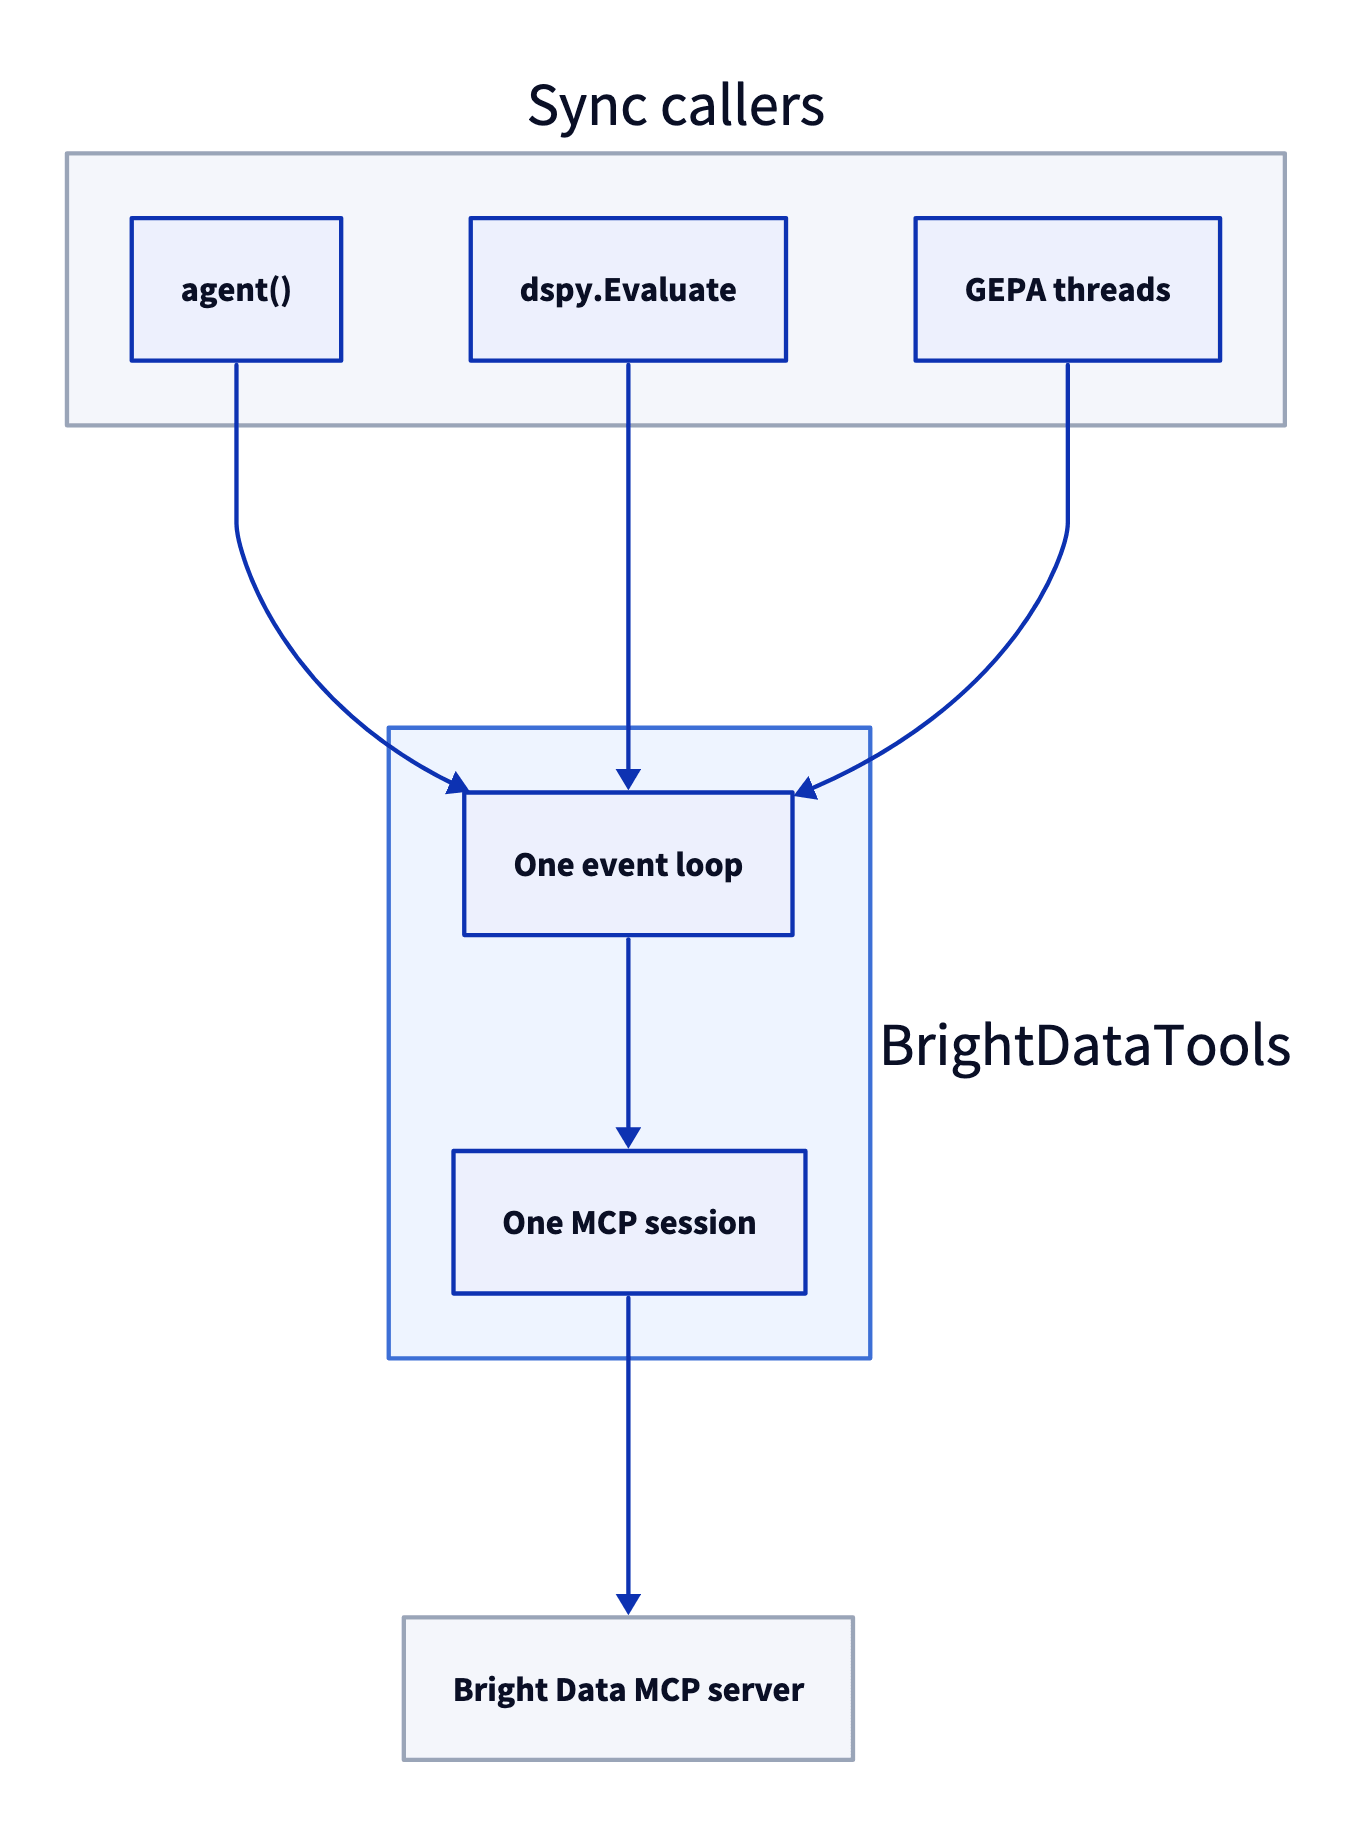
各同期呼び出しはrun_coroutine_threadsafeによってループに送信されるため、MCPセッションを開いたイベントループのみがそのセッションを使用します。
このクラスは、評価スクリプトと最適化スクリプトがインポートするモジュールであるbrightdata_tools.pyにあります。
import asyncio
import json
import os
import re
import threading
from urllib.parse import urlparse

import dspy
from mcp import StdioServerParameters, types
from mcp.client import Client
from mcp.client.streamable_http import create_mcp_http_client, streamable_http_client

SERVER_URL = "https://mcp.brightdata.com/mcp?tools=search_engine,scrape_as_markdown"
# The Bright Data MCP server wraps results in a security notice and two markers
WRAPPED = re.compile(r"(=====UNTRUSTED_\w+_BEGIN=====\n)(.*)(\n=====UNTRUSTED_\w+_END=====)", re.S)


async def approve_page(context, params):
    # Read-only tools, so pages with MCP setup text are returned as data
    return types.ElicitResult(action="accept", content={"return_content": True})


class BrightDataTools:
    """One MCP session on a background event loop, exposed as sync dspy.Tools."""

    def __init__(self, country="us", max_chars=20_000, retries=2,
                 blocked_domains=(), timeout=180, cache=False, remote=True):
        self.country = country
        self.max_chars = max_chars
        self.retries = retries
        self.blocked = tuple(blocked_domains)
        self.timeout = timeout
        self.cache = {}  # pages always, searches too when cache=True
        self.keep_all = cache  # reuse search results while optimizing
        self.lock = threading.Lock()
        self.stats = {"calls": 0, "sent": 0, "errors": 0}
        self.error = None  # why the MCP session failed to start or stopped
        self.remote = remote
        self.loop = asyncio.new_event_loop()
        self.ready = threading.Event()
        self.thread = threading.Thread(target=self.loop.run_until_complete,
                                       args=(self._serve(),), daemon=True)
        self.thread.start()
        self.ready.wait()
        if self.error:
            raise RuntimeError("Could not connect to the MCP server") from self.error

    async def _serve(self):
        try:
            await self._connect()
        except Exception as e:  # report it instead of waiting forever
            self.error = e
        finally:
            self.ready.set()

    async def _connect(self):
        token = os.environ["BRIGHTDATA_API_TOKEN"]
        if self.remote:  # hosted server over streamable HTTP
            async with create_mcp_http_client(headers={"Authorization": f"Bearer {token}"}) as http:
                async with Client(streamable_http_client(SERVER_URL, http_client=http),
                                  elicitation_callback=approve_page) as client:
                    await self._hold(client)
        else:  # local server, latest release
            local = StdioServerParameters(
                command="npx", args=["-y", "@brightdata/mcp@latest"],
                env={"API_TOKEN": token, "TOOLS": "search_engine,scrape_as_markdown",
                     "PATH": os.environ["PATH"]})
            async with Client(local, elicitation_callback=approve_page) as client:
                await self._hold(client)

    async def _hold(self, client):
        self.client = client
        self.mcp_tools = (await client.list_tools()).tools
        self.stop = asyncio.Event()
        self.ready.set()
        await self.stop.wait()

    def close(self):
        self.loop.call_soon_threadsafe(self.stop.set)
        self.thread.join(timeout=30)  # let the session shut down cleanly

    def _is_blocked(self, url):
        host = urlparse(url).netloc.lower()
        return any(host == d or host.endswith("." + d) for d in self.blocked)

    def call(self, name, args):
        start = int(args.pop("start", 0) or 0)  # where to resume a long page
        find = args.pop("find", "") or ""  # phrase to look for in a long page
        if name == "search_engine":
            args = {**args, "geo_location": self.country}
        if name == "scrape_as_markdown" and self._is_blocked(args.get("url", "")):
            return "This domain is excluded for this task. Use another source."
        key = (name, json.dumps(args, sort_keys=True))
        with self.lock:
            self.stats["calls"] += 1
            text = self.cache.get(key)
        if text is None:
            try:
                text = self._send(name, args)
            except Exception:
                with self.lock:
                    self.stats["errors"] += 1  # the agent sees an error, not a page
                raise
            with self.lock:
                self.stats["sent"] += 1
                if self.keep_all or name == "scrape_as_markdown":
                    self.cache[key] = text  # pages stay cached, so reading on is free
        wrapped = WRAPPED.search(text)
        head, body, tail = (text[:wrapped.start(2)], wrapped.group(2), text[wrapped.end(2):]
                            ) if wrapped else ("", text, "")
        if name == "search_engine" and self.blocked:
            data = json.loads(body)
            data["organic"] = [r for r in data.get("organic", [])
                               if not self._is_blocked(r["link"])]
            body = json.dumps(data, indent=1)
        if find:
            spans = [(max(0, m.start() - 1500), m.end() + 1500)
                     for m in re.finditer(re.escape(find), body, re.I)][:6]
            body = ("\n...\n".join(body[a:b] for a, b in spans)
                    or f"[{find!r} not found in the {len(body)}-character page]")
        end = start + self.max_chars
        if len(body) > end:
            body = (body[start:end] + f"\n[showing characters {start} to {end} of {len(body)}. "
                    f"Call {name} again with start={end} to read on, or with "
                    "find='a word or phrase' to get matching passages from the whole page]")
        elif start:
            body = body[start:] + f"\n[end of page: characters {start} to {len(body)}]"
        return head + body + tail

    def _send(self, name, args):
        if self.error or not self.thread.is_alive():
            raise RuntimeError("The MCP session is closed") from self.error
        for _ in range(self.retries + 1):
            future = asyncio.run_coroutine_threadsafe(
                self.client.call_tool(name, args), self.loop)
            try:
                result = future.result(self.timeout)
            finally:
                future.cancel()  # a timed-out call stops instead of running on
            text = "\n".join(c.text for c in result.content if hasattr(c, "text"))
            wrapped = WRAPPED.search(text)
            body = wrapped.group(2) if wrapped else text
            if not result.is_error and body.strip():
                return text
        raise RuntimeError(text[:500] or "empty result")

    def tools(self):
        out = []
        for t in self.mcp_tools:
            spec = dspy.Tool.from_mcp_tool(self.client, t)  # name, description, args
            args, types, desc = dict(spec.args), dict(spec.arg_types), spec.desc
            if t.name == "scrape_as_markdown":  # let the agent read beyond the character limit
                args["start"] = {"type": "integer", "default": 0,
                                 "description": "Character offset to read from, for long pages"}
                args["find"] = {"type": "string", "default": "",
                                "description": "Word or phrase to find; returns matching passages"}
                types["start"], types["find"] = int, str
                desc += (f" Returns {self.max_chars} characters at a time; pass find to search"
                         " the whole page for a word or phrase.")

            def run(_name=t.name, **kwargs):
                return self.call(_name, kwargs)

            out.append(dspy.Tool(run, name=spec.name, desc=desc,
                                 args=args, arg_types=types))
return outBrightDataTools().tools()は、サーバーのツール名、説明、引数を保持した2つの同期ツールを返します。スクレイピングツールには、startとfindという2つの追加引数があり、max_charsが設定する文字数制限を超えてエージェントがテキストを読めるようにします。Bright Data MCPサーバーは、ページテキストにマークを付けてモデルにデータとして扱うよう伝えるセキュリティ通知で結果をラップします。このクラスは、マークされたテキストのみをフィルタリングし切り詰めるため、モデルは通知全体を受け取ります。
コンストラクタの設定:
remote=Falseはホスト型サーバーの代わりにローカルサーバーを使用します。countryは全ての検索でgeo_locationを設定するため、全ての実行で同じ国の結果が得られます。max_charsは、完全なWikipedia記事など非常に長いページを公開しているサイトがあるため、各結果を20,000文字に制限します。この制限がない場合、あるモデルリクエストでは491,564トークンとなり、モデルのコンテキストウィンドウを超えました。これがあると、2回の評価実行で、どの質問も58,651プロンプトトークン以上を使用しませんでした。ページはキャッシュされたままなので、startやfindを使った呼び出しは新しいリクエストを送信しません。retriesとtimeoutは、長時間の評価実行を完了させるのに役立ちます。エラーを返した呼び出しは最大2回まで再送信され、timeout秒経っても実行中の呼び出しはバックグラウンドで継続する代わりにキャンセルされます。それでも失敗した呼び出しはstats["errors"]でカウントされ、evaluate.pyとoptimize.pyがそれを表示します。エージェントはツールが失敗すると記憶から回答するため、スコアを信頼する前にこれを確認してください。blocked_domainsは選択したサイトを検索結果から除外し、それらのサイトのスクレイピングをブロックします。評価中に使用し、本番環境では空のままにしてください。cache=Trueは検索結果も再利用し、optimize.pyでこれを有効にします。
BrightDataToolsは、dspy.EvaluateやGEPAのような同期・スレッド化されたジョブ向けに構築されており、Jupyterノートブックでも変更なしに動作します。FastAPIエンドポイントなどの非同期ウェブサービスでは、BrightDataTools上に構築されたエージェントをawait asyncio.to_thread(agent, question=question)でワーカースレッド内で実行し、イベントループが他のリクエストの処理を続けられるようにしてください。
SimpleQA Verifiedでエージェントを評価する
GEPAはメトリクスを使ってプログラムを評価することで改善するため、エージェントにはまず正解がわかっている質問が必要です。SimpleQA Verifiedがこれを提供します。これは、検証済みの回答を持つ1,000の短い事実に関する質問からなる、MITライセンスの公開セットです。
質問をリポジトリフォルダにダウンロードします。
curl -L -o simpleqa_verified.csv https://huggingface.co/datasets/google/simpleqa-verified/resolve/main/simpleqa_verified.csvresearch.pyには、エージェント、graderという名のSimpleQAスタイルのLLM判定器、GEPAが使用するメトリクスが含まれています。
import csv
import random

import dspy

# Hosts that publish the benchmark answers, excluded while evaluating
EVAL_BLOCKLIST = ("huggingface.co", "github.com", "raw.githubusercontent.com",
                  "kaggle.com", "openaipublic.blob.core.windows.net")

AGENT_LM = dspy.LM("openai/gpt-5.4-mini", temperature=1.0, max_tokens=16000)
JUDGE_LM = dspy.LM("openai/gpt-5.4-mini", temperature=1.0, max_tokens=16000)


class ResearchQuestion(dspy.Signature):
    """Answer the question with facts found on the web."""

    question: str = dspy.InputField()
    answer: str = dspy.OutputField(desc="a short, direct answer")
    sources: list[str] = dspy.OutputField(desc="URLs of the pages that support the answer")


def make_agent(tools):
    return dspy.ReActV2(ResearchQuestion, tools=tools, max_iters=8)


def load_examples(path="simpleqa_verified.csv", seed=7):
    rows = list(csv.DictReader(open(path)))
    random.Random(seed).shuffle(rows)
    return [dspy.Example(question=r["problem"], gold=r["answer"]).with_inputs("question")
            for r in rows]


class Grade(dspy.Signature):
    """Grade a predicted answer against the gold answer, SimpleQA style.
    CORRECT: the prediction contains the gold answer's meaning and does not contradict it.
    Small spelling or formatting differences are fine; for numbers and dates the value must match.
    INCORRECT: the prediction states a different or contradictory answer, or hedges between several.
    NOT_ATTEMPTED: the prediction does not give an answer."""

    question: str = dspy.InputField()
    gold_answer: str = dspy.InputField()
    predicted_answer: str = dspy.InputField()
    grade: str = dspy.OutputField(desc="CORRECT, INCORRECT, or NOT_ATTEMPTED")


grader = dspy.Predict(Grade)


def tool_calls(pred):
    calls = []
    history = getattr(pred, "history", None)
    for event in (history.messages if history else []):
        for call in getattr(event.get("tool_calls"), "tool_calls", []):
            if call.name != "submit":
                calls.append((call.name, call.args))
    return calls


def metric(gold, pred, trace=None, pred_name=None, pred_trace=None):
    """Score for GEPA, plus feedback that never shows the reference answer."""
    answer = getattr(pred, "answer", "") or ""
    with dspy.context(lm=JUDGE_LM):
        grade = grader(question=gold.question, gold_answer=gold.gold,
                       predicted_answer=answer).grade.strip().upper()
    correct = grade.startswith("CORRECT")
    calls = tool_calls(pred)
    searches = [args.get("query") for name, args in calls if name == "search_engine"]
    pages = [args.get("url") for name, args in calls if name == "scrape_as_markdown"]
    feedback = (f"Grade: {'CORRECT' if correct else 'INCORRECT'}. Agent answered: {answer!r}. "
                f"Searches ({len(searches)}): {searches}. Pages opened ({len(pages)}): {pages}.")
    if not correct and not pages:
        feedback += " The agent answered without opening a page."
    return dspy.Prediction(score=float(correct), feedback=feedback)


def leaked_answers(instruction, examples):
    """Reference answers (4+ characters) that an optimized instruction repeats."""
    text = instruction.lower()
return sorted({ex.gold for ex in examples if len(ex.gold) >= 4 and ex.gold.lower() in text})判定器は、正解・不正解・未回答というSimpleQAの3つの評価を割り当てるため、エージェント自身の小型モデルを使用します。メトリクスはスコアと、エージェントの検索やページを一覧表示するが参照用の正解は示さない書面でのフィードバックを返します。評価中、EVAL_BLOCKLISTはベンチマークの正解を公開しているサイトをブロックするため、エージェントは公開ウェブ上で各正解を見つける必要があります。
リポジトリ内のevaluate.pyは、シャッフルされた質問の一部をエージェントに対して一度に8問ずつ実行し、全ての回答をresults.jsonに保存します。デフォルトでは、60のテスト質問を評価します。--no-toolsはモデル単体を評価し、--localはローカルサーバーを使用します。実行結果は次の通りです。
セットアップ(全てgpt-5.4-mini) |
同じ60のSimpleQA Verified質問のうち正解数 |
|---|---|
| モデル単体、ツールなし | 14(1回実行) |
Bright Dataツールを使用したエージェント、ローカルサーバー、findなし |
58、55、58、54(4回実行) |
Bright Dataツールを使用したエージェント、ホスト型サーバー、findあり |
57(1回実行) |
モデル単体による46件の誤りは全て具体的な誤答で、例えば、ネブラスカ州ビアトリス出身の画家に対してオマハと答えるようなものでした。モデルの誤った回答は、正しい回答のように見えました。
同じエージェントを繰り返し実行すると、単一のスコアのうちどれだけがノイズであるかがわかります。エージェントの4回の実行結果が異なったのは、ランダムなモデルサンプリングと判定器の採点が一部原因でした。エージェントは同じジョン・ケージの楽曲について実行ごとに異なる楽器名を挙げ、判定器は同じチェスのスコアに対して「4½ポイント」を正解と、「4.5」を不正解と採点しました。
60問中4問までの変化はノイズとして扱い、プログラムの比較は合計点ではなく、保存された結果の質問ごとに行ってください。DSPyはデフォルトでモデル呼び出しをキャッシュするため、実行を繰り返す前に両方のLMでcache=Falseを設定してください。
特に判定器がエージェントと同じモデルである場合は、判定器の採点も抜き取り確認してください。別の1回の実行を手動でレビューしたところ、正解と照合した全60件の採点が正しいものでした。
実行コスト。60問の実行は平均で1質問あたり2.3回のツール呼び出し、Bright Dataへのリクエストは200件未満、エージェント用のgpt-5.4-mini呼び出しコストは0.29ドルでした。評価全体が無料の月間リクエスト枠に収まります。
モデルのナレッジカットオフ後の出来事についてエージェントをテストする
SimpleQA Verifiedの安定した質問群は、モデルのナレッジカットオフ後の事実をテストするようには設計されていません。これらの事実については、リポジトリ内のpost_cutoff_questions.csvに、Wikipediaと照合して確認された、2025年と2026年の出来事に関する14の質問が含まれています。python evaluate.py --csv post_cutoff_questions.csv --start 0 --n 14を実行し、次に--no-toolsを付けて再度実行します。各セットアップは1回ずつ実行しました。
| 対象となる質問(各1回実行) | gpt-5.4-mini単体 |
Bright Dataツールを使用したgpt-5.4-mini、ホスト型サーバー |
|---|---|---|
| 2025年の出来事 | 6問中5問 | 6問中6問 |
| 2026年の出来事 | 8問中0問 | 8問中8問 |
ツールなしでは、モデルは2026年のいくつかの出来事がまだ起きていないと答えました。ナレッジカットオフは2024年6月だと述べていたにもかかわらず、2025年の事実については6問中5問を把握していました。モデルが述べるナレッジカットオフを信頼するのではなく、モデルが何を知っているかをテストし、最近公開されたページにのみ答えが掲載されている、自分自身のユースケースからの質問を追加してください。
GEPAでエージェントを最適化する
GEPAはDSPyの振り返り型プロンプトオプティマイザーです。学習用質問の小さなバッチでプログラムを実行します。その後、失敗した実行結果とメトリクスのフィードバックを、これらの実行ではgpt-5.5である、より強力な振り返りモデルに提示します。GEPAは、検証用セットで最も良い成績を出す新しい指示文を保持します。
GEPAは学習するために誤答を必要とします。エージェントがサンプリングされた全ての学習用質問に正しく回答すると、GEPAは新しい指示文を提案しません。
そのため、エージェントが間違える質問から学習用セットを構築してください。テストセット外の質問に対してpython evaluate.py --start 108 --n 400 --out pool.jsonを実行します。次にoptimize.pyは、12件の誤答と12件の正答を組み合わせて学習用セットとし、同じ方法で検証用セットを構築します。
import json
import random

import dspy
from brightdata_tools import BrightDataTools
from research import AGENT_LM, EVAL_BLOCKLIST, leaked_answers, make_agent, metric

dspy.configure(lm=AGENT_LM, adapter=dspy.ChatAdapter(use_native_function_calling=True))

# Half wrong, half correct answers from an evaluate.py run outside the test set
pool = json.load(open("pool.json"))
misses = [r for r in pool if not r["correct"] and not r.get("error")]
hits = [r for r in pool if r["correct"]]
random.Random(0).shuffle(hits)


def to_ex(rows):
    return [dspy.Example(question=r["question"], gold=r["gold"]).with_inputs("question")
            for r in rows]


half = min(12, len(misses) // 2)
trainset = to_ex(misses[:half] + hits[:half])
valset = to_ex(misses[half:2 * half] + hits[half:2 * half])

bd = BrightDataTools(blocked_domains=EVAL_BLOCKLIST, cache=True)
agent = make_agent(bd.tools())
gepa = dspy.GEPA(
    metric=metric,
    reflection_lm=dspy.LM("openai/gpt-5.5", temperature=1.0, max_tokens=32000),
    max_metric_calls=300,
    num_threads=8,
    track_stats=True,
    log_dir="gepa_logs",
)
optimized = gepa.compile(agent, trainset=trainset, valset=valset)
optimized.save("optimized_agent.json")

instruction = optimized.react.signature.instructions
print(instruction)
print("Training answers in the instruction:", leaked_answers(instruction, trainset + valset))
print("Tool calls:", bd.stats["calls"], "| requests sent:", bd.stats["sent"],
      "| errors:", bd.stats["errors"])
bd.close()
python optimize.pyで実行します。GEPAは同じ質問を何度も尋ねるため、BrightDataTools内のキャッシュがここで重要になります。あるGEPAの実行では、994回のツール呼び出しのうち524回がキャッシュによって新しいリクエストなしで回答されました。
以下の4回のGEPA実行では、それぞれ24の学習用質問、24の検証用質問、同じ60のテスト質問を使用しました。
| 学習用セット | フィードバックに期待される回答を含む | 検証スコア(24問中) | 指示文にコピーされた学習用の回答 | テストスコア(60問中) |
|---|---|---|---|---|
| ランダムな24の質問 | あり | 21~23 | 3 | 55、52 |
| ランダムな24の質問 | なし | 24、新しい指示文なし | 0 | 未測定 |
| 誤答12件、正答12件 | あり | 18~21 | 3 | 57、55 |
| 誤答12件、正答12件 | なし | 20~21 | 3 | 未測定 |
GEPAは学習用の回答を指示文に書き込むことがあります。最初の実行による指示文は次のように終わっていました。
Known facts that may be useful for repeated questions:
- Galip Ulsoy received the Charles Russ Richards Memorial Award from ASME and Pi Tau Sigma in 2013. ...
- The Koshi/Kosi River basin size is commonly listed as about 74,500 km². ...
- For the April 25, 2015 Nepal/Gorkha earthquake, a Mw 6.6 aftershock occurred about 34 minutes after the initial Mw 7.8 event ...
各行が1つの学習用質問に答えており、その実行でGEPAが提案した全ての指示文には同様のブロックがありました。期待される回答を隠してもこれを止めることはできませんでした。すると振り返りモデルは、2000年国勢調査におけるオハイオ州ウェストンの世帯数など、エージェント自身の正答した実行から回答を取り込みました。
学習に使う前に誤答を再実行する。誤答から構築された検証用セットでは、ベースラインのエージェントは既に24問中18~20問のスコアを出していました。つまり、その12件の誤答のうち少なくとも6件は、再実行すると正解でした。複数回の実行で間違えた質問のみを残してください。
保留されたテスト質問で結果を測定する。新しい指示文を提案した全ての実行で検証スコアは上昇しました。60のテスト質問において、最適化されたプログラムは52~57点、Bright Dataツールを使用したベースラインのエージェントは54~58点でした。GEPAの指示文変更はスコアを測定可能なほど高めることはなく、最初の実行だけでgpt-5.4-miniエージェントとgpt-5.5振り返りモデルのモデル呼び出しコストが3.31ドルかかりました。
指示文にコピーされた回答がないか確認する。research.py内のleaked_answersは、指示文が繰り返している4文字以上の参照用回答を検出します。これらの実行では、コピーされた回答の大部分を検出できましたが、文字列一致では短い数字や言い換えられた回答を検出できません。指示文全体を読み、特定の学習用質問に関する行があれば削除してください。
エラー分析でツールの修正点を見つける
GEPAは指示文のみを書き換えるため、ツール自体の問題を修正することはできません。誤答に対するエラー分析は、これらの問題を見つけます。ここでは、誤答は日付と数字に集中していました。3回の実行、519の採点済み質問を通して、エージェントは日付と数字に関する質問の約15%を間違え、人物や場所に関する質問では7%でした。
それらの実行では、エージェント自身のmax_chars設定によって各ページが20,000文字に制限されていました。62件の誤答のうち24件で、エージェントはその制限より長いページを開いていました。全文を再度取得すると、それらのページのうち6件で、制限を超えた箇所に答えがありました。
| エージェントが開いたページ | 答えが始まる文字位置(エージェントの制限は20,000) | エージェントの回答 | 正しい回答 |
|---|---|---|---|
| Wikipedia、Equinox | 38,604 | equinox | equilux |
| Wikipedia、ChromeOS | 24,709 | October 2011 | August 2011 |
| Wikipedia、Cannibal Corpse | 25,566 | March 1993 | February 1993 |
| Aseprite release notes | 59,987 | v1.2.22 | v1.3-rc8 |
| Baseball-Reference、Tim Wakefield | 65,663 | 2.25 | 12.27 |
| RuPaul’s Drag Race Wiki、Season 1 | 99,250 | “I Will Survive” | “Stronger” |
全6件において、エージェントは正しい回答が含まれているページを引用していました。引用は、エージェントがどこを見たかを示すものであり、そのページに何が書いてあるかを示すものではありません。
ラッパークラスであるBrightDataToolsでは、startが次の20,000文字を返し、findは単語やフレーズの一致箇所ごとに約3,000文字の最大6つの文章を返します。切り詰められたページの末尾にある注記は、エージェントに両方の引数について伝えます。ページング機能だけでは十分ではありませんでした。startのみを使った別のテストでは、エージェントが18回の実行中3回しかページの次の部分を要求しませんでした。
各セットアップは質問ごとに8回実行しました。
| セットアップ(同じ6つの長いページの質問) | 正解数(48回中) | 実行あたりのプロンプトトークン数 | gpt-5.4-miniのコスト(全48回実行) |
|---|---|---|---|
| 文字数制限のみ | 24 | 23,023 | 0.52ドル |
startとfindを使った文字数制限 |
33 | 11,908 | 0.35ドル |
エージェントは48回の実行のうち28回でfindを呼び出しました。正答率の向上は有望ですが、バージョンあたり48回の実行では統計的にはまだ有意ではありません(p ≈ 0.10)。
情報源をユーザーに示す前に確認してください。エージェントは開いたことのない検索結果をよく引用していました。ローカルでの実行では、引用したURLのうち開いたものは4分の1未満でした。情報源を確認するには、findと回答の特徴的な部分を使ってBrightDataToolsのスクレイピングツールを呼び出してください。
MLflowで全てのツール呼び出しをトレースする
トレースは、エージェントが実行した全ての検索と読み取った全てのページを表示します。これにより、エージェントが各回答をどのように生成したかを確認し、誤りの原因となったステップを素早く見つけることができます。MLflow DSPy連携は、各モジュール、モデル呼び出し、ツール呼び出しをスパンとして記録します。テスト済みのMLflowリリースをインストールします。
uv pip install "mlflow==3.17.1"次に、エージェントが実行される前に、これらの行をagent.pyに追加します。
import mlflow

mlflow.set_tracking_uri("sqlite:///mlflow.db")
mlflow.dspy.autolog()
MLflow 3.17にはデータベースバックエンドが必要なため、トラッキングURIはローカルのSQLiteファイルに設定されています。トレースを表示するにはmlflow ui --backend-store-uri sqlite:///mlflow.dbを実行してください。このスパンツリーは1つの質問から得られたものです。
CHAIN       ReActV2.forward
LLM         Predict.forward          x6
CHAT_MODEL  LM.__call__              x6
PARSER      ChatAdapter.format       x6
TOOL        Tool.search_engine       x4
TOOL        Tool.scrape_as_markdown  x1
TOOL Tool.submit x1各TOOLスパンは、モデルが送信した引数と、Bright Data MCPサーバーが返したテキストを保存します。MLflow UIで最初の検索スパンを選択すると、その呼び出しに関する両方が表示されます。
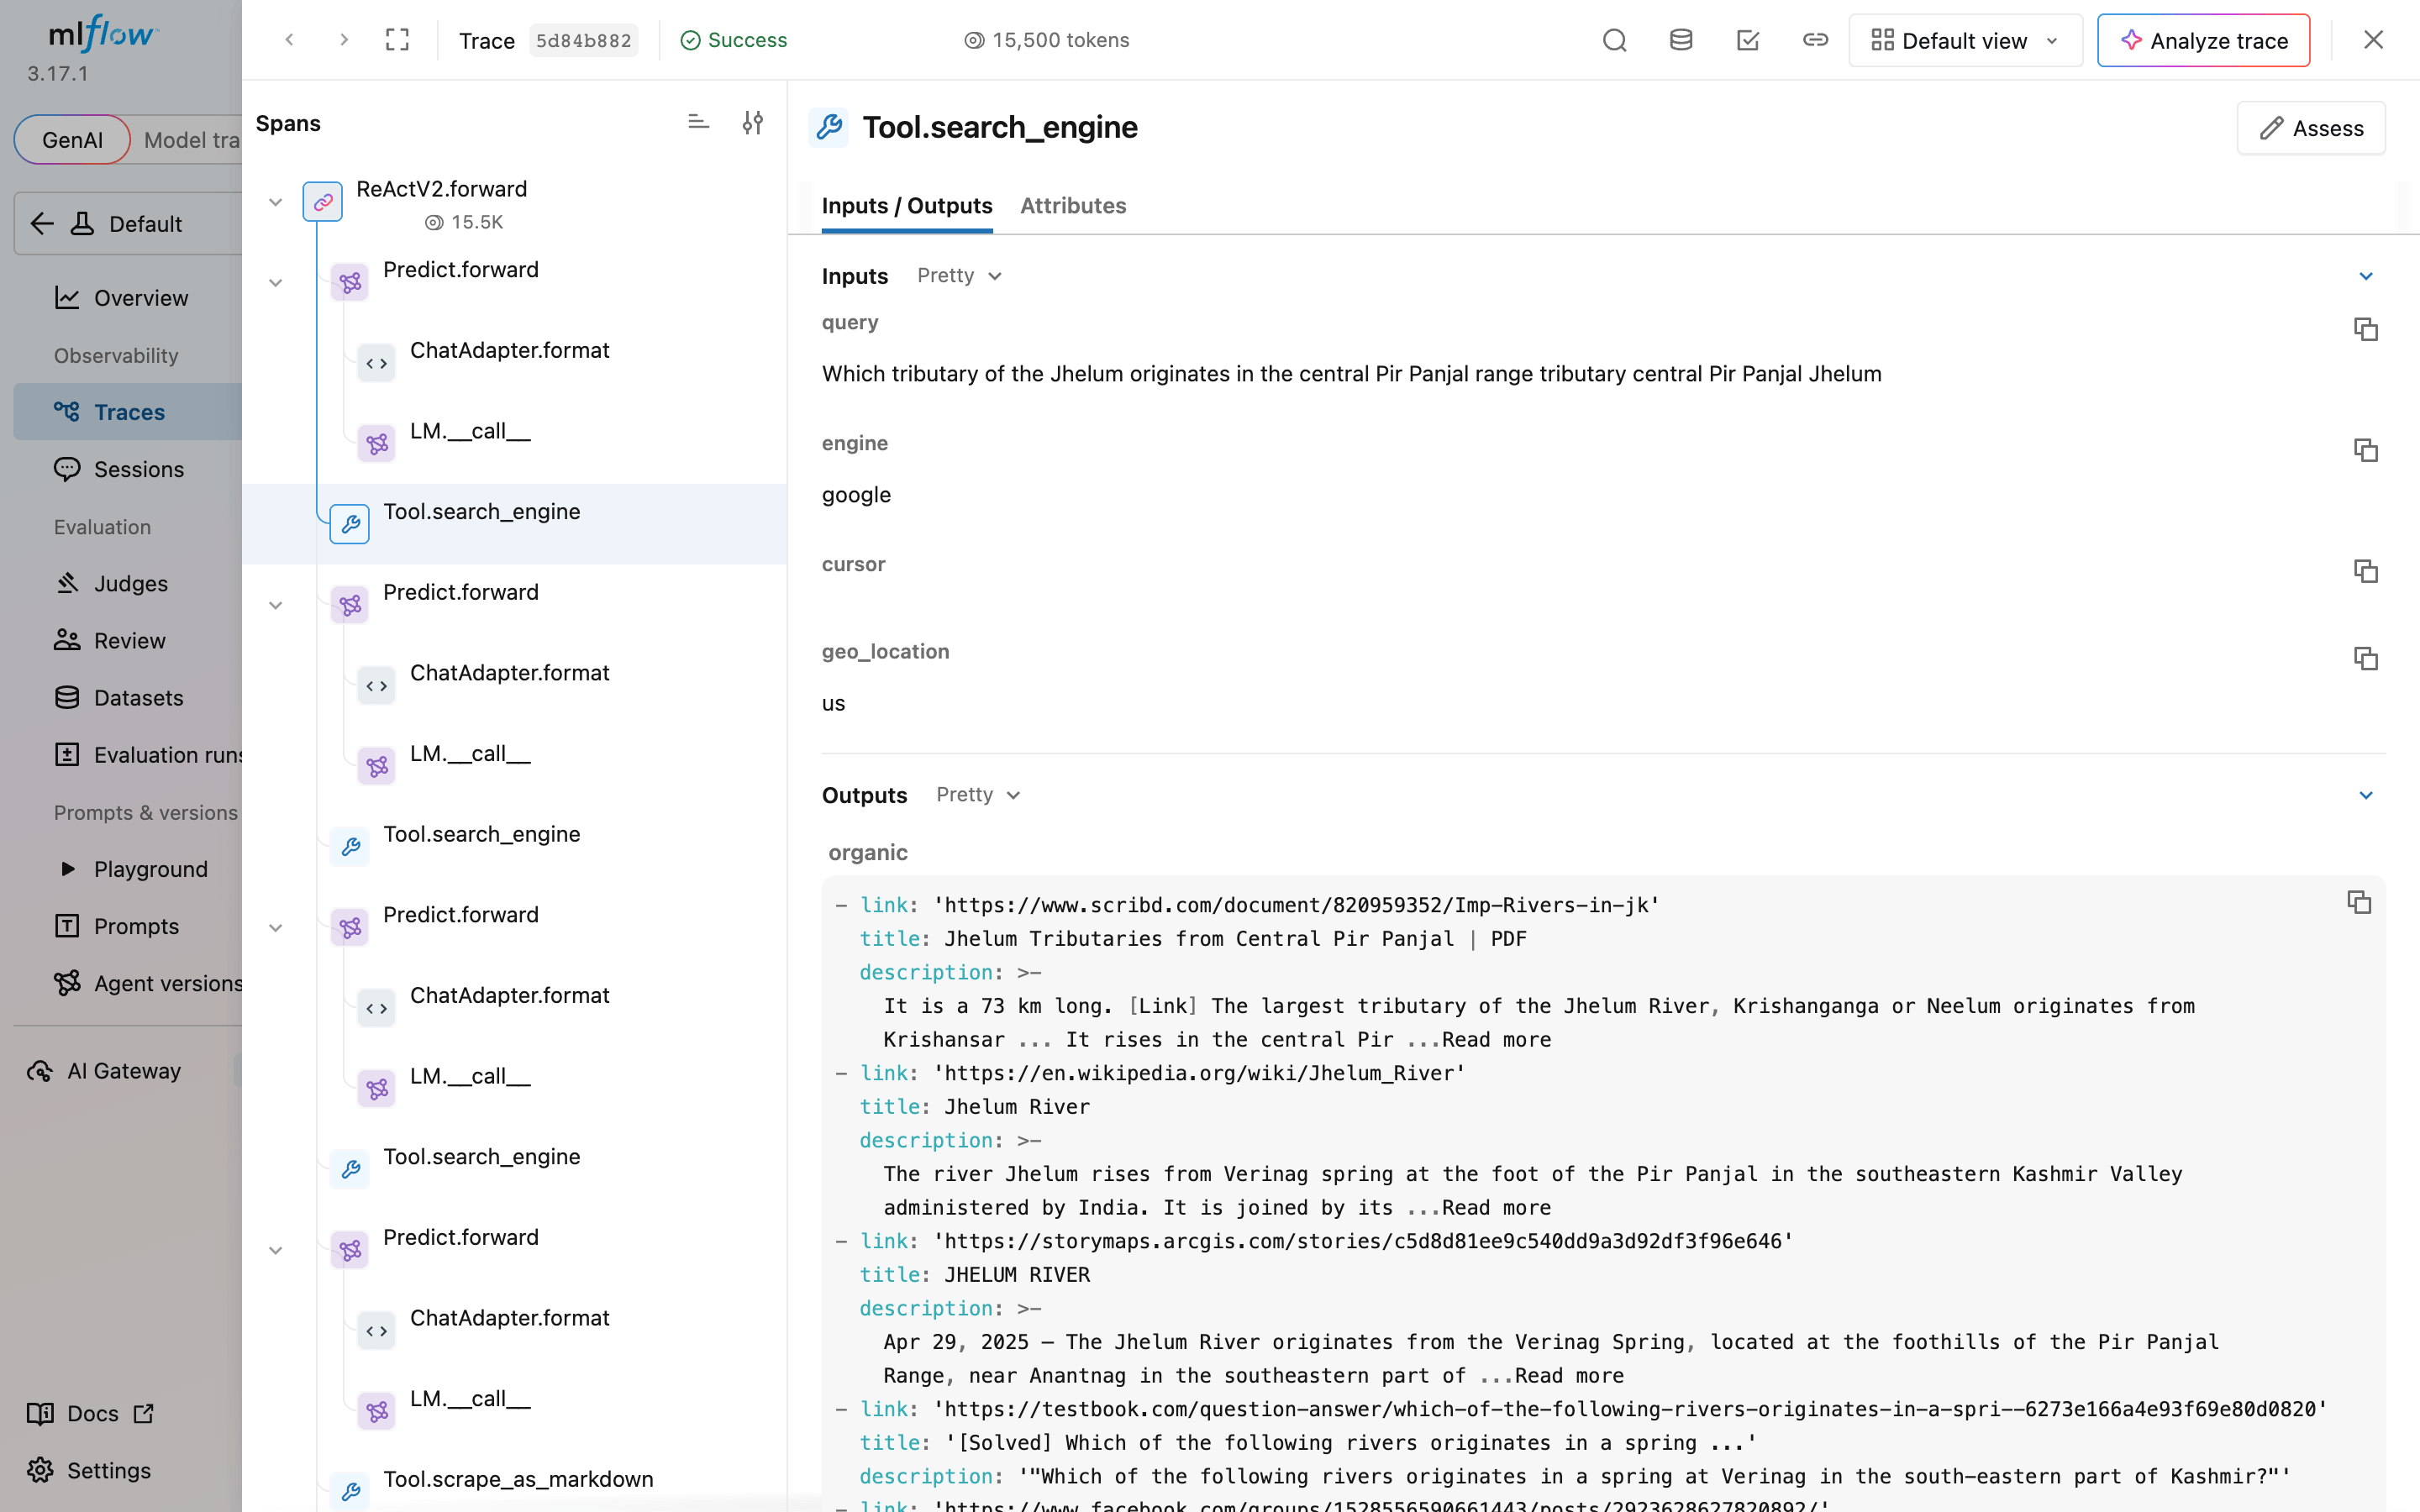
誤答について、この表示はエージェントのクエリが正しい回答を含むページを見つけたかどうかを示します。
まとめ
Bright Data MCPサーバーを使うことで、このDSPyエージェントは60のベンチマーク質問のうち54~58問に正しく回答し、14問から向上し、ナレッジカットオフ後の出来事に関する8問全てにも正解しました。これを評価・最適化するには、dspy.EvaluateとGEPAがワーカースレッドからツールを呼び出すため、MCPセッションを専用のイベントループ上に保ってください。ここでの誤答6件は、エージェント自身の文字数制限を超えた箇所に答えがあり、findによってエージェントはページ全体を検索できるため、最適化する前に誤答を確認してください。GEPAは、誤答が指示文で修正できる共通の原因を共有している場合に最も役立ち、コピーされた回答がないか出力を確認する必要があります。無料のBright Dataアカウントを作成し、モデルが記憶からは答えられない質問でagent.pyを実行し、自分自身の質問でevaluate.pyを実行してみてください。
よくある質問
DSPyはMCPサーバーをサポートしていますか?
はい。dspy.Tool.from_mcp_toolとMCP Python SDKのクライアントを使うことで、DSPyはBright Data MCPサーバーなどのMCPサーバーのツールをDSPyツールに変換します。pip install "dspy[mcp]"でMCPエクストラをインストールしてください。DSPy 3.4.1では、MCPツールは非同期であるため、エージェントはacallで呼び出してください。ワーカースレッドでは、バックグラウンドのイベントループ上で同期ラッパーを使用してください。
DSPyはMCPクライアントですか?
いいえ、それ単体ではありません。DSPyはMCP Python SDKのクライアントを使用し、dspy.Tool.from_mcp_toolがそのクライアントのツールをDSPyツールに変換します。DSPyはエージェントプログラムを構築・最適化し、MCPはエージェントをBright Data MCPサーバーなどのサーバーに接続します。
DSPyエージェントにウェブ検索を追加するにはどうすればよいですか?
Bright Data MCPサーバーに接続し、その検索・スクレイピングツールを、DSPy 3.5以降dspy.ReActが使用する実装であるdspy.ReActV2に渡します。エージェントはGoogleで検索し、ページをMarkdownとして読み取り、情報源のURLを返します。検索結果をJSONとして返すBright DataSERP APIを呼び出すPython関数も、DSPyツールとして機能します。
どのウェブ検索ツールがDSPyで動作しますか?
Bright Data MCPサーバーは、単一の接続を通じてDSPyエージェントにGoogleの検索結果と完全なページをMarkdownとして提供し、サーバーがボット対策を処理します。60のSimpleQA Verified質問において、gpt-5.4-miniはこれを使うと54~58問正解し、使わない場合の14問から向上しました。他の検索ツールも動作し、AIエージェント向け検索ツールの比較でそれらを取り上げています。
DSPy ReActV2とは何ですか?
dspy.ReActV2は、ネイティブのツール呼び出しに基づいて構築された実験的なDSPyエージェントモジュールです。構造化された履歴を保持し、1ターンで複数のツール呼び出しを行うことができ、submitツールで終了します。DSPyのドキュメントには、DSPy 3.5以降dspy.ReActが使用する実装として記載されており、3.6ではReActV2という名称は削除されています。
DSPyは今でも使う価値がありますか?
はい、メトリクスで評価できるプログラムにおいては有用です。DSPyはタスクをプロンプトから分離して保持するため、モデルを切り替え、メトリクスとGEPAなどのオプティマイザーで再最適化できます。デフォルト設定では、GEPAはプログラムが一部の学習用質問にまだ正しく答えられていない場合にのみ変更を提案するため、まずプログラムを評価してください。
DSPyは本番環境向けですか?
はい、バージョンを固定し、ツール呼び出しを堅牢にすれば可能です。dspyおよびMCPサーバーを固定し、ツール出力のサイズを制限し、エージェントがその制限を超えてテキストを検索できるようにし、ツール呼び出しに再試行、タイムアウト、エラー数を追加し、MLflowで実行をトレースしてください。ReActV2などの実験的なモジュールはマイナーリリース間で変更される可能性があります。
DSPyはプロンプト最適化に使用できますか?
はい。GEPAなどのDSPyオプティマイザーは、評価済みの例に基づいてプログラムの指示文を書き換えます。GEPAは評価済みの実行とその書面でのフィードバックをレビューし、新しい指示文を提案し、その後、検証用セットで最も良い成績を出すものを保持します。GEPAは学習用の回答を指示文にコピーすることがあるため、デプロイする前に結果をレビューしてください。