この記事では、以下の内容を学びます:
- データフライホイールモデルとは何か。
- AIデータフライホイール戦略とは何か、そしてエンタープライズにとってなぜ必要なのか。
- Bright Dataのサービスを使用してAIデータフライホイールを実装する方法。
さっそく始めましょう!
データフライホイールモデルとは?
フライホイールモデルは、ジム・コリンズが著書「ビジョナリー・カンパニー」で提唱したコンセプトです。比較研究を通じて、コリンズは企業が持続的な高パフォーマンスを長期間にわたって達成するための要因を特定しました。
このシナリオでは、フライホイールというアイデアが根本的なプロセスを非常にうまく説明しています。フライホイールに少しずつ力を加えていくと、やがて回転速度と勢いが増し、止めることができなくなります。その瞬間、フライホイールはあなたのために働き、小さな力で勢いを維持するだけでよくなります。
このコンセプトは、近年データの役割がますます重要になっているため、組織にとって重要です。そのため、コリンズのアイデアに触発され、企業はデータフライホイールモデルを適用し始めました。
これは、情報の収集・処理・活用が継続的なフィードバックループを生み出すモデルです。その核心にある原則はシンプルです。データがプロセスを最適化し、より質の高い情報をもたらし、その知識がさらなる成果を生み出します。時間が経つにつれ、この好循環はフライホイールに力が加わるのと同様に、止められない勢いを生み出します。
エンタープライズにおけるデータフライホイールモデル
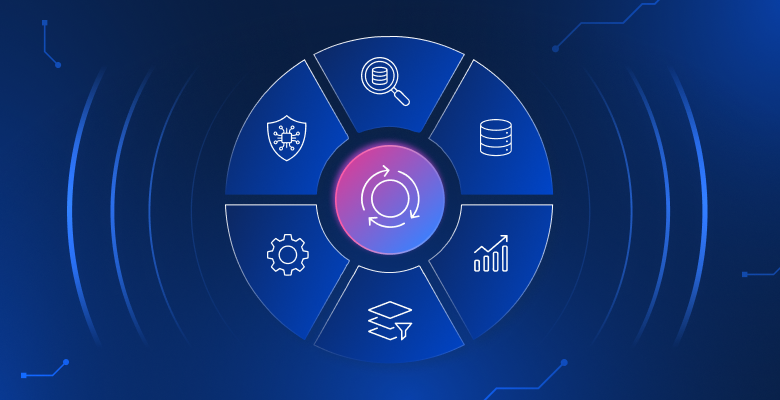
ビジネスにとって、データフライホイールモデルは最もシンプルな形で以下のように図式化できます:
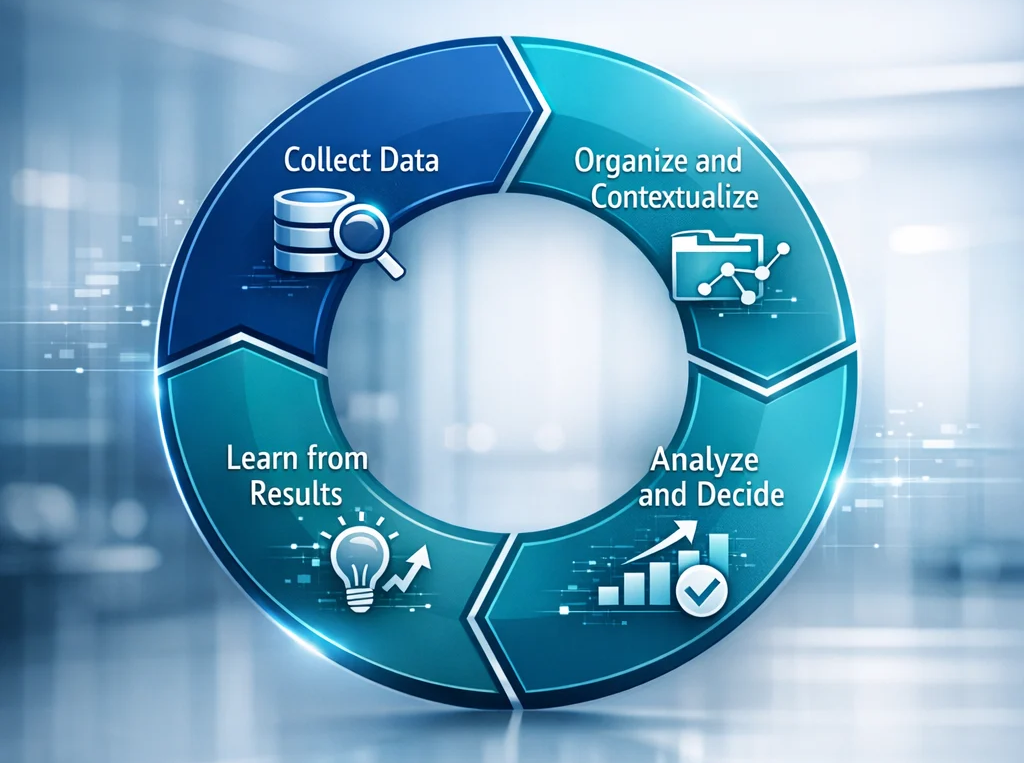
以下に、その仕組みの説明を示します:
- データ収集:データ収集のステップには、企業の内部データ、ウェブデータ、製品やサービスに対する顧客のインタラクションなど、さまざまなソースが含まれます。
- 整理とコンテキスト化:データが収集された後、次のステップはデータを整理し、分析のために準備することです。
- 分析と意思決定:データが適切に整理されたら、パターン、逸脱、新興トレンドを発見するために分析できます。これにより、正確でデータ駆動型の意思決定が可能になります。
- 結果からの学習:成果が新たなインプットを生み出し、後続のサイクルでシステムをより賢くします。
AIデータフライホイールとは?
LLMの台頭により、企業はAIを活用してデータ駆動型プロセスを改善する機会を得ました。ここからAIデータフライホイールが生まれ始めました。コンセプトは前述のものと似ていますが、根本的なプロセスはより広範です。
AIデータフライホイールループとは、さまざまなソースから収集されたデータがAIモデルを継続的に改善する自己強化サイクルです。以下は、エンタープライズにとってこれが高レベルでどのように機能するかを示す図です:
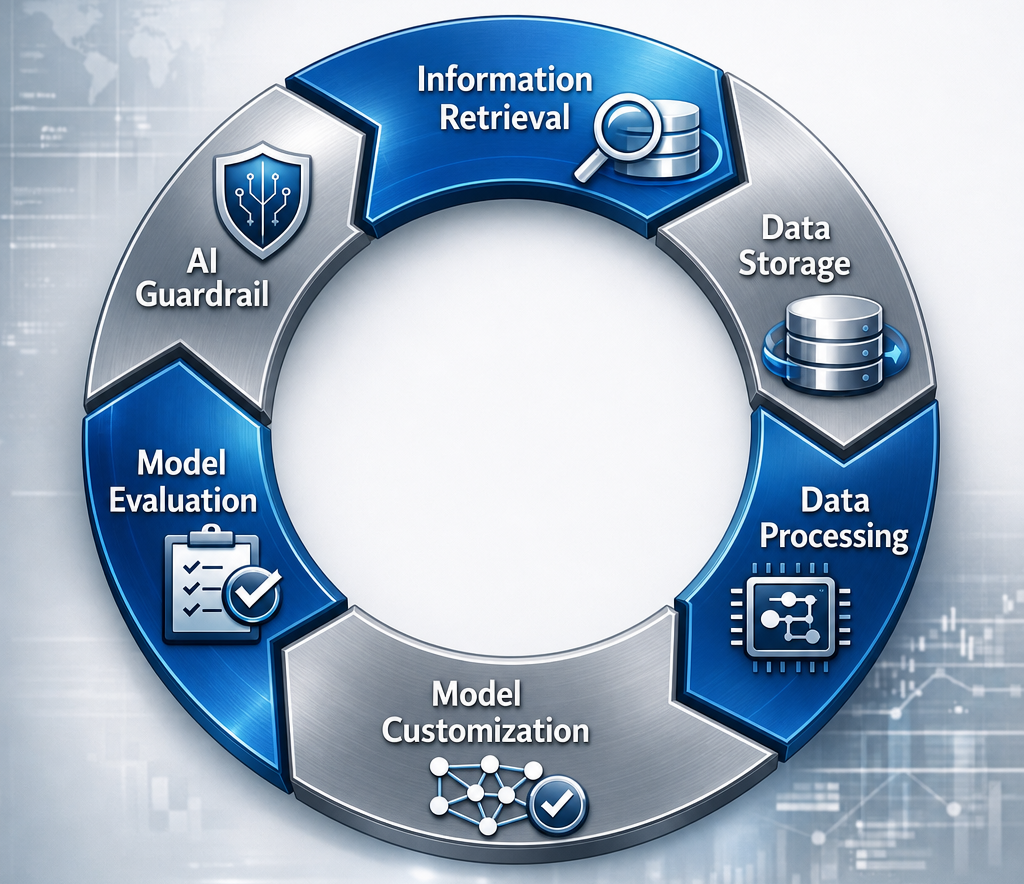
この場合、ループは以下のとおりです:
- 情報取得:AIデータフライホイールサイクルは、ウェブ、社内のウィキやドキュメント、サポートクエリと回答、チャットボットとの顧客インタラクションなど、さまざまなソースからエンタープライズデータを収集することから始まります。また、データはテキスト、画像、動画などさまざまな形式で取得できます。
- データストレージ:あらゆるデータ戦略の核心、特にエンタープライズにとっては、データの保存方法に依存します。LLMは構造化データと非構造化データの両方を取り込めるため、AIデータフライホイール戦略に対応したデータストレージシステムは、必要なすべてのデータタイプを保存できる必要があります。
- データ処理:データ処理は、ストレージからデータを抽出して精製するループのステップです。生データをフィルタリングしてノイズを除去し、LLMへの取り込みに備えます。
- モデルカスタマイズ:このステップでは、教師あり微調整やMixture of Experts(MoE)などのプロセスに基づいてモデルの改善を行います。簡単に言えば、収集・処理されたデータをLLMに供給し、モデルの能力向上に活用します。ビジネス観点から見ると、LLMがエンタープライズのデータ収集から得られた新しい能力と知識を習得することを意味します。
- モデル評価:LLMのカスタマイズは、得られた出力がアプリケーションや特定のユースケースにとってすぐに良いものであることを自動的に保証するわけではありません。モデルのパフォーマンスを評価し、最終的に結果がビジネス目標と一致するまで改善を続ける必要があります。
- AIガードレール:エンタープライズはデータのコンプライアンスとセキュリティを必要とします。AIガードレールは、LLMがポリシーに準拠した応答をすることを保証するシステムです。
エンタープライズパイプラインにAIデータフライホイール戦略が必要な理由
データパイプラインは線形ロジックを中心に構築されてきました。データがソースから宛先へと流れ、途中で変換され、ダウンストリームシステムに供給されます。従来、このようなデータパイプラインはETL(Extract、Transform、Load)と呼ばれています。このアプローチは機能的ですが、これらのパイプラインは静的であるため、多くの価値が失われます。
AIによって着実に形成されるビジネス環境において、静的なパイプラインはもはや十分ではありません。なぜなら、データを処理するだけで、そこから学習しないからです。これがまさに、AIデータフライホイールが状況を変える点です。
エンタープライズデータインフラに自己強化ループを組み込むことで、パイプラインは受動的なものから脱却し、継続的改善の能動的な推進力となります。そうすることで、AIシステムが処理する各インタラクション、クエリ、またはトランザクションが新しいデータを生成します。新しい情報がサイクルにフィードバックされると、それらのシステムはより正確になり、ビジネス目標に沿ったものになります。
時間が経つにつれて、この複合効果は以下のような具体的なエンタープライズの利点に変換されます:
- 運用コストの削減。
- より迅速で信頼性の高い意思決定。
- ビジネスの拡大とともに能力が向上するAIモデル。
言い換えれば、パイプラインが稼働すればするほど、より賢くなります。そして、より賢くなればなるほど、組織により多くの価値をもたらします。
AIフライホイール戦略を使用するメリット
正しく実装された場合、AIデータフライホイール戦略のメリットはモデルのパフォーマンスを超えて広がります。以下に、企業がこのモデルを実装することで得られるメリットを示します:
- 継続的なモデル改善:データ分布が変化するにつれて品質が低下する静的なAIデプロイメントとは異なり、AIデータフライホイールは新鮮なデータでモデルを常に改善し続けます。すべての新しいインタラクションがトレーニングシグナルとなるため、AIシステムはより正確で関連性の高いものになります。これらすべてが、コストのかかる手動の再トレーニングサイクルを必要とせずに実現されます。
- 複合的な競争優位性:フライホイール効果は本質的に累積的です。サイクルを早く開始した組織は、競合他社が複製できない独自のデータ資産とモデルの改善を蓄積します。時間が経つにつれて、これは構造的な競争優位を生み出します。フライホイールが回り続けるほど、競合他社がギャップを縮めることが難しくなります。
- 大規模での運用コスト削減:AIモデルが能動的学習によってより高性能になるにつれて、人間の介入を減らしてより複雑なタスクを処理できるようになります。これにより、大量の反復的なワークフローの自動化が実現します。
- より迅速で正確な意思決定:AIフライホイール戦略により、分析ツールを動かすモデルは最新かつ文脈的に関連性の高いデータで供給されます。これにより、イベントとインサイトの間のレイテンシが短縮され、リーダーシップがほぼリアルタイムで正確な情報に基づいて行動できるようになります。
- 深いエンタープライズパーソナライゼーション:フライホイールが顧客、内部ユーザー、ビジネスプロセスからのインタラクションデータを取り込むにつれて、AIモデルはエンタープライズ固有のパターンとニーズについて詳細な理解を深めます。これにより、汎用AIモデルでは達成できないレベルのパーソナライゼーションが実現します。
- データガバナンスとコンプライアンスの改善:適切に構造化されたAIフライホイールは、ガードレールと評価レイヤーをループに直接統合します。つまり、コンプライアンスとセキュリティは、進化する規制およびビジネス要件に対してモデルの出力を継続的に検証する組み込みのチェックポイントです。
Bright DataがAIデータフライホイール戦略の実装を支援する方法
Bright DataのサービスはAIデータフライホイールサイクルの最上位に位置し、特に以下のサービスを通じてウェブから最新データを取得することで支援します:
- ウェブデータマーケットプレイス:250以上のドメインをカバーする350以上のAI対応データセットのコレクション。JSON、CSV、Parquetなど複数のフォーマットで、クラウド配信やその他の配信方法で提供されます。
- ウェブスクレイピング製品:ライブウェブデータ抽出のためのAPIベースのソリューションスイートで、以下が含まれます:
– SERP API:Google、Bingなどの検索エンジンから構造化された検索結果をリアルタイムで提供します。
– Crawl API:構造化データ抽出のためのスケーラブルなウェブサイトクローリングを実行します。
– スクレイパーAPI:人気ドメインから直接データを抽出するための120以上のウェブサイトをカバーします。
- MCPサーバー:Bright DataのMCPサーバーにより、AIアプリケーションがリアルタイムでウェブデータにアクセス、検出、抽出できます。Claude Desktop、Cursor、およびその他すべてのMCP互換ソリューションに接続したAIエージェントを作成し、ブロックされることなくリアルタイムでウェブを検索し、アクションを実行し、データを取得できます。
Bright Dataが際立っているのは、以下に基づくエンタープライズグレードのスクレイピングインフラです:
- 195カ国に分散した4億以上のレジデンシャルプロキシネットワークで、高度にスケーラブルで並行したウェブデータ収集をサポートします。
- GDPR、CCPA、およびISO27001、SOC2などの高レベルのプライバシーとセキュリティ認証に準拠しています。
また、Bright DataがAIデータフライホイール戦略に特に適している理由は、その統合能力にあります。データはエンタープライズのデータストレージに保存されている限り使用可能です。Bright DataのサービスはSnowflake、S3バケット、その他いくつかのクラウドプロバイダー(GCP、Azure、AWSなど)とシームレスに統合します。これにより、お好みのストレージサービスを引き続き使用しながら、Bright Dataのサービスを統合できます。
Bright DataでAIデータフライホイール戦略を実装する方法
AIデータフライホイール戦略を実装するには、ループの各レイヤーに適切なサービスを組み合わせる必要があります。前述のとおり、Bright Dataはデータ取得レイヤーに適合し、サイクルのエントリーポイントとして機能します。
以下は、収集レイヤーでBright Dataサービスを使用してAIデータフライホイール戦略を実装する方法の高レベルアーキテクチャです:
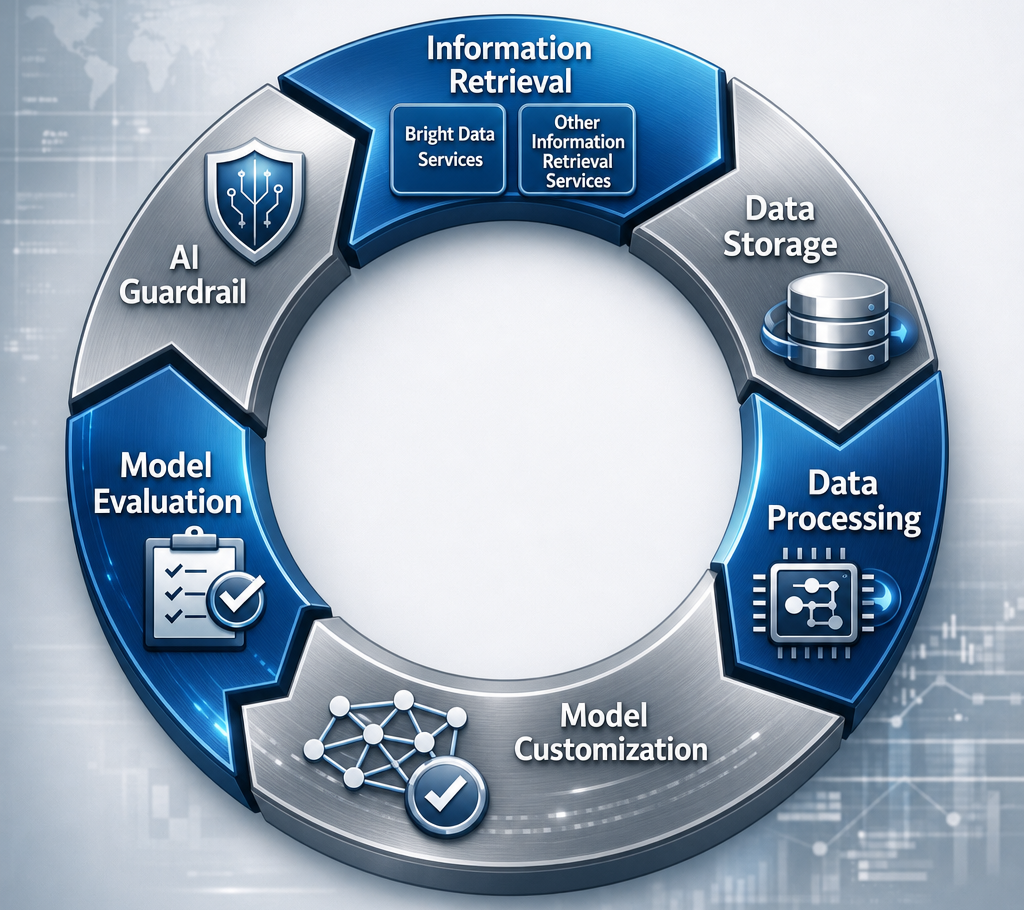
このアーキテクチャを念頭に置いて、Bright Dataがフライホイールを動かす2つの具体的なエンタープライズユースケースを見てみましょう。
金融サービスにおける競合情報
金融機関は、状況が急速に変化する市場で事業を展開しています。価格、センチメント、規制の更新、競合他社のポジショニングはすべてほぼリアルタイムで変化します。静的なデータセットは、たとえ最近のものであっても、すぐに古くなります。
このコンテキストでは、Bright Dataを活用したAIデータフライホイールを以下のように構成できます:
- データ取得:Bright DataのSERP APIとスクレイパーAPIを活用して、金融ニュースメディア、決算報告、規制機関、ユーザーセンチメントを把握するためのRedditなどのプラットフォームから構造化データを収集します。
- データストレージと処理:スクレイピングされたデータはBright Dataのネイティブ統合を通じてSnowflakeインスタンスに流れ込み、モデルへの取り込みに利用できるようになる前に、クリーニング、重複排除、コンテキストメタデータによる強化が行われます。
- モデルカスタマイズ:LLMは更新されたコーパスで定期的にファインチューニングされ、ドメイン固有の金融用語、競合他社の戦略、市場パターンの理解を向上させます。
- AIアプリケーション:改善されたモデルが社内分析ツールを動かし、競合インサイトを表示し、規制リスクにフラグを立て、アナリストや意思決定者向けの自動ブリーフィングを生成します。
- フライホイールフィードバック:ツールとのインタラクションが新しいトレーニングシグナルとして記録されます。これらのシグナルはストレージレイヤーに戻り、モデルが露出したギャップを対象とした新鮮なデータ収集を促します。
時間が経つにつれて、モデルは機関の特定の市場フォーカスに対してますます特化し、既製のAI製品では複製できない独自のインテリジェンス資産を構築します。
Eコマースにおける顧客体験の最適化
大規模なEコマースエンタープライズにとって、顧客の期待に沿い続けることは大きな課題です。製品の好みは変化し、競合他社の価格は毎日変わり、顧客のセンチメントは数十のプラットフォームにわたって進化します。定期的なアンケートや四半期ごとのレビューに頼るだけでは、競争力を維持するのに十分ではありません。
このシナリオでは、Bright Dataのサービスを使用して構築されたAIデータフライホイールは以下のように機能します:
- データ取得:Bright DataのスクレイパーAPIがAmazon、Trustpilot、Googleショッピングなどのプラットフォームから構造化された製品レビュー、評価、Q&Aコンテンツを抽出します。または、複数の更新オプションを提供するウェブデータマーケットプレイスからAI対応データセットをダウンロードすることもできます。
- データストレージと処理:抽出されたデータはBright Dataのネイティブクラウド配信を通じてS3バケットに格納され、LLMへの取り込みのために処理・準備されます。
- モデルカスタマイズ:スクレイピングされ処理されたデータを使用してLLMがファインチューニングされます。これにより、モデルは実際の顧客が製品のニーズ、ペインポイント、満足度の要因をどのように表現するかについて詳細な理解を深めます。
- AIアプリケーション:ファインチューニングされたモデルが、パーソナライズされた製品推薦、プロアクティブなサポート応答、市場ポジショニングに合わせた動的な価格設定提案を提供します。
- フライホイールフィードバック:システムとのすべての顧客インタラクションが新しい行動シグナルを生成します。これらはデータパイプラインに戻され、モデルを更新・改善します。
結果として、顧客ニーズの理解を深めるシステムが生まれ、チャーンを減らし、手動分析システムに依存する競合他社を上回るパフォーマンスを発揮します。
AIデータフライホイール戦略実装のメリットとデメリット
あらゆるエンタープライズの取り組みと同様に、AIデータフライホイール戦略を採用することには大きな機会と課題が伴います。方程式の両面を理解することは、賢明な投資と現実的な期待設定を望む組織にとって不可欠です。
👍 メリット:
- 自己持続的な価値創造:フライホイールが十分な勢いに達すると、自律的に改善を生み出します。サイクルがそれ自体に複利をかけて時間とともに増加するリターンをもたらすため、企業は成果を得るためにリソースを投入し続ける必要がなくなり、比例的に低い限界努力で実現します。
- 戦略的資産としての独自データ:フライホイールは体系的なデータ収集と前処理を促進し、時間の経過とともにビジネス固有の独自のデータ基盤を構築します。この資産は競合他社には複製できず、長期的な競争優位性の最も防御可能なソースの一つとなります。
- コスト増加に比例しないスケーラビリティ:フライホイールを通じてトレーニングされたAIモデルが段階的により高性能になるため、エンタープライズは人員やインフラ支出の対応する増加なしに事業を拡大できます。
- AIとビジネスコンテキストの整合:エンタープライズ固有のデータによる継続的な再トレーニングにより、モデルは組織の言語、プロセス、目標と緊密に整合し続けます。言い換えれば、汎用LLMから始まり、ビジネスニーズについて独自かつ深い知識を持つ特化したモデルになります。
👎 デメリット:
- 高い初期投資:AIデータフライホイールの開始には、相当な初期資本が必要です。ストレージ、処理、モデルカスタマイズの構築または統合は、リターンが見えてくる前に技術と人材の両方への投資を必要とする取り組みです。
- 専門知識と人材要件:エンタープライズレベルでAIデータフライホイールを運用することは、ジェネラリストのITチームが吸収できるタスクではありません。データエンジニアリング、MLOps、AIにわたる専門的な専門知識が必要です。これらのプロファイルは希少でコストがかかります。
- 遅いスタート、遅延したリターン:フライホイールのメタファー自体が、初期の勢いを構築することが難しいことを示しています。初期段階では、メリットはわずかで、コストは高くなります。サイクルの複利効果が測定可能で意味のあるものになるまでの長い立ち上げ期間に備える必要があります。
- ガバナンスとコンプライアンスの複雑さ:フライホイールを流れるデータの量と種類が増えるにつれて、規制リスクの表面積も拡大します。複数の法域で事業を展開するエンタープライズは、データ収集、ストレージ、モデルトレーニングの実践がGDPRやCCPAなどのフレームワークに準拠し続けることを確保する必要があります。
まとめ
このAIデータフライホイールの記事では、フライホイールのコンセプトの起源と、AIデータフライホイール戦略とは何かを学びました。また、これが企業にとってなぜ重要なのか、そしてBright Dataがその実装にどのように役立つかも確認しました。
Bright DataはAI情報取得レイヤーでゲームに参入し、スクレイピングインフラを管理することなくウェブからデータを抽出するのを支援します。エンタープライズグレードのインフラと広範な統合能力により、必要なデータをスクレイピングし、すでに使用しているサービスに保存できます。
Bright Dataのアカウントを無料で作成して、ウェブデータソリューションの統合を始めましょう!