求人ボードはキーワード完全一致でしか検索できないため、表現が求人票と一致しないと最適な求人が見つかりません。セマンティック検索は意味でマッチングします。エンドツーエンドで構築し、最も複雑なモードが最良と決めつけず、どの検索モードが優れているかを実測します。
TL;DR
このガイドでは、Bright Data(ウェブスクレイピング)、Cohere(エンベディング+リランク)、LanceDB(ローカルベクターストア)を使い、200件の実際のLinkedIn求人票を対象にセマンティック求人検索エンジンを構築します。
- キーワード検索は完全一致、ベクター検索は意味でマッチングします。「LLMを扱うエンジニア」というクエリで、キーワード検索では見逃す「GenAI開発者」の求人を発見できます。
- Bright DataのWeb Scraper APIは、構造化されたLinkedIn求人をJSONで返します。料金は1件あたり$0.0015で、HTMLパースやスクレイパーのメンテナンスは不要です。
- LanceDBはローカルで動作し、ベクター検索とSQLフィルター(給与、シニアリティ)を1クエリで組み合わせ、全文検索とCohereリランキングも対応します。
- 10件のテストクエリで、ベクター検索のprecision@3は70%、キーワードは43%でした。ハイブリッド+リランクはこの規模では改善なし。1万行未満ではベクター単体が合理的なデフォルトです。
- プロジェクト全体は9つの小さなファイルで構成され、評価ハーネスを含む完全なコードはGitHubにあります。全体の実行コストは約$0.34です。
キーワード検索の問題点
求人ボードのキーワード検索は、まさに指示通りに動作します。クエリ内のリテラルトークンを含む求人票を返します。「LLMとプロンプトエンジニアリングを扱うエンジニア」と検索しても、完璧に適合しているのに「GenAI開発者」のような求人は見つかりません。語彙検索は意味ではなく完全一致で検索するからです。
ベクター検索は意味でマッチングします。各求人の説明はエンベディング(セマンティックな内容を捉えた高次元ベクター)に変換され、クエリも同様に変換されます。クエリのベクターに近い求人は、共通の単語がなくても意味的に良いマッチとなります。
実用的な検索エンジンを構築するには3つの要素が必要です:
- Bright Dataが200件の実際のLinkedIn求人票を構造化されたクリーンなJSONとしてスクレイピングします。
- Cohereが説明文をエンベディングに変換し、最終結果をリランキングします。
- LanceDBがエンベディングをローカルに保存し、SQLスタイルのフィルターを使ったハイブリッド(ベクター+全文)クエリを提供します。
スタックの概要
各レイヤーの役割と採用理由:
| レイヤー | ツール | 採用理由 |
|---|---|---|
| Webデータ | Bright Data Web Scraper API | LinkedInの専用スクレイパーが給与・シニアリティ・所在地を含む構造化JSONを返し、HTMLパースやスクレイパーのメンテナンスが不要。 |
| エンベディング | Cohere embed-english-v3.0 |
非対称エンコーディング(ドキュメントとクエリで異なる入力タイプ)。Cohereはマルチモーダルなembed-v4.0も提供。v3はEnglish専用の価格・レイテンシプロファイルでここでは採用(v3のEOL前に再エンベディングを推奨)。 |
| リランカー | Cohere rerank-v3.5 |
価格・レイテンシプロファイルのためv3.5を固定。Cohereはquality向け-proとlatency向け-fastのrerank-v4.0も提供。 |
| ベクターストア | LanceDB | ローカル・組み込み型でサーバー不要。ハイブリッド(ベクター+BM25)検索とSQLプリフィルターをサポート。 |
| UI(任意) | Streamlit | PythonデータアプリのミニマルコードWebUI。 |
このスタックはラップトップの単一Python venvで動作します。管理サービスはBright DataとCohereのみです。
セットアップ
実行可能な完全プロジェクトはGitHubにあります。クローンして依存関係をインストールしてください(Python 3.10以上):
git clone https://github.com/triposat/semantic-job-search.git
cd semantic-job-search
python -m venv .venv && source .venv/bin/activate
pip install -r requirements.txtサンプル環境ファイルをコピーし、Bright DataトークNとdashboard.cohere.comのCohereキー(トライアルキーでガイド全体を通して使用可能)の2つのAPIキーを追加します:
cp .env.example .env
# then edit .env with your keys:
#   BRIGHTDATA_API_TOKEN=...
# COHERE_API_KEY=...両方のキーを設定したら、python scrape.pyでデータを取得し、python index.pyでインデックスを構築します。
アーキテクチャ
システムは1つではなく2つのフローで構成されています。インジェストはインデックスを構築します(1回、またはスケジュールで実行)。クエリは検索のたびに実行されます。両方ともCohereとLanceDBを使用しますが、それぞれ異なる処理を行います。
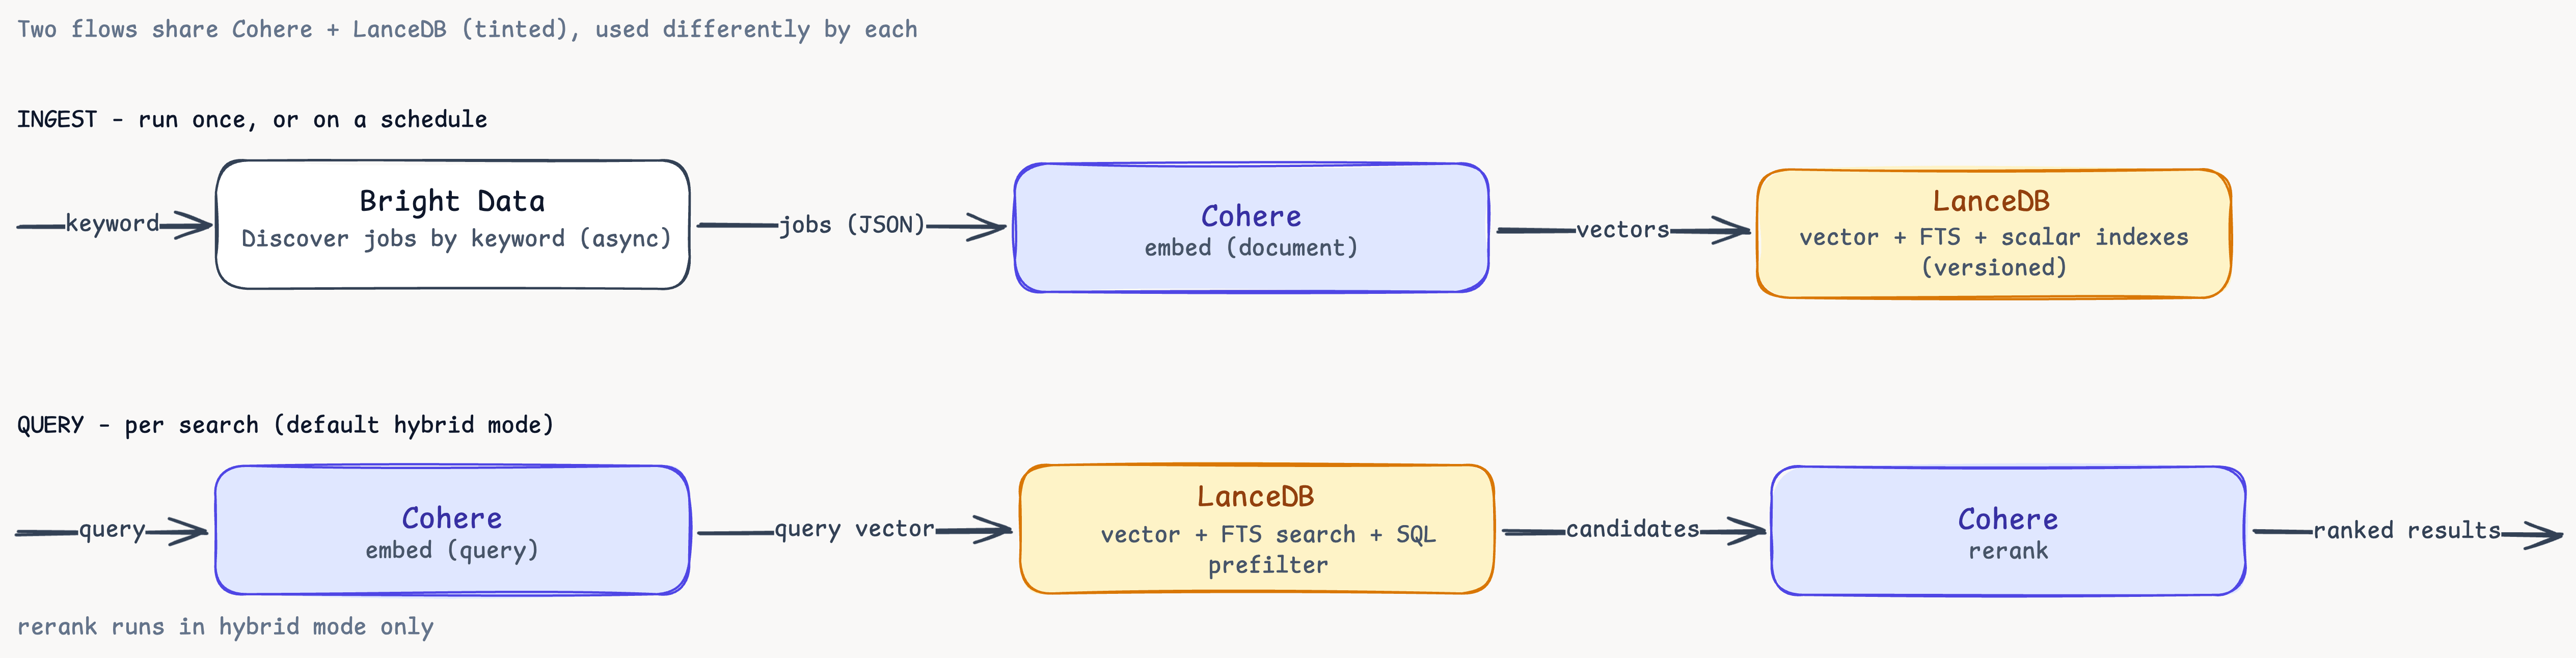
2つのフローを並べて表示。インジェストはドキュメントをエンベディングして保存します。クエリは検索テキストをエンベディングし、SQLプリフィルターを使ってベクター+全文検索を実行し、リランキングします。CohereとLanceDBは両フローに登場しますが、それぞれ異なる処理を行います。リランクがインジェストパスに触れない理由はここにあります。
パイプラインは3つのスクリプトで実行されます:scrape.py、index.py、search.py。その他6つのヘルパー:lib.py(共有検索バックエンド)、compare.py(モード比較)、eval.py(precision@3)、stats.py(データセット概要)、versions.py(スナップショットブラウザ)、app.py(Streamlit UI)。
Bright DataでLinkedInをスクレイピングする
LinkedInは求人データの主要ソースですが、レート制限・動的マークアップ・予告なく変更されるHTMLにより、安定したスクレイピングは困難です。Web Scraper APIはビルド済みエンドポイントからクリーンな構造化JSONを返すため、パーサーのメンテナンスが不要です。
適切なエンドポイントを選択する
Bright DataはいくつかのLinkedInスクレイパーを提供しています:
- 人物プロフィール → 個人メンバープロフィール
- 企業情報 → 企業ページ
- 求人情報 → URLで収集 → 既に持っている特定の求人URL
- 求人情報 → キーワードで発見 ← これを使用
- 求人情報 → URLで発見 → 検索結果URLからの求人
- LinkedIn投稿と人物検索 → その他のエンティティタイプ
キーワードで発見は、検索クエリから求人を一括発見したいため最適です。1回のAPI呼び出しで、キーワードごとに最大1,000件の構造化求人票(タイトル・企業・所在地・シニアリティ・雇用形態・給与範囲・求人説明全文を含む)を返します。
各スクレイパーには固有のdataset_idがあります。見つけるには、Bright Dataのスクレイパーライブラリを開き、サイト(ここではlinkedin.com)を検索して開きます。求人情報 → キーワードで発見エンドポイントを選択すると、dataset_id(gd_lpfll7v5hcqtkxl6l)とすぐに実行できるリクエストがコード例パネルに表示されます。有効なトークンがあればscrape.pyから呼び出せます。
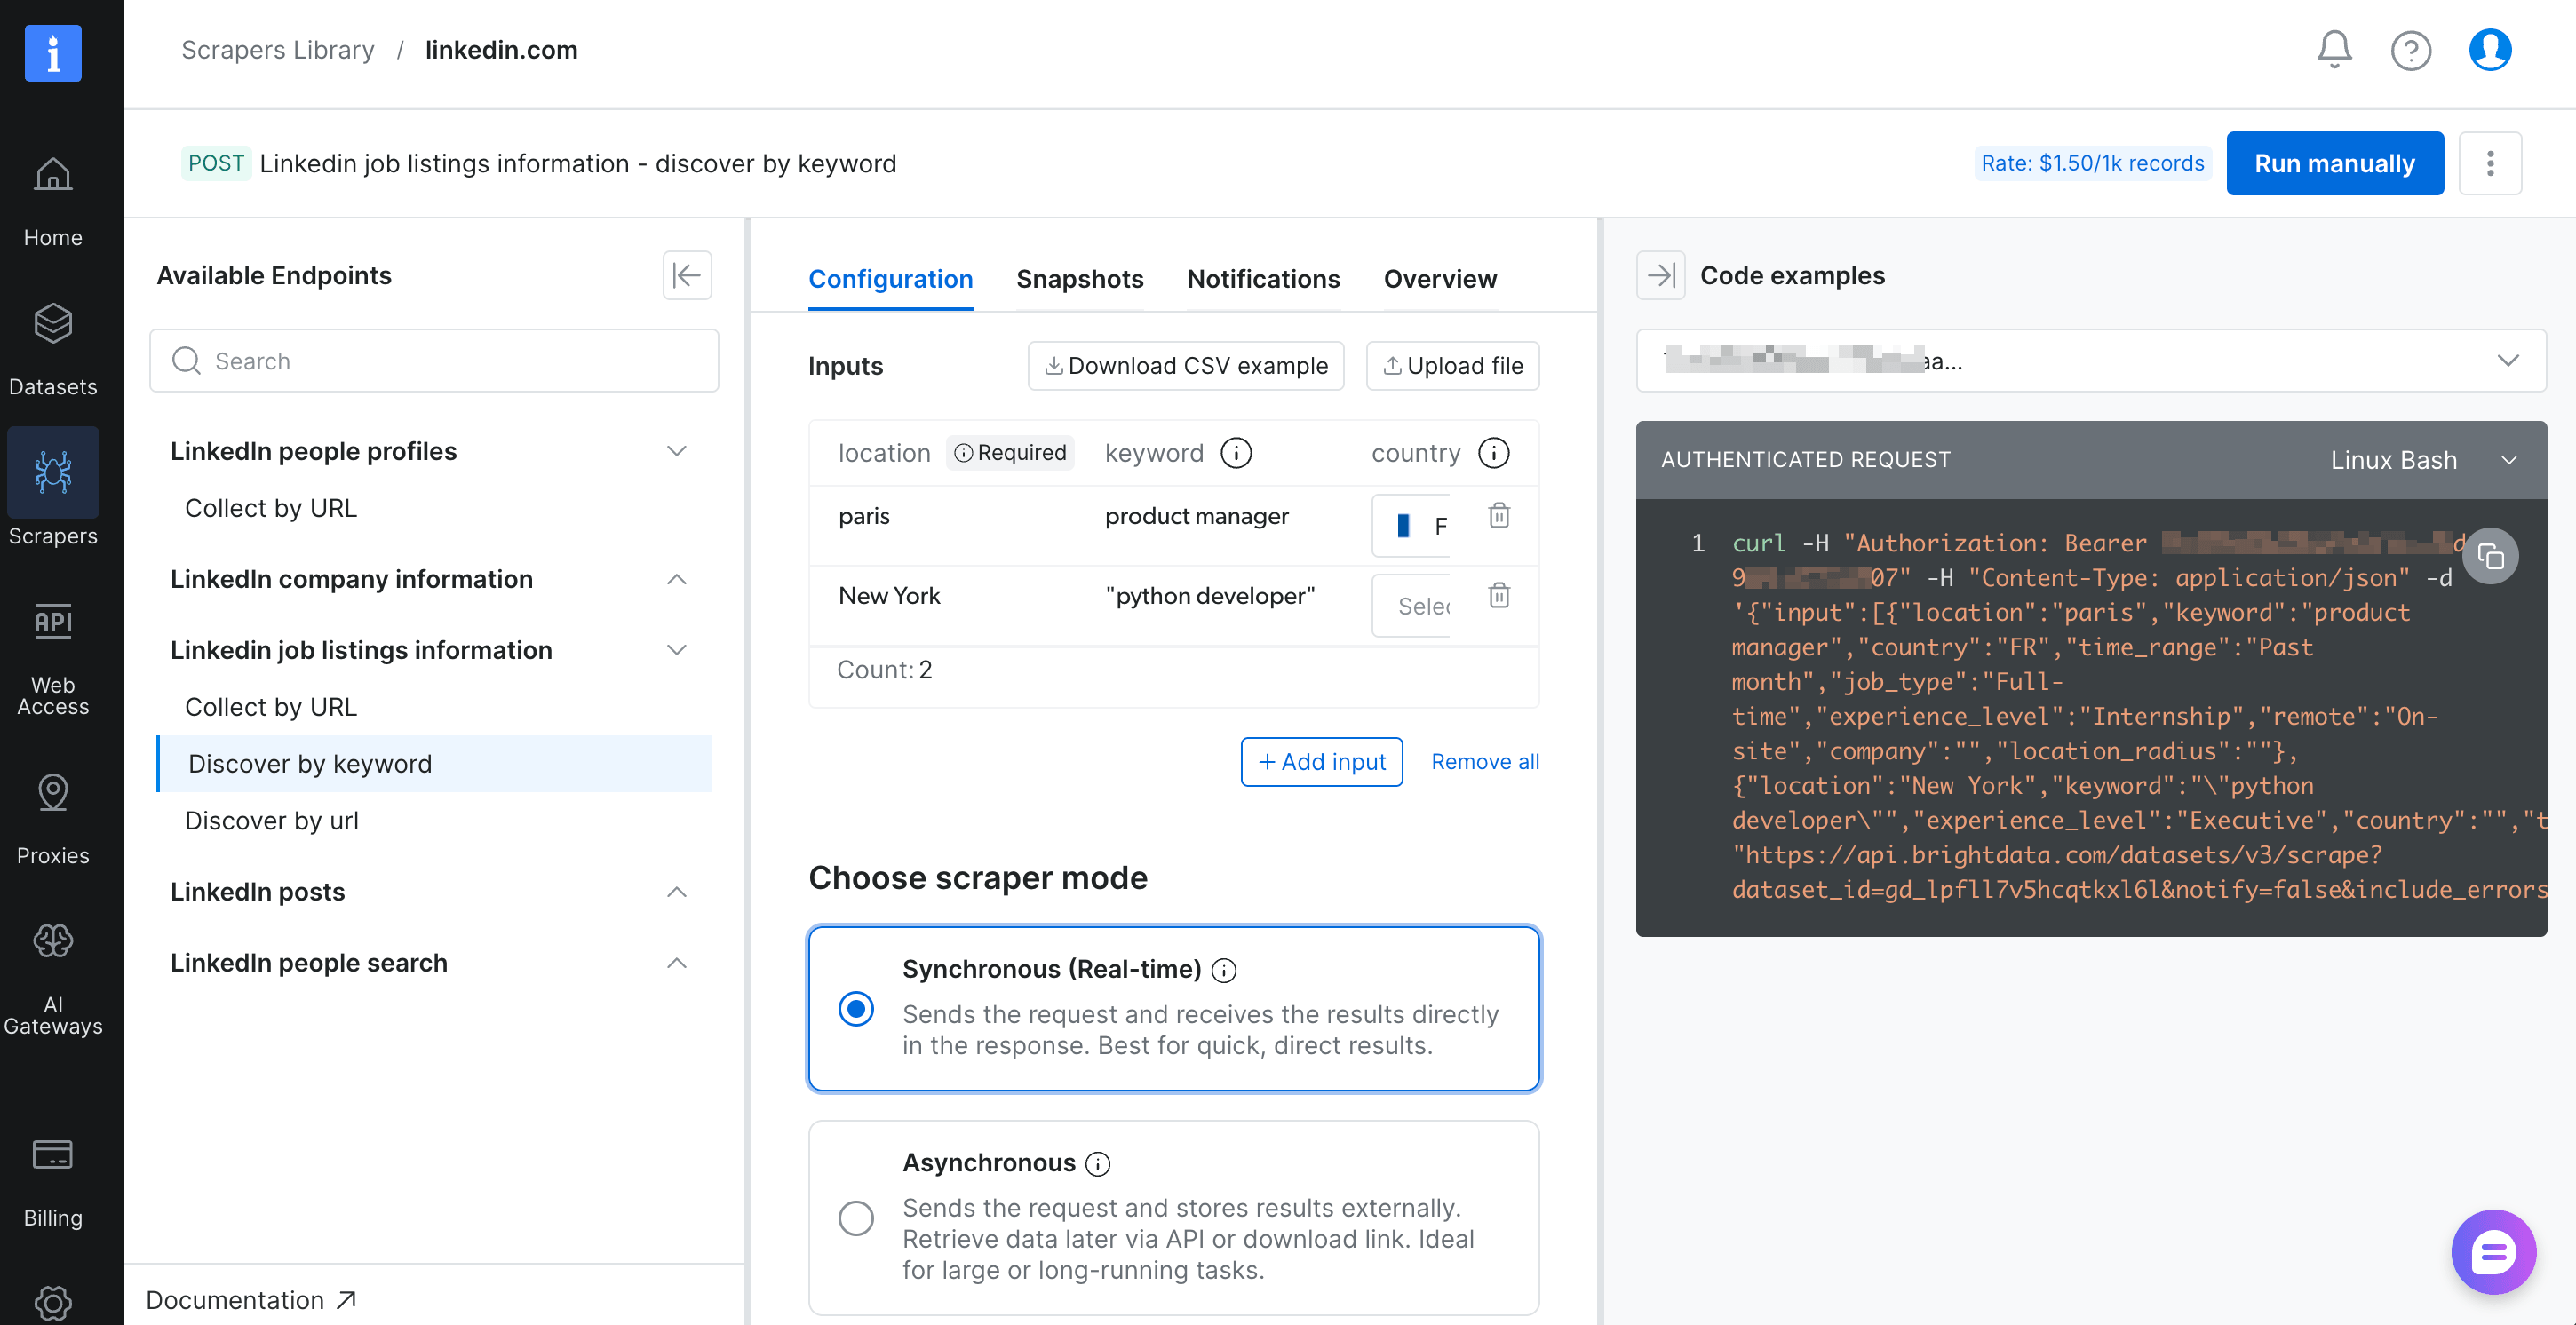
「キーワードで発見」スクレイパーページ。右のCode examplesパネルにdataset_idがあります。
同期 vs 非同期
Bright Dataは2つの配信モードを提供しています:
- 同期(
POST /datasets/v3/scrape)はデータをインラインで返します。小さなバッチに最適です。 - 非同期(
POST /datasets/v3/trigger)はスナップショットIDを返します。完了をポーリングして結果をダウンロードします。大きなバッチに最適です。
今回の実行では、応答時間は入力ごとに平均約6秒でした。limit_per_input=100で2キーワード(合計200件)の場合、同期呼び出しはバッチ全体の接続を保持する必要があり、タイムアウトのリスクがあります。非同期が安全なデフォルトです。
入力ごとの制限でコストを管理する
クエリパラメーターlimit_per_input=Nは各入力検索が返す結果数を制限します。予測可能な支出のための正確なコントロールです:
2キーワード × 100件 × $0.0015 = 1回の実行で$0.30大規模な実行では最大キーワードあたり1,000件まで増やせます。
コード
スクレイパーはスナップショットをトリガーし、準備完了までポーリングし、JSONをダウンロードします。コアは以下の通りです(本番環境ではリトライ・バックオフとより豊富なエラーハンドリングを追加してください):
# scrape.py
import json, time, sys
from pathlib import Path
import requests
from lib import require_env

BD_TOKEN = require_env("BRIGHTDATA_API_TOKEN")
DATASET_ID = "gd_lpfll7v5hcqtkxl6l"  # LinkedIn jobs - discover by keyword
LIMIT_PER_INPUT = 100

SEARCHES = [
    {"location": "San Francisco", "keyword": "machine learning engineer",
     "country": "US", "time_range": "Past month", "job_type": "Full-time",
     "experience_level": "", "remote": "", "company": "", "location_radius": ""},
    {"location": "New York", "keyword": "python developer",
     "country": "US", "time_range": "Past month", "job_type": "Full-time",
     "experience_level": "", "remote": "", "company": "", "location_radius": ""},
]

API = "https://api.brightdata.com/datasets/v3"
HEADERS = {"Authorization": f"Bearer {BD_TOKEN}", "Content-Type": "application/json"}

def trigger_snapshot() -> str:
    r = requests.post(f"{API}/trigger", headers=HEADERS, json={"input": SEARCHES},
        params={"dataset_id": DATASET_ID, "type": "discover_new",
                "discover_by": "keyword", "include_errors": "true",
                "limit_per_input": str(LIMIT_PER_INPUT)})
    r.raise_for_status()
    return r.json()["snapshot_id"]

def wait_until_ready(snapshot_id: str) -> None:
    while True:
        status = requests.get(f"{API}/progress/{snapshot_id}", headers=HEADERS).json()["status"]
        if status == "ready": return
        if status == "failed": raise RuntimeError("snapshot failed")
        time.sleep(10)

def download(snapshot_id: str) -> list[dict]:
    return requests.get(f"{API}/snapshot/{snapshot_id}",
                        headers=HEADERS, params={"format": "json"}).json()
実行時:
$ python scrape.py
→ scraping 2 keyword searches, max 100 jobs each
  estimated max cost: $0.30 (at $0.0015/record × 200 max records)
  triggered snapshot: sd_mojicp6g39xwbwqn2
  status: ready
✓ saved 204 jobs → data/raw_jobs.json
  actual cost: $0.31
返ってくるデータ
JSONの各求人には25以上のフィールドがあります。重要なものは以下の通りです:
{
  "job_posting_id": "<id>",
  "job_title": "Associate Machine Learning Engineer",
  "company_name": "ExampleCo",
  "job_location": "San Francisco, CA",
  "job_seniority_level": "Entry level",
  "job_employment_type": "Full-time",
  "job_industries": "Software Development",
  "job_summary": "About ExampleCo. ExampleCo is the career network for the AI economy...",
  "base_salary": {
    "min_amount": 115000,
    "max_amount": 144000,
    "currency": "$",
    "payment_period": "yr"
  },
  "job_posted_date": "2026-04-25T03:41:21.072Z",
  "url": "https://www.linkedin.com/jobs/view/<id>"
}構造化されたbase_salaryフィールドが、次のステップで給与フィルタークエリを可能にします。
CohereとLanceDBでインデックスを構築する
204件の生の求人レコードがあり、そのうち4件はロード時にフィルタリングするエラー行です。残りの200件をセマンティック検索可能にします。
Cohereを選ぶ理由
代替手段(OpenAIのエンベディングモデル、Voyage AI、ローカルのsentence-transformers)よりCohereを選んだ理由:
- 非対称エンコーディング。 Cohereではインデックス時に
search_document、検索時にsearch_queryとしてタグ付けできます。モデルは各側を異なる方法でエンコードするため、両方を同じように扱うよりも良い結果が得られます。 - 宣言的エンベディング。 LanceDBのレジストリはCohereをネイティブにサポート(OpenAIやsentence-transformersと同様)するため、挿入とクエリ時に手動の
embed()呼び出しなしでエンベディングが実行されます。 - Rerank API。 クエリと候補リストを受け取り、実際の関連性に基づいて候補を並び替える別のモデルです。ハイブリッドパイプラインのランキングを改善できる第2段階で、1回の
.rerank()呼び出しで追加できます。
LanceDBエンベディングレジストリ
LanceDBのエンベディングはエンベディングレジストリを通じて処理されます。スキーマを1度宣言すれば、すべての挿入とクエリで適切なinput_typeでエンベディングが自動的に実行されます。
# index.py
import lancedb
from lancedb.embeddings import get_registry
from lancedb.pydantic import LanceModel, Vector

cohere = get_registry().get("cohere").create(
    name="embed-english-v3.0",
    api_key=COHERE_API_KEY,
)

class Job(LanceModel):
    text: str = cohere.SourceField()              # ← エンベディング対象
    vector: Vector(cohere.ndims()) = cohere.VectorField()  # ← 保存されるエンベディング
    job_id: str
    title: str
    company: str
    location: str
    country_code: str
    seniority: str
    employment_type: str
    job_function: str
    industry: str
    posted_date: str
    apply_url: str
    search_keyword: str
    salary_min_annual: float
    salary_max_annual: float
    salary_currency: str
    salary_display: str
description_snippet: strvector以降はすべてプレーンな保存カラムで、フィルタリングと表示に使用されます。
給与正規化のトリック
ほとんどの求人は年収で給与が記載されていますが、一部は時給です。salary_min_annual >= 200000を一貫して機能させるため、インジェスト時に正規化します:
HOURS_PER_YEAR = 2080

def _normalize_salary(base):
    if not base:
        return 0.0, 0.0, "", ""
    lo = float(base.get("min_amount") or 0)
    hi = float(base.get("max_amount") or 0)
    if (base.get("payment_period") or "").lower() == "hr":
        lo *= HOURS_PER_YEAR
        hi *= HOURS_PER_YEAR
    currency = base.get("currency") or ""
    display = f"{currency}{int(lo):,}–{currency}{int(hi):,}/yr" if (lo and hi) else ""
    return lo, hi, currency, display
生の数値(フィルター用)と人間が読みやすい表示文字列(UI用)の両方を保存します。
アップサートによる増分更新
index.pyの初回実行でテーブルが作成されます。以降の実行はすべてjob_idをキーとしたアップサートです:
result = (
    table.merge_insert("job_id")
         .when_matched_update_all()       # 既存の求人票を更新
         .when_not_matched_insert_all()   # 新規発見の求人を追加
         .execute(rows)
)
print(f"inserted={result.num_inserted_rows}, updated={result.num_updated_rows}")
新しいBright Dataスクレイプからの求人は挿入され、再掲載された求人(同じjob_id)は給与・説明・タイムスタンプが更新されます。古い求人を完全に削除するには.when_not_matched_by_source_delete()をチェーンします。
アップサート全体は単一のアトミックトランザクションです。Lanceはコピーオンライトで列指向にデータを保存するため、再インジェストはテーブル全体の再構築ではなく増分書き込みになります。
高速SQLフィルターのためのスカラーインデックス
search.py, where "salary_min_annual >= 200000"を実行すると、LanceDBはベクタースキャンの前にフィルターを適用します(prefilter=True)。200行では即座に処理されます。200,000行では、インデックスの設定方法をLanceDBに伝えない限り、フィルターはカラム全体を走査します:
table.create_scalar_index("salary_min_annual", index_type="BTREE",  replace=True)
table.create_scalar_index("seniority",         index_type="BITMAP", replace=True)
table.create_scalar_index("search_keyword",    index_type="BITMAP", replace=True)
table.create_scalar_index("employment_type",   index_type="BITMAP", replace=True)
2種類のインデックスで必要な処理をカバーします:
- BTREEはソート可能な高カーディナリティのカラムに使用。
salary_min_annualは範囲クエリ(>=、BETWEEN)に適しています。 - BITMAPは低カーディナリティの列挙型に使用。
seniorityは約6種類の値、employment_typeはほぼ全てFull-time、search_keywordはスクレイプ入力の2つのうちの1つです。各値にビットマップが作成され、=フィルターは単一のビット単位ANDになります。
両方ともreplace=Trueで実行されるため、index.pyを再実行するとべき等に再構築されます。呼び出し後、table.list_indices()は全5件(4つのスカラー+FTSインデックス)を報告します:
text_idx               type=FTS      columns=['text']
salary_min_annual_idx  type=BTree    columns=['salary_min_annual']
seniority_idx          type=Bitmap   columns=['seniority']
search_keyword_idx     type=Bitmap   columns=['search_keyword']
employment_type_idx    type=Bitmap   columns=['employment_type']
インデックスされたデータを確認する
python index.pyを実行後、補助スクリプトstats.pyでデータベースの内容を確認できます:
$ python stats.py

📊 LanceDB · table 'jobs'  ·  200 rows

by source keyword
  machine learning engineer  ████████████████████ 100
  python developer           ████████████████████ 100

by seniority
  Mid-Senior level  ████████████████████ 99
  Entry level       ████████████ 62
  Not Applicable    ████ 20
  Internship        ██ 14
  Associate          4
  Director           1

salary coverage: 43/200 jobs (22%)
  min  $   65,000
  med  $  150,000
  max  $1,000,000

  highest-paying jobs:
    • Quantitative Developer (Python)                  Fintal Partners       $400,000–$1,000,000/yr
    • Machine Learning Engineer                        Mercor                $130,000–$500,000/yr
    • Data Scientist                                   Triumph               $200,000–$400,000/yr
    • Senior Python Developer (Middle Office Tech)     Quantitative Systems  $200,000–$400,000/yr
    • ML Engineer (Infra & Distributed training)       techire ai            $250,000–$400,000/yr

top hiring companies (top 10)
  Turing          ████████████████████ 7
  Handshake       █████████████████ 6
  OpenAI          █████████████████ 6
  Meta            █████████████████ 6
  Jack & Jill     ██████████████ 5
  DataAnnotation  ██████████████ 5
  Catalyst Labs   ███████████ 4
  Notion          ███████████ 4
  LangChain       ███████████ 4
  Uber            ████████ 3
リランキング付きハイブリッド検索を実行する
LanceDBは3つの検索モードをサポートしており、lib.pyは単一の関数でこれら全てを公開しています:
# lib.py
from lancedb.rerankers import CohereReranker

reranker = CohereReranker(model_name="rerank-v3.5")  # 固定; Cohereの新しいモデルはrerank-v4.0

def search(query: str, mode: str = "hybrid", limit: int = 10, where: str | None = None):
    table = _table()
    if mode == "vector":
        q = table.search(query, query_type="vector")
    elif mode == "keyword":
        q = table.search(query, query_type="fts")
    elif mode == "hybrid":
        q = table.search(query, query_type="hybrid").rerank(reranker=reranker)
    if where:
        q = q.where(where, prefilter=True)
return q.limit(limit).to_pandas()search()の3つの要素について説明します:
query_type="hybrid"はベクター類似度と、インデックス構築時に作成した全文インデックス(LanceDBネイティブFTS)のBM25スコアを組み合わせます。候補のユニオンがリランキングされます。.rerank(reranker)は候補リストをCohereのRerank APIに送信し、その順序付けを返します。LanceDBのデフォルトが古いため、model_name="rerank-v3.5"を明示的に渡しています。prefilter=TrueはSQLWHERE句をベクタースキャンの後ではなく前に適用します。これにより高速(検索空間が小さくなる)かつ正確(切り捨てによる結果の損失がない)になります。
実際のクエリ
データセット内のどの求人タイトルとも多くのリテラル単語を共有しないクエリの上位2件の結果を示します:
$ python search.py "deep learning model training with GPUs"

  ▸ Training: ML Framework Engineer  ·  score 0.275
    OpenAI — San Francisco, CA
    Entry level · Full-time · 2026-04-22
    "About The Team Training Runtime designs the core distributed
     machine-learning training runtime that powers everything from early
     research experiments to frontier-scale model runs..."

  ▸ Machine Learning Engineer  ·  score 0.138
    Skild AI — San Mateo, CA
    Entry level · Full-time · 2026-04-15
    "Company Overview At Skild AI, we are building the world's first
     general purpose robotic intelligence that is robust and adapts to
     unseen scenarios without failing. We believe massive scale through
     data-driven machine learning..."
どちらの求人タイトルにも「GPU」という言葉は含まれていませんが、両方の説明は分散MLトレーニングに関するもので、クエリが求めている内容です。純粋なキーワード検索では両方とも見逃す可能性が高いです。
各モードは異なる種類のスコアを返します。ベクターモードはコサイン距離(低いほど近い)、ハイブリッド+リランクはCohereの関連性スコア(0から1、高いほど良い)、キーワードモードは生のBM25(無制限、高いほどキーワードの重複が多い)を返します。数値はモード間で比較できません。同一モード内のみで比較可能です。
セマンティクスとハード制約を組み合わせる
LanceDBでは、セマンティック類似度とSQLフィルターを1つのクエリで組み合わせられます:
$ python search.py "fintech python role with equity" \
    --where "salary_min_annual >= 250000"

  ▸ Quantitative Developer (Python)  ·  score 0.374
    Fintal Partners — New York, United States
    Mid-Senior level · Full-time · $400,000–$1,000,000/yr · 2026-04-22

  ▸ Senior Software Engineer (Python)  ·  score 0.272
    Fintal Partners — New York, NY
Mid-Senior level · Full-time · $250,000–$400,000/yr · 2026-04-23ベクター部分が説明的な部分(「fintechのpythonとエクイティ」)にマッチします。SQLフィルターが数値制約(>= $250k)を適用します。両方の結果は適切な給与帯のFintal Partners求人です。
同じハイブリッド+フィルターパターンがStreamlit UIでも実行されます(ライブ求人はCLI実行時とは異なります):
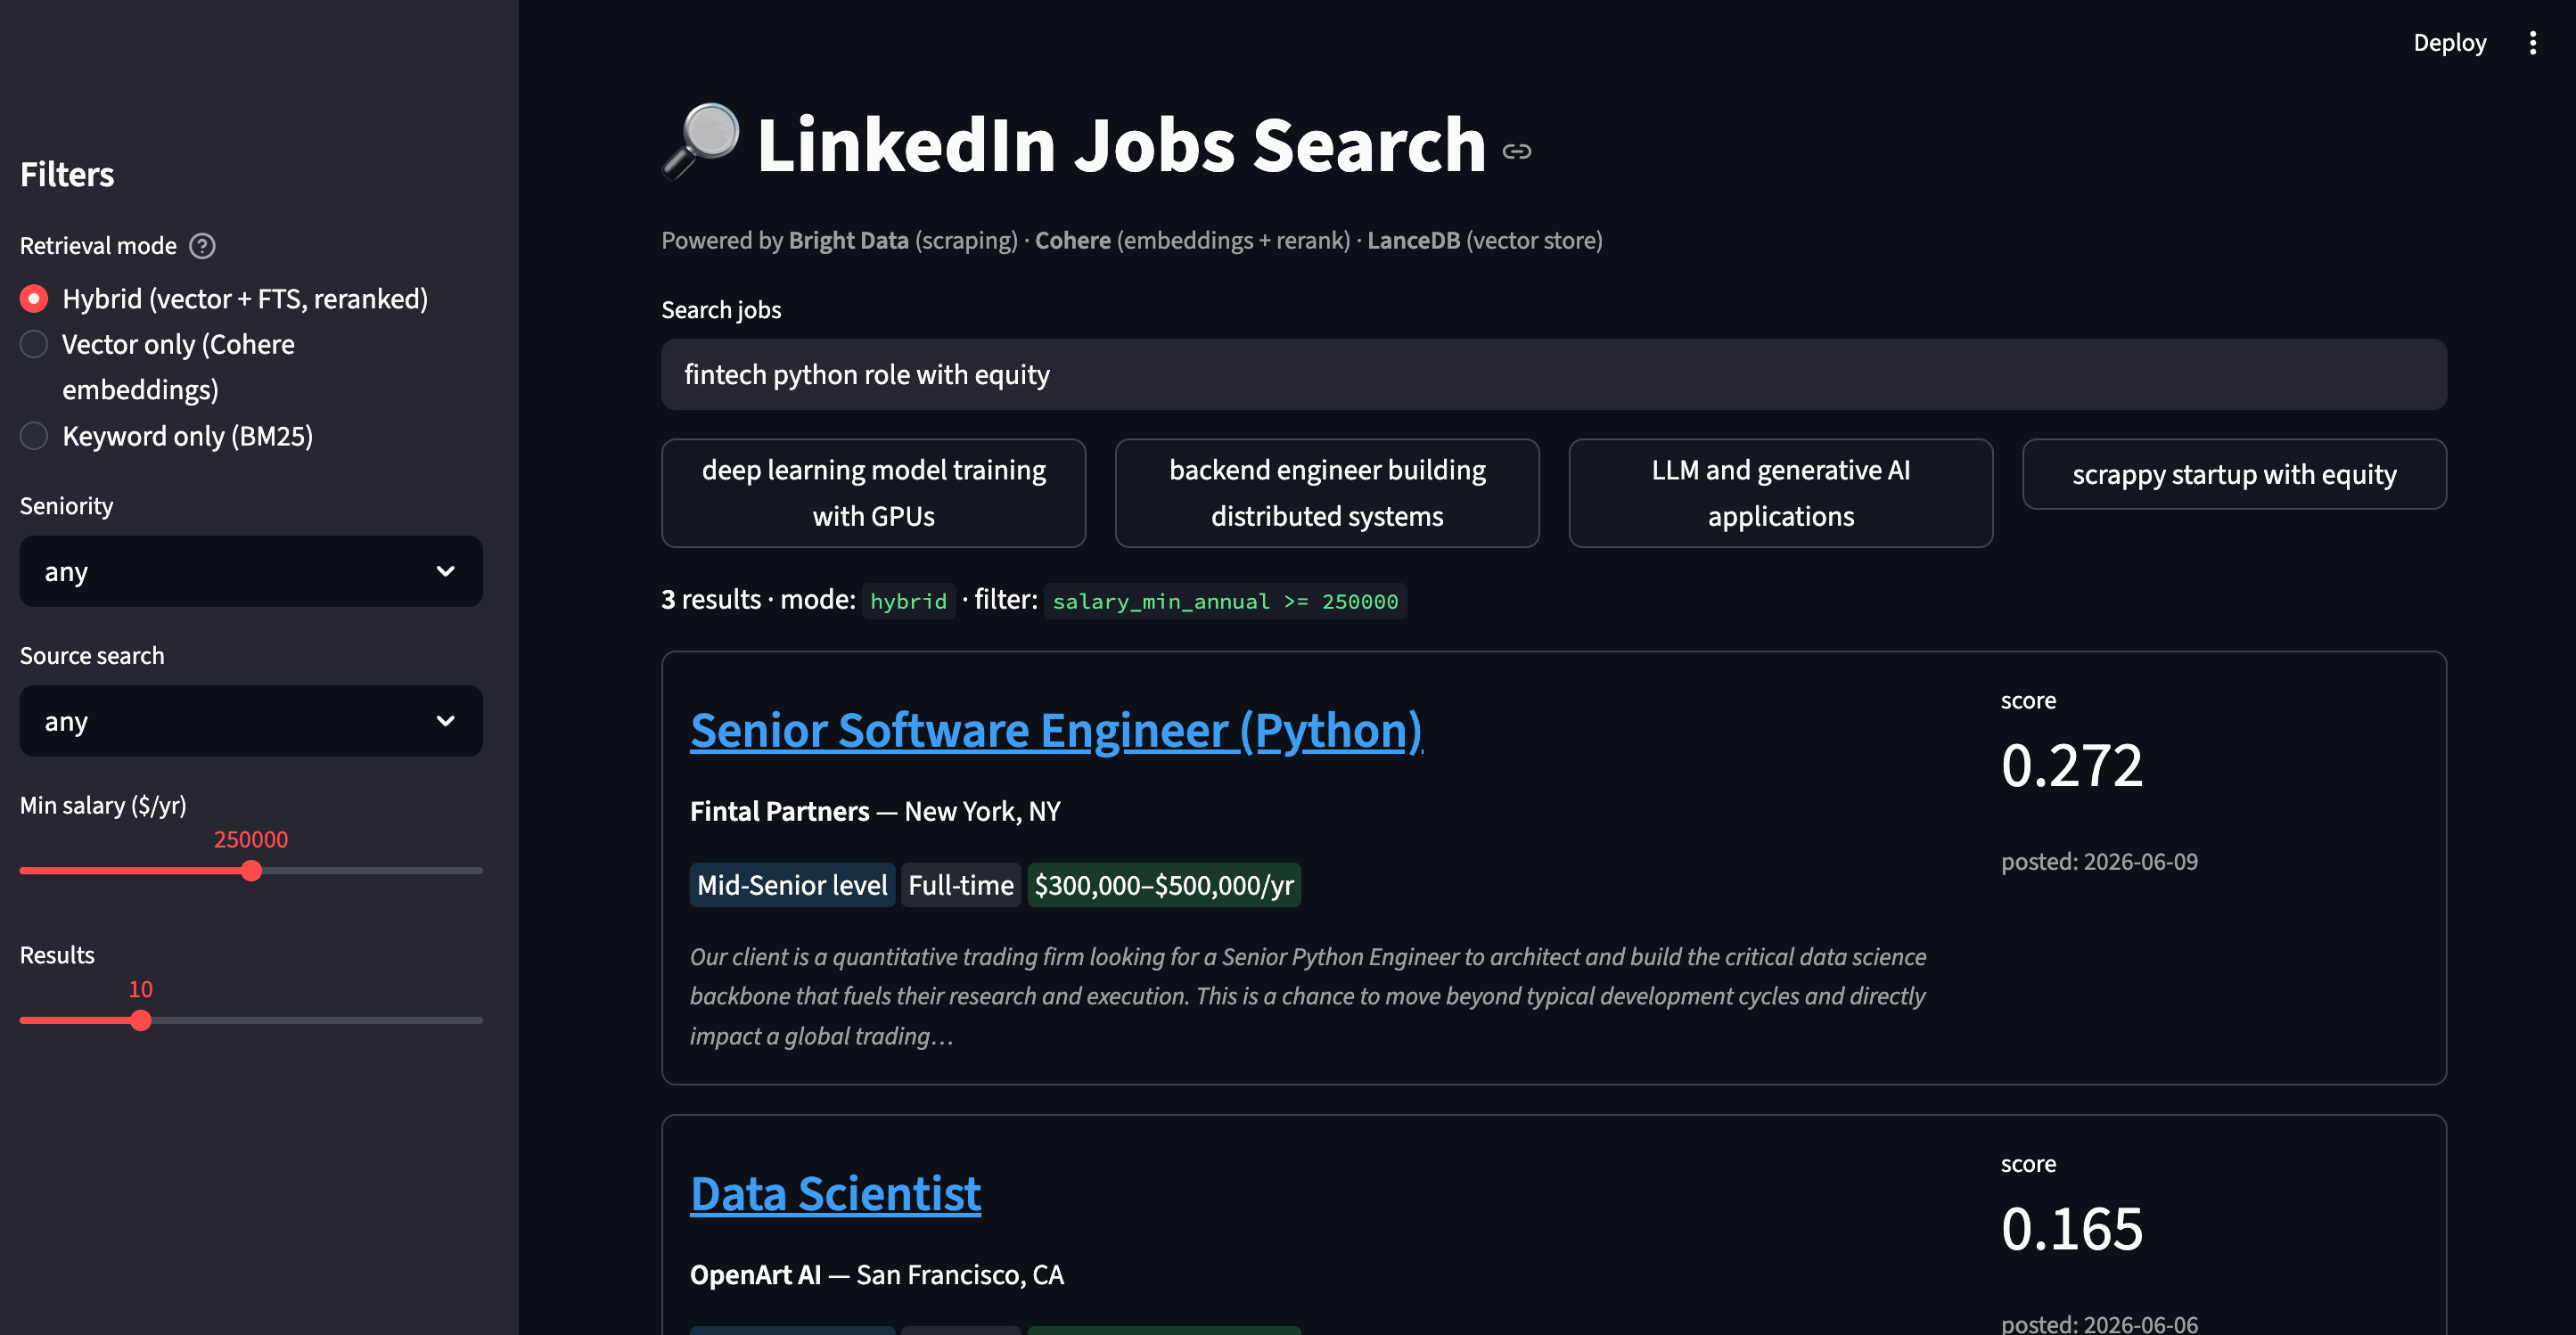 給与スライダーを設定した
app.pyからのハイブリッドクエリ。スライダーは緑色のフィルターバナーに表示されているsalary_min_annual >= 250000プリフィルターを生成します。
キーワード・ベクター・ハイブリッドが異なる結果を返す場合
compare.pyは同じクエリを3つのモード全てで実行し、並列レポートを出力します:
$ python compare.py "engineer working on LLMs and prompt engineering" --top 3

══════════════════════════════════════════════════════════════════════════
  query: engineer working on LLMs and prompt engineering
══════════════════════════════════════════════════════════════════════════

  ── keyword (BM25) ───────────────────────────────────────────────────────
  1. AI/ML Engineer                                          — Careerswift
  2. AI/ML Engineer                                          — Careerswift
  3. Applied AI Engineer                                     — Serval

  ── vector (Cohere) ──────────────────────────────────────────────────────
  1. Senior Software Engineer (Prompt Engineer Python/GenAI)        — Genpact
  2. 15+ Years exp/ Need f2f/ AI/ML Engineer or Python AI Engi...   — Jobs via Dice
  3. ML Engineer (Infra & Distributed training)                     — techire ai

  ── hybrid + rerank ──────────────────────────────────────────────────────
  1. Applied AI Engineer                                     — Serval
  2. Senior Software Engineer (Prompt Engineer Python/GenAI) — Genpact
  3. AI/ML Engineer                                          — Careerswift

overlap: keyword∩vector=0/3 · hybrid∩vector=1/3 · hybrid∩keyword=2/3オーバーラップ行では、キーワードとベクターは上位3件で同じ求人を0件も見つけていません。異なる概念空間を検索しているのです。
- キーワード(BM25)は「LLM」と「prompt」というリテラルトークンが最も頻繁に出現する求人票を見つけます。汎用的なAI/MLタイトルを返します。
- ベクター(Cohere)はSenior Software Engineer (Prompt Engineer Python/GenAI)の求人を1位に見つけます。ユーザークエリが「prompt engineering」(動名詞)と言い、タイトルが「Prompt Engineer」(名詞)と言っているにもかかわらずです。また、クエリと語彙的には距離があるが強いセマンティックマッチであるJobs via DiceのLLM関連求人も返します。
- ハイブリッド+リランクはユニオンを取り、重複を削除し、Cohere Rerankで処理します。ServalのApplied AI Engineerの求人($200k〜$325k)が1位に上がります。その説明はプロンプトエンジニアリングとLLMエージェントの作業で密度が高いですが、タイトルも上位BM25重み付きタームもこの求人をここまで高くランク付けしなかったでしょう。
この特定のクエリでは、ベクターとハイブリッドの両方がキーワードより優れていました。生のトークン重複は、セマンティック関連性が示す位置よりもGenpactとServalの結果を低くランク付けしました。しかし、1つのクエリは逸話であり証拠ではありません。そのパターンが一般的に成立するかどうかは、実際の評価のみが答えられます。
precision@3で品質を測定する
適切に測定するために、eval.pyは10件の手書きクエリを3つのモード全てでスコアリングし、precision@3(上位3件の結果のうち透明なグラウンドトゥルース述語にマッチする割合)を計算します。
各クエリのグラウンドトゥルースは魔法の数字ではなくPython述語であるため、読者は同じ方法で結果を評価するかどうか判断できます。
「OpenAIの機械学習エンジニア」では、companyフィールドに「OpenAI」が含まれている場合のみ関連とみなします。「取引会社の量的開発者」では、ルールがより広くなります。タイトルに「Quant」または「Trading」が含まれているか、企業が既知の取引会社(Fintal Partners、DRW、Hudson River Trading、Tower Research、Mondrian Alpha)の場合に関連とみなします。これらの述語はサンプルデータセットに合わせて調整されているため、新しい求人ではスコアが変わります。独自のデータに合わせて再調整してください。モード間のギャップは正確なパーセンテージが変わっても持続します。
実行時:
$ python eval.py

precision@3 per query (hits/3)
────────────────────────────────────────────────────────────────────────
  query                                          keyword    vector     hybrid
────────────────────────────────────────────────────────────────────────
  machine learning engineer at OpenAI            1.00 (3/3)  1.00 (3/3)  1.00 (3/3)
  founding engineer at AI startup with equity    0.33 (1/3)  0.67 (2/3)  0.67 (2/3)
  prompt engineer working with LLMs              0.00 (0/3)  0.67 (2/3)  0.33 (1/3)
  quantitative developer at trading firm         0.67 (2/3)  1.00 (3/3)  1.00 (3/3)
  computer vision and robotics engineer          1.00 (3/3)  0.67 (2/3)  1.00 (3/3)
  data scientist role                            0.67 (2/3)  1.00 (3/3)  1.00 (3/3)
  distributed training infrastructure for ML     0.33 (1/3)  0.67 (2/3)  0.67 (2/3)
  backend engineer at AI company                 0.33 (1/3)  0.33 (1/3)  0.33 (1/3)
  python developer at fintech                    0.00 (0/3)  0.67 (2/3)  0.33 (1/3)
  high-paying machine learning role with equity  0.00 (0/3)  0.33 (1/3)  0.33 (1/3)
────────────────────────────────────────────────────────────────────────
  AVERAGE (10 queries)                           0.433       0.700       0.667
同じ数値をグラフで:
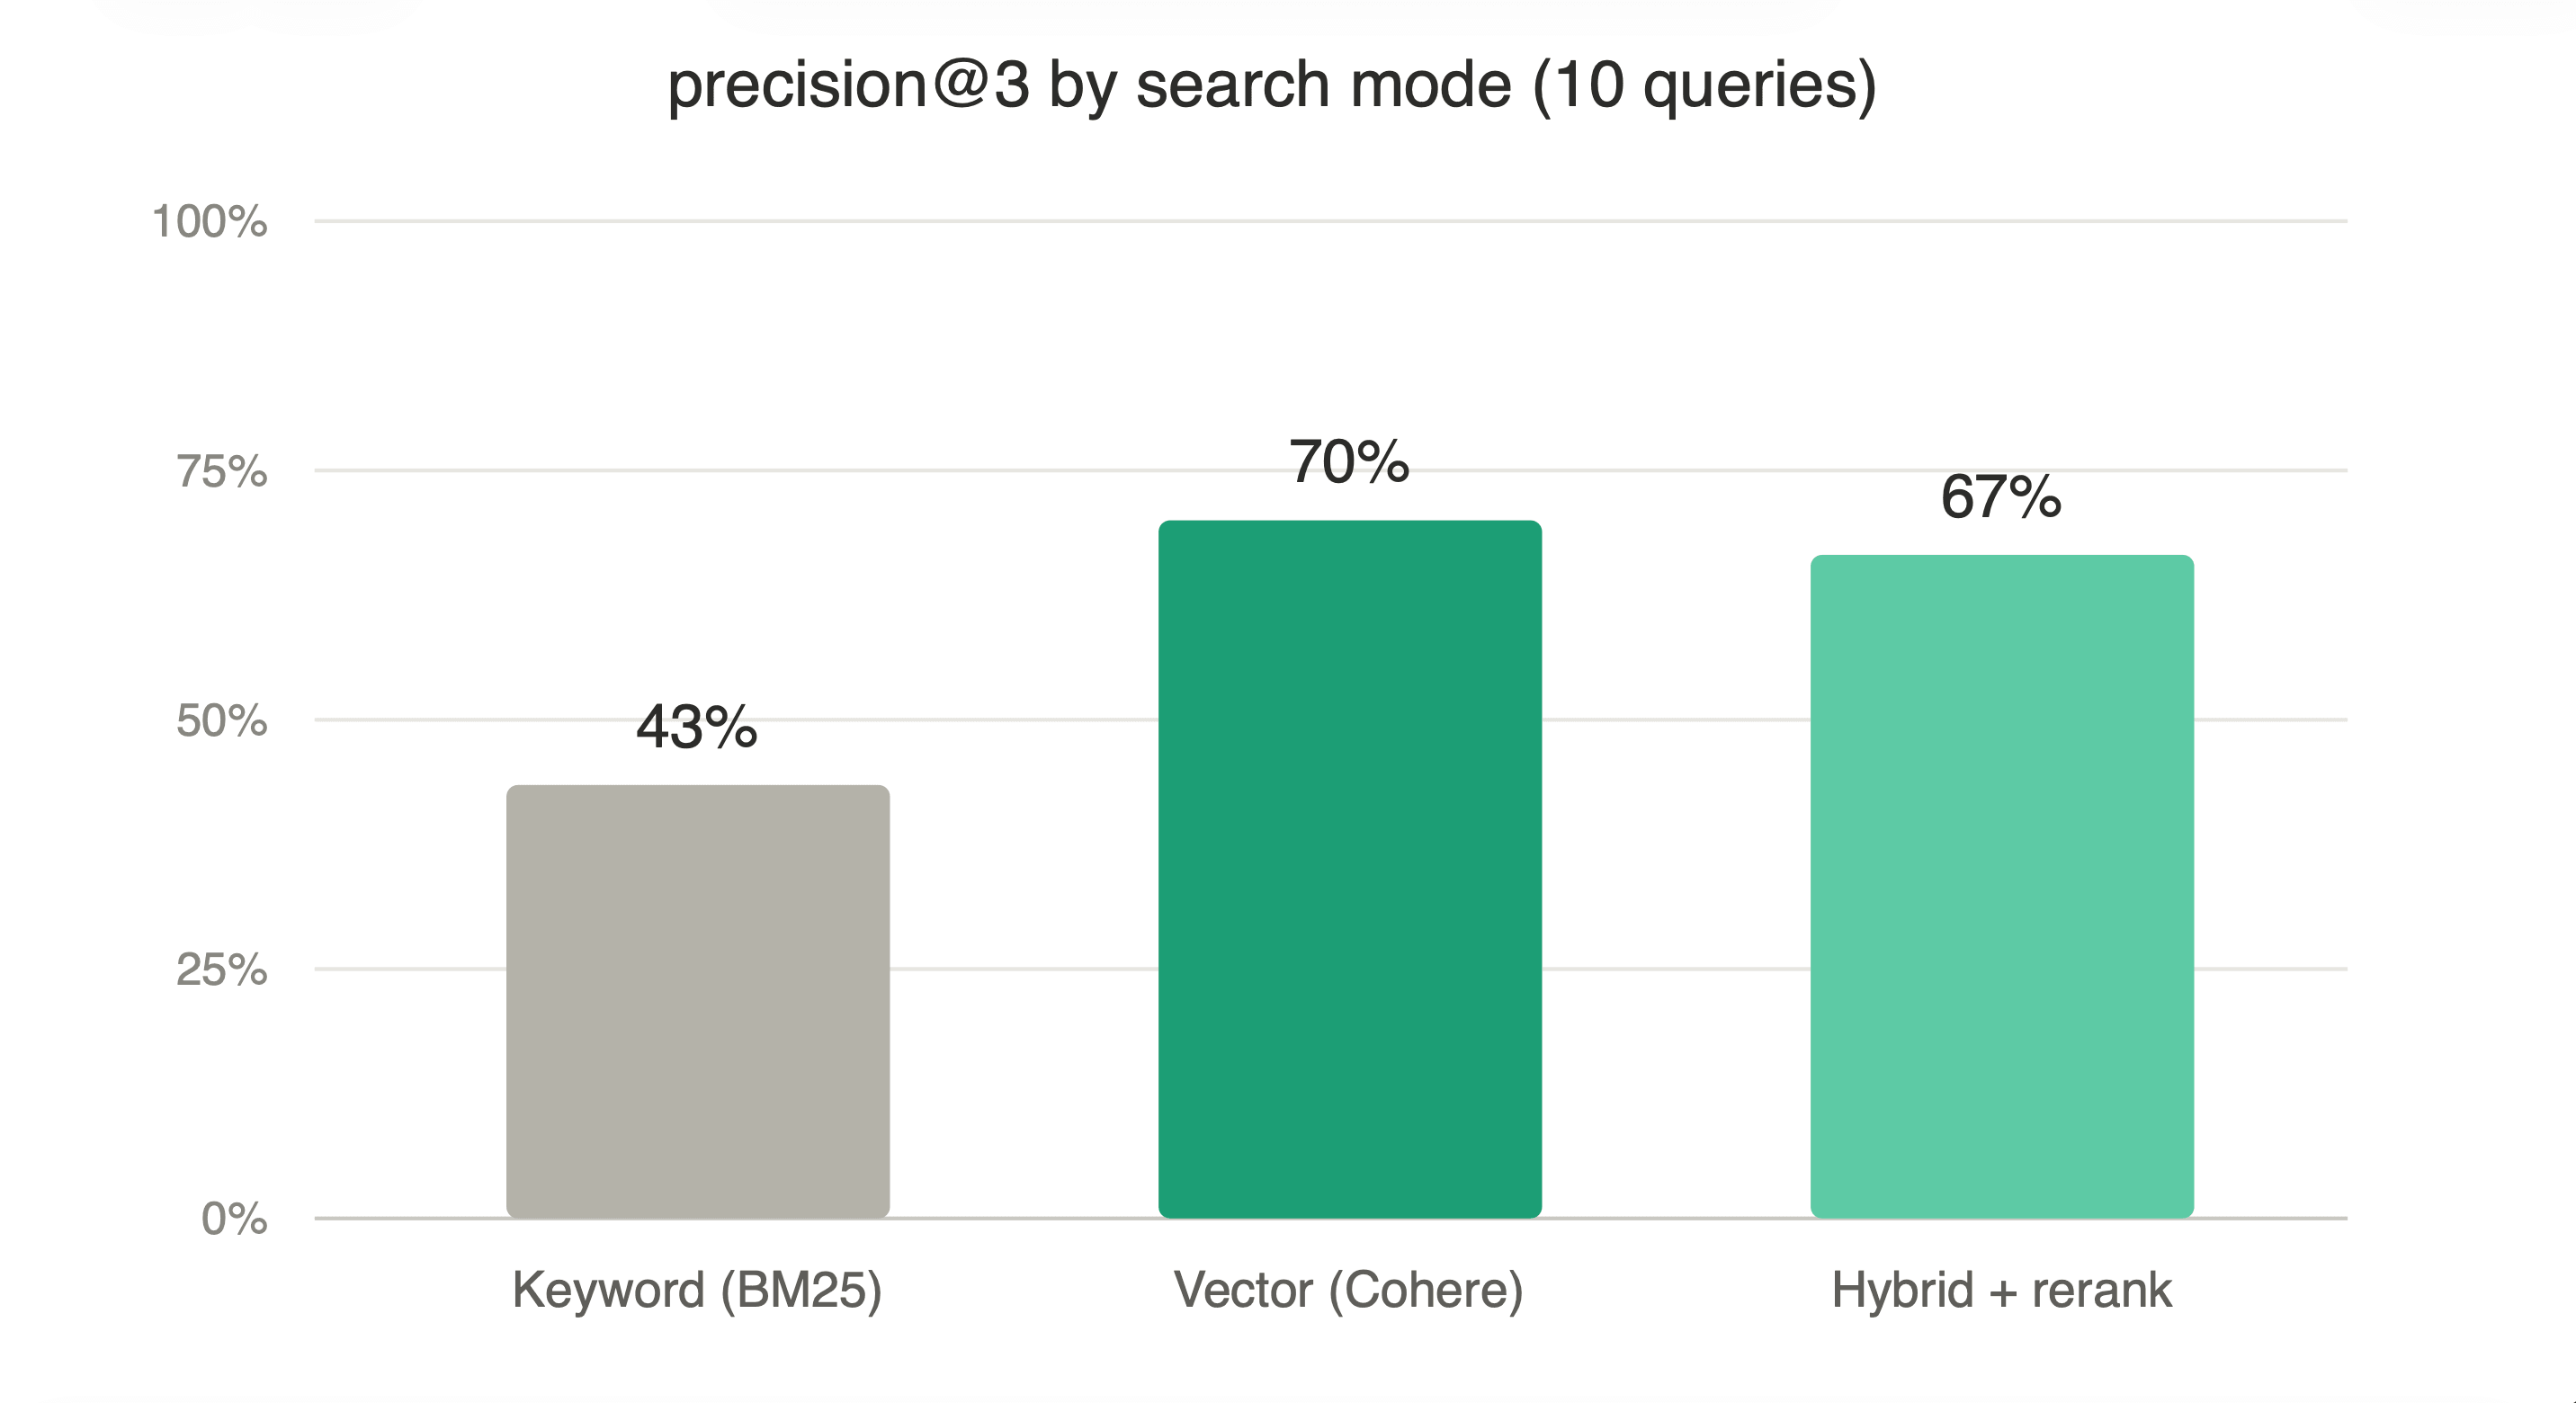
10件の評価クエリで平均したprecision@3。ベクターはキーワードを大きく上回り、ハイブリッドはベクターから数ポイント以内です。
数値が示すこと
表から:
- ベクター検索はキーワード検索を大きく上回りました(平均precision@3で70% vs 43%)。キーワードが0点だった3つのクエリ(「プロンプトエンジニア」、「fintechのpython開発者」、「エクイティ付き高給MLポジション」)はすべて、ベクター検索では少なくとも1件の関連ヒットがありました。
- ハイブリッド+リランクはこの規模ではベクターを上回りませんでした。 67% vs 70%のギャップはノイズの範囲内です。リランカーはクエリごとにCohere呼び出しを追加し、FTS半分は語彙的に近い候補を供給し、その後フィルタリングが必要になります。
- どのモードも完全に劣っているわけではありません。「コンピュータビジョンとロボティクス」は、関連企業の説明にリテラルのロボティクス用語が含まれているため、キーワード(1.00)がベクター(0.67)を上回る唯一のクエリです。
ハイブリッド+リランクを有効にする場合
いくつかの要因によります:
- 候補プールのサイズ。数百行ではベクター単体で十分なことが多いです。ハイブリッドの2段階検索はリランクステップのコストに見合うために、より大きなプール(1万件以上)が必要です。
- クエリタイプ。セマンティックな意図と特徴的なキーワード(ブランド名、特定の技術)の両方を持つクエリはハイブリッドから恩恵を受けます。純粋なセマンティッククエリは通常そうではありません。
- リランカーの品質。Cohereのrerank-v3.5は評価で良いパフォーマンスを示しました。別のリランカーに切り替える場合は、信頼する前に
eval.pyを再実行してください。弱いリランカーは小さな候補プールで良いベクター結果を下位に並び替える可能性があります。
独自のデータでeval.pyを実行して判断してください。クエリの追加は文字列とグラウンドトゥルース述語だけです。
注意:ハイブリッド評価は無料のCohereキーで問題なく実行されます。トライアルのレート制限により約15秒ではなく約90秒かかります。
StreamlitでWeb UIを追加する
Streamlitは同じ検索バックエンドをクリッカブルなWebアプリに変換します。検索とレンダリングのコアは以下の通りです:
# app.py
import streamlit as st
from lib import search

mode = st.sidebar.radio("Mode", ["hybrid", "vector", "keyword"])
seniority = st.sidebar.selectbox("Seniority", ["any", "Entry level", "Associate", "Mid-Senior level", "Director", "Internship", "Not Applicable"])
min_salary = st.sidebar.slider("Min salary ($/yr)", 0, 500_000, 0, step=10_000)

query = st.text_input("Search jobs", placeholder="e.g. remote ML engineer...")

if query:
    where_clauses = []
    if seniority != "any":
        where_clauses.append(f"seniority = '{seniority}'")
    if min_salary > 0:
        where_clauses.append(f"salary_min_annual >= {min_salary}")
    where = " AND ".join(where_clauses) or None

    df = search(query, mode=mode, where=where, limit=10)
    for _, row in df.iterrows():
        with st.container(border=True):
            st.markdown(f"### [{row['title']}]({row['apply_url']})")
            st.markdown(f"**{row['company']}** — {row['location']}")
            st.caption(row["description_snippet"] + "…")
実行:
streamlit run app.pylocalhost:8501で、検索ボックス・モード切替・シニアリティ/ソースキーワード/給与のサイドバーフィルター・バッジ/スコア/スニペットプレビュー付き結果カードを備えた完全な検索ページが表示されます。
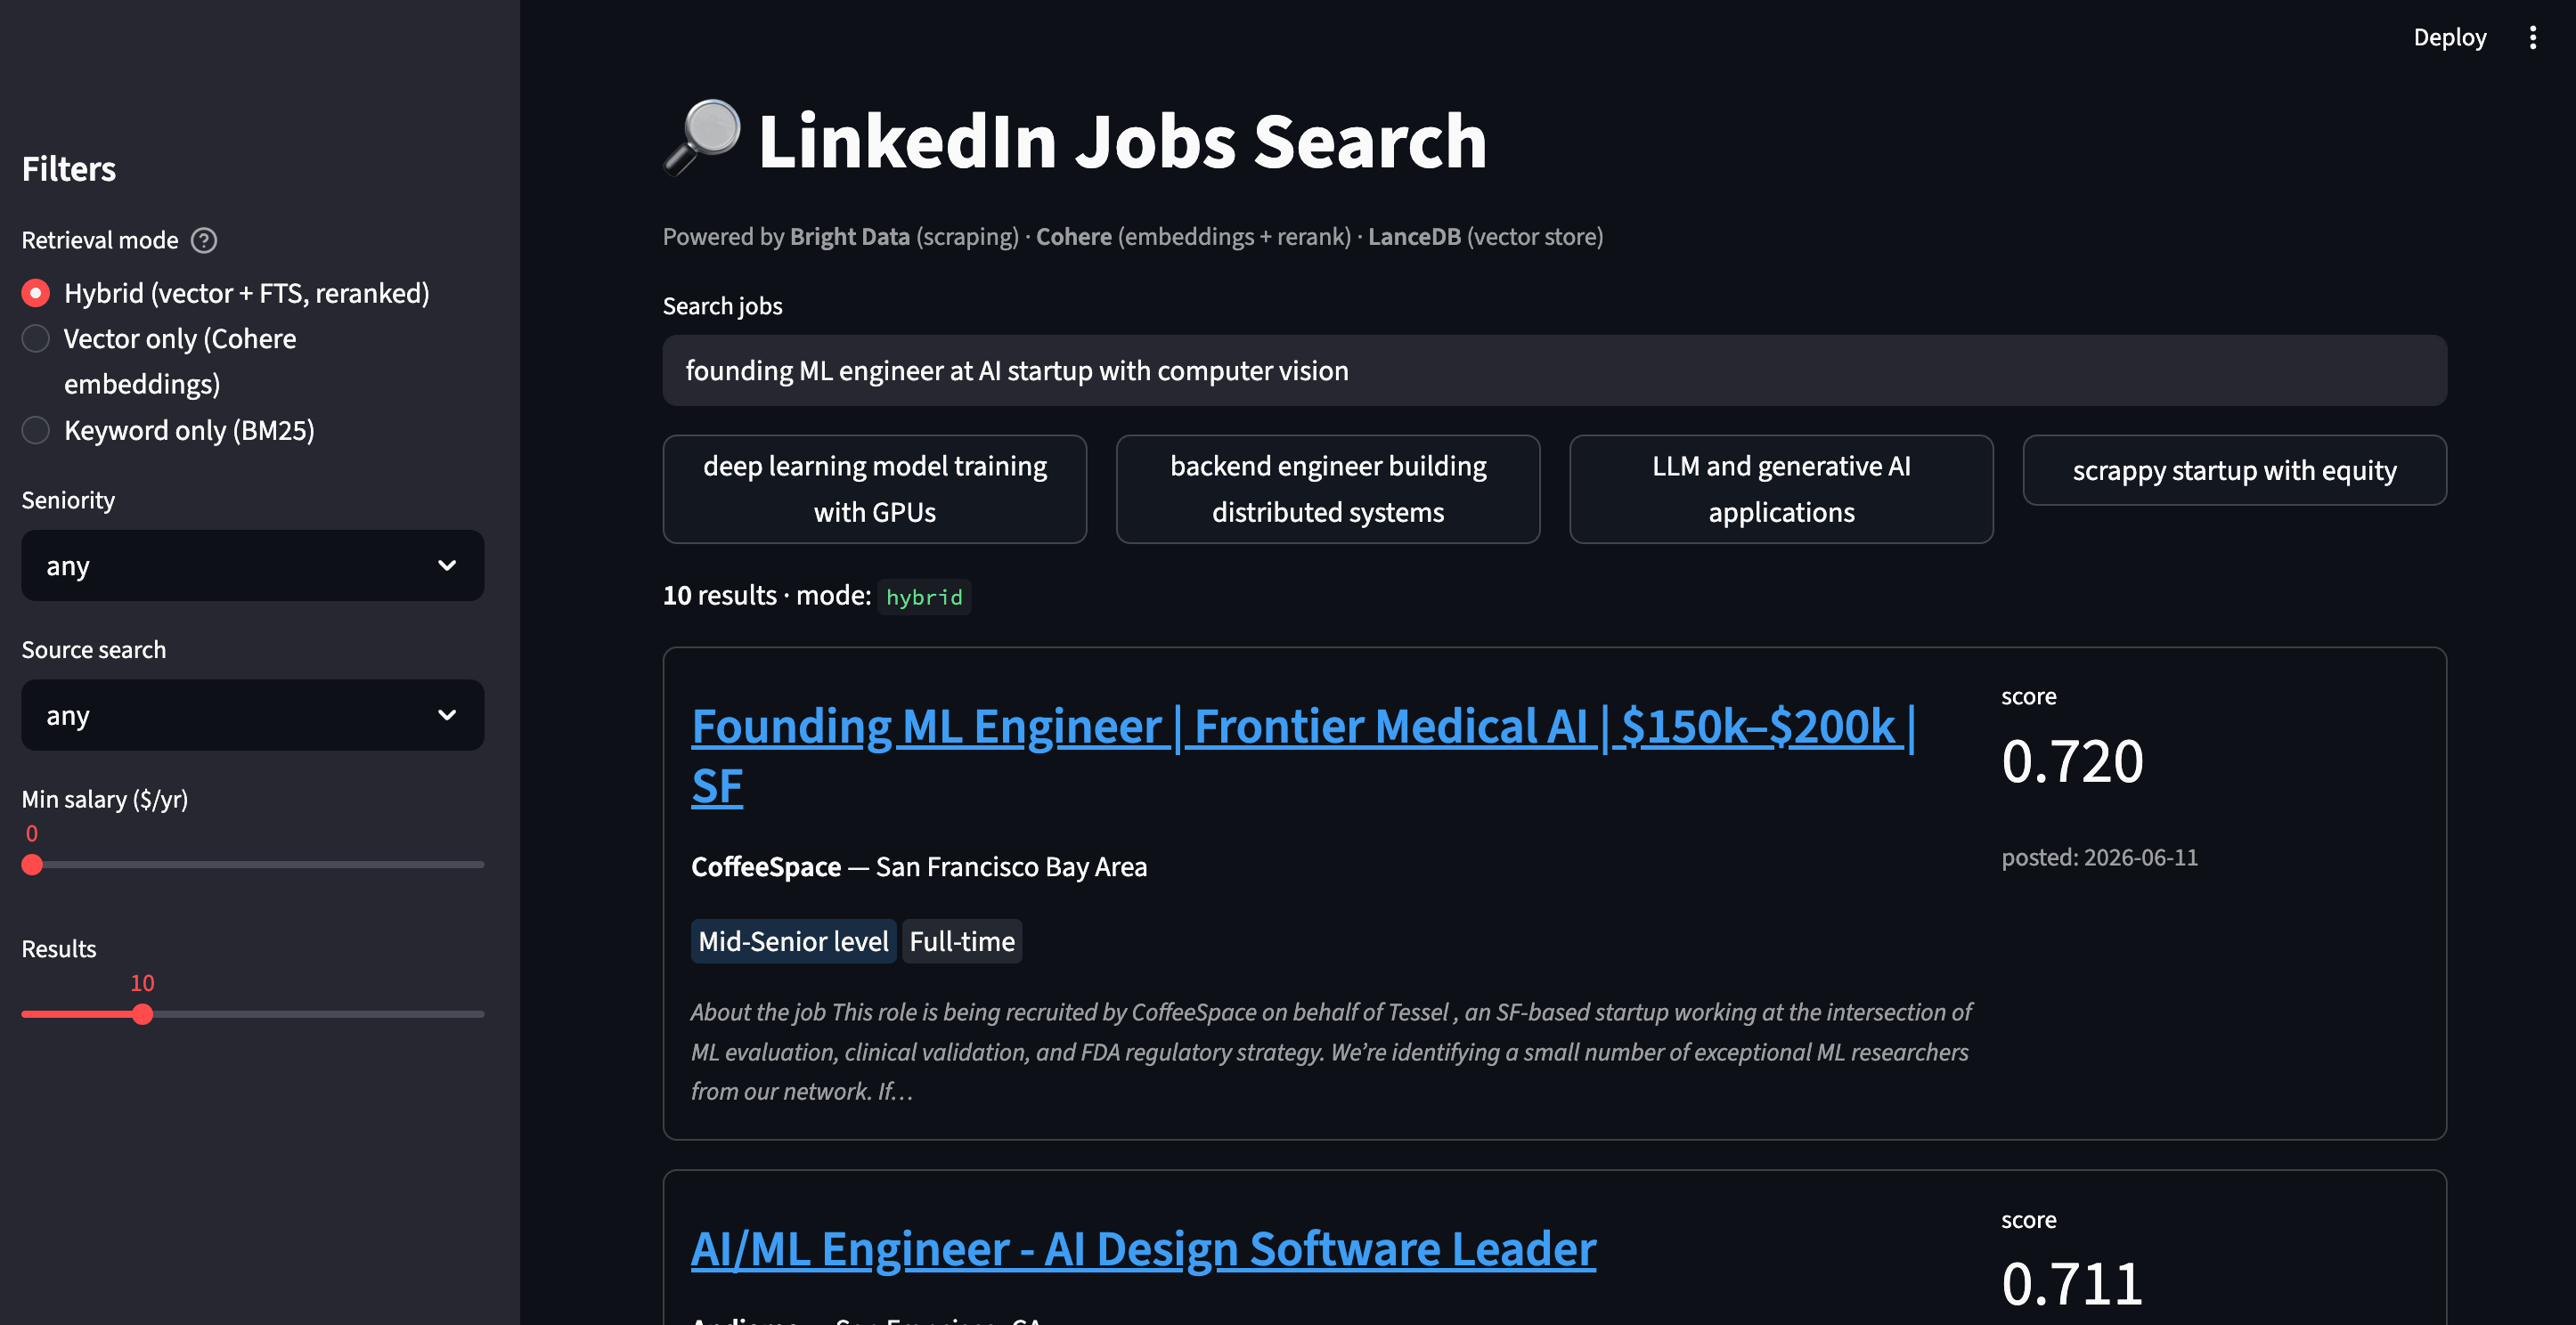
ハイブリッド検索を実行しているStreamlitアプリ。各カードのスコアバッジはCohereの関連性スコアで、バッジの下のスニペットは各結果が上位3件に入った理由を示しています。
LanceDBによる無料のタイムトラベル
検索とUIについては以上です。LanceDBにはもう1つ示す価値のある機能があります。LanceDBへの書き込みは毎回、追加コストやインフラなしに新しいバージョンを自動的に作成します。これが基盤となるLance列指向フォーマットの仕組みです。バージョンを後で簡単に見つけられるように、index.pyはインジェストごとにタグを付けます:
table.tags.create(f"ingest-{datetime.now():%Y-%m-%d-%H%M}", table.version)補助スクリプトversions.pyを使用すると、過去のスナップショットを閲覧して開くことができます。python index.pyを1回実行すると1つのタグが表示されます。2回目のインジェスト(例えば1週間後に再スクレイピング)後は2つ表示されます:
$ python versions.py

📊 table 'jobs'  ·  current version: 13  ·  200 rows

🏷  tags (2):
  • ingest-2026-05-20-0905           → version 7
  • ingest-2026-05-20-0906           → version 13  ← current

  travel back with: `python versions.py --tag <name>`

$ python versions.py --tag ingest-2026-05-20-0905

📌 snapshot 'ingest-2026-05-20-0905'  ·  version 7  ·  200 rows
  • Associate Machine Learning Engineer  — Handshake
  • Machine Learning Engineer            — RZR
• Machine Learning Engineer — ChatGPT Jobsタイムトラベルは1回のtable.checkout(tag_or_version)呼び出しです。求人検索プロダクトでは「先四半期に掲載された求人は?」や「給与分布は時間とともに変化しているか?」といった質問に、別の時系列データベースなしで答えられます。これがLanceDBを選んだ理由の1つです。
コストとスケール
デモ(200件の求人、約5件のサンプルクエリ)の場合:
| 項目 | コスト |
|---|---|
| Bright Dataスクレイプ(204件 @ $0.0015/件) | $0.31 |
| Cohereエンベディング(合計約228kトークン @ $0.10/1M) | ~$0.02 |
| Cohereリランク(約$0.002/クエリ、Rerank v3.5で$2/1k検索) | 5クエリで~$0.01 |
| LanceDB | 無料 |
エンドツーエンドのデモコストは合計約$0.34です。これらの価格は2026年時点のものですので、現在のプロバイダーの料金を確認してください。
スケールアップ
ローカルデモは200件の求人を扱います。ここから本番規模のデータセットへの道をカバーするいくつかのレバーがあります:
- より多くの求人。
LIMIT_PER_INPUTを変更(キーワードあたり最大1,000件)するか、キーワード検索を追加します。10,000件の求人はBright Dataクレジットで約$15です。 - より多くのキーワード/地域。
scrape.pyのSEARCHESリストにエントリを追加します。 - スケジュール更新。構築した
merge_insertアップサートにより、パイプラインを再実行すると変更された内容が更新されます。Bright Dataはダッシュボードからスケジュール収集と配信をサポートしています。アップサートと組み合わせると、自己更新データセットが完成します。 - ベクターインデックス。約1万行を超えたら、
table.create_index(vector_column_name="vector")でブルートフォース検索をHNSWまたはIVF_PQインデックスに切り替えます。デフォルトではCPUでビルドされます。GPUビルドにはPyTorch>2.0でaccelerator="cuda"(またはApple Siliconでは"mps")を渡します。自動GPUインデックスは現在LanceDB Enterpriseの機能です。 - 本番ベクターストア。LanceDB OSSは単一ノードで数百万のベクターにスケールします。数億ベクターまたはテラバイト規模のデータを超えると、LanceDB CloudとEnterpriseが分散インデックスとクエリ実行を追加します(ドキュメントでは約100億〜500億行/約10〜30TBを対象としています)。
ただし、スケーリングの前に、デモ自体には鋭いエッジがあります。
遭遇した8つのバグと注意点
時間の節約になれば:
list_tables()はリストを返しません。 LanceDB 0.30ではListTablesResponseオブジェクトを返し、REPLでは反復可能に見えますが、if TABLE in db.list_tables()は静かに失敗します。代わりにtry: db.open_table(TABLE)を使って例外をキャッチするか、レスポンスの.tablesを使用してください。table.checkout(tag)はNoneを返し、テーブルハンドルをその場で変更します。バグのように見えますが、そうではありません。t = db.open_table(...); t.checkout(tag); use(t)を実行してください。t = db.open_table(...).checkout(tag)ではありません。- デフォルトの
CohereReranker()は古いモデルを使用します(テストしたバージョンではrerank-english-v3.0)。モデルを明示的に渡してください。ここでピン留めしているrerank-v3.5か、より高品質のrerank-v4.0-proです。デフォルトは警告を表示しません。 - 実際のバッチには
/scrapeではなく/trigger+ポーリングを使用してください。同期(/scrape)は小さなプル向けです。limit_per_input=100×2キーワード(約200件)の接続を保持するとタイムアウトのリスクがあるため、約50件以上では/trigger+ポーリングを使用してください。 - スクレイピングされたレコードの一部はエラー行です。 204件のうち4件は
job_titleの代わりにerrorフィールドが設定されていました(例:"Crawl aborted on job cancel")。表面上は通常のレコードのように見えるため、index.pyでフィルタリングしてください。そうしないとmerge_insertが空のjob_idで失敗します。 - 給与は2つの期間(
yrとhr)で提供されますが、スキーマフィールドは同じです。時給を年収に正規化(時給×2080)しないと、salary_min_annual >= 200000のようなフィルターは高給の時給契約を静かに見逃し、不当に低い年収の求人を含めてしまいます。 - 生の
%を含むargparseヘルプ文字列はPython 3.14で壊れます。ヘルプテキストに--where "salary > 200000 AND location LIKE '%SF%'"と書くと、argparseがフォーマットしようとしてValueError: badly formed help stringが発生します。%%にエスケープするか、例を言い換えてください。 - StreamlitはDollar記号で囲まれたテキストをLaTeX数式としてレンダリングします。
st.markdownやst.captionで表示される$150k,$200kのような給与は、崩れた数式になります。表示文字列のすべての$をエスケープしてください(リポジトリのapp.pyでは1行のreplaceで対応しています)。そうしないと給与バッジが文字化けします。
次に構築できるもの
このパターン(Bright Data ⟶ エンベディング ⟶ ベクターDB ⟶ ハイブリッド検索)はほぼあらゆるドメインに一般化できます:
| ドメイン | Bright Dataプロダクト | クエリの内容 |
|---|---|---|
| エージェンティックWebアクセス | Bright Data MCP(現在無料枠で月5,000リクエスト) | 「AIエージェントにライブ検索+スクレイプツールを与え、過去の結果のLanceDBバックキャッシュに対して回答を根拠付ける」 |
| サイト全体のコーパス | Crawl API | 「ドキュメントサイト全体またはナレッジベースをハイブリッド検索用にインデックス化する」 |
| Eコマース | Web Scraper API(Amazon商品) | 「4つ星以上で$100以下の快適なランニングシューズ」 |
| 不動産 | Web Scraper API(Zillow / Redfin) | 「良い学校の近く、3ベッドルーム以上の静かな家族向け住宅」 |
| ニュースインテリジェンス | SERP API+Web Unlocker | 「今週のAI安全記事、アライメントへの関連性でランク付け」 |
| セールスプロスペクティング | LinkedIn企業情報 | 「欧州のヘルスケアAI分野のシリーズAスタートアップ」 |
| レストラン | Yelpデータセット | 「屋外席のある居心地の良いイタリアンレストラン」 |
このプロジェクトの自然な拡張:
- マルチモーダル検索。Cohere
embed-v4.0(ネイティブマルチモーダル)に切り替えて、求人説明と並んで企業ロゴをエンベディングします。 - LLM抽出フィルター。ユーザーが「$200k以上のリモートMLポジション」と入力し、LLMが自動的に
remote=true, salary_min_annual >= 200000を抽出できるようにします。 - メールアラート付き保存検索。最新のスクレイプに対してクエリを再実行し、新しいマッチを通知します。
- 履歴書マッチング。履歴書をエンベディングし、候補者への類似度で求人を検索します。Bright DataのLinkedIn求人探しAIアシスタントがより完全な例です。
- 自己メンテナンス型スクレイパー。エージェントにBright DataのMCPへのアクセスを与えると、ページを検査してスクレイパーを書き、レイアウトが変わったときに手動で
scrape.pyを修正する代わりに修正を試みることができます。Bright DataのScraper Studioはこれを管理製品としてパッケージ化し、平易な英語のプロンプトから自己修復型スクレイパーを作成します。
次のステップ
キーワード検索は適切な求人を見逃し、ベクター検索はタイトルがクエリと一致しなくても見つけました。評価では、ベクターがprecision@3で70%を記録し、キーワードの43%を上回りました。ハイブリッドはこの規模では改善が見られませんでした。
GitHubの完全プロジェクトは9つの小さなファイルで構成されています。独自のデータで使用するには、まずpython eval.pyを実行してください。最適なモードはデータに依存し、最も複雑なものではないからです。次に更新頻度を決定します。merge_insertアップサートは変更されたもののみを更新し、versions.pyは各インジェストをスナップショットします。そしてリリース前に、キーローテーションルーティンを計画してください。BDとCohereの両方のキーが.envに入ります。
同じパターンはBright Dataがスクレイピングできるものすべてに機能します。求人だけではありません。そこから、スクレイピングしたあらゆるデータセットに再利用できるセマンティック検索エンジンが完成します。
FAQ
LinkedIn以外のサイトでも使用できますか?
はい。Bright DataのWeb Scrapers Libraryは数百のサイト(Amazon、Zillow、Yelpなど)をカバーし、それぞれ固有のdataset_idがあります。scrape.pyのDATASET_IDと、index.pyのto_row()マッピングを新しいJSON形状に合わせて変更してください。検索とインデックスロジックはデータに依存せず、そのまま使用できます。
Cohereの有料アカウントが必要ですか?
いいえ、トライアルキーでデモ全体を実行できます。CohereのトライアルRerankエンドポイントは現在10回/分に制限されているため、eval.pyは429エラーで自動的にバックオフします(約15秒ではなく約90秒)。スクレイピング、インデックス化、アドホック検索は制限内に収まります。evalを頻繁に繰り返す場合のみアップグレードしてください。
なぜPinecone、Weaviate、pgvectorではなくLanceDBなのですか?
LanceDBはサーバー不要・別データベース不要・管理サービス料金不要の組み込みライブラリです。ハイブリッド検索とCohereリランキングをネイティブにサポートし、すべての書き込みがバージョンスナップショットになります。opsなしの単一マシンパイプラインでは、これが最小のオーバーヘッドです。他のものは優れていますが、より多くのインフラを追加します。
どのくらいの頻度でスクレイパーを再実行すべきですか?
アクティブな求人ボードには1日1回が適しています。Bright Dataはダッシュボードからスケジュール収集を実行でき、merge_insertアップサートがLanceDB側で重複を排除するため、再実行は安価です。約30日以上経過した求人は通常クローズされるため、古いスナップショットは履歴となり、versions.pyがクエリ可能な状態に保ちます。