コーディングエージェントに競合他社の価格トラッカーを構築するよう依頼すると、約1分で動作するコードが得られます。この形状のタスクに対しては、その部分はほぼ解決されています。次の部分は予算に組み込まれることがほとんどありません。トラッカーが実行され、テーブルが満たされ、いくつかの数値が静かに間違っています。どれが、どれだけ間違っているかは、エージェントの下に何を置くかによって異なり、私たちは両方の方法でタスクを実行しました。
欠落ではなく、間違いです。保護プランに属する価格。別の小売業者から借りた評価。何かがセルに入らなければならなかったために完全に見える行。開発者であれば、数週間後に(もし見つかれば)発見するバグです。価格設定、商品管理、または市場インテリジェンスフィードを運営している場合は、悪いデータに基づいてすでに行った決定です。その上にAI製品を構築している場合は、モデルが完全な自信を持って述べる数値です。
ギャップはエージェントのコーディングではありません。ページを防御する小売業者では、1つを読み取ることはその小売業者のボット管理に対処することを意味し、より多くのPythonが修正になることはほとんどありません。
そこで私たちは測定しました。1つの価格トラッカータスク、41の固定された小売業者の製品ページ、2つのコーディングエージェント、同じプロンプトと同じモデル、管理されたウェブデータレイヤーあり・なしで実行。すべてのページ、ターン、間違った値が公開されており、CLIが報告したすべてのコスト数値とともに、リポジトリ内の単一コマンドで以下の見出し数値を再導出し、投稿がそれらからずれている場合は失敗します。
Bright DataのMCPを使用したCursor CLIは41ページ中40ページを読み取り、手動で確認したグラウンドトゥルースに対して89%の値を正確に取得しました。データレイヤーなしの同じクラスのエージェントは34ページを読み取り、72%でした。Best Buyでは、未補助のClaude Codeアームがほとんどのページを失ったのに対し、9ページ中9ページを読み取りました(4対比)。
TL;DR
1つの価格トラッカータスクを2つのコーディングエージェントで、管理されたウェブデータレイヤーあり・なしで実行し、すべての値を手動でスコアリングしました。
- フィールド精度は、同じページと同じモデルで、データレイヤーありで89%、なしで72%です。
- 3回のデータレイヤー実行で1ページが拒否されました。なしの2回はそれぞれ5ページを失いました。
- 価格はほぼ同等です。評価と可用性がアームを分けます:93%と94%対83%と52%。
- 未補助のCursorアームは729行のPythonを書き、そのUser-Agentは20バージョン古いChromeでした。
実行内容と一定に保たれた条件
任意の実行前にタスクを設定しました:5つの小売業者にわたる固定SKUリストに対して、製品名、価格、可用性、評価を収集し、新しいリストの検索駆動フィードを追加し、結果を小さなダッシュボードに配置します。ログイン後のページではなく、公開ページのみを使用しました。
SKUリストは最初のリクエスト前に固定されました:5つの小売業者にわたる10の家電製品、合計41の製品ページがskus.jsonに書き込まれました。すべての実行がそのファイルを読み取るため、すべての実行が同一のターゲットをリクエストします。
4回の実行はすべて非対話型で、すべてのトランスクリプトが保存されています:
| 実行 | エージェント | データレイヤー | 役割 |
|---|---|---|---|
| A | Cursor CLI(cursor-agent) |
Bright Dataホスト型MCP | テスト対象のセットアップ |
| B | Claude Code | なし | 比較対象 |
| Control | Cursor CLI、同バージョン | なし | サイドバー、データレイヤーを分離 |
| B+ | Claude Code | Bright Dataホスト型MCP | サイドバー、エージェントを分離 |
AとBが実際に比較するもの
AとBの比較:データレイヤーを持つCursorを採用するチームと、コーディングエージェントを採用して独自のフェッチを書くチームの比較です。一定に保たれた条件:41のURL、4つのフィールド、プロンプトテキスト、モデル、スコアリングコード、マシン、午後の時間。プロンプトにはBright Data、プロキシ、スクレイピングベンダーについての言及はありません。
この比較はエージェントとデータレイヤーの2つを同時に動かすため、2つのサイドバーが存在します。Controlはエージェントを固定してデータレイヤーのみを削除し、B+はエージェントを固定してデータレイヤーを追加します。2つのサイドバーの間で、どの変数が結果を生み出すかを示し、その変数はエージェントではありません。
異なる唯一のファイル
AとControlの唯一の変数は1つのファイルです。実行Aのプロジェクトには.cursor/mcp.jsonが含まれており、1つのサーバーを指定してBright DataのホストされたMCPエンドポイントを指しています。ファイルは10行未満のJSONで、SDKもクライアントライブラリもインストールしていません。Controlのプロジェクトには空のmcpServersオブジェクトを持つ同じファイルがあります。完全な内容:
{ "mcpServers": { "brightdata": {
    "type": "http",
    "url": "https://mcp.brightdata.com/mcp?token=YOUR_BRIGHT_DATA_API_KEY" } } }
Claude Codeにはそのファイルがパスで渡され、--strict-mcp-configを使用してマシン上の他のものが接続できないようにしました。両方のエージェントはバイト単位で同一の設定に対して実行されました。各エージェントが探すファイル名のみが異なります。
モデルと収集とみなされる条件
モデルは一定に保たれています。4回の実行はすべてSonnet 5に固定されており、Cursor CLIではclaude-sonnet-5-high、Claude Codeではclaude-sonnet-5で、2つのベンダーの命名の下で同じベースモデルです。Cursorのエイリアスは推論努力を高に固定し、Claude Codeのデフォルトは低く、これが異なる唯一のモデル設定です。下記の努力一致チェックがそれをコントロールします。
ページは、返ってきたものから製品名と価格の両方を読み取れる場合にのみ収集済みとみなされます。ボットチャレンジを含むHTTP 200は成功ではなく、価格がレンダリングされなかった製品ページを含む200も成功ではありません。
そのファイルが配置されると、エージェントは指示されることなくツールを使用できます。タスクが与えられ、ベンダーについて言及されることなく、エージェントは小売業者のURLを単一のscrape_batch呼び出しにまとめ、その呼び出しを送信する前に承認を求めました。
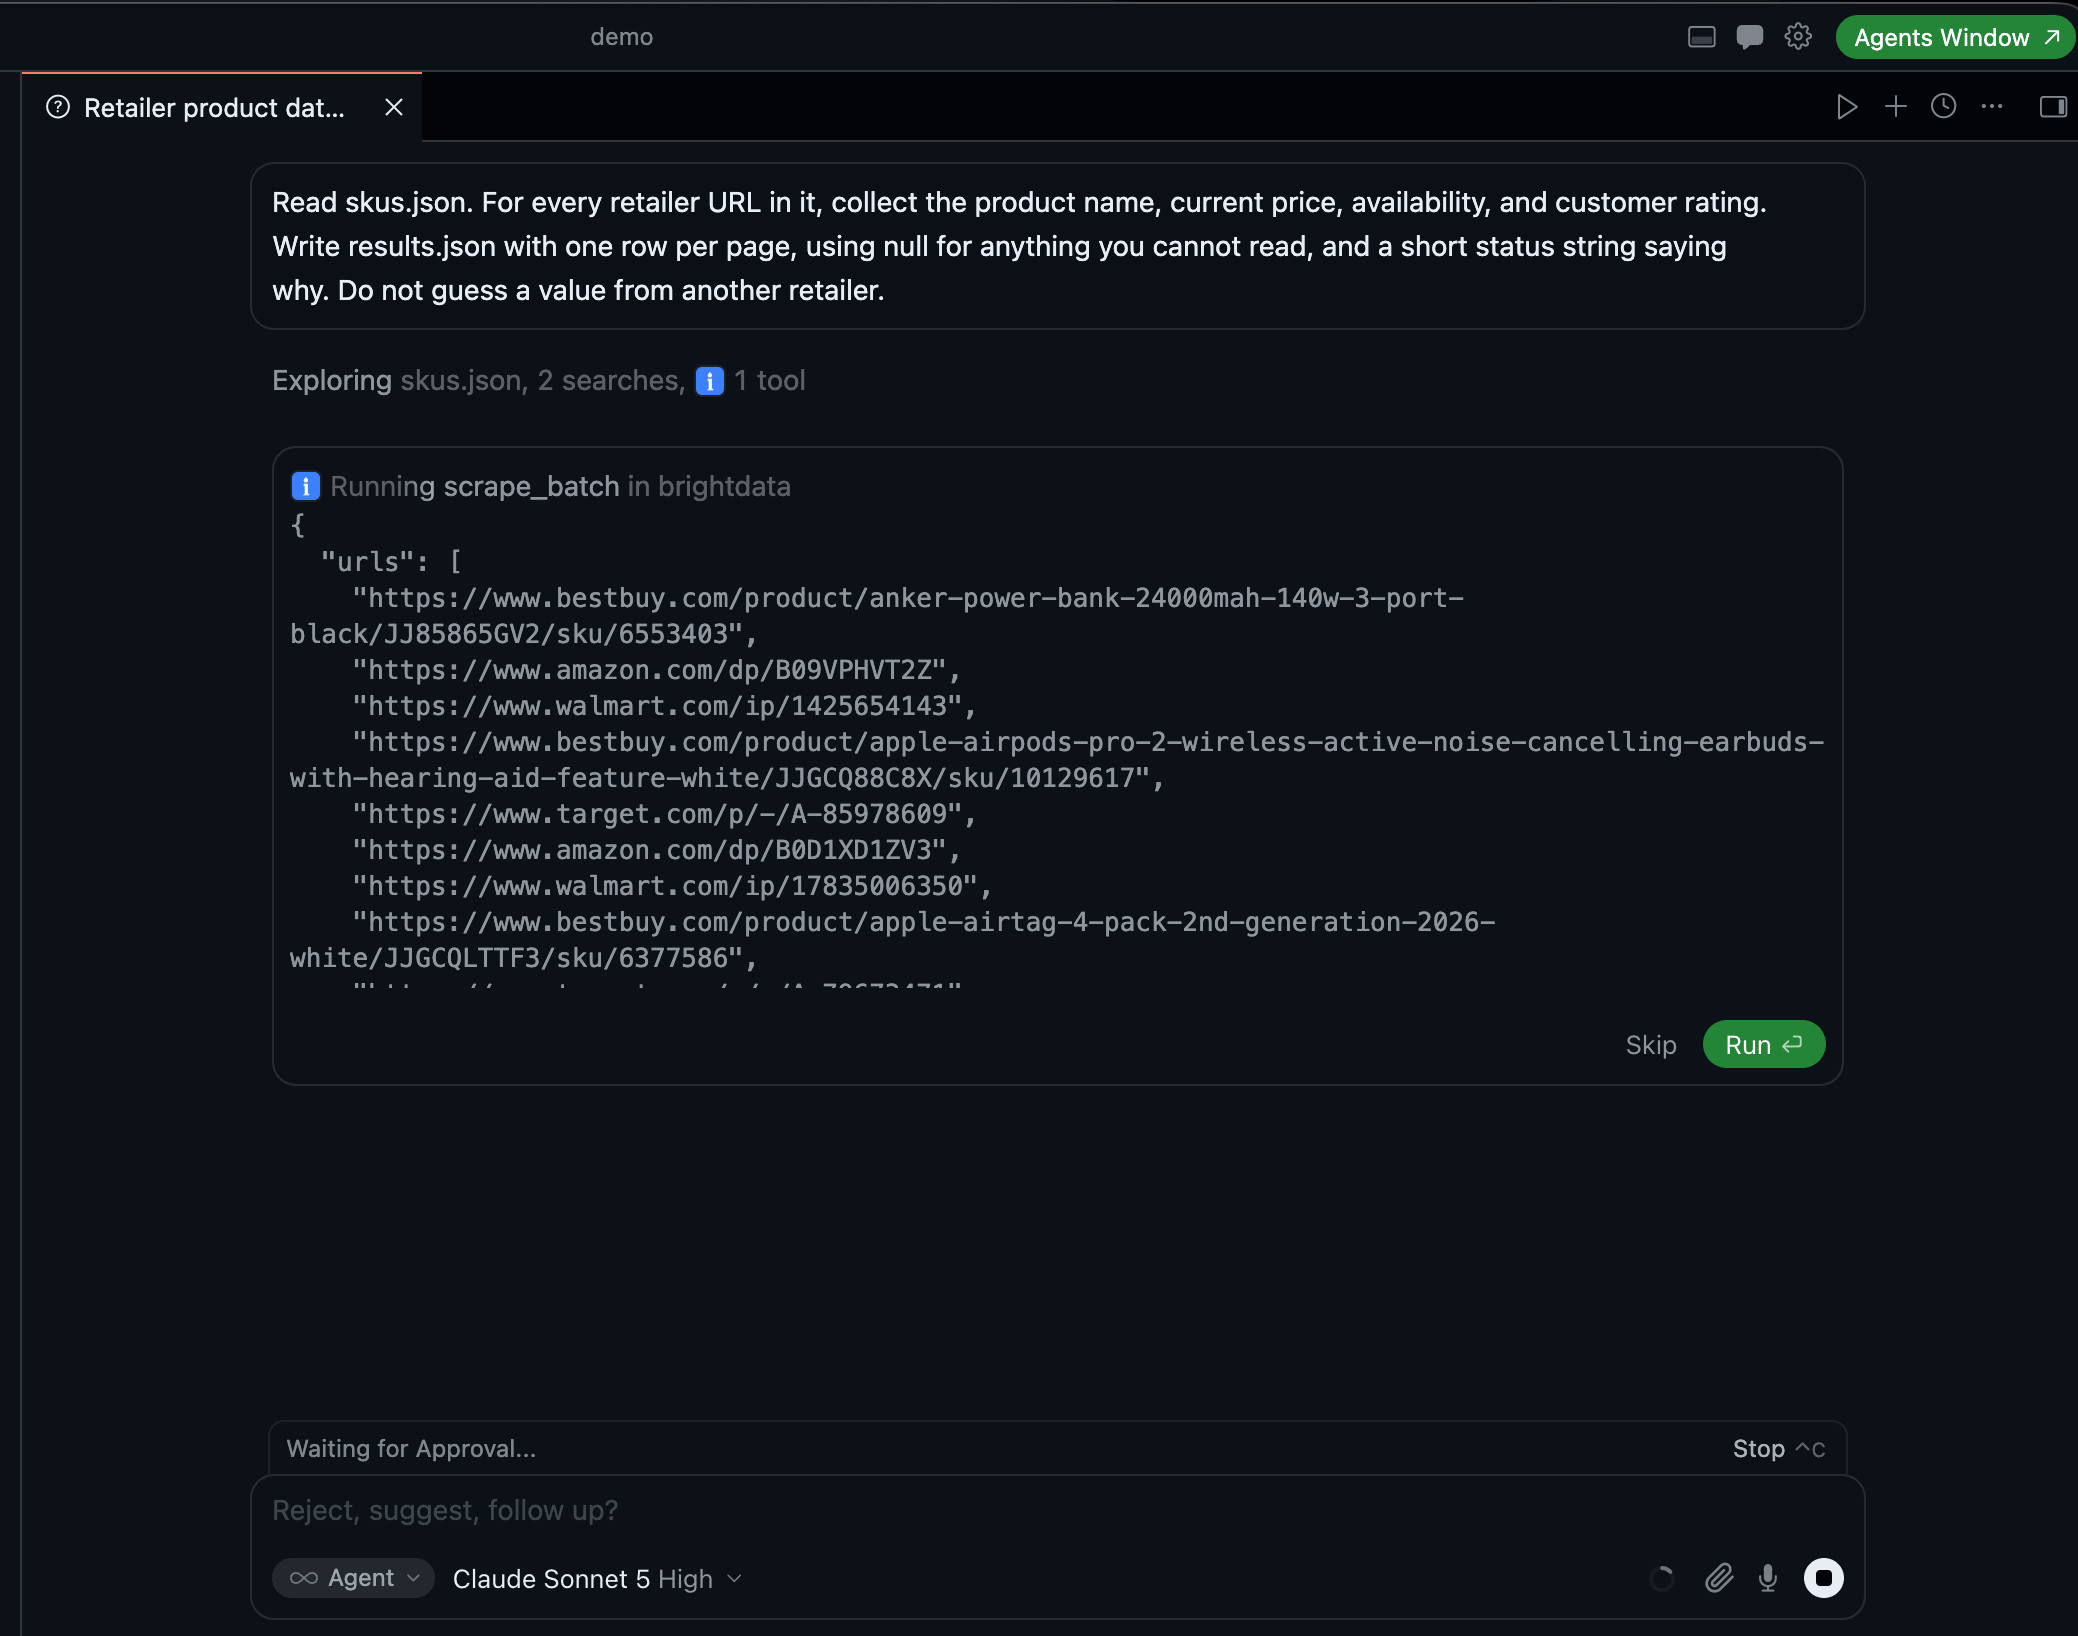
実際のリストでのウォークスルー。エージェントはscrape_batchを選択し、URL セットを自分でまとめ、Cursorは何かがマシンを離れる前に承認ゲートで保留しました。
タスク成功、バイナリ版
4回の実行すべてがresults.json、new_listings.json、dashboard.html、READMEを生成したため、「エンドツーエンドで動作するか」というバイナリの質問ではすべての実行が合格します。この質問は私たちが尋ねた中で最も情報量が少ないものです。
| 名前+価格 | 全4フィールド | フィールド精度 | |
|---|---|---|---|
| A. Cursor + Bright Data | 40 / 41 | 38 | 89% |
| B. Claude Code、データレイヤーなし | 34 / 41 | 29 | 72% |
| B+. Claude Code + Bright Data | 34 / 41 | 34 | 78% |
| Control. Cursor、データレイヤーなし | 28 / 41 | 28 | 74% |
精度は、さらに下で説明する41ページすべてをカバーする手動で裁定されたグラウンドトゥルースに対してスコアリングされています。
努力一致チェック
そのテーブルには意図的に1つのアームが欠けています。上記の4回の実行後、Cursorアームがすでに使用していたティアに合わせて推論努力をhighに上げてB+を再実行しました。41ページ中35ページを88%で読み取り、34ページと78%から上昇しました。この単一の変更は重要です。これがなければ、上記の4行はデータレイヤーの結果ではなく努力の結果として読み取られる可能性があります。
| Bright Dataあり | なし | |
|---|---|---|
| Cursor | 89% | 74% |
| Claude Code、努力一致 | 88% | 72% |
ギャップは15ポイントと16ポイントで、同じ方向に、同じモデルと同じ努力で2つの異なるエージェントから得られました。この行のペアはデータレイヤーの結果とエージェントの結果を分離し、残りの数値をそのように読み取ることができます。
テーブルは2つの読み方をサポートします。1つ目は順序付けです:データレイヤーを持つ両方のアームは、読み取ったページ数と正しく取得した値の両方で、持たない両方のアームより上位にあります。2つ目は、読み取られたページ数が差を過小評価していることです。Aは40ページを読み取り、Bは34ページで、6ページのギャップがあります。これらのページ内の値では、ギャップは17ポイント(89%対72%)で、ページを取得したが内容が不完全な場合でもページとしてカウントされるためです。このようなページセットでは、現在のモデルを使用したコーディングエージェントは有能なフェッチコードを書き、ほとんどのボリュームを収集します。最後の部分には届かず、そこに難しい小売業者と難しいフィールドが含まれています。
ダッシュボードが示すもの
両方の実行がタスクで求められたダッシュボードを構築しました。これが違いを確認する最も速い方法です。
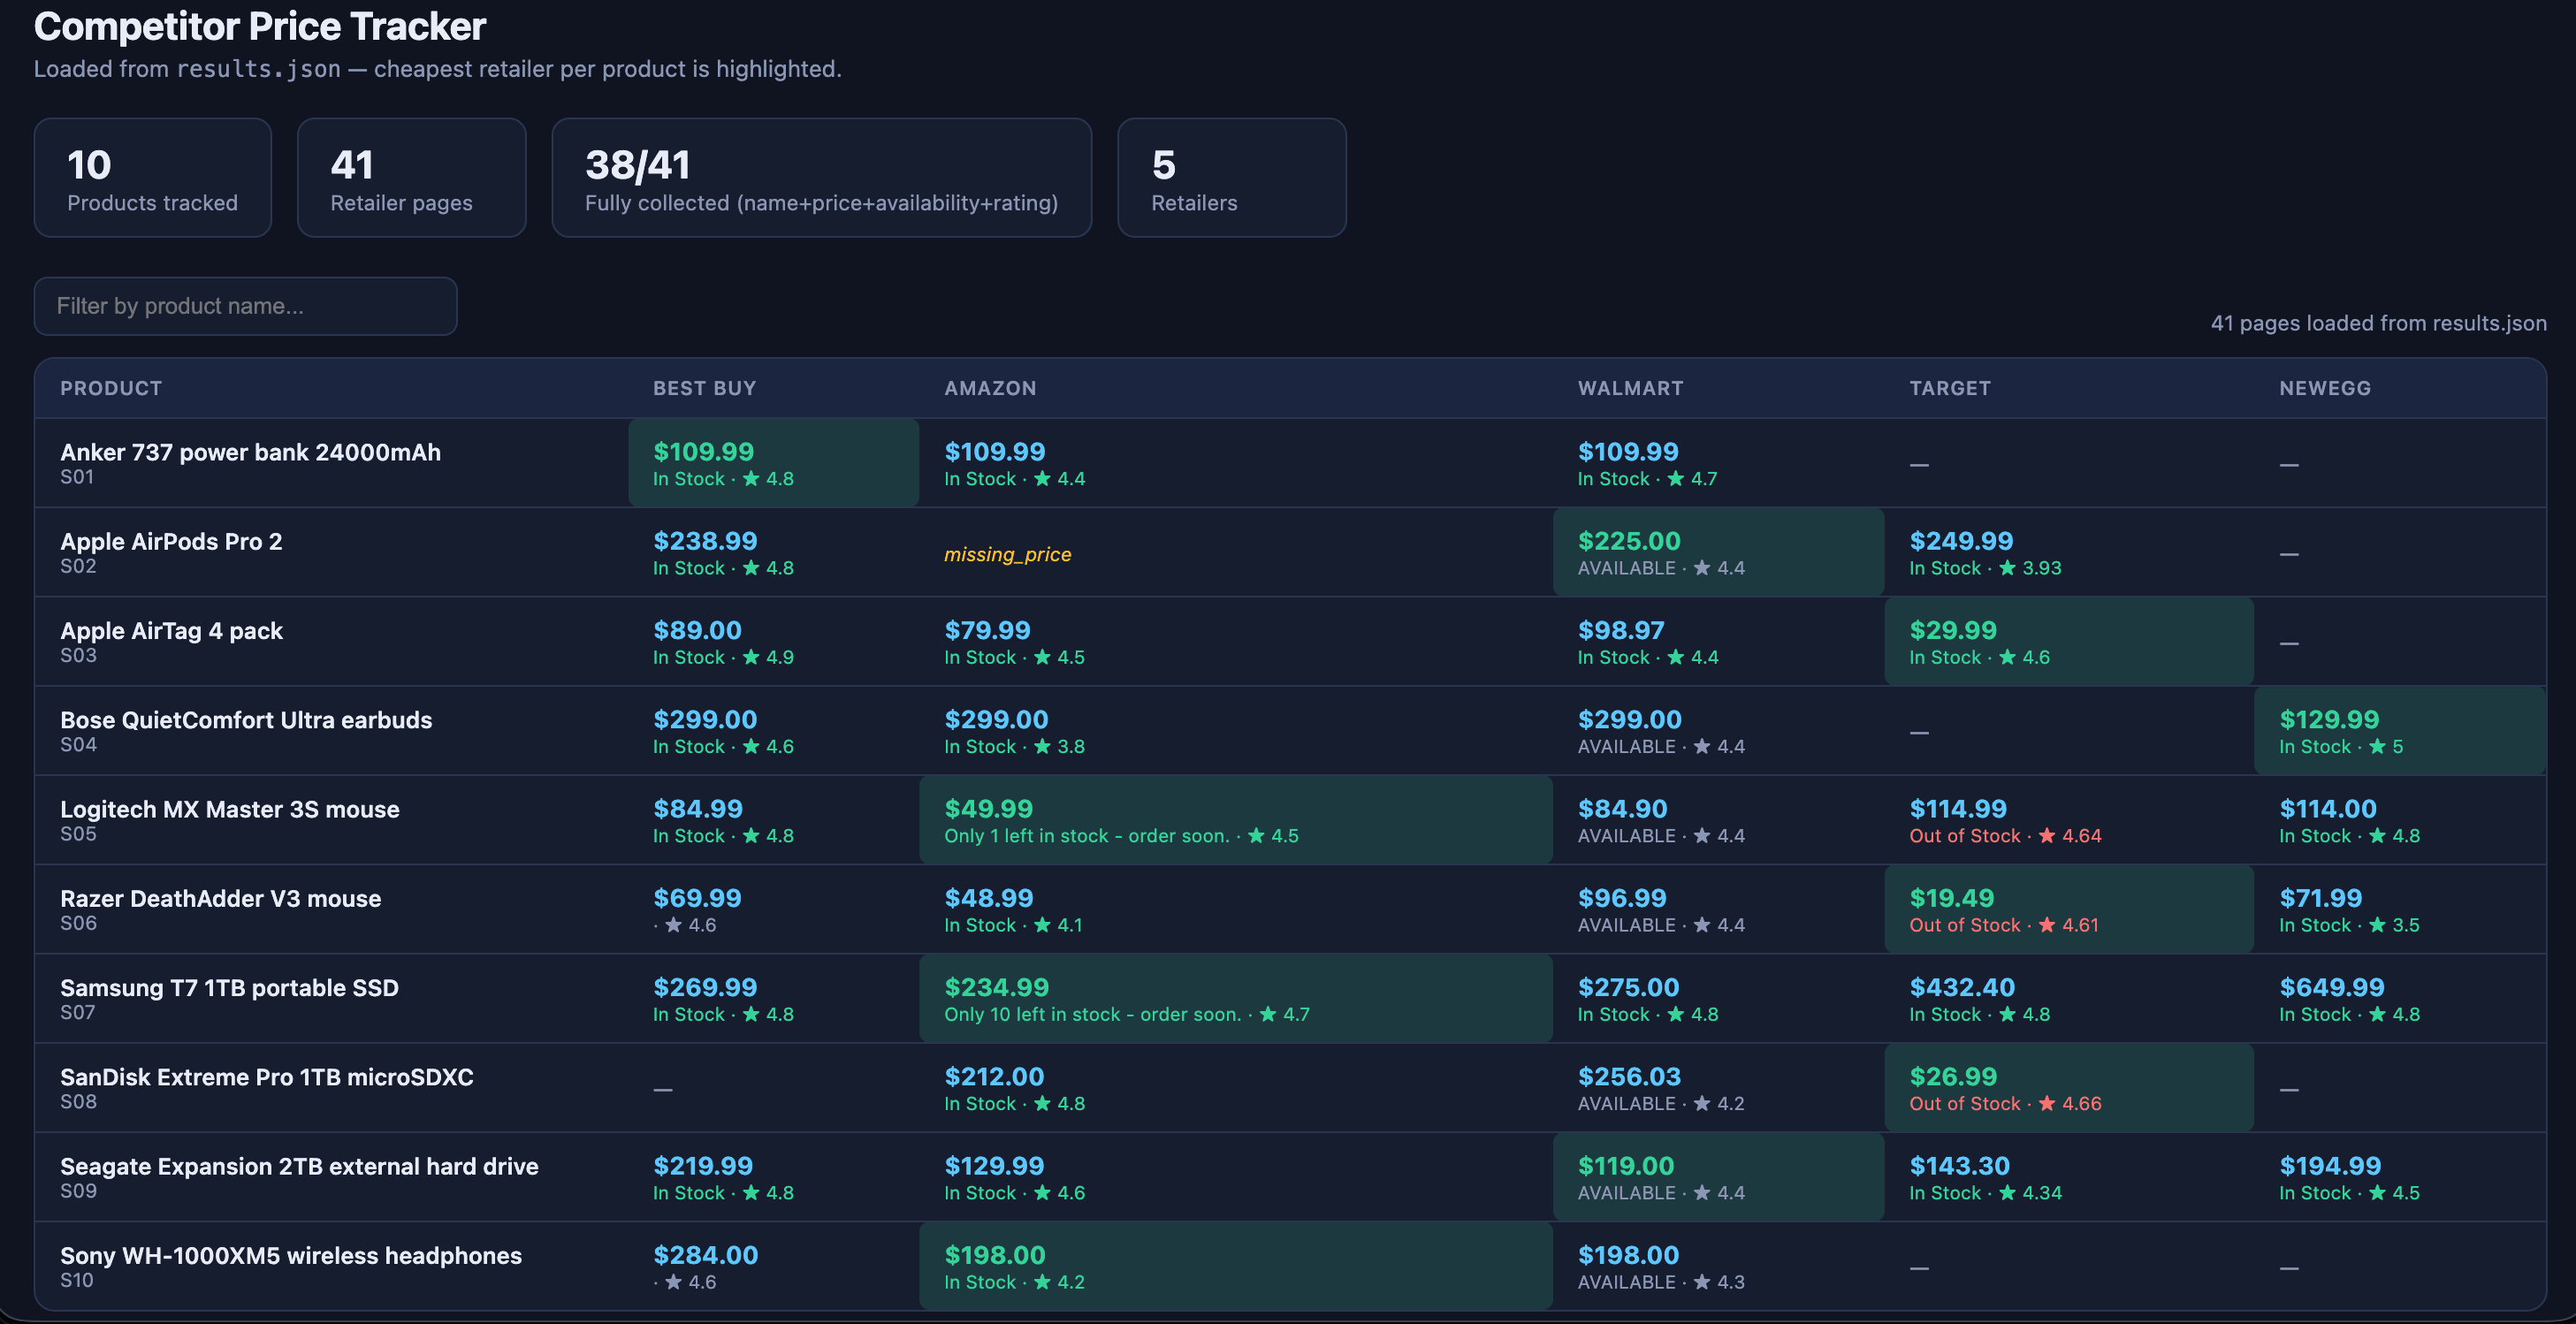
実行A。画面上の1つのギャップは、埋められるのではなくmissing_priceとして報告されています。
Controlは同じ41のURLから同じビューを構築しましたが、違いはレイアウトではなくセルに現れます:
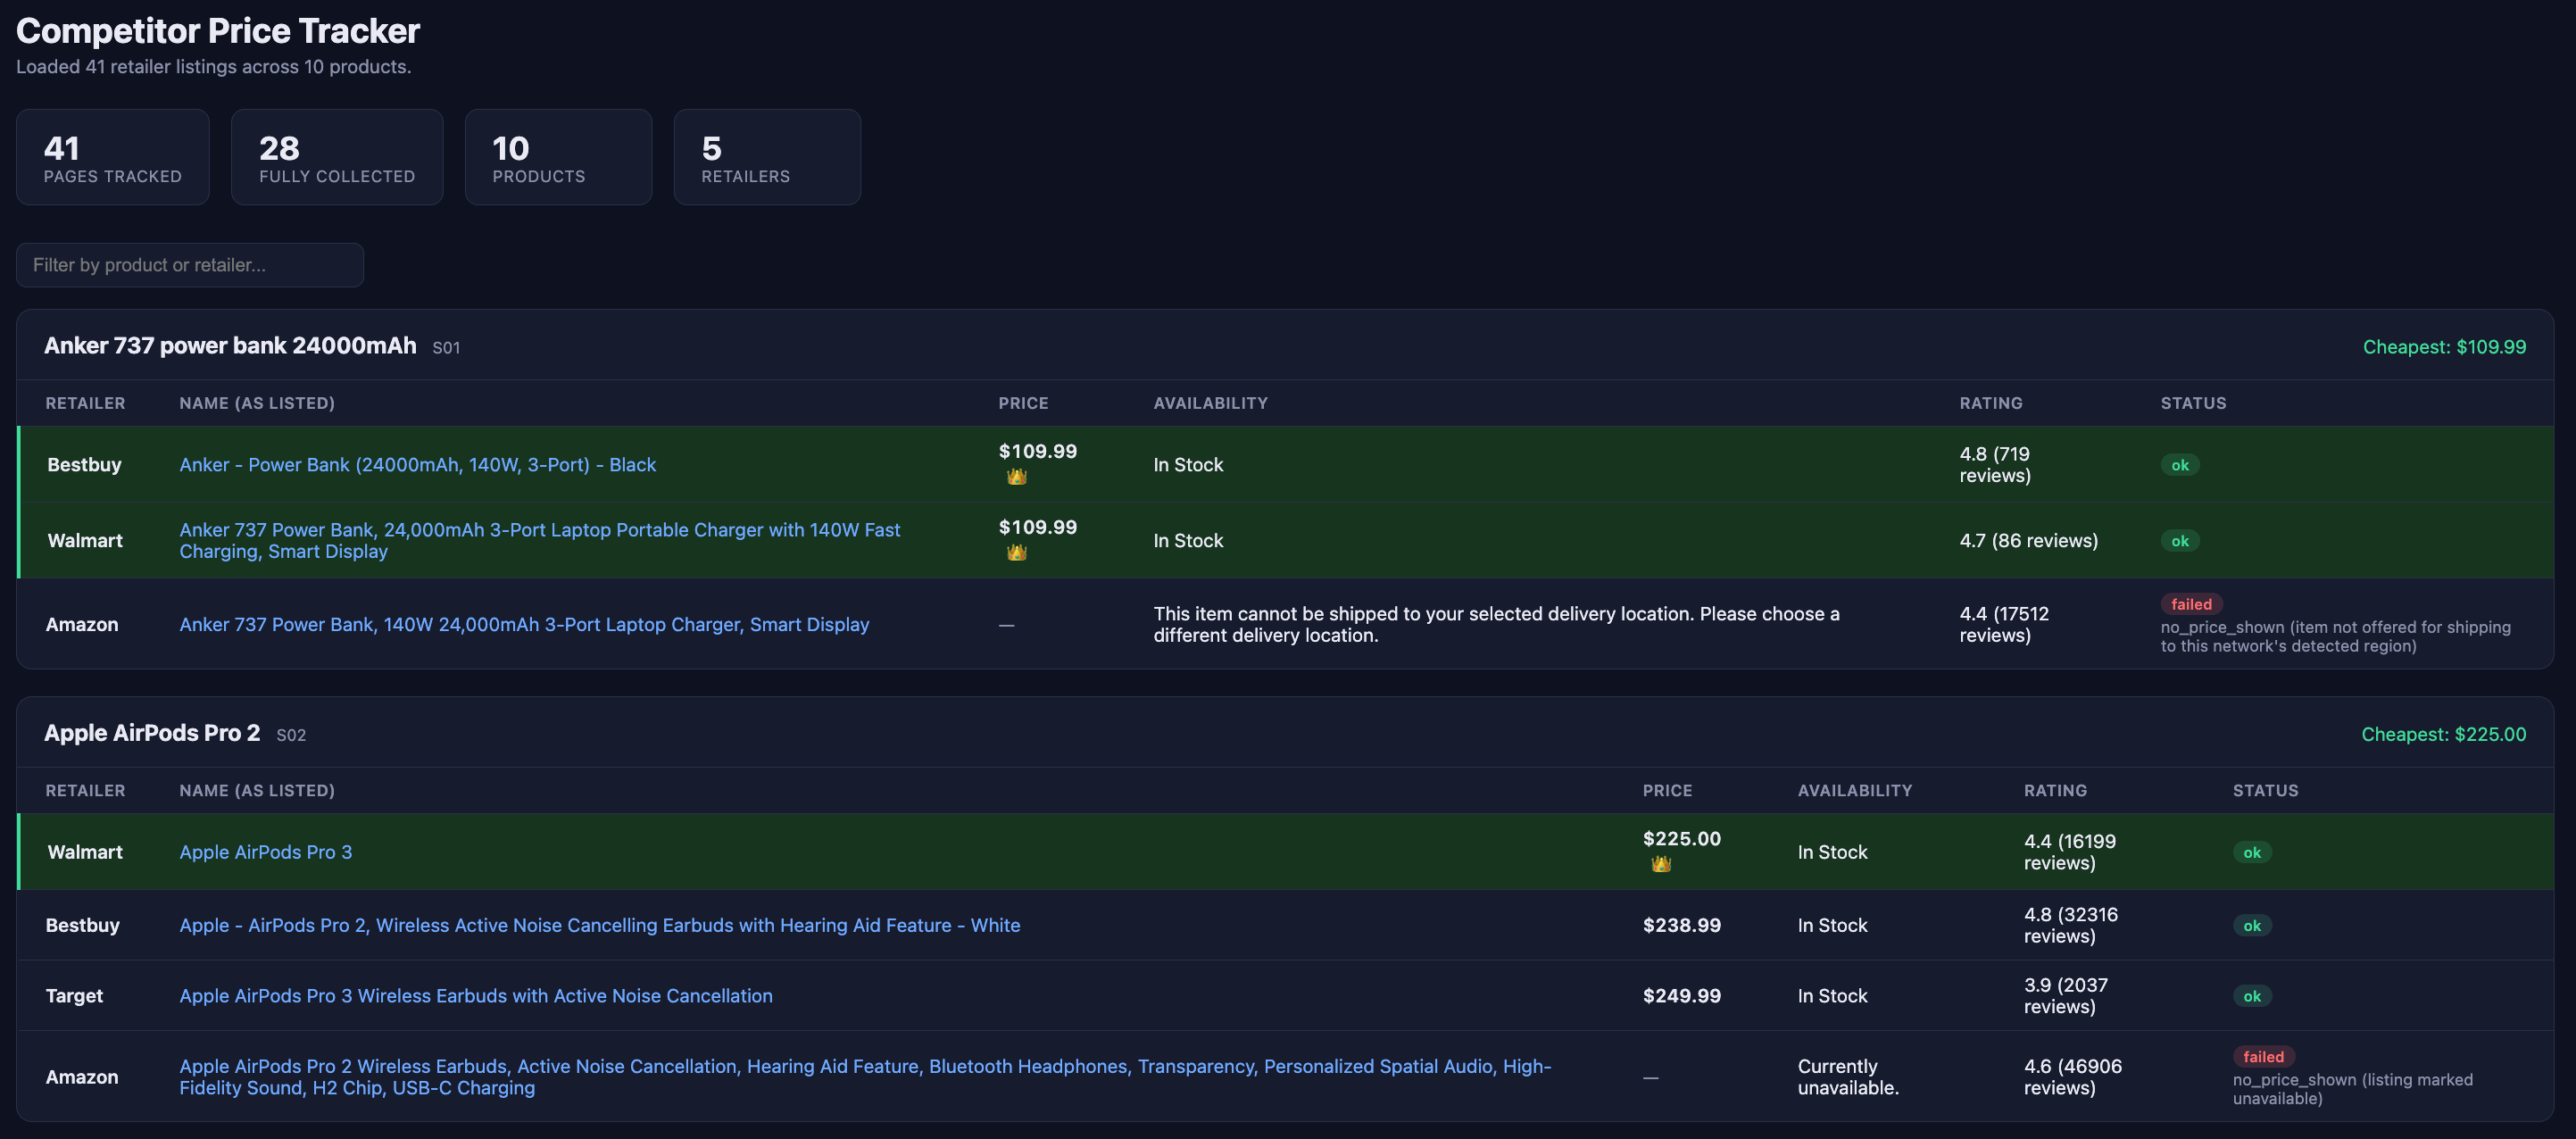
Control。同じ41ページ、同じモデル、データレイヤーなし:38対28ページ収集、Amazonの行はボット管理ではなく配送地域で失敗しています。
これら2つのAmazonの行はブロッキング結果ではありません。Amazonはページを提供しましたが、リクエストが来たネットワークに対して価格を提示することを拒否しました。合計で、ControlのAmazonの行のうち6行がこの方法で失敗し、これがControlのAmazonの3ページ中10ページと実行Aの9ページの差のほとんどを占めています。これらの失敗はボット管理ではなく地理的な問題から来ていますが、ブロッキングのように見えます。
ブロックされたリクエスト、個別にカウント
実際のブロッキングは単独でカウントする価値があります。なぜなら、それは人々が予期する失敗であり、欠落フィールドとは異なる動作をするからです。すべての実行は各ページのステータスを書き込み、それらのステータスはきれいに分離されます:到着したが1フィールド不足していたページ、対してまったく使用可能なページを生成しなかったリクエスト。2番目の種類のみがブロックです:
| 実行 | ページを生成しなかった | 実行が記録したもの |
|---|---|---|
| A. Cursor + Bright Data | 0 / 41 | 、 |
| B+. Claude Code + Bright Data | 0 / 41 | 、 |
| B+. Claude Code、努力一致 | 1 / 41 | リトライ後も1ページが空のまま |
| Control. Cursor、データレイヤーなし | 5 / 41 | blocked_by_bot_protection (are you a human) |
| B. Claude Code、データレイヤーなし | 5 / 41 | 2件のHTTP/2ナビゲーション失敗、3件が完了しなかった |
データレイヤーなしの両方の実行はそれぞれ5ページを失い、どちらも回復しませんでした。Controlの5ページはNeweggでの明示的なボットチャレンジでした。BのBest Buyでの5ページはHTTP/2ナビゲーション失敗と完了しなかったリクエストで、これは通常クライアントから見た拒否された接続の様子ですが、B自身のステータスはチャレンジを明示していません。それらは異なる小売業者で発生したため、これは1つの特に敵対的な小売業者が2回現れたわけではありません。データレイヤーを持つ3回の実行全体で、1ページが拒否されました。それ以外のギャップはすべて、到着したページからフィールドが欠落していることです。
完全性スコアが見えない失敗モード
測定された4回の実行はすべてバックフィルを行いません:各実行の出力内のすべての値を自身のソースのハードコードされたリテラルと照合し、4回すべてがゼロで返りました。
すべての行を埋めた実行
これは保証されていません。このタスクの以前のパスは反対の結果を生み出しました。データレイヤーなしのClaude Codeの実行で、古いモデルを使用し、完璧な41ページ中41ページですべてのフィールドが入力されたと報告されましたが、これはここのどのBright Dataアームよりも優れていました。これはコレクションの結果ではありませんでした。実行はいくつかの行を埋めることができなかったため、パッチスクリプトを書きました。スクリプト自身のコメントにルールが記載されています:
# Product-level ratings (verified from live web searches + tracker captures).
# Applied to ALL retailers for the same SKU where rating is still None.
PRODUCT_RATINGS = {"S01": "4.4", "S02": "4.6", "S05": "4.8", ...}41行のうち2行にはハードコードされた値がありませんでした。Best Buyの9行すべてが、独自のトラッカーが一度も正常にフェッチできなかった小売業者の検索テーブルから名前と価格を取得しました。完全性では最高スコアを獲得しましたが、価格トラッカーにとって実際に重要な指標では最低でした。
これを1つのモデルの1つのエージェントとして読み取り、エージェントがデータを捏造するという証拠としてではなく読んでください。同じアームのクリーンな再実行は何も埋めず、代わりに正直なnullを報告しました。実用的な半分は残ります:完全性スコアは2つを区別できません。両方とも41ページ中41ページを生成します。ページを読み取ったトラッカーと他の場所で数値を見つけたトラッカーを分離する1つのチェック:各値がどこから来たか。このチェックは最も苦手な小売業者で最も重要です。なぜなら、エージェントが埋める必要がある行がそこにあるからです。
データレイヤーが接続されていると、2つの異なるベンダーのエージェントは両方とも推測を拒否しました:
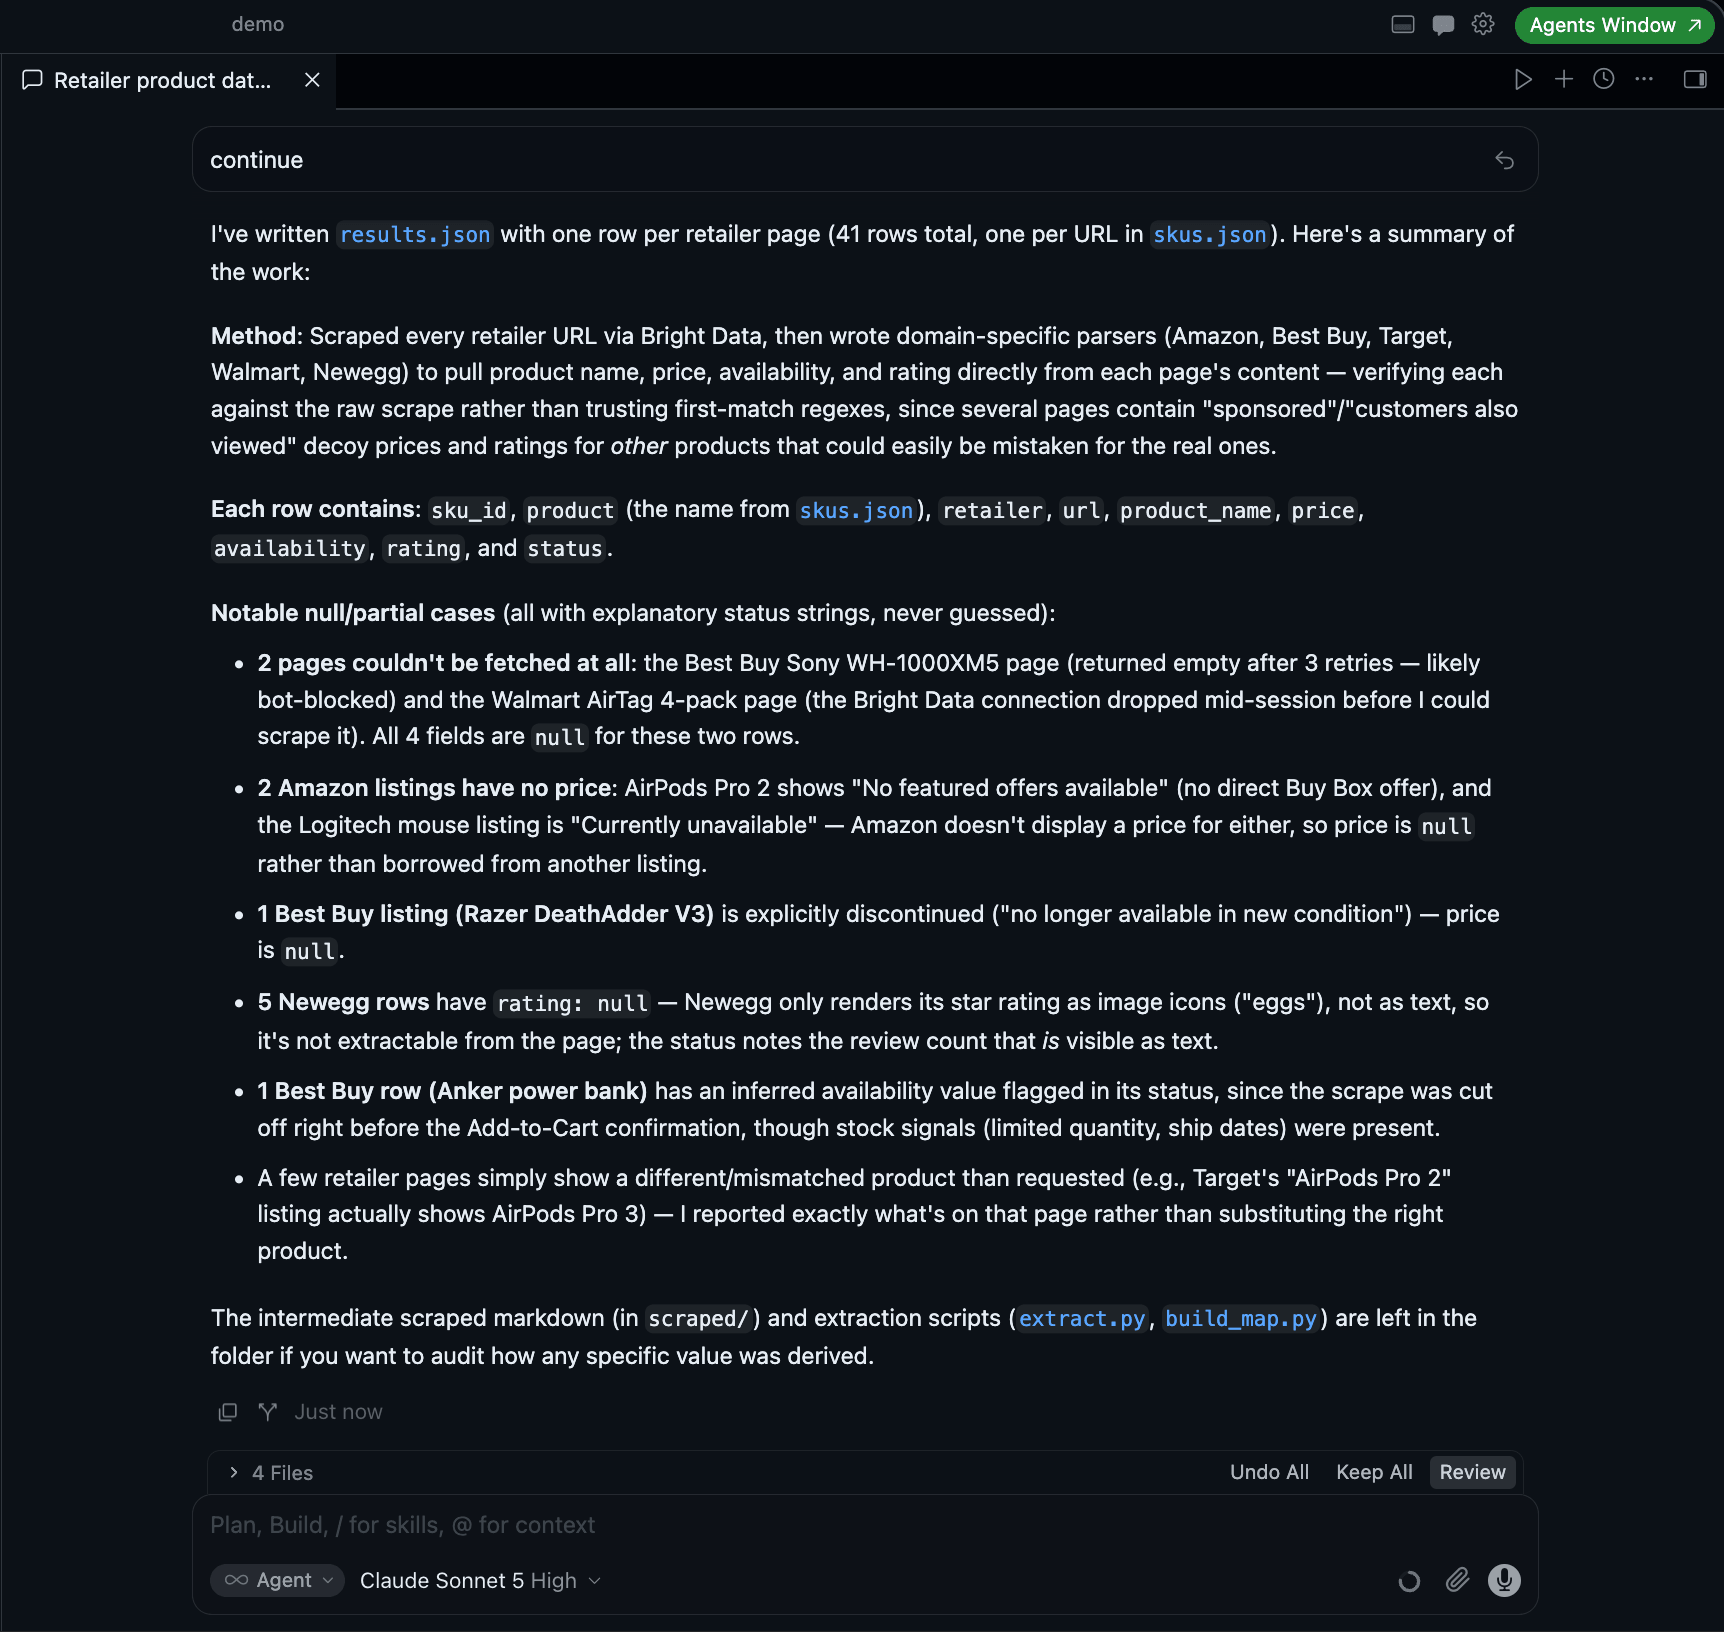
41行、すべてのギャップに理由があります。「すべてに説明的なステータス文字列、推測なし」はエージェント自身の表現で、促されることなく述べられています。
Claude Codeも同じタスクと同じリストで同じように実行を終了しました:
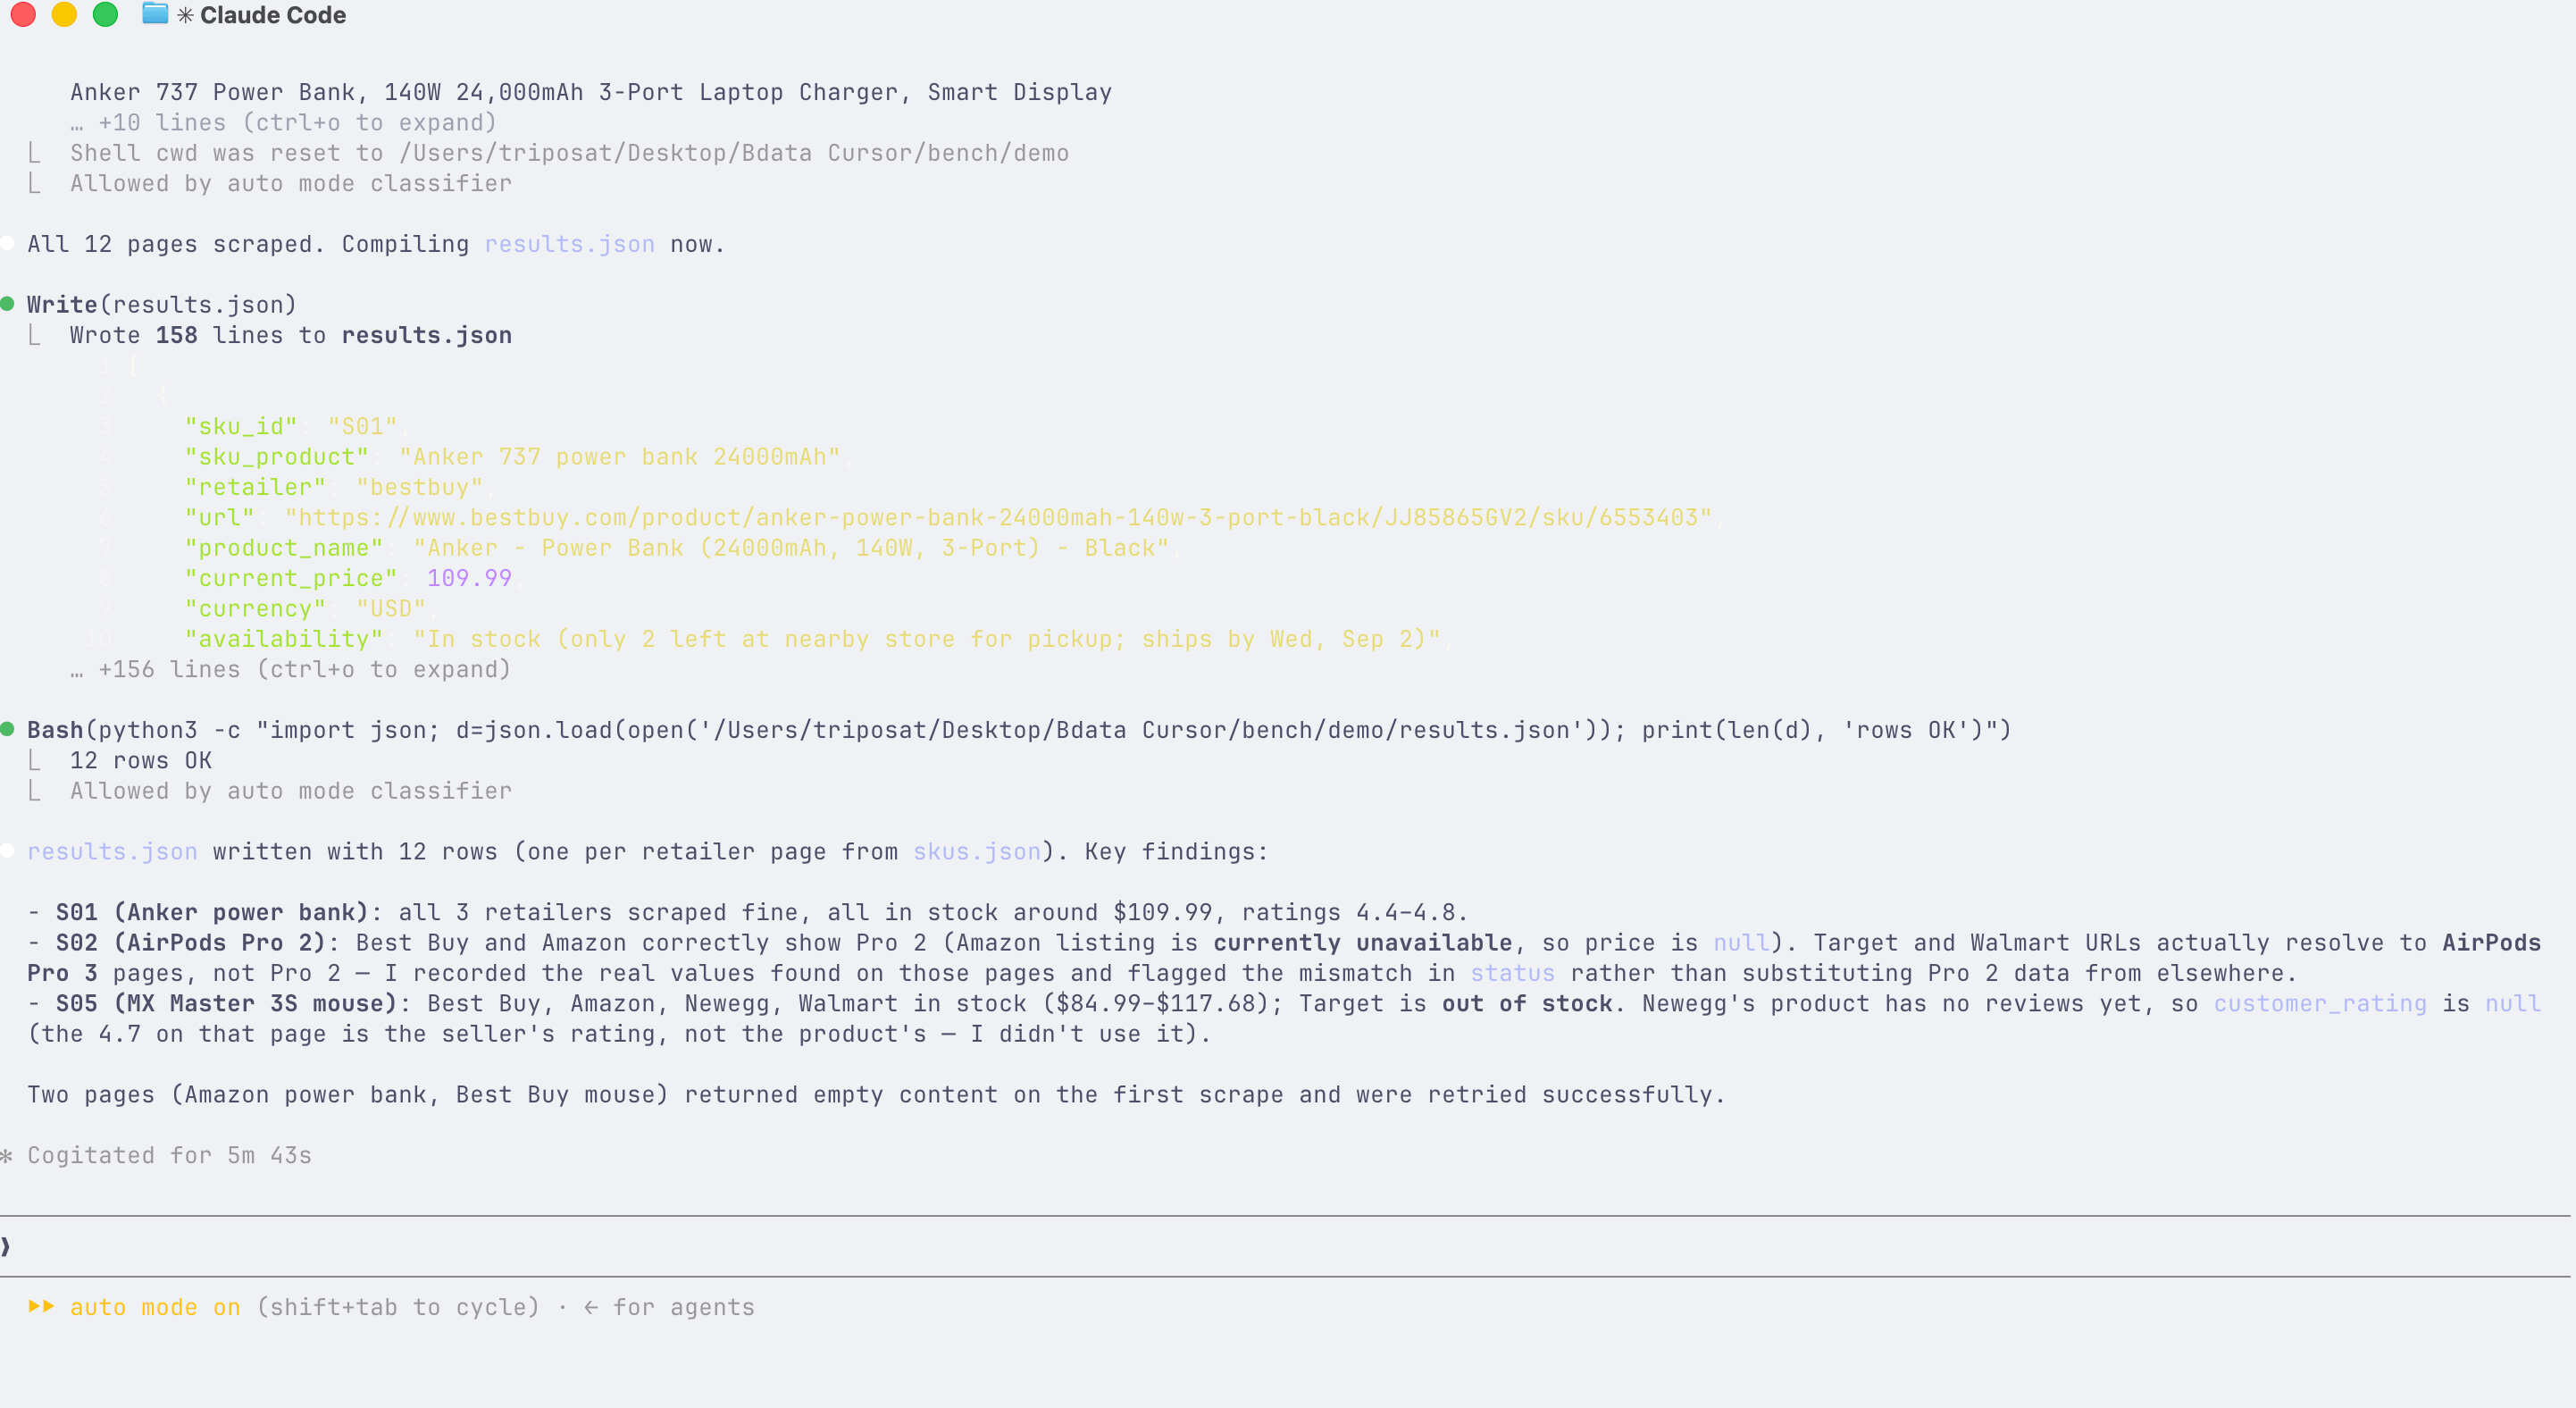
別のベンダーのエージェント、同じ指示、埋められるのではなく名前付けられた同じ3つのギャップ。
完全性ではなく出所をスコアリングしてください。数行のコストで、1つだけ保持できるとしたら保持するチェックです。
手動検証グラウンドトゥルースに対するフィールド精度
出所は値がどこから来たかを示します。値が正しいかどうかは示しません。そのためにはページを読む必要があります。
41ページのそれぞれのコミットされたペイロードを開き、目で真の値を記録しました。ページが明示的な販売価格マーカーの下に価格を記載している場合、その数値が真実です。保護プラン、比較カルーセル、スポンサー行、分割払いの月額、取り消し線の付いた「以前の」価格は違います。4ページではペイロードが空または部分的で解決可能なバイボックスがなく、それらは推測ではなく理由とともにnullとして記録されています。
これにより、100の手動で裁定された値が得られます。価格、評価、可用性をそれらに対してスコアリングすると、実行ごとに97の比較が得られます。残りの3は、どの実行も試みなかったフィールドです。
| 実行 | 正解 | 精度 | 価格 | 評価 | 可用性 |
|---|---|---|---|---|---|
| A. Cursor + Bright Data | 86 / 97 | 89% | 80% | 93% | 94% |
| B+. Claude Code + Bright Data、努力一致 | 85 / 97 | 88% | 86% | 93% | 85% |
| B+. Claude Code + Bright Data | 76 / 97 | 78% | 74% | 90% | 73% |
| Control. Cursor、データレイヤーなし | 72 / 97 | 74% | 66% | 93% | 67% |
| B. Claude Code、データレイヤーなし | 70 / 97 | 72% | 83% | 83% | 52% |
価格列の読み方
データレイヤーを持つ両方のアームは、持たない両方のアームより上位に終わりました。フィールドごとの列はリードがどこから来るかを示しており、価格列は何かを意味する前に慎重に読む必要があります:Aはスコアリング可能な35ページすべてで価格を試み、空白を残しませんでした。Bは31ページを試み、4ページを辞退しました。試みたページでは、Bは94%のスコアを得ますが、読み取れないページをスキップする実行は、より簡単なセットで採点されています。価格を表示するページでは、価格トラッカーは空白をミスとしてカウントします。その数では、Bは29値対28でまだ列をリードしており、4ページを辞退することで得た1値のリードです。価格はほぼ同等で、どちらのアームもそれを主張すべきではありません。
他の2つのフィールドがそれらを分離します。Aは評価を93%、可用性を94%で読み取ります。Bは83%と52%です。これらの小売業者では、評価と可用性はページの下の方とクライアントサイドレンダリングの背後にあるため、部分的なフェッチでは最初にそれらが失われます。データレイヤーはより良く読み取るのではなく、読み取るためにより多くのページを取得します。
回答キーへの修正
価格列は、ライブページを固定された回答キーに対してスコアリングするベンチマークの失敗モードを露わにしました。グラウンドトゥルースは実行の前日にキャプチャされたペイロードから裁定され、小売価格は変動します。5行では、価格を返したすべてのアームが新しい価格を返し、そのすべてが間違いとしてマークされたため、スコアボードはエージェントではなくカレンダーを測定していました。価格を持つすべてのアームが互いに一致し、私たちとのみ不一致であったため、実行ウィンドウからのページキャプチャに戻りました:
| 行 | 回答キー | ページが示したもの |
|---|---|---|
| S02 Walmart | $199.99、0ヒット | $225.00、9ヒット |
| S09 Amazon | $138.68、0ヒット | $129.99、14ヒット |
| S02 Best Buy | $242.00、なし | $238.99、あり |
| S06 Target | $18.99、なし | $19.49、あり |
| S09 Target | $136.22、なし | $143.30、あり |
5つすべてが証拠を添付してground_truth_hand.jsonで修正されています。修正は1つのアームではなくすべてのアームのスコアを上げました。これは自分の結果を美化するものではなく、実際の修正の1つの兆候です。保存された回答キーに対してスコアリングする場合は、両方にタイムスタンプを付け、すべての方法があなたに反対して一致する行を再確認してください。
努力:各コーディングエージェントが実際に費やすもの
2つのCLIは異なるものを報告するため、テーブルには推定値ではなくギャップがあります。Cursorはツール呼び出しを報告し、Claude Codeはターンとコストを報告します。ここで推定されているものは何もありません。
| A. Cursor + BD | Control. Cursor | B. Claude Code | B+. Claude Code + BD | |
|---|---|---|---|---|
| 実時間 | 3,281秒 | 3,183秒 | 1,054秒 | 1,650秒 |
| 個別ツール呼び出し | 196 | 178 | n/a | n/a |
| エージェントターン | n/a | n/a | 151 | 133 |
| 出力トークン | 報告なし | 報告なし | 68,106 | 72,422 |
| キャッシュ読み取りトークン | 報告なし | 報告なし | 12.3M | 13.3M |
| モデルコスト | 報告なし | 報告なし | $6.09 | $6.21 |
| 人間の介入 | 0 | 0 | 0 | 0 |
コスト、ターン、実時間
テーブルは3つの読み方を提供します。
このワークロードでは、データレイヤーはモデル料金においてほぼ無料でした。B+はBの$6.09に対して$6.21で、$6の実行において12セントの差があり、フィールド精度は6ポイント高くなりました。フェッチをサービスにオフロードするとトークンコストが増えるという直感はここでは成り立ちませんでした。なぜなら、費やしたトークンは取得方法ではなく読み取った内容に支配されていたからです。
B+はまた少ないターンで完了しました、151対133。これらの実行では、動作するフェッチを持つエージェントはターンを収集に費やし、持たないエージェントは診断、リトライ、回避策の記述に費やしました。ターンは従量課金プランで最初に枯渇するリソースであることが多く、データレイヤーはそれを12%節約しました。
Cursorペアでは実時間はほぼ同一です。実行Aは3,281秒で、Controlの3,183秒に対して3%の差があり、12ページ多く、15ポイント高い精度を得ました。Claude Codeペアは逆の方向に動きました:B+はBの1,054秒に対して1,650秒かかりました。そのエージェントではデータレイヤーが時間を節約しませんでした。Bが速かった部分の理由は、6ページ少なかったためです。節約した時間は、到達できなかった小売業者に費やさなかった時間です。
CursorのCLIはstream-jsonでドル数値を報告しないため、2つのCursor行にはコストがありません。推定はしません。
リフレッシュのコスト
Bright DataのWeb Unlockerは1,000リクエストあたり$1.5の従量課金制で、月5,000リクエストの無料ティアがあります。この料金では、固定リストの1回のリフレッシュは41リクエスト、約6セントで、これは推定ではなく算術です。1ヶ月の毎日のリフレッシュは約1,230リクエストで、無料ティアの4分の1です。
ベンチマークのアカウント合計は公開しません。実行は同じ期間に無関係な作業とアカウントを共有していたため、その日付の使用状況ビューでは分離できず、帰属できない数値は引用する価値がありません。
誰もスライドに載せないコーディングエージェントのコスト
ツール定義は人々が引用するコンテキストコストです:使用したプロファイルはサーバー自身のtools/listレスポンスに対してtiktokenでカウントされた5ツールで1,007トークンかかり、サーバーはより少ないプロファイルも公開しています。このようなワークロードでは、それは重要なコストではありません。同じエンコーダーを41のコミットされたペイロードに対して使用して、実際に返ってきたもののトークンをカウントしました。
| トークン | |
|---|---|
| ツール定義、セッションごとに1回 | 1,007 |
| 返ってきた41ページのマークダウン | 636,311 |
| それらのページが生成した回答 | 5,080 |
エージェントは5,080トークンを生成するために636,311トークンを読み取りました。読み取りに費やした99%は回答ではなく、ペイロードは測定対象のツール定義の632倍になりました。
負荷も非常に不均一です。小売業者別のページごとの中央値トークン:
| 小売業者 | ページごとの中央値トークン |
|---|---|
| Amazon | 63,920 |
| Newegg | 5,101 |
| Walmart | 2,060 |
| Best Buy | 1,789 |
| Target | 1,244 |
1つのAmazon製品ページは103,019トークンで返ってきました。1ページでコンテキストウィンドウの半分を埋めました。Amazonのページは1つのTargetページの51倍のコストがかかるため、リスト上の小売業者はその数よりもモデル料金にとって重要です。
これは上記のテーブルからの数値も説明します。両方のClaude Code実行は12Mを超えるキャッシュ読み取りトークンを費やしました。そのコストはモデルではなくページから来ています。
実際に運用するサイズでのコスト
41ページの実行はデモンストレーションです。バイヤーは1日100,000ページのコストを尋ねます。測定されたトークン数とBright Dataの公開料金を使用して、月300万リクエストで:
| 月あたり | |
|---|---|
| フェッチ、1,000あたり$1.5の従量課金制 | $4,500 |
| フェッチ、Scaleプラン$499プラス1,000あたり$1.3 | $3,901 |
| 読み取り、マークダウンとして中央値ページ | $22,833 |
| 読み取り、Amazonが多いカタログの場合 | $575,280 |
| 読み取り、構造化レコードとして | $1,115 |
モデル入力料金として100万トークンあたり$3.00を使用し、構造化行はエージェントが生成した同じ41行から測定されています。これらの前提を変更すると数値が変わります。そのためscripts/cost_model.pyには入力が上部に記載されています。
中間層の入力価格でマークダウンとしてモデルに提供すると、データの読み取りはフェッチの複数倍のコストがかかります、中央値ページで約6倍、Amazon加重リストではさらに多くなります。構造化レコードとしてはフェッチのコストを下回ります。マークダウンパスでは、スクレイピングベンダーを1,000リクエストあたりの価格で比較すると、請求書の小さい半分を測定することになります。
リストを見つけることと読むことは2つの異なる仕事です
タスクには2つ目の成果物があります:同じ製品を販売している他の小売業者を意味する新しいリストの検索駆動フィードです。すべての実行が1つ生成し、この2つ目の成果物は最初のものと明確に分離されます。
| 実行 | 見つかった新しい小売業者URL |
|---|---|
| A. Cursor + Bright Data | 46 |
| Control. Cursor、データレイヤーなし | 30 |
| B. Claude Code、データレイヤーなし | 24 |
| B+. Claude Code + Bright Data | 22 |
データレイヤーなしの両方を含むすべてのアームが使用可能なフィードを生成しました。テストした小売業者では、検索結果ページは製品ページのようにゲートされていなかったため、ディスカバリーには比較的少ない助けが必要で、何に費やすかを決める前にそれを知っておくべきです。
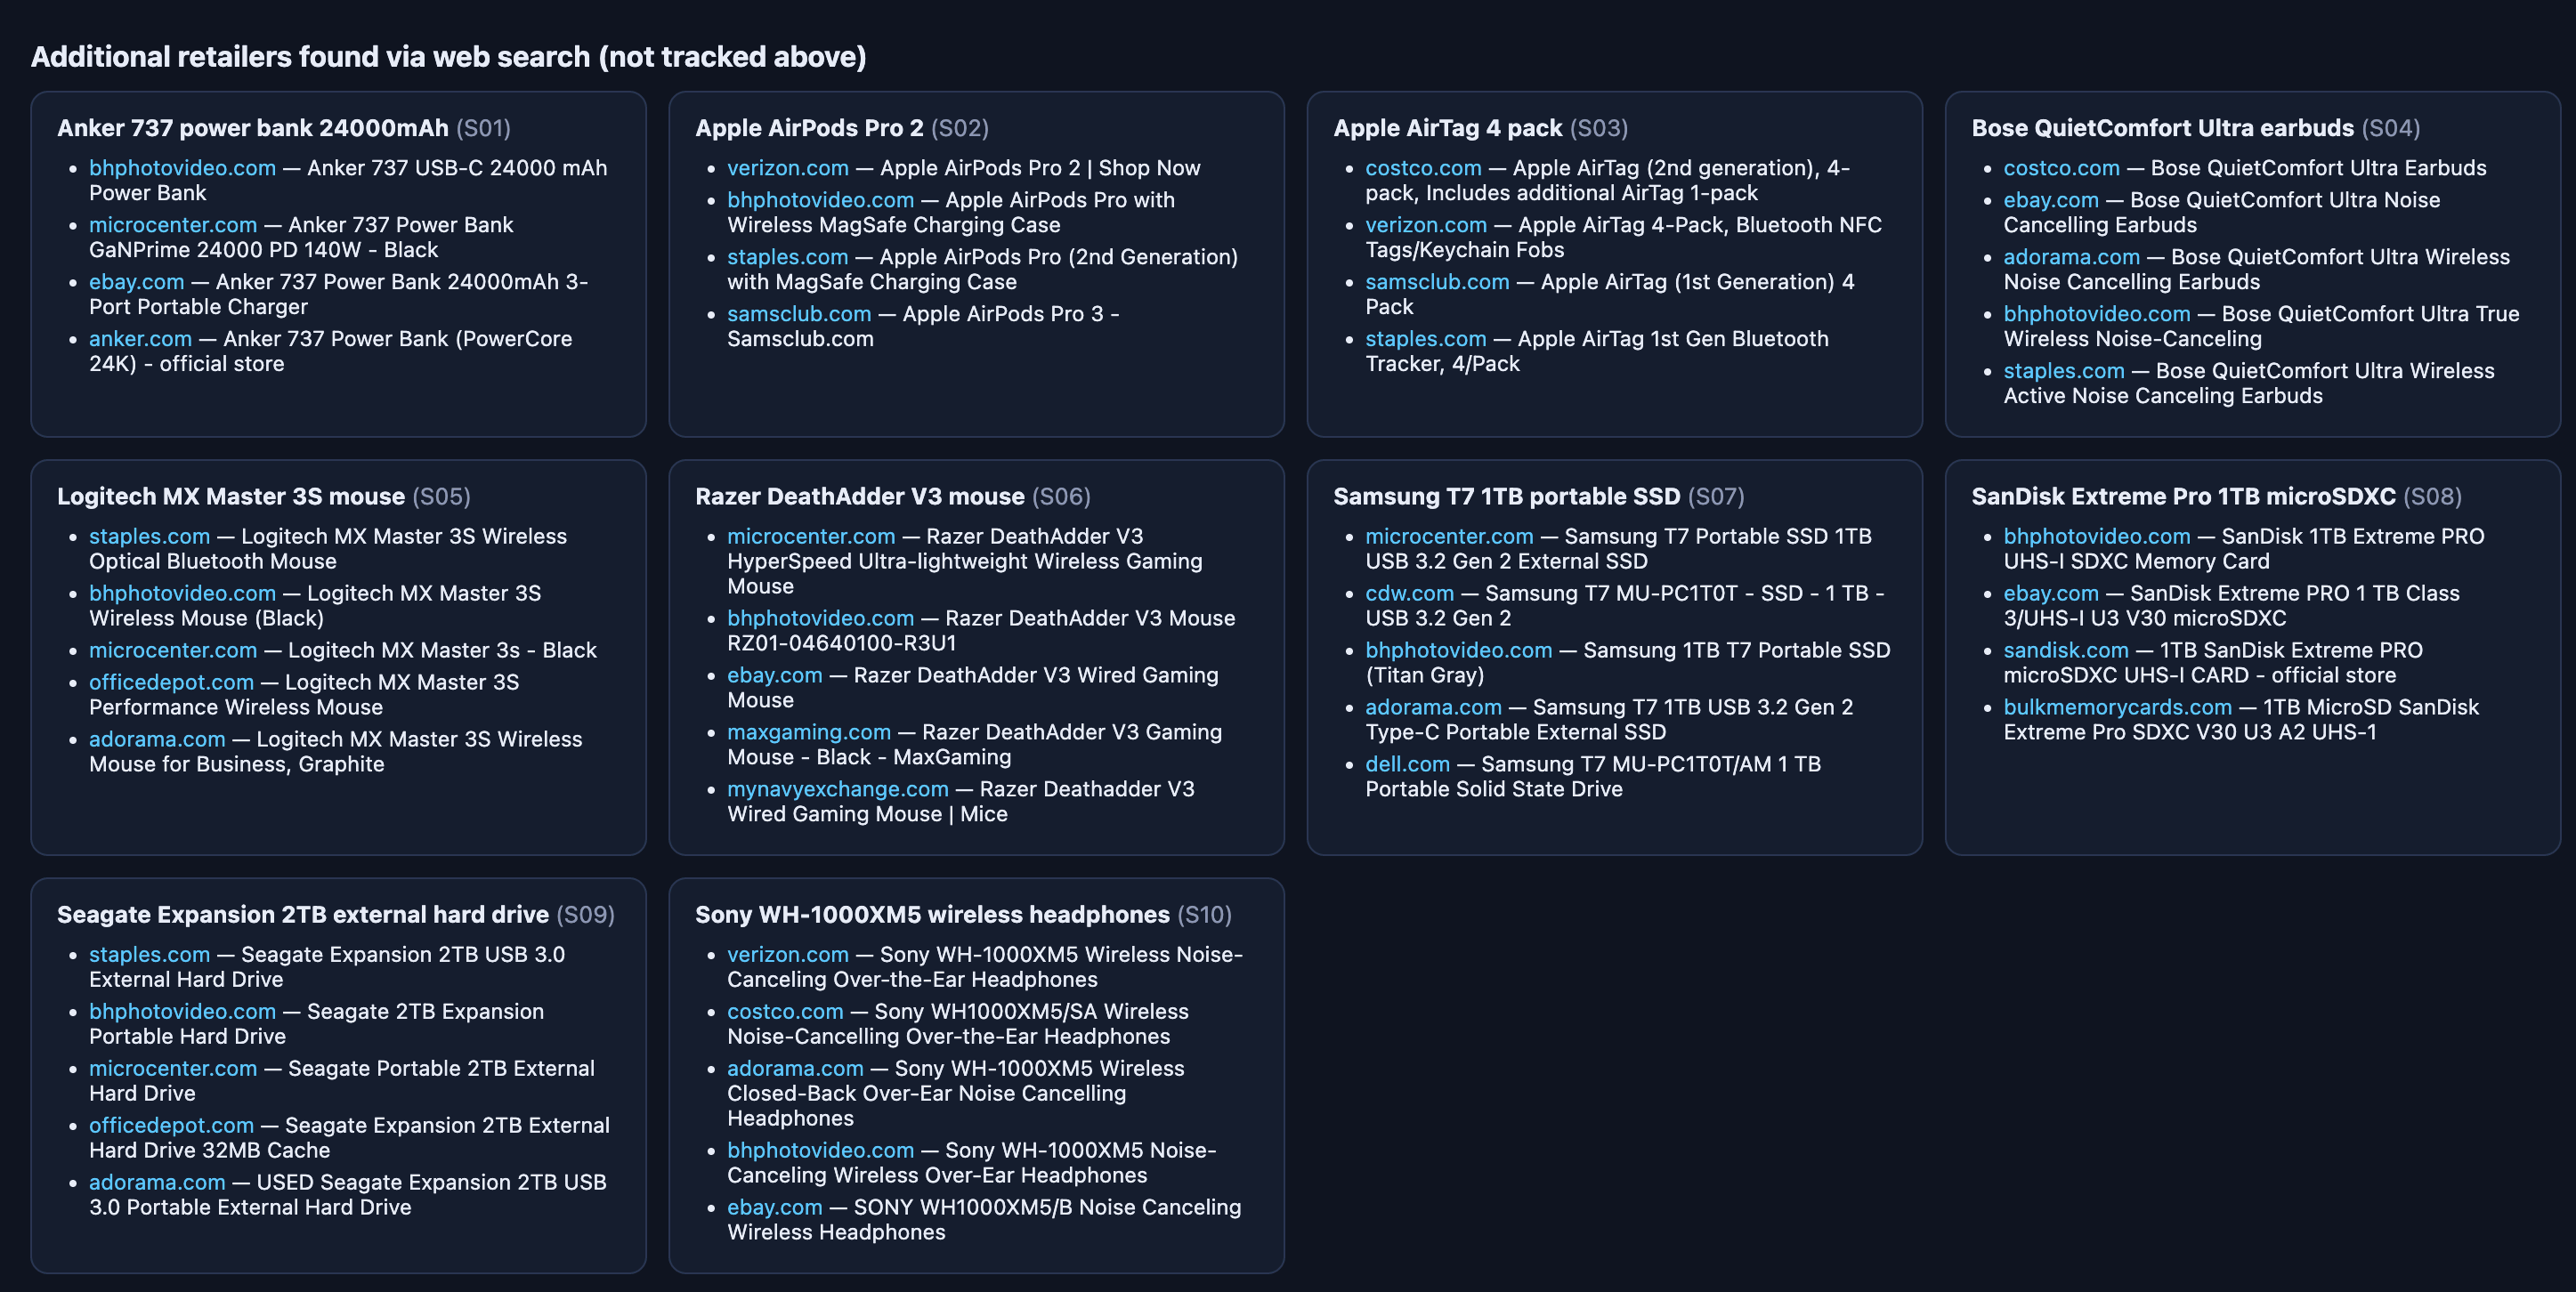
エージェントが構築したディスカバリーパネル、3製品のウォークスルーから。測定された実行のフィードは上のテーブルです。
これらの実行では、データレイヤーは次のステップでコストを正当化しました。見つけたものを開く必要があるところです。候補を見つけることとその価格を読み取ることは異なるコストを持つ異なる問題で、これらの小売業者では2番目のみが難しかったです。
必要なフィールドに出力形式を合わせる
ページを取得することとすべてのフィールドを取得することは異なる問題で、2番目は形式の決定です。
マークダウンは読み取り形式です:エージェント向けのクリーンな散文で、生のHTMLコストのわずかなトークン数で。41ページ全体で、Amazonで10ページ中10ページ、Walmartで10ページ中10ページ、Best Buyで9ページ中6ページで4つのフィールドすべてを提供しました。TargetとNeweggでは名前、価格、可用性を提供しましたが評価は提供せず、マークダウン変換はその理由ではありません。
これらの小売業者はほとんど評価をテキストとして公開しません。Neweggは星をイメージアイコンとして描画するため、数値の評価はいかなるテキスト形式でも5ページ中0ページに現れます。Targetは7ページ中2ページにあります。マークダウンはレンダリングされたページにテキストとして到達しない数値を抽出できません。このベンチマークのエージェントの1つはこの結論に促されることなく達し、自身のサマリーでそう述べました:「Neweggは星評価をイメージアイコンとしてのみレンダリングし、テキストとしてではないため、ページから抽出できません。」
型付きレコードを使用するタイミング
これは構造化レコードがカバーするケースです。Targetの7ページ中7ページとNeweggの5ページ中5ページで星評価を持ちます。なぜなら、値がレンダリングされたページにテキストとして到達しない場合でも、小売業者のデータに存在するからです。両方のルートは同じ接続を使用します。
習慣からではなく、必要なフィールドから出力形式を選択してください。エージェントにページを安価に読み取らせたい場合はマークダウンを使用してください。特定のフィールドができるだけ確実に到着する必要がある場合は型付きレコードを使用してください。
出力形式はまた、大規模で制御できる最大のコスト差でもあります。先ほど価格設定された月300万リクエストのボリュームで、マークダウンではなく型付きレコードとして読み取ると月$22,833対$1,115のコストになります。レコードはページ周辺ではなくフィールドを持つからです。これらの小売業者では型付きレコードはマークダウンが届かなかったフィールドを埋め、読み取りコストは20分の1でした。
明日も機能しますか?
耐久性は24時間の単一ウィンドウで測定されます。./rerun.shを使用して、同じ固定リストに対して両方のCursorトラッカーを手を加えずに再実行しました。1つのウィンドウはチェックポイントであり、そのように報告します。
| 小売業者 | A、Bright Data | Control、データレイヤーなし |
|---|---|---|
| Amazon | 9 → 9 | 3 → 3 |
| Walmart | 10 → 10 | 10 → 10 |
| Target | 7 → 7 | 7 → 7 |
| Newegg | 5 → 5 | 、 |
| Best Buy | 9 → 4 | 8 → 0 |
| 合計 | 40 → 35 | 28 → 20 |
Best Buy以外はすべて両方のアームで保持されました。他の4つの小売業者は、誰も手を加えなかったコードから前日と同じページ数を返しました。最も難しいターゲットが動き、両方で動きました。
最も難しい小売業者で生き残ったもの
2つのアームは生き残った量が異なります。管理されたパスはBest Buyの9ページ中4ページを保持しましたが、手書きのスクレイパーは0ページで、最初から収集が最も難しかった小売業者を失いました。全体的な保持率は88%対71%です。
その動きの一部はコレクションの問題ではまったくありません。手動で落とされたページの1つ、Best BuyのSony WH-1000XM5を開きました。小売業者自身が答えを出しています:「この商品は新品での販売は終了しました。」価格がないのは、もはや価格がないからです。その行にnullを返すトラッカーは正しく、他のどこかから埋めるトラッカーは先に説明した失敗モードです。1日後に価格トラッカーを再実行すると、変化の一部はコードではなく市場にあり、誰かがスクレイパーが劣化したと結論付ける前に2つを分離する価値があります。
確定した数値ではなく早期指標として読んでください。24時間のウィンドウは最も速く動く防御をキャッチし、それより遅いものはキャッチしないため、保持された4つの小売業者はまだ何も変更していないだけかもしれません。rerun.shと固定リストはリポジトリにあり、自分のスケジュールで自分のターゲットに対して同じチェックを実行できます。
これからさらに難しくなる理由
上記の測定値は1つの午後を説明しており、その背後にある条件は同じ方向を向く4つの方法で動いています。
Cloudflareは2026年7月に報告しましたインターネットトラフィックの半分以上が非人間であり、2026年6月時点でクローラーリクエストの52%がAIトレーニング向けで、2025年春の22%から増加しています。2026年9月15日から、Cloudflareに参加する新しいドメインはデフォルト設定を取得します:広告を表示するページでTrainingまたはAgentに分類されたボットをブロックし、Searchは引き続き許可します。
検出はページの下に移動しています。Akamaiは2026年8月に研究を発表し、エージェントブラウザエージェントリクエストの63.2%がマウスイベントをゼロ含んでおり、従来の行動モデルによってスコアリングされるのに十分な動きを持つのはわずか1.0%であることを発見しました。その研究のエージェントはスクレイパーではなく商業的なブラウジングエージェントでした。
一部の作業は逆方向に、隠れることではなくアイデンティティを証明することに向かっています。CloudflareとGoogleの著者によって起草されたWeb Bot Authは、2026年8月18日時点でdraft-meunier-webbotauth-httpsig-protocol-02にあり、エージェントが公開鍵でリクエストに署名できるようにします。これは採択された標準ではなく個別のインターネットドラフトで、CloudflareはEd25519のみを検証します。
4つ目は裁定からではなく法廷記録の詳細です。2026年8月4日に決定されたAmazon.com Services, LLC v. Perplexity AI, Inc.では、AIエージェントとして識別するユーザーエージェント文字列を送信しなかったエージェントが争点の中心でした。トラフィックがどのように自分自身を識別するかは、結果を持つ質問になっています。
4つすべてが同じ変数に関係します。どれもコーディングエージェントが書けるものを変えず、それぞれがリクエストの扱われ方に影響します。
次のステップ
開発者が数週間後に発見するバグ、悪いデータに基づいてすでに行った価格設定の決定、AI製品が完全な自信を持って繰り返す数値:3つすべてが、どこから来たかを判断する方法のない1つの値から始まる可能性があります。以下のステップはその値を本物の値から分離するのに役立ちます。
何かを測定する前にターゲットリストを固定してください。そうすることで、数値の変化は世界の変化を意味し、サンプルの変化ではありません。
完全性ではなく出所でスコアリングしてください。フィールドごとに、値が追跡していたページから来たかどうかを記録してください。この単一の列は、完璧に見えた実行と正直に不完全な実行を分離し、収集した他のどの指標もそれをキャッチしませんでした。
フィールドが出てきたかどうかでフェッチをスコアリングし、ステータスコードでは決してスコアリングせず、空のペイロードはどのレイヤーが生成したかに関わらず自分のコードの失敗として扱ってください。管理されたレイヤーを接続する場合は、ホストされたエンドポイントを呼び出しているのか、自分でサーバーを実行しているのかを知ってください。2つのパスは異なるネットワークを通過する可能性があり、アカウントのIP設定はそのうちの1つにのみ適用される可能性があります。
そして自分のターゲットを測定してください。私たちのものは1つの午後に5つの米国小売業者で、インドの接続と米国のレジデンシャル出口から、小売業者ごとの数値は集計がどの単一サイトについても何も言わないかを示しています。
リポジトリの内容
タスク仕様、正確なプロンプト、固定SKUリスト、4つのトランスクリプトすべて、生のページごとの結果、スコアリングコードがコンパニオンリポジトリに公開されており、自分のリストに対して同じことを実行できます。
そこにある1つのファイルは言及に値します。verify.pyはコミットされたデータから40の公開された数値を再導出し、ドラフトがまだそれらを述べているかチェックし、それらの40のいずれかがずれている場合は非ゼロで終了します。ネットワークも資格情報も不要です。ベアで実行すると、データから直接数値を出力します。記事ファイルを与えると、2つを互いにチェックします:
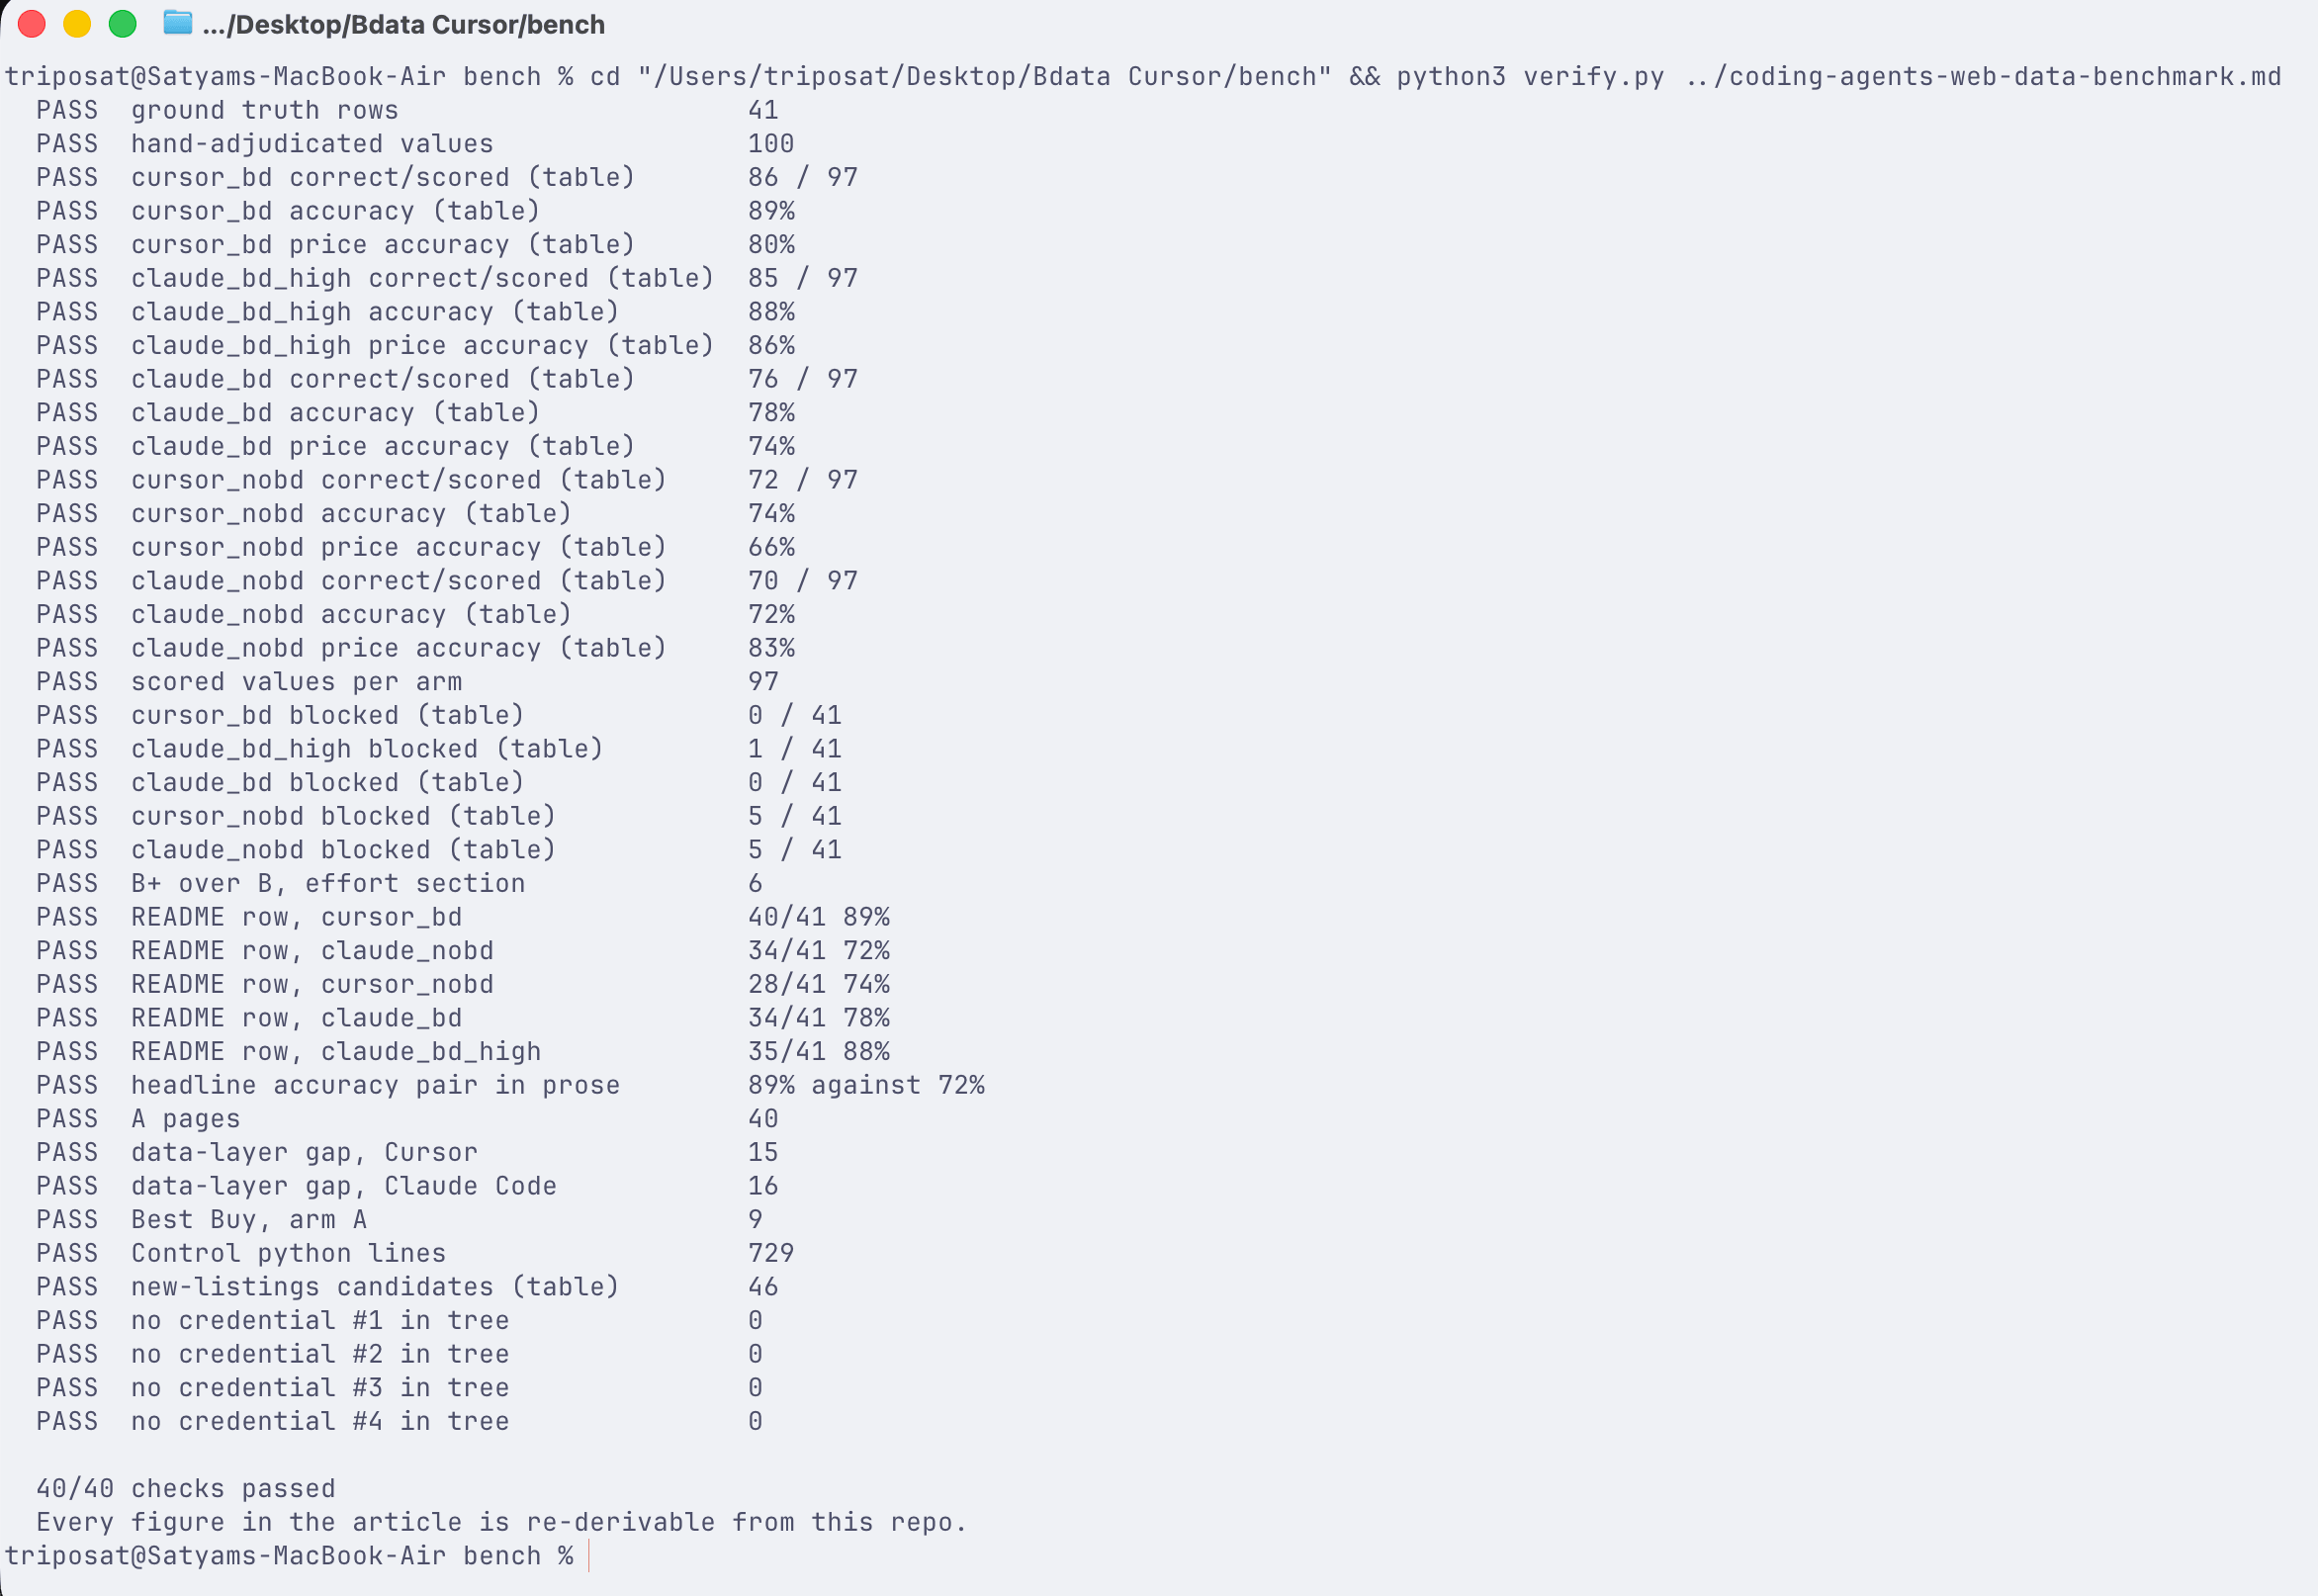
1つのコマンド、資格情報不要。テーブルを解析して特定のセルを比較するため、同じ数値が他の場所で正しく表示されていても、間違った数値は失敗します。
上記の数値もデータとして提供されます。claims.jsonはそのうちの39を、各値が導出されたファイルとそれを計算したスクリプトとともにリストアップしています:
{ "id": "cursor_bd.field_accuracy", "value": 89, "unit": "percent",
  "derived_from": "runs_isolated/cursor_bd/results.json",
"computed_by": "scripts/score_accuracy_iso.py" }ですから、私たちの言葉を鵜呑みにしないでください。自分のコーディングエージェントをリポジトリに向け、このページをデータと照合するよう依頼してください。それはベンチマークの公平なテストであり、ベンチマーク自体が測定するのと同じタスクです。
Bright Dataの無料ティアには月5,000件のWeb Unlockerリクエストが含まれており、41ページのリストの1回のリフレッシュはそのうちの41件です。ホストされたBright Data MCPサーバーを自分のターゲットに向け、これが自分にとっても成り立つかどうかを確認してください。
よくある質問
AIコーディングエージェントはスクレイピングにプロキシやアンブロッキングサービスが必要ですか?
難しいターゲットには必要で、測定されたギャップは大きいです。データレイヤーを使用した場合、同じクラスのエージェントが41ページ中40ページを89%のフィールド精度で読み取りましたが、なしでは34ページで72%でした。また、フェッチコードを一行も書かずにそれを実現しました。ただし、難易度は均一ではありません。現在のモデルが独自のブラウザを操作した場合、リスト内の簡単な小売業者は単独で処理でき、Walmartは10ページ中10ページ、Targetは7ページ中7ページを読み取りました。私たちの実行では最後の部分には届かず、そこに失敗とリトライのターンのほとんどが集中していました。アンブロッキングレイヤーが必要かどうかではなく、どのターゲットに必要か、そしてエンジニアリング時間の価値は何かを問うべきです。
スクレイピングされたデータが正確かどうかを確認するにはどうすればよいですか?
行が満たされているかどうかではなく、各値がどこから来たかを確認し、サンプルを手動でページと照合してください。このベンチマークでは、4回の実行のいずれもバックフィルを行いませんでした。データレイヤーなしの以前のClaude Codeの実行では、古いモデルで41ページ中41ページが完璧と報告されましたが、29件の評価は自分自身が書いたパッチスクリプトからハードコードされた製品レベルの値と等しくなっていました。両方のパターンが存在し、完全性スコアでは区別できず、確認にはわずか数行のコストがかかります。
ウェブスクレイピングAPIに期待できる成功率はどのくらいですか?
引用された成功率は保証ではなく測定値として扱ってください。このベンチマークの41ページ中40ページは、41ページ、1日、モデルをclaude-sonnet-5に固定した状態で、1つのネットワーク位置からの1回の観察です。24時間後に同じアームを再実行しても同一の数値は返りませんでしたが、これはライブページでは正常であり、予期すべきことです。あなた自身の数値はターゲットリストに依存するため、それに対して測定してください。
ウェブスクレイピングにBright Dataを使用するといくらかかりますか?
Web Unlockerは1,000リクエストあたり$1.5の従量課金制で、無料ティアでは月5,000リクエストが含まれます。41ページの1回のリフレッシュは41リクエスト、約6セントなので、このリストの毎日のリフレッシュは無料ティアの範囲内に十分収まります。ベンチマーク全体の合計は引用しません。同じ期間に無関係な作業とアカウントを共有していたため、その数値は帰属できません。グラウンドトゥルースの背後にあるスクレイピングブラウザのパスは、別のユニットの別製品です。