Pinterestのピン URLがあり、タイトル、説明、保存数を取得したいとします。それをスクレイピングするのにブラウザは不要です。ログアウト状態のピンページには、この3つすべてがJSON-LDブロックに含まれており、さらにピン投稿者とアウトバウンドリンクも含まれます。プロフィールとボードのRSSフィードは、通常のHTTPでピンURLを一覧表示します。
しかし、それらはいずれも検索には届きません。Pinterestは検索グリッドをブラウザ内で構築し、ログアウトした訪問者にはその上にログインモーダルを被せます。レンダリングされるタイルにはタイトルもリンクもありません。
このガイドでは、Pinterestをスクレイピングし、必要なすべての公開データを適切に取得する方法を説明します。
TL;DR
公開ピンは通常のHTTPでパースできますが、キーワード検索やプロフィール全体のクロールには管理型APIが必要です。
- 検索へのゲートはボットスコアではなくアカウント状態を読み取るため、ステルスブラウザを使っても何も変わりません。
- 古いガイドが失敗するのは2つの理由からです:
pinWrapperは何にも一致せず、レコードはReduxストアに存在しません。 - データセンターIPではピンページのJSON-LDブロックが取得できないため、レジデンシャルアドレスから実行してください。
- 1つのアカウントのボード全体に対して両方の無料手法を使った結果、9,000以上保存されているうち435件のユニークなピンに到達しました。
Pinterestから抽出できるもの
ピンのレコードには、タイトル、説明、画像または動画のURL、ハッシュタグ、カテゴリー、コメント数、ピン投稿者のプロフィールURLが含まれます。プロフィールにはフォロワー数、ボード名、ユーザーが公開したピンが一覧表示されます。
難しいのはデータモデルではなくアクセスです。Pinterestの開発者ガイドラインは「Pinterestから情報にアクセスするための自動化手段またはスクレイピング・データ抽出の形式」を禁止しています。robotsファイルはブロックリストではなく許可リストです。何百ものクローラーを個別に名指しし、User-agent: *にはDisallow: /を設定しています。名指しされていないクライアントはいずれも許可されていません。
したがって、公開データのみを収集し、リクエストレートを低く保ち、個人アカウントでログインして自動化しないようにしてください。ピン投稿者の名前とプロフィールURLはGDPRの下では個人データであり、同じガイドラインはPinterestの素材をAIモデルの訓練に使用することも禁止しています。それ以外のことについては、専門家にご相談ください。
ピンページが通常のHTTPに返すもの
すでに持っているピンURLに対しては、ブラウザは不要です。ログアウト状態のピンページにはJSON-LDのSocialMediaPostingブロックが埋め込まれており、そのブロックがそのままレコードです。
開始にはPython 3だけが必要で、それ以外は不要です。json、re、urllibはすべて標準ライブラリです。最初のpip installは、後でプロフィールをボードフィードに変換するときに出てきます。
このブロックをパースすれば、数行でピンのデータを取得できます:
import json, re, urllib.request

UA = ("Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 "
      "(KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36")
BOILERPLATE = "Discover (and save!) your own Pins"

def scrape_pin(url):
    req = urllib.request.Request(url, headers={"User-Agent": UA})
    resp = urllib.request.urlopen(req, timeout=30)
    html = resp.read().decode("utf-8", "ignore")
    block = re.search(
        r'<script[^>]*type="application/ld\+json"[^>]*>(.*?)</script>',
        html, re.S)
    if not block:            # deleted pin: no JSON-LD block on the page
        return None
    data = json.loads(block.group(1))

    # Recipe pins use name/description, everything else headline/articleBody
    description = data.get("articleBody") or data.get("description")
    if description and BOILERPLATE in description:
        description = None   # Pinterest filler text, not the pin's own words

    saves = next((s.get("userInteractionCount")
                  for s in data.get("interactionStatistic") or []), None)
    return {
        "schema": data.get("@type"),
        "title": data.get("headline") or data.get("name"),
        "description": description,
        "pinner": (data.get("author") or {}).get("name"),
        "image": data.get("image"),
        "date": data.get("datePublished"),
        "source_link": (data.get("sharedContent") or {}).get("url"),
        "saves": saves,
    }

if __name__ == "__main__":
    print(json.dumps(scrape_pin(
        "https://www.pinterest.com/pin/99360735523397542/"), indent=2))
実行すると、生きているピンは完全なレコードを返します:
{
  "schema": "SocialMediaPosting",
  "title": "12 Bombshell Hair Color Ideas To Try This Summer | Ecemella",
  "description": "A person with long, straight reddish-brown hair wearing a black leather jacket...",
  "pinner": "Sarah Komnick",
  "image": "https://i.pinimg.com/originals/0d/b9/56/0db956e2c07e1580514b1c19587b4152.jpg",
  "date": "2023-05-24T22:32:51.000Z",
  "source_link": "https://www.ecemella.com/summer-hair-color-ideas/",
  "saves": 196
}
これらすべてが1回のリクエストで得られます。
このレコードはJSON-LDブロックにあり、ページのReduxストアにはありません。2つ目のスクリプト__PWS_INITIAL_PROPS__はinitialReduxState.pinsを空のオブジェクトに設定します。ストアを読むスクレイパーは何も見つけられません。また削除されたピンにはJSON-LDブロックが一切ないため、scrape_pinは部分的なレコードではなくNoneを返します。
Pinterestは複数のJSON-LDタイプを配信しており、schemaを無視するとスクレイパーは静かに壊れます。105件のピンのうち、100件がSocialMediaPostingを返し、5件がRecipeを返しましたが、すべてにJSON-LDブロックが含まれていました。
この105件は2つのソースから来ました。90件は10アカウントのRSSフィードからで、動画ピンはまったく含まれていませんでした。残り15件はScraper APIを通じたキーワード検索からで、そのうち10件が動画でした。動画ピンも同じSocialMediaPostingスキーマを使用しており、エラーなくパースできます。
2つのスキーマの分かれ方は部分的ではなく完全であるため、見落としやすいです。90件のフィードサンプルでは、85件の通常投稿すべてにheadline、articleBody、datePublished、sharedContentが含まれており、5件のレシピはいずれもそれらを含んでいませんでした。レシピピンは代わりにnameとdescriptionを使用します。headlineだけを読むと、このカテゴリー全体で何も返らず、日付もアウトバウンドリンクも得られません。
動画ピンには別の問題があります。そのJSON-LDのimageは.jpgの静止フレームであり、ブロックにはcontentUrl、duration、embedUrlが含まれていません。
動画そのものはv1.pinimg.com上のHLSマニフェスト(HTTP Live Streamingのプレイリスト形式)です。これは構造化ブロックではなくページHTMLに現れるため、動画ピンは正常にパースされ、サムネイルを返します。Scraper APIからのレコードにはvideo_lengthとメディアURLが直接含まれており、2回目のリクエストなしで動画ピンを識別できます。
この割合はアカウントによって異なり、逆転することもあります。別にサンプリングした結果、ある料理アカウントのフィードは25件中19件がRecipeとして返されました。headlineだけのパースでは、そのうち4分の3が空のタイトルになっていたでしょう。レシピピンには、役立つ場合にrecipeYieldとaggregateRatingが追加されます。
レシピピンでは、descriptionはピン投稿者が書いたものではなく、Pinterestの定型文であることがよくあります。コードはこれをコンテンツとして扱わず、Noneを返します。
大量実行時に実際に壊れるもの
Pinterestはピンページの前にAkamaiを置いていますが、レスポンスにはBot Managerがそれらで作動していることを示すものは何もありません。デフォルトのurllib User-Agentで送信した12回の高速リクエストは、すべて200を返しました。レスポンスが設定したのはcsrftoken、_pinterest_sess、_auth、_routing_idだけでした。Akamai Bot Managerのクッキーはいずれも現れず、センサーペイロードも配信されなかったため、解くべきTLSチャレンジはありませんでした。
6種類のクライアントIDにわたって、同じピンは毎回JSON-LDブロックを返しました。これにはChromeのUser-Agent、curl、Googlebot、空文字列が含まれます。つまりパースに偽のUser-Agentは不要です。
これはレジデンシャルアドレスからの場合に成り立ちます。5件のピンにわたって、レジデンシャル経由の取得は毎回JSON-LDブロックを含み、データセンター経由の取得は一度も含みませんでした。どちらも正しいページ、正しいタイトル、同程度のスクリプト数を返しました。
Pinterestはこの違いをページ自体の中で、__PWS_DATA__内のcontextオブジェクトの下に表示しています。is_hostingはレジデンシャル側でfalse、ホスティング側でtrueと読み取れ、is_botはどちらもfalseでした。つまりこのテストはボットスコアではなくネットワークの評判です。
クラウドVMからscrape_pinを実行すると、テストしたすべてのピンでNoneが返り、その理由を示すものはページ上に何もありませんでした。フィンガープリンティング対策のクライアントを使っても、実行元のアドレスは変わりません。
トラフィックに課金が発生するようになると、HTTPクライアントの選択がこれらすべてよりも重要になります。標準ライブラリのurllibはAccept-Encodingヘッダーを送らないため、サーバーは非圧縮で返信します。標準ライブラリの例では、ピン1件あたり約1.13 MBをダウンロードします。
requestsライブラリはデフォルトでgzipを交渉し、約183 KBを転送します。Brotliを提供するブラウザは約124 KBです。これは同じページ、同じデータでありながら、選んだクライアントによって転送バイト数に9倍の差が出ます。
これが重要なのは、プロキシは転送バイト数に課金されるためです。10,000件のピンでは、標準ライブラリの例は11.3 GBを移動しますが、requestsを通した同じ作業では1.83 GBです。帯域幅の定価$8/GBでは、これは$15ではなく約$90になります。仕組みを学ぶには標準ライブラリ版を使い、実際に運用するものにはrequestsかcurl_cffiに切り替えてください。
大量実行時に悪化するのはIPの評判であり、あなたのTLSフィンガープリントではありません。したがって、レジデンシャルアドレスのローテーションはここで役立ちますが、フィンガープリンティング対策のクライアントはほとんど役立ちません。後で、ハンドシェイクを実際にチェックするPinterestのページを見つけた場合、curl_cffi(ライブラリドキュメント)が標準的な代替手段であり、パース処理には手を加える必要がありません:
from curl_cffi import requests as cffi   # pip install curl_cffi

resp = cffi.get("https://www.pinterest.com/pin/99360735523397542/",
                impersonate="chrome", timeout=30)
html = resp.text # feed this to the same JSON-LD parse2つの制限があります。Pinterestの内部エンドポイントへのアクセスは得られません。PinResourceは、通常のurllibにもChromeになりすましたクライアントにも403を返したため、そこではフィンガープリントが問題ではありません。また、JavaScriptチャレンジが配信された場合にはそれに答えることもできません。
公式のoEmbedエンドポイント
Pinterestは公開ピン向けにoEmbedエンドポイントを公開しています。これはここで最も軽量な単一ピンのルックアップであり、HTMLページではなくJSONで応答します。この呼び出しはcurlを使用します。macOS、Linux、Windows 10以降に標準搭載されています。URLをブラウザに直接貼り付けてまずテストすることもできます:
PIN="https://www.pinterest.com/pin/99360735523397542/"
curl "https://www.pinterest.com/oembed.json?url=$PIN"
帰属情報、サムネイル、作成済みの埋め込みコードを返します:
{"version":"1.0","type":"rich","provider_name":"Pinterest","title":" ",
 "author_name":"Sarah Komnick",
 "author_url":"https://www.pinterest.com/sarahkomnick/",
 "thumbnail_url":"https://i.pinimg.com/236x/0d/b9/56/0db956e2c07e1580514b1c19587b4152.jpg",
 "thumbnail_width":236,"thumbnail_height":314,
"html":"<iframe src=\"https://assets.pinterest.com/ext/embed.html?id=99360735523397542\" ...></iframe>"}自分で実行するルートの中では、これが最も露出が少ないものです。oEmbedは、サードパーティがコンテンツを埋め込めるようサイトが公開する標準フォーマットです。これは内部APIではなく、公開されたインターフェースです。
ピンだけでなく、ボードとプロフィールのURLも受け付けます。どちらに対しても実際のタイトルを返しましたが、ピン呼び出しでは空のままでした。説明、保存数、アウトバウンドのソースリンクはレスポンスに含まれません。
Pinterestはピンページに対してソフト404を返します。削除されたピン、存在しない数値ID、不正な形式のスラッグはいずれもHTTP 200を返しました。切り詰められたIDと未使用の数値IDも同様で、いずれもJSON-LDブロックが欠落していました。response.statusに基づくチェックは何も測定していないことになります。
oEmbedエンドポイントは代わりにHTTP 400で応答します。これはその5つのケースすべてで起こり、生きているピンは200を返しました。
19件のピンにわたって中央値583バイトを転送し、ページの約124 KBと比較しても安価です。これにより、何かをパースする前にURLリストをフィルタリングする安価な方法になります。遅延なしで連続した80回の呼び出しはすべて200を返し、レート制限も遅延の変化もありませんでした。
検索グリッドなしでピンURLを発見する
JSON-LDパースもoEmbedも、すでに持っているピンURLが必要です。では、そのURLはどこから来るのでしょうか?
1つのルートは明らかに見えますが、実はそうではありません。チェック時点で、Pinterestのrobotsファイルは/v3_sitemaps/の下に50個のSitemap: URLを宣言していました。名前はコレクターが欲しがるものをまさに説明しています:image_pin_sitemap_recent_engagement_tier_1、video_product_pin_sitemap、複数階層のボードリンクサイトマップなどです。この50個すべてがHTTP 404を返しました。
宣言されたサイトマップは、信頼する前に1回リクエストしてみる価値があります。
プロフィールやボードについては、URLはRSSから得られます。Pinterestは今でも/<username>/feed.rssと/<username>/<board-slug>.rssで認証不要のフィードを公開しています:
import re, urllib.request
import xml.etree.ElementTree as ET

UA = ("Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 "
      "(KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36")

def list_pins(feed_url):
    req = urllib.request.Request(feed_url, headers={"User-Agent": UA})
    xml = urllib.request.urlopen(req, timeout=30).read()
    pins = []
    for item in ET.fromstring(xml).findall(".//item"):
        desc = item.findtext("description") or ""
        thumb = re.search(r'src="([^"]+)"', desc)
        pins.append({
            "url": item.findtext("link"),
            "published": item.findtext("pubDate"),
            "thumbnail": thumb.group(1) if thumb else None,
        })
    return pins

if __name__ == "__main__":
    feed = list_pins("https://www.pinterest.com/boredpanda/animals.rss")
    print(f"found {len(feed)} pins")
    print(feed[0])
あるボードフィードは、実際のピンURLの使えるリストを返しました:
found 26 pins
{'url': 'https://www.pinterest.com/pin/150307706316766946/',
 'published': 'Thu, 23 Jul 2026 12:14:04 GMT',
'thumbnail': 'https://i.pinimg.com/236x/18/a4/8b/18a48b04fbe868130b0a2ad14759fe87.jpg'}こうしたフィードURLの1つをブラウザで開くと、構造は読みやすいです。各<item>には、ピンのリンク、投稿日、説明内のサムネイルが含まれています:
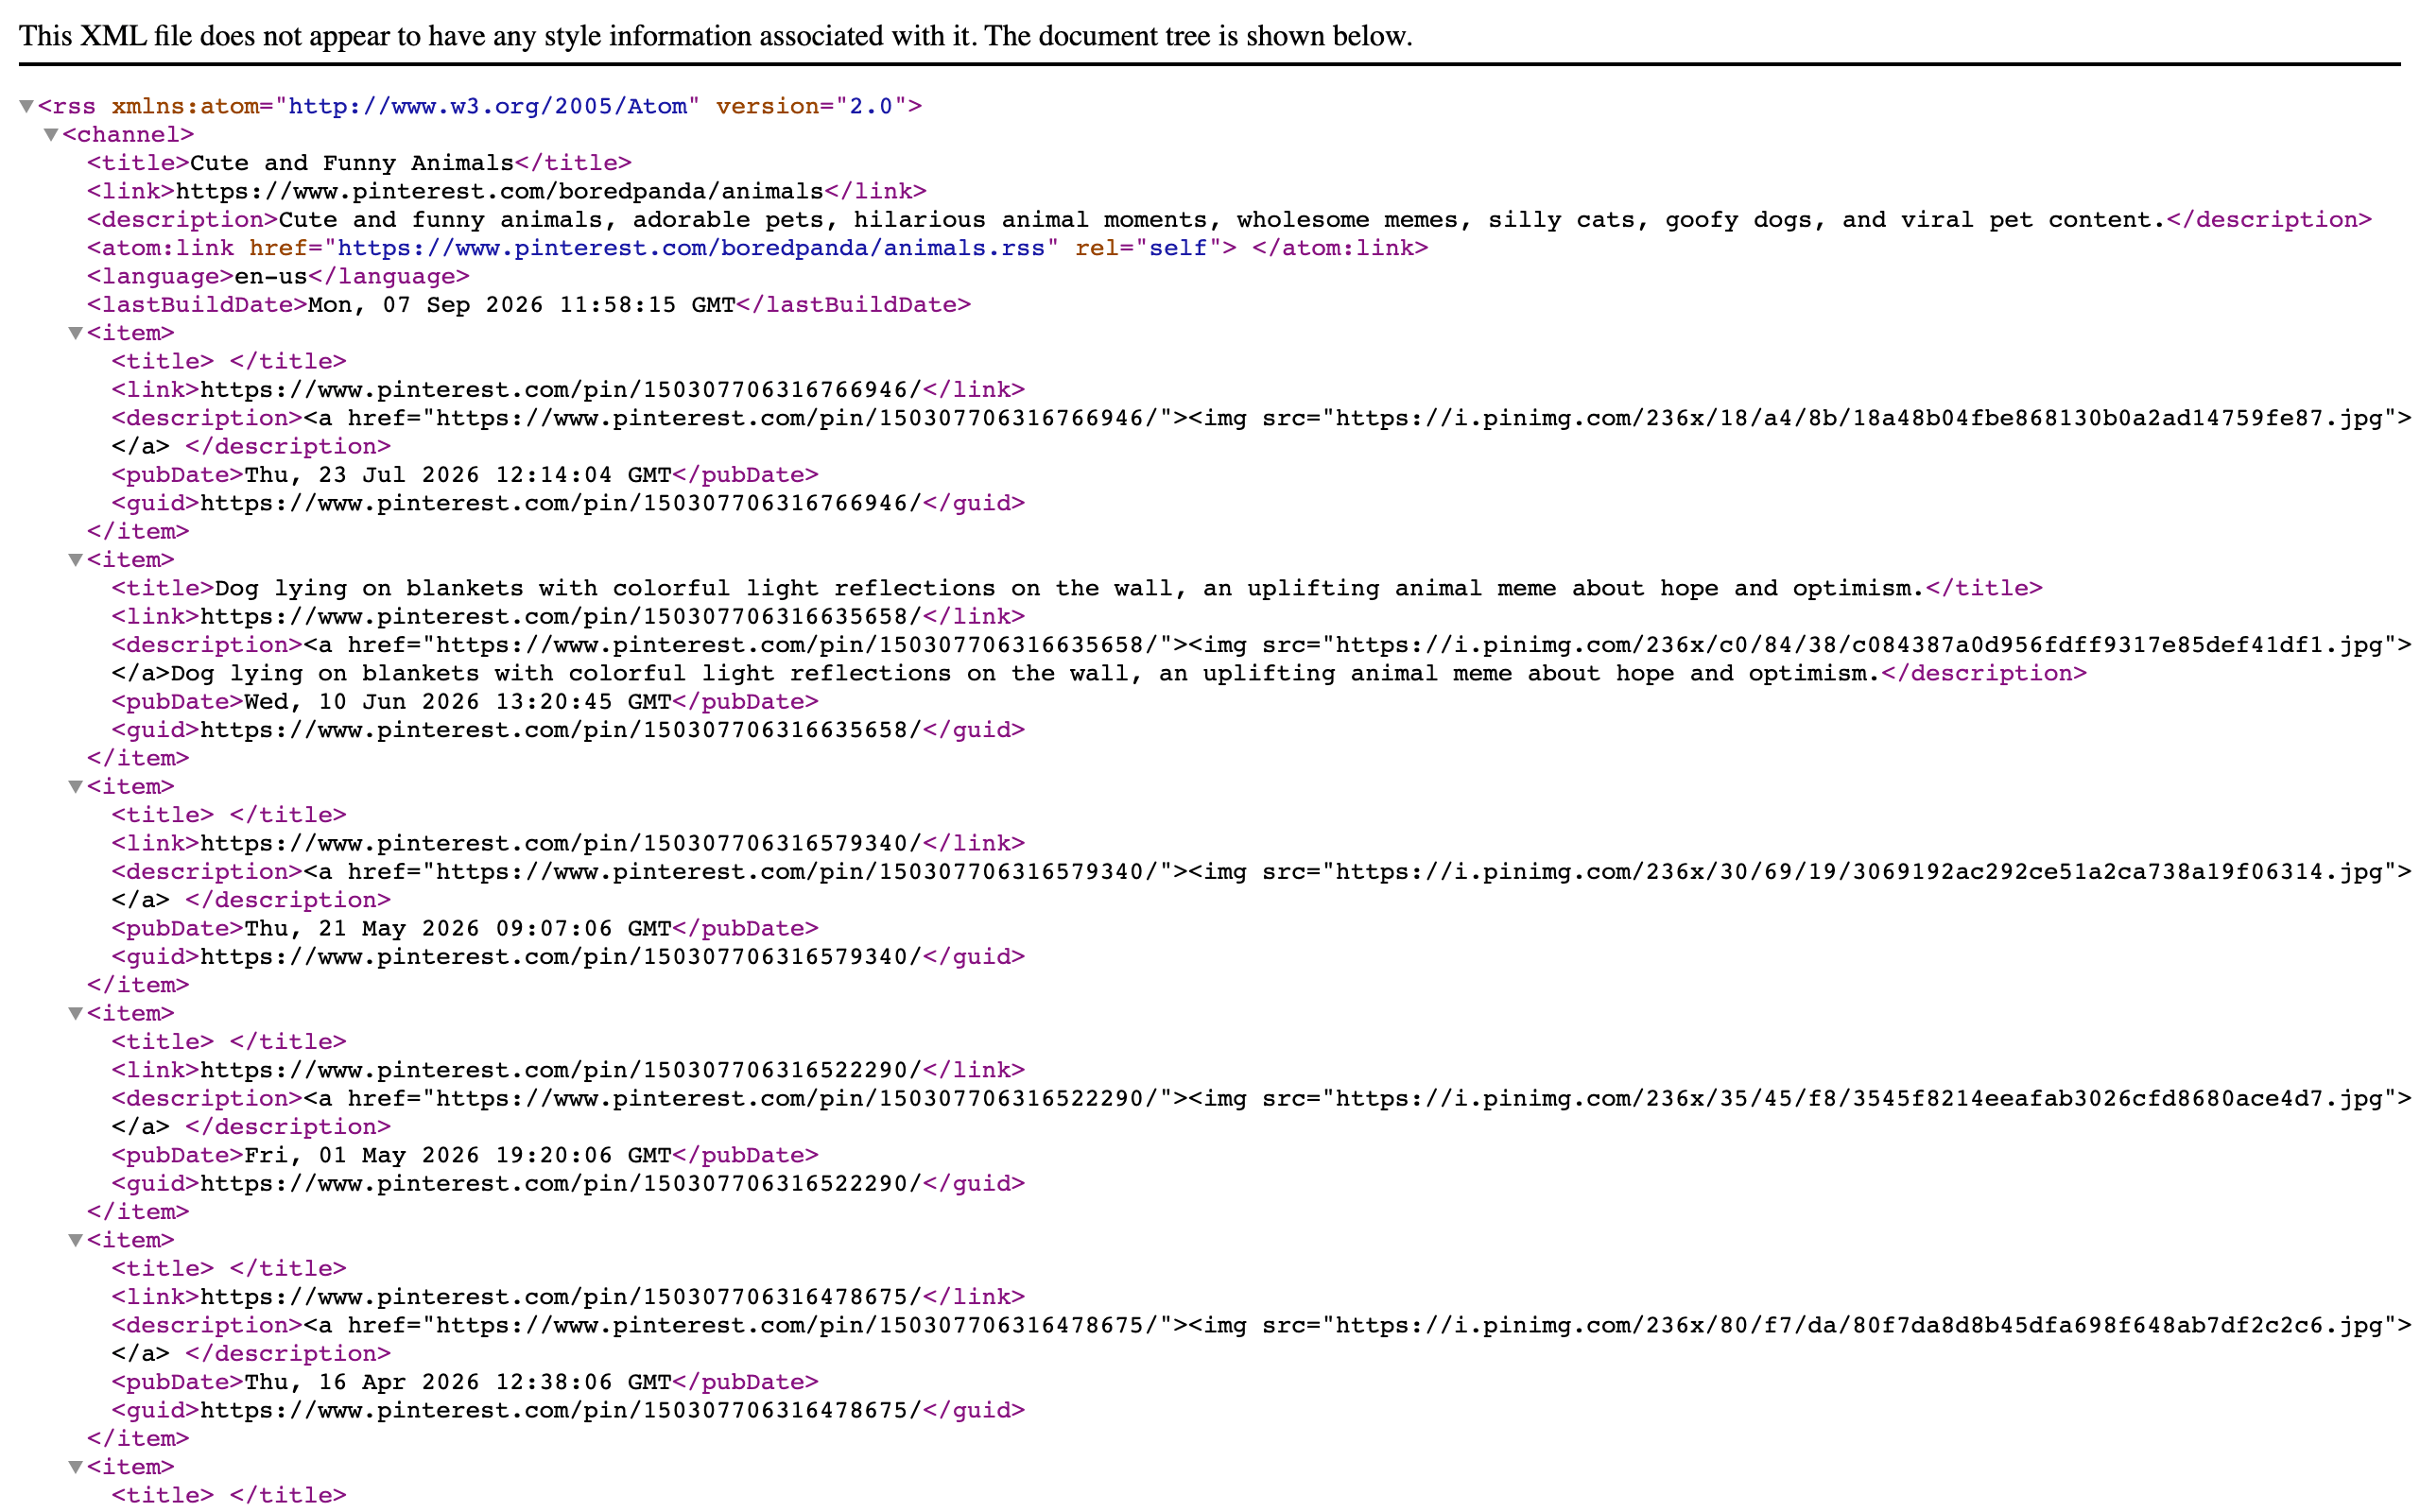
空の<title>タグこそが、このフィードがメタデータではなくURLの情報源となる理由です。このフィードの1項目には実際のタイトルがありますが、残りは空白です。
これをピンごとのパースと連結させることで、ブラウザを一切読み込まない完全なパイプラインが得られます。scrape_pinとlist_pinsを一緒にpinterest.pyとして保存すれば、以下はそれらを変更せずにインポートします:
import time, json
import xml.etree.ElementTree as ET
from pinterest import scrape_pin, list_pins   # from pinterest.py

def collect_feed(feed_url, delay=0.5):
    records = []
    try:
        pins = list_pins(feed_url)
    except (OSError, ET.ParseError) as err:   # skip a bad feed, keep going
        print(f"skipped feed {feed_url}: {err}")
        return records
    for pin in pins:
        time.sleep(delay)         # before the request, so skips stay polite too
        try:
            record = scrape_pin(pin["url"])
        except (OSError, ValueError) as err:  # transient: keep what you have
            print(f"skipped {pin['url']}: {err}")
            continue
        if record is None:        # deleted pin: the page soft-404s to 200
            continue
        record["url"] = pin["url"]
        record["feed_published"] = pin["published"]
        records.append(record)
    return records

rows = collect_feed("https://www.pinterest.com/foodnetwork/feed.rss")
print(f"{len(rows)} pins enriched")
with open("feed-pins.json", "w") as f:
json.dump(rows, f, indent=2)ある料理アカウントでは、46秒で25 pins enrichedと表示されました。25件すべてにタイトルがあり、スキーマの内訳はレシピ19件、通常投稿6件でした。フィードは、個人クリエイターから大手ブランドまで、テストした12アカウントすべてで利用可能でした。プロフィールフィードは22〜25件、ボードフィードは23〜26件を返しました。
フィードには、ボードの規模に応じて増える上限ではなく、固定された上限があります。約6,000件のピンを持つとされるボードは24項目を返しましたが、これは39件保持するボードと同じでした。この上限を下回る場合は、実際にあるものに近い数が得られます。6件のピンを保有するボードは5件を返しました。
プロフィールを複数のボードフィードに変換する
1つのアカウントには複数のフィードがあり、プロフィールページはそれらをログイン不要で、名前とピン数とともに公開しています:
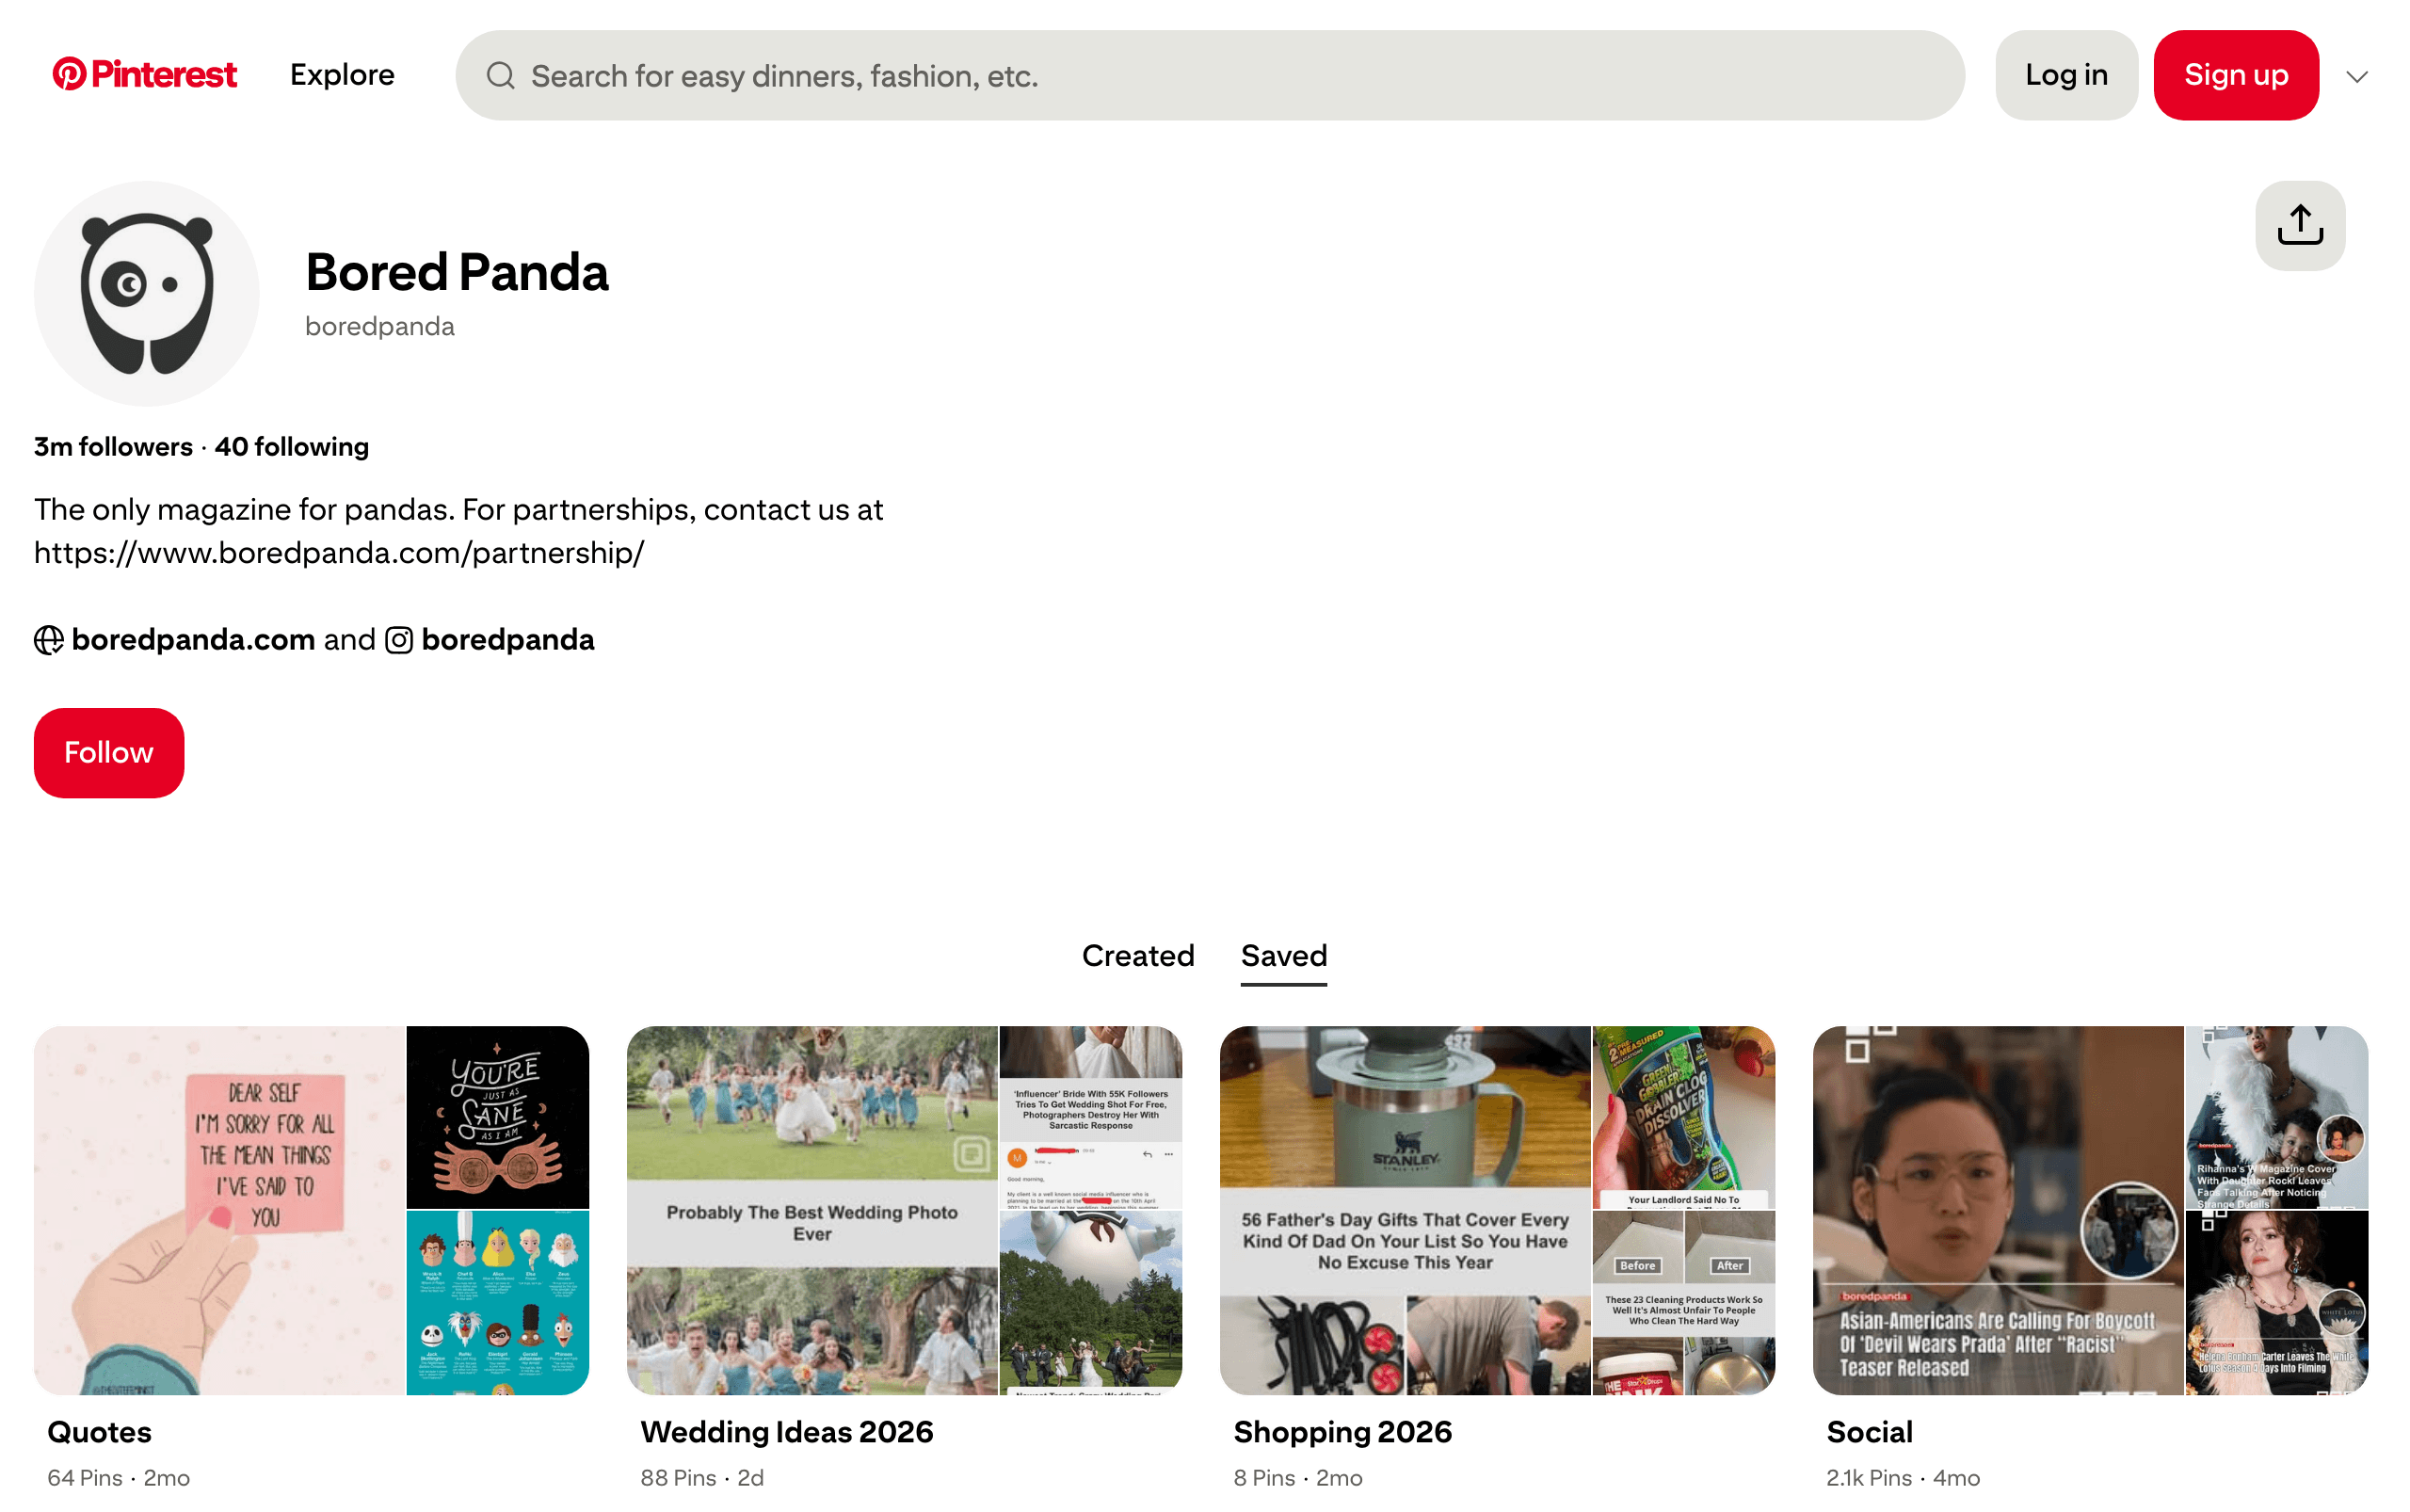
検索にはログインモーダルがかかりますが、プロフィールにはかかりません。これらのボード名は、list_boardsがページHTMLから読み取るスラッグです。ピン数を見れば、どのボードがフィードの上限に達し、どのボードがそのほとんどを返せるほど小さいかがわかります。
ボードのスラッグは通常、プロフィールHTML内に通常のHTTPで現れるため、正規表現でアカウント名を一連のフィードURLに変換できます:
import re, requests            # pip install requests

UA = ("Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 "
      "(KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36")
RESERVED = {"pins", "boards", "followers", "following"}   # routes, not boards

def list_boards(handle):
    html = requests.get(f"https://www.pinterest.com/{handle}/",
                        headers={"User-Agent": UA}, timeout=30).text
    found = re.findall(rf'"/{handle}/([A-Za-z0-9][A-Za-z0-9_-]*)/"', html)
    slugs = set(found) - RESERVED
    base = f"https://www.pinterest.com/{handle}"
    return [f"{base}/{s}.rss" for s in sorted(slugs)]

feeds = list_boards("boredpanda")
print(f"{len(feeds)} board feeds")
print(feeds[0])
あるアカウントは9つのボードフィードを返しました:
9 board feeds
https://www.pinterest.com/boredpanda/animal-memes.rssボード一覧とともに、ログアウトしたプロフィールHTMLにはProfilePageのJSON-LDブロックが埋め込まれています。テストした8アカウントすべてでパースできました。
これは表示名、ハンドル、プロフィール文、アバターURL、アカウントの作成日を提供します。sameAs配列は所有者の他のプロフィールを指しており、これらのアカウントではInstagramと自社ドメインを意味していました。8件のうち6件はinteractionStatisticの下にフォロワー数も含んでおり、Etsyの場合は1,100万を超えていました。これはピンページと同じパース処理を、別のURLに対して行っているだけです。
9つのボードフィードすべてをlist_pinsに通すと、boredpandaから208件のユニークなピンURLが返り、単一フィードの25件と比較されます。どのピンも2つのボードフィードに重複して現れませんでした。テストしたすべてのアカウントがこの方法でボードを一覧表示していました:10件中10件、それぞれ8〜10個のスラッグでした。最初のボードのフィードは、10件すべてで項目を返しました。
これら9つは、プロフィールページが表示するボードであり、アカウントの完全なセットではありません。APIのプロフィールレコードは、同じアカウントについて51と報告しています。通常のHTTPでは、その51のうち9に到達し、それぞれが同じ25項目の上限を通ります。
先に使ったanimalsフィードはこれが見逃すものの1つなので、すでに知っているボードでも直接リクエストする価値があります。実在のプロフィールがスラッグをまったく返さないこともあり得ます。空のリストは、アカウントにボードがないことの証拠としてではなく、ハンドルを確認すべき合図として扱ってください。
テストしたフィード全体で、1項目を除いてフィードのタイトルはすべて空でした。残りはピンごとのパースに任せましょう。
フィードの上限を超える2つのルート
Scraper APIのプロフィールスクレイパーは、逆方向からボード一覧に到達します。boards_numはboredpandaについて51のボードを報告したので、着手する前にセットの大きさがわかります。
そのsaved配列内のすべてのエントリにはsaved_collection_urlが含まれており、そのURLに.rssを付けると、テストした6つのボードすべてでフィードが返りました。配列自体はその51のうち10を返し、別の部分的なリストでした。
追加する前に末尾のスラッシュを取り除いてください。saved_collection_urlは末尾にスラッシュがあり、Pinterestはその結果できる2つの形式を大きく異なる扱いをします。quotes.rssで終わる場合は13 KBのフィードを返します。
quotes/.rssで終わる場合は、代わりにHTTP 200とHTMLアプリを返します。これはXMLパーサー内で、JavaScriptの行を指す無効トークンエラーで失敗します。URLをsaved_collection_url.rstrip("/") + ".rss"で構築すれば、その形式がパーサーに届くことはありません。
widgets.pinterest.com/v3/pidgets/にある旧式のウィジェットバックエンドも認証なしのリクエストに応答し、ほとんどのボードでRSSよりも多くを返しました。そのボードエンドポイントは、同じボードのフィードが26件返すところ、50件のピンを返し、それぞれに説明が付いていました。これはボードレベルのpin_countも報告するため、見逃しているものの規模を把握できます。
50はページサイズではなく上限です。page、offset、limit、count、page_sizeはすべて無視され、それぞれ同じ50を返しました。boredpandaの9つのボードにわたって、ウィジェットバックエンドは362件のユニークなピンに到達し、ボードフィードからの208件と比較されます。両方を合わせると、それらのボードに保存されている9,000件以上のうち435件に到達しました。
依存する前に3点注意してください。repin_countはJSON-LDの保存数ではありません。このガイドを通じて使用したピンで両方を照合すると、JSON-LDが196を返したのに対し、こちらは77を返しました。PinterestがSavesとラベル付けしているのはJSON-LDの数値だけです。
アウトバウンドリンクはボードによって異なります。あるボードでは50件中50件、別のボードでは43件中5件でした。説明はほぼすべてのピンに含まれていました。そして常に優れているわけではありません。ある小さなボードでは、RSSが8件に対して9件を返しました。このエンドポイントは文書化されておらず、検索機能もなく、互換性の保証もありません。
その50件目を超えて、またはスケジュールに沿って収集するには、Scraper APIのプロフィールクロールがアカウント全体をバックグラウンドジョブとして実行します。見つかった各ピンについて構造化レコードを返します。
Scraper APIでの発見はプロフィールレベルで動作するため、プロフィールURLを渡し、欲しいボードにレコードをフィルタリングしてください。テストした2つのボードでは、ボードURLを渡してもリクエストで指定したボードではなくプロフィールが返されました。
無料手法が検索で止まる理由
検索結果ページを取得しても、HTMLにJSON-LDブロックはゼロです。グリッドは後から行われるブラウザのリクエストで構築され、それらはログアウト中のセッションに対してゲートが設けられています。2026年9月時点で、__PWS_DATA__ブロックには10個のlop_unauth_lockdown_*実験が記載されており、その中には_main、_closeup、_searchが含まれます。
この10個のうち2個が、このガイドで使用するルートを指しています:lop_unauth_lockdown_profileとlop_unauth_lockdown_boardです。ログアウト中のゲーティングは実行中の実験であり、サイトの恒久的な一部ではありません。そのため、プロフィールとボードへのアクセスは、前提とすべきものではなく、監視すべきものとして扱ってください。
同じブロックが、ゲートが何をチェックしているかを示しています。Pinterestは自社のクライアント観測結果をその中に記録しているためです。contextの下で、ピン、検索、プロフィールページはすべて同じ15のクラス分類フィールドを含んでいます。これにはis_bot、is_proxy、is_vpn、is_tor、is_hosting、is_unauth_botspam_asn、is_authenticatedが含まれます。
通常のレジデンシャルアドレスからリクエストすると、is_botは"false"を返し、すべてのプロキシおよびホスティングフラグはfalseを返しました。それでも検索グリッドにはゲートがかかっていました。ロックダウン実験が読んでいるのはログアウト状態であり、ボットスコアではありません。
is_hostingは、ピンのJSON-LDを返した取得と、それなしで届いた取得とを区別するものでした。そのため、単一のピンページの<script id="__PWS_DATA__">タグからcontextを読み取ってください。これが、収集元のアドレスが期待どおりに見えているかを確認する最も安価な方法です。パーサーのせいでレコード数が少ないと思い込んで実行を無駄にする前に、これを行ってください。
これは文書化されていない内部的なものであり、Pinterestが約束しているものではないため、繰り返し行うチェックとして扱ってください。このオブジェクトにはunauth_idとあなたのIPの国と地域も含まれています。データがマシンから出る前にそれらをマスクしてください。
そのチェックは、もう一方のスクリプトタグを対象にしたJSON-LDパースです:
import json, re, urllib.request

UA = ("Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 "
      "(KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36")
FLAGS = ("is_bot", "is_proxy", "is_vpn", "is_tor", "is_hosting",
         "is_unauth_botspam_asn", "is_authenticated")

def how_pinterest_sees_you(url):
    req = urllib.request.Request(url, headers={"User-Agent": UA})
    resp = urllib.request.urlopen(req, timeout=30)
    html = resp.read().decode("utf-8", "ignore")
    block = re.search(
        r'<script id="__PWS_DATA__" type="application/json">(.*?)</script>',
        html, re.S)
    if not block:
        return None
    ctx = json.loads(block.group(1)).get("context") or {}
    # this object also holds unauth_id and your IP geo: don't return those
    return {k: ctx.get(k) for k in FLAGS}

print(how_pinterest_sees_you(
    "https://www.pinterest.com/pin/99360735523397542/"))
自宅の回線とクラウドVMから実行すると、1つのフィールドが変化します:
# residential
{'is_bot': 'false', 'is_proxy': False, 'is_vpn': False, 'is_tor': False,
 'is_hosting': False, 'is_unauth_botspam_asn': False, 'is_authenticated': False}

# same pin, same parse, hosting range
{'is_bot': 'false', 'is_proxy': False, 'is_vpn': False, 'is_tor': False,
'is_hosting': True, 'is_unauth_botspam_asn': False, 'is_authenticated': False}is_botは文字列"false"として届きますが、他のフラグは実際の真偽値であるため、文字列として比較してください。is_hostingが変化するフィールドであり、それがピンページにJSON-LDブロックが含まれるかどうかを決めます。
古いガイドが呼び出す内部JSONエンドポイントは、1つずつではなくクラスとして閉じられています。PinResource、BoardFeedResource、UserResource、BaseSearchResource、RelatedModulesResourceは、認証なしのリクエストにすべてHTTP 403を返しました。これは、実際のブラウザに一致するTLSフィンガープリントの有無にかかわらず真でした。
リクエストはCDNとしてのAkamaiを経由します。検索ページとプロフィールページでの同じクッキーチェックでも、Bot Managerのマーカーはまったく示されませんでした。
公式のPinterest APIがスクレイピングツールでない理由
PinterestはREST APIを運用しており、まずそれを試したくなるのも当然です。しかし、有用な規模で公開コンテンツを収集することはできません。その理由は品質ではなく範囲にあります。
API v5は、自分自身のアカウントを管理するために構築されています:自分のボード、自分のピン、自分の広告、自分の分析です。org_readカテゴリーは、認証済みアカウントの「ユーザーアカウント、ボード、ボードセクション、ピンの取得」に適用されます。パートナー検索ベータを除けば、あなたが所有していない公開ピンを返すエンドポイントはありません。
唯一のキーワード検索はGET /v5/search/partner/pinsで、「すべてのアプリで利用可能ではない」ベータ版で、上位10件のピンを返します。ほとんどのスクレイピングプロジェクトが欲しがるデータ、つまり他人の公開ピンとプロフィールには、APIを通じてアクセスできません。
同じページはレート制限も公開しています。2026年9月時点で、トライアルアクセスはすべてのエンドポイントを合わせて1日1,000リクエストに制限されていました。スタンダードアクセスはアプリごと、ユーザーごとに毎秒100リクエストでした。Pinterestはそこで、これらすべてが「予告なく変更される可能性がある」と注記しています。
規模を伴うサードパーティの公開データに対しては、公式APIは適切なツールではありません。したがって、通常のHTTPルートを超える収集には、ブラウザ自動化か管理型スクレイパーが必要になります。
PlaywrightでPinterestをスクレイピングする
検索は、ページをレンダリングするためにブラウザが必要な唯一のルートであり、PlaywrightはPythonからブラウザを操作します。初めて使う場合は、Bright Dataブログに同じ使い方のAPIを解説したより詳しいPlaywrightの解説記事があります。
インストールする前に、このルートが何を返すかを知っておいてください:画像URLのみで、タイトル、説明、ピンリンクは一切ありません。それがあなたのユースケースに不十分なら、「ブラウザアプローチが破綻する箇所」を読んでインストールをスキップしてください。
ライブラリとブラウザをインストールします:
pip install playwright
playwright install chromiumこのスクリプトは検索ページを開き、スクロールして、ピンのタイルを読み取ります。まず重要な点があります:タイルのセレクタが変わりました。古いガイドはdiv[data-test-id='pinWrapper']をターゲットにしていますが、今日のログアウト状態のサイトでは何にも一致しません。現在のログアウト状態のグリッドでは、各タイルにgated-pin-rep、その画像にgated-pin-imageを使用しています:
import asyncio, json
from playwright.async_api import async_playwright

BROWSER_UA = ("Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 "
              "(KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36")

async def scrape_pins(query, scrolls=6):
    url = f"https://www.pinterest.com/search/pins/?q={query}&rs=typed"
    seen = set()
    async with async_playwright() as p:
        browser = await p.chromium.launch(headless=True)
        page = await browser.new_page(user_agent=BROWSER_UA,
                                      viewport={"width": 1280, "height": 900})
        await page.goto(url, wait_until="domcontentloaded")
        for _ in range(scrolls):
            await asyncio.sleep(1.5)
            images = await page.query_selector_all(
                "[data-test-id='gated-pin-image'] img")
            for img in images:
                src = await img.get_attribute("src")
                if src and "/236x/" in src:   # pin thumbnails, not UI images
                    seen.add(src)
            await page.mouse.wheel(0, 4000)
        await browser.close()
    return sorted(seen)

async def main():
    results = await scrape_pins("minimalist%20office")
    print(f"collected {len(results)} thumbnail URLs")
    with open("office-pins.json", "w") as f:
        json.dump(results, f, indent=2)

if __name__ == "__main__":
asyncio.run(main())User-Agentを設定することが、Pinterestスクレイピングのアドバイスで最も繰り返されるものですが、それが主張されているような効果を発揮することはありません。上書きなし、現在のChrome文字列、2年前のChrome文字列、文字通りのpython-requests/2.32.3、いずれもHTTP 200と同じタイル数を返しました。どれもピンリンクは一切返さず、同じログインモーダルが表示されました。それでも、コストはかからず、トラフィックを正直に識別できるため、妥当なものを保っておいてください。
この集合が重要なのは、Pinterestがスクロールするにつれてタイルノードを再利用するためです。実行すると、あるログアウト状態のセッションは次のように表示します:
collected 16 thumbnail URLsつまりPlaywrightは検索からサムネイルURLを返すだけで、それ以上は何も得られません。
Pinterestのサムネイルからフルサイズ画像を取得する
これらの実行で返されるサムネイルは幅236ピクセルです。すでにピンのJSON-LDやAPIレコードを持っているなら、フルサイズのURLはその中に含まれており、書き換えは不要です。代わりにサムネイルから作業する場合、フルサイズのファイルは同じパスでサイズのセグメントが置き換えられたものにあります。この置き換えは通常1行の文字列置換として書かれますが、それだけではほぼ失敗します。
ライブフィードから取得した40枚のサムネイルのうち、/236x/を/originals/に置き換え、.jpg拡張子を保ったままにする方法が成功したのは5回だけでした。残りの35回はHTTP 403を返しました。Pinterestは再エンコードを行います。サムネイルは.jpgとして配信されますが、保存されているオリジナルはしばしば.pngです。拡張子を順番に試すことで、40枚すべてで成功しました。
ダウンロードするファイルは他人の写真であるため、それをどう扱うかはスクレイピングの問題ではなくライセンスの問題です:
import re, urllib.request

UA = ("Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 "
      "(KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36")

def full_size(thumb_url):
    """Pinterest re-encodes, so the original's extension often differs."""
    base = re.sub(r"/\d+x\d*/", "/originals/", thumb_url).rsplit(".", 1)[0]
    for ext in ("jpg", "png", "webp", "gif"):
        candidate = f"{base}.{ext}"
        req = urllib.request.Request(candidate, method="HEAD",
                                     headers={"User-Agent": UA})
        try:
            if urllib.request.urlopen(req, timeout=15).status == 200:
                return candidate
        except Exception:
            continue
return Noneただし、順番は変えないでください。どの拡張子が機能するかはアカウントによって異なるためです。40枚のあるサンプルでは.pngが35回、.jpgが5回でした。4つのアカウントにわたる別の40枚のサンプルでは、.webpが19回、.jpgが15回、.pngが6回でした。その中で、あるアカウントはすべて.jpg、別のアカウントはすべて.webp、3つ目のアカウントはほとんどが.pngでした。
画像1枚あたり約2回のHEADリクエストを見込んでください。その4アカウントのサンプルでは、ファイルを見つけるまでのループは平均2.1回のルックアップでした。
ブラウザアプローチが破綻する箇所
Playwrightはレコードの残りの部分を取りこぼします。各タイルのaltテキストは文字どおりの文字列Pinであり、タイルにはタイトルがありません。それらは/pin/リンクも一切包んでいないため、グリッドには辿るべきものが何もありません。
得られるのは短い画像URLのリストだけで、それ以外は何もありません。説明もなく、ピン投稿者もなく、保存数もなく、ハッシュタグもありません。同じ検索を通常のログアウト状態のブラウザで読み込むと、その理由がわかります:
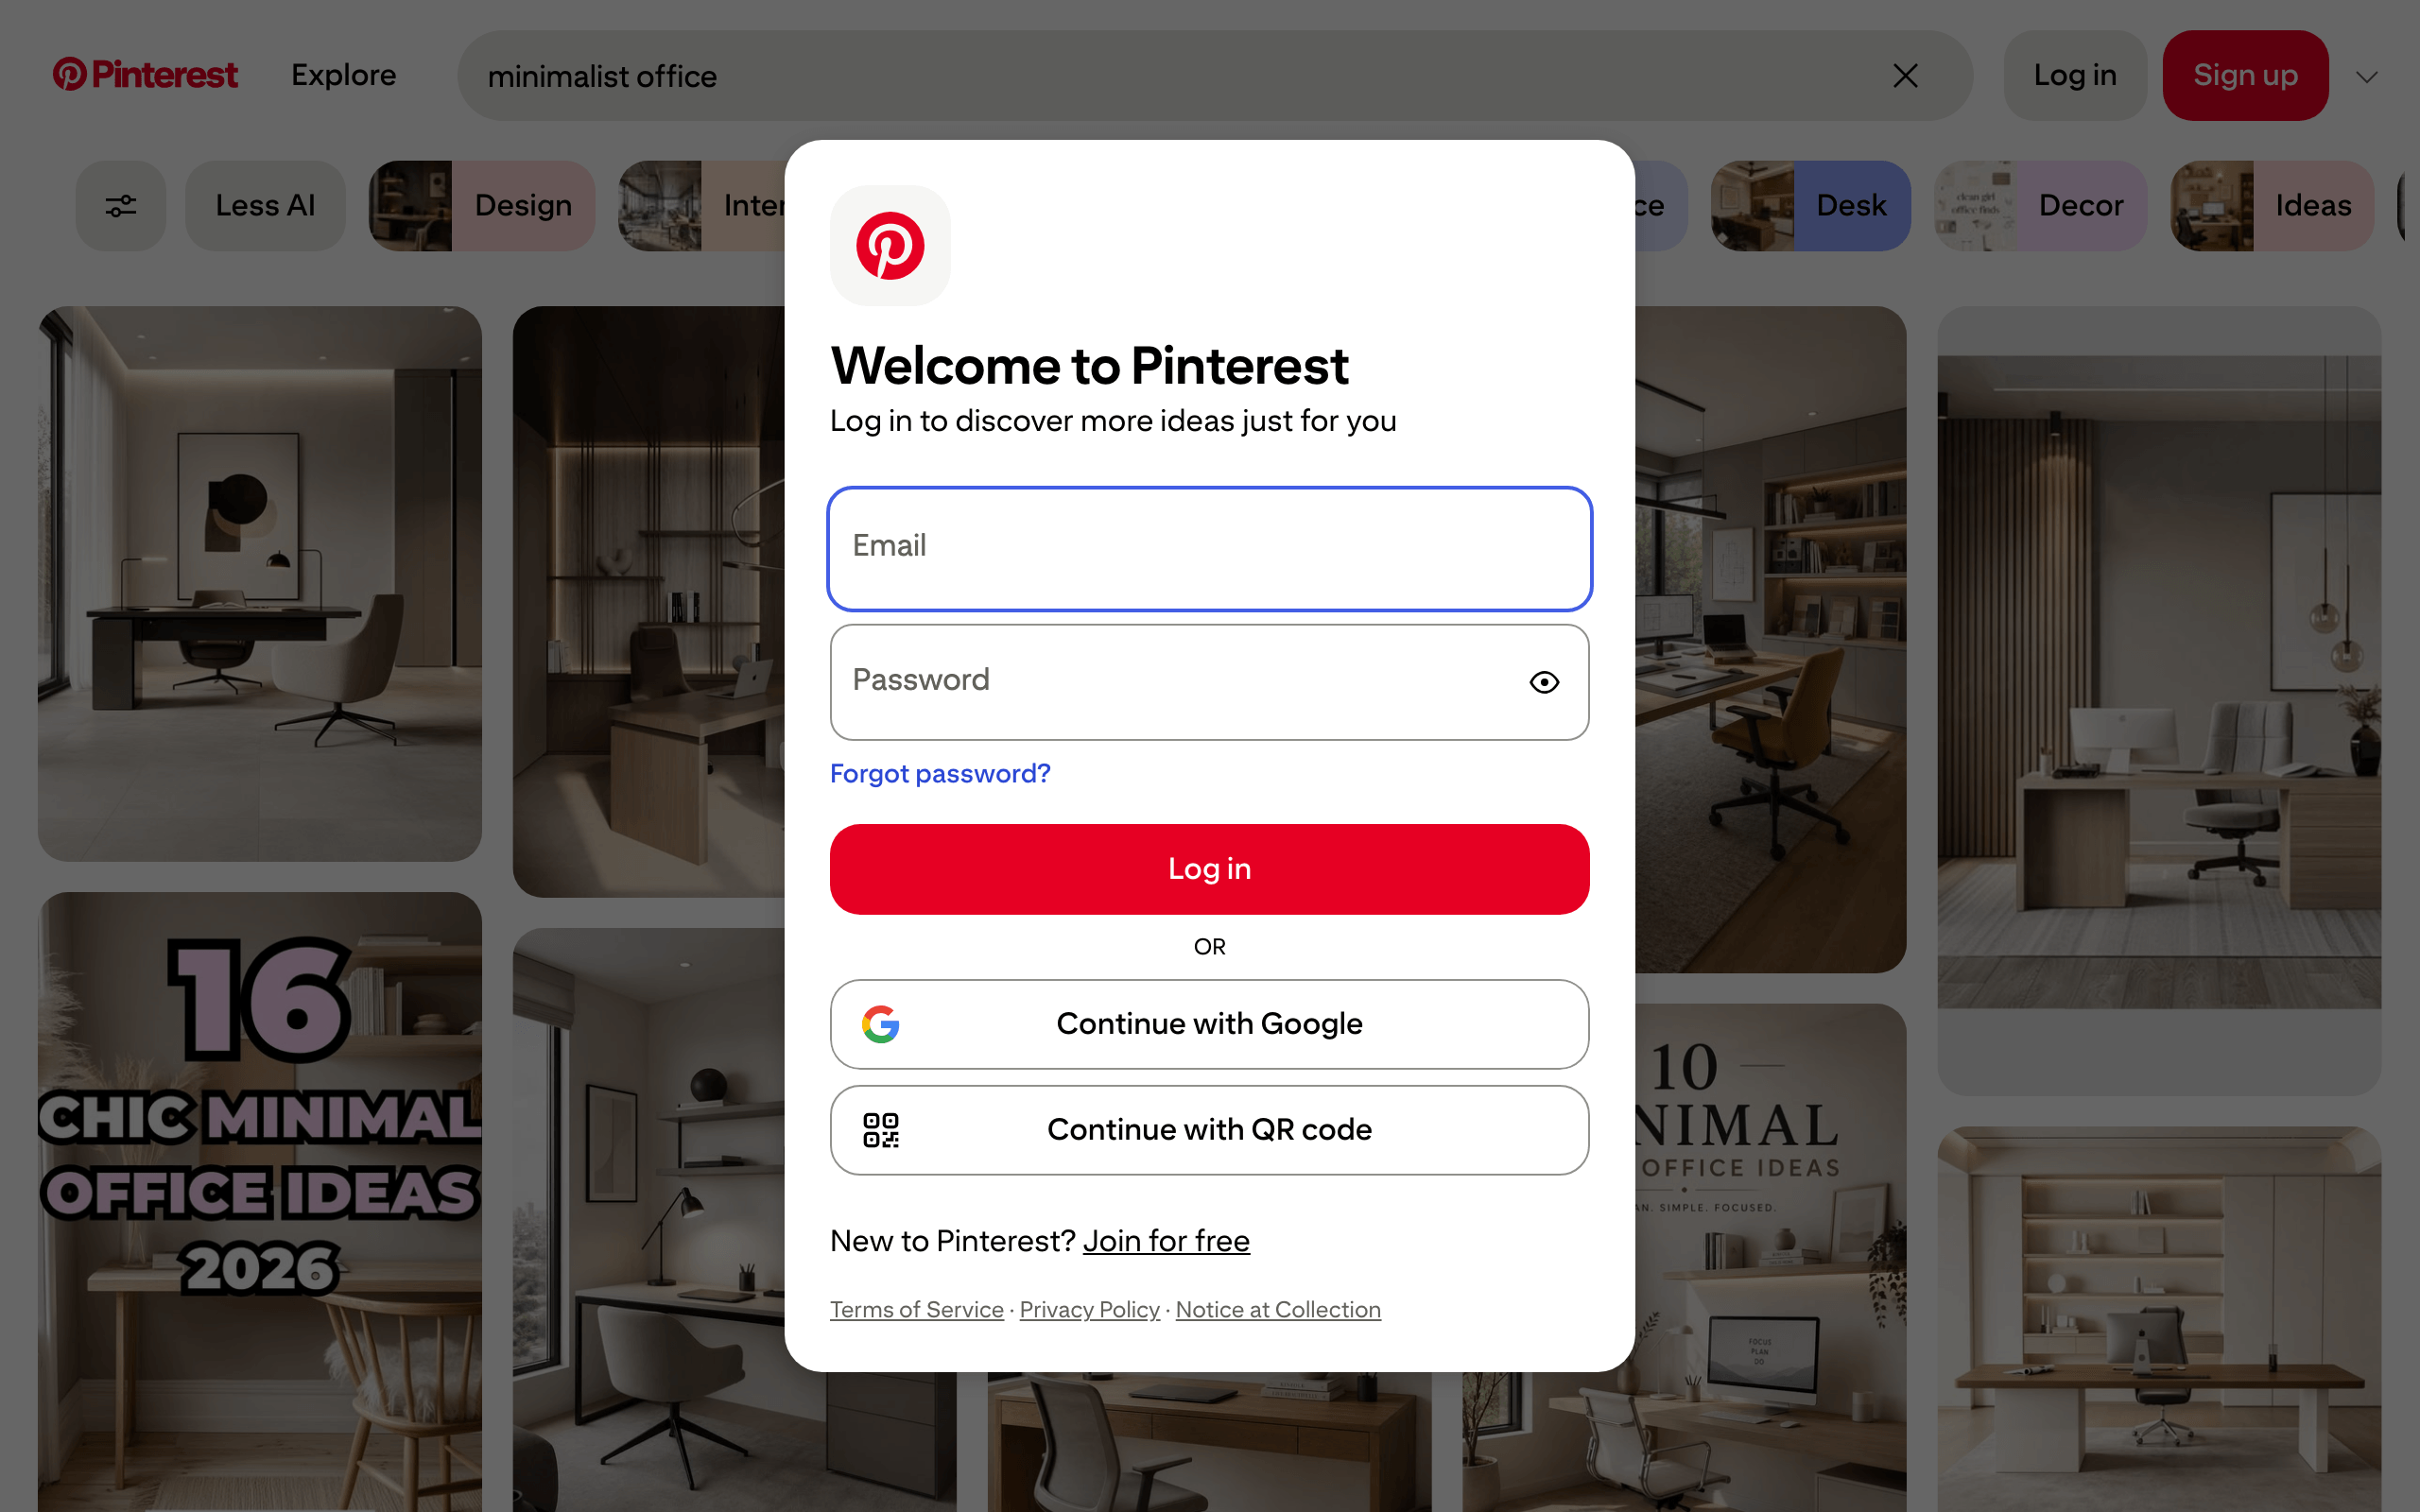
モーダルの周囲のタイルは、スクリプトが読み取るのと同じgated-pin-rep要素です。それぞれに画像だけが含まれており、それ以外は何もないため、実行はURLのみを返し、タイトルは返しません。
さらにスクロールしても何も変わりません。グリッドは3回スクロールした後も25回スクロールした後も同じ数を保っており、サムネイルURLの集合がそれを超えて増えることはありません。
その数はセッション内では安定しており、セッション間では変動します。1つのセッション内での繰り返し実行では、minimalist officeは毎回17件、fall fashionは毎回15件を返しました。これら同じ2つのクエリに対する別々のセッションでは16、17、18件が返されました。
10件台半ばから後半のどこかで固定された数を予想してください。正確な数字は信頼すべき数値ではなく、セッションに固有のものとして扱ってください。ログインモーダルがフィードを覆い、サインイン済みセッションが得られる無限スクロールをブロックしており、DOM内には実際のパスワードフィールドがそこにあります。
ステルスブラウザで解決しない理由
自然な次の一手はステルスブラウザですが、これはゲートがかかったグリッドに対する誤った診断です。未修正のPlaywrightは、プロトコルレベルで自動化のシグナル、最も目立つのはChrome DevTools ProtocolのRuntime.enable呼び出しを実際に示しており、パッチ適用版はそれらを隠します。PatchrightはPlaywrightパッケージの直接の代替であり、スクリプトに手を加えることなくそれらのシグナルを隠すよう作られています。CamoufoxはPlaywrightへのパッチではなく、独立したFirefoxビルドです。
レンダリングブラウザと自前のプロキシプールを持つある商用アンブロッカーを、同じクエリに対して向けたところ、ログアウト状態のページを完全に返しました。それはサインアッププロンプト、カテゴリーボタン、フィルターバーを意味し、ピンのタイトルや/pin/リンクは1つもありませんでした。
1つのセッションで同じ2つのクエリに対してPatchrightと未修正のPlaywrightを並べて実行しても、何も変わりません。どちらもminimalist officeに対して16個のタイル、fall fashionに対して15個を返しました。どちらも/pin/リンクはゼロ、すべてのタイルのaltテキストはPin、DOM内の同じパスワードフィールドを返しました。
アカウント状態のゲートがログアウト状態のフィードを制限しているのであって、ボットスコアではありません。検索ページやプロフィールページにBot Managerのクッキーは現れません。10個のlop_unauth_lockdown実験は2026年9月時点で__PWS_DATA__内で稼働しており、タイル数は4つのUser-Agentにわたって変わりません。
さらに先へ進むために必要なこと
自前のブラウザで検索にわたって説明、リンク、エンゲージメントに到達するには、Pinterestが実際のログイン済みユーザーとして扱うセッションが必要です。つまり、サインインしてクッキーを保持することを意味します。個人のログインを自動化することはプラットフォームの利用規約に違反し、「自動化された手段を使用して(弊社の事前の明示的な許可なく)」Pinterestのデータにアクセスすることを禁止しています。
規模はもう1つの制約であり、このターゲットではフィンガープリンティングではなくIPの評判です。1つのアドレスから約250リクエストを行っても、レート制限もチャレンジも発生しなかったため、上限は最初の試みが示唆するよりも高いです。1つのアドレスから継続的に実行すると状況が変わり、それが持続可能なスクレイパーが対処すべき3つの問題のうちの最初のものです。
持続可能なスクレイパーに必要なもの
サムネイル1画面分を取得するのはデモです。スケジュールに沿って数千件の完全なピンレコードを収集するのはインフラの課題です。
- IPの多様性。 レジデンシャルプロキシは、1つのデータセンターアドレスではなく、多数のコンシューマーIPに同じジョブを分散させます。3つのうち、ここでの証拠はこれこそがお金を払う価値があるものだと示しており、規模の大きさだけの話ではありません。ホスティングに分類されたアドレスは、JSON-LDブロックが欠落したピンページを取得するため、パースはコンシューマーIPからのみ機能します。単一アドレスが継続的に実行されるようになると、それ以上にローテーションが重要になります。
- フィンガープリントとチャレンジ処理。 Browser APIのような管理型ブラウザは、一貫した実在のフィンガープリントを提示するよう構築されています。また、プレーンなヘッドレスChromiumでは応答できないチャレンジにも答えます。これは、パイプラインがそれを強制するサイトに向けられた瞬間に必要になるものです。公開Pinterestページは簡単なケースです:Bot Managerのクッキーなし、センサーペイロードなし、6種類のクライアントIDにわたってチャレンジなしでした。
- メンテナンス。
pinWrapperからgated-pin-repへの変化やロックダウン実験が示すように、セレクタやゲーティングは予告なく変わります。Scraplingは、クラス名が頻繁に変わるときに類似性によって要素を再度見つけられるよう構築されており、これは問題のパーサー側に役立ちます。
これらすべてを自分で構築することもでき、スクレイパーがブロックされないようにするための一般的なパターンは、他の場所と同様にここでも当てはまります。
トレードオフは、これが一度書くスクリプトではなく、継続的なエンジニアリング作業になるということです。メンテナンスのコストがパイプラインを所有する価値を上回るときは、管理型スクレイパーAPIに移行できます。
Bright DataのScraper APIでPinterestをスクレイピングする
Bright DataのPinterest Scraper APIは、ブラウザ、プロキシ、アンブロッキング層を管理型サービスに移行します。ピンURL、キーワード、プロフィールURLを送信すると、構造化レコードが返ってきます。これはWeb Scraper APIの一部で、毎月の無料枠があり、その後は配信されたレコードごとの従量課金制です。このガイドのすべてのScraper APIの例は、その無料枠内で実行されました。
ここでは汎用アンブロッカーではなくPinterestスクレイパーを使用してください。これは生のHTMLではなくパース済みのレコードを返します。汎用アクセスモードは、サイトを横断するあらゆるURLのための別ルートです。どれが利用可能かはアカウントによって異なります。また、作成する各製品の名前付き設定であるゾーンによっても異なります。
Bright Dataは、このガイドで先に説明したrobotsの許可リストをその層で適用します。それらのモードのうち1つは、まさにそれを理由にPinterestへのリクエストを完全に拒否しました。
セットアップは2段階です。Bright Dataアカウントはカードなしで開設でき、アカウント設定でAPIキーを自分で作成します。新規アカウントにはまだキーがないため、APIキーのテーブルは空から始まります:
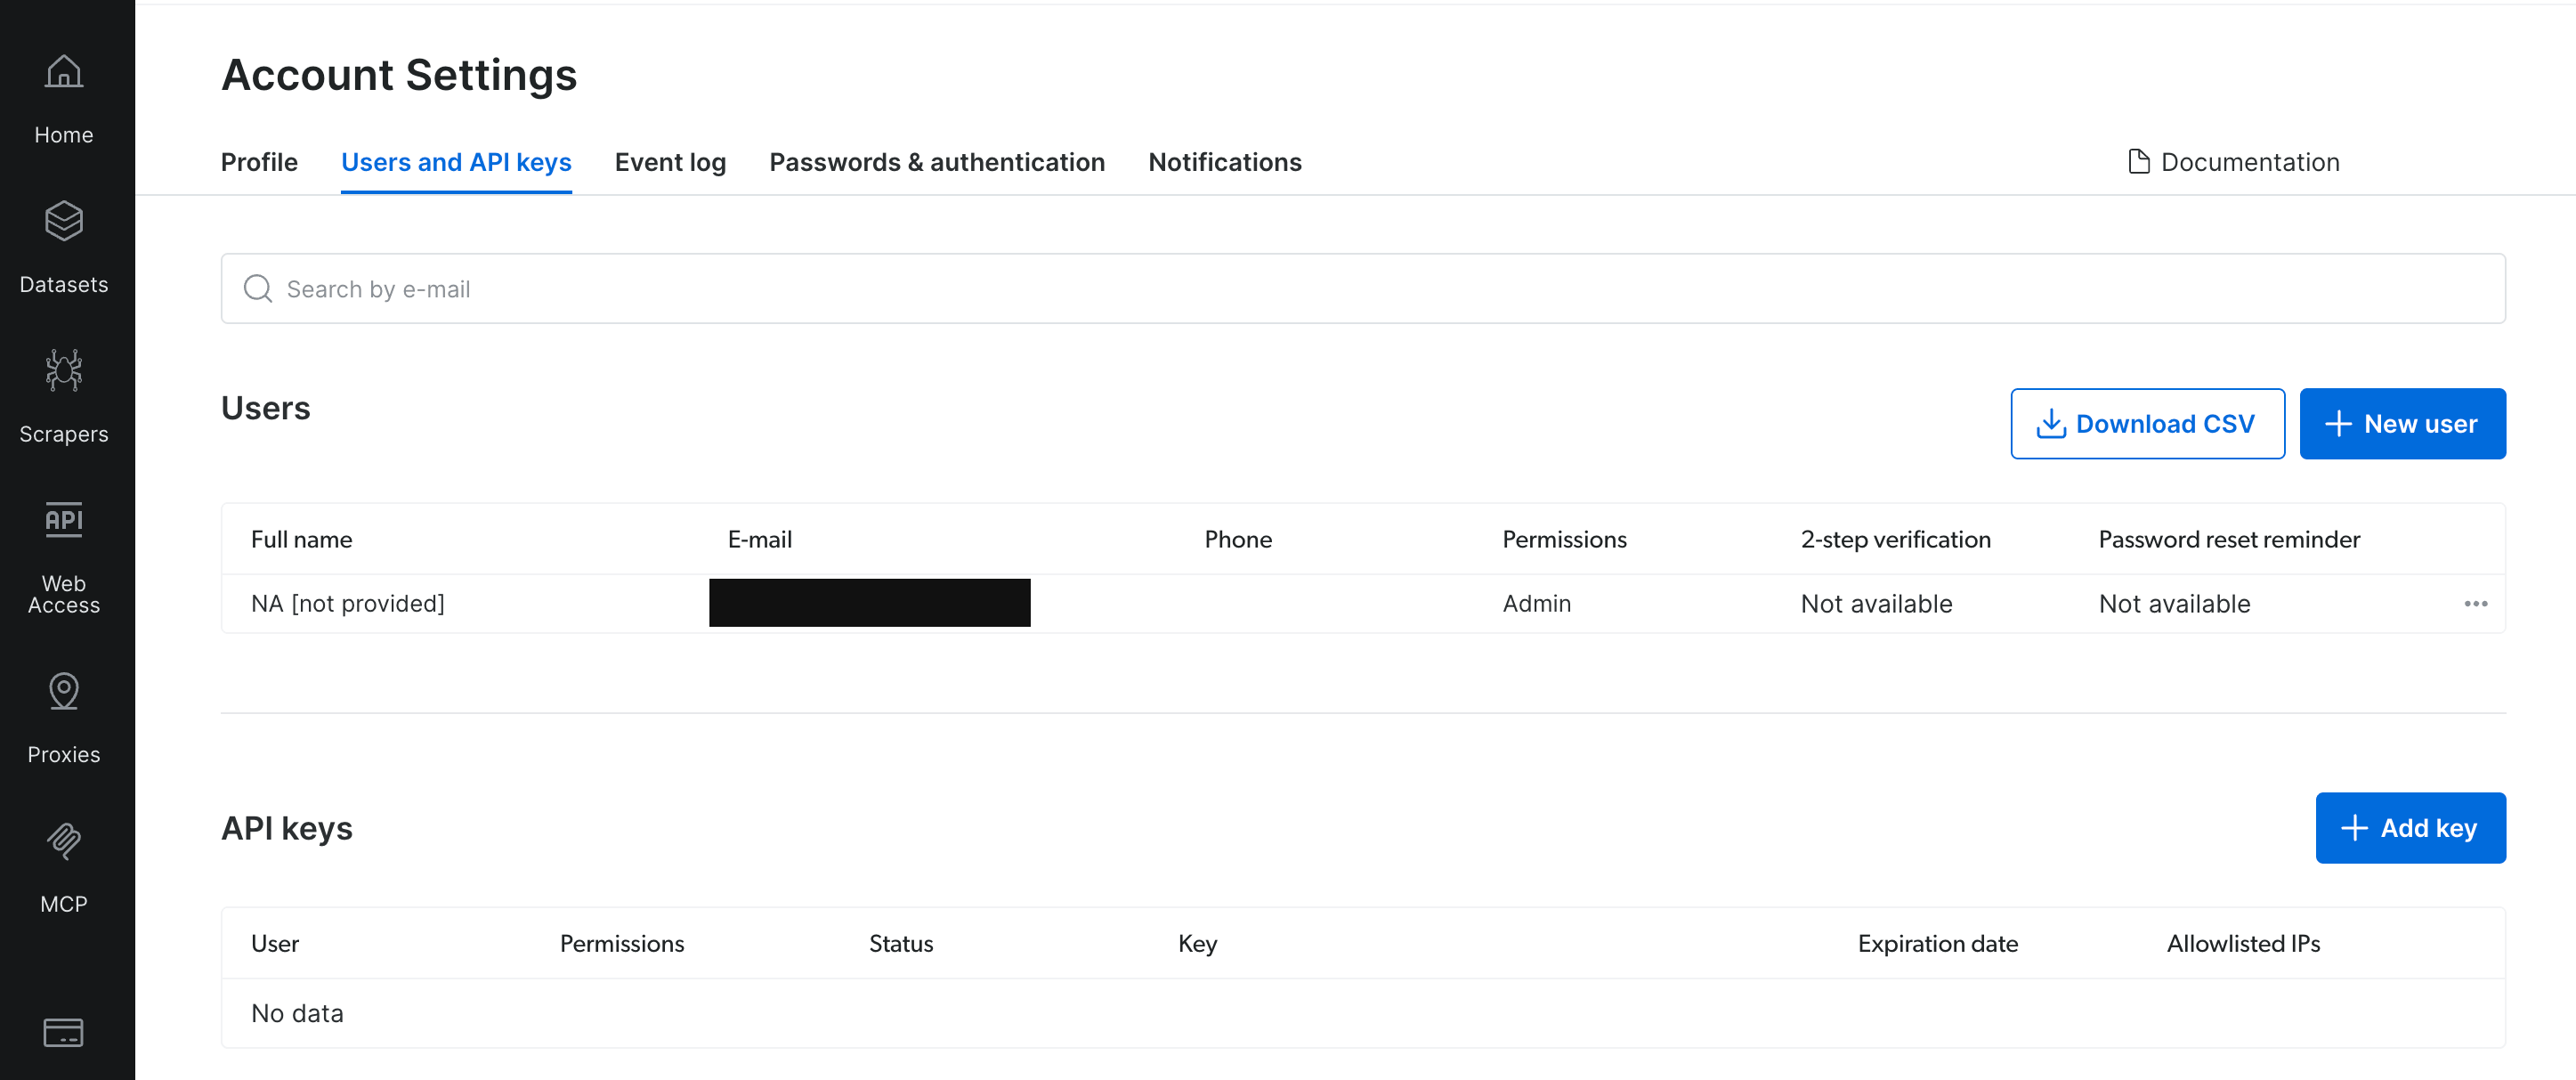
キーを追加すると、ダイアログがユーザー、権限レベル、有効期限を尋ねてきます。
請求や管理ではなく、API アクセス用に意図された権限レベルを選択してください。Bright Dataの認証ドキュメントはこれを「プロキシ/APIレベルでのAPI使用を有効にする」ものと説明しています。有効期限については、プロジェクトの終了日より先の日付を選んで、実行途中でキーが期限切れにならないようにしてください。
この例では、先にボードフィードで使用したのと同じrequestsパッケージを使用します:
pip install requestsこの1つのパッケージが依存関係の全リストです。各収集モードはこの設定を共有しており、コンソールはそれらをまとめて一覧表示するので、何かを書く前に各モードが何をするか確認できます:
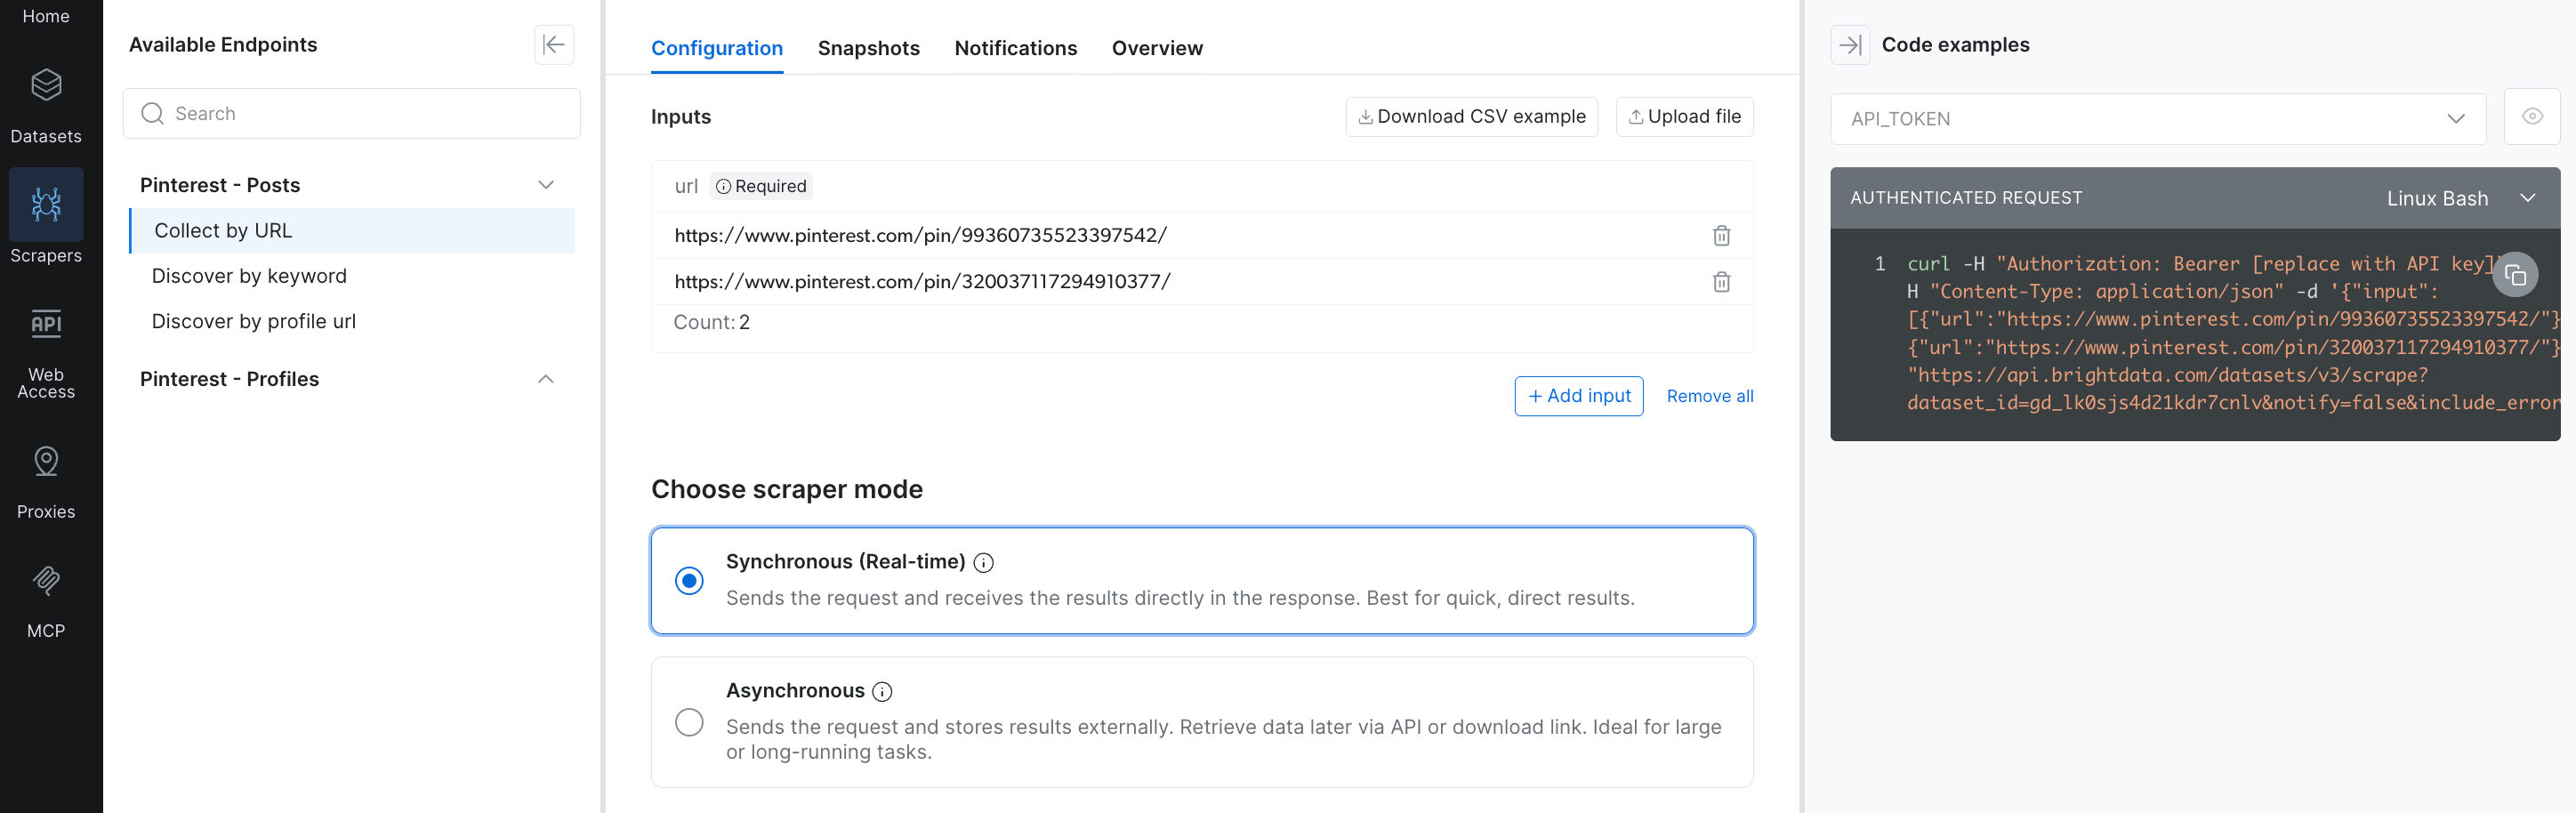
パネルにはこのスクレイパーのエンドポイントが一覧表示されています。ここで使用する3つは、URLによる収集、キーワードによる発見、プロフィールによる発見です。
URLでピンを収集する
1つまたは複数のピンURLを送信し、レスポンスからレコードを読み取ります。include_errors=trueフラグは、APIに失敗した入力を削除する代わりに報告させます。エラーは自分でフィルタリングしますが、その代わり、すべての入力の結果を確認できます:
import requests

API_KEY = "YOUR_API_KEY"  # create this in your Bright Data account settings
# copy the current dataset ID from the scraper's page
DATASET_ID = "gd_lk0sjs4d21kdr7cnlv"

resp = requests.post(
    "https://api.brightdata.com/datasets/v3/scrape",
    headers={"Authorization": f"Bearer {API_KEY}",
             "Content-Type": "application/json"},
    params={"dataset_id": DATASET_ID, "include_errors": "true"},
    json={"input": [
        {"url": "https://www.pinterest.com/pin/99360735523397542/"},
        {"url": "https://www.pinterest.com/pin/3166662230556591/"},
    ]},
    timeout=60,
)

# an HTTP error raises here, so resp holds records
resp.raise_for_status()
for line in resp.text.strip().splitlines():
    print(line)
レスポンスは改行区切りのJSONで、入力ごとに1オブジェクトです。生きているURLは約20フィールドのレコードを返し、ここでは関連するものに短縮しています。削除されたピンはエラーを返しました:
{"url": "https://www.pinterest.com/pin/99360735523397542/", "post_id":
"99360735523397542", "title": "12 Bombshell Hair Color Ideas To Try This
Summer | Ecemella", "content": "Copper Red",
"date_posted": "2023-05-24T22:32:51.000Z", "user_name": "ecemella",
"user_url": "https://www.pinterest.com/ecemella", "likes": 2,
"categories": ["Beauty", "Hair"], "hashtags": ["Casual Fall Outfit
Inspiration", "Fall Fashion Outfit Ideas"], "image_video_url":
"https://i.pinimg.com/originals/0d/b9/56/0db956e2c07e1580514b1c19587b4152.jpg",
"video_length": 0, "post_type": "image", "comments_num": 0}
{"input": {"url": "https://www.pinterest.com/pin/3166662230556591/"},
"error": "Bad input. Page does not exist.", "error_code": "dead_page"}
このレコードは、タイトル、日付、画像の点でJSON-LDパースと一致し、さらに1回の呼び出しでピン投稿者のハンドル、カテゴリー、ハッシュタグを追加しています。保存数とアウトバウンドのソースリンクは、代わりにピンページのJSON-LDから得られます。
失敗したURLは、Pinterestがその後削除した実在のピンIDです。APIはそれに対してクラッシュではなくdead_pageエラーを返すため、ログに記録して続行できます。Bright DataはScraper APIを正常に配信されたレコードごとに課金するため、この基準では死んだピンが請求額に加算されるべきではありません。
ピンは頻繁に削除されるため、どのバッチでもこのエラーを想定しておいてください。各オブジェクト自身のurlまたはinputフィールドでレスポンスを入力に照合してください。位置によってではありません。3回の同一実行のうち、エラー行が2回最初に、1回2番目に届きました。
scrapeエンドポイントは通常インラインで応答します。ジョブにもっと時間がかかる場合、snapshot_idと処理中のメッセージを返し、そのID の下でレコードが待機します。どちらのモードをリクエストしたかに関わらず、レスポンスをレコードとしてパースする前にsnapshot_idがあるかどうか確認してください。
キーワードでピンを発見する
発見モードは、キーワード検索へのルートであり、ログインゲートが通常のHTTPに対して閉じている唯一の分野です。これは、URLのリストではなくトピックがある場合に使用するモードです。type=discover_newとdiscover_by=keywordを追加し、limit_per_inputでキーワードごとの件数を制限してください:
import requests

API_KEY = "YOUR_API_KEY"
# copy the current dataset ID from the scraper's page
DATASET_ID = "gd_lk0sjs4d21kdr7cnlv"

resp = requests.post(
    "https://api.brightdata.com/datasets/v3/scrape",
    headers={"Authorization": f"Bearer {API_KEY}",
             "Content-Type": "application/json"},
    params={"dataset_id": DATASET_ID, "include_errors": "true",
            "type": "discover_new", "discover_by": "keyword"},
    json={"input": [{"keyword": "minimalist office"},
                    {"keyword": "fall fashion"}],
          "limit_per_input": 4},
    timeout=180,
)
# an HTTP error raises here, so resp holds records
resp.raise_for_status()
print(resp.text)各キーワードは設定した上限まで返されます。各レコードには、それを見つけたキーワードを示すdiscovery_inputフィールドが追加されます。ピンに説明がある場合、contentフィールドに全文が保持されます。minimalist officeの実行からの1レコード、説明は省略しています:
{"url": "https://www.pinterest.com/pin/320037117294910377", "title":
"Minimal Cream Office With Ultrawide Monitor, Wood Desk and Natural Window
Light", "content": "A pale wood desk sits beside a bright window with an
ultrawide monitor... #MinimalCreamOffice #PaleWoodWorkspace",
"user_name": "theSetupDistrict", "categories": ["Home Decor"],
"date_posted": "2026-08-25T15:59:51.000Z",
"discovery_input": {"keyword": "minimalist office"}}
つまり、キーワードだけで構造化されたピンレコードを取得するのに十分です。ほとんどには説明とカテゴリーが含まれていますが、どちらもログアウト状態の検索グリッドには現れません。
非同期APIでプロフィール全体をクロールする
プロフィール上のすべてのピンをクロールすることは、単一のレスポンスで保持できる量を超えるため、APIはこれをバックグラウンドジョブとして実行します。ジョブを開始し、IDを受け取り、完了したらレコードを収集します。コンソールでモードを切り替えると、リクエスト自体の違いがわかります:
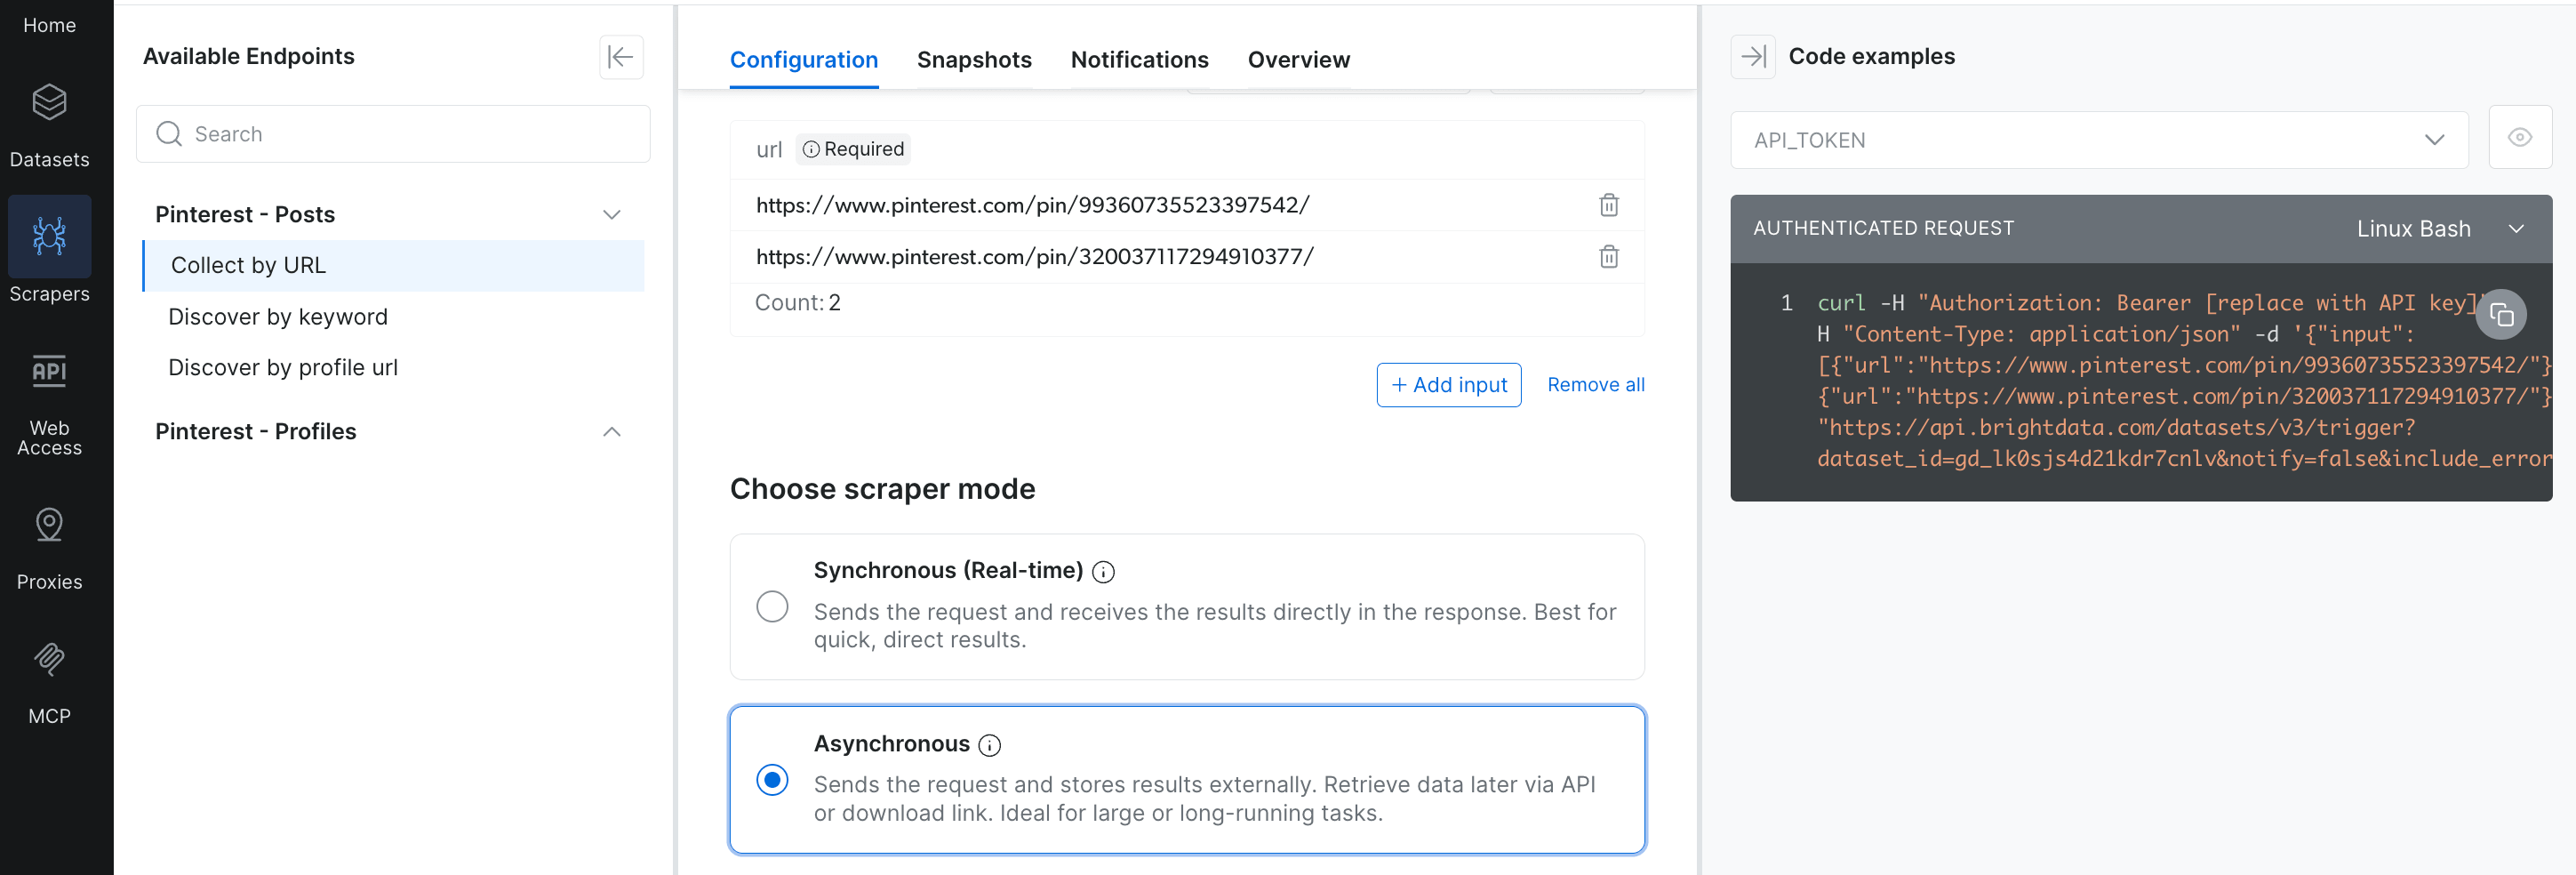
非同期モードを選択すると、パスが自動的に書き換えられます。scrapeエンドポイントがtriggerになります。その後、実行は接続を開いたままにする代わりに、ポーリング用のsnapshot_idを返します。
triggerエンドポイントを使用すると、すぐにsnapshot_idが返されます:
import requests

API_KEY = "YOUR_API_KEY"
# copy the current dataset ID from the scraper's page
DATASET_ID = "gd_lk0sjs4d21kdr7cnlv"
HEADERS = {"Authorization": f"Bearer {API_KEY}",
           "Content-Type": "application/json"}

start = requests.post(
    "https://api.brightdata.com/datasets/v3/trigger",
    headers=HEADERS,
    params={"dataset_id": DATASET_ID, "include_errors": "true",
            "type": "discover_new", "discover_by": "profile_url"},
    json={"input": [{"url": "https://www.pinterest.com/boredpanda/",
                     "start_date": "", "end_date": ""}],
          "limit_per_input": 4},
    timeout=60,
)
# an HTTP error raises here, so start.json() holds a real snapshot_id
start.raise_for_status()
snapshot_id = start.json()["snapshot_id"]
print("snapshot:", snapshot_id)空のstart_dateとend_dateは任意であり、空のままにすると日付フィルターなしで収集されます。その後、ジョブの準備が整うまで進捗エンドポイントをポーリングし、スナップショットをダウンロードしてください。進捗レスポンスは件数とエラーコードを報告するので、取得する前に何が得られるかがわかります:
import requests, time

API_KEY = "YOUR_API_KEY"
HEADERS = {"Authorization": f"Bearer {API_KEY}",
           "Content-Type": "application/json"}
# printed by the trigger block; keep it to re-download a crashed run
snapshot_id = "sd_..."

progress_url = f"https://api.brightdata.com/datasets/v3/progress/{snapshot_id}"
while True:
    poll = requests.get(progress_url, headers=HEADERS, timeout=30)
    # an HTTP error raises here, so poll.json() is a real progress object
    poll.raise_for_status()
    progress = poll.json()
    if progress["status"] in ("ready", "failed"):
        break
    time.sleep(10)

# records and error_codes say what the run produced; status only says it stopped
codes = progress.get("error_codes") or {}
if progress["status"] == "failed" or not progress.get("records"):
    raise RuntimeError(
        f"{snapshot_id} finished with no records to download: "
        f"{progress['status']}, {codes}")

data = requests.get(
    f"https://api.brightdata.com/datasets/v3/snapshot/{snapshot_id}",
    headers=HEADERS, params={"format": "json"}, timeout=120,
).json()

# include_errors=true reports failed inputs as rows, so filter before counting
records = [row for row in data if not row.get("error_code")]
if codes:
    print(f"skipped {sum(codes.values())} failed inputs: {codes}")
print(f"downloaded {len(records)} records")
このループが処理の仕組みを担います。レスポンスが実行について何を語っているかには、もっと注意が必要です。
ダウンロードする前に進捗レスポンスを読む
進捗レスポンスには、statusに加えてerrorsとerror_codesが含まれており、この3つすべてが重要です。readyだけでは、ジョブが停止したことを意味するだけで、すべての入力が成功したわけではありません。実行はrecords: 0と0でないerrorsの件数のままreadyで完了することがあります。
statusだけをテストするループはdownloaded 0 recordsを表示し、まるで成功したかのように続行してしまいます。レコード数ゼロの実行でエラーを発生させるのが正しいデフォルトです。エラーだけでエラーを発生させるのは正しくありません。削除されたピンをいくつかスキップしつつレコードを返すクロールは、意図したとおりに機能しているだけです。
ダウンロードにも同じ注意が必要です。include_errors=trueは、失敗した入力を実際のレコードの隣に行としてスナップショットに入れるためです。したがって、生の行数は保持するレコードより多くなることがあります。1レコードと報告する実行が、3行を返すことがあります。urlのないdead_pageのエントリが2つと、完全なピンが1つです。何かをカウントしたり保存したりする前にerror_codeでフィルタリングしてください。
boredpandaでのプロフィール実行は、上限によって許可された4件のレコードとともに約21秒で返り、それぞれにdiscovery_inputがタグ付けされます。プロフィールクロールは、同期的なscrapeエンドポイントを呼び出した場合でも、設計上非同期で実行されます。
キーワードやプロフィールのクロールも、進捗のerror_codes内で削除されたピンをdead_pageのエントリとして報告します。上限より少ない有効レコードを返す実行は、通常はあなたのコードのバグではなく、削除されたピンを見つけたことによるものです。
実行を確認し、プロフィールレコードを収集する
すべての実行はコンソールに記録されるので、自分で構築しなくても実行履歴が得られます:
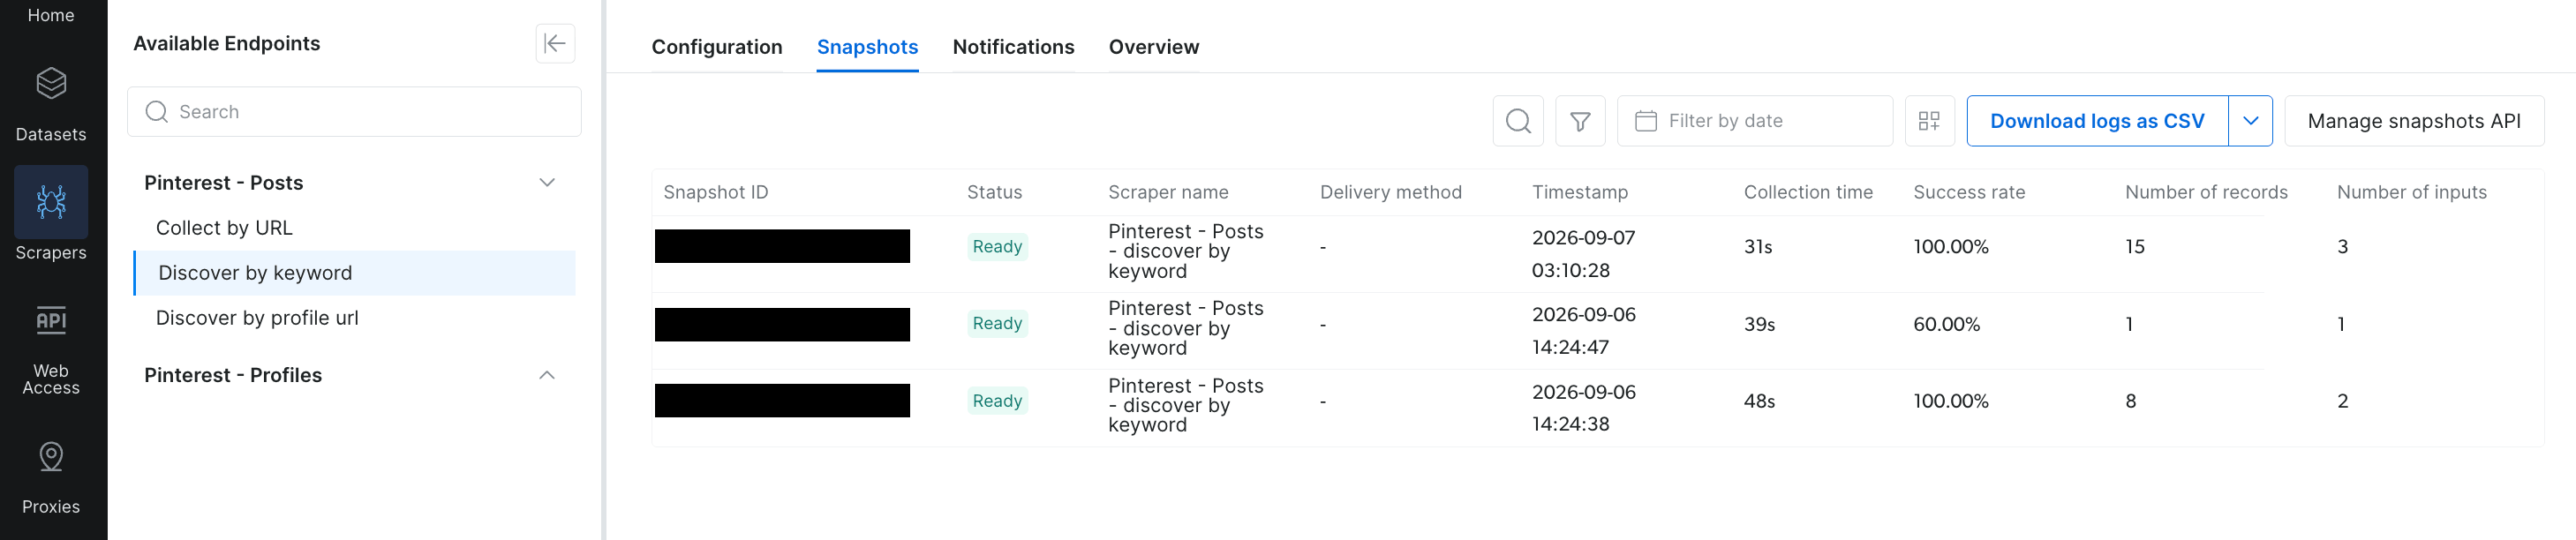
IDをログに記録しなかった実行でも、ここで再ダウンロードできます。これらのうち2つはエラーなしで100%で実行され、3つ目は60%で、エラー列に2件の削除されたピンが記録されています。
その中間の実行は、見つかったピンのうち2件が削除されていたため、1件のレコードしか返しませんでした。コンソールはこれを、このスクリーンショットには写っていないエラー列の下にdead_page: 2として記録します。わずかなレコード数を壊れたリクエストと判断する前に、自分の実行でその列を確認してください。成功率はクロールが訪れたページについてのコンソール独自の数値なので、レコード数とエラー数と合わせて読んでください。
2つ目のスクレイパーは、プロフィールクロールが収集するピンに加えて、プロフィールレコード自体も返します。データセットIDをPinterestプロフィールスクレイパーのページにあるものに切り替え、discover_byなしでプロフィールURLを投稿してください。同じアカウントに対して、テスト時点で約300万のfollower_countと51のboards_numを返しました。また、ピン数付きのボードのsaved配列、51件中10件も返しました。
このスクレイパーはインラインのレコードではなくsnapshot_idを返すため、同じ方法でポーリングしてください。テストではピンクロールの約20秒に対し、4分弱かかったため、ポーリング間隔は分単位で設定してください。
レコードに含まれるもの
テストした30レコードすべてに10フィールドが現れました:url、post_id、date_posted、user_name、user_url、post_type、image_video_url、video_length、likes、comments_numです。これらは当時の安定したコアでした。さらに4つは保証されたものではなく一般的なものです:30件のうち27件にtitle、24件にcategories、22件にcontent、16件にhashtagsがありました。この2つ目のグループは、直接インデックスするのではなく.get()で読んでください。
保存数は、ほとんどのPinterest分析が求めるエンゲージメント数値であり、post_idでの2ソース結合から得られます。APIは発見と構造化レコードを提供します。ピンページのJSON-LDが保存数を提供し、チェックした6件のピンのうち5件でそれを返しました。
指標を構築する前に実際の数値を確認してください。3つのアカウントそれぞれから最近のピン8件をサンプリングしたところ、中央値は1、1、2でしたが、個々のピンは数百に達していました。つまり、このカウンターは画像単位ではなくピン単位です。likesは、同じ6件のうち5件で0を返しましたが、これはPinterestが何年も前に公開指標としての「いいね」を廃止したことと一致します。
同じ6件のピンにわたって、タイトルは2つのソース間で毎回一致し、日付は6件中3件で一致しました。ピン投稿者の名前も通常は一致しますが、これは信頼すべきでないフィールドです。このガイドを通じて使用したピンは、それらが異なるケースです。そのoEmbedレスポンスとAPIレコードは異なる人物を名指ししています。
APIレコードはピンがリンクするサイトの背後にあるアカウントを名指ししますが、JSON-LDとoEmbedはそれを保存した個人を名指しします。ピンが別のアカウントから再保存されると、2つのソースは異なる人物を名指しすることがあります。2つのデータセットは、ピン投稿者ではなく、必ずピンURLまたはpost_idで結合してください。
日付が異なった場合、APIのdate_postedはピンがフィードに現れた日付と同じかそれに近いものでした。JSON-LDのdatePublishedはより古く、ある場合には数年もの差がありました。2つを混ぜる前に、あなたの分析がどちらの定義を必要としているか決めてください。
どのPinterestスクレイピング手法を使うべきか?
選択は、何から始めているか、どれだけレコードが必要かによります:
| 要因 | 通常のHTTP(JSON-LD、oEmbed、RSS) | Playwright(DIY) | Bright Data Scraper API |
|---|---|---|---|
| セットアップ | requestsと標準ライブラリ |
Playwrightとブラウザをインストール | APIキーとrequests |
| 返されるデータ | 既知のピンの完全なレコード、構造化されたプロフィールレコード | 検索またはプロフィールからの画像URLのみ | タイトル、説明、ピン投稿者、ハッシュタグ、カテゴリー、メディア;保存数はピンページから取得し、post_idで結合 |
| 発見 | ボードフィードとウィジェットバックエンド、検索なし | 1つの検索でのゲートがかかったタイル | URL、キーワード、プロフィール全体によるピン |
| ブロッキング | 自前のIP、TLSチャレンジは観測されず | プロキシとメンテナンスを自分で管理 | 管理されたプロキシおよびアンブロッキング層 |
| メンテナンス | フィードやJSON-LDブロックが変わったら自分で対応 | Pinterestがマークアップやゲーティングを変更したら自分で対応 | プロバイダー側が、同じマークアップやゲーティングの変更に対応 |
| コスト | 1つのIPからは無料、10,000ピンページで1.24 GB、oEmbed経由ならはるかに少ない | 無料、10,000ピンで43.5 GBのプロキシトラフィックが追加 | 毎月の無料枠、その後は正常に配信されたレコードごとの課金 |
通常のHTTPは、ほとんどのガイドが示唆するよりも多くに到達します。名前を指定した生きているピン、構造化されたプロフィールレコード、アカウントが表示するすべてのボードからの最近のピンを返します。1つのアカウントのすべてのボードに対して両方の無料手法を実行した結果、435件のユニークなピンが返されました。
制約はどれだけ到達できるかであり、見た目よりも狭いものです。その435件は、それらが来た9つのボードに保存されている9,000件以上のうち、5%未満です。無料手法はキーワード検索には届かず、Playwrightはゲートがかかったサムネイルを追加するだけです。Scraper APIは、キーワードの発見、プロフィール全体のクロール、定期的な収集のためのものです。
各手法が10,000ピンでかかるコスト
ペイロードサイズが請求額を決め、実際に転送されたバイト数で測定されます。この表は、圧縮を交渉するクライアントを前提としています。解凍時に約1.13 MBのピンページは、Brotliで約124 KB、またはrequestsが送信するgzipヘッダーでは183 KBを転送します。代わりに標準ライブラリの例を実行すると、ピンページHTMLの行のすべての数値はおよそ9倍になります。
バイト数はここで測定されたものですが、料金はそうではありません。2つの料金が表のすべてのドル額を決めます。どちらも2026年9月時点のBright Dataの定価であり、帯域幅の行とレコードの行は1つの基準を使っています:
- レジデンシャル帯域幅、$8/GB。 プロキシネットワーク料金ページの従量課金定価で、これは公開されている最大のコミットメントプランで適用される水準です。
- Scraper API、配信レコード1,000件あたり$1.50。 Web Scraper API料金ページの従量課金定価で、これは公開されているより高いプランでは数量とともに下がります。同じページには毎月の無料枠も掲載されていますが、表ではすべてのレコードに定価を使用しています。
どちらのページにもプロモーションが表示されており、どちらもこの記事が変わらなくても変化します。コストを見積もる前に、その2つのページで現在の料金を確認してください。見積もられた値を、最後の列の掛け算に当てはめてください。
| 手法 | 課金対象 | ピンあたりの転送バイト数 | 10,000件での量 | その料金でのコスト |
|---|---|---|---|---|
| RSSフィード、一覧表示されたピンごと | 帯域幅 | 147 B | 0.0015 GB | × $8/GB = $0.01 |
| oEmbed JSON | 帯域幅 | 583 B | 0.006 GB | × $8/GB = $0.05 |
| ピンページHTML | 帯域幅 | 124 KB | 1.24 GB | × $8/GB = $9.92 |
| Scraper API | 配信されたレコード | ページサイズに関わらず同じ | 10,000レコード | × $1.50/1k = $15.00 |
| Playwright経由のピンページ | 帯域幅 | 4.35 MB | 43.5 GB | × $8/GB = $348.00 |
各行は、失敗にかかるコストが異なります。削除されたピンでも、依然としてフルページでHTTP 200を返すため、帯域幅の行はそのバイト数に対して支払いが発生します。レコードの行は配信されたレコードごとに課金されます。
金額には表れないもの
同じピンをヘッドレスChromiumで読み込むと、約180のレスポンスにわたって4.35 MBをダウンロードします。これは同じレコードに対して通常の取得が移動する量のおよそ35倍です。
そのうち約3.1 MBがJavaScriptであり、これが通常のバイト節約方法がほとんど役立たない理由です。画像、フォント、スタイルシートをブロックしても3.8 MBまでしか下がりません。ページはレンダリングのためにまだスクリプトを必要とするためです。
時間はもう1つのコストです。ピンページの取得は、1台のマシンから15リクエストの2回の実行にわたって中央値0.8〜1.0秒かかりました。実際のフル実行は、この中央値が示唆するよりも遅く完了します。
0.5秒の遅延を伴う25ピンフィードへの3回のパスは、1分あたり21〜33ピンで完了しました。1つずつ実行すると、10,000ピンで5〜8時間です。並列実行すればこれを短縮できますが、同時に1つのアドレスへのリクエストレートが集中することになります。
コストの数字が実際に比較しているもの
oEmbedは583バイトを移動しますが、ピンページは124 KBです。著者名を1つ読むためだけにページ全体を取得するのは無駄です。
管理型APIは2つのものを買っています:到達範囲と、誰かにメンテナンスを任せられることです。通常のHTTP、キーワード検索、プロフィール全体のクロールを超えたページタイプに到達します。節約はそこから来るのであって、転送バイト数からではありません。
同じ基準で見ると、ピンページの行とScraper APIの行は近く、約1.5倍以内です。両側ともプロモーションを実施しており、さらに下がることもあります。どちらが安いかは、この記事にもあなたにも制御できない料金次第です。
ヘッドレスブラウザとの比較はそれほど近くありません。同じプロキシ料金ページの公開されているどの料金でも、43.5 GBのトラフィックは10,000レコードの何倍ものコストがかかります。
この2つの数字は同じものを測定していないため、それぞれが何を含んでいるかを読んでください。トラフィックの行は帯域幅だけであり、それ以外は何もありません。プロキシプランの最低料金や、パイプラインの構築とメンテナンスに費やした時間は除外されています。また、どの無料手法もその規模では供給できない10,000件のピンURLをすでに持っていることも前提としています。
レコードの数字はより広範です。URLリストを生成した発見処理も含まれ、その料金は数量が増えると改善します。プランの最低料金はどちらの側にも適用されるため、プロキシの見積もりを確認するのと同じように、大きなジョブについて確認してください。
次のステップ
必要なデータに対して最も軽量なツールから始めてください。ピンURLがあるなら、JSON-LDパースは通常のHTTPで完全なレコードを返し、oEmbed単体でも帰属情報が得られます。クリエイターやボードを追跡しているなら、RSSフィードをそのパースに連結すれば、ブラウザを一切読み込む必要がありません。
キーワード検索とプロフィール全体のクロールは、それらのルートを超えたケースです。Pinterest Scraper APIはキーワードまたはプロフィールURLを受け取り、構造化されたレコードを返し、それに対してテストできる毎月の無料枠があります。
継続的に運用する予定のものについては、最初から3つのデフォルトを設定してください:
- すべてのバッチで削除されたピンを処理する。 それは、JSON-LDパースからの
None、またはAPIからのdead_pageエントリを意味します。 - リクエストの間隔を約0.5秒保つ。 このペースは、フル実行にわたって1分あたり21〜33ピンで実行され、約250リクエストにわたってレート制限は発生しませんでした。
- 非同期ジョブの
snapshot_idをログに記録する。 それにより、クラッシュした実行を再ダウンロードできます。
単一のアドレスを超えるには、レジデンシャルプロキシを経由させ、すでに持っているパース処理をそのまま維持してください。データを収集するのではなく購入したい場合は、Pinterestデータセットがすでに構築済みで、ダウンロードの準備ができています
FAQ
Pinterestをスクレイピングできますか?
はい。ピンURLは通常、ブラウザ不要で、通常のHTTPでJSON-LDブロックからタイトル、説明、保存数、ピン投稿者、アウトバウンドリンクを返します。プロフィールとボードのRSSフィードは最近のピンURLを一覧表示します。キーワード検索は例外であり、スクレイパーAPIが必要です。
Pinterestはスクレイパーをブロックしますか?
いいえ、レジデンシャルアドレスからの公開ピンページではブロックされません。デフォルトのurllib User-Agentによる12回のリクエストはすべてHTTP 200を返し、Akamai Bot Managerのクッキーはありませんでした。データセンターIPは例外で、ページは依然として200を返しますが、JSON-LDブロックはありません。
Pinterestスクレイパーが機能しないのはなぜですか?
レコードはReduxストアではなくJSON-LDブロックにあるため、initialReduxState.pinsは空として読み取られます。検索グリッドでは、古いpinWrapperセレクタは何にも一致しません。ログアウト状態のタイルは現在gated-pin-repを使用しているためです。削除されたピンは依然としてHTTP 200を返しますが、JSON-LDブロックは一切ありません。
Pinterestには公開APIがありますか?
はい、ただし自分のアカウントに限定されます。Pinterest API v5は、他のユーザーの公開ピンではなく、自分のボード、ピン、広告を管理します。トライアルアクセスには1日のリクエスト制限があります。唯一のキーワード検索はすべてのアプリで利用可能ではないベータ版で、上位10件の結果に限定されます。
PinterestにはRSSフィードがありますか?
はい。Pinterestは/<username>/feed.rssと/<username>/<board-slug>.rssで認証不要のフィードを公開しています。12アカウントにわたって、ピンURL、タイムスタンプ、サムネイルを含む22〜26件の最近の項目を返しましたが、タイトルはほとんどありませんでした。フィードは新しいピンのみを一覧表示し、キーワード検索も履歴の深さもありません。
Pinterestのフルサイズ画像をダウンロードするには?
サムネイルURLのサイズセグメントをoriginalsに置き換え、次に.jpg、.png、.webp、.gifの順に試してください。サムネイル自身の.jpgを保ったままにすると、40ピンのうち35ピンで403が返りました。Pinterestが再エンコードするためです。画像1枚あたり約2回のHEADリクエストを見込んでください。
Pinterestのボードをスクレイピングするには?
ボードURLの末尾のスラッシュを取り除き、.rssを追加してください。末尾にスラッシュがあると、フィードの代わりにHTMLページが返されます。フィードは、ボードがどれだけ大きくても約25項目で止まります。widgets.pinterest.com/v3/pidgets/のウィジェットバックエンドは最大50を返し、それを超えるとプロフィール全体をクロールすることになります。