Yahoo Financeは無料の株価、価格履歴、財務諸表、アナリスト予想を提供していますが、公式APIはありません。見積もりページにはこのデータがHTML内のJSONとして含まれているため、Pythonパイプラインはブラウザなしでそれを読み取ることができます。
多くの古いチュートリアルのコードは2つの点で失敗していました。デフォルトのUser-Agentでは、Pythonのrequestsライブラリは最初のリクエストで429 Too Many Requestsを受け取りました。リクエストが成功した場合でも、古いセレクタは何にもマッチしないか、個別銘柄ではなくS&P 500の価格にマッチしていました。
このガイドでは、そのJSONからYahoo Financeをスクレイピングする方法、429を回避する方法、サーバーへの移行方法を解説します。
要約
- Yahooの最初のリクエストでの429は、リクエストレートではなくクライアントに依存します。 Chromeになりすましたcurl_cffiは、429なしで503のS&P 500見積もりページをリクエストしました。
- 1回のリクエストでティッカーの価格履歴全体を取得できます。 period1=0で、MSFTの履歴データタブは1986年以降のすべての日次バーを返しました。
- 200を返した場合でも、すべてのページを検証してください。 MetaのFBという旧シンボルはProShares ETFを返し、Vodafoneのロンドンでのpriceはペンスでした。
- フェッチ関数を交換してサーバーに移行します。 Bright DataのWeb Unlocker APIはIPローテーションと自動リトライを追加します。または、Bright DataのYahoo Finance Scraper APIは構造化されたレコードを返します。
Yahoo Financeがデータを保持している場所
見積もりページの数値は、そのHTML内にJSONとして埋め込まれています。YahooはJavaScriptフレームワークであるSvelteKitを使用してサーバー上でページをレンダリングし、レンダリング中に独自のJSON APIを呼び出します。SvelteKitは各レスポンスをHTML内にインライン化するため、ブラウザは再取得することなくそれを再利用できます。各レスポンスは独自のscriptタグ内にあり、data-sveltekit-fetched属性とソースAPI URLをdata-urlに持っています。
MSFTのサマリータブからのタグは次のようになっており、JSON本文は短縮されています:
<script type="application/json" data-sveltekit-fetched
data-url="https://query1.finance.yahoo.com/v1/finance/quoteType/MSFT?formatted=true&enablePrivateCompany=true&overnightPrice=true&lang=en-US&region=US"
data-hash="1ibomen" data-ttl="1800">
{"status":200,"statusText":"","headers":{"cache-control":"public, max-age=1800, stale-while-revalidate=1800"},"body":"{\"quoteType\":{\"result\":[{\"symbol\":\"MSFT\",\"quoteType\":\"EQUITY\",\"exchange\":\"NMS\",\"longName\":\"Microsoft Corporation\"}],\"error\":null}}"}
</script>bodyフィールドにはAPIレスポンスがJSON文字列として含まれています。タグのパースには2回のjson.loads()呼び出しが必要です。最初の呼び出しでラッパーをパースし、2回目の呼び出しでbody文字列をパースします。見積もりページの各タブには異なるAPIレスポンスのセットが埋め込まれています:
| タブ | 埋め込まれたAPIレスポンス | そこから読み取れるもの |
|---|---|---|
/quote/MSFT/ |
v10/finance/quoteSummaryとv7/finance/spark |
価格、時価総額、PER、配当、52週範囲、アナリスト目標株価、最大24時間分の5分間隔の終値 |
/quote/MSFT/history/ |
v8/finance/chart |
日次、週次、または月次の価格、調整後終値、株式分割、配当 |
/quote/MSFT/financials/、balance-sheet/、cash-flow/ |
ws/fundamentals-timeseries |
年次および直近12か月の項目 |
/quote/MSFT/analysis/ |
earningsTrendを含むv10/finance/quoteSummary |
EPSと収益予想、アナリスト人数、決算サプライズ |
/quote/MSFT/key-statistics/ |
ws/fundamentals-timeseries |
四半期ごとの時価総額、企業価値、バリュエーション比率 |
/quote/MSFT/profile/ |
assetProfileを含むv10/finance/quoteSummary |
主要な経営陣、従業員数、セクター、SEC提出書類 |
/quote/MSFT/holders/ |
所有権モジュールを含むv10/finance/quoteSummary |
機関投資家、ファンド、インサイダーの保有者 |
/quote/MSFT/options/ |
v7/finance/options |
最も近い満期日のオプションチェーン、および満期日のリスト |
YahooのAPIホストであるquery1.finance.yahoo.comとquery2.finance.yahoo.comは同じJSONを提供しており、オープンソースのyfinanceライブラリはそれらを直接呼び出します。それらのホストでは、quote、quoteSummary、optionsエンドポイントはcrumbがないリクエストに対して401を返しました。crumbとは、Yahooがセッションcookieと一緒に発行し、crumb=クエリパラメータとして期待するトークンです。
古いCSVダウンロードは401 User is not logged inを返しました。両方のAPIホストで、robots.txtはすべてのパスを禁止しています(Disallow: /)。見積もりページに埋め込まれたレスポンスには、cookie、crumb、APIホストへのアクセスは一切必要ありません:
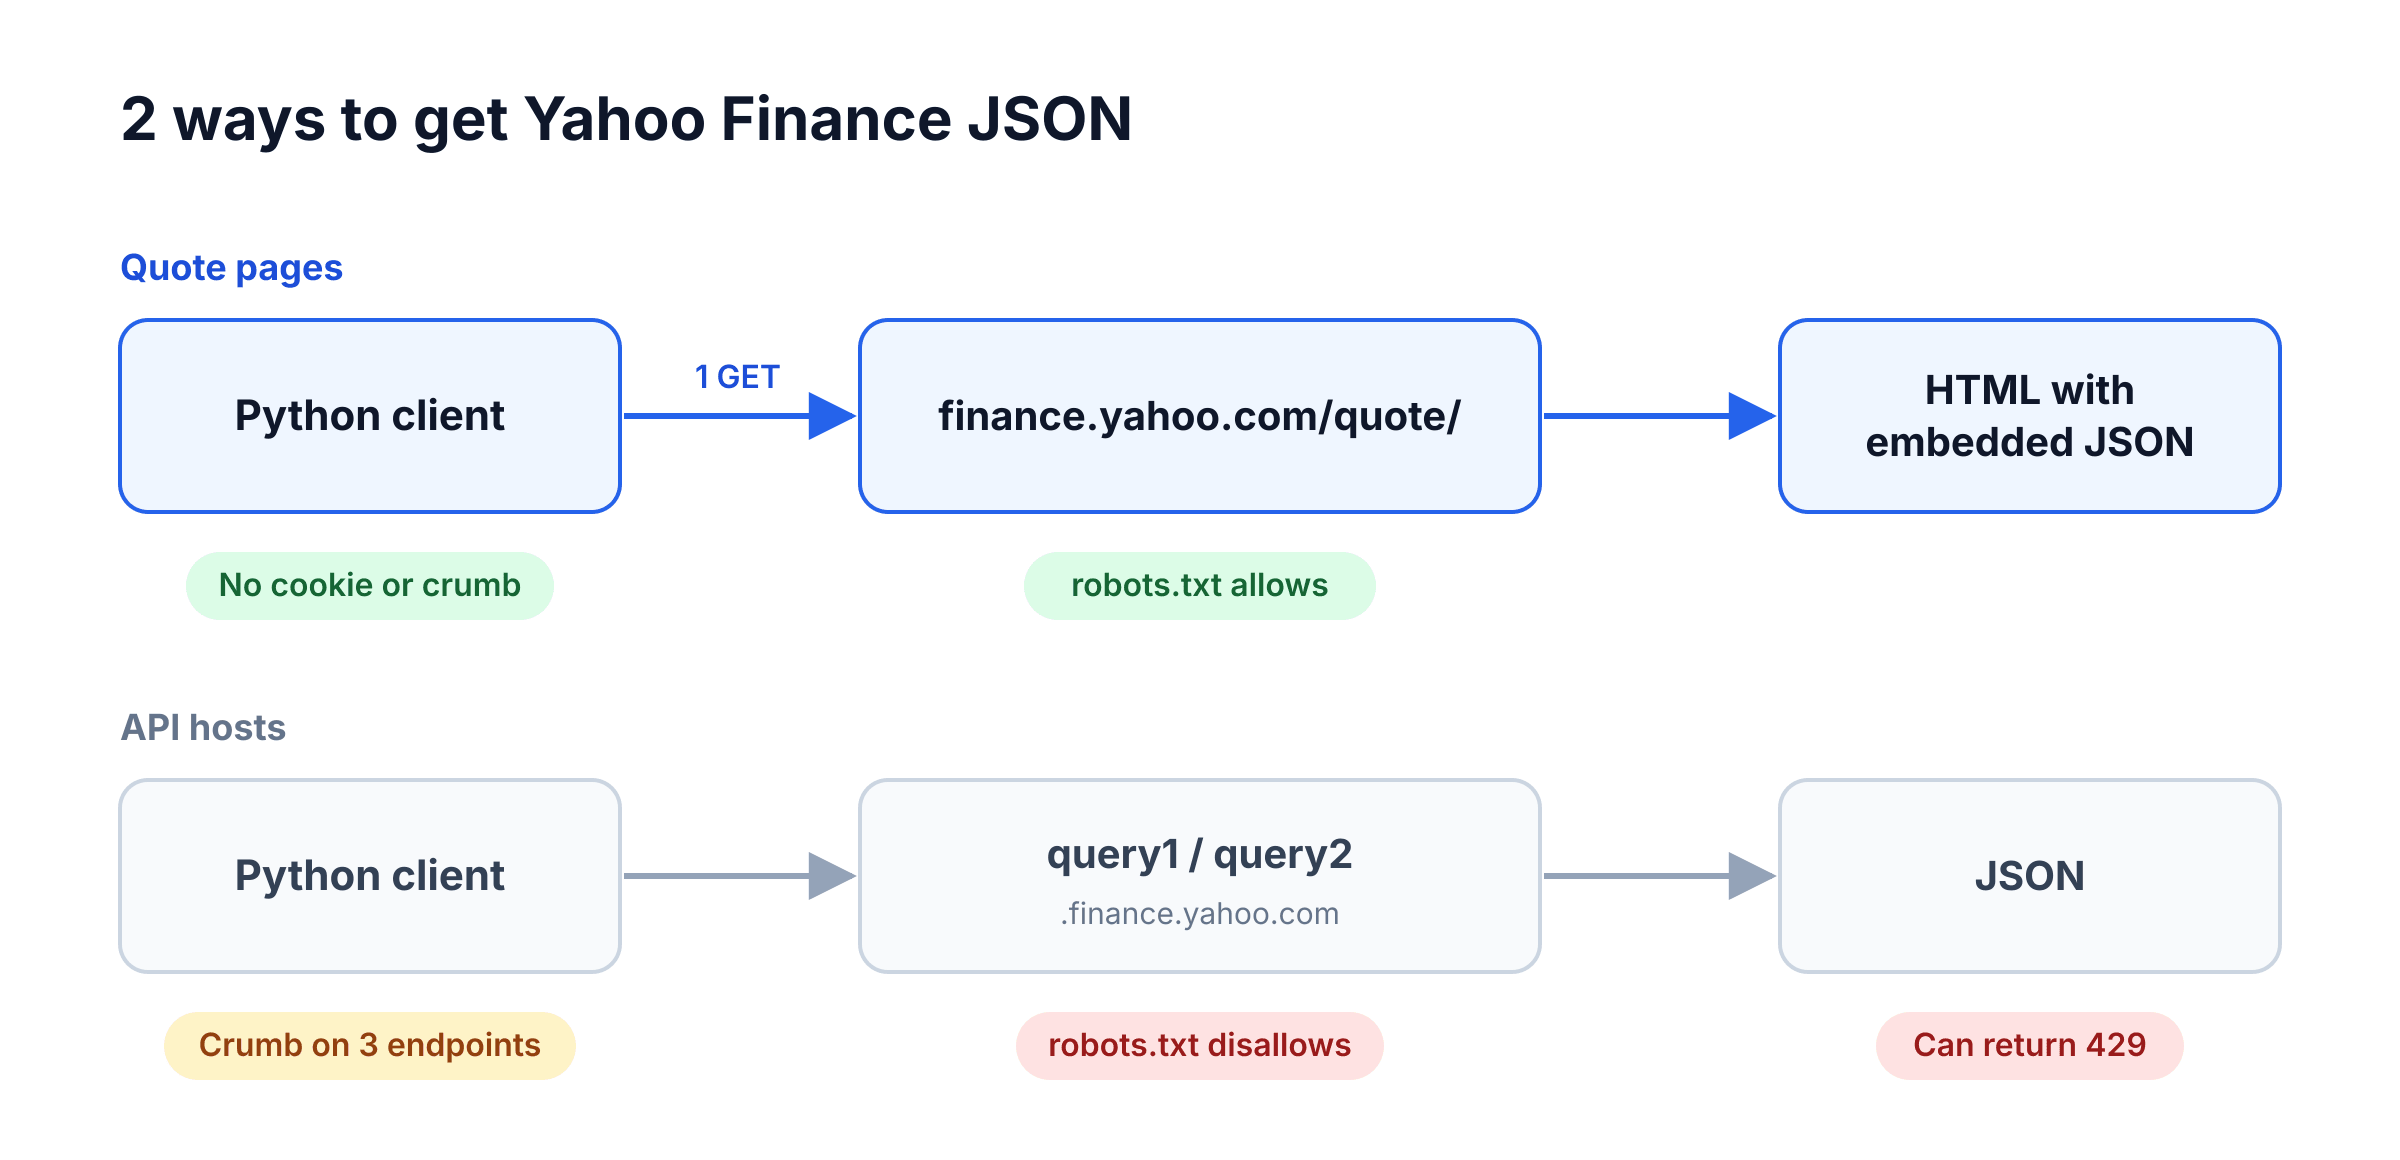
スクリプトは見積もりページのみを読み取るため、APIホストを呼び出すことは一切ありません。
多くの古いチュートリアルは、もはや機能しないCSSセレクタで価格を読み取っています。MSFTページでは、[data-symbol="MSFT"][data-field="regularMarketPrice"]と#quote-summary [data-test="PREV_CLOSE-value"]は0個の要素にマッチしました。より一般的なfin-streamer[data-field="regularMarketPrice"]セレクタは9個にマッチしましたが、最初のマッチはページの市場サマリーからのS&P 500の価格を含んでいました。
他のチュートリアルではブラウザを自動化します。埋め込まれたJSONにより、見積もり、日次履歴、年次財務諸表、予想についてはブラウザが不要になります。なぜなら、タブごとに1回のHTTPリクエストで同じデータが返されるからです。
ブラウザを使用する場合は、生のHTMLレスポンスを読み取ってください。SvelteKitのクライアントサイドコードは各scriptタグを読み取った後に削除するためです。4回のテストページ読み込みのうち2回で、page.content()はタグなしのページを返しました。そのうちの1回では、DOMContentLoadedが発火した直後にスクレイパーがページを読み取っていました。
Yahoo Financeが最初のリクエストで429を返す理由
Yahooのレスポンスはクライアントのユーザーエージェントとtlsハンドシェイクに依存していたため、クライアントは最初のリクエストで429を受け取る可能性があります。レスポンスのserver: ATSヘッダーはApache Traffic Serverを示しています。デフォルト設定では、Pythonのrequestsライブラリは最初のリクエストで429を受け取りました。429レスポンスには2つの形式がありました:
- デフォルトの
python-requests/2.34.2ユーザーエージェントでは、以下の表のすべてのTLSスタックが23バイトのEdge: Too Many Requestsレスポンスを受け取りました。Pythonのrequestsライブラリはfinance.yahoo.comでも同じレスポンスを受け取りました。 - APIホストでは、PythonのTLSスタック上での一部のブラウザユーザーエージェントは19バイトの
Too Many Requestsレスポンスを受け取りました。
表は、yfinanceが使用するAPIホストであるquery1が、1つのレジデンシャル接続から少なくとも1.5秒間隔で送信されたチャートリクエストにどう応答したかを示しています。PythonのHTTPクライアントであるcurl_cffiライブラリは、ブラウザのTLSハンドシェイクになりすますことができます。各行はTLSスタックとUser-Agentヘッダーをペアにしています:
| TLSスタック | User-Agentヘッダー | 429を受け取った回数 |
|---|---|---|
| Python requests(OpenSSL) | デフォルトのpython-requests/2.34.2 |
5回中5回 |
| Python requests(OpenSSL) | macOSのChrome 140 | 26回中26回 |
| Python requests(OpenSSL) | WindowsのFirefox 147 | 17回中16回 |
| Python requests(OpenSSL) | macOSのSafari 26 | 11回中8回 |
| Python requests(OpenSSL) | macOSのChrome 150 | 6回中3回 |
| Python requests(OpenSSL) | WindowsのChrome 150 | 11回中0回 |
| Python requests(OpenSSL) | Mozilla/5.0単体 |
11回中0回 |
| curl_cffi(Chrome、Firefox、Safariハンドシェイク) | Chrome 140または150、Firefox 147、Safari 26、またはMozilla/5.0 |
80回中0回 |
| curl_cffi(同じ3つのハンドシェイク) | python-requests/2.34.2 |
15回中15回 |
なぜTLSハンドシェイクが重要なのか?
User-Agentが同じであっても、Yahooのレスポンスは使用しているTLSスタックに依存していました。管理されたテストでは、requestsとcurl_cffiは同じIPアドレスからHTTP/1.1で同じUser-Agent(macOSのChrome 140)とAcceptヘッダーを送信しました。変化したのはHTTPクライアントとそのTLSスタックだけでした。Pythonのrequestsライブラリ経由では8回中0回成功し、curl_cffiのChrome TLSスタック経由では8回中8回成功しました。
ヘッダーが送信される前から、2つのスタックはすでに異なっています。TLSフィンガープリンティングの一般的な形式であるJA4フィンガープリントは、クライアントがTLSハンドシェイクで最初に送信するメッセージであるClientHelloを要約したものです。PythonのOpenSSLハンドシェイクはt13d1812h1_85036bcba153_b26ce05bbdd6を生成し、curl_cffiのchromeターゲットはt13d1516h2_8daaf6152771_806a8c22fdeaを生成し、これはChromeの暗号スイートと一致します。自身のクライアントからhttps://tls.peet.ws/api/allをリクエストして、何が送信されているかを確認してください。
それぞれの結果はTLSスタックとUser-Agentの組み合わせに依存していました。Mozilla/5.0という文字列単体ではPythonのTLS上で11回中11回成功しました。macOSのChrome 140は26回中26回失敗し、Firefox 147は17回中16回失敗しました。つまり、リアルなブラウザのUser-Agentを使用すると、Pythonのrequestsライブラリがより頻繁に失敗する可能性があります。
curl_cffiのブラウザのTLSハンドシェイクを使用すると、表のブラウザUser-Agentは80回中80回成功しました。より小規模なテストでは、finance.yahoo.com自体がPythonのTLS上でChrome 140の文字列を受け入れ、デフォルトのpython-requests文字列をブロックしました。スクレイパーコードはfinance.yahoo.comでもcurl_cffiを使用しているため、User-AgentとTLSハンドシェイクの両方がChromeと一致します。
ブラウザのUser-Agentを送信する場合は、それに合わせてブラウザのTLSハンドシェイクも送信してください。
リクエストレートは重要なのか?
最初のリクエストでの429には関係ありません。それはクライアントに依存します。8スレッドで、curl_cffiは429を受けることなく503すべてのS&P 500見積もりページをリクエストし、続けて501件の履歴データページをリクエストしました。これは日次のS&P 500更新に相当する量です。より高いボリュームで429が発生した場合、スクレイパーコードはバックオフして再試行します。
yfinanceのissueトラッカーに投稿されたレート制限スニペットは、トラフィックを毎分60リクエスト、毎時360リクエスト、1日8,000リクエストに制限しています。これらの数値はYahoo DSP Traffic APIのレート制限ページからのものです。Yahoo DSPは広告購入のためのデマンドサイドプラットフォームであるため、このスニペットは別の製品の制限を使用しています。
yfinanceライブラリもYahooから429エラーを受け取り、YFRateLimitError('Too Many Requests. Rate limited. Try after a while.')として発生させていました。429エラーに関するissueスレッドが140件以上のコメントを受け取った後、yfinanceのメンテナーは同じ修正、つまりブラウザのTLSハンドシェイクを採用しました。バージョン0.2.58(2025年)でライブラリはcurl_cffiに移行し、バージョン1.7.0ではimpersonate="chrome"でデフォルトのセッションを作成します。
クラウドサーバーからコードは動作するのか?
はい、Microsoft AzureのIPアドレスを持つ3つのGitHub Actionsランナーで動作します。各ランナーで、curl_cffiの最初のリクエストは、米国株やETFから暗号資産や海外上場銘柄まで、20銘柄それぞれの見積もりページを返しました。2回目の実行では、各ランナーが429なしで503すべてのS&P 500見積もりページをリクエストしました。
スクリプトは自宅と同じ履歴、財務諸表、予想を返しました。ランナー上では、デフォルトのUser-Agentを使ったPythonのrequestsライブラリは同じ23バイトの429レスポンスを受け取った一方、yfinanceはMSFTの完全な日次履歴を取得しました。
報告されているクラウドでの失敗には古いクライアントや共有IPレンジが関わっているため、ジョブをスケジュールする前に自身のサーバーからスクリプトをテストしてください。2025年、yfinanceがcurl_cffiに移行する前、そのメンテナーはYahooからのデータ取得に失敗した後にGitHub Actionsのテストジョブを削除しました。別の開発者は、クラウドプラットフォームであるRenderの共有無料枠IPレンジに401「Invalid Crumb」レスポンスの原因を追跡しました。同じ呼び出しはレジデンシャルIPからは正常に動作しました。
見積もりページから埋め込まれたJSONを抽出する
Python 3.11以降と5つのパッケージが必要です。コードはPython 3.11、3.13、3.14で、curl_cffi 0.16.3、beautifulsoup4 4.15.0、lxml 6.1.3、pandas 3.0.6、requests 2.34.2を使用してテストされました。pipでインストールします:
pip install curl_cffi beautifulsoup4 lxml pandas requestsPythonスクレイピングの基本については、Pythonでのウェブスクレイピングガイドをご覧ください。コアモジュールは単一のタブを取得し、Yahooが見積もりページを返したことを確認し、APIのURLをキーとした埋め込まれたレスポンスを返します。これをyahoo_embedded.pyとして保存してください。Yahooのページを読み取るスクリプトはこれに依存しているためです:
import json
import random
import threading
import time
from urllib.parse import quote

from bs4 import BeautifulSoup
from curl_cffi import requests

QUOTE_URL = "https://finance.yahoo.com/quote"
_local = threading.local()


class SymbolNotFound(Exception):
    """Yahoo returned its lookup page or a soft 404 instead of a quote page."""


def page_url(symbol: str, tab: str = "") -> str:
    return (
        f"{QUOTE_URL}/{quote(symbol.upper(), safe='')}/{tab}"  # ^GSPC becomes %5EGSPC
    )


def embedded(html: str) -> dict[str, dict]:
    """Map the API URLs the page was rendered from to their JSON bodies."""
    soup = BeautifulSoup(html, "lxml")
    found = {}
    for tag in soup.select('script[type="application/json"][data-sveltekit-fetched]'):
        try:
            wrapper = json.loads(tag.string)
            found[tag["data-url"]] = json.loads(wrapper["body"])
        except (TypeError, KeyError, ValueError):
            continue  # an embedded response whose body isn't JSON
    return found


def pick(found: dict[str, dict], path: str) -> dict:
    """Return the first embedded response whose URL contains `path`."""
    for url, body in found.items():
        if path in url:
            return body
    raise LookupError(f"no embedded response for {path}")


def is_quote_page(html: str, symbol: str) -> bool:
    """True for a quote page, False otherwise, SymbolNotFound for an unknown symbol."""
    found = embedded(html)
    if any("/v1/finance/lookup" in url for url in found):
        raise SymbolNotFound(symbol)
    for url, body in found.items():
        if "/v1/finance/quoteType/" in url:
            result = (body.get("quoteType") or {}).get("result") or [{}]
            if not result[0].get("exchange"):
                # A soft 404, as for BRK.B (Yahoo spells it BRK-B)
                raise SymbolNotFound(symbol)
            return True
    return False


def _session() -> requests.Session:
    # One Chrome-impersonating session per thread, as curl_cffi recommends.
    if not hasattr(_local, "session"):
        _local.session = requests.Session(impersonate="chrome")
    return _local.session


def fetch_page(
    symbol: str, tab: str = "", params: dict | None = None, attempts: int = 4
) -> str:
    """Return the HTML of a quote page, for example tab="history/"."""
    for attempt in range(attempts):
        if attempt:
            time.sleep(2**attempt + random.random())  # back off before each retry
        try:
            response = _session().get(
                page_url(symbol, tab), params=params, timeout=30, allow_redirects=False
            )
        except requests.RequestException:
            continue  # timeout or dropped connection
        if response.is_redirect:
            location = response.headers.get("location", "")
            if "/lookup" in location:
                raise SymbolNotFound(symbol)
            # For example, a tab that doesn't exist
            raise LookupError(f"{symbol} {tab}: Yahoo redirected to {location}")
        if response.status_code == 200 and is_quote_page(response.text, symbol):
            return response.text
        if 400 <= response.status_code < 500 and response.status_code != 429:
            response.raise_for_status()
    # Every attempt timed out or got a 429, a 5xx, or a page without quote data
    raise RuntimeError(f"{symbol} {tab}: no quote data after {attempts} attempts")


if __name__ == "__main__":
    from urllib.parse import urlsplit

    found = embedded(fetch_page("MSFT"))
    print(len(found), "embedded responses")
    for url in found:
        if url.startswith("https://"):
            print(urlsplit(url).netloc, urlsplit(url).path)
このモジュールは3つのエッジケースを処理します:
allow_redirects=Falseは、リダイレクトを追わずにクライアントを停止させます。/lookup/への302は不明なシンボルを意味するため、モジュールはSymbolNotFoundを発生させます。robots.txtで禁止されているため、lookupページ自体は取得しません。ETFには存在しないタブなど、それ以外のリダイレクトは最初の試行でLookupErrorを発生させます。is_quote_page()は、ステータス200だけではページにデータがあることを証明できないため、quoteTypeレスポンスの有無を確認します。news/を含むMSFTの11タブすべてにそれが埋め込まれていました。exchangeのないquoteTypeは、ステータス200だが見積もりデータのないソフト404ページを意味します。YahooはBRK.Bに対してその種のページを返しました。これはシンボルがBRK-Bと表記されるためです。quote(symbol.upper(), safe='')はシンボルを大文字にし、^GSPCのようなインデックスシンボルをパーセントエンコードします。^はエンコードされるまで有効なURL文字ではないためです。
MSFTについて、このモジュールはページが呼び出すYahooのAPIをリストします:
23 embedded responses
query1.finance.yahoo.com /ws/obi-integration/v1/premiumTiersMeta
query1.finance.yahoo.com /v1/finance/quoteType/MSFT
query1.finance.yahoo.com /v7/finance/spark
query1.finance.yahoo.com /v6/finance/quote/marketSummary
query1.finance.yahoo.com /v7/finance/quote
query1.finance.yahoo.com /v7/finance/quote
query1.finance.yahoo.com /v6/finance/recommendationsbysymbol/MSFT
query1.finance.yahoo.com /v6/finance/markettime
query1.finance.yahoo.com /v7/finance/spark
query1.finance.yahoo.com /v10/finance/quoteSummary/MSFT
query1.finance.yahoo.com /v1/finance/trending/US
query1.finance.yahoo.com /v7/finance/quote
query1.finance.yahoo.com /v1/finance/screener/predefined/savedサマリータブの統計データはv10/finance/quoteSummaryからのもので、MSFTに関しては17モジュールにわたり約223KBのJSONを含んでいました。リストには13個の絶対APIのURLが示されており、残りの10件のレスポンスはYahoo自身の/xhr/エンドポイントからのものでした。23件のうちほとんどは、トレンドティッカーや市場サマリーなどのページウィジェットにデータを提供しています。件数は変動します:米国のクラウドランナーからは、同じページが26件のレスポンスを埋め込んでおり、追加分にはprice-insightsが含まれていました。
価格、バリュエーション、レーティングのフィールドをパースする
quoteSummary内の多くの数値は{"raw": 516.17, "fmt": "516.17"}のペアになっているため、ヘルパー関数は生の値を保持します。この関数は20個の見積もりフィールドを返します。estimatesとbatchスクリプトがこれを再利用するため、quote_summary.pyとして保存してください:
import json

from yahoo_embedded import embedded, fetch_page, pick


def raw(module: dict, key: str):
    """Many numbers are {"raw": 516.17, "fmt": "516.17"} pairs. Keep the raw value."""
    value = module.get(key)
    return value.get("raw") if isinstance(value, dict) else value


def quote_summary(symbol: str, fetch=fetch_page) -> dict:
    found = embedded(fetch(symbol))
    result = pick(found, "/v10/finance/quoteSummary/")["quoteSummary"]["result"][0]
    price = result.get("price", {})
    detail = result.get("summaryDetail", {})
    stats = result.get("defaultKeyStatistics", {})
    analysts = result.get("financialData", {})
    return {
        "symbol": price.get("symbol"),
        "name": price.get("longName") or price.get("shortName"),
        "quote_type": price.get("quoteType"),
        "currency": price.get("currency"),
        "price": raw(price, "regularMarketPrice"),
        "change_pct": raw(price, "regularMarketChangePercent"),
        "market_time": raw(price, "regularMarketTime"),
        "market_state": price.get("marketState"),
        "delay_minutes": price.get("exchangeDataDelayedBy"),
        "market_cap": raw(price, "marketCap"),
        "trailing_pe": raw(detail, "trailingPE"),
        "forward_pe": raw(detail, "forwardPE"),
        "dividend_yield": raw(detail, "dividendYield"),
        "beta": raw(detail, "beta"),
        "week52_low": raw(detail, "fiftyTwoWeekLow"),
        "week52_high": raw(detail, "fiftyTwoWeekHigh"),
        "eps_ttm": raw(stats, "trailingEps"),
        "target_mean": raw(analysts, "targetMeanPrice"),
        "recommendation": analysts.get("recommendationKey"),
        "reporting_currency": analysts.get("financialCurrency"),
    }


if __name__ == "__main__":
    print(json.dumps(quote_summary("MSFT"), indent=2))
MSFTについて、この関数は市場終了後に20個すべてのフィールドの生の値を出力しました:
{
  "symbol": "MSFT",
  "name": "Microsoft Corporation",
  "quote_type": "EQUITY",
  "currency": "USD",
  "price": 516.17,
  "change_pct": 0.0366316,
  "market_time": 1790366401,
  "market_state": "CLOSED",
  "delay_minutes": 0,
  "market_cap": 3832843862016,
  "trailing_pe": 28.739979,
  "forward_pe": 21.801512,
  "dividend_yield": 0.0076,
  "beta": 1.108,
  "week52_low": 349.2,
  "week52_high": 553.72,
  "eps_ttm": 17.96,
  "target_mean": 577.26135,
  "recommendation": "strong_buy",
  "reporting_currency": "USD"
}
サマリータブには、3.833Tの時価総額、28.74のPER、0.76%の配当利回りなど、同じ数値がフォーマットされて表示されていました:
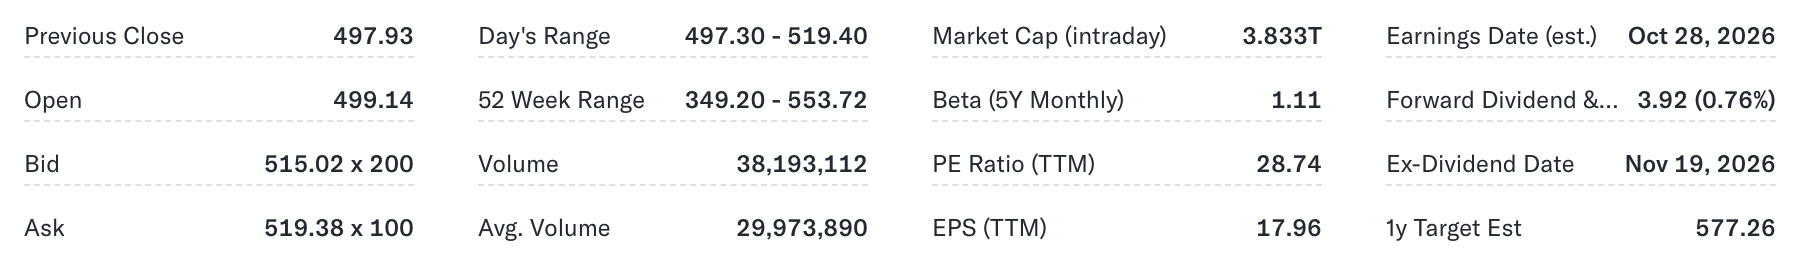
JSONには代わりに生の値が含まれており、たとえば3.833Tの時価総額は3832843862016となっています。
生の値では、パーセンテージは小数で表されるため、0.0366316のchange_pctは3.66%の変動を意味し、0.0076のdividend_yieldは0.76%を意味します。埋め込まれたモジュールは資産タイプによって異なるため、この関数はすべてのモジュールを.get()で読み取ります。SPY、^GSPC、BTC-USD、EURUSD=XはすべてfinancialDataモジュールなしで価格を返したため、それらのアナリストフィールドはNoneでした。SPYには代わりにfundProfileとtopHoldingsが含まれていました。
1回のリクエストで価格履歴全体をダウンロードする
履歴データタブ(history/)は、独自のURLからperiod1、period2、frequencyパラメータを、埋め込むチャートリクエストに渡します。両方のperiodパラメータはUnixタイムスタンプであるため、period1を0に設定すると1970年1月1日以降のすべてのバーが要求されます。すると日付ピッカーはその日付から始まり、frequency=1dは日次の行を表示します:
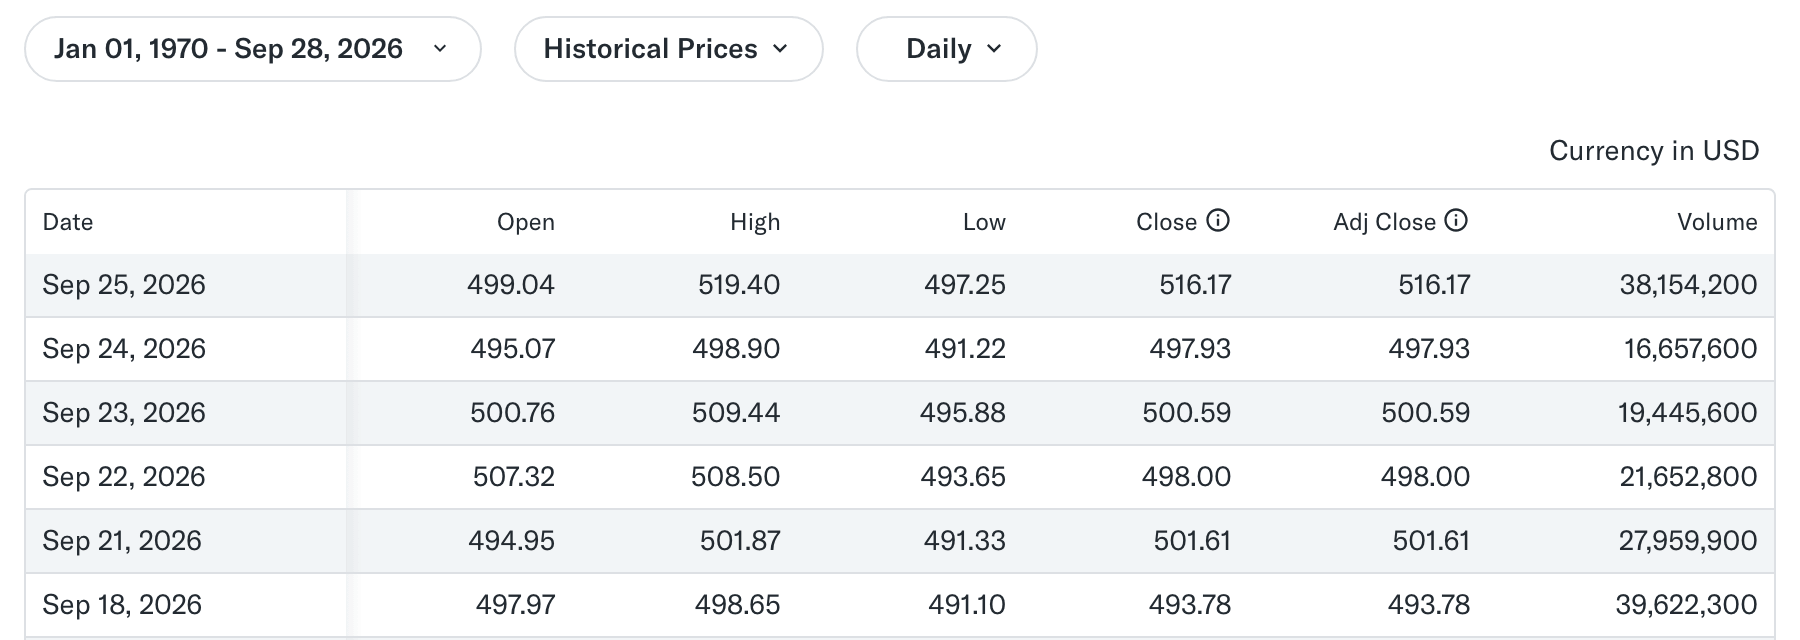
表の最新行は、以下でprice_history()が出力する最後の行と一致します。
price_history()関数は、埋め込まれたチャートレスポンスを、取引所のタイムゾーンでインデックスされたDataFrameに変換します。これをprice_history.pyとして保存してください:
import time

import pandas as pd

from yahoo_embedded import embedded, fetch_page, pick


def price_history(
    symbol: str, frequency: str = "1d", fetch=fetch_page
) -> tuple[pd.DataFrame, dict]:
    """Every bar since 1970 at 1d, 1wk or 1mo, plus split and dividend events."""
    params = {"period1": 0, "period2": int(time.time()), "frequency": frequency}
    found = embedded(fetch(symbol, "history/", params))
    result = pick(found, "/v8/finance/chart/")["chart"]["result"][0]
    bars, meta = result["indicators"]["quote"][0], result["meta"]
    utc = pd.to_datetime(result["timestamp"], unit="s", utc=True)
    index = utc.tz_convert(meta["exchangeTimezoneName"]).tz_localize(None).normalize()
    frame = pd.DataFrame(
        {
            "open": bars["open"],
            "high": bars["high"],
            "low": bars["low"],
            "close": bars["close"],
            "adj_close": result["indicators"]["adjclose"][0]["adjclose"],
            "volume": bars["volume"],
        },
        index=index,
    )
    if frequency != "1d" and result["timestamp"][-1] == meta.get("regularMarketTime"):
        frame = frame.iloc[:-1]  # Yahoo appends the latest session as an extra bar
    return frame.dropna(how="all"), result.get("events", {})


if __name__ == "__main__":
    history, events = price_history("MSFT")
    print(history.tail(3).round(2).to_string())
    print(
        f"{len(history):,} daily bars from {history.index[0]:%Y-%m-%d} "
        f"to {history.index[-1]:%Y-%m-%d}"
    )
    splits = sorted(
        pd.Timestamp(s["date"], unit="s").date()
        for s in events.get("splits", {}).values()
    )
    if splits:
        print(f"{len(splits)} splits, the last one on {splits[-1]}")
1回のリクエストでMSFTの履歴全体が返されました:
              open    high     low   close  adj_close    volume
2026-09-23  500.76  509.44  495.88  500.59     500.59  19445600
2026-09-24  495.07  498.90  491.22  497.93     497.93  16657600
2026-09-25  499.04  519.40  497.25  516.17     516.17  38154200
10,213 daily bars from 1986-03-13 to 2026-09-25
9 splits, the last one on 2003-02-18
APIホスト経由でも、yfinanceはその範囲に対して同じ10,213本のバーを返しました。履歴データのパイプラインでは、以下の5つの詳細を処理してください:
- テストでは、履歴は1970年より前には始まりませんでした。Yahooの履歴データに関するヘルプページには、通常それより前からは価格が始まらないと記載されています。コカ・コーラは1919年から取引されていますが、その完全な履歴は1970-01-02から始まっていました。負の
period1は404を返しました。 frequencyは1d、1wk、1moをサポートします。1wkと1moでは、Yahooは最後のセッションを追加のバーとして付加するため、この関数はそれを削除します。そのバーが削除された状態では、最終の週次または月次バーには最後の取引セッションが含まれない場合があるため、直近の終値は日次バーから取得してください。1h、5m、1mなどの日中値は、代わりに日次バーを返しました。サマリータブには/v7/finance/sparkから最大24時間分の5分足終値が埋め込まれています。市場サマリー用に2つ目のsparkレスポンスも埋め込まれているため、symbolsパラメータがティッカーと一致するレスポンスを選んでください。見積もりページにはその24時間分の日中データしか含まれていません。それより長い日中履歴はAPIホストから提供されますが、robots.txtで禁止されているためです。- Yahooは株式分割について
closeを、株式分割と配当についてadj_closeを調整します。新しい株式分割や配当があるたびに過去のバーが変化するため、ダウンロードごとに株式分割と配当のイベントを保存してください。 - ページサイズは日付範囲とともに増加します。フルの日付範囲では、MSFTの履歴データタブは4.9MBのHTMLで、サマリータブは約1.1MBでした。日次更新の場合は、
period1を最近のタイムスタンプに設定し、新しい株式分割や配当があった後に全範囲を再ダウンロードしてください。
財務諸表とアナリスト予想を取得する
財務諸表と予想は異なるタブにあるため、それぞれに専用の関数を用意します。
年次財務諸表を取得する
財務諸表は、財務諸表、貸借対照表、キャッシュフロータブのfundamentals-timeseriesレスポンスから取得されます。MSFTの財務諸表タブでは、そのレスポンスには96個の年次シリーズと96個の直近12か月シリーズが含まれていました。statement()は年次シリーズを保持し、会計年度ごとに1列を持つテーブルにピボットします。これをstatements.pyとして保存してください:
import pandas as pd

from yahoo_embedded import embedded, fetch_page, pick


def statement(symbol: str, tab: str = "financials/", fetch=fetch_page) -> pd.DataFrame:
    """Annual line items from the financials/, balance-sheet/ or cash-flow/ tab."""
    found = embedded(fetch(symbol, tab))
    series = pick(found, "/fundamentals-timeseries/")["timeseries"]["result"]
    rows = []
    for item in series:
        name = item["meta"]["type"][0]  # for example "annualTotalRevenue"
        if not name.startswith("annual"):
            continue  # skip non-annual series, such as trailing 12 months
        for point in item.get(name) or []:
            if point:
                rows.append(
                    {
                        "line_item": name.removeprefix("annual"),
                        "fiscal_year_end": point["asOfDate"],
                        "value": point["reportedValue"]["raw"],
                    }
                )
    table = pd.DataFrame(rows).pivot(
        index="line_item", columns="fiscal_year_end", values="value"
    )
    return table.sort_index(axis=1)


if __name__ == "__main__":
    income = statement("MSFT")
    billions = (
        income.loc[["TotalRevenue", "GrossProfit", "OperatingIncome", "NetIncome"]].T
        / 1e9
    )
    billions["DilutedEPS"] = income.loc["DilutedEPS"]
    print(billions.round(2).to_string())
    print(f"{len(income)} line items")
スクリプトは、EPSを除き10億ドル単位で損益計算書の4会計年度分を出力しました:
line_item        TotalRevenue  GrossProfit  OperatingIncome  NetIncome  DilutedEPS
fiscal_year_end
2023-06-30             211.92       146.05            88.52      72.36        9.68
2024-06-30             245.12       171.01           109.43      88.14       11.80
2025-06-30             281.72       193.89           128.53     101.83       13.64
2026-06-30             331.84       225.46           155.24     133.75       17.95
47 line items
財務諸表タブでは、Yahooは千単位で同じ数値を表示しており、出力中の331.84Bの収益は331,839,000として表示されています:
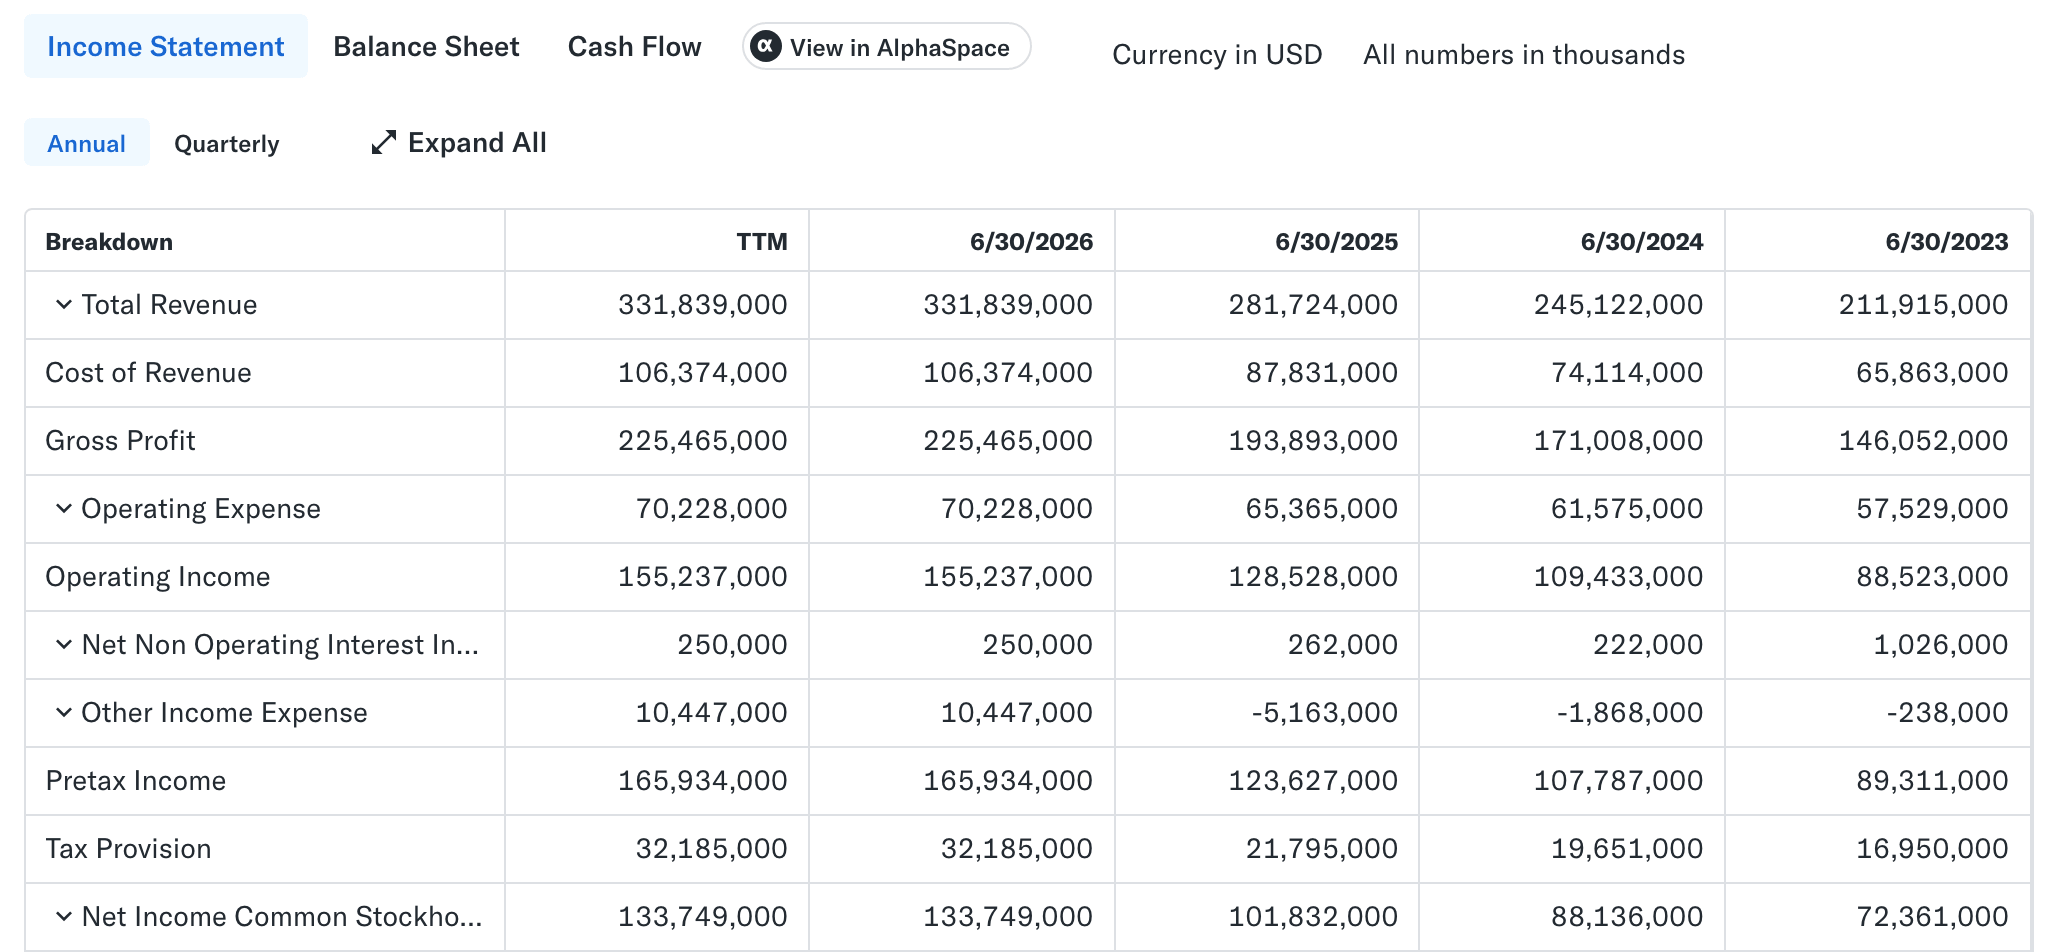
Income Statement、Balance Sheet、Cash Flowの各ビューは、statement()が読み取るfinancials/、balance-sheet/、cash-flow/の各タブです。
MSFTでは、96個の年次シリーズのうち47個に値がありました。空のシリーズは、保険金請求、優先配当、物品税などの項目でした。その4年間について、関数はbalance-sheet/から79項目、cash-flow/から59項目を返しました。四半期財務諸表はQuarterlyトグルを選択した後にのみ読み込まれ、テストしたどのURLパラメータもそれを変更できませんでした。
quoteSummary内のincomeStatementHistoryとbalanceSheetHistoryモジュールはスキップしてください。これらの損益の行は、年次版と四半期版の両方で、総収益と純利益にのみ実際の値を持っていました。貸借対照表の行には日付しかありませんでした。その他の損益フィールドにはプレースホルダーとして0が含まれていたため、それを信頼するパーサーは売上総利益を0として保存してしまいます。
アナリスト予想を取得する
analysisタブにはearningsTrendが埋め込まれており、当四半期、次四半期、当年度、次年度のコンセンサスEPSと収益が含まれています。estimates()はそれを期間ごとに1行にフラット化します。これをestimates.pyとして保存してください:
import pandas as pd

from quote_summary import raw
from yahoo_embedded import embedded, fetch_page, pick


def estimates(symbol: str, fetch=fetch_page) -> pd.DataFrame:
    """Consensus EPS and revenue for the current and next quarter and year."""
    found = embedded(fetch(symbol, "analysis/"))
    result = pick(found, "/v10/finance/quoteSummary/")["quoteSummary"]["result"][0]
    rows = []
    for period in result["earningsTrend"]["trend"]:
        eps, revenue = period["earningsEstimate"], period["revenueEstimate"]
        revenue_avg = raw(revenue, "avg")
        rows.append(
            {
                "period": period["period"],  # 0q, +1q, 0y, +1y
                "ends": period["endDate"],
                "eps_avg": raw(eps, "avg"),
                "eps_low": raw(eps, "low"),
                "eps_high": raw(eps, "high"),
                "eps_analysts": raw(eps, "numberOfAnalysts"),
                "revenue_avg_bn": None if revenue_avg is None else revenue_avg / 1e9,
                "revenue_analysts": raw(revenue, "numberOfAnalysts"),
            }
        )
    return pd.DataFrame(rows).set_index("period")


if __name__ == "__main__":
    print(estimates("MSFT").round(2).to_string())
MSFTについて、各予想は25〜51人のアナリストから出されたものでした:
              ends  eps_avg  eps_low  eps_high  eps_analysts  revenue_avg_bn  revenue_analysts
period
0q      2026-09-30     4.72     4.43      4.83            25           90.66                38
+1q     2026-12-31     4.82     4.72      5.02            25           95.49                37
0y      2027-06-30    19.76    19.21     20.70            33          391.04                50
+1y     2028-06-30    23.68    22.08     26.00            32          467.27                51
analysisタブでは、Earnings Estimateテーブルに同じEPSの数値が表示されます。そのCurrent Qtr.、Next Qtr.、Current Year、Next Yearの各列は、0q、+1q、0y、+1yの行と一致します:
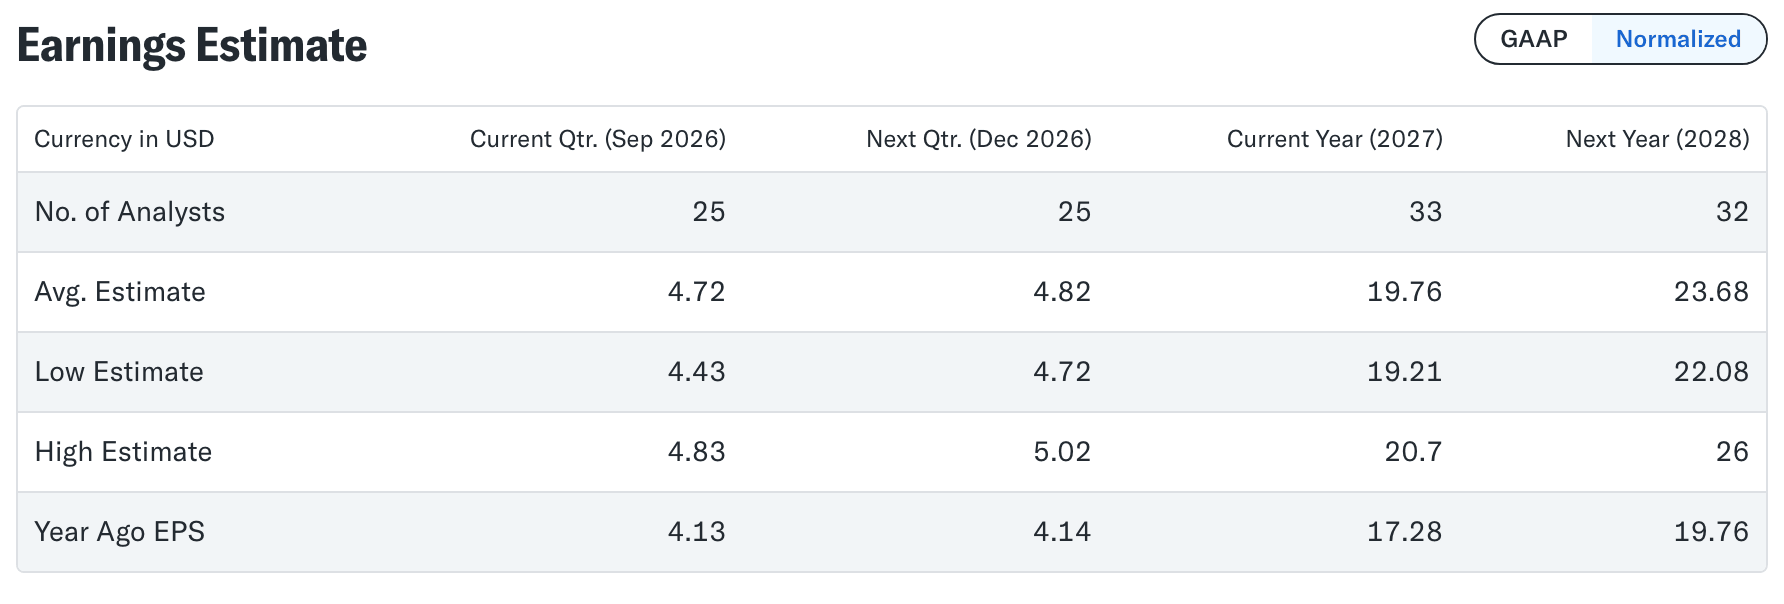
テーブルのNormalizedビューは、earningsTrendに含まれる数値と同じものを表示しています。
同じリクエストは、各期間のepsTrendとepsRevisions、および直近4四半期の報告結果とそのサプライズ率を含むearningsHistoryも返します。
数百銘柄のためにYahoo Financeをスクレイピングする
多くの本番環境のティッカーリストには古いシンボル、インデックス、海外上場銘柄が含まれているため、バッチスクリプトは問題を報告しつつ処理を続行する必要があります。次のスクリプトをbatch.pyとして保存してください。デフォルトで8スレッドを実行し、見つからなかった銘柄と失敗した銘柄を別々に収集し、小単位の通貨を変換します:
from concurrent.futures import ThreadPoolExecutor

import pandas as pd

from quote_summary import quote_summary
from yahoo_embedded import SymbolNotFound, fetch_page

# Yahoo quotes many London, Johannesburg, and Tel Aviv prices in minor units.
# Market cap stays in major units.
MINOR_UNITS = {"GBp": ("GBP", 100), "ZAc": ("ZAR", 100), "ILA": ("ILS", 100)}
PRICE_FIELDS = ("price", "week52_low", "week52_high", "target_mean")


def to_major_units(row: dict) -> dict:
    unit = MINOR_UNITS.get(row["currency"])
    if unit is None:
        return row
    currency, divisor = unit
    prices = {key: row[key] / divisor for key in PRICE_FIELDS if row[key] is not None}
    return {**row, **prices, "currency": currency}


def collect(symbols: list[str], fetch=fetch_page, workers: int = 8):
    """Quote rows for many symbols, plus the symbols that were missing or failed."""
    # " msft" and "MSFT" are the same ticker
    symbols = list(dict.fromkeys(s.strip().upper() for s in symbols))
    missing, failed = [], {}

    def one(symbol: str) -> dict | None:
        try:
            return to_major_units(quote_summary(symbol, fetch=fetch))
        except SymbolNotFound:
            missing.append(symbol)
        except Exception as error:  # keep the batch running, report at the end
            failed[symbol] = repr(error)
        return None

    with ThreadPoolExecutor(max_workers=workers) as pool:
        rows = [row for row in pool.map(one, symbols) if row]
    return pd.DataFrame(rows), missing, failed


if __name__ == "__main__":
    tickers = "AAPL MSFT SQ ^GSPC SPY BTC-USD 7203.T SAP.DE VOD.L NPN.JO".split()
    table, missing, failed = collect(tickers)
    cols = "symbol price currency market_cap delay_minutes reporting_currency".split()
    print(table[cols].to_string(index=False))
    print("missing:", missing, "| failed:", failed)
10銘柄の混在リストが2.5秒で完了しました:
 symbol     price currency   market_cap  delay_minutes reporting_currency
   AAPL   341.070      USD 4.977637e+12              0                USD
   MSFT   516.170      USD 3.832844e+12              0                USD
  ^GSPC  7743.410      USD          NaN              0                NaN
    SPY   771.350      USD          NaN              0                NaN
BTC-USD 85011.320      USD 1.707212e+12              0                NaN
 7203.T  2989.500      JPY 3.540116e+13             20                JPY
 SAP.DE   185.920      EUR 2.145897e+11             15                EUR
  VOD.L     1.258      GBP 2.907280e+10             15                EUR
 NPN.JO   709.380      ZAR 5.307029e+11             15                USD
missing: ['SQ'] | failed: {}
Block, Inc.がシンボルをXYZに変更したため、バッチはSQを見つからない銘柄として報告しました。Yahooは古いシンボルをlookupページにリダイレクトしますが、再利用されたシンボルは静かに失敗します。Metaの旧シンボルであるFBはステータス200でProShares ETFを返したため、各nameをティッカーリストと比較してください。FBの見積もりページは他のどの見積もりページとも見た目は変わりません:
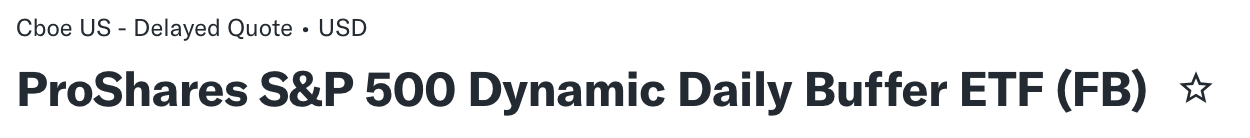
再利用されたシンボルは通常の見積もりページを返すため、名前が変更の最も明確な兆候になります。
単位、通貨、遅延を確認する
ステータスコードのチェックだけでは検出できない、さらに3つの問題があります:
- 小単位の通貨。 Yahooは、VOD.Lの価格を
GBp(ペンス)で125.8、時価総額をポンドで29.07Bと報告していました。NPN.JOの価格はZAc(セント)で70,938でした。to_major_units()は価格フィールドのみを割るため、時価総額はメジャー単位のままです。 - 報告通貨。 財務諸表の値は企業の報告通貨を使用しており、タイムシリーズのデータポイントには
currencyCodeフィールドにその通貨が含まれています。Vodafone(VOD.L)はペンス建てで取引されますがユーロで報告し、Naspers(NPN.JO)はランド建てで取引されますが米ドルで報告します。比率は2つの通貨が混ざる場合があります。TEVA.TAのフォワードPERは43.5でしたが、ニューヨーク上場であるTEVAは12.9でした。YahooはTEVA.TAのシェケル建て価格をドル建てのEPS予想で割っていました。 - 取引所の遅延。 米国上場銘柄とビットコインでは
delay_minutesは0でした。Xetra、ロンドン、ヨハネスブルグの見積もりは15分の遅延があり、東京の見積もりは20分の遅延がありました。取引所間で価格を比較する前に、すべての行でdelay_minutesとmarket_timeを保持してください。
より大規模なバッチを実行する
デフォルトの8スレッドで、collect()はレジデンシャル接続から429やリトライなしで503すべてのS&P 500シンボルを74秒で処理しました。見つからなかったのはBRK.BとBF.Bだけでした。これはWikipediaのS&P 500リストがドット表記を使う一方、YahooはBRK-BとBF-Bを使用するためです。period1を7日前に設定すると、501件すべての履歴が48秒で更新されました。中央値のページサイズはMSFTの完全な履歴の4.9MBに対して1MB未満でした。
指数バックオフにより、fetch_page()はすでにタイムアウト、429、5xxレスポンス、見積もりデータのないページに対してリトライを行っています。Pythonでのリクエストリトライのガイドではurllib3のRetryとTenacityによるバックオフを解説しています。
asyncioに移行する場合は、まずクライアントのレスポンスヘッダーサイズの制限を確認してください。MSFTサマリータブのレスポンスには約37KBのヘッダーが含まれており、8,765バイトのContent-Security-Policyと27,039バイトのLinkヘッダーが含まれていました。デフォルト設定では、aiohttp 3.14.3は、Yahooがステータス200で提供したページに対してClientResponseErrorを発生させました。そのメッセージは400, message='Got more than 8190 bytes when readingで始まっていました。
aiohttp.ClientSessionにmax_field_size=65536を渡すことでエラーが解消されました。httpxとcurl_cffiのAsyncSessionはどちらもデフォルト設定でこのページを処理できました。requests、httpx、aiohttpの比較のガイドでは、それら3つの間の他のトレードオフについて解説しています。
Web Unlocker APIを使ってサーバーから同じパーサーを実行する
Bright DataのWeb Unlocker APIはURLを受け取ってページを返します。IPローテーション、CAPTCHAの解決、自動リトライを当社サーバー側で処理するため、同じパーサーをお使いのサーバーから実行しつつ、ブロック回避の維持はこちらで行います。fetch_page_unlocker()はfetch_page()と同じsymbol、tab、params引数を取るため、quote_summary()、price_history()、statement()、estimates()はすべてfetchパラメータを通じてこれを受け取ることができます。これをunlocker.pyとして保存してください:
import os
from urllib.parse import urlencode

import requests

from yahoo_embedded import page_url

API_URL = "https://api.brightdata.com/request"


def fetch_page_unlocker(symbol: str, tab: str = "", params: dict | None = None) -> str:
    """Takes the same symbol, tab, and params as fetch_page(), via Web Unlocker API."""
    url = page_url(symbol, tab) + (f"?{urlencode(params)}" if params else "")
    response = requests.post(
        API_URL,
        headers={"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"},
        json={
            "zone": os.environ["BRIGHTDATA_UNLOCKER_ZONE"],
            "url": url,
            "format": "json",  # Yahoo's status, headers, and HTML, wrapped in JSON
            "country": "us",
        },
        timeout=120,
    )
    response.raise_for_status()
    return response.json()["body"]
これは、APIキーとWeb Unlocker APIのゾーン名を2つの環境変数から読み取ります。ゾーンとは、お使いのアカウント内で名前が付けられた製品設定のことです。キーはアカウント設定ページにあり、ゾーンを作成する手順はWeb Unlocker APIクイックスタートに記載されています。ゾーンが作成されると、その概要タブに両方の値が表示されます:
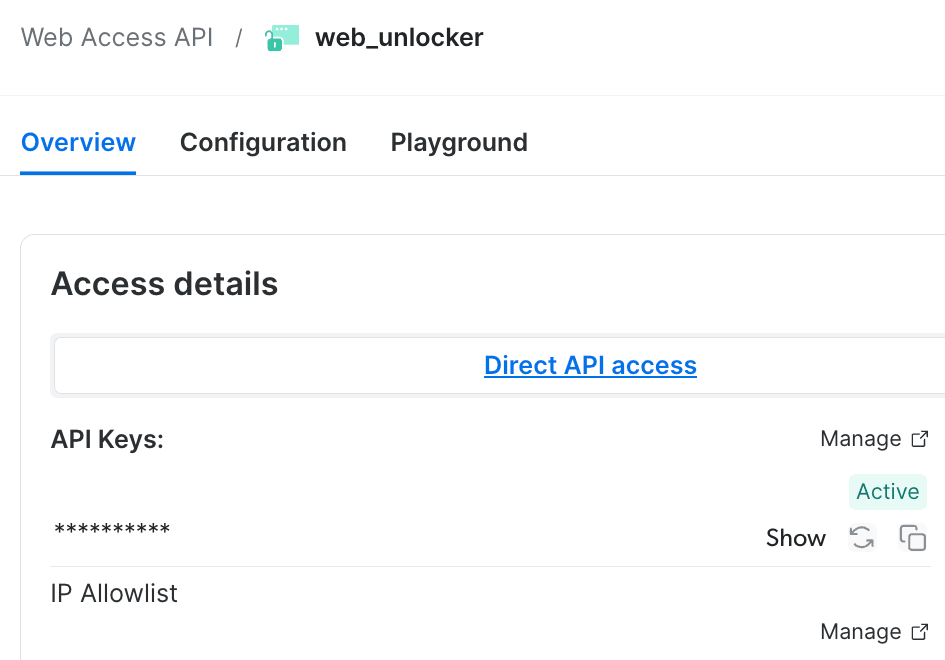
ここではweb_unlockerというゾーン名が上部にあり、API Keysの下のコピーボタンでキーをコピーできます。
次のスクリプトを実行する前に、シェルで両方を設定してください:
export BRIGHTDATA_API_KEY="your-api-key"
export BRIGHTDATA_UNLOCKER_ZONE="your-zone-name"quote_summary()、price_history()、statement()、またはestimates()をWeb Unlocker API経由にルーティングするには、fetch引数としてfetch_page_unlockerを渡してください。このスクリプトをunlocker_demo.pyとして保存します:
from price_history import price_history
from unlocker import fetch_page_unlocker

history, events = price_history("MSFT", fetch=fetch_page_unlocker)
print(
    f"{len(history):,} daily bars from {history.index[0]:%Y-%m-%d} "
    f"to {history.index[-1]:%Y-%m-%d}"
)price_history.pyと同じ履歴が出力されました:
10,213 daily bars from 1986-03-13 to 2026-09-251回のリクエストで履歴データページ全体が返され、パーサーはそれを読み取るために変更の必要はありませんでした。バッチスクリプトはcollect(tickers, fetch=fetch_page_unlocker)を通じて同じ関数を受け入れます。
次の3点に注意してください:
"format": "json"を使用してください。 すると、レスポンスには単一のJSONオブジェクト内にYahooのステータスコード、ヘッダー、完全なHTMLが含まれます。この関数はbodyフィールドからHTMLを返します。- 特殊文字をエンコードしてください。
page_url()は^GSPCのようなインデックスシンボルをすでに%5EGSPCとしてパーセントエンコードしているため、生成されるすべてのURLは有効です。 - または当社のPython SDKを使用してください。
pip install brightdata-sdkでbrightdata-sdkをインストールし、scrape_url()にresponse_format="json"を渡すことで、ページと一緒にYahooのステータスコードを取得できます。
各タブは個別のリクエストであり、成功したリクエストに対してのみ料金が発生します。
Yahoo Finance Scraper APIから構造化レコードを取得する
当社のYahoo Finance Scraper APIは、ティッカーごとに構造化されたレコードを返し、プロキシ、ブロック回避、リトライが組み込まれています。これはWeb Scraper API内の既成のスクレイパーです。1つのレコードには、スクレイパーの製品ページがフィールドごとにリストしている、サマリーフィールド、企業プロフィール、主要経営陣、年次財務、アナリスト目標株価が組み合わされています。Control Panelには、スクレイパーの同期・非同期モードと、以下のコードが呼び出すエンドポイントが表示されます:
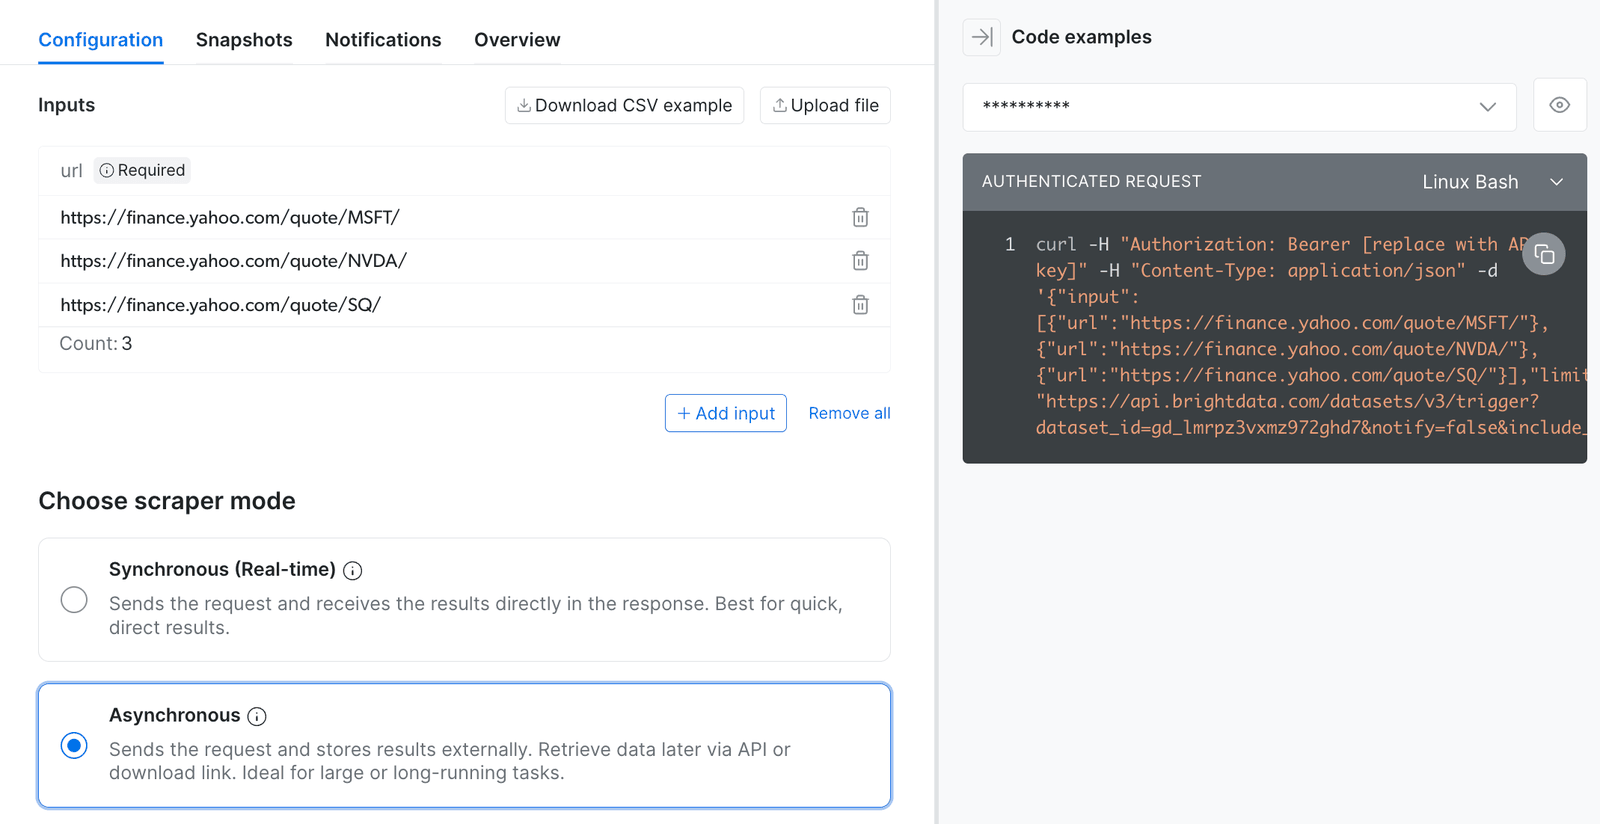
パネルのcurlの例は、scraper_api.pyと同じ見積もりURL、トリガーエンドポイント、データセットIDを使用しており、Asynchronousモードはスケジュールされたバッチジョブに最も適しています。
ジョブをトリガーしてレコードをダウンロードする
次のスクリプトをscraper_api.pyとして保存してください。URLのリストに対してジョブをトリガーし、進捗をポーリングし、レコードをダウンロードし、Yahooがもはやリストしていないシンボルを報告します:
import os
import time

import requests

API = "https://api.brightdata.com/datasets/v3"
DATASET_ID = "gd_lmrpz3vxmz972ghd7"  # Yahoo Finance business information
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"}
# The API returns only these fields, so the list keeps input, error, and error_code.
FIELDS = (
    "input|error|error_code|stock_ticker|closing_price|"
    "market_cap|pe_ratio|currency|timestamp"
)


def job_status(snapshot_id: str) -> str:
    progress = requests.get(
        f"{API}/progress/{snapshot_id}", headers=HEADERS, timeout=60
    )
    return progress.json()["status"]


def run_batch(urls: list[str], poll_seconds: int = 30) -> list[dict]:
    """Trigger one collection job, wait until it's ready, and return its records."""
    trigger = requests.post(
        f"{API}/trigger",
        params={
            "dataset_id": DATASET_ID,
            "include_errors": "true",
            "custom_output_fields": FIELDS,
        },
        headers=HEADERS,
        json={"input": [{"url": url} for url in urls]},
        timeout=60,
    )
    trigger.raise_for_status()
    snapshot_id = trigger.json()["snapshot_id"]

    while job_status(snapshot_id) != "ready":
        time.sleep(poll_seconds)

    records = requests.get(
        f"{API}/snapshot/{snapshot_id}",
        params={"format": "json"},
        headers=HEADERS,
        timeout=300,
    )
    records.raise_for_status()
    return records.json()


def collect_records(urls: list[str]) -> tuple[list[dict], dict[str, str]]:
    """Run one job and split its records into results and per-URL errors."""
    records = run_batch(list(dict.fromkeys(urls)))  # drop duplicate URLs
    done = [record for record in records if not record.get("error")]
    errors = {
        record["input"]["url"]: f'{record.get("error_code")}: {record["error"]}'
        for record in records
        if record.get("error")
    }
    return done, errors


if __name__ == "__main__":
    urls = [f"https://finance.yahoo.com/quote/{s}/" for s in ("MSFT", "NVDA", "SQ")]
    records, errors = collect_records(urls)
    for record in records:
        print(record)
    print("errors:", errors)
2件のレコードと、SQに対するエラーを出力しました:
{'input': {'url': 'https://finance.yahoo.com/quote/MSFT/'}, 'stock_ticker': 'MSFT', 'closing_price': 516.17, 'market_cap': 3832843862016, 'pe_ratio': 28.739979, 'currency': 'USD', 'timestamp': '2026-09-27T16:15:44.789Z'}
{'input': {'url': 'https://finance.yahoo.com/quote/NVDA/'}, 'stock_ticker': 'NVDA', 'closing_price': 225.07, 'market_cap': 5434765213696, 'pe_ratio': 28.489874, 'currency': 'USD', 'timestamp': '2026-09-27T16:16:02.513Z'}
errors: {'https://finance.yahoo.com/quote/SQ/': 'dead_page: Target quote not found on lookup page'}YahooはSQをlookupページにリダイレクトするため、スクレイパーはそれをdead_pageとしてフラグ付けし、fetch_page()も同じケースでSymbolNotFoundを発生させます。
スケジュールされたパイプラインを設定する
Scraper APIをバッチジョブとして実行してください。各トリガー呼び出しで多数のティッカーを送信し、進捗エンドポイントをポーリングするか、Webhookを待ちます。
同期の/scrapeエンドポイントは、レコードをそのレスポンス内に直接返します。より長いジョブでは、同期APIリファレンスが説明しているように、代わりにポーリングするためのsnapshot_idを返します。
トリガー呼び出しには、スケジュールされたパイプラインにとって重要ないくつかの設定があります。非同期APIリファレンスにそれらが記載されており、Control PanelでもScraper settingsの下に同じオプションが用意されています:
- エラーレポート。
include_errors=trueは、Yahooがもはやリストしていないシンボルなど、結果のない入力にerrorとerror_codeを追加します。collect_records()はそれらの入力をURL別に報告します。 - 出力フィールド。
custom_output_fieldsは、|で区切ってリストしたフィールドのみを保持するため、エラーレポートを維持するためにinput、error、error_codeを追加してください。 - レコード数の制限。
limit_per_inputは入力あたりのレコード数を制限し、limit_multiple_resultsはジョブあたりのレコード数を制限します。両方の制限はDiscover by keyword検索のコストを管理します。 - 配信とWebhook。
endpointはレコードをお使いのWebhook URLに配信します。notify=trueはジョブ完了時に通知を送信するため、スケジューラーが/progressをポーリングする必要がなくなります。Webhookペイロードを非圧縮で受け取るにはuncompressed_webhook=trueを渡してください。パネルのDelivery settingsは、データ配信ドキュメントが説明しているように、結果をAmazon S3、Google Cloud Storage、またはSnowflakeに書き込むこともできます。 - スケジュール。 Control Panelは、日次のティッカー更新のように、同じ収集を定期的なスケジュールで実行できます。
より長いティッカーリストでは、スクレイパーはMMC、BK、FIもdead_pageとしてフラグ付けしました。それらの企業はシンボルをMRSH、BNY、FISVに変更していました。正常に配信されたレコードに対してのみ料金が発生します。
キーワードで検索するか、CLIから実行する
Discover by keywordモードは、取引所や資産タイプを横断してキーワードに一致する銘柄を検出します。WIXというクエリはWix.com、Wickes Group(WIX.L)、WIXのオプション契約を見つけ、MSFTというクエリはMicrosoftのトロント上場銘柄や単一銘柄ETFも見つけました。欲しい銘柄だけを保持するためにentity_typeとstock_tickerでフィルタリングしてください。
Yahoo Finance Scraper APIは、Bright Data CLI内でbrightdata pipelines yahoo_finance_business <url>としてターミナルからも実行できます。web_data_yahoo_finance_businessツールを通じて、AIエージェントは指定した見積もりURLのレコードを取得できます。このツールは、financeツールグループを有効にした後、当社のYahoo Finance MCPサーバー上で動作します。
パイプラインに適した方法を選ぶ
まずは無料で見積もりページを読み取るところから始め、スケジュールされたサーバージョブにはWeb Unlocker APIを追加してください。構造化されたレコードが必要な場合は、Scraper APIまたはYahoo Financeデータセットを使用してください:
| 選択肢 | 最適な用途 | 自分で管理する部分 | 料金 |
|---|---|---|---|
| yfinance | READMEに記載の通り、個人的な調査用途 | ライブラリの更新、ブロックされたIP | 無料 |
| curl_cffiを使った見積もりページ | 自宅やGitHub Actionsランナーから1日数百銘柄 | パーサー、リトライ、ブロックされたIP | 無料 |
| Web Unlocker APIを使った見積もりページ | 任意のタブを読み取るスケジュールされたサーバージョブ | パーサー | 成功したリクエストごと |
| Browser APIを使ったPlaywright | トグル選択後に表示される四半期財務諸表などのデータ | ブラウザスクリプト、パーサー | トラフィックのGBごと |
| Yahoo Finance Scraper API | スケジュールに沿って配信されるパース済みレコード | 出力フィールドのリスト | 配信されたレコードごと |
| Yahoo Financeデータセット | 企業、ファンド、インデックスの既成ファイル | 配信設定 | レコードごと |
月間予算を見積もるには、更新ごと、ティッカーごと、タブごとに1回のWeb Unlocker APIリクエストとしてカウントしてください。Yahoo Finance Scraper APIは、更新ごと、ティッカーごとに1レコードが必要です。いずれかの量を、Web Unlocker API料金ページまたはWeb Scraper API料金ページの現在の価格に掛け合わせてください。
四半期財務諸表については、当社のBrowser API内でPlaywrightまたはPuppeteerのスクリプトが財務諸表タブのQuarterlyトグルを選択できます。クラウド上でChromiumを実行し、CAPTCHAの解決とJavaScriptレンダリングが組み込まれています。Pythonで動的なウェブサイトをスクレイピングするガイドでは、そのワークフローをステップごとに解説しています。
当社のYahoo Financeデータセットは、Scraper APIと同種のレコードを既成のJSON、NDJSON、CSV、Parquetファイルにパッケージ化しています。株式、投資信託、インデックス、ETF、通貨、マネーマーケットファンドを含んでいるため、欲しい資産クラスを保持するためにentity_typeでフィルタリングしてください。
必要なデータポイントのみを含むサブセットを購入し、日次、週次、月次、またはカスタムスケジュールで更新を受け取ることができます。各配信には新規または更新されたレコードのみを含めることができ、Amazon S3、Google Cloud、Azure、Snowflake、SFTPに直接送信できます。データセットページには現在のレコード数と料金が表示されており、購入前にJSONまたはCSV形式のサンプルファイルをダウンロードできます。
他の市場データソースについては、金融データのスクレイピングとGoogle Financeのスクレイピングに関するガイドをご覧ください。当社の他のスクレイパーとデータセットは、さらに多くの株式データや他のYahoo関連の結果を提供します:
- Stock Market Scraperは、Yahoo Finance、Google Finance、TradingViewなどのサイトから株式データを収集します。
- Google Finance ScraperとTradingView Scraperは、その2つのサイトから株価と市場トレンドを収集します。
- Nasdaq Scraperは、始値、終値、出来高などのNasdaqデータを収集します。
- Stocktwits Scraperは、Stocktwitsの投稿、センチメント、トレンド銘柄を収集します。
- Financial Data Scraper APIは、会社名、株式ティッカー、取引所、終値などのフィールドを返します。
- Stock Market Dataset、Stock Prices Dataset、Financial Datasetは、企業プロフィール、株式ティッカー、価格を既成ファイルとして提供します。
- Google Finance Datasets、Historical Financial Data、Financial News Datasetは、Google Financeデータ、過去の財務データ、金融ニュースを既成ファイルとして提供します。
- Yahoo News APIとYahoo Search APIは、Yahoo NewsとYahoo検索の結果を返します。
まとめ
Yahoo Financeの見積もりページには、独自のAPIレスポンスがJSONとして含まれているため、タブごとに1回のリクエストでブラウザ、cookie、crumbなしでデータを取得できます。Yahooの最初のリクエストでの429はクライアントのTLSハンドシェイクとUser-Agentに依存していたため、遅延を追加する前にまずクライアントを修正してください。埋め込まれたレスポンスをパースし、すべてのページを検証し、各名前をティッカーリストと比較し、パーサー内で小単位の通貨を変換してください。
スケジュールされたサーバージョブには、同じパーサーをWeb Unlocker API経由でルーティングするか、Yahoo Finance Scraper APIに構造化されたレコードを返させてください。当社の月間無料クレジットは両方に適用されるため、お手持ちのティッカーリストでどちらも試すことができます。
よくある質問
公式のYahoo Finance APIはありますか?
いいえ。Yahooは述べています、データプロバイダーがAPI形式での再配布を「現時点では許可していない」ため、見積もりデータへのAPIアクセスを無効化したと。yfinanceが使用する内部APIホストは非公開であり、robots.txtでも禁止されています。Yahooの見積もりページには同じデータがJSONとして埋め込まれています。
yfinanceは今でも使用できますか?
はい、自宅と3つのGitHub Actionsランナーから、yfinanceは1.5秒未満でMSFTの完全な日次履歴を取得しました。curl_cffiのChrome TLSハンドシェイクを使用しています。そのREADMEはYahoo APIを「個人利用のみを意図したもの」と呼んでいます。一部のクラウドホストから401エラーや取得失敗が報告されているため、自身のサーバーからテストしてください。
Yahoo Financeはウェブスクレイピングをブロックしますか?
一部のクライアントについては、はい。Yahooは最初のリクエストでPythonのデフォルトのrequestsクライアントをブロックしました。ChromeのTLSハンドシェイクを使用すると、curl_cffiはレジデンシャル接続や3つのGitHub Actionsランナーでも429を受けませんでした。スケジュールされたジョブには、Bright DataのWeb Unlocker APIがIPローテーションと自動リトライを伴って同じページを取得します。
Yahoo Financeからデータをダウンロードできますか?
はい、ただしYahooのヘルプページでは、CSVダウンロードは有料のYahoo Finance加入者に限定されています。コードでは、履歴データタブへの1回のリクエストで1986年以降のすべてのMSFT日次バーが返されました。大量のファイルには、Bright DataのYahoo Financeデータセットが、選択したスケジュールで企業、ファンド、インデックスのレコードを配信します。
Yahoo Finance APIは無料ですか?
公式には無料ではありません。Yahooの内部エンドポイントの呼び出し自体に料金はかかりませんが、非公開でありクローラーに対しては禁止されています。Yahooのヘルプページでは、CSVダウンロードは有料加入者に限定されています。Bright DataのYahoo Finance Scraper APIは構造化されたレコードを返し、新規アカウントにはそれをテストするための月間無料クレジットが付与されます。