本ガイドでは、2026年にAIエージェント向けウェブアクセスツールのベスト10を紹介します。まず最初はBright Dataと、そのAIエージェント向けウェブアクセスプラットフォームです。これは、ライブデータで3つの機能すべてをカバーする唯一のプラットフォームです。Google、Bing、Yandexをリアルタイムで検索し、任意のページをクリーンなMarkdownまたは構造化JSONとして返します。また、複数ステップのタスク用にクラウドブラウザも実行します。1つのアカウントと毎月5,000件の無料クレジットで、そのすべてをカバーします。
AIエージェントにとってのウェブアクセスとは、3つの異なる機能を意味します。エージェントはライブのウェブを検索し、モデルが利用できる形式でページを読み取る必要があります。また、サイトがクリック操作を必要とする場合は、実際のブラウザを操作する必要もあります。多くの比較記事はこれら機能のうち1つだけをランク付けしています。本記事では3つすべてでツールをランク付けします。また、結果がライブエンジン、プライベートインデックス、キャッシュのいずれから得られたかも記載します。各Bright Dataの手順は実際の出力とともに示します。
クイック回答:各エージェント機能に最適なウェブアクセスツール
- AIエージェントにライブのウェブへの信頼できるアクセスを提供する最良のプラットフォーム: Bright Data。SERP API、Web Unlocker、1,200以上のスクレイパー、Browser APIを1つの鍵の背後に統合しています。エージェントはMCPサーバーまたはCLI経由で接続します。
- クリーンなMarkdownと構造化データをAIワークフローに返す最良の選択: Bright DataはMarkdownに加え、すぐに使えるJSONスクレイパーを提供します。Firecrawlは、任意のページからスキーマベースの抽出を行う際の選択肢です。
- JavaScript中心のウェブサイトを閲覧し、複数ステップのタスクを完了する最良のインフラ: Bright DataのBrowser APIで、ブロック解除機能が組み込まれています。BrowserbaseとBrowser Useは、ブラウザ中心の強力な代替手段です。
- 引用と最新情報を伴うLLMグラウンディングに最良の検索API: Bright Dataはライブ Google結果を提供します。Exa、Parallel、Braveは自社のインデックスから結果を提供します。
要約:AIエージェント向け最良のウェブアクセスツール一覧
ランク付けされたショートリストと、各機能のカバー範囲、無料枠、開始価格をまとめました。
| ツール | 最適な用途 | ライブ検索 | Markdownと構造化データ | クラウドブラウザ | 無料枠 | 開始価格 |
|---|---|---|---|---|---|---|
| Bright Data | AIエージェント向け総合ウェブアクセスプラットフォーム | ライブGoogle、Bing、Yandex | Markdown + 1,200以上のJSONスクレイパー | 対応、Browser API | 5,000クレジット/月 | 1,000リクエストあたり$1から;ブラウザは$5/GBから |
| Firecrawl | スキーマベースの抽出に | 独自インデックス + ライブ | Markdown + JSONスキーマ | 一部対応(Interact) | 1,000クレジット/月 | 月額$16から(年払い) |
| TinyFish | 無料検索&取得枠に | 対応(TinySearch) | MarkdownまたはJSON | 対応、エージェント実行も可 | 無料検索&取得、レート制限あり | ブラウザ:$0.002/分 |
| Browserbase | ヘッドレスブラウザ群に | 再販(Parallel、Exa) | MarkdownまたはJSONスキーマ | 対応 | ブラウザ1時間 + 検索/取得1,000回 | 月額$20から |
| Tavily | チャンク化されたRAG検索結果に | 対応 | Markdownまたはテキスト | 非対応 | 1,000クレジット/月 | 月額$30から |
| Exa | セマンティック検索に | 独自インデックス | ページ内容 + LLM要約 | 非対応 | $10クレジット/月 | 検索1,000件あたり$4から |
| Parallel | 圧縮抜粋に | 独自インデックス | 全文ページまたは抜粋 | 非対応 | 月5,000リクエストまで | 検索1,000件あたり$1〜$5 |
| Apify | すぐ使えるアクターのマーケットプレイス | RAG Web Browserアクター経由 | Markdown + アクターデータセット | 一部対応(アクターがブラウザを実行) | $5クレジット/月 | 1,000ページあたり$1.33から |
| Browser Use | オープンソースのブラウザエージェント | 非対応 | エージェント出力経由 | 対応、ステルスChromium | $1の一回限りクレジット | $0.02/時間 + $5/GBプロキシ |
| Brave Search API | 独立した検索インデックス | 独自インデックス | 非対応 | 非対応 | $5クレジット/月 | 1,000リクエストあたり$5 |
AIエージェント向けウェブアクセスツールとは?
ウェブアクセスツールは、AIエージェントが作業中に公開ウェブへ到達する手段を提供します。検索、ページ取得、フィールド抽出、ブラウザ操作のためのツールを公開します。エージェントはAPI、MCPサーバー、CLI、またはSDKを通じてこれらのツールを呼び出します。ツールは、ブロック、CAPTCHA、JavaScriptのレンダリング、HTMLをモデルが読める文章への変換など、モデル自身にはできないことを処理します。
データがどこから来るかは、形式と同じくらい重要です。ライブ検索エンジンは、今まさに人がGoogleやBingで見ている結果を返します。プライベートインデックスは、ベンダーが以前にクロールしたページを、自社モデルでランク付けして返します。キャッシュは、数時間から数日前の保存済みページを返します。価格、ニュース、リリースノートについては、エージェントはライブデータ、または明示的にそれを要求する手段を必要とします。
各機能に適したウェブアクセスツールは?
エージェントが行う機能を、それをカバーするツールにマッピングしましょう。ほとんどのエージェントは複数の機能を担うため、3つすべてにおけるカバー範囲が重要になります。
| エージェントの機能 | エージェントに必要なもの | 最良の選択 | 代替手段 |
|---|---|---|---|
| ライブウェブ検索とLLMグラウンディング | ニュースやローカル結果を含む、引用可能なURL付きの最新結果 | Bright Data SERP API | Tavily、Exa、Parallel、Brave |
| クリーンなMarkdownと構造化データ | 定型文を除いたページテキスト、または型付きJSONフィールド | Bright Data Web UnlockerとWeb Scraper API | Firecrawl、TinyFish、Apify |
| JavaScript中心のサイトと複数ステップのタスク | クリック、入力、スクロール、ログインが可能な実際のブラウザ | Bright Data Browser API | Browserbase、Browser Use、TinyFish |
| サイト全体のクロール | ドメイン内の全ページをLLM対応形式で | Bright Data Crawl API | Firecrawl、Apify |
これらのツールのランク付け方法
ここに掲載されたすべてのツールは、AIエージェント向けに構築されたAPIを提供し、3つの機能のうち少なくとも1つをカバーしています。ベンダーの事実情報は、2026年10月時点の各ベンダー自身の価格ページとドキュメントから得たものです。ツールは7つの要素で評価されています。
- 機能カバー範囲:検索、Markdownと構造化データ、クラウドブラウザ。
- 鮮度:ライブエンジンの結果とライブページの読み取り、またはインデックスやキャッシュ。
- ブロック解除:ボットチェック、CAPTCHA、地域制限ページの処理。
- 出力:クリーンなMarkdown、スキーマ付きJSON、トークン効率の良い結果。
- エージェントインターフェース:ホスト型MCPサーバー、SDK、CLI。
- 無料枠:月次割当は一回限りのクレジットより高く評価されます。
- 信頼性:セキュリティ認証と公開されたコンプライアンス。
2026年、AIエージェント向けウェブアクセスツールのベスト10
1. Bright Data
Bright Dataは、1つのプラットフォームからAIエージェントに3種類すべてのウェブアクセスを提供します。SERP APIは、国別のニュース、ショッピング、ローカル結果を含む、ライブのGoogle、Bing、Yandexの結果を返します。Web Unlockerは、任意の公開ページをクリーンなMarkdownまたはHTMLとして返し、CAPTCHA、ボットチェック、再試行を処理します。Web Scraper APIは、AmazonやBest Buyなどのサイト向けに型付きJSONを返す1,200以上のすぐ使えるスクレイパーを追加します。Browser APIは、Playwright、Puppeteer、SeleniumがCDP経由で操作するクラウドブラウザを実行し、ブロック解除機能も組み込まれています。エージェントは、ホスト型のBright Data MCPサーバー、CLI、PythonおよびNode.js SDKを通じて、そのすべてにアクセスできます。Scrape.doの2026年ベンチマークでは、16のスクレイピングAPIの中で最高の平均成功率98.87%を記録しました。
主な詳細:
- 最適な用途:1つのプロバイダーからライブ検索、ページ読み取り、構造化データ、ブラウザを必要とするエージェント。
- 製品:SERP API、Web Unlocker、Web Scraper API、Crawl API、Browser API。
- エージェントインターフェース:OAuth対応ホスト型MCPサーバー、Bright Data CLI、PythonおよびNode.js SDK。
- 鮮度:すべての検索とページ読み取りは、情報源に対してライブで実行されます。
- 無料枠:月5,000クレジット、クレジットカード不要、検索・ページ読み取り・スクレイパー・Browser API間で共有。
- 価格:検索とページ読み取りは1,000リクエストあたり$1から;Browser APIは$5/GBから。
- コンプライアンス:SOC 2およびSOC 3レポート、ISO 27701、GDPR、Trust Centerに記載。
メリット:
- 検索、Markdown、構造化JSON、クロール、ブラウザを1つの鍵でカバー。
- プライベートインデックスではなく、ライブGoogle結果。
- 4億以上のIPのネットワーク上で、すべての製品にブロック解除機能を組み込み。
- MCP、CLI、SDKにより、同一アカウントがチャットアプリとコーディングエージェント双方に対応。
デメリット:
- 製品数が多いため、初日の選択肢が多くなる。
- ライブGoogle検索はインデックス検索より数秒遅い。
⭐ レビュースコア: G2 4.7/5(349件のレビュー)
2. Firecrawl
Firecrawlは、検索、スクレイピング、クロール、ブラウザ操作のためのウェブデータAPIです。クリーンなMarkdownを返し、JSONモードでは定義したスキーマに一致するフィールドを抽出します。検索は、自社のAlexandriaインデックスまたはライブ取得を利用します。Interactセッションでは、ページ上でのクリック、スクロール、入力が追加できます。Firecrawlのドキュメントでは、デフォルトのmaxAgeを2日に設定しています。新鮮なコピーをリクエストしない限り、ページ読み取りはキャッシュされたコピーを返す場合があります。
主な詳細:
- 最適な用途:任意のページからのスキーマベースJSON抽出。
- エージェントインターフェース:ホスト型MCPサーバー、PythonおよびNode SDK、CLI。
- 無料枠:月1,000クレジット、クレジットカード不要。
- 価格:Hobbyプラン月額$19、または年払いで月額$16、5,000クレジット付き。
- コンプライアンス:SOC 2 Type II。
メリット:
- 強力なスキーマベースJSON抽出。
- 検索、スクレイプ、クロール、ページ操作をカバー。
- 大規模なオープンソースコミュニティ。
デメリット:
- デフォルトでキャッシュされたページ読み取り。
- ブラウザセッションはスクレイピングに加えて1分あたり2クレジットかかる。
⭐ レビュースコア: G2 4.6/5(94件のレビュー)
3. TinyFish
TinyFishは、自らをAIエージェント向けのウェブスタックと称しています。TinySearchとTinyFetchは無料でレート制限があり、1時間あたり500検索、1日あたり1,000件のURL取得が上限です。TinyFetchはJavaScriptをレンダリングし、Markdown、HTML、またはJSONを返します。TinyBrowserは、CDPとPlaywrightを通じて制御するクラウドブラウザセッションを実行し、TinyAgentは複数ステップの自動化を実行します。そのドキュメントでは、ttlをゼロに設定しない限り、Fetchはキャッシュされたエントリを提供する場合があるとしています。
主な詳細:
- 最適な用途:同一アカウントで無料の検索・取得とブラウザを使いたいチーム。
- エージェントインターフェース:ホスト型MCPサーバー、PythonおよびNode SDK、CLI。
- 無料枠:検索・取得は$0、レート制限あり、カード不要。
- 価格:ブラウザは1分あたり$0.002、エージェント実行は1ステップあたり$0.016。
- コンプライアンス:Enterpriseプランで ISO 27001。
メリット:
- 公開された上限付きの無料検索・取得。
- 1つのプラットフォームでブラウザセッションとエージェント。
デメリット:
- Fetchはデフォルトでキャッシュされたページを返す場合がある。
- エージェント実行はステップごとの課金のため、長いタスクでは積み重なる。
⭐ レビュースコア: G2 4.3/5(103件のレビュー)
4. Browserbase
Browserbaseは、AIエージェント向けにクラウド上でヘッドレスブラウザを実行します。Playwright、Puppeteer、Selenium、そして独自のオープンソースStagehandフレームワークに対応しています。有料プランには、CAPTCHAの解決とレジデンシャルプロキシが追加されます。Browserbase Fetchは、Markdown、HTML、または定義したスキーマに一致するJSONとしてページを返します。価格ページによると、そのSearch APIはParallelとExa上で動作しています。
主な詳細:
- 最適な用途:自社でブラウザ自動化を大規模に運用するチーム。
- エージェントインターフェース:ホスト型MCPサーバー、NodeおよびPython SDK、Browse CLI。
- 無料枠:ブラウザ1時間、検索呼び出し1,000回、取得呼び出し1,000回。
- 価格:Developerプラン月額$20で100ブラウザ時間、その後は1時間あたり$0.12;プロキシは$12/GB。
- コンプライアンス:SOC 2。
メリット:
- Stagehandを備えた成熟したブラウザプラットフォーム。
- JSONスキーマ出力に対応したFetch。
デメリット:
- 検索は他のプロバイダーからの再販。
- プロキシトラフィックは別途課金。
⭐ レビュースコア: G2 4.3/5(56件のレビュー)
5. Tavily
Tavilyは、現在Nebiusの一部となっている、AIエージェント向けに構築された検索・抽出APIです。モデルが使える、ランク付けされチャンク化された結果を返し、オプションでページ内容も提供します。Extractは、MarkdownまたはプレーンテキストぉpP返します。Crawl、Map、Researchエンドポイントがそれを補完します。ブラウザ製品はありません。
主な詳細:
- 最適な用途:チャンク化された検索結果を求めるRAGパイプライン。
- エージェントインターフェース:ホスト型MCPサーバー、PythonおよびJavaScript SDK、CLI。
- 無料枠:月1,000クレジット、クレジットカード不要。
- 価格:Projectプラン月額$30で4,000クレジット、または1クレジットあたり$0.008。
- 注:基本検索は1クレジット;5件のURL抽出で1クレジット。
メリット:
- 結果はモデル向けにチャンク化されて届く。
- シンプルなクレジットモデル。
デメリット:
- スキーマによる構造化JSON抽出がない。
- クラウドブラウザがない。
⭐ レビュースコア: G2 4.5/5(3件のレビュー)
6. Exa
Exaは、意味ベースのクエリ向けにニューラル検索を備えた独自のウェブインデックスを運用しています。そのContents APIは、モデル向けに全文ページテキストを返し、要約はフィールドをJSONスキーマに抽出できます。Exaは自社のインデックスを世界最大の独立系インデックスと称しています。そのドキュメントでは、新鮮なコンテンツをリクエストしない限り、Contentsは利用可能な場合キャッシュされたコピーを使用するとしています。
主な詳細:
- 最適な用途:セマンティック検索および「類似検索」。
- エージェントインターフェース:ホスト型MCPサーバー、PythonおよびJavaScript SDK。
- 無料枠:月$10のクレジットに加え、登録時$10ボーナス。
- 価格:検索は1,000リクエストあたり$4から;コンテンツは1,000ページあたり$1。
- コンプライアンス:SOC 2 Type II、GDPR、BAA付きHIPAA。
メリット:
- 強力なセマンティック検索。
- 毎月更新される無料クレジット。
デメリット:
- 結果はライブエンジンではなく自社インデックスから。
- クラウドブラウザがない。
⭐ レビュースコア: G2 4.4/5(23件のレビュー)
7. Parallel
Parallelは、自社のウェブインデックス上に検索・調査APIを構築しています。Searchは、圧縮された抜粋付きのランク付けされたURLを返し、Extractは全文ページまたは抜粋を返します。そのTask APIは深い調査を実行し、構造化されたエンリッチメントを返します。詳しい比較はBright Data対Parallelの比較記事をご覧ください。
主な詳細:
- 最適な用途:グラウンディング向けのトークン密度の高い抜粋。
- エージェントインターフェース:ホスト型MCPサーバー、PythonおよびTypeScript SDK、CLI。
- 無料枠:月5,000リクエストまで。
- 価格:検索は10件あたり$0.001〜$0.005;抽出はリクエストあたり$0.001。
- コンプライアンス:SOC 2 Type 2。
メリット:
- コンパクトな抜粋によりコンテキストを小さく保つ。
- 同一アカウントで深い調査API。
デメリット:
- 結果は自社インデックスから。
- クラウドブラウザがなく、G2の掲載もまだない。
8. Apify
Apifyは、Actorsと呼ばれる、すぐに実行できるスクレイパーのマーケットプレイスです。そのRAG Web BrowserアクターはGoogleを検索し、フルブラウザで上位ページをスクレイピングし、クリーンなMarkdownを返します。他の何千ものアクターが特定サイト向けの構造化データセットを返します。ホスト型MCPサーバーにより、エージェントはアクターを見つけて実行できます。
主な詳細:
- 最適な用途:各サイト向けにすぐ使えるアクターを求めるチーム。
- エージェントインターフェース:ホスト型MCPサーバー、JavaScriptおよびPythonクライアント、CLI。
- 無料枠:月$5のプラットフォームクレジット、クレジットカード不要。
- 価格:RAG Web Browserは1,000取得ページあたり$1.33から;Starterプランは月額$19。
- コンプライアンス:SOC 2、GDPR、CCPA。
メリット:
- サイト特化型アクターの巨大なライブラリ。
- 690件のレビューにわたる強力なG2評価。
デメリット:
- コミュニティ製アクターの品質にばらつきがある。
- 自作エージェントコード向けの生のCDPブラウザ製品がない。
⭐ レビュースコア: G2 4.7/5(690件のレビュー)
9. Browser Use
Browser Useは、ブラウザエージェント向けのオープンソースライブラリとして始まり、現在はクラウドを運用しています。Browser Use Cloudは、PlaywrightやPuppeteer、またはbrowser-useライブラリでCDP経由で操作するステルスChromiumをホストします。Browser Use Agentsは、平易な言語でタスクを受け取り、ブラウザ内で完了させます。検索APIはありません。
主な詳細:
- 最適な用途:すでにbrowser-useライブラリ上で構築しているチーム。
- エージェントインターフェース:ホスト型MCPサーバー、PythonおよびTypeScript SDK、CLI。
- 無料枠:対象登録者向けに一回限り$1のクレジット。
- 価格:クラウドブラウザは1時間あたり$0.02、レジデンシャルプロキシは$5/GB追加。
- コンプライアンス:SOC 2 Type IIおよびHIPAA。
メリット:
- 人気のオープンソースブラウザエージェント。
- 低廉な時間単価のブラウザ価格。
デメリット:
- 検索またはページ読み取りAPIがない。
- 無料クレジットは一回限り。
⭐ レビュースコア: G2 4.3/5(89件のレビュー)
10. Brave Search API
Brave Search APIは、Brave独自の独立したインデックスからすべてのクエリに応答します。そのLLM Contextエンドポイントは、モデルが必要とする内容のみを返し、Answersはグラウンディングされた応答を返します。任意のURLを取得したりブラウザを実行したりはしません。Braveの利用規約は、結果の保存とAIモデル訓練への使用を制限しています。
主な詳細:
- 最適な用途:グラウンディング向けの独立した検索インデックス。
- 無料枠:月$5の無料クレジット、前払い。
- 価格:検索およびLLM Contextは1,000リクエストあたり$5。
- コンプライアンス:SOC 2 Type II。
メリット:
- 再販業者ではなく独立したインデックス。
- シンプルなリクエストあたりの価格設定。
デメリット:
- 検索のみ。
- 利用規約で結果の保存が制限されている。
AIエージェントに引用付きのライブウェブ検索を与える方法
グラウンディングには、最新の結果とモデルが引用できるURLが必要です。SERP APIは、ランク付けされたタイトル、リンク、スニペットを含む、ライブの検索結果ページを返します。応答には、GoogleがPeople Also AskやAI Overviewブロックを表示する際には、それらも含まれます。Bright Data CLIはそれを1つのコマンドにまとめているため、コーディングエージェントはシェルから検索できます。
  npm install -g @brightdata/cli
bdata login
bdata search "model context protocol specification latest version" --json
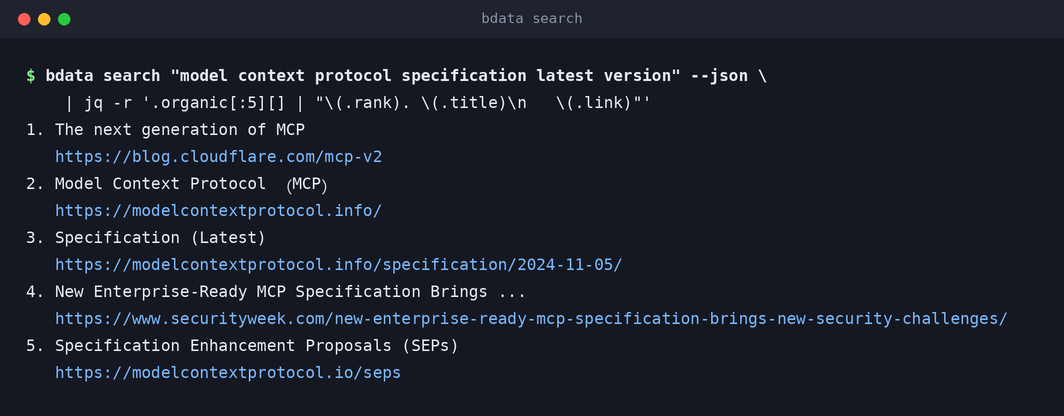
エージェントはランク付けされたURLを読み取り、回答内でそれらを引用します。最新のニュース向けには--type newsを、ローカル結果向けには--countryを追加してください。グラウンディングのコストをさらに詳しく知りたい方は、Bright Data MCPによる軽量SERPグラウンディングをお読みください。
クリーンなMarkdownと構造化データをAIワークフローに返す方法
エージェントには2種類の形式が必要です。Markdownはページ全体の読み取りと推論に適しています。構造化JSONはパイプライン、比較、データベースに投入するあらゆる用途に適しています。それぞれのトークンコストは大きく異なり、あるBest Buyの商品ページがそれを示しています。
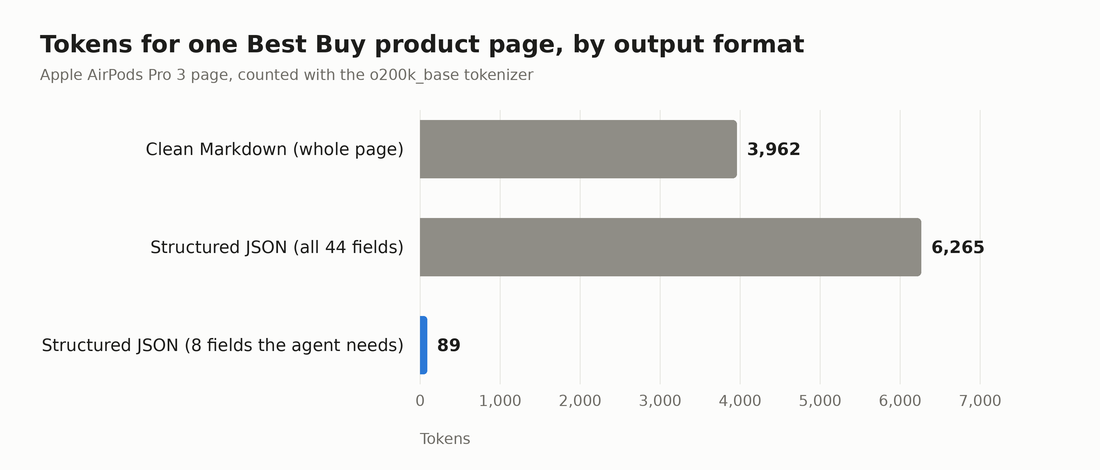
ページ全体をクリーンなMarkdownにすると3,962トークンかかります。44フィールドすべてを含む完全な構造化レコードでは6,265トークンかかります。エージェントが価格チェックに必要な8フィールドだけに絞ると、レコードは89トークンまで減少します。エージェントが読み取る必要がある場合はMarkdownを、比較や保存が必要な場合はJSONフィールドを使用してください。Bright Dataは同一アカウントから両方を返します。
  # any page as clean Markdown (Web Unlocker)
bdata scrape "https://www.amazon.com/dp/B0DM63WNWL" -o page.md

# the same kind of page as typed JSON (Web Scraper API)
bdata pipelines search amazon product
bdata pipelines run gd_l7q7dkf244hwjntr0 collect_by_url "https://www.amazon.com/dp/B0DM63WNWL" --pretty
MCPサーバー経由では、同じ機能がページ向けのscrape_as_markdownと、構造化レコード向けのsearch_scrapersおよびrun_scraperになります。サイト全体の場合は、Crawl APIがすべてのページをMarkdown、テキスト、HTML、またはJSONとして返します。
AIエージェントにJavaScript中心のウェブサイトを閲覧させ、複数ステップのタスクを完了させる方法
一部のタスクには実際のブラウザが必要です。検索ボックス、フィルター、ログイン、無限スクロールは、何かがクリックして入力した場合にのみ機能します。Browser APIは、フィンガープリント、CAPTCHAの解決、レジデンシャルIPをあなたの代わりに処理しながら、クラウド上でこれらのブラウザを実行します。CLIはそれを短いコマンドとして公開します。snapshotは、参照番号付きでページの要素を一覧表示し、エージェントはその参照に対して操作を行います。
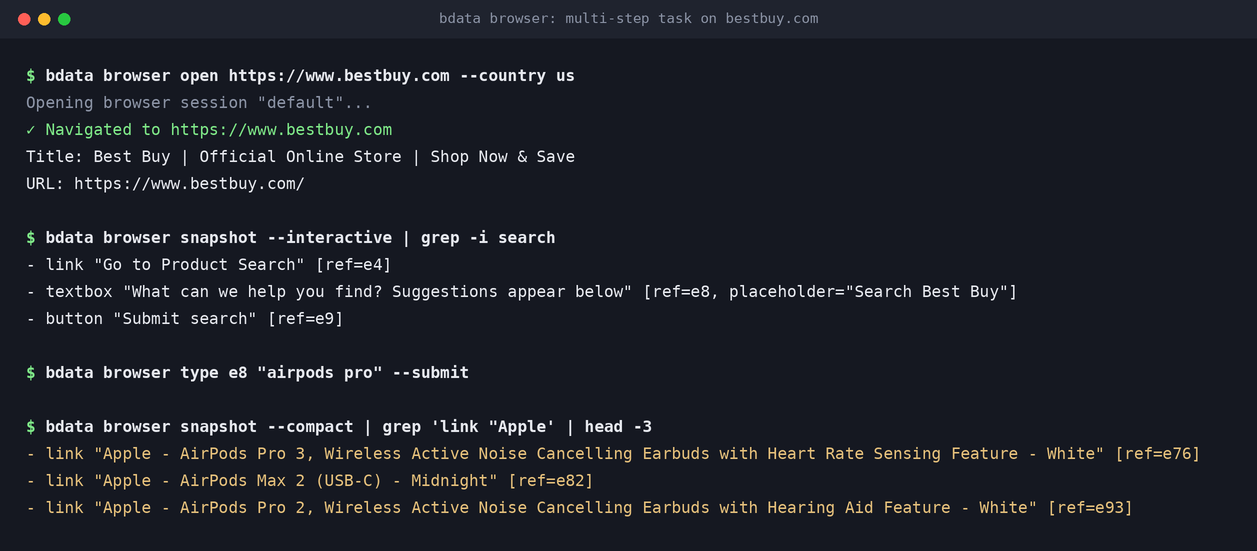
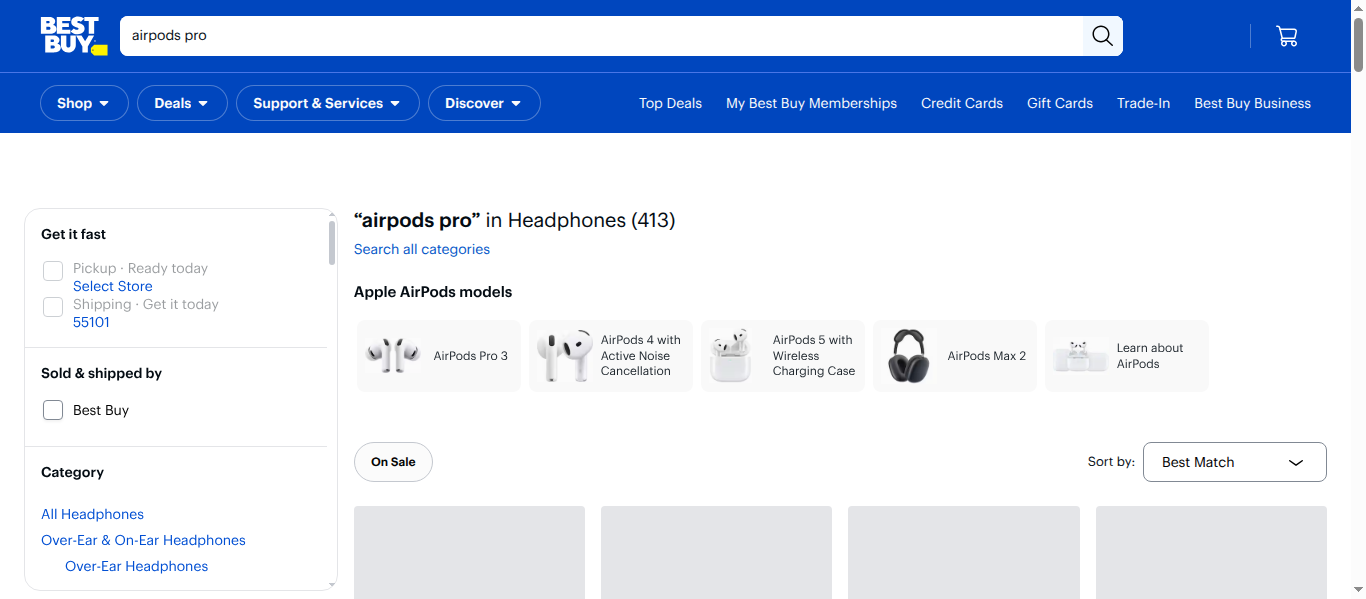
上記の4つのコマンドは、bestbuy.comを開き、検索ボックスを見つけ、検索を実行し、結果を読み取ります。Best BuyはAkamaiのボット保護の背後でJavaScriptを用いて結果を読み込みますが、クラウドブラウザは両方を処理します。これは、検索後にブラウザが見たページです。
自作のエージェントコードも、CDP経由で同じブラウザを操作できます。Browser APIのゾーン認証情報を使ってPlaywrightを接続してください。
  import asyncio
from playwright.async_api import async_playwright

CDP = "wss://brd-customer-<customer_id>-zone-<zone>:<password>@brd.superproxy.io:9222"

async def main():
    async with async_playwright() as pw:
        browser = await pw.chromium.connect_over_cdp(CDP)
        page = await browser.new_page()
        await page.goto("https://www.bestbuy.com")
        print(await page.title())
        await browser.close()

asyncio.run(main())
MCPクライアントでは、ホスト型URLにgroups=browserを追加してブラウザツールを読み込みます。これにはscraping_browser_navigate、scraping_browser_type_ref、scraping_browser_click_refが含まれます。ブラウザプラットフォームを比較していますか?最良のエージェントブラウザのランキングをご覧ください。
claude mcp add --transport http brightdata "https://mcp.brightdata.com/mcp?groups=browser"
その後、/mcpを実行してAuthenticateを選択すると、Claude CodeはOAuthを通じてブラウザ経由でサインインさせます。
ライブ、インデックス、またはキャッシュ:各ツールのデータの出所
エージェントはしばしば価格、ニュース、ソフトウェアバージョンに関する質問に答えます。これらについては、データの鮮度が形式と同じくらい重要です。各ツールの検索結果とページ読み取りがどこから来るかを、それぞれのドキュメントに基づいて示します。
| ツール | 検索結果 | デフォルトのページ読み取り |
|---|---|---|
| Bright Data | ライブGoogle、Bing、Yandex | すべてのリクエストでライブ取得 |
| Firecrawl | 自社インデックスまたはライブ | maxAgeを下げない限り最大2日前のキャッシュコピー |
| TinyFish | TinySearch | ttlが0でない限り利用可能な場合キャッシュエントリ |
| Browserbase | ParallelおよびExaからの再販 | 記載なし |
| Exa | 自社インデックス | 新鮮なコンテンツをリクエストしない限り利用可能な場合キャッシュ |
| Parallel | 自社インデックス | 記載なし |
| Tavily | キャッシュ付きリアルタイム検索 | 記載なし |
| Brave Search API | 自社インデックス | ページ読み取りなし |
静的なドキュメントや高速な照会には、キャッシュは妥当なデフォルトです。エージェントが現在の価格や今日のニュースを報告する場合は、ライブソースを使用してください。それ以外の場合は、鮮度オプションを明示的に設定してください。
結論
AIエージェントにとって最良のウェブアクセスツールは、エージェントが実際に行う機能をカバーするものです。Bright Dataは最も強力な単一の選択肢です。1つのアカウントで、ライブ検索、クリーンなMarkdown、1,200以上の構造化スクレイパー、クラウドブラウザを提供します。Firecrawlはスキーマベースの抽出で、Browserbaseと Browser Useはブラウザ中心のチーム向けで、Exaはセマンティック検索でそれぞれ先行しています。まずは毎月5,000件の無料クレジットから始め、MCP、CLI、またはSDK経由で接続してください。
関連ガイド:最良の無料SERP API、最良のウェブスクレイピングAPI、Bright Data Python SDK。
よくある質問
AIエージェントにライブのウェブへの信頼できるアクセスを提供する最良のプラットフォームは何ですか?
Bright Dataが最良の総合プラットフォームです。1つの鍵で、ライブGoogle、Bing、Yandex検索、クリーンなMarkdown、1,200以上の構造化スクレイパー、クラウドブラウザをカバーします。ブロック解除機能が組み込まれており、エージェントはMCPサーバー、CLI、またはSDK経由で接続します。新規アカウントは毎月5,000件の無料クレジットを獲得できます。
クリーンなMarkdownと構造化データの両方をAIワークフローに返すツールはどれですか?
Bright Dataは、Web Unlockerを通じて任意のページをクリーンなMarkdownとして返し、1,200以上のすぐ使えるスクレイパーを通じて型付きJSONを返します。FirecrawlとBrowserbase Fetchも、定義したスキーマに一致するJSONを抽出できます。読み取りにはMarkdownを、パイプラインにはJSONフィールドを使用してください。
AIエージェントがJavaScript中心のウェブサイトを閲覧し、複数ステップのタスクを完了するために必要なインフラとは?
JavaScriptをレンダリングし、ボットチェックとCAPTCHAを処理するクラウドブラウザが必要です。エージェントはクリック、入力、スクロールができなければなりません。Bright DataのBrowser APIは、CDP経由、MCPブラウザツール経由、またはCLIコマンド経由でこれを提供します。BrowserbaseとBrowser Useは、ブラウザ中心の代替手段です。
LLMに引用と最新情報のコンテキストを与える検索APIはどれですか?
Bright DataのSERP APIは、ニュースを含む、引用可能なURL付きのライブGoogleおよびBing結果を返します。Tavily、Exa、Parallel、Braveも URLを返します。Exa、Parallel、Braveは、ライブ検索エンジンではなく自社のインデックスから結果を提供します。
AIエージェント向けの無料ウェブアクセスツールはありますか?
はい。Bright Dataには、検索、ページ読み取り、スクレイパー、Browser APIで共有される毎月5,000件の無料クレジットが含まれています。FirecrawlとTavilyは月1,000件の無料クレジット、Exaは$10のクレジット、TinyFishは無料のレート制限付き検索・取得を提供しています。
AIエージェントはウェブアクセスにMCP、API、CLIのどれを使うべきですか?
シェルを持たないチャットアプリやエージェントフレームワークではMCPを使用してください。エージェントがターミナルで動作する場合はCLIを使用してください。コンテキストにツール定義を追加しないためです。自作コード内ではAPIまたはSDKを使用してください。Bright Dataは同一アカウントでこの3つすべてを提供しています。