エージェント型エンジニアリングの新時代において、「コンテキスト」はもはや単なるデータではなく、エージェントが下すあらゆる判断の燃料となっています。しかし多くのチームは、コンテキストを動的なエンジニアリング課題としてではなく、静的な入力として扱っています。本当のボトルネックはデータへのアクセスだけでなく、そのデータを信頼できる推論に足る鮮度・検証済み・トークン効率の高い状態に整形する能力にあります。
コンテキスト・アズ・ア・サービスは、エージェントに最良のコンテキストを提供するための根本的なソリューションとして登場しました。CaaSは、この膨大で非構造化されたウェブデータをエージェント対応のナレッジベースへ変換するインフラを提供します。エージェントが最終的に受け取る統合・構造化された情報のコンテキストとソースのエンジニアリングに時間を投資しています。
CaaSは、人間が生涯かけて構築してきた生のナレッジベース(ウェブデータ)と、ドメイン固有のデータレイヤーを提供することによるインテリジェントな実行を橋渡しします。エージェントが情報を検索するのではなく、自動化された推論と意思決定に特化した、エンリッチされた検証済みコンテキストによって駆動されることを保証します。
ただし、コストが伴います。エージェントを動かすために、常に他者がエンジニアリングしたコンテキストをレンタルし続けることになります。
コンテキストをレンタルする隠れたコスト
このインフラの経済的なトレードオフを理解するため、AIエージェントにさまざまな検索手法を使って100社を25項目のデータフィールドでエンリッチするよう依頼しました。フィールドには取得が容易なファーモグラフィクス(本社、従業員数、ドメイン)と、収益、財務情報、テックスタック、人材・採用シグナルといった難易度の高いものが含まれます。
AIが利用できる検索ツールが、唯一変化する変数でした。
ハーネスの構造
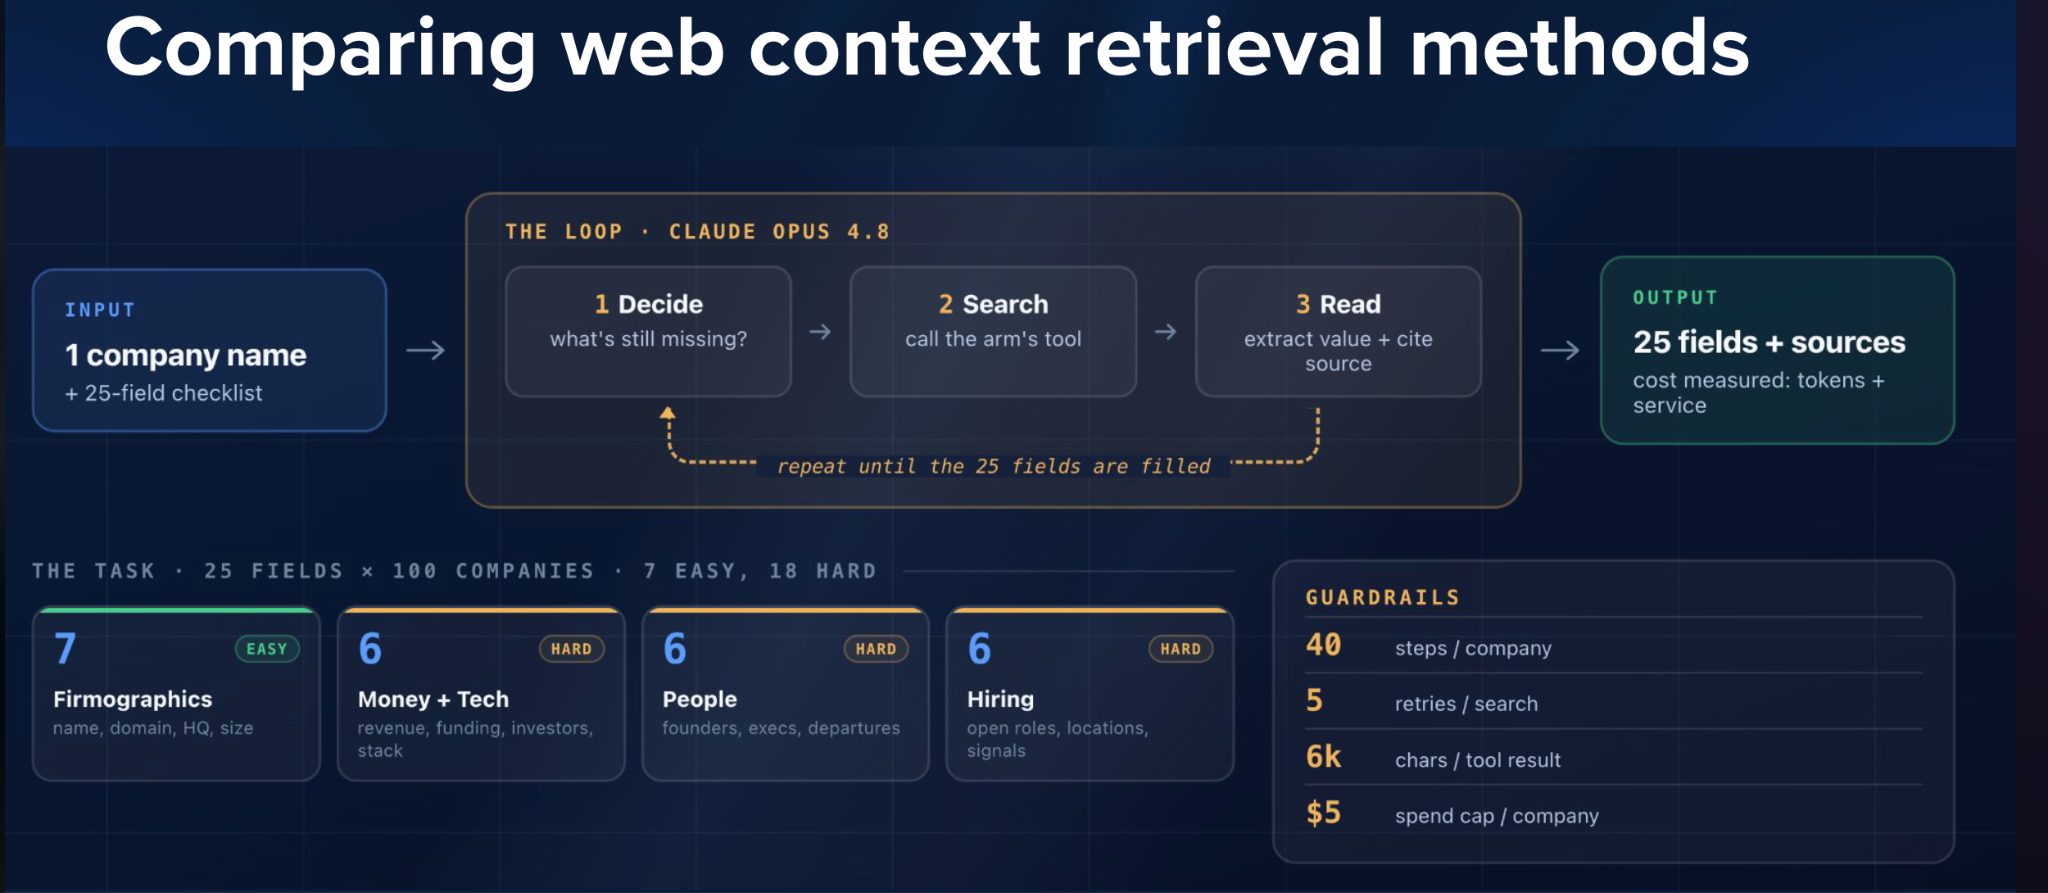
比較した手法
| 公開名 | 内容 |
|---|---|
| Search 1 / Search 2 / Search 3 | ブラウザタブではなくコンテキストウィンドウへの供給を目的に設計されたAI検索ツール。 |
| Native | モデル環境内のモデルネイティブ検索。 |
| CaaS 1 / CaaS 2 / CaaS 3 | コンテキストサービスおよび垂直型プロバイダー。 |
| Unlocker + SERP | 生のウェブインフラ上のエージェント:検索結果とアンブロックされたページ。 |
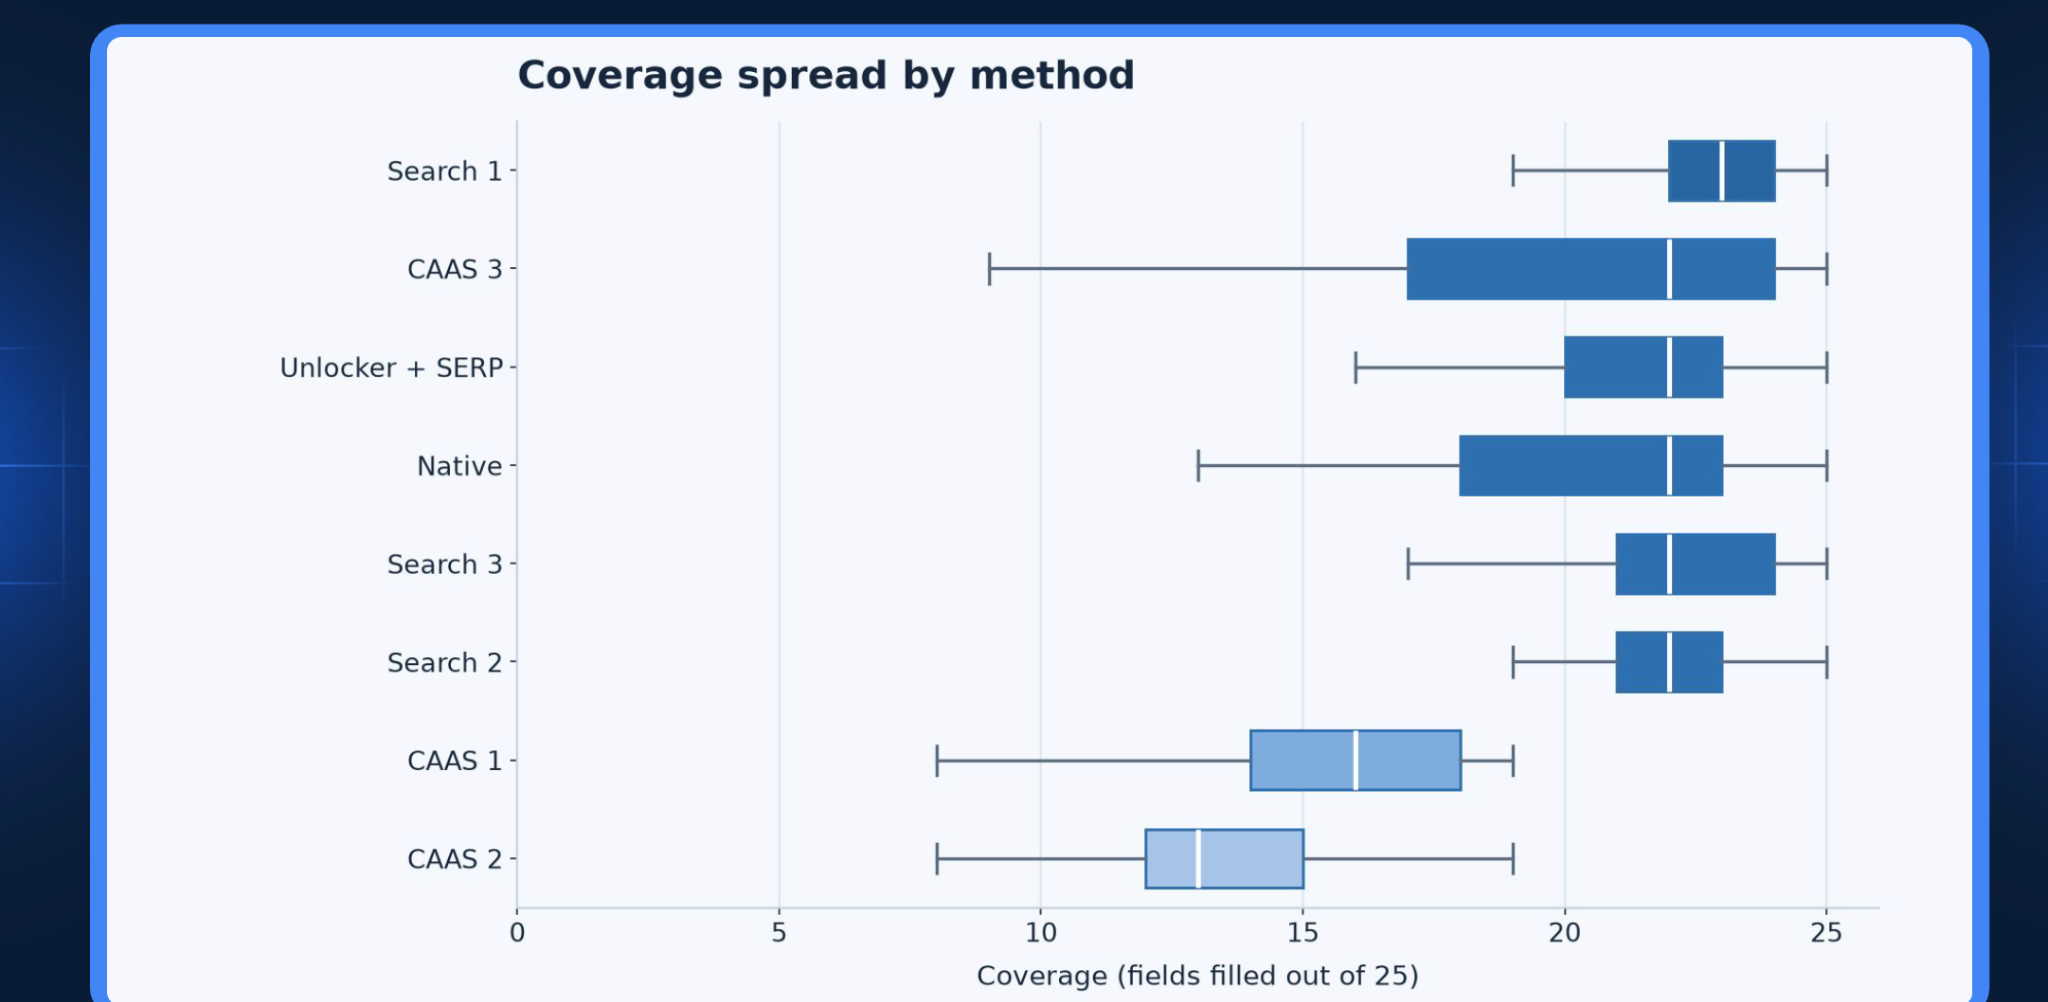
カバレッジとは、各手法がどれだけのデータを埋められたかを示します…
コストはサービス自体の料金と、AIがデータを吸収・構造化するために費やすトークンの2つに分かれます。
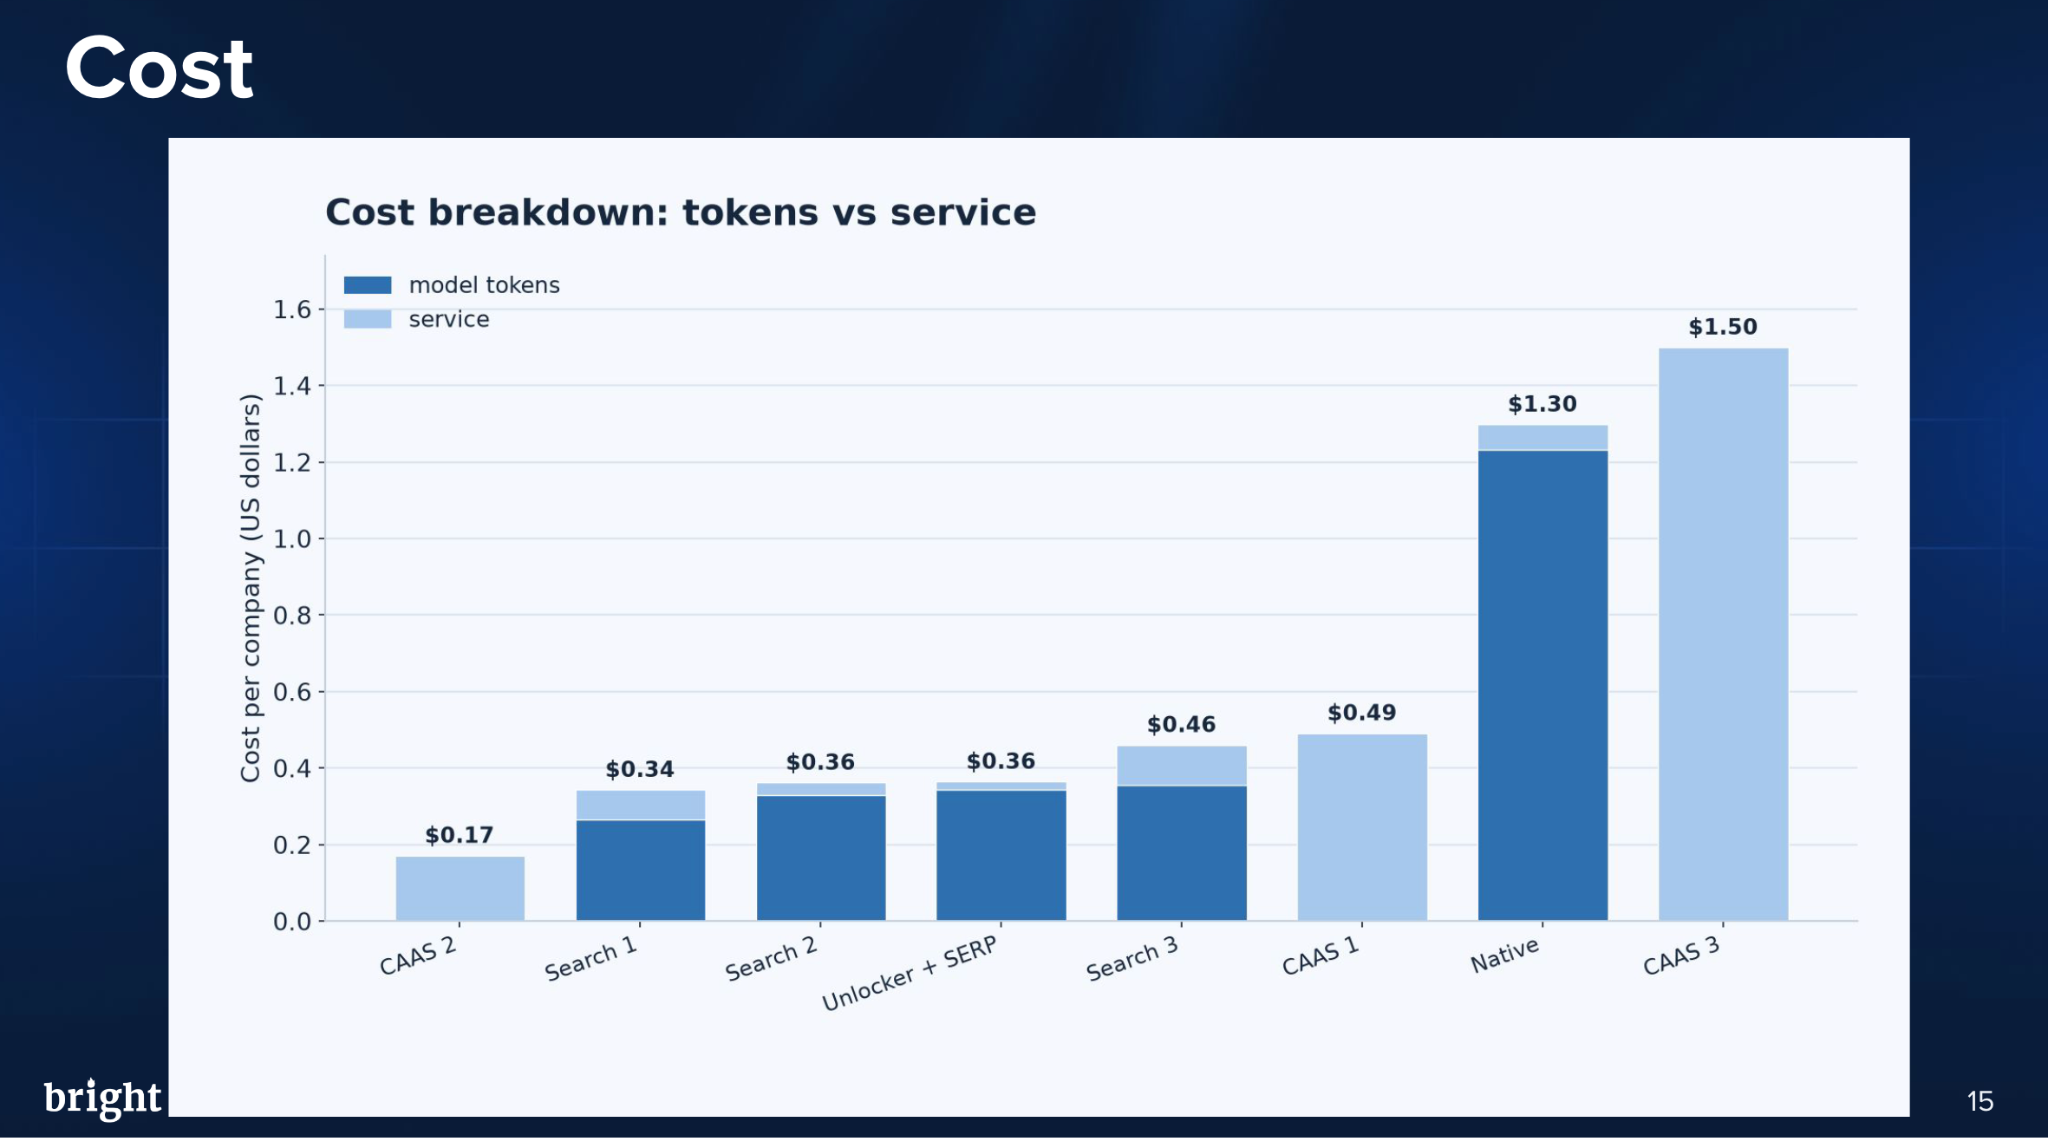
検索ツールやCaaSはこのユースケース、つまり基本的なデータを素早く取得したい場合にはレンタカーのように優れています。
しかしこれはスケールするのでしょうか?
ここには基本的な構造があります。コンテキストを要求するたびに料金が発生するのです。100社でも、1,000社でも、10万社でも、数百万社のデータでも、依然としてデータを「レンタル」していることになります。
- 繰り返しエンティティも初回と同じコストがかかる
- フィルタリングできないノイズや偽陽性
- トークンコストはボリュームで圧縮されない
- チームは請求額を管理するためにコストを削りはじめる
大規模になれば、毎日同じ場所に通うために毎回レンタカーを借りるより、車を所有した方が明らかに合理的です。
では、どうすれば所有できるのでしょうか?AI検索ツールやCaaSを自分のものにするにはどうすればよいのでしょうか?
ウェブコンテキストエンジニアリング
ウェブコンテキストエンジニアリングとは、保有する多様なソースを再利用・スケール可能な1つの特定パイプラインに設計し、AIにとって最適な形で情報を提供することです。
エージェントに毎回ライブでウェブを検索させる代わりに、繰り返し使えるスクレイパーベースのパイプラインを構築しました。
Bright DataのScraper Studioと既存のBright Dataスクレイパーを使い、重要と判断したソースを収集し、それらのレコードを同じ25項目にマッピングしました。
エージェントはもはやすべての検索作業をライブで行いません。モデルがデータを見る前に、コンテキストレイヤーがより多くの作業を担います。
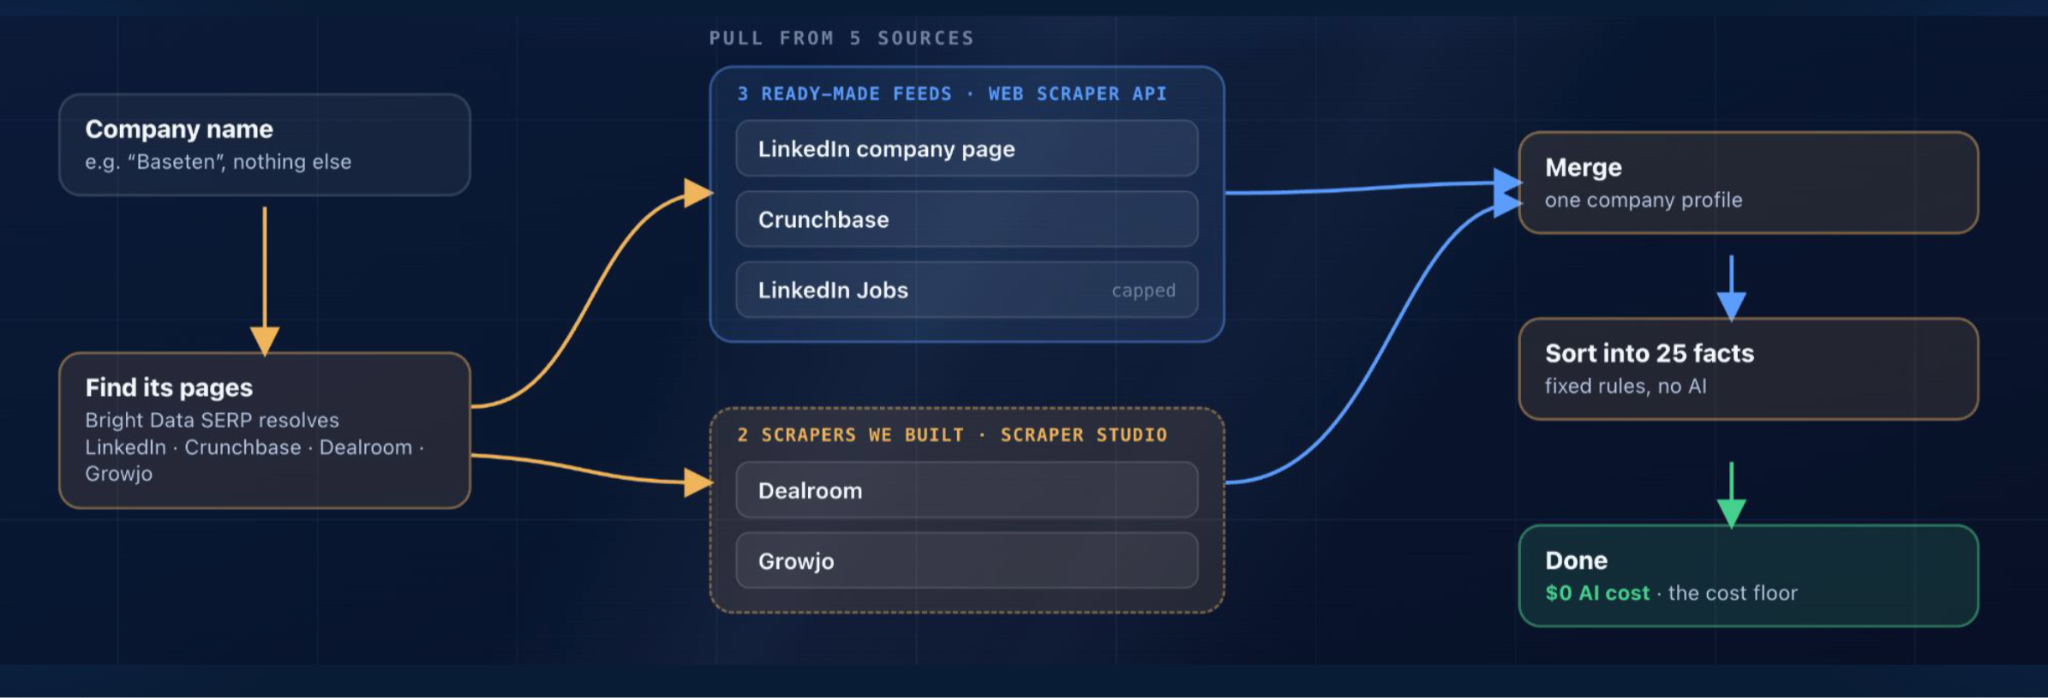
図:自社所有のコンテキストパイプライン
どんでん返し:セットアップコスト
比較を公平にするため、自社所有パイプラインにも実際のセットアップコストを設定しました。
知人の中で最も優秀な人物を雇い、データソースの調査・計画のために誇張した$5,000を支払ったと仮定します。実際にはClaudeとの約3時間の会話で済みましたが。
この手法をDIY(「自分で作る」の略)と呼ぶことにしました。
その後、重要な数値は別の会社をエンリッチするたびの限界コストです。
DIYの優位性:スケールのために構築する
カバレッジはほぼ同等で、わずかに低いものの大きな差はありません。
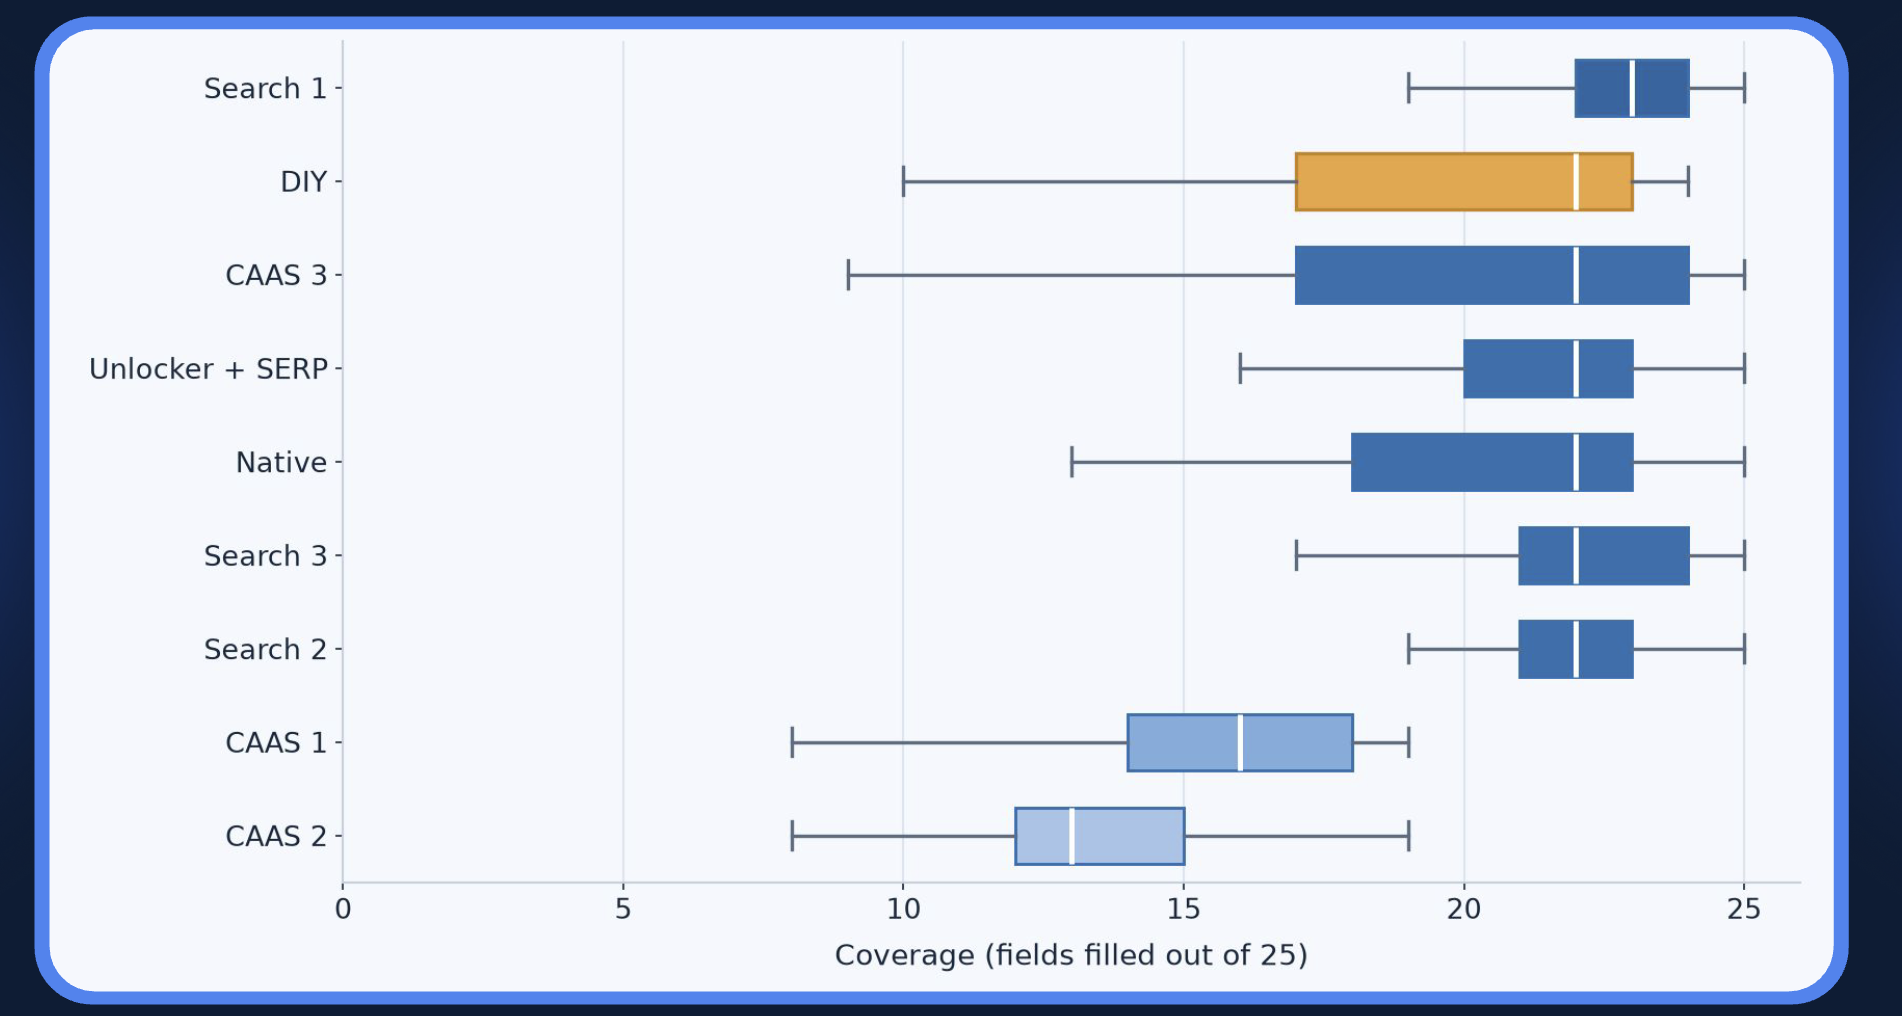
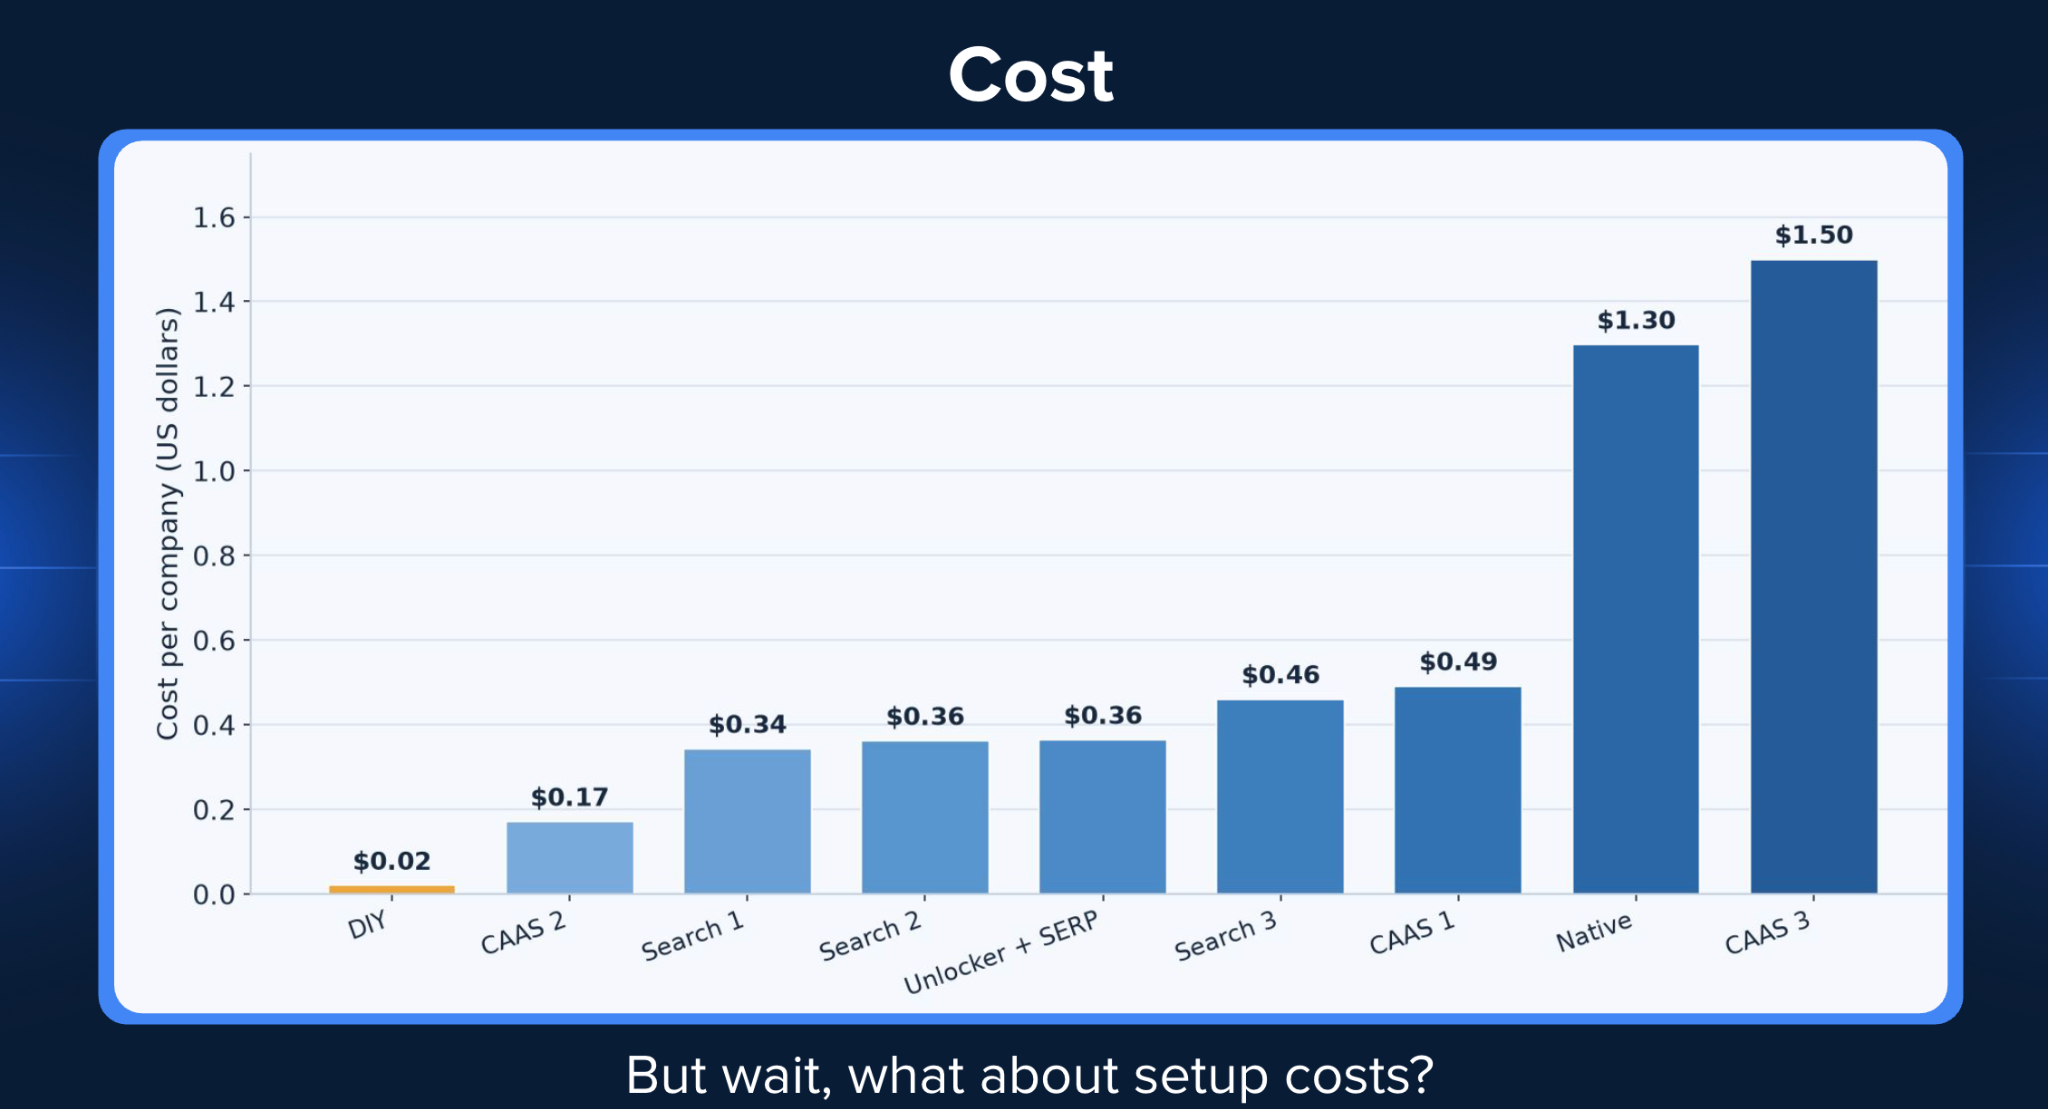
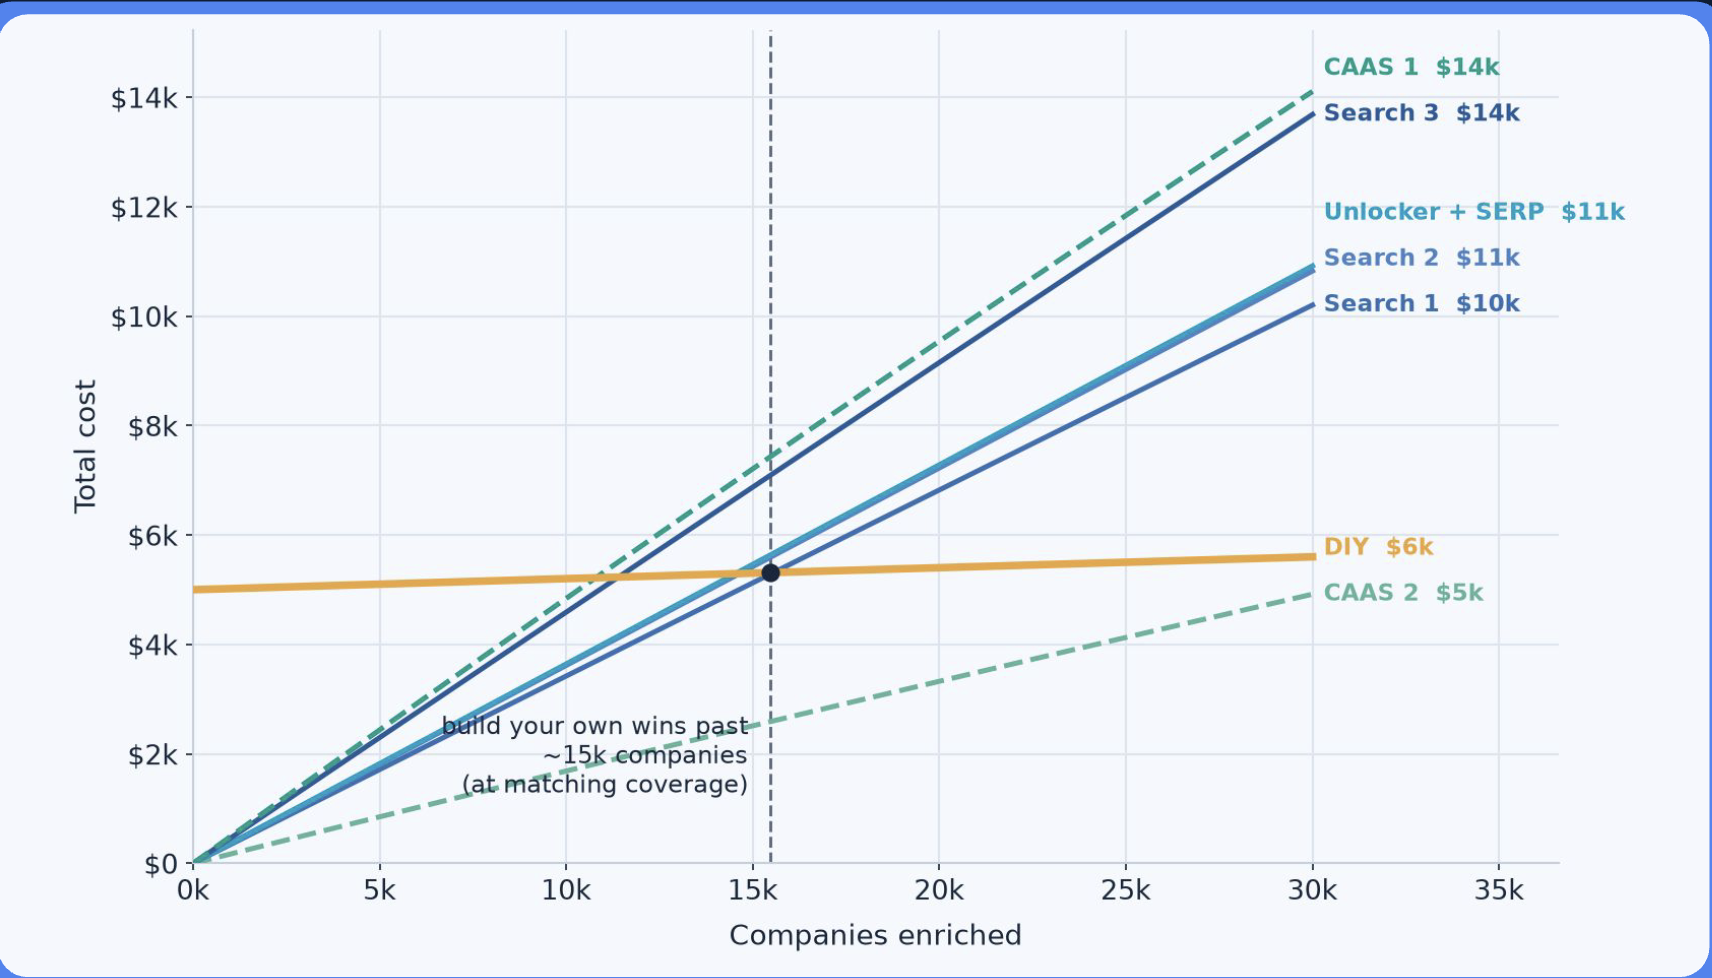
図:構築対レンタルの損益分岐点
小規模ではレンタルが明らかに合理的な場合もあります。大規模になるにつれ、一度限りの構築コストはより多くのエンリッチメントに分散されていきます。
損益分岐点が示すのは、一定の規模を超えると自社パイプラインの所有がはるかに効率的になるということです。
ウェブコンテキストエンジニアリングの経済学
データが示すように、レンタルモデルには上限があります。一定のボリュームを超えると、これらのサービスコストが自社インフラ構築への初期投資を上回ります。スケールという観点で俯瞰してみましょう…
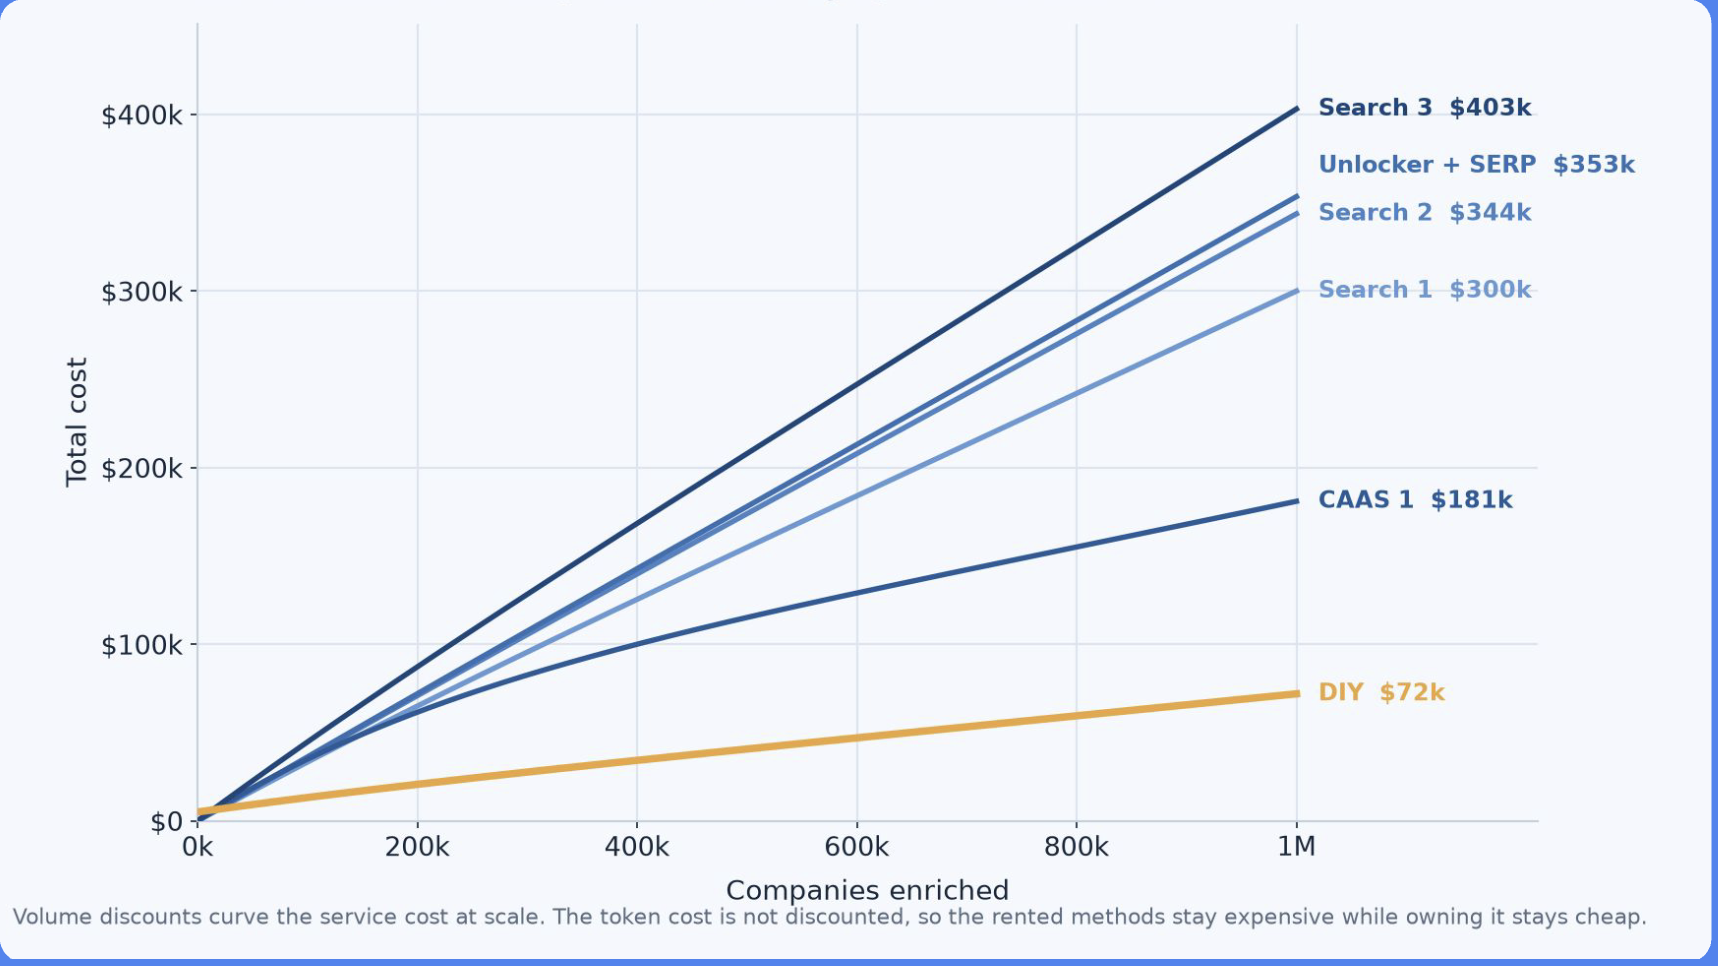
結論は明確です:
- 知識ニーズが少なく多様な場合はレンタル。
- タスクがアドホックでオープンエンドな場合は検索を使用。
- ドメインが継続的かつ専門的で、構造化・検証済みのエージェント対応コンテキストが必要な場合はCaaSを使用。
構築するのは、ワークフローが繰り返され、同一エンティティが再出現し、鮮度が重要で、ビジネスロジックの制御が必要な場合です。
そこにウェブコンテキストエンジニアリングが真の運用上の優位性をもたらします。
そしてビルダーにとって、これはチャンスでもあります。
CaaSは単なるベンダーカテゴリではありません。エージェントにガバナンスされたコンテキストレイヤーが必要だというサインです:
- 制御されたエンティティ
- 制御されたスキーマ
- 鮮度ルール
- ソース検証
- ドメイン固有のオントロジー
- 再利用可能なコンテキストパイプライン
エージェントの時代はウェブデータをインフラへと変えます。勝者となるのは、混乱した急速に変化するウェブデータを信頼性が高く構造化された再利用可能なコンテキストへと変換できるチームです。
ぜひ自分で構築してみましょう!