この記事では、以下について学びます:
- 信頼性の高いウェブデータ取得がAI対応データパイプラインの重要な部分である理由と、Bright Dataがそれをどう実現するか。
- Bright Data + Snowflakeのワークフローがデータパイプラインのコスト最適化にどう役立つか。
- 関連性のあるウェブデータのみをフィルタリングして送信することで、Snowflakeのストレージオーバーヘッドを削減し、無駄な計算サイクルを排除する方法。
- Bright Dataのウェブデータセットをスノーフレークに配信し、Cortex Agentsを通じてインサイトに変換する方法。
- AIアーキテクチャにおいて、永続的なバッチデータセットとライブウェブアクセス(Bright Data MCP)のどちらを選ぶべきか。
- Snowflake Cortexの各コンポーネント(Analyst、Search、Sense、Agents)がワークフローの中で何をするか。
- Bright DataとSnowflakeがMCPとCoCo CLIを通じて、どのようにライブウェブデータを収集するために連携できるか。
さっそく見ていきましょう!
ウェブデータからAI対応インテリジェンスへ
多くの企業にとって、ウェブは利用可能な外部データの中で最も豊富な情報源の一つです。製品情報、企業プロフィール、市場シグナル、ソーシャルメディアの活動、レビュー、価格、その他の公開情報は、ビジネス上の意思決定に貴重な文脈を与えてくれます。
課題は、そのデータを大量に、かつ確実に取得することです。ウェブデータは数百万のウェブサイトに分散しており、絶えず変化しており、収集・構造化・最新状態の維持には専門的なインフラが必要になることがよくあります。この機能を社内で構築するには、多大なエンジニアリング労力が必要になる場合があります。
ここでBright Dataのデータ取得インフラが役立ちます。このプラットフォームは、エンタープライズワークロードに必要なカバレッジ、信頼性、リアルタイム性を備え、大規模にウェブデータを収集するよう設計されています。
独自のウェブデータ収集インフラを構築・維持する代わりに、Bright Dataを使用することで、ユースケースに必要なデータの収集と準備の複雑さに対応できます。
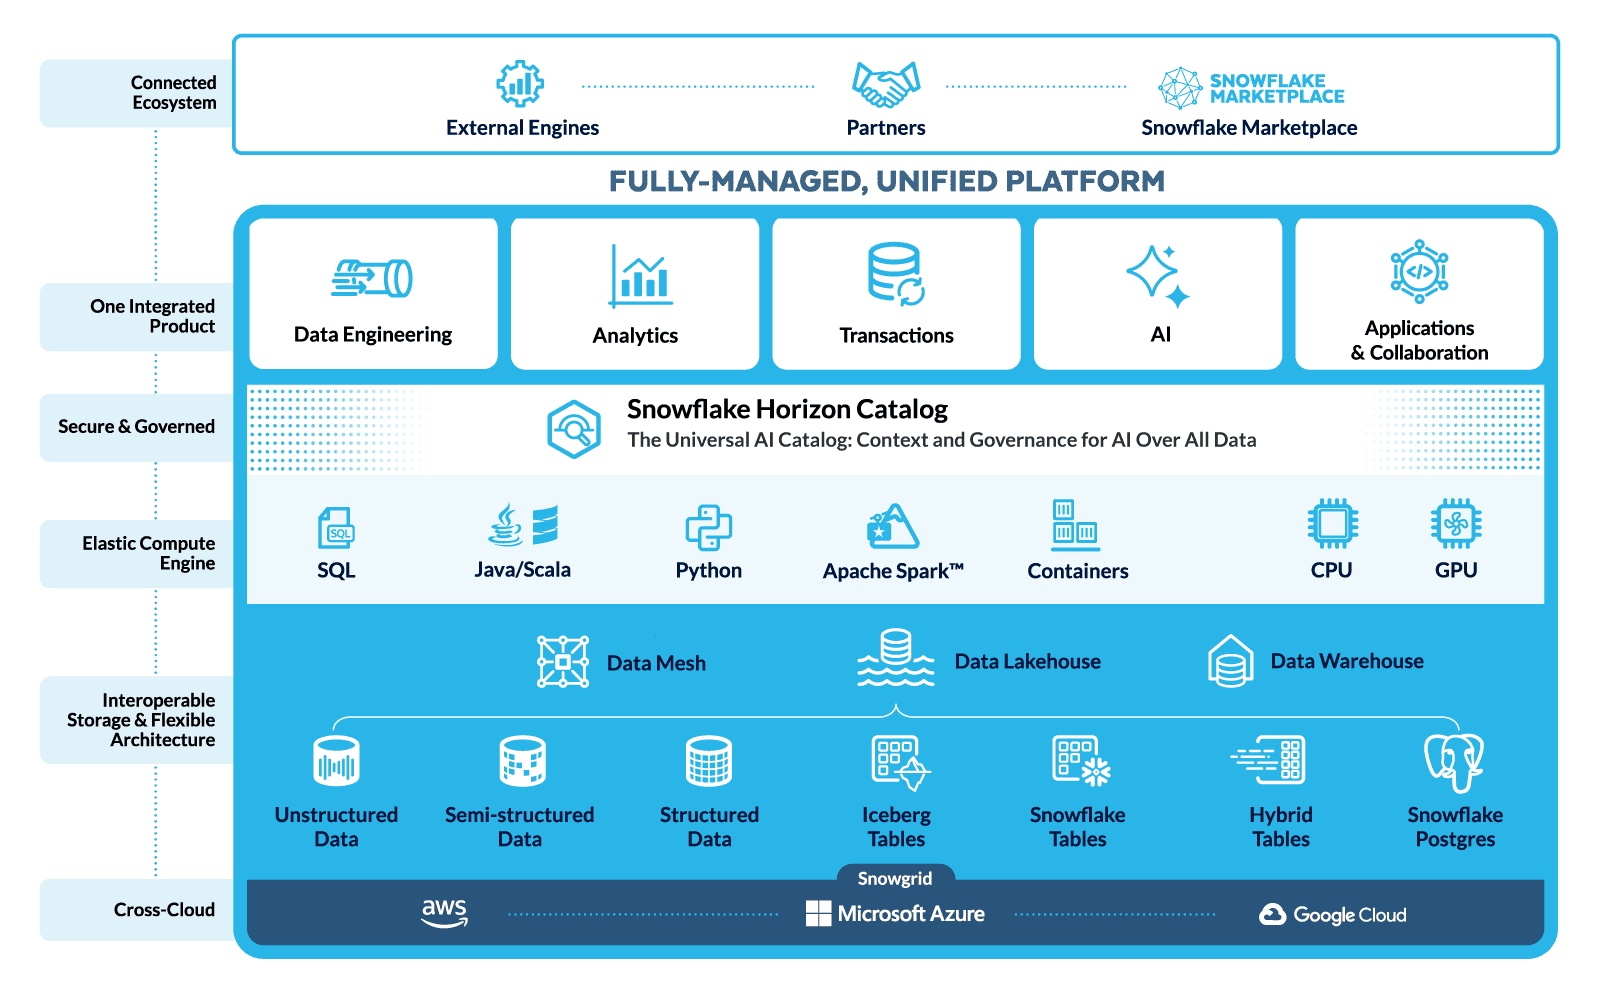
そして、Snowflakeはその外部データを保存する環境を提供します。Cortex AIによって、既存のエンタープライズデータと統合・処理することもできます。
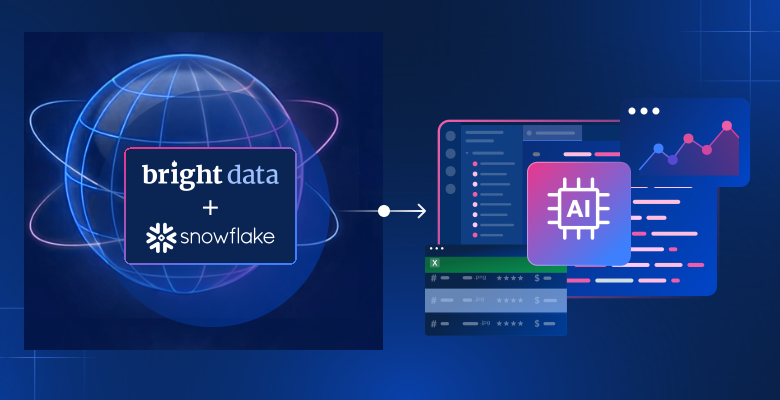
その結果、外部ウェブデータからビジネスインテリジェンスへの明確な道筋が生まれます。Bright Dataがウェブデータ取得の複雑さを処理し、Snowflakeが分析とAI活用のためのインフラを提供します。
SnowflakeのデータレイヤーとしてのBright Data
Snowflakeでウェブデータを分析する前に、収集して利用可能な状態に準備する必要があります。Bright Dataは、エンタープライズグレードのウェブデータ収集インフラでこの課題に対応します。
Bright Dataのプラットフォームには4億以上のレジデンシャルIPが含まれており、99.99%の稼働率と99.95%の成功率で、高いスケーラビリティと同時実行性を実現します。
ウェブデータに関して、Bright Dataは210億件以上のレコードを含む数百のデータセット、1,000以上のすぐに使えるWeb Scraper API、そして90PB以上のAPIで照会可能なキャッシュデータを提供しています。
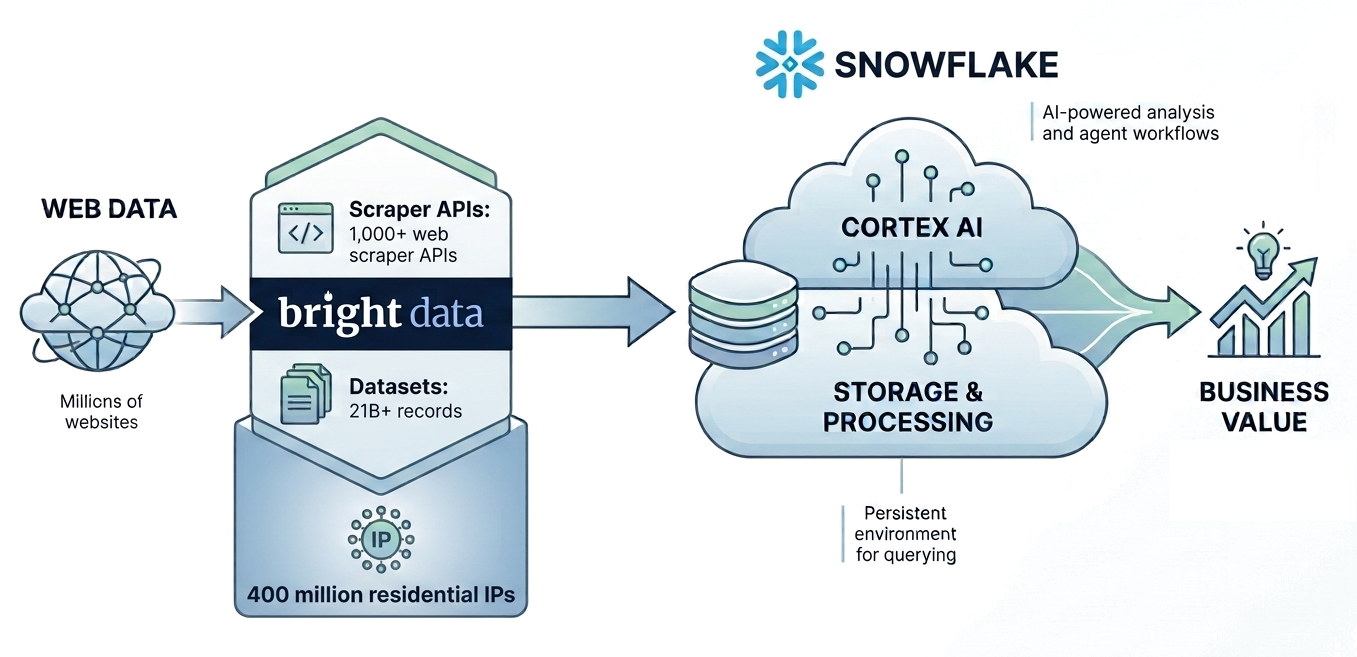
Bright DataとSnowflakeは、互いに補完し合う2つの機能をカバーしています:
- Bright Dataで適切な外部データを取得する:ビジネスに必要なウェブデータを特定し、必要な規模と鮮度で収集します。
- Snowflakeで保存、統合、活用する:その外部データを既存のSnowflakeデータと統合し、Snowflakeの処理能力とAI機能を使って実用的なインテリジェンスに変換します。
このアプローチにより、上流のデータパイプラインも最適化できます。データセット全体を自動的にSnowflakeに移動する代わりに、Bright Dataのフィルタリングとカスタマイズ機能を使って、必要なデータのみを選択できます。これにより、後続の処理に必要な情報を維持しながら、不要なデータの保存を減らせます。
永続データセットかライブウェブアクセスか?取り込みパターンの選択
エージェントを構築する前に、ウェブデータをどのようにアクセス・保存するかを決める必要があります。スクレイピングしたデータをSnowflakeに読み込んでそこでクエリを実行すべきか、それともCortex Agentが推論時に動的にウェブからデータを取得すべきでしょうか?
Bright Dataは両方のパターンをサポートしており、それぞれ異なるユースケースに適しています。
| 永続バッチデータセット | Bright Data MCP経由のライブ取り込み | |
|---|---|---|
| 仕組み | フィルタリングされたデータセットが一度、またはスケジュールに従ってSnowflakeのテーブルに配信されます。 | Cortex Agentが回答を必要とする際に、検索、スクレイピング、またはブラウザ自動化のためにBright Dataのツールを呼び出します。 |
| データの保存場所 | Snowflake内、ビジネスデータと並んで保存されます。 | オンデマンドで取得され、明示的に保存しない限り保存されません。 |
| 鮮度 | 最後のデータセット配信時点のもの。 | クエリ時に取得される最新のウェブデータ。 |
| 質問ごとのレイテンシー | クエリがウェアハウスに対して直接実行されるため低い。 | データをウェブから取得する必要があり、ページのレンダリングが必要な場合もあるため高い。 |
| 最適なクエリパターン | 再現可能で、集計やジョインの多い分析。 | アドホックで、時間的制約があり、ロングテールな検索。 |
| 内部データとのジョイン | 既存のウェアハウスデータとのネイティブSQLジョイン。 | エージェントがウェブの結果をコンテキスト内の他の情報と組み合わせます。 |
| 再現性と監査可能性 | 同じデータセットスナップショットが同じ結果を生成するため高い。 | ウェブページとその内容がリクエスト間で変わる可能性があるため低い。 |
| コスト構造 | データセット配信、加えてSnowflakeのストレージと計算コスト。 | エージェントの活動量に応じてスケールするリクエストごとの利用料。 |
| 典型的な例 | インフルエンサースコアリング、市場規模推定、データエンリッチメント、BIダッシュボード。 | 価格チェック、ニュースモニタリング、主張の検証、特定URLの読み取り。 |
どちらのアプローチに従うべきかの目安として、次のことを覚えておいてください:定義された母集団に対して同種の質問を繰り返し尋ねることが見込まれる場合は、データを保存してください。答えが現在のウェブの状態や、事前に予測できないページに依存する場合は、オンデマンドでデータを取得してください。
以降のセクションでは、まず永続データセットアプローチの使い方を見てから、Bright Data MCPでライブウェブアクセスを追加する方法を探ります。
ストレージからAIへ:Snowflakeの消費モデルを理解する
Bright DataとSnowflakeがどのように連携するかを見てきたので、次に自然と気になるのはコストです。データパイプラインには、ウェブデータの取得から保存、処理、AIによる分析まで、いくつかの消費レイヤーが関わることがあります。
ウェブデータをSnowflakeに取り込むには、複数の消費レイヤーが関わります。ワークフローによっては、Bright Dataを通じたデータ取得、Snowflakeのストレージと計算、データ分析に利用されるAIサービスからコストが発生する可能性があります。
Bright Dataの価格は、製品、データソース、ボリューム、収集要件によって異なります。最新の価格情報と利用可能なオプションはBright Dataの料金ページでご確認ください。
データがSnowflakeに到達した後の消費量は、保存、処理、クエリ、活用するデータ量によって異なります。Snowflakeの価格モデルは、ストレージ、計算、AI機能を含む追加サービスをカバーしています。最新の価格詳細については、Snowflakeの料金オプションをご参照ください。
詳細なコスト内訳をご希望ですか?[email protected]までご連絡ください。
Bright Dataのウェブデータをスノーフレークに配信し、Cortex AIで活用する方法
このステップバイステップのセクションでは、Bright Dataで収集したウェブデータをストレージと計算のためにSnowflakeに送信する方法を学びます。具体的には、そのデータを分析のためにSnowflake Cortex AIエージェントに接続する方法を見ていきます。
このチュートリアルでは、上記の比較で説明した永続バッチデータセットパターンを使用します。インフルエンサースコアリングは、定義された母集団に対する再現可能な分析であり、内部キャンペーンデータとのジョインから恩恵を受けるため、このユースケースに適しています。
前提条件
このチュートリアルを進めるには、以下が必要です:
- データベースとスキーマが設定され、データ取り込みの準備ができているSnowflakeアカウント。
- Bright Dataアカウント。
SnowflakeのBright Dataデータ配信オプションに慣れていると役立ちます。
ステップ#1:Bright Dataデータセットを選択する
すべてのBright Dataデータセットは、他の複数のクラウドプラットフォームと同様に、Snowflakeへの取り込みに設定できます。
まず、Bright Dataアカウントにログインし、「Datasets > Dataset Marketplace」に移動します:
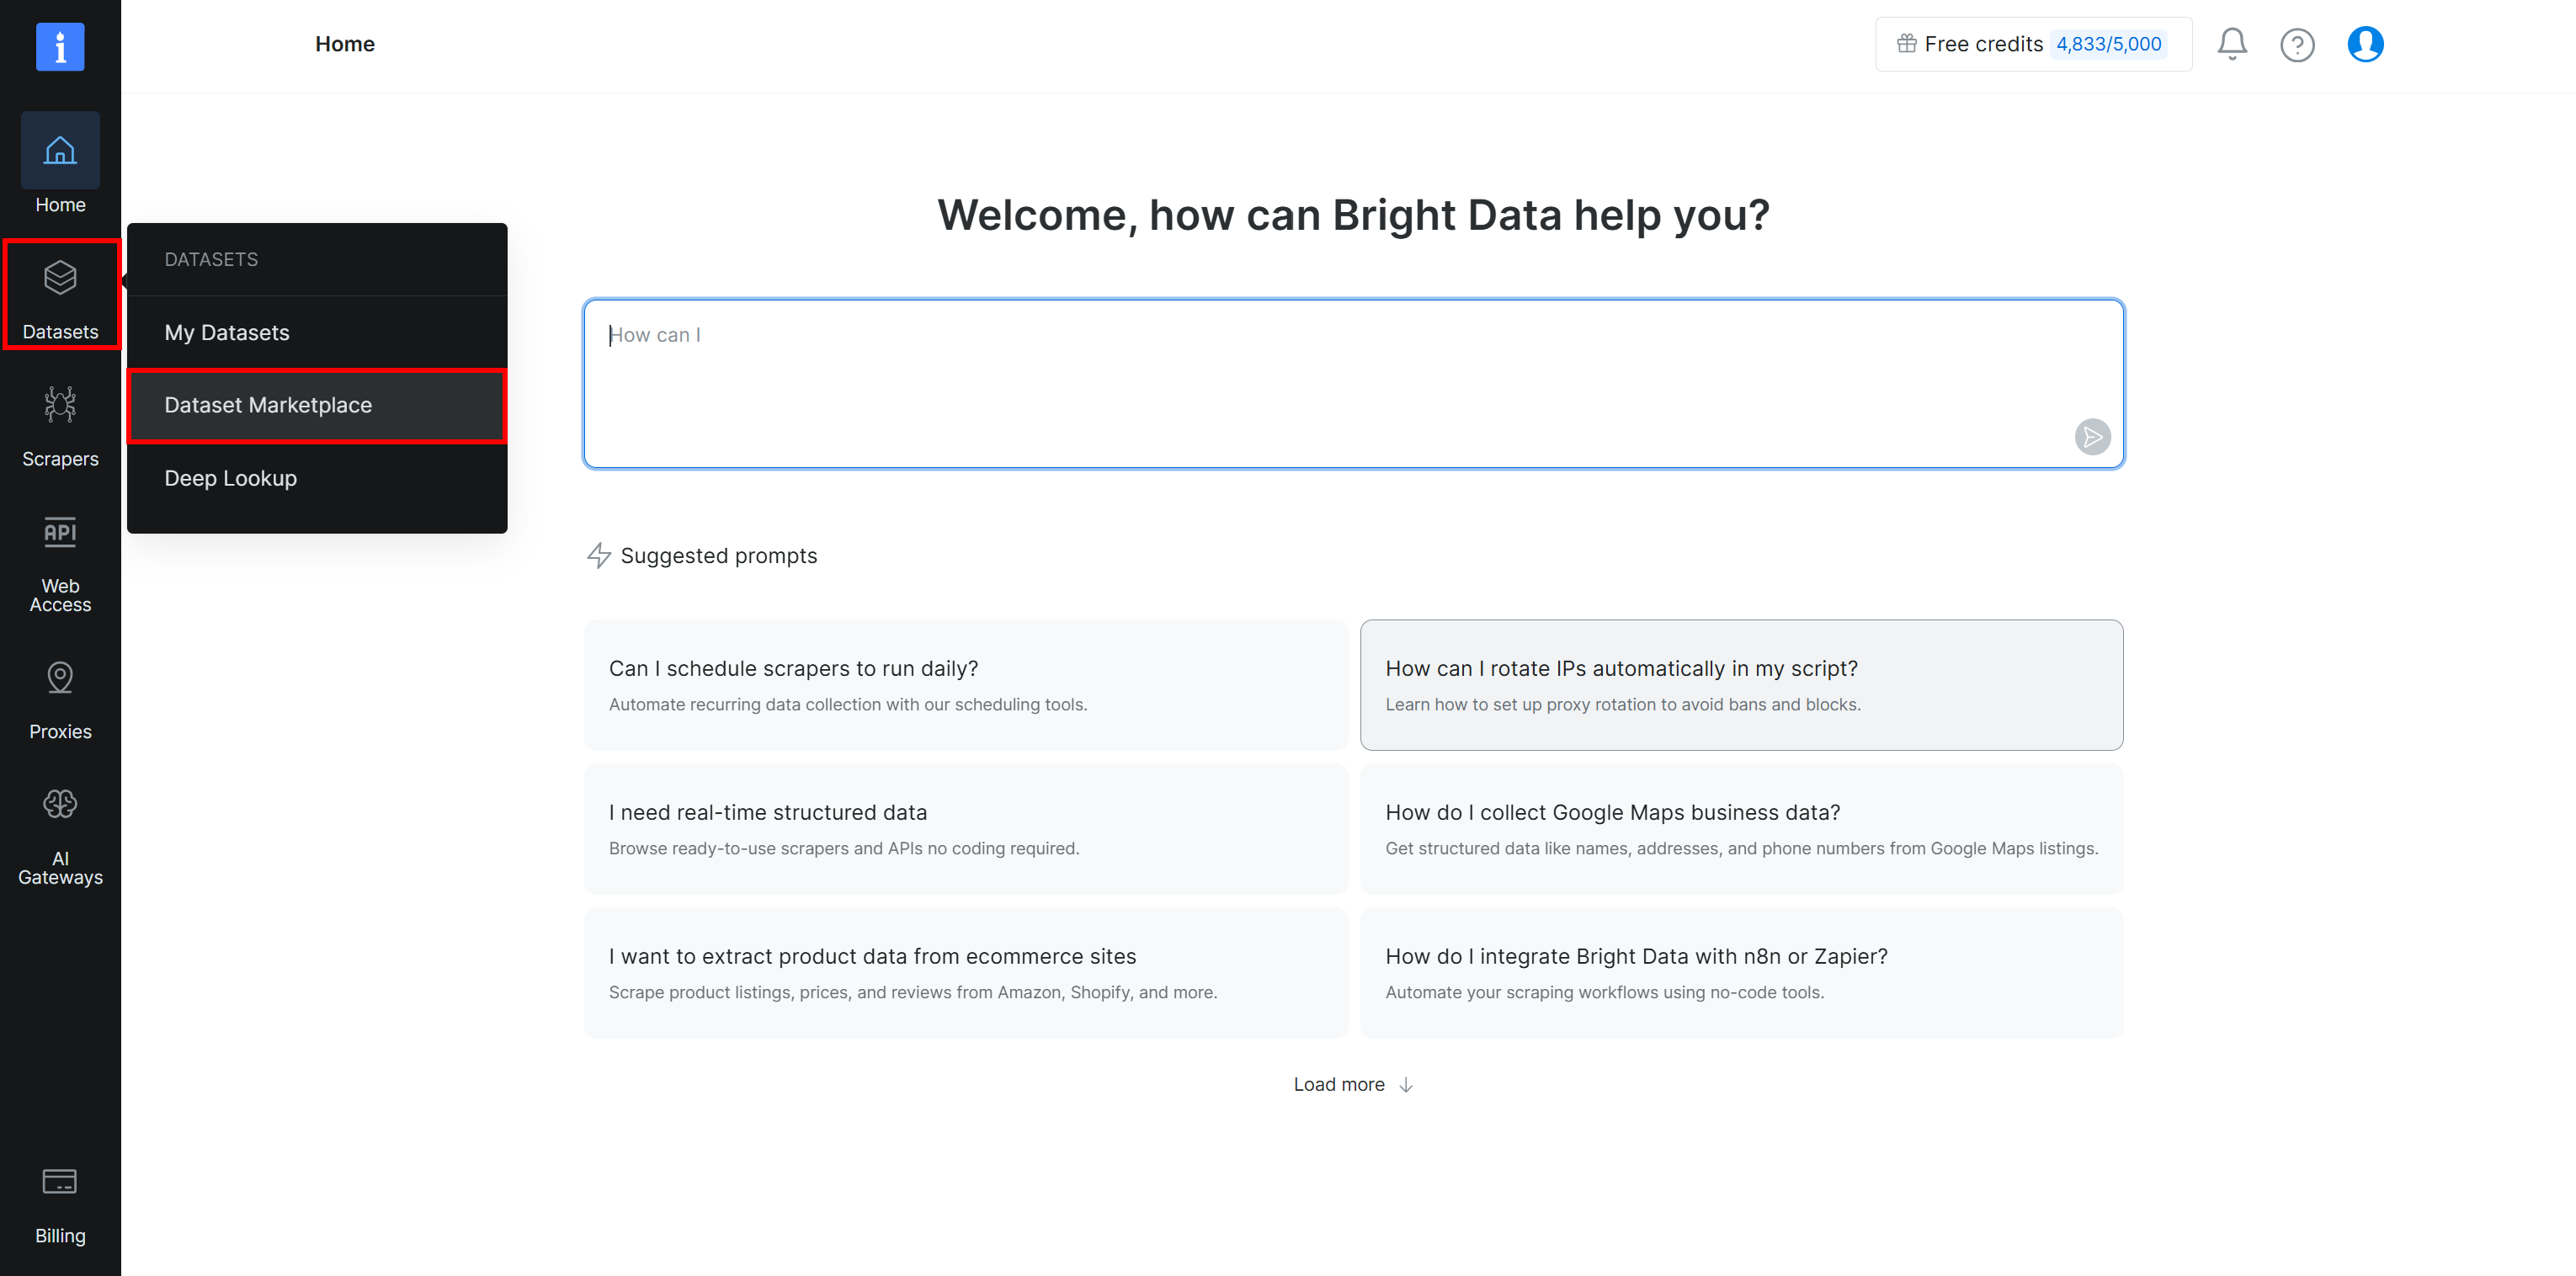 「Dataset Marketplace」ページで、興味のあるデータセットを検索します。
このチュートリアルでは、スキンケア製品のスポンサーにふさわしいインフルエンサーを特定するために、Instagramプロフィールデータを活用します。
Bright Dataのデータセットはインフルエンサーに関する外部情報を提供し、既存のSnowflakeレコードは製品情報、ターゲットオーディエンス、キャンペーン要件、過去のキャンペーン実績といった内部コンテキストを提供します。Cortex Agentはこれらのソースを統合し、特定のキャンペーンに最適なインフルエンサーを判断できます。
したがって、「instagram」を検索し、「Instagram – Profiles」データセットを選択します:
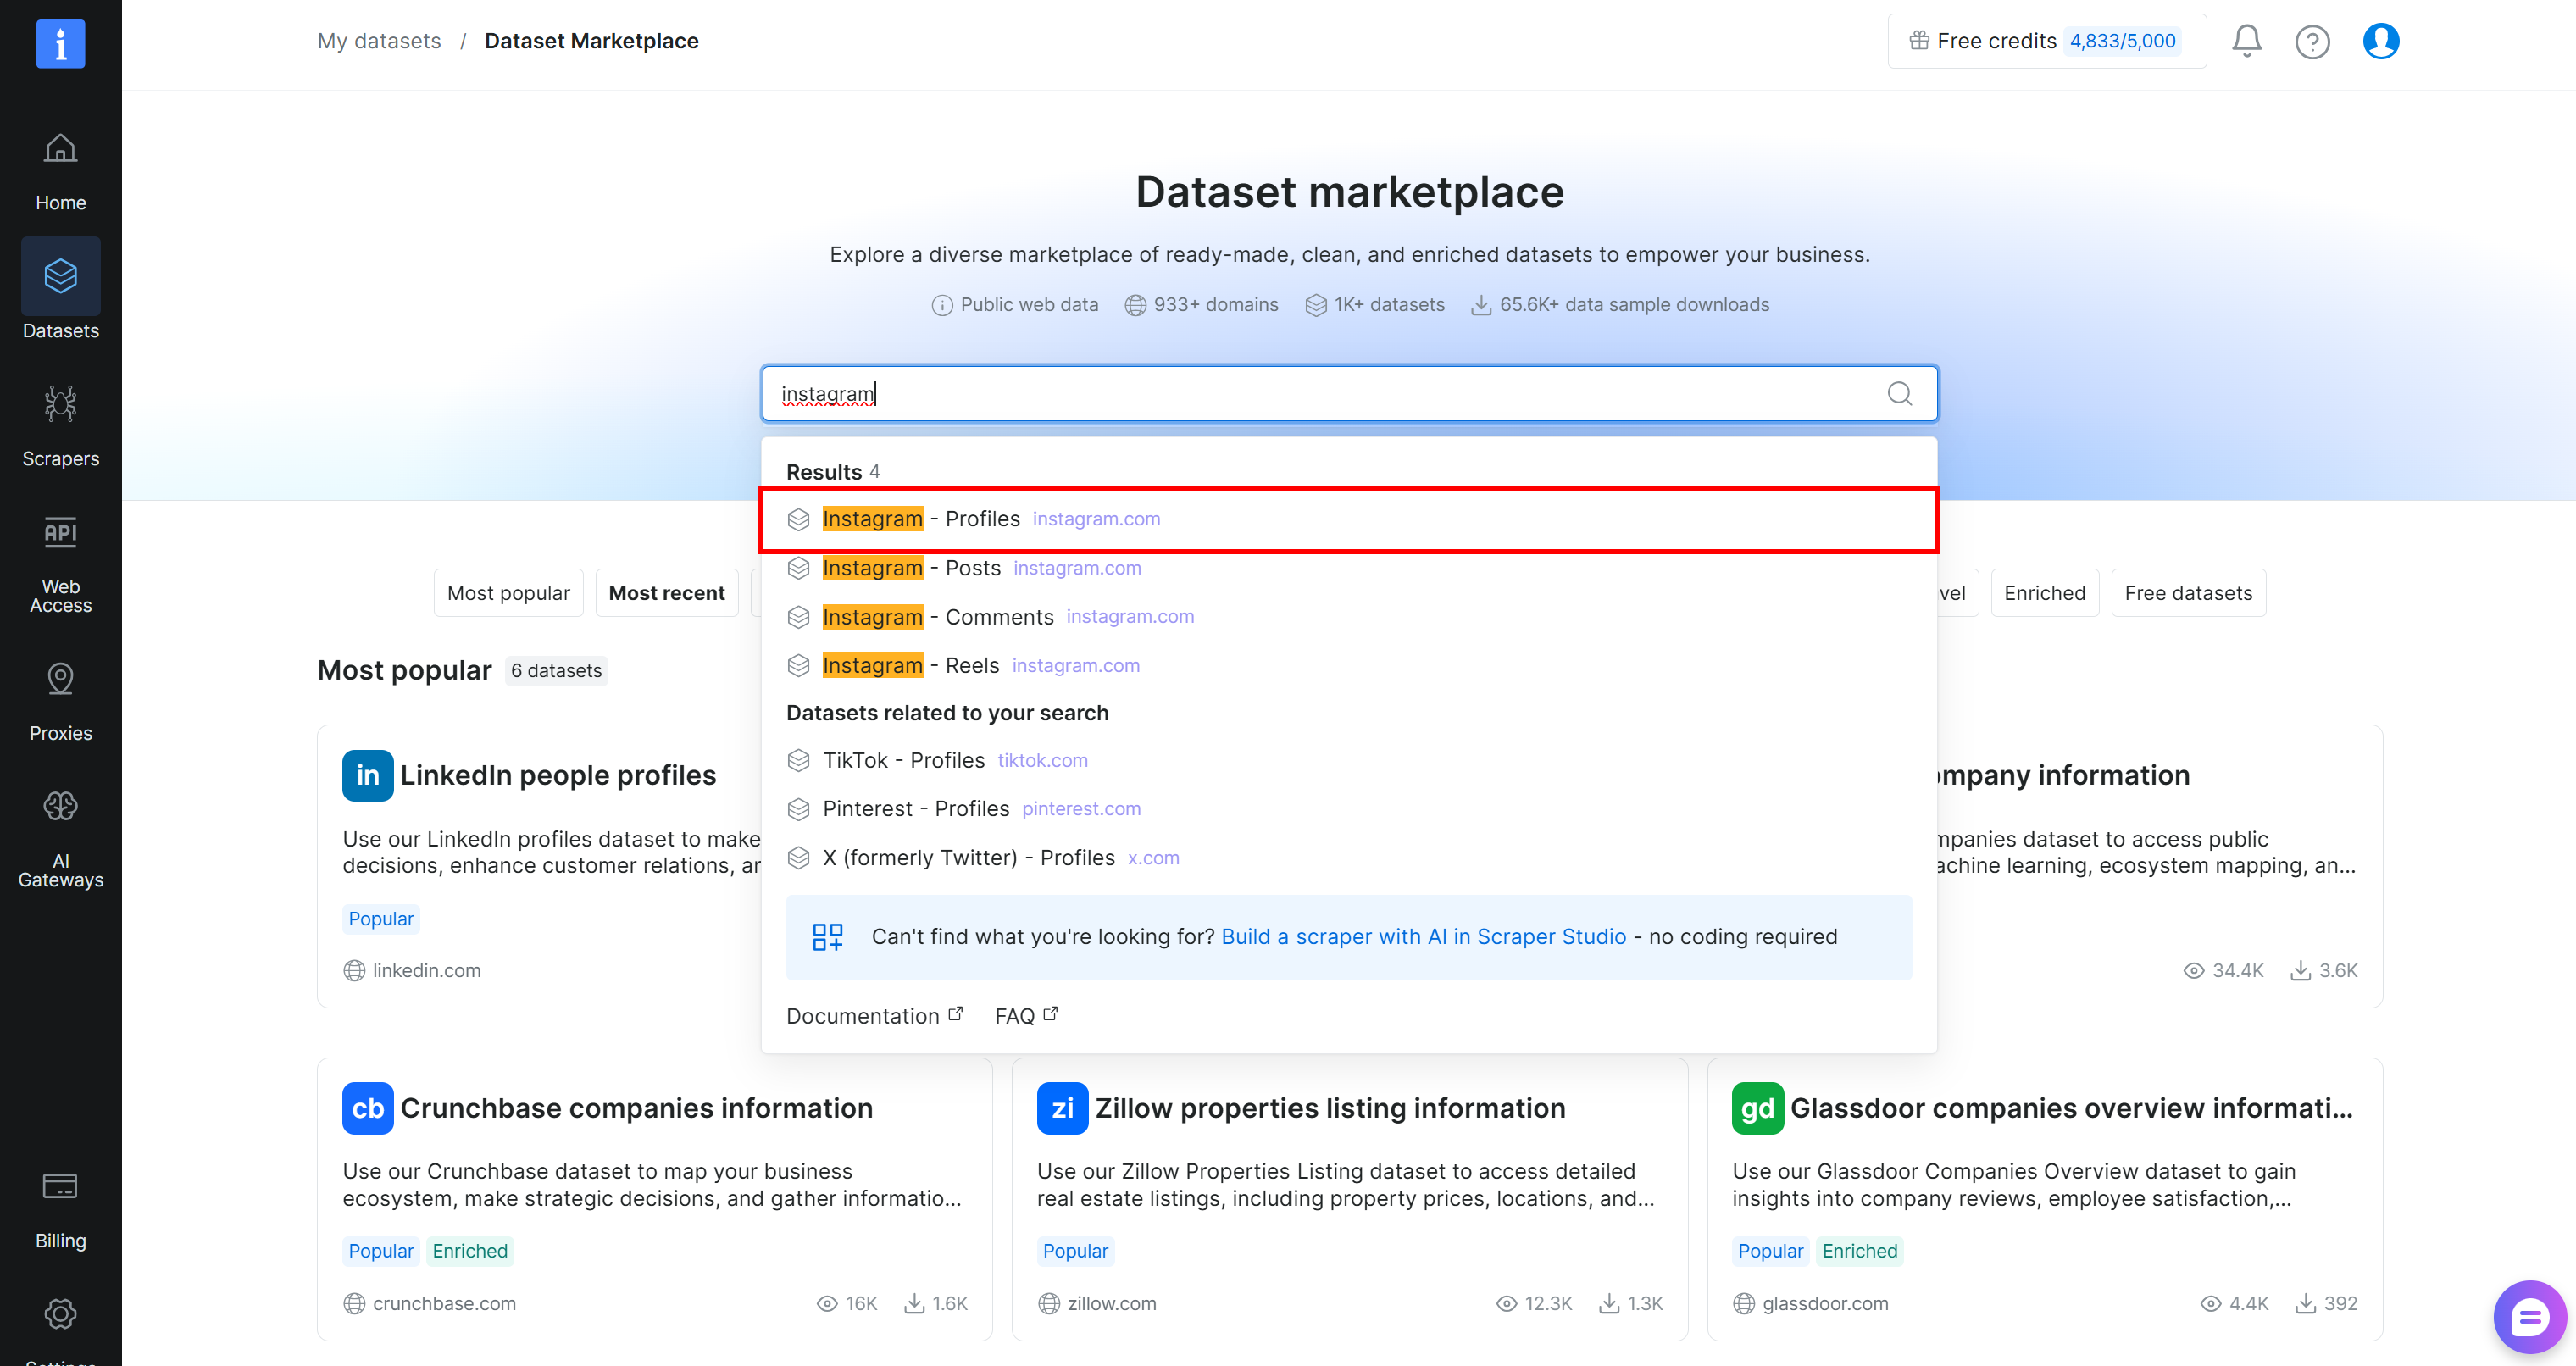
よくできました!そのままデータセットページにリダイレクトされ、購入を進めることができます。
代替アプローチ:Snowflake Marketplaceから直接Bright Dataサービスを入手することもできます:
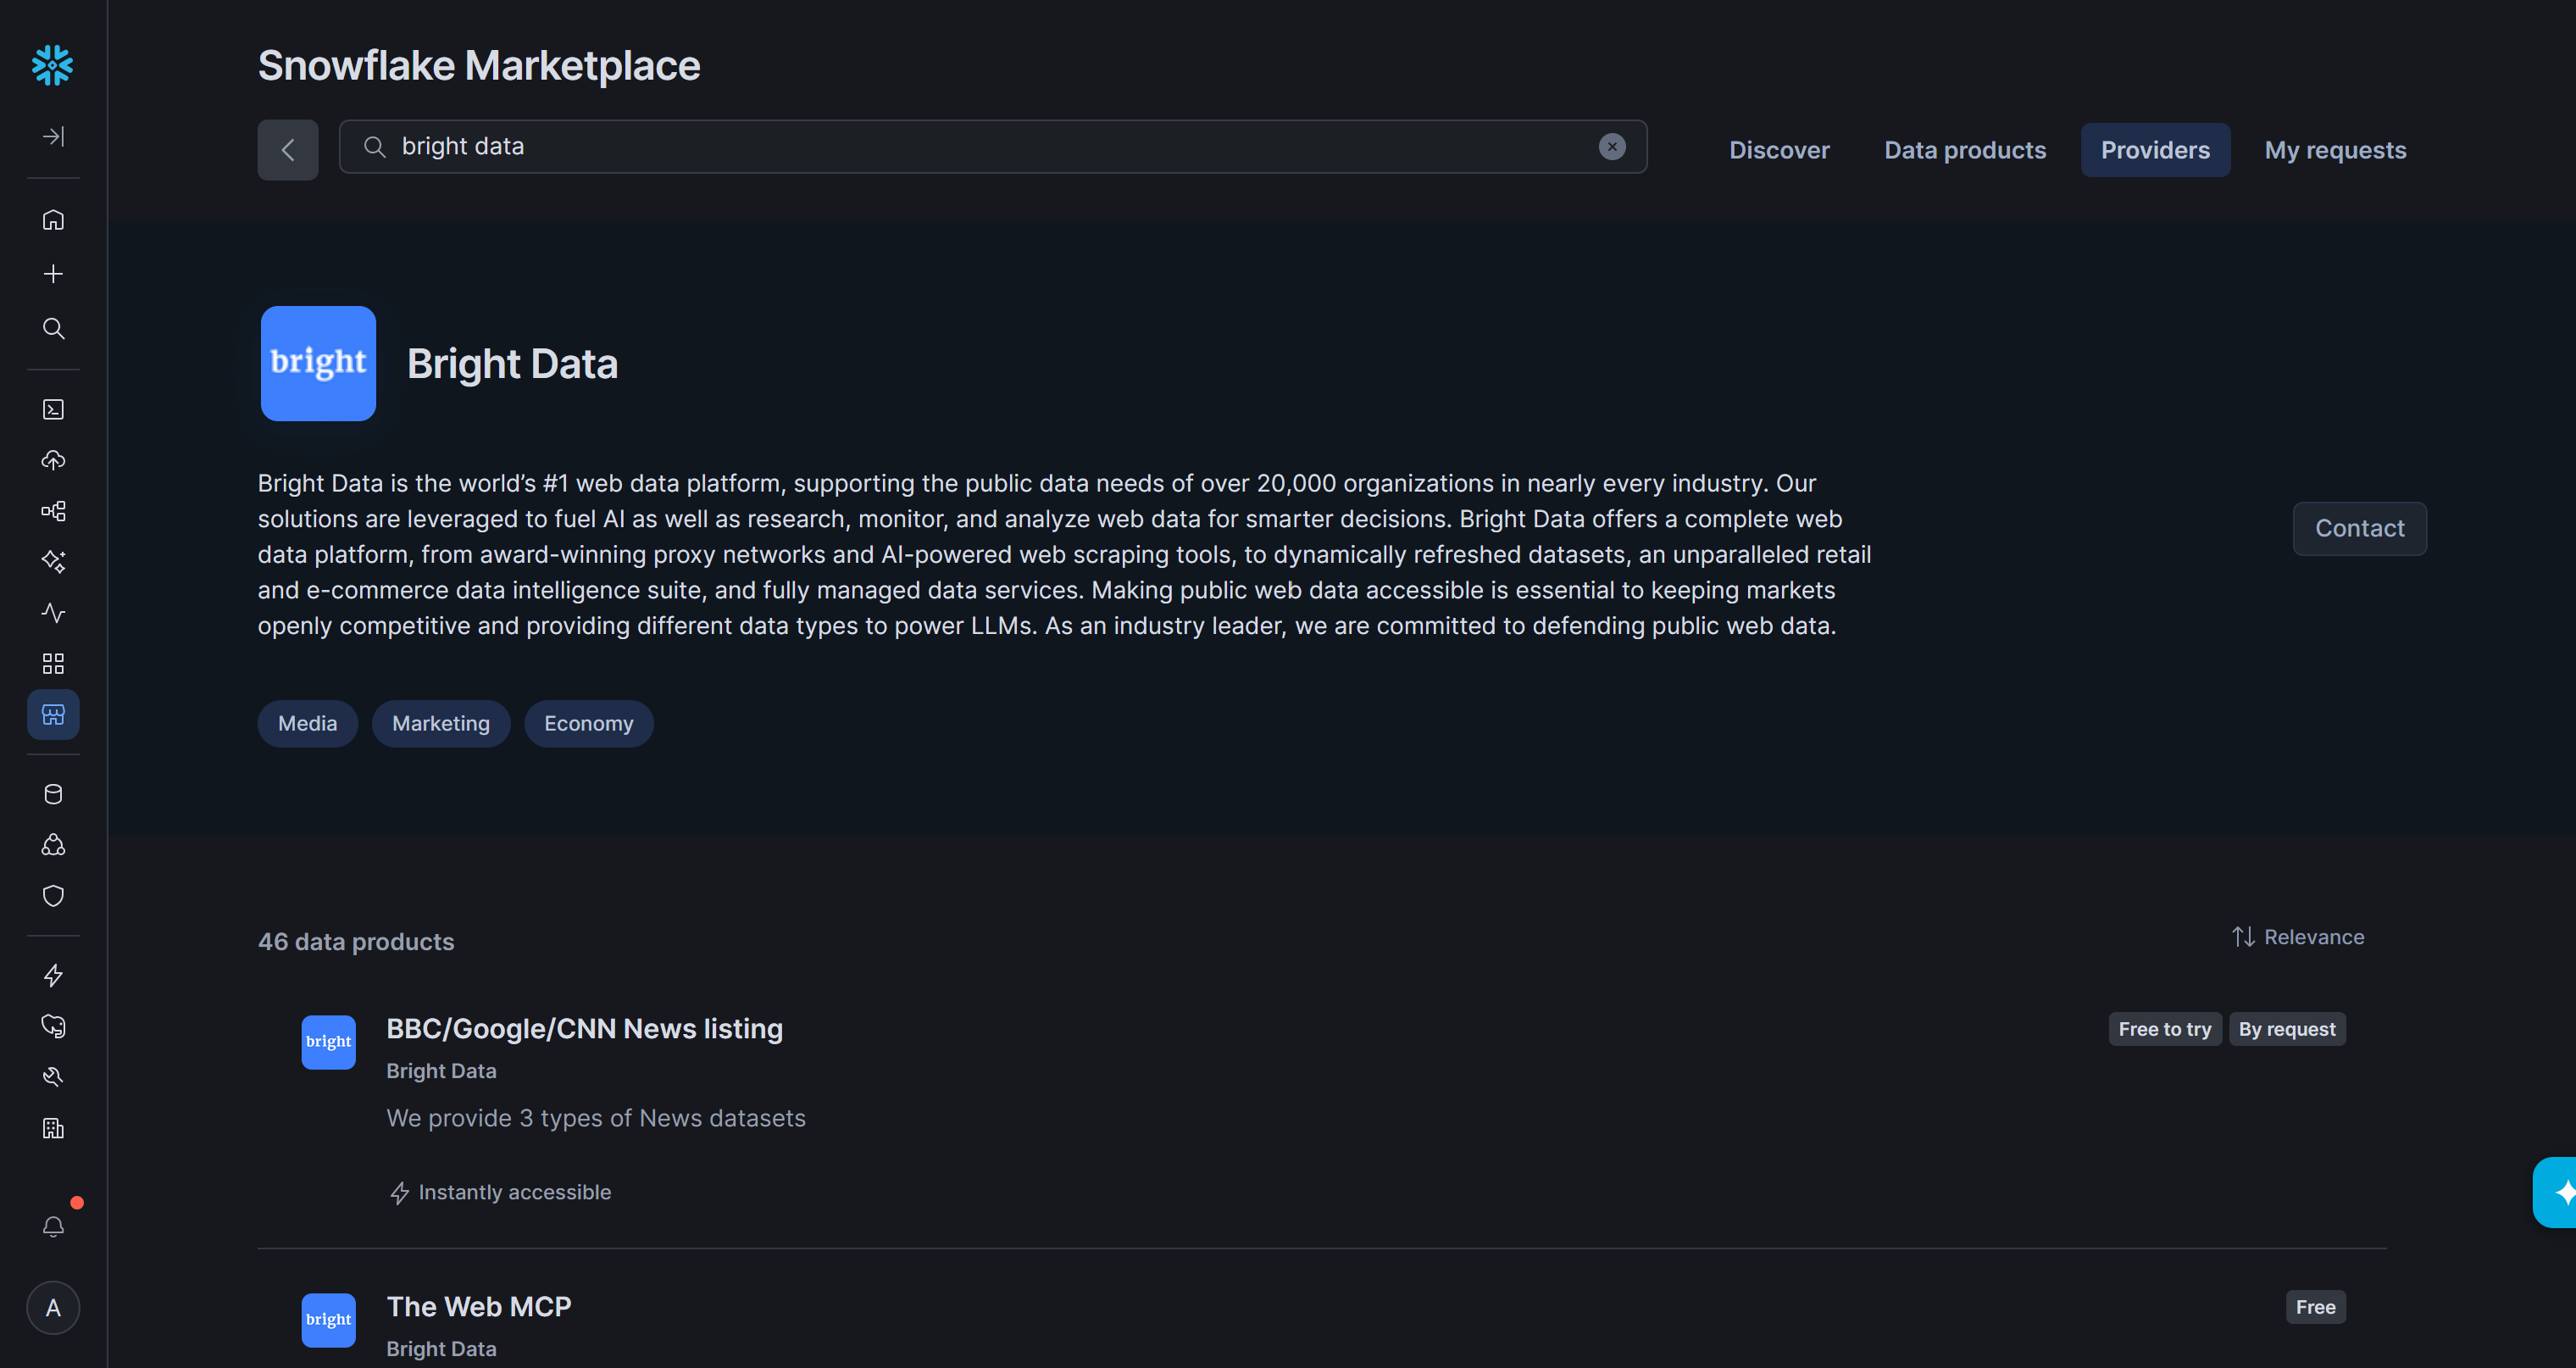
Bright DataはSnowflakeの公式プロバイダー兼パートナーであることを覚えておいてください。
ステップ#2:目的のデータを取得する
Bright Dataの「Instagram – Profiles」データセットには、6億5000万件を超えるレコードが含まれています。しかし、ほとんどの場合、データセット全体のサブセットのみが必要になります。これが、Bright Dataに組み込みのフィルタリングオプションが用意されている理由です。
「Instagram – Profiles」データセットページで、左側の「Filters」をクリックします:
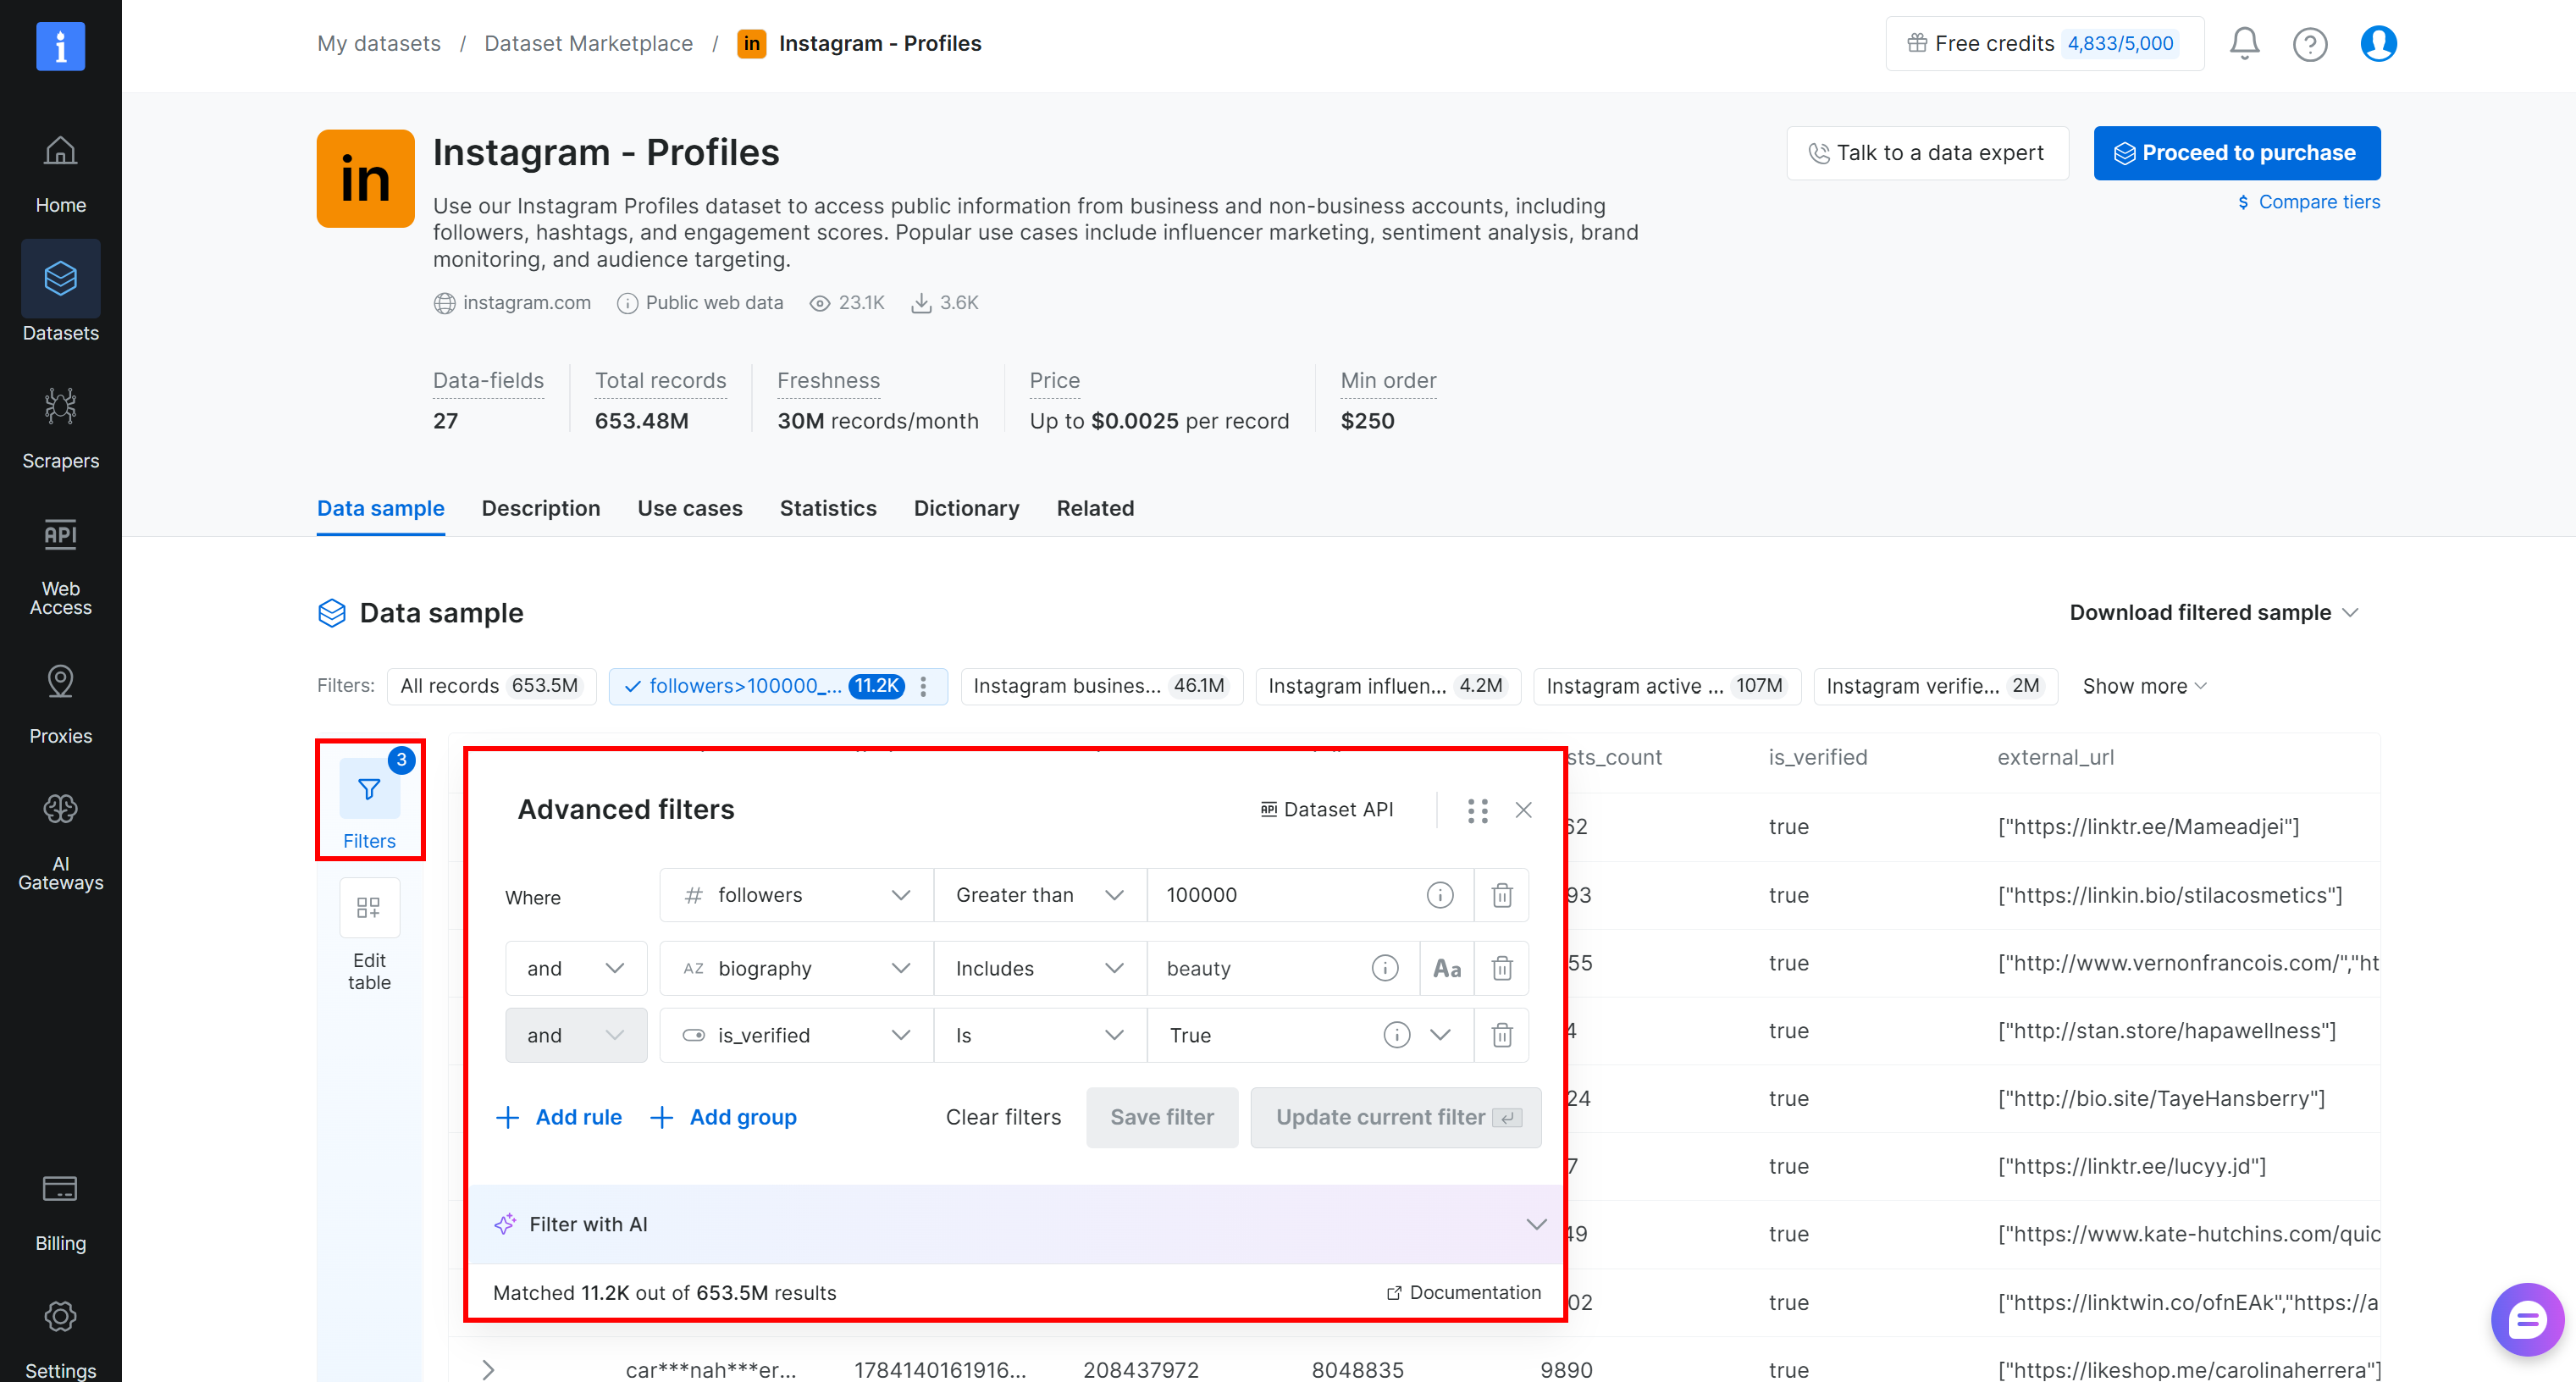
ここで、以下の条件を満たすInstagramプロフィールが欲しいとします:
- フォロワー数が10万人以上。
- 自己紹介に「beauty」という単語を含む。
- 認証済みである。
このフィルタリングステップは、データ効率の観点からも重要です。6億5350万件のデータセット全体をSnowflakeに移動する代わりに、まず必要なレコードに絞り込むことができます。ここでは、Bright Dataのフィルタリングによりデータセットが約11.2千件のプロフィールに削減され、ストレージオーバーヘッドの回避に役立ちます。
フィルターを適用します。Bright Dataのコントロールパネルでフィルタリングされたプロフィールを直接確認したり、最大1,000件のサンプル(一部のフィールドは伏せられています)をダウンロードしたりすることもできます。
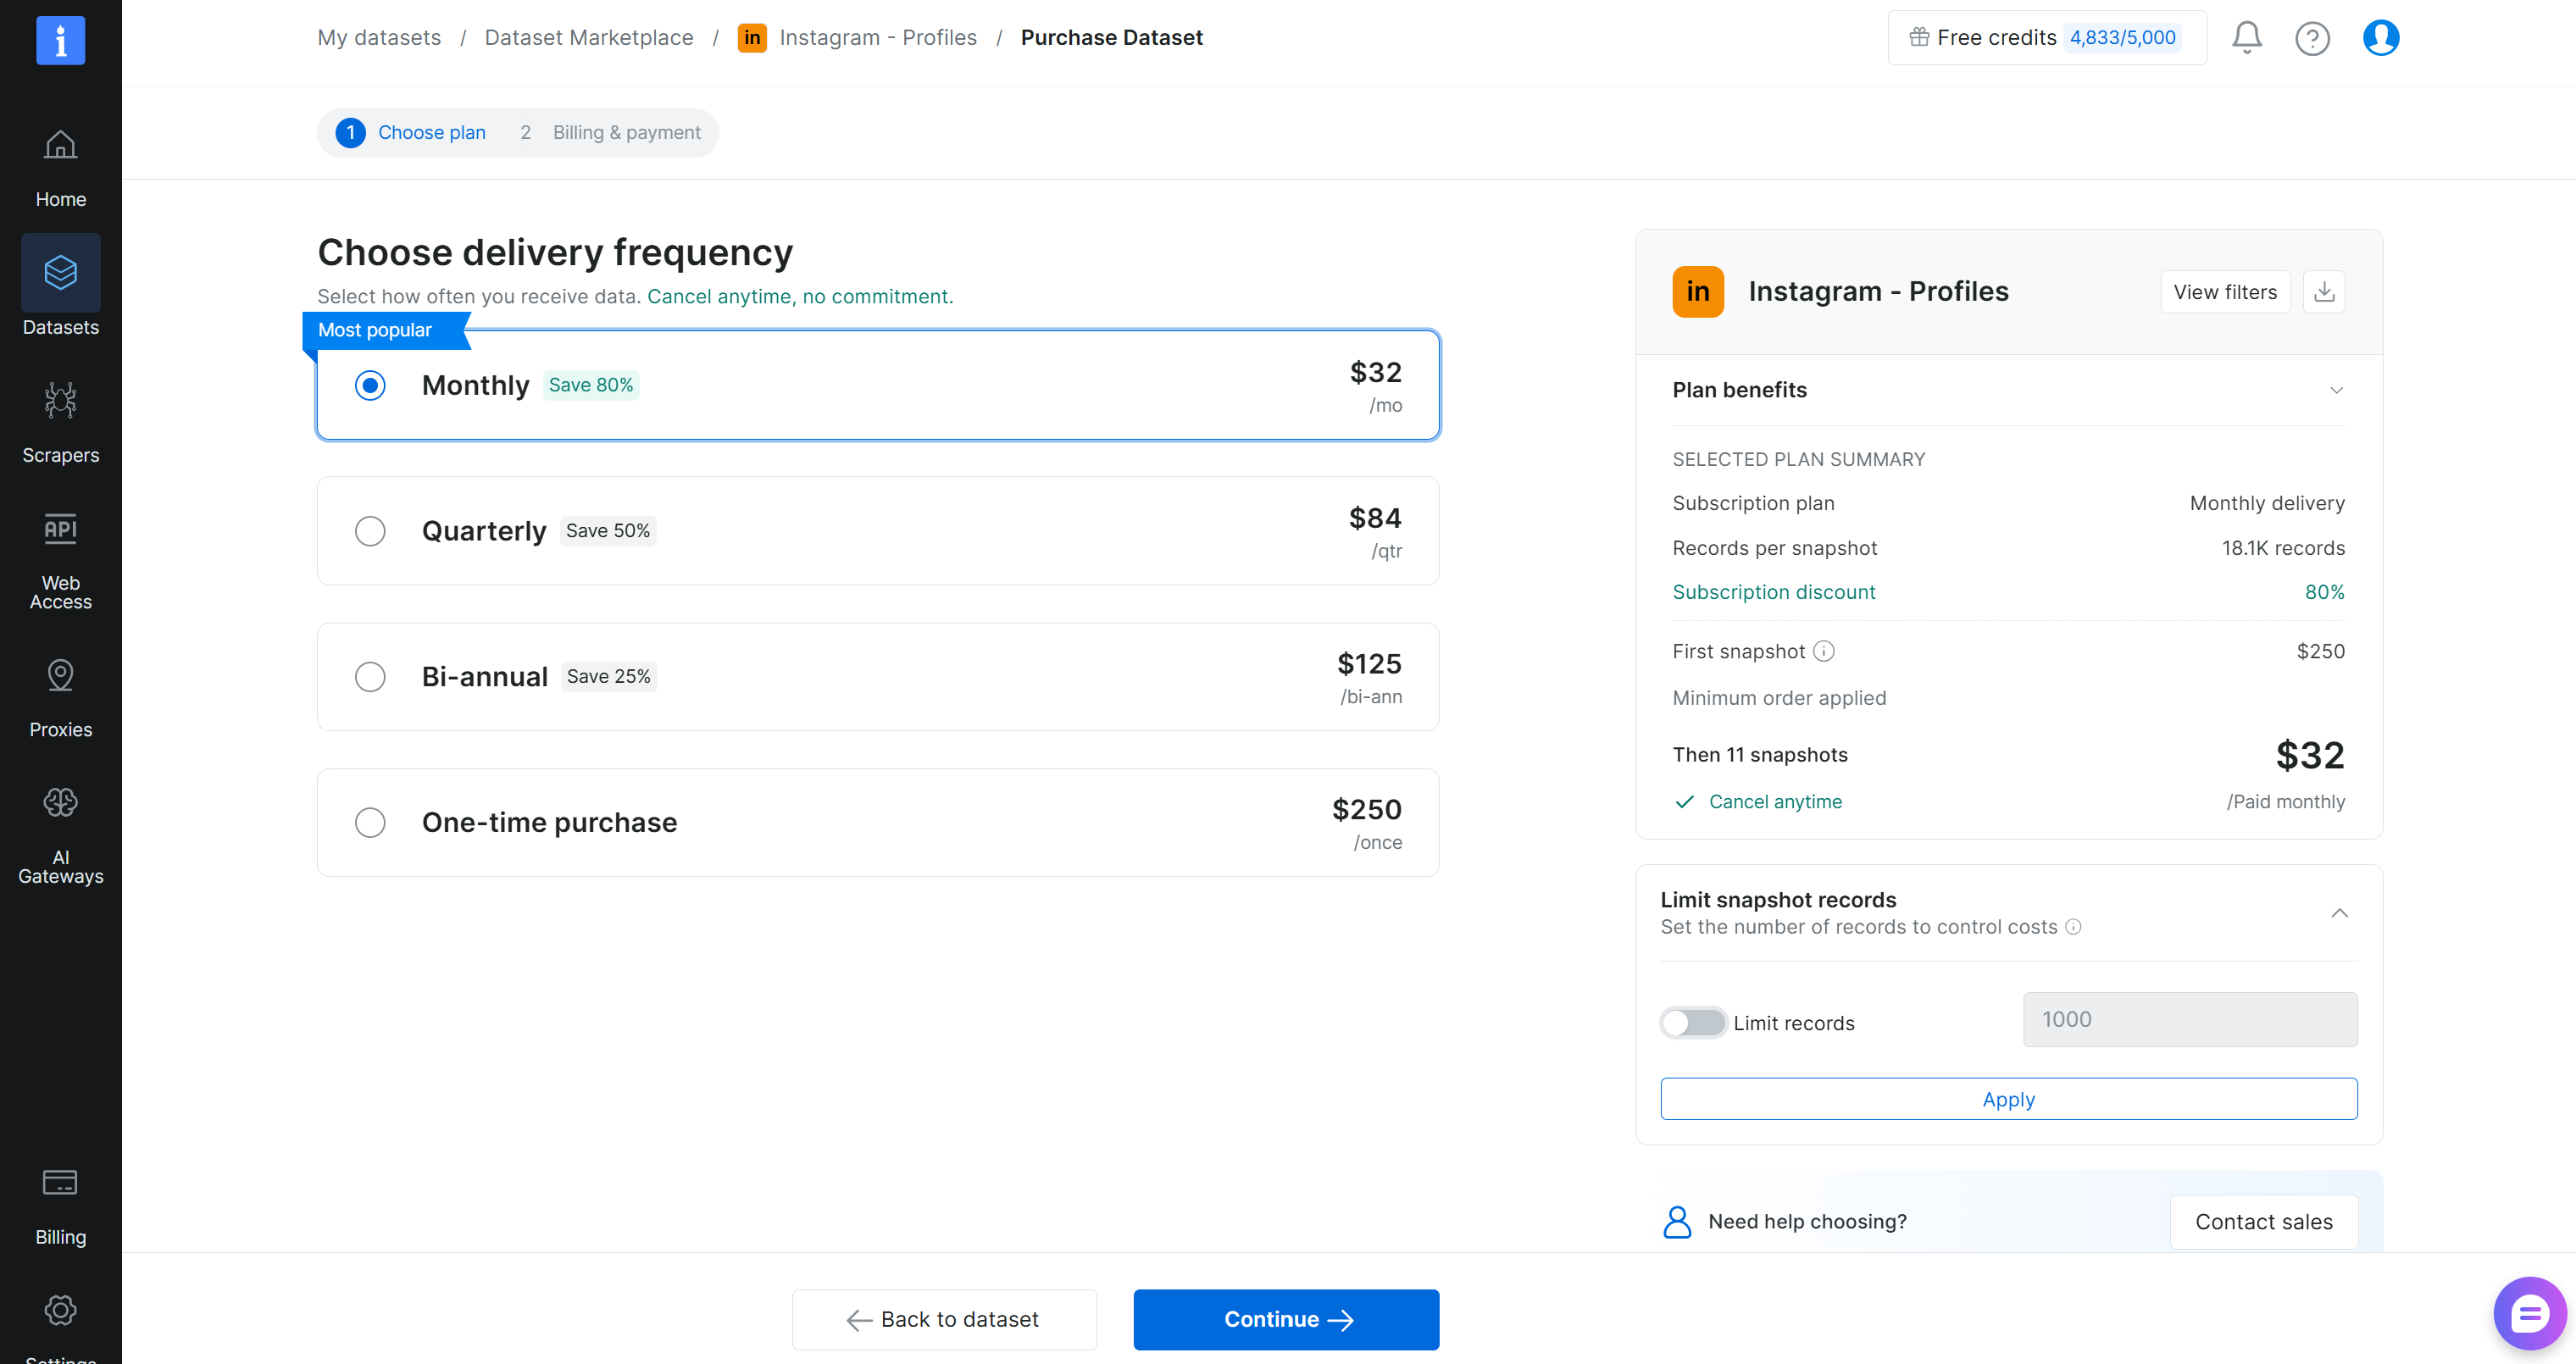
フィルターと結果に満足したら、「Proceed to purchase」をクリックし、配信頻度を選択します。選択したデータの一括購入か、定期的な更新(月次、四半期ごと、または半年ごと)のどちらかを選べます:
支払いプロセスを完了し、データセットの準備を待ちます。データセットのスナップショットの準備ができ次第、リンク付きのメールが届きます:
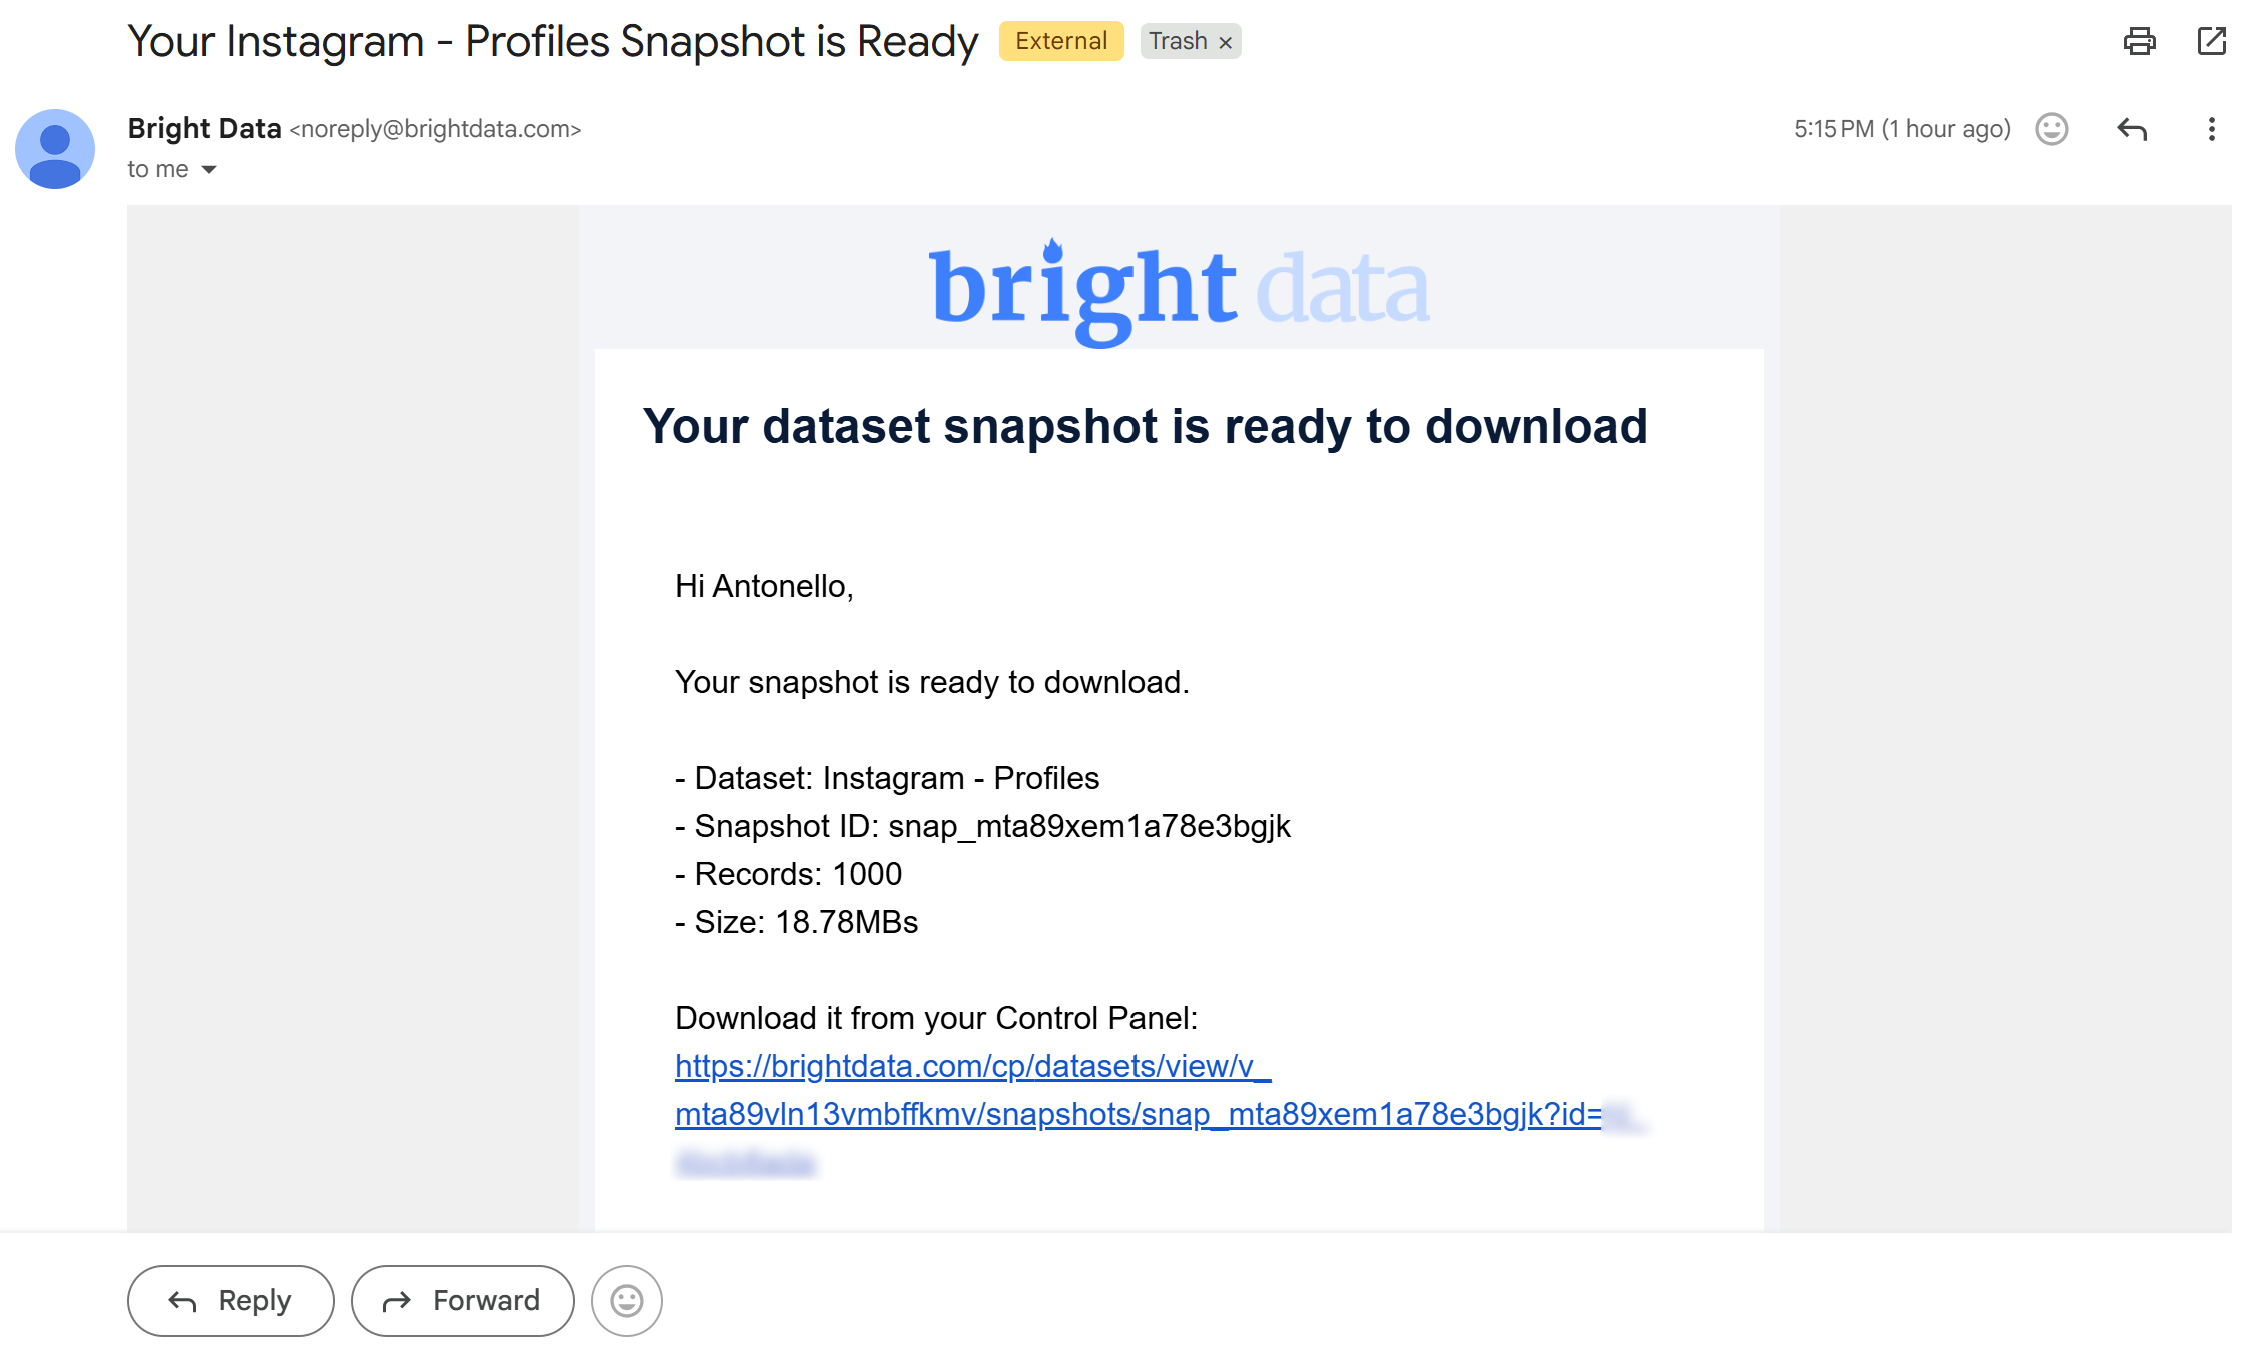
メール内のURLをクリックして、スナップショットページを開きます:
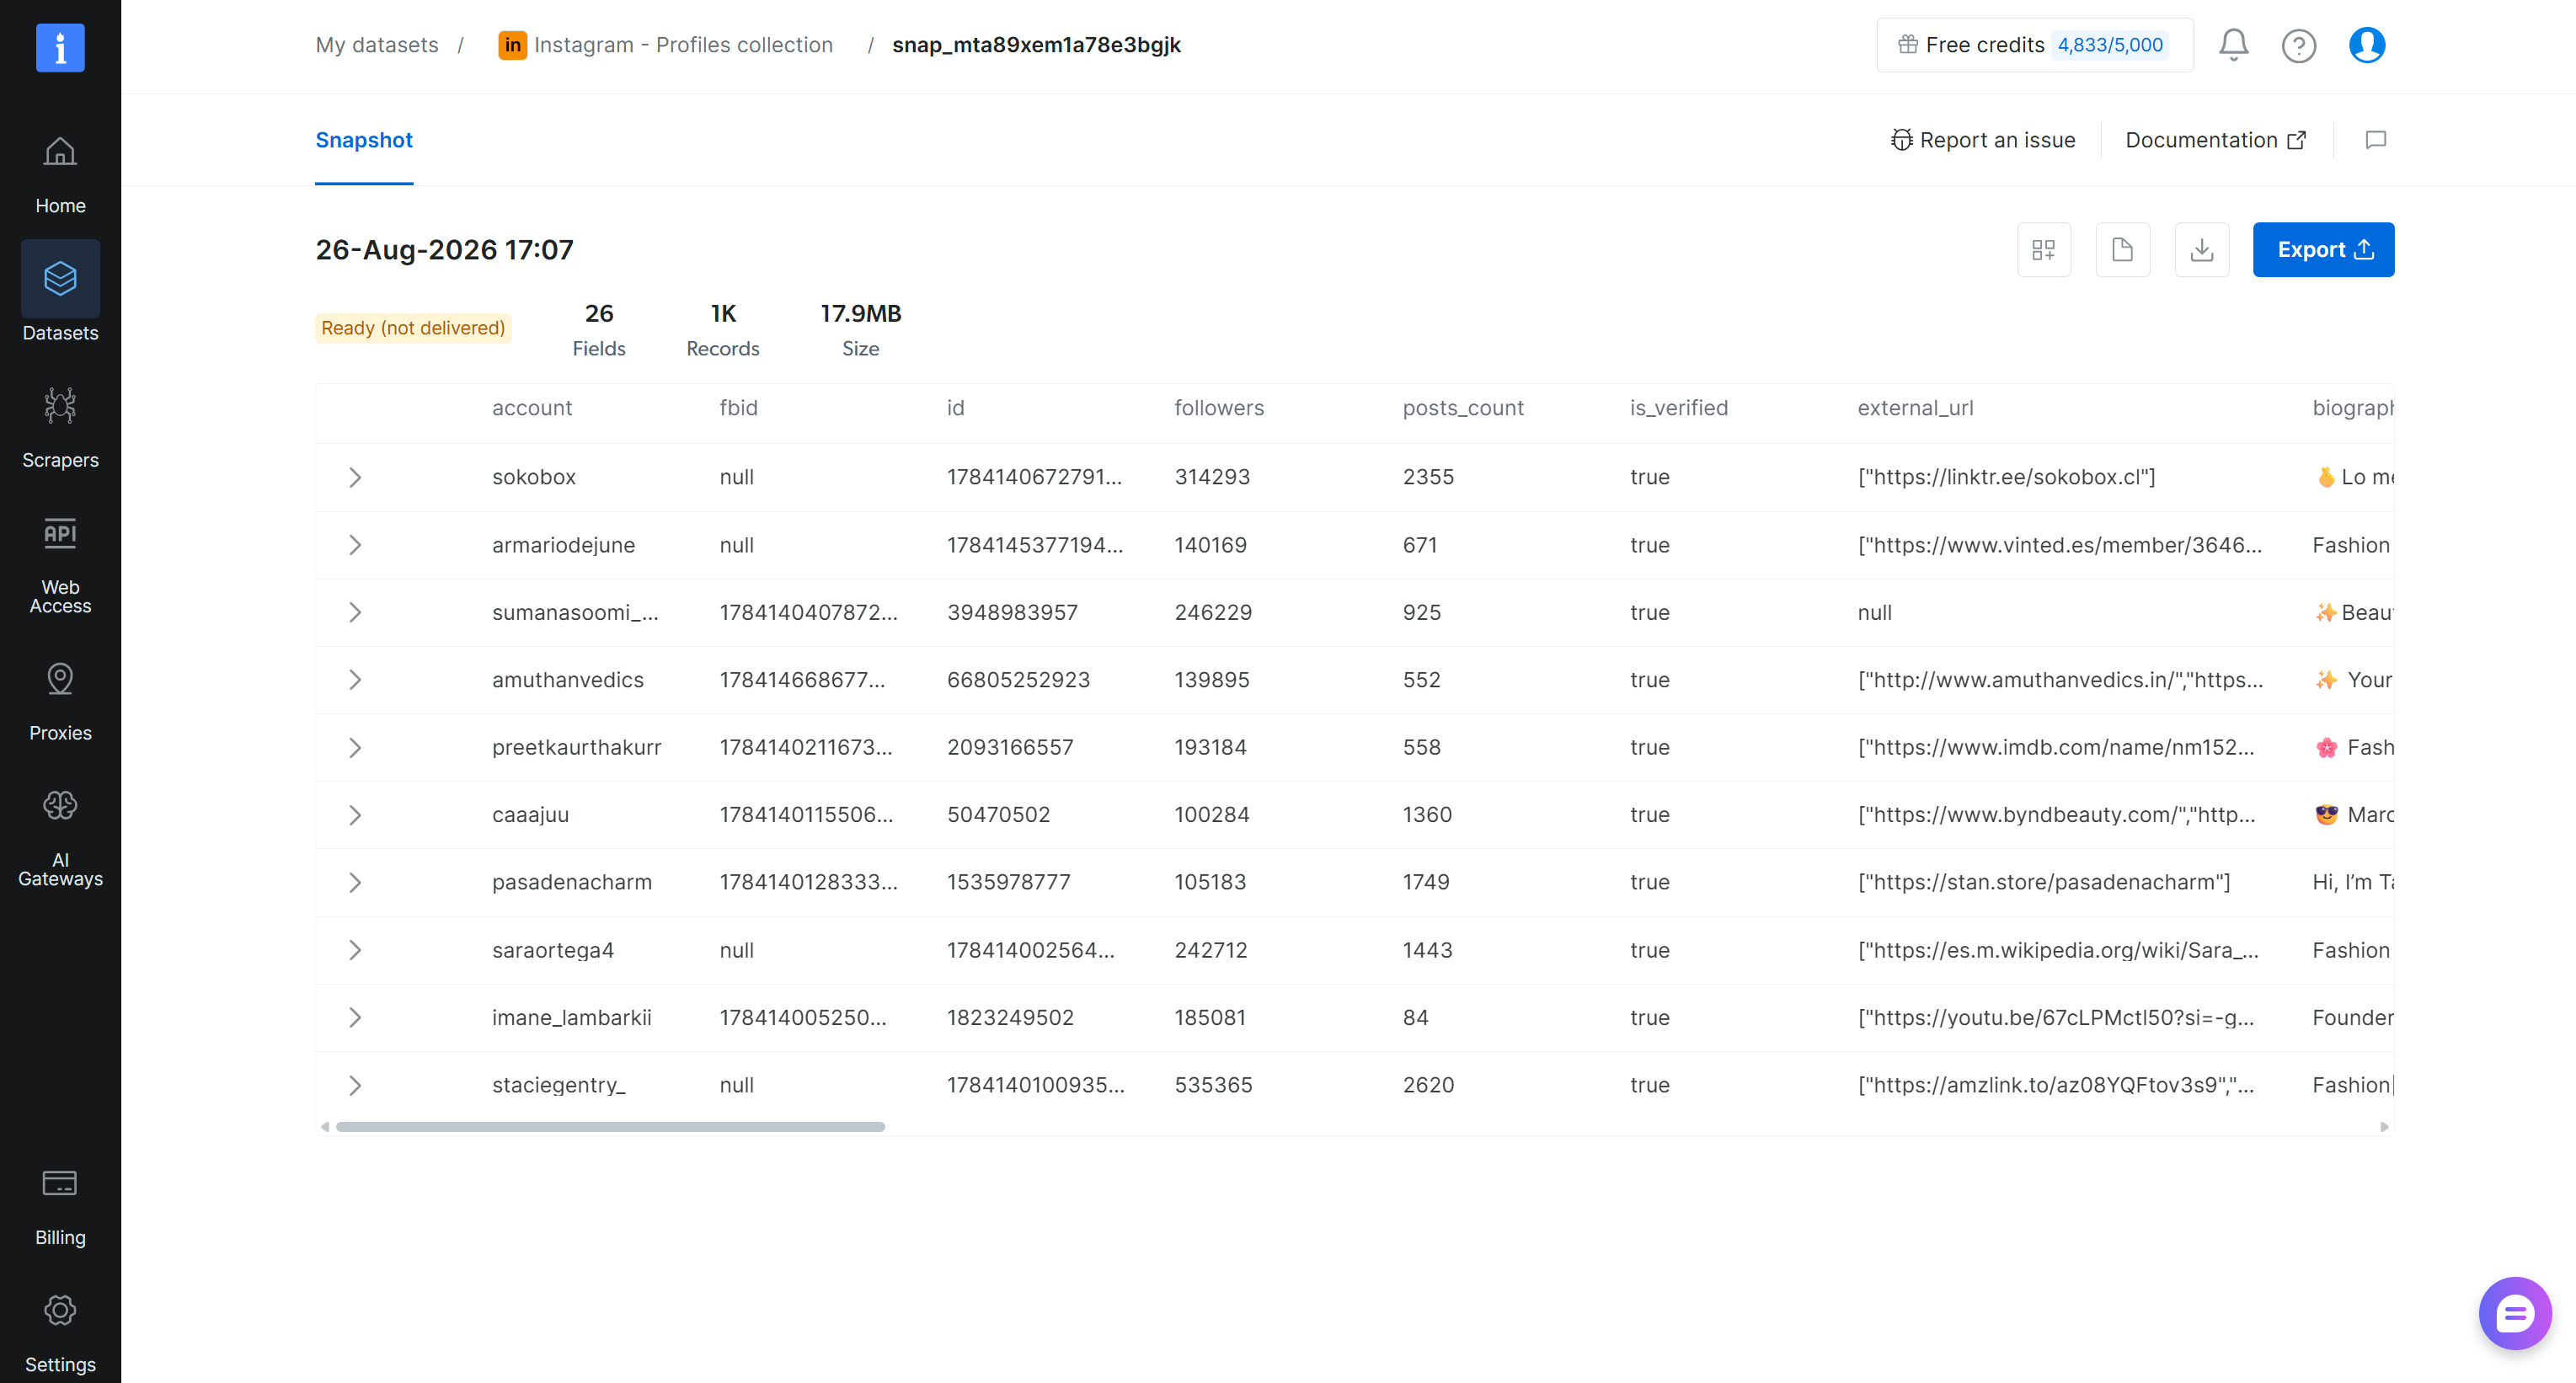
ここでは、データの一部をプレビューしたり、コストやレコード数などの詳細を含むレポートを確認したりできます。最も重要なのは、データセットをダウンロードするか、他のサポートされている宛先とともにSnowflakeに直接エクスポートできることです。
注:この例では、簡略化のため購入したレコード数を1,000件に制限しています。そのため、レコード数は11.2千件ではなく1,000件に設定されています。
ステップ#3:Bright Dataのウェブデータをスノーフレークに送信する
フィルタリングされたデータセットをSnowflakeに送信するには、まずデータセットのスナップショットページで「Export」ボタンをクリックします:
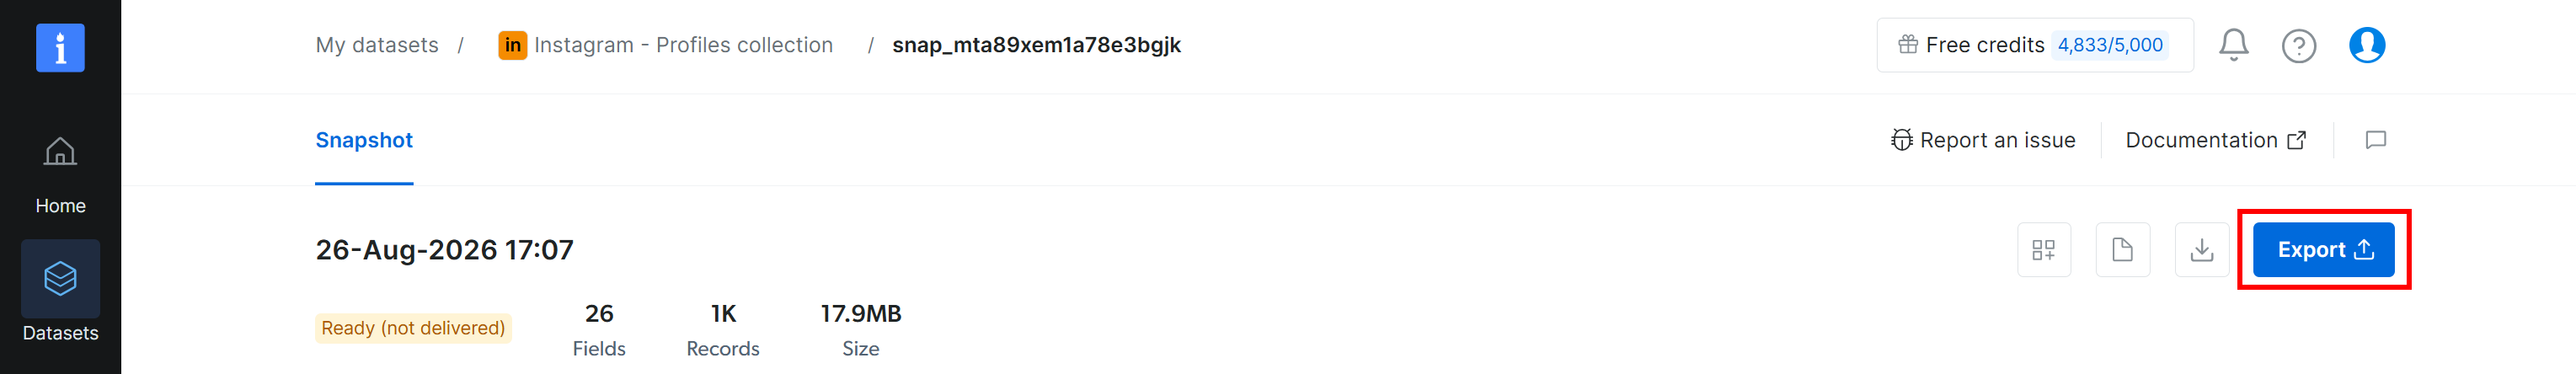
「Snowflake」を選択し、データ配信を設定するために必要なフィールドを入力します:
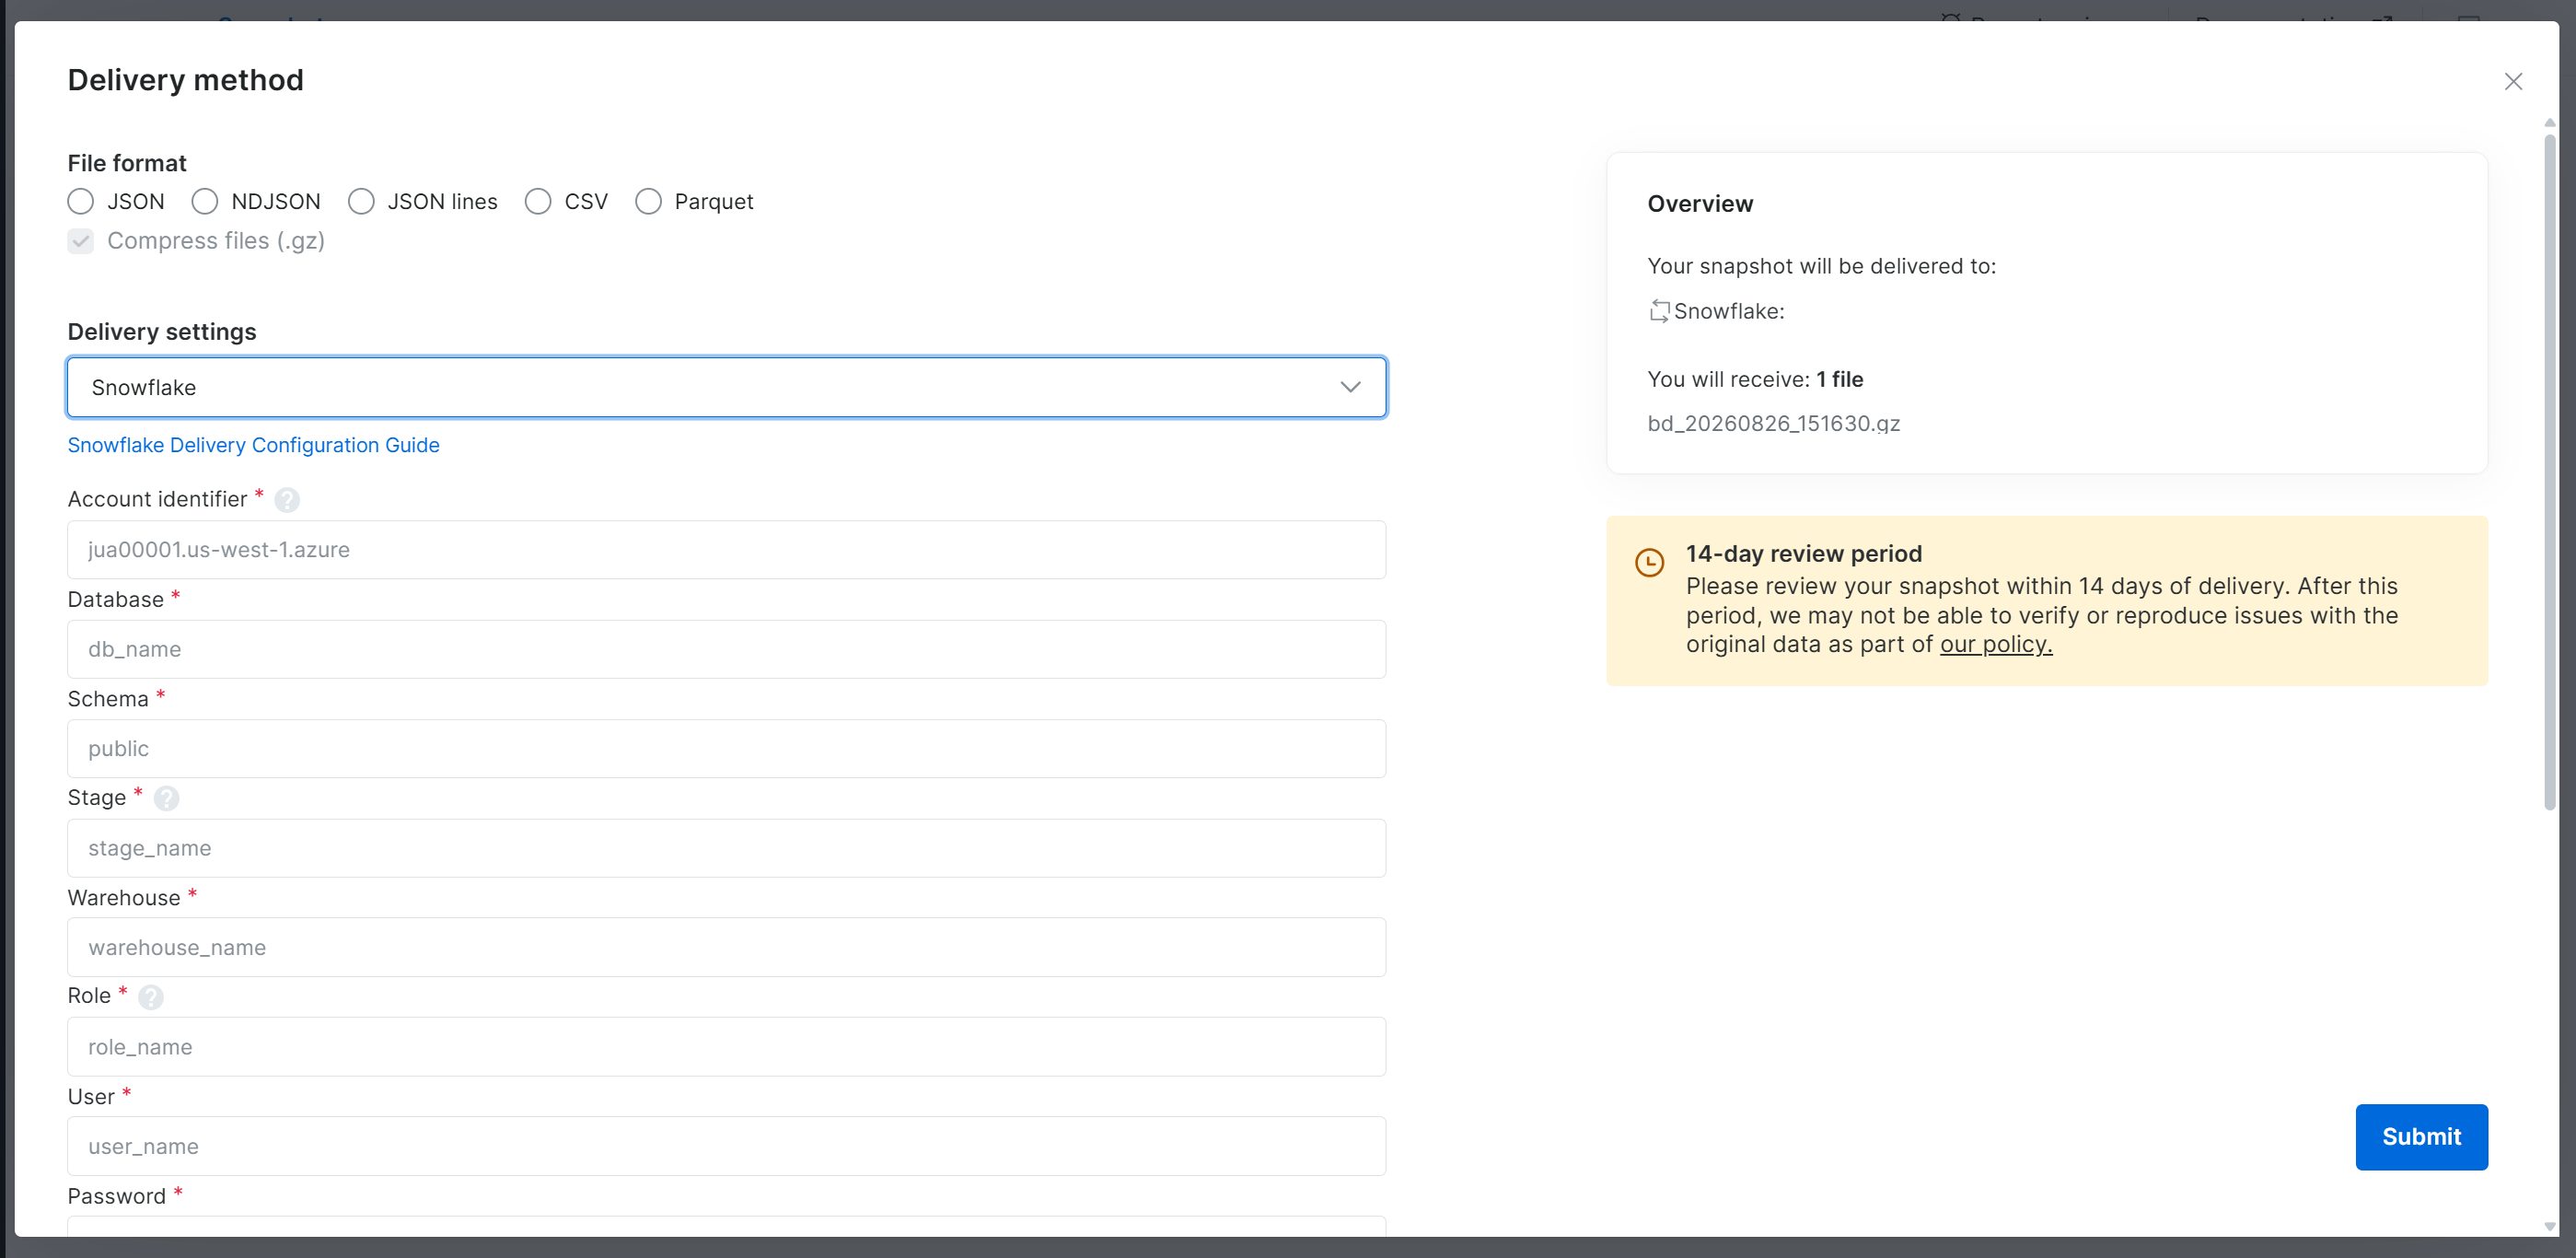
これらの設定に不慣れな場合は、Bright DataデータセットをSnowflakeに取り込む方法に関する完全なガイドをご参照ください。Bright Dataデータセット配信のためのSnowflake設定に関するすべての手順と、必須フィールドの入力ガイダンスが記載されています。
この例では、SNOWFLAKE_INTELLIGENCE.PUBLIC.INSTAGRAM_PROFILESテーブルにデータをインポートするように配信を設定したと仮定します。取り込みが完了すると、Snowflakeで直接インポートされたデータを確認できます:
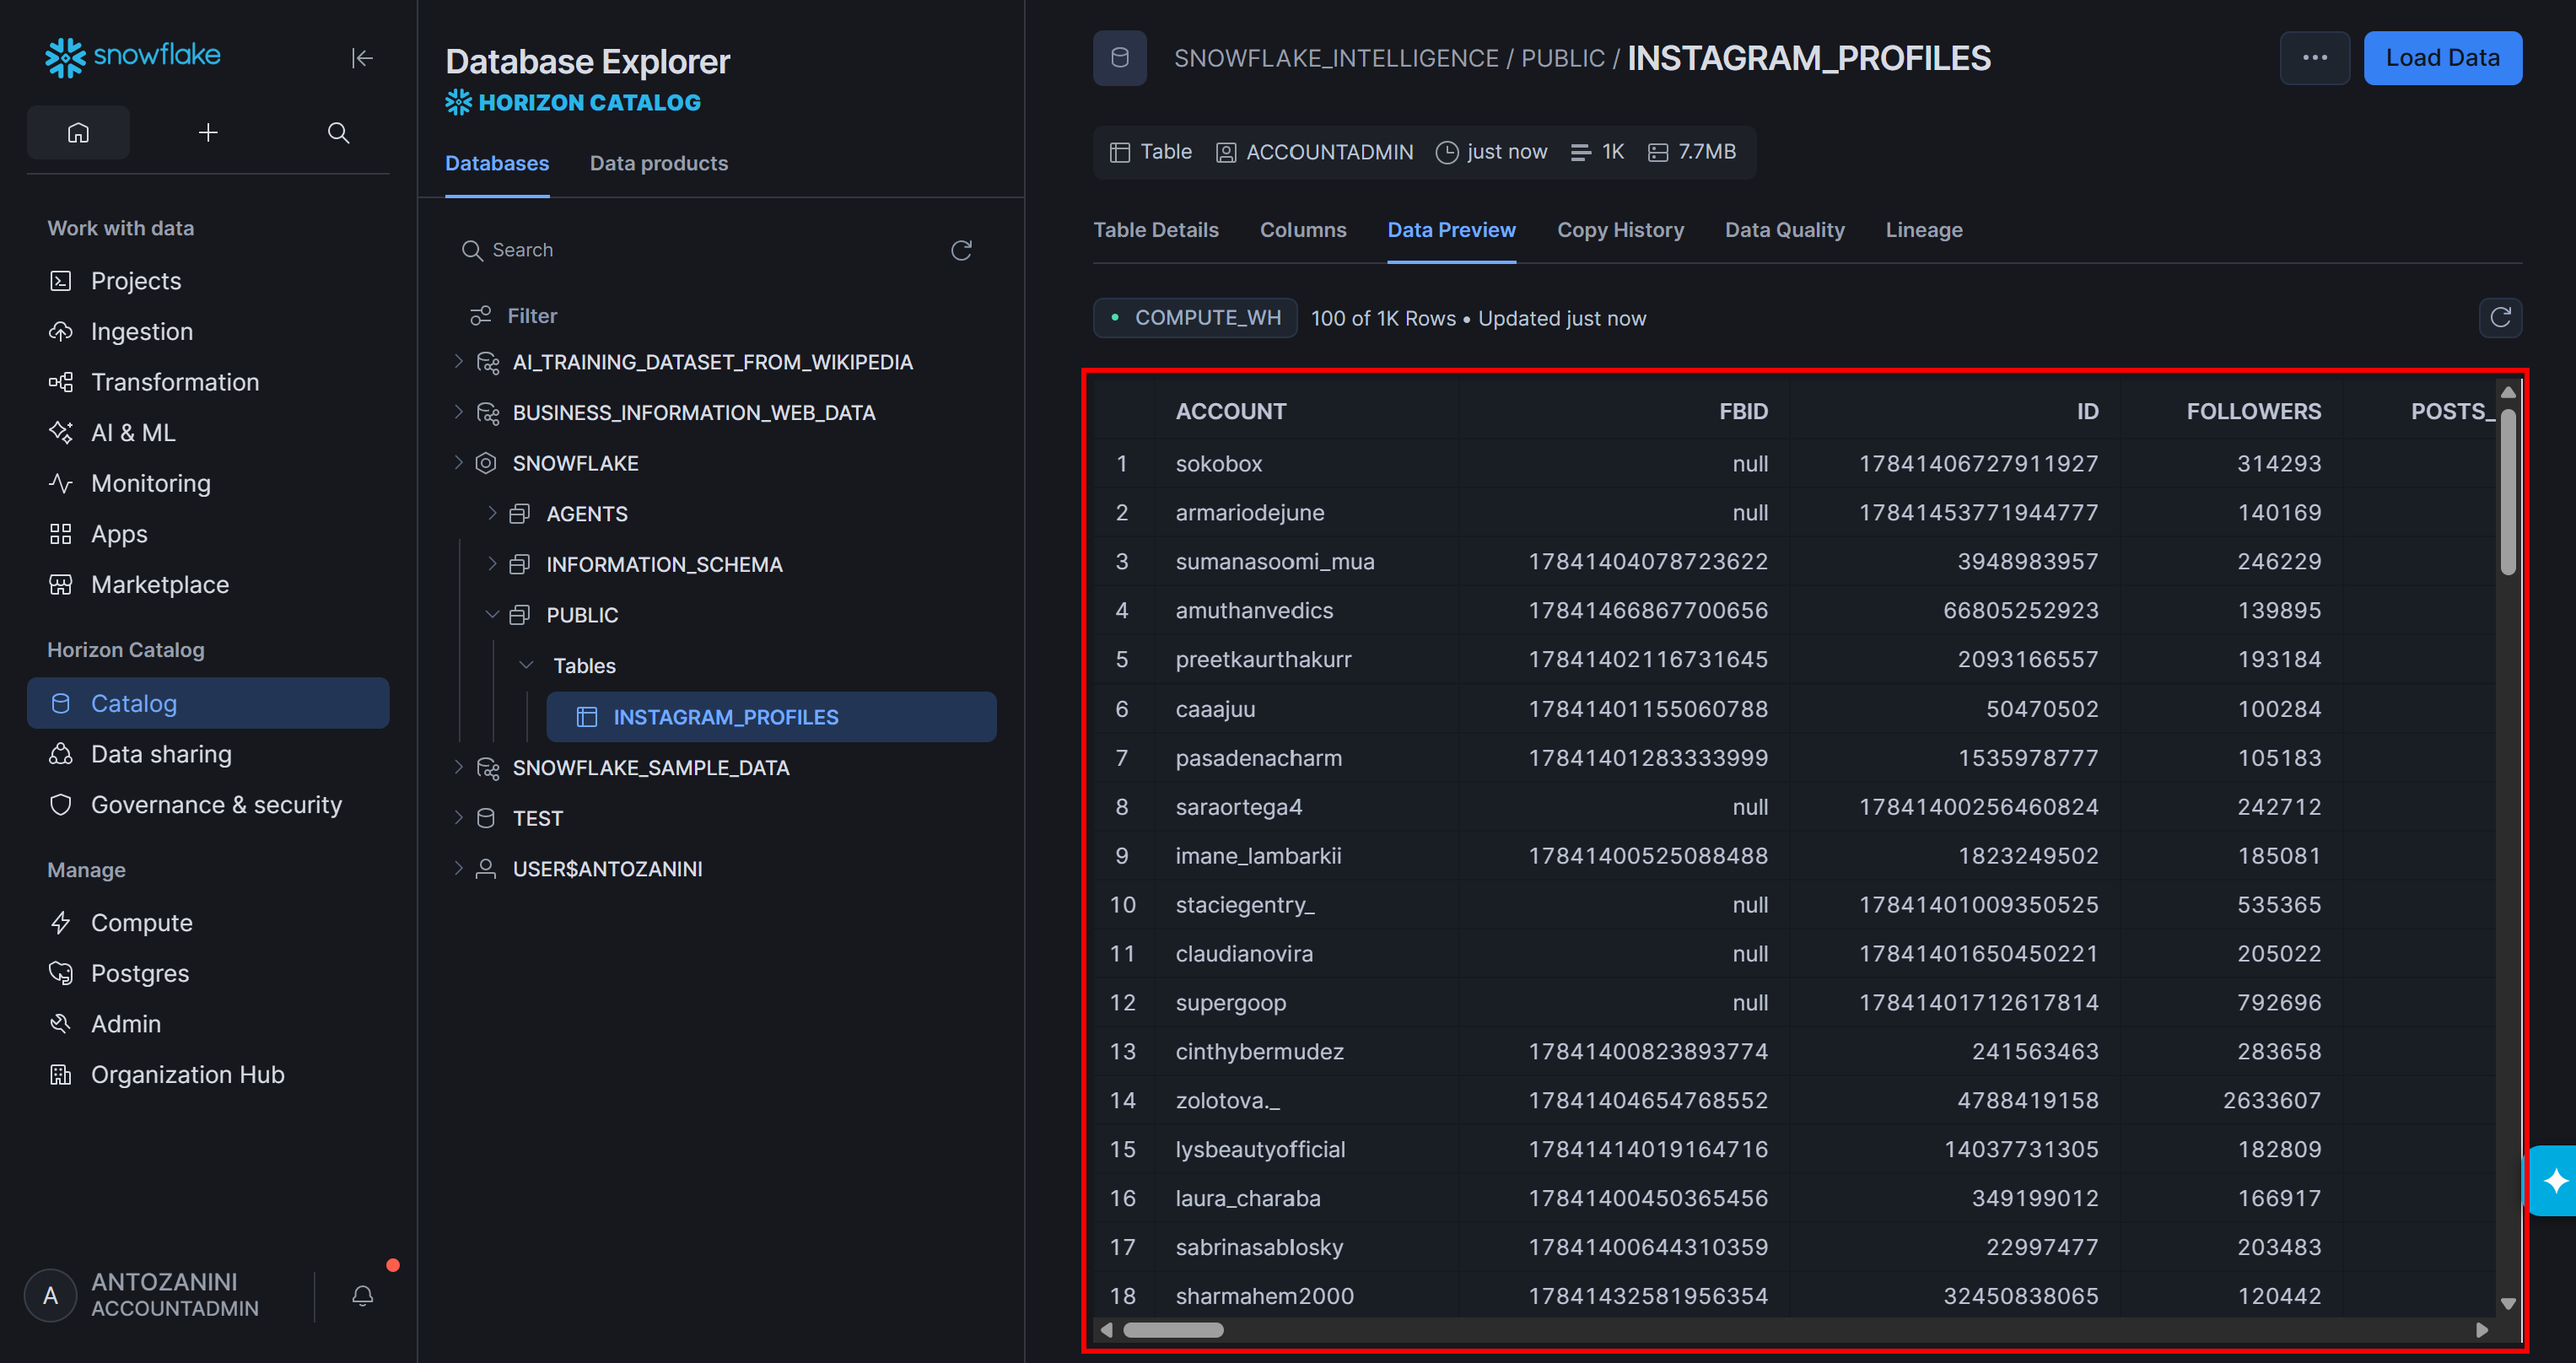
テーブルに、Bright Dataデータセットから選択したのと同じフィルタリングされたInstagramプロフィールデータが含まれていることに注目してください。このデータはビジネスデータと並んでSnowflake上で利用可能になり、Cortex AIエージェントが両方のソースを一緒に分析できるようになります。
ステップ#4:Cortex Agentを作成する
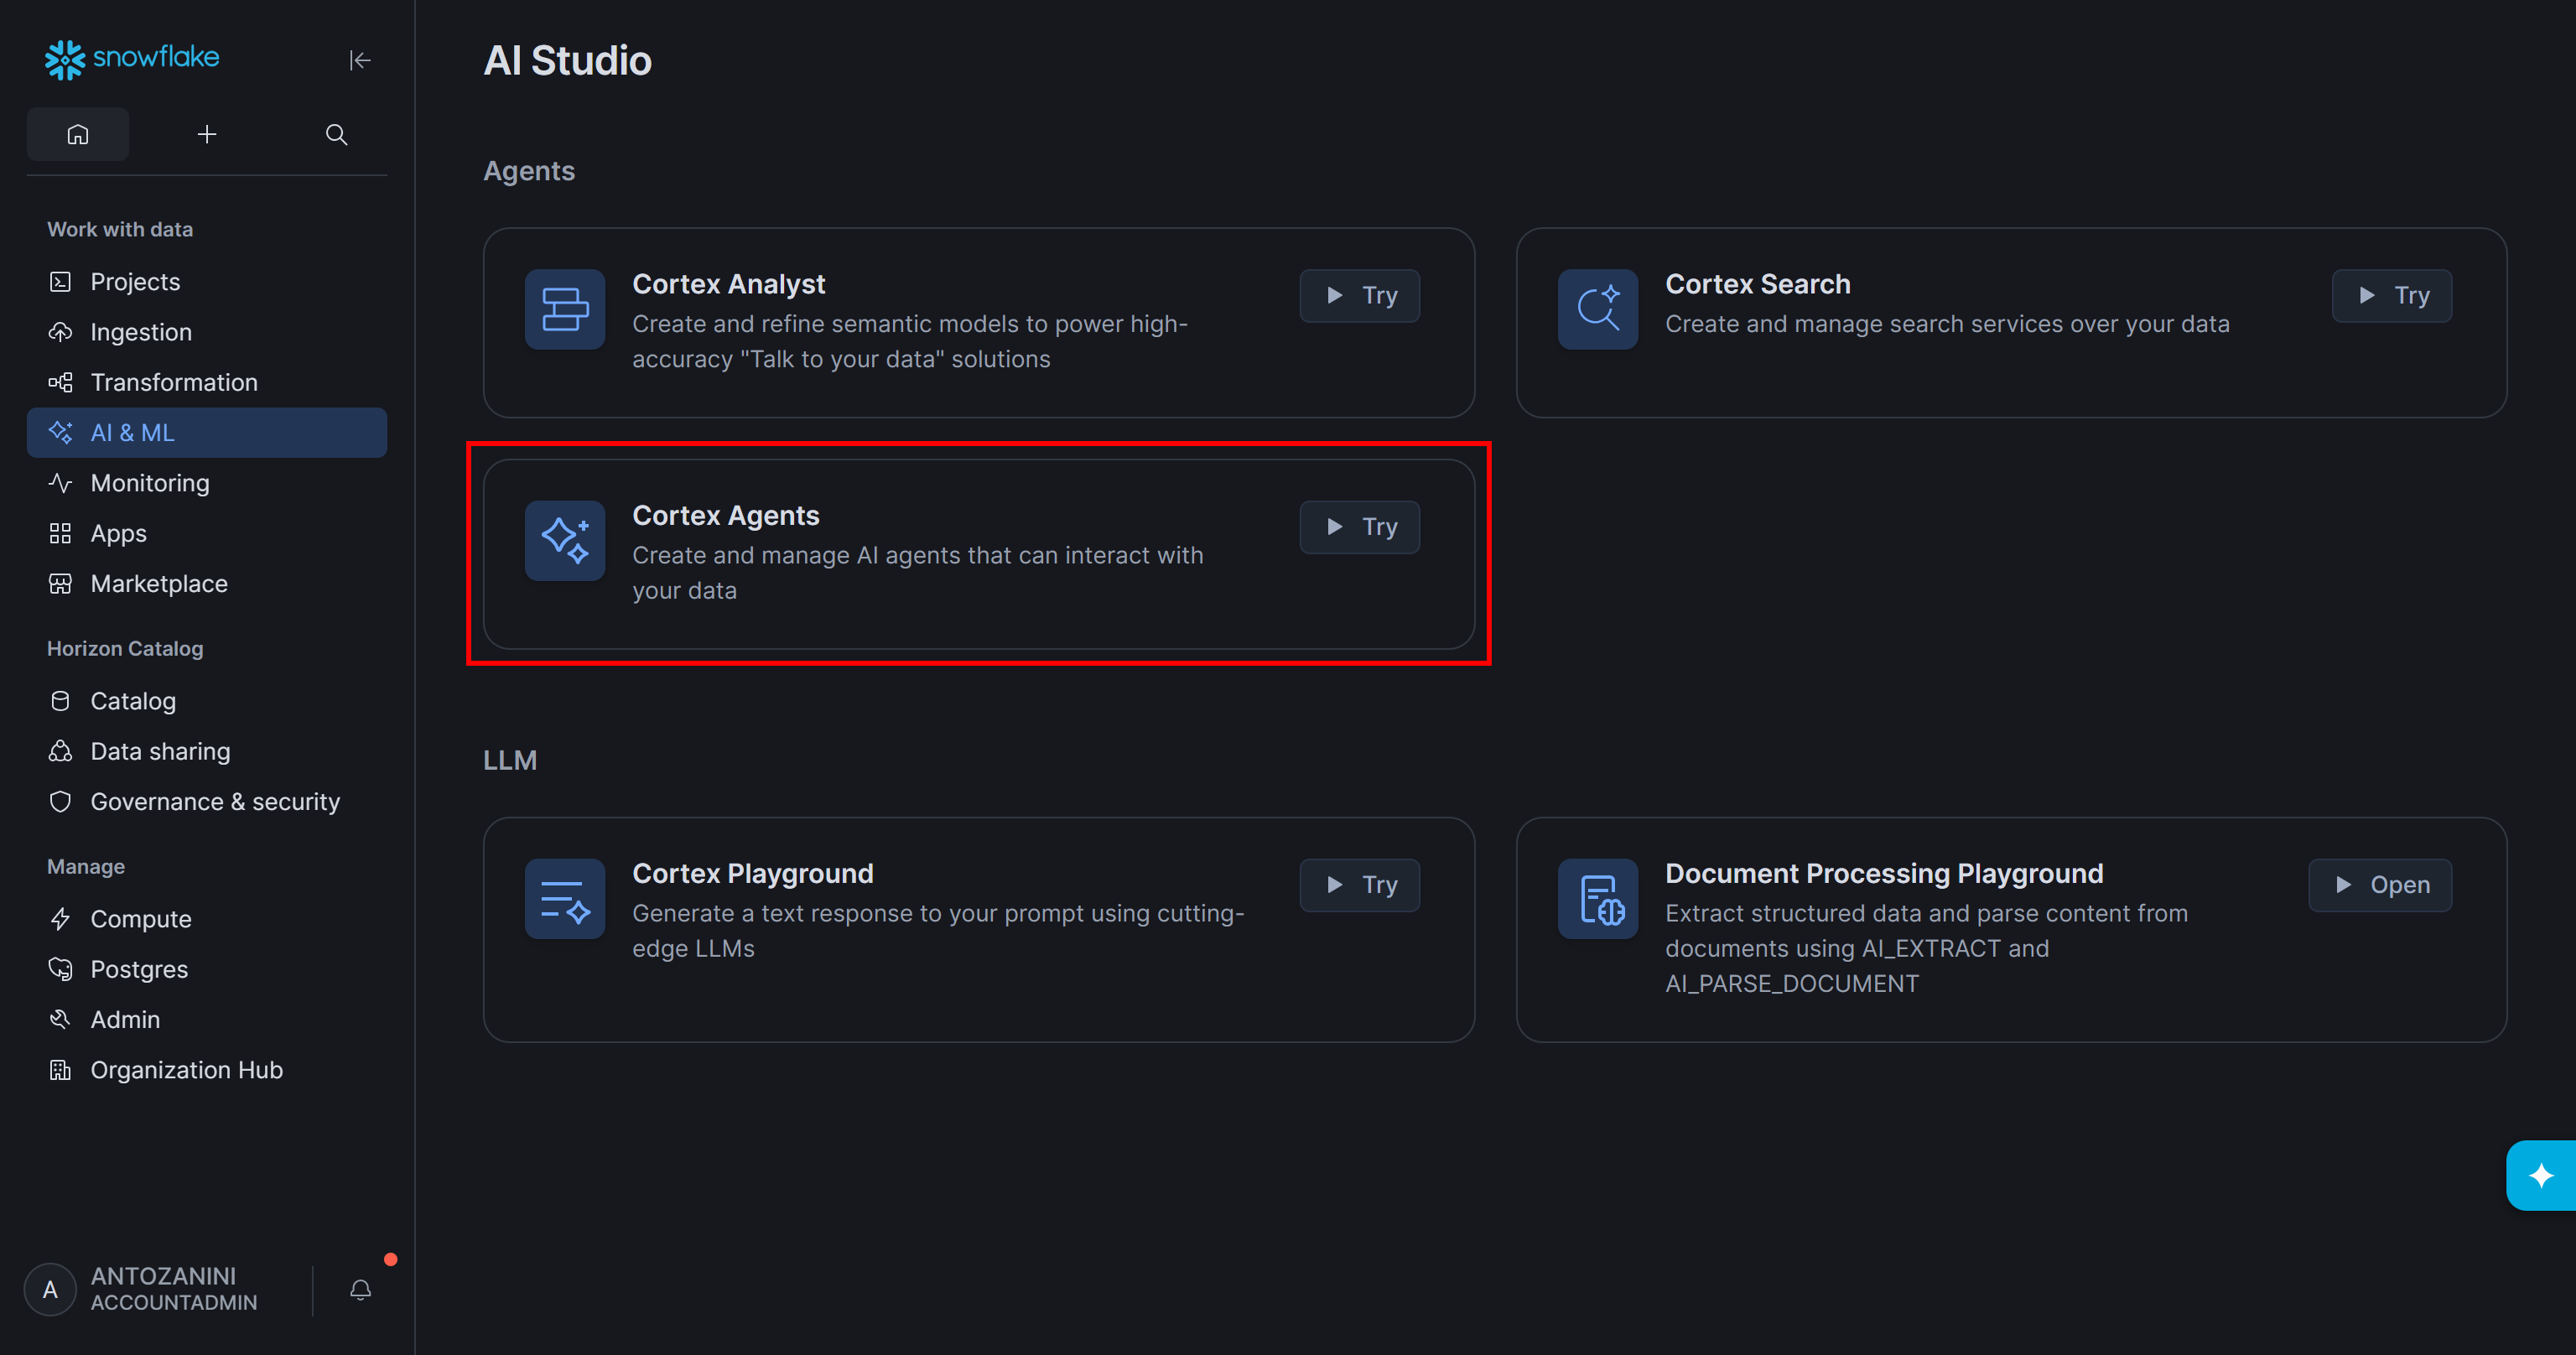
Snowflakeウェアハウスに新しいCortex Agentを追加するには、「AI & ML」ページに移動し、「Cortex Agents」カードを選択します:
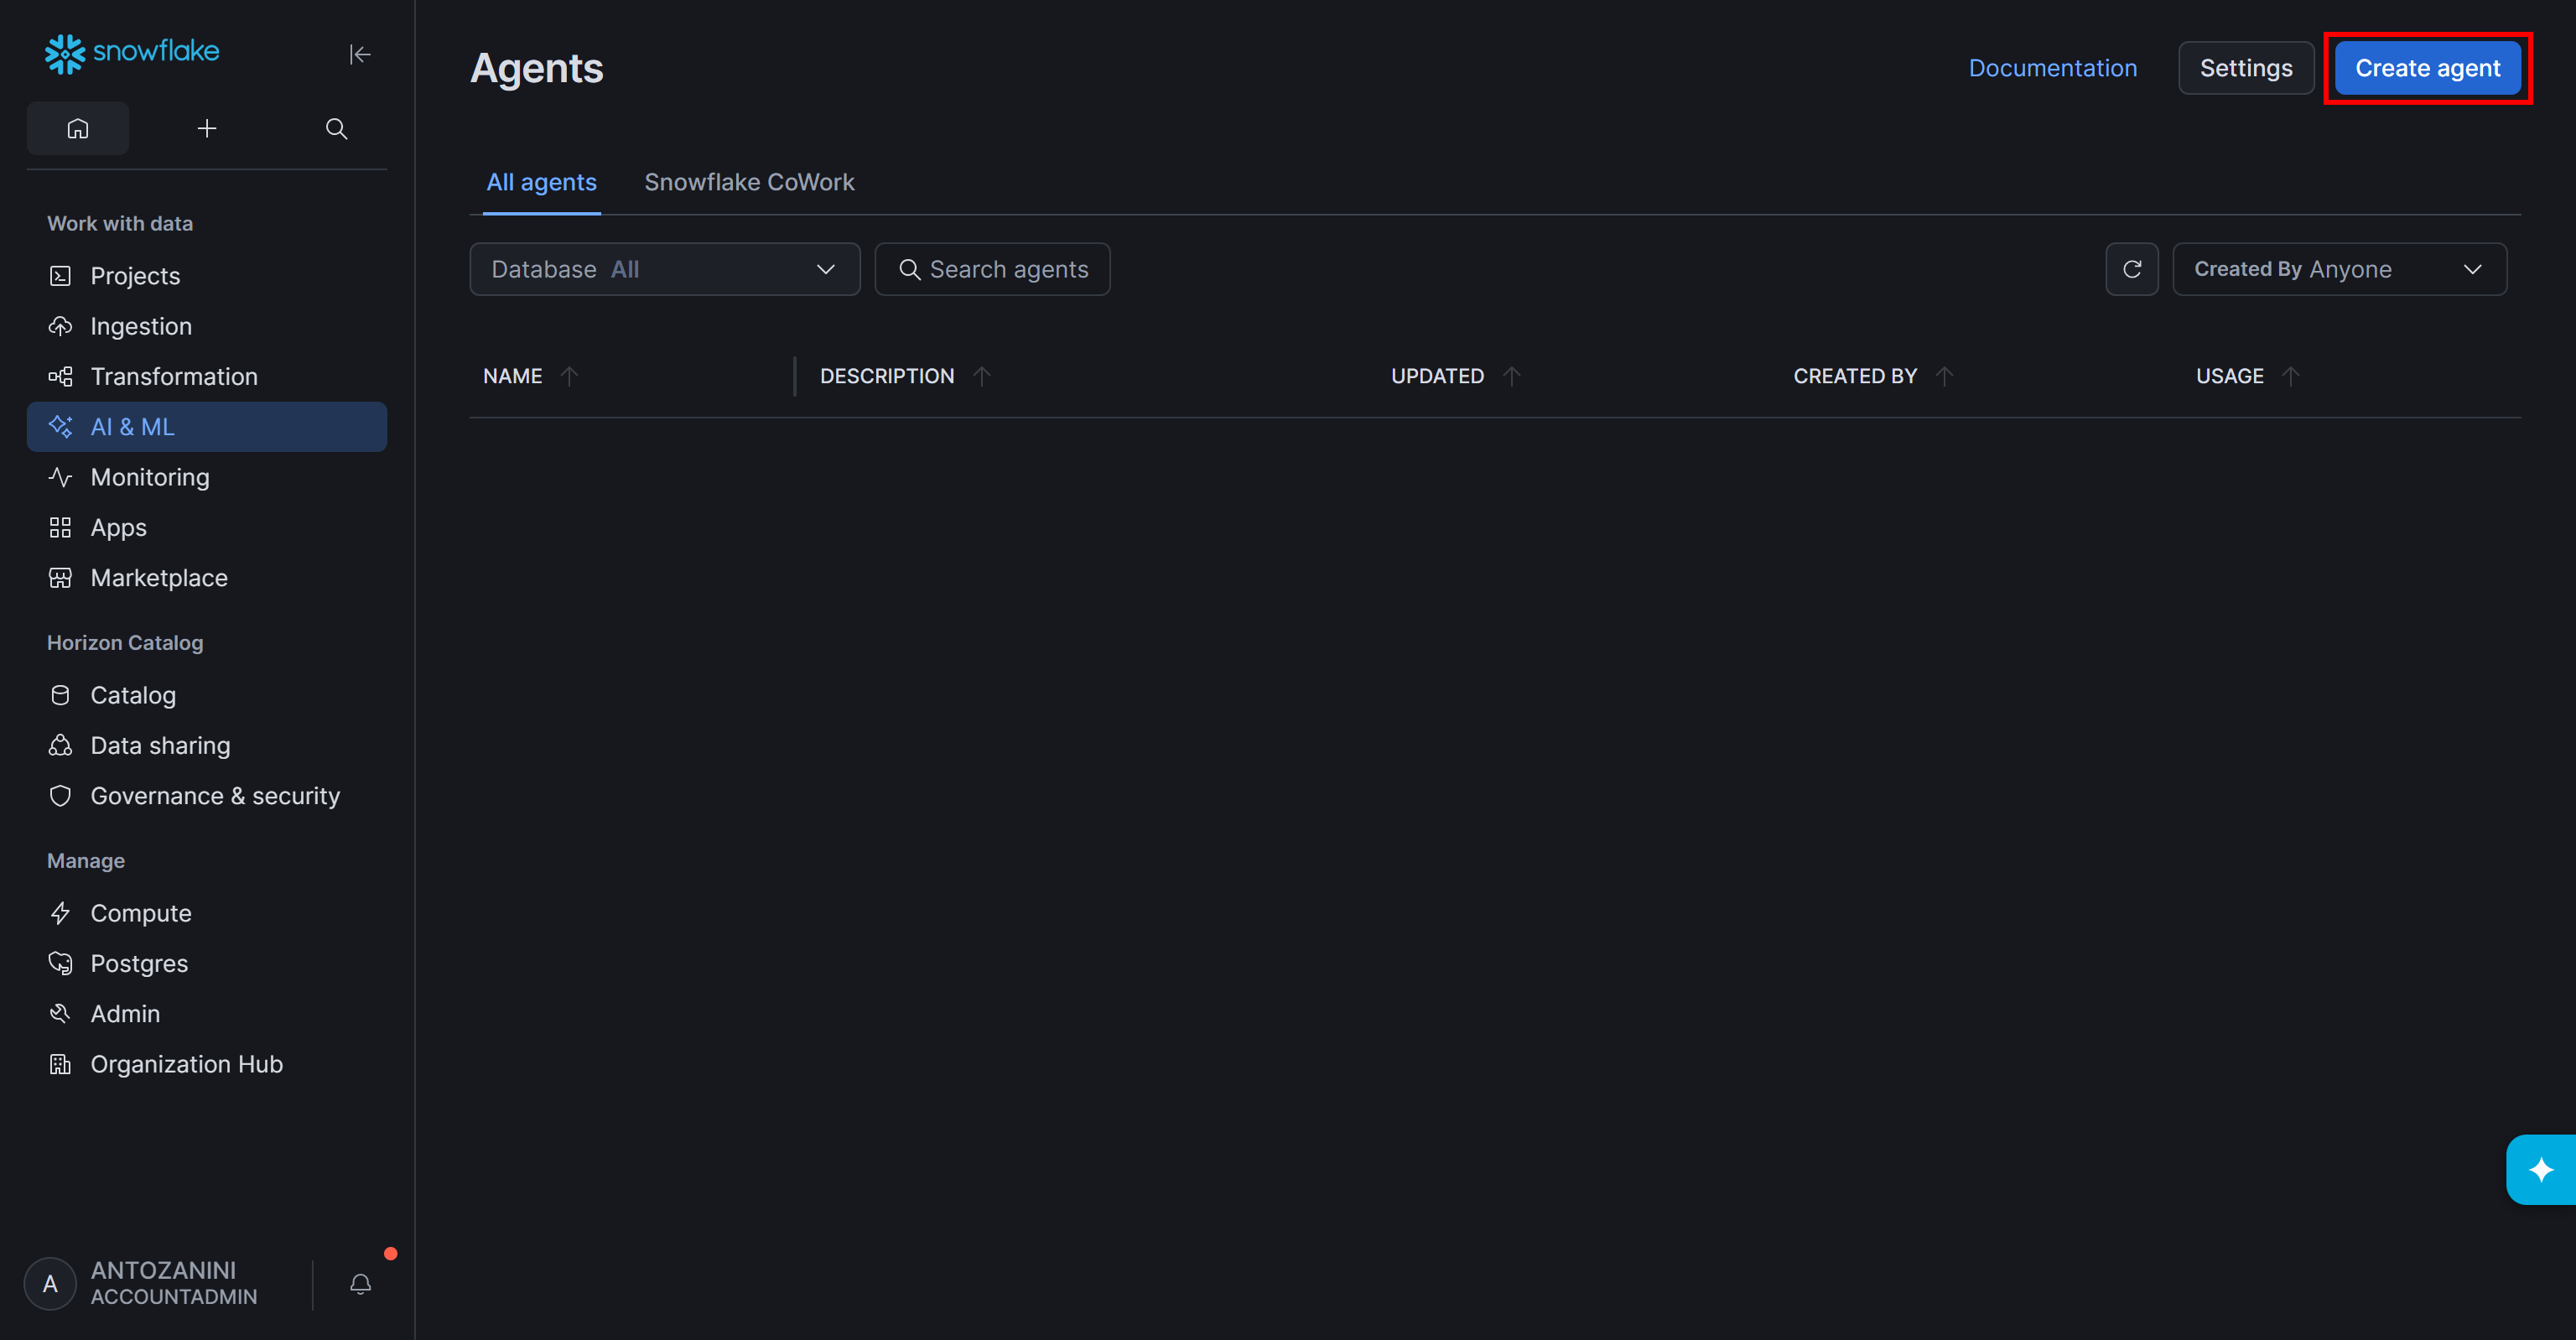
「Agents」ページで「Create agent」をクリックします:
インポートしたBright Dataデータセット(その他の貴重なビジネスデータとともに)を含むデータベースとスキーマを選択します。次に、エージェントに名前を付けます(例:「Influencer_Analyzer」):
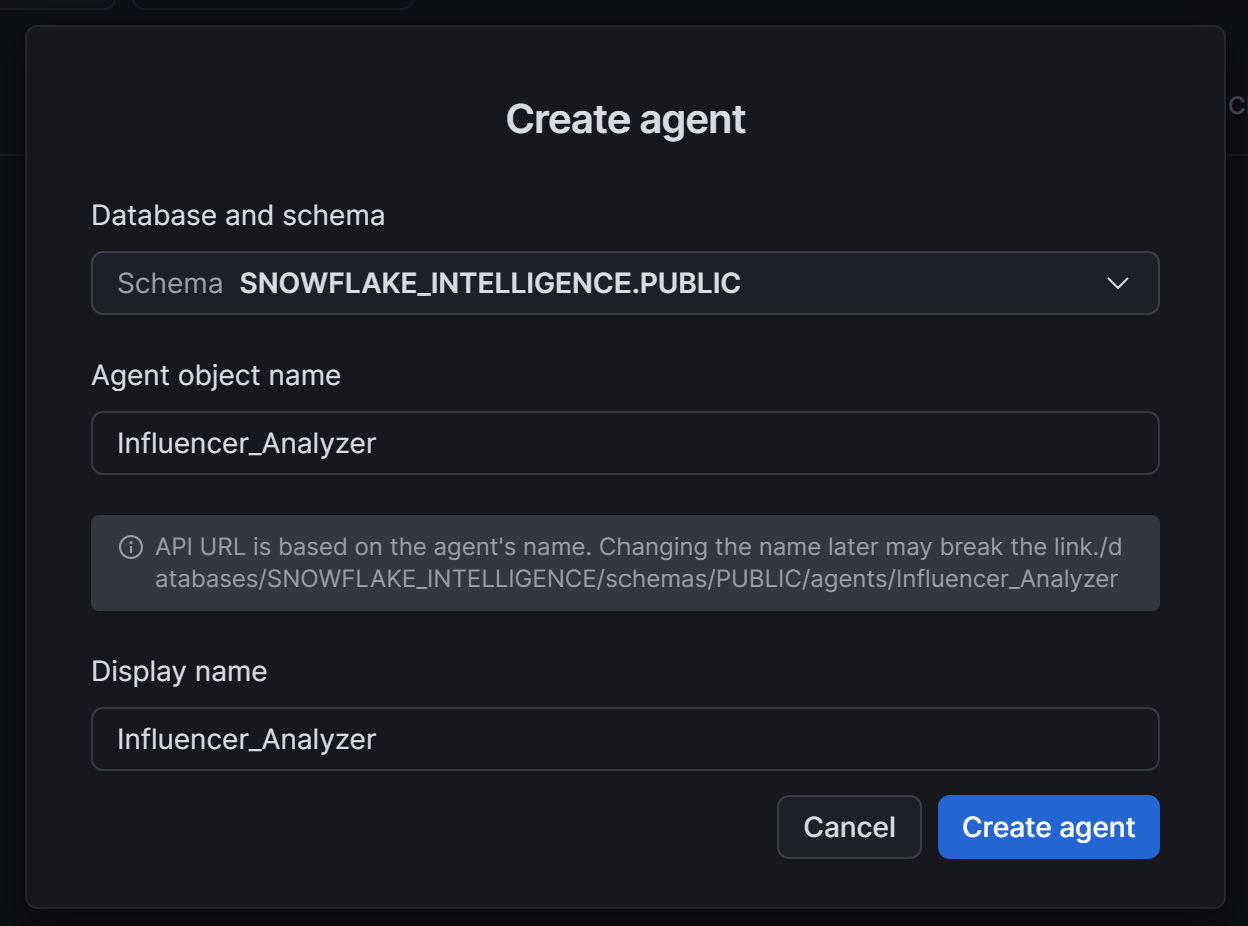
最後に、「Create agent」ボタンをクリックしてCortex Agentの設定を完了します。
ステップ#5:エージェント設定を完了する
Cortex Agentページで、「Connect」をクリックしてSnowflake CoCoによるガイド付きセットアップを開始します:
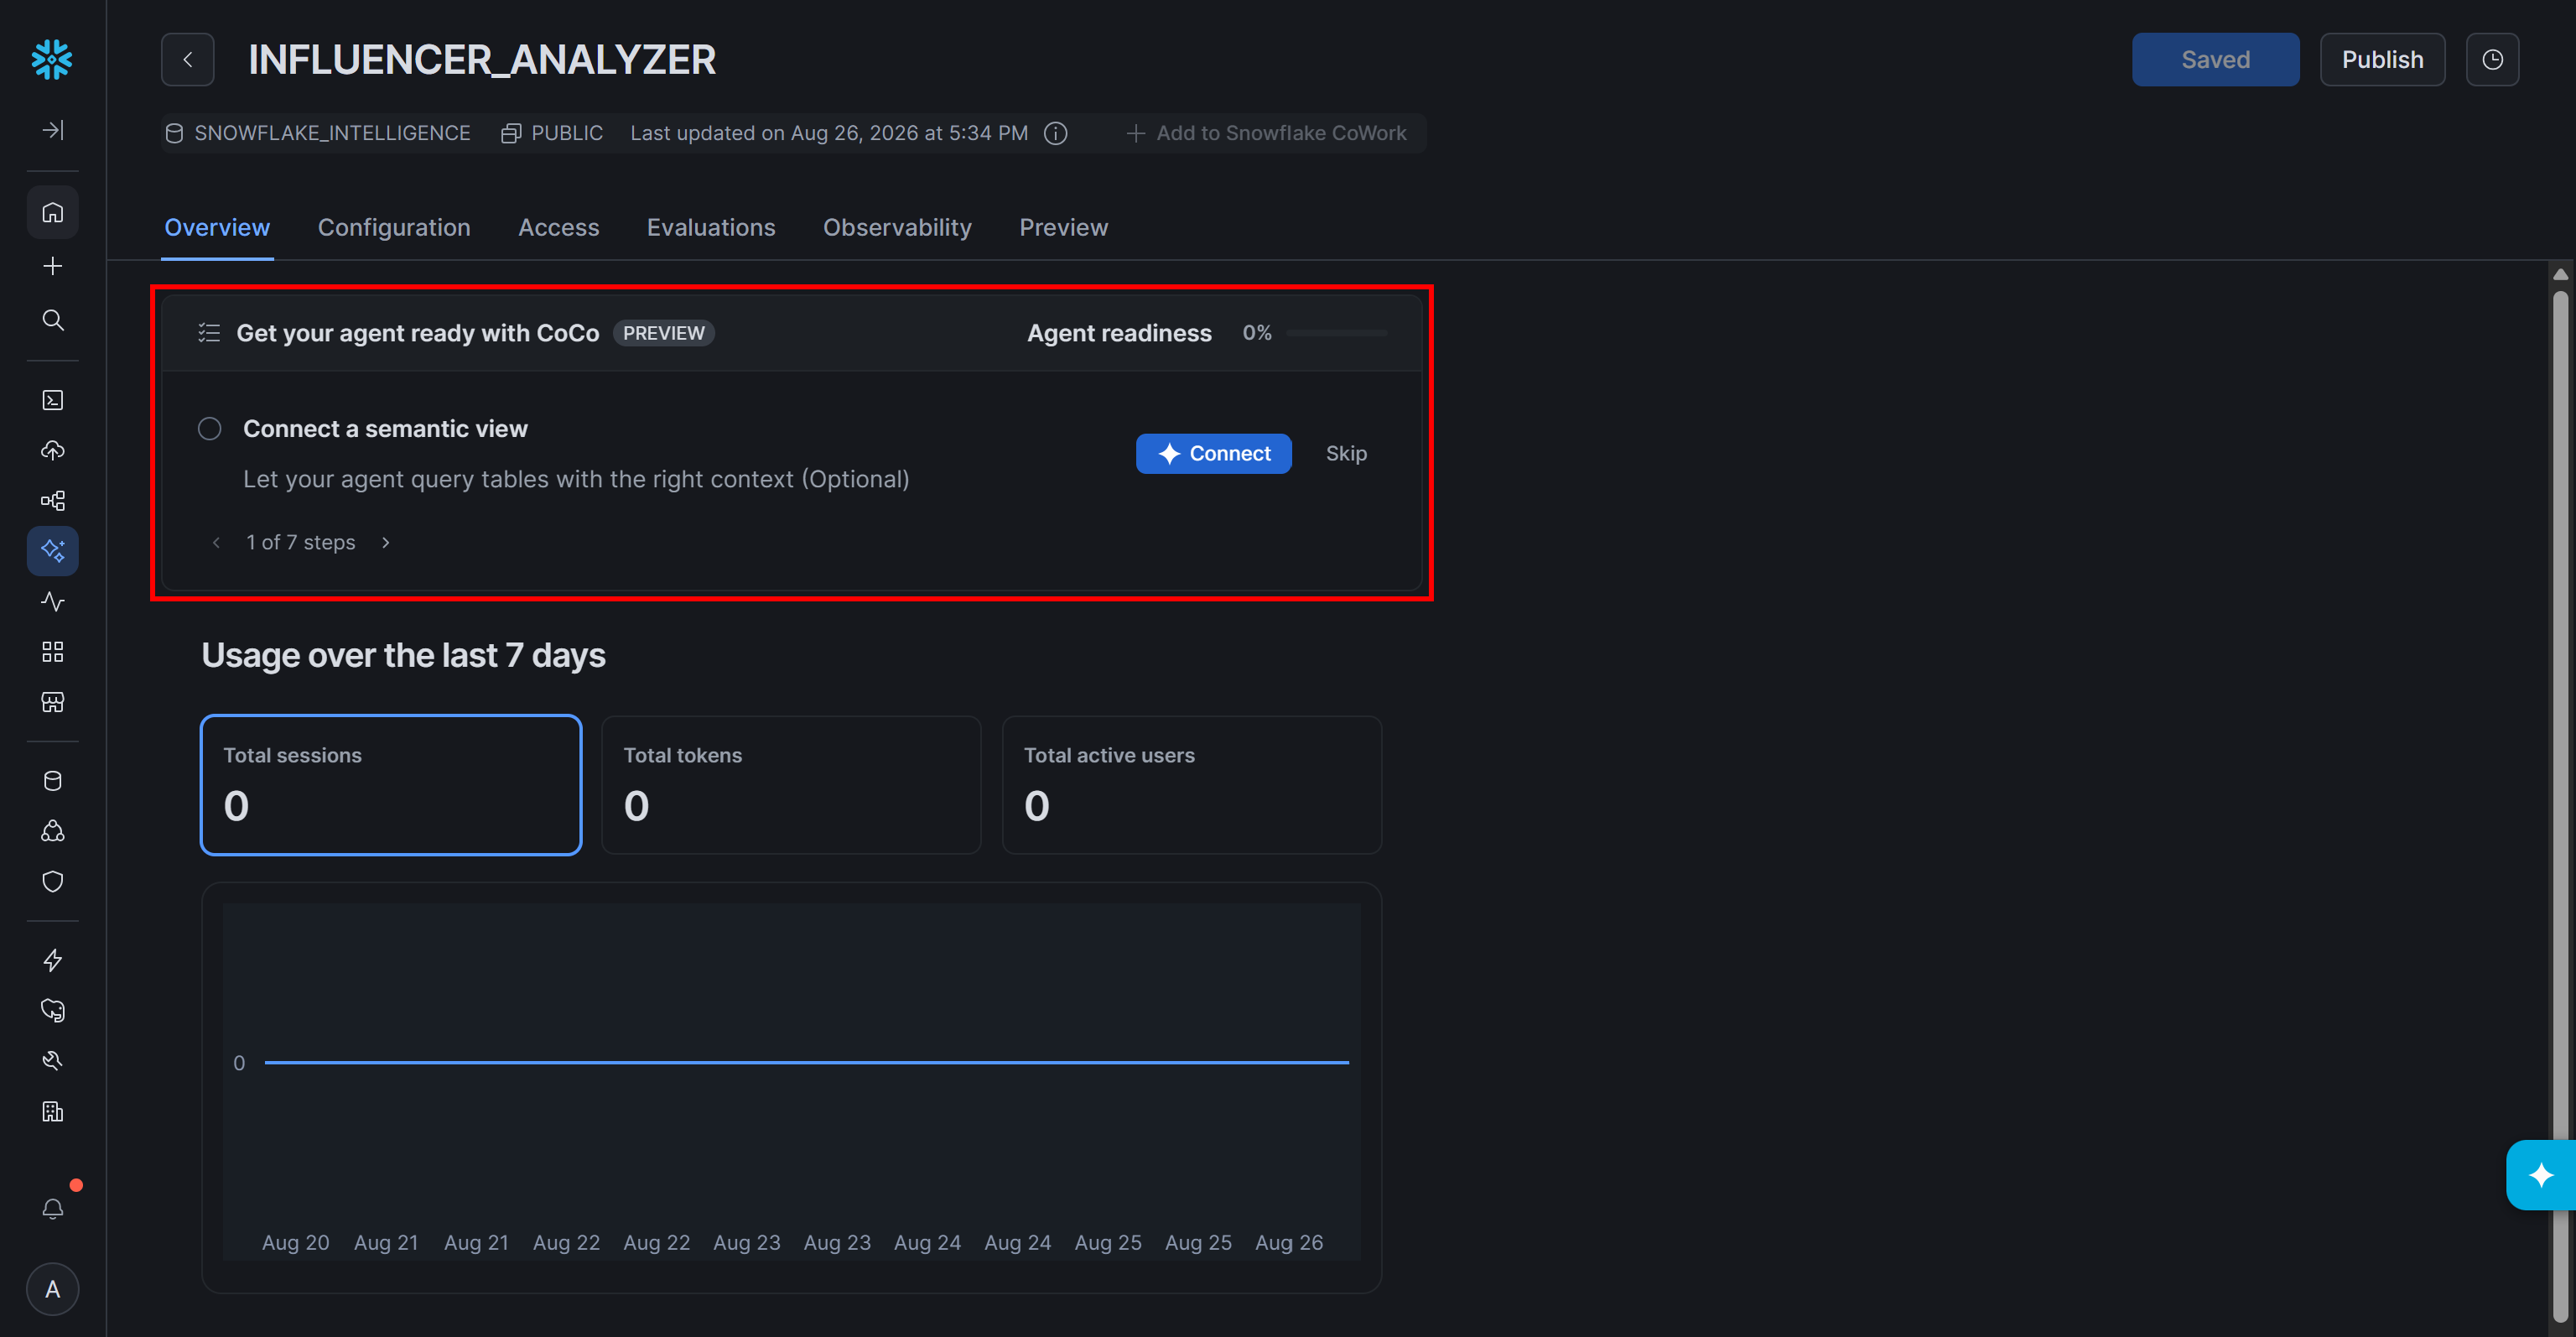
CoCoチャットでは、エージェントのセマンティックビューの作成、検索サービスの接続など、設定プロセスを案内されます:
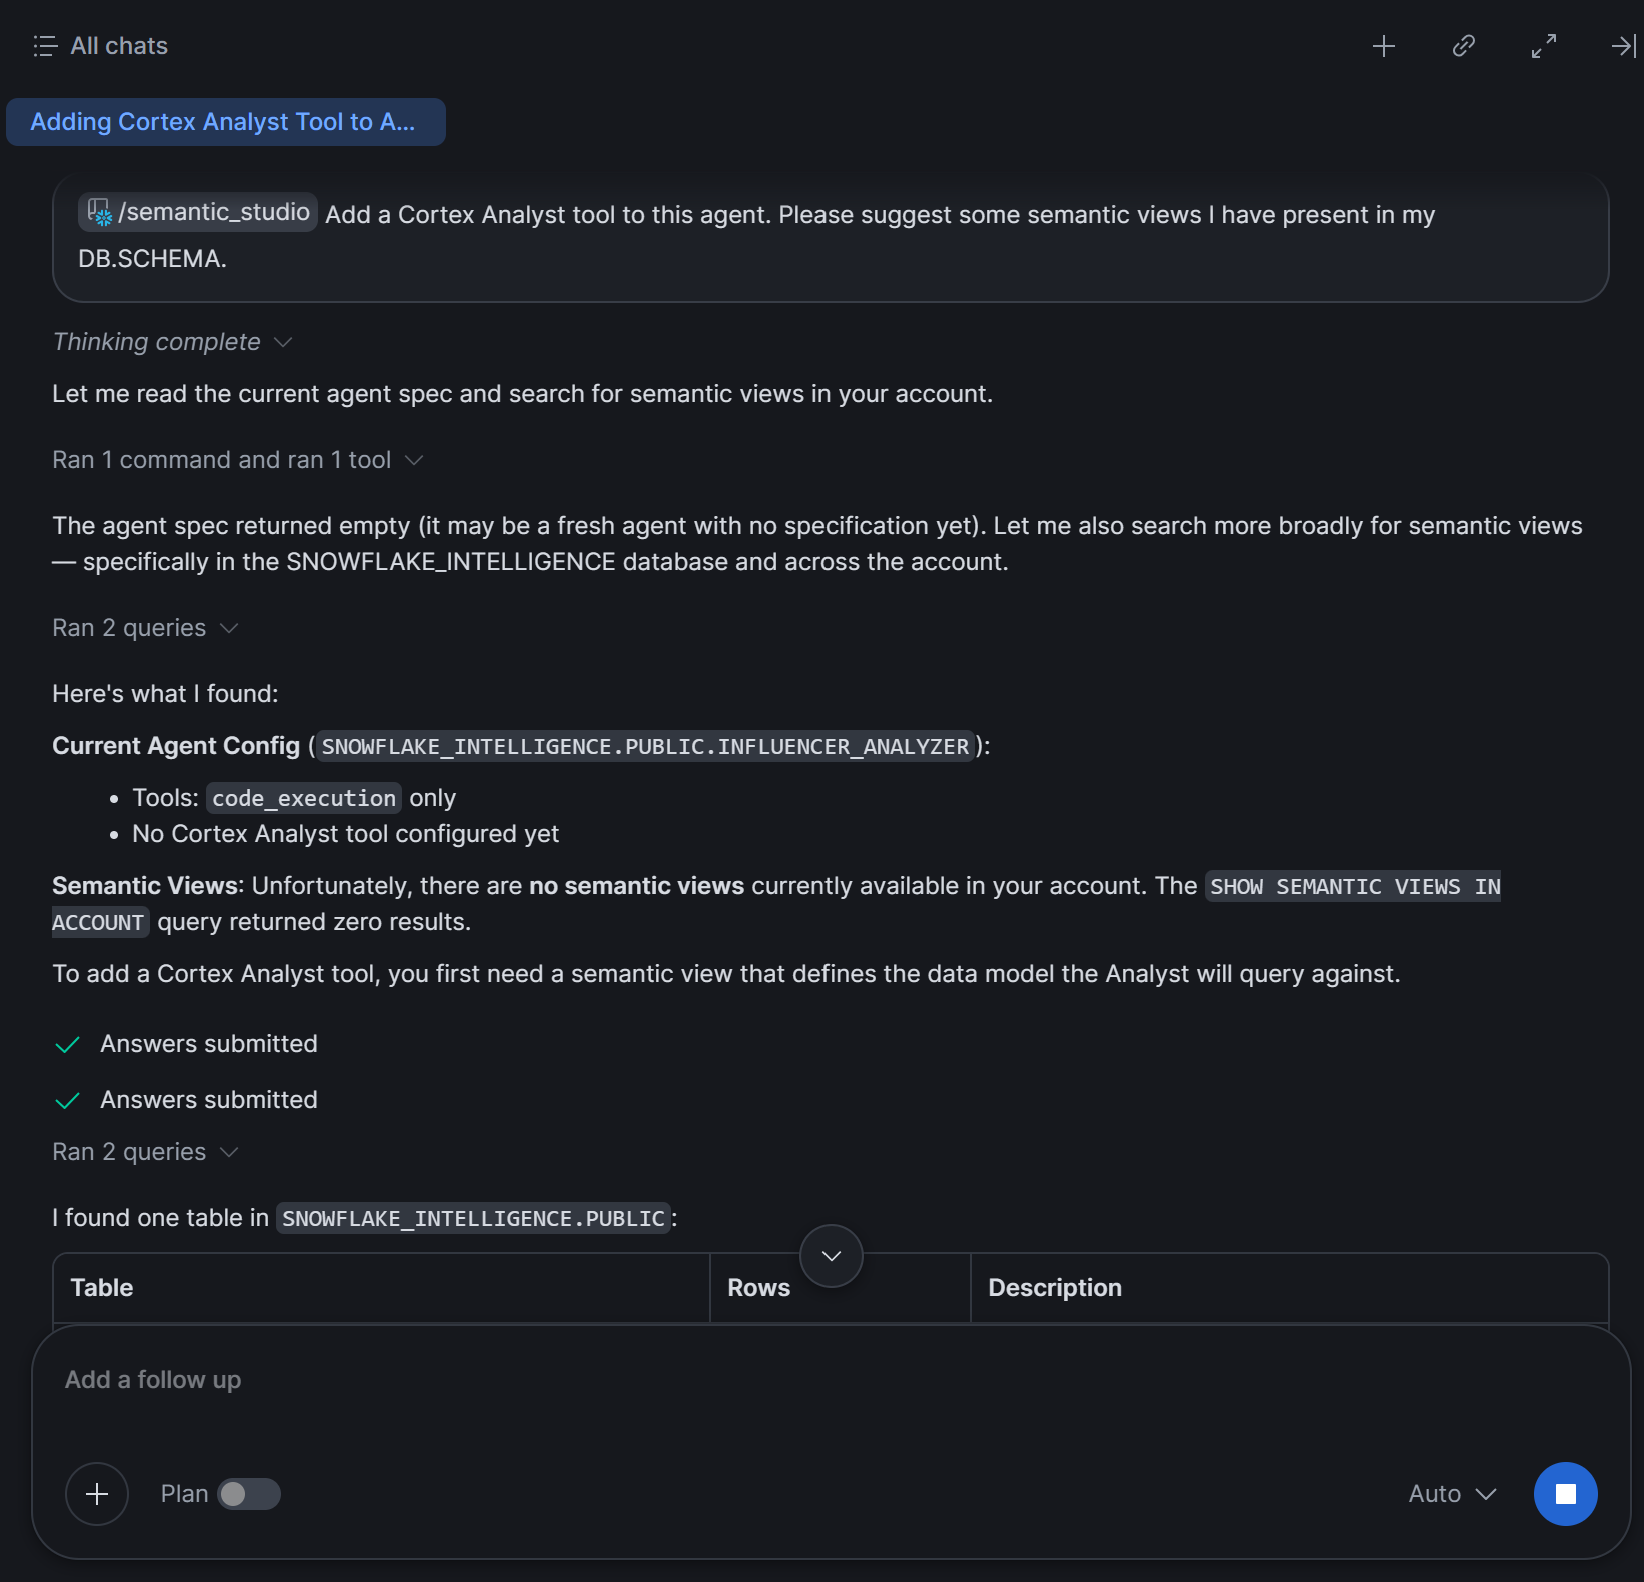
CoCoはまた、次のような必要なSnowflake Cortexコンポーネントを連携させます:
| コンポーネント | 機能 |
|---|---|
| Cortex Analyst | 自然言語の質問を構造化テーブルに対するSQLに変換します。メトリクス、ディメンション、関係性を定義するセマンティックビュー(またはYAMLセマンティックモデル)によって案内されます。 |
| Cortex Search | ベクトル(セマンティック)検索とキーワード検索を組み合わせたハイブリッドインデックスを非構造化テキスト上に構築し、エージェントが意味によっても正確な語句によっても情報を取得できるようにします。 |
| Cortex Sense | クエリ履歴とメタデータからビジネス定義、メトリクス、テーブル関係を学習するランタイムコンテキストレイヤーであり、セマンティックビューを手動で維持する必要なくエージェントをグラウンディングします。 |
| Cortex Agents | タスクを計画し、各ステップを適切なツールにルーティングするオーケストレーター。 |
次に、「Configuration」タブを開き、エージェントの説明と指示を定義し、ツール、スキル、MCP統合を追加します:
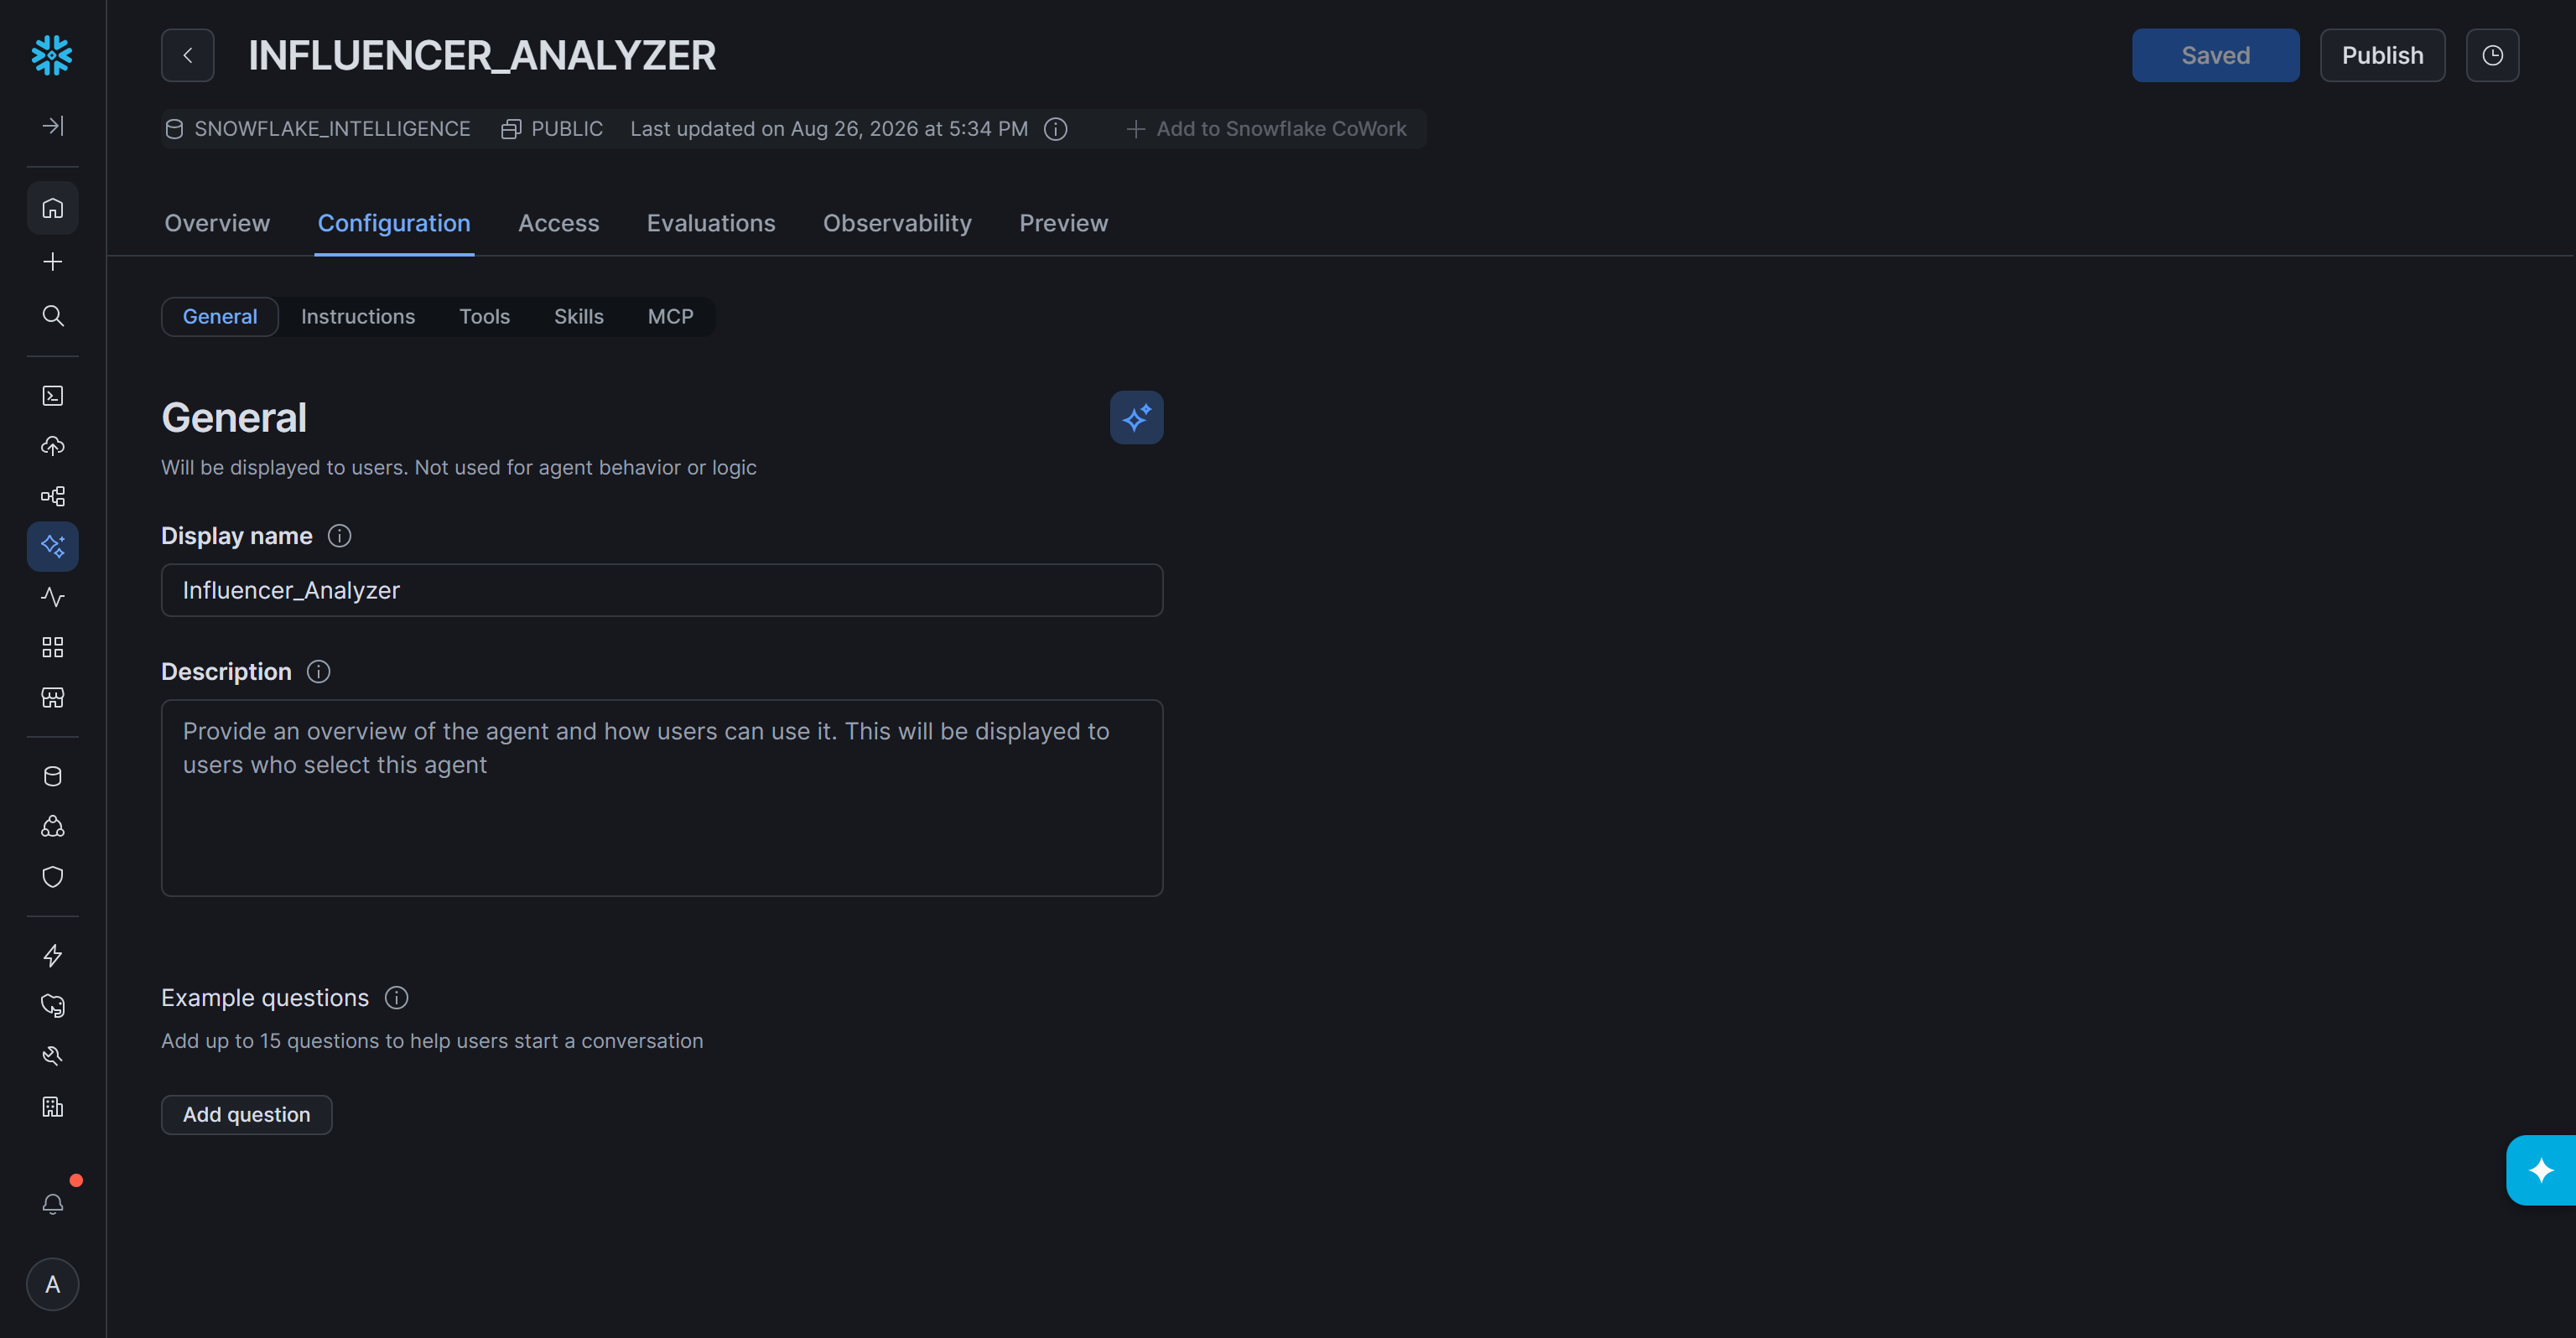
これで、エージェントは設定されたSnowflakeスキーマに保存されているデータをクエリ、推論、処理できるようになりました。
ステップ#6:エージェントをテストする
設定が完了したら、「Preview」タブに移動してエージェントをテストします。例えば、次のようなプロンプトを入力します:
Retrieve the top 5 Spanish-speaking influencers from the list to promote our revolutionary skincare product targeting female teenagers. Give each influencer a suitability score.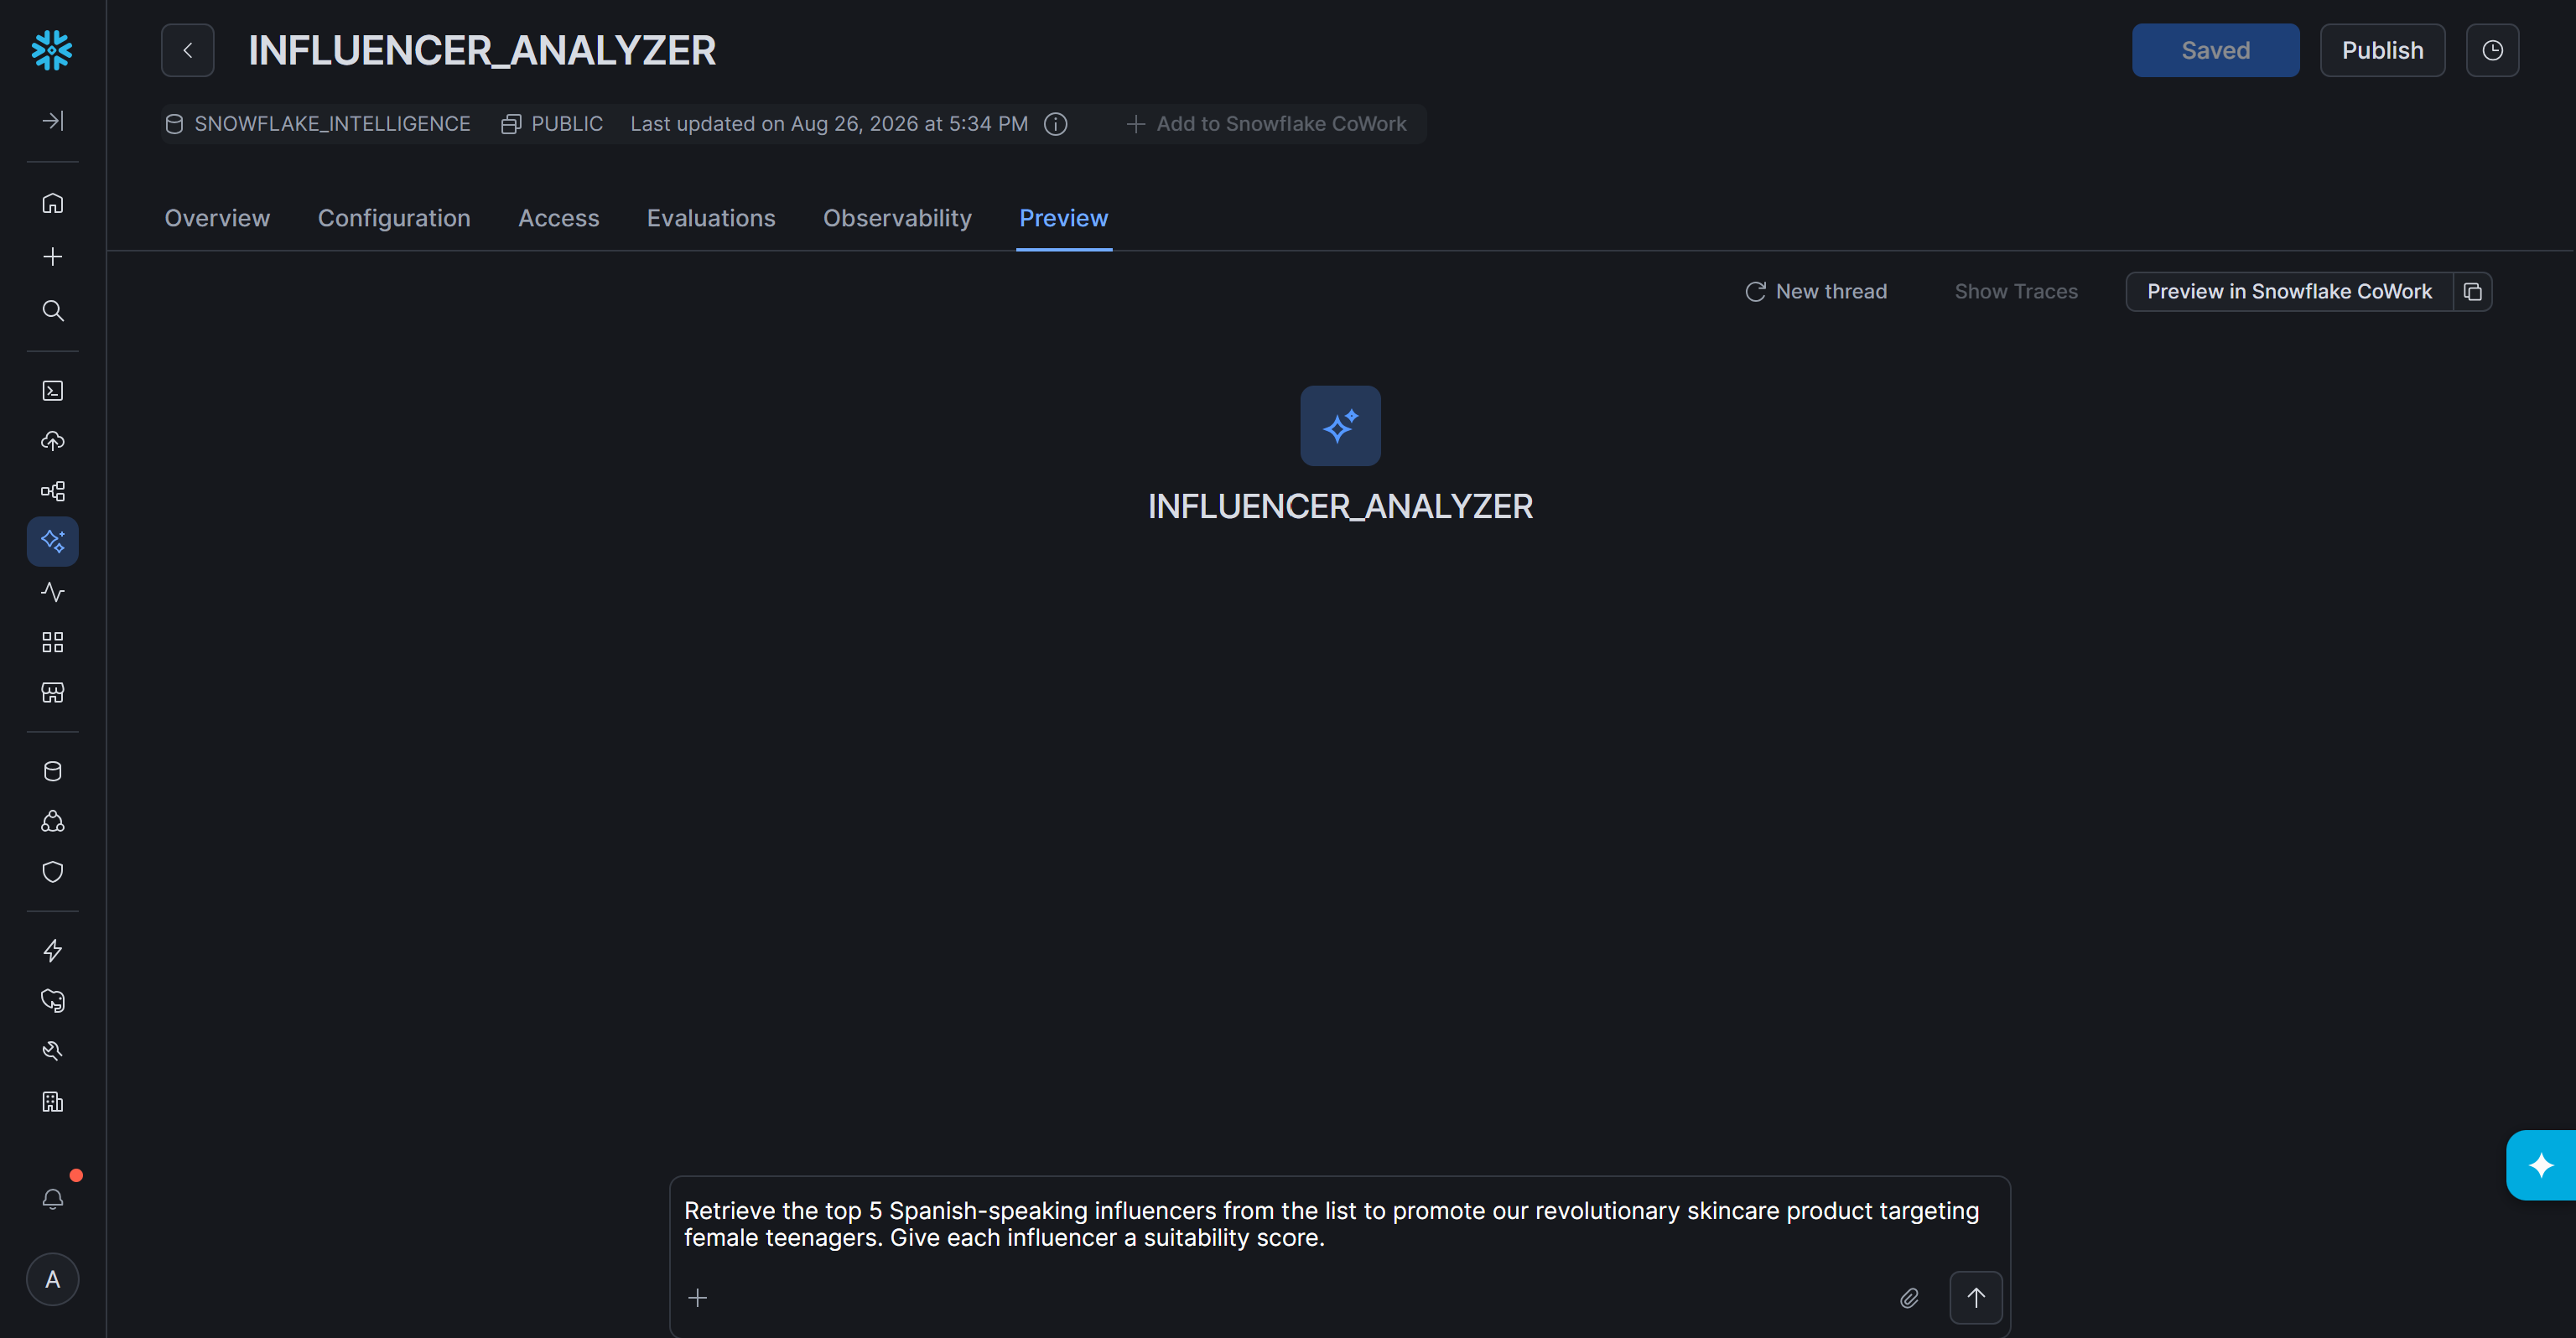
エージェントはSnowflakeテーブル内のInstagramプロフィールデータをクエリし、最も適した5人のインフルエンサーを、それぞれの適合度スコアとともに返します。内部では、Cortex Analystを使って構造化フィルタリング(言語やプロフィール属性など)を行い、Cortex Searchを使ってスコアリング前に自己紹介やキャプションの適合性を評価することができます。より現実的なシナリオでは、製品データに関するコンテキストをエージェントに与えることで、結果をより精緻化できます。
Bright Data MCPでライブウェブアクセスを追加する
上記のワークフローは永続バッチデータセットパターンをカバーしています。比較表が示すように、もう一つのパターンはライブ取り込みです:最初にウェブデータを保存する代わりに、エージェントが推論時にデータを取得します。
Bright DataをMCP経由でCortex Agentsに接続するか、CoCo CLI(以前はCortex Code CLIとして知られていました)と統合できます。
Bright Data MCPでライブウェブデータを取得する
すべてのワークフローが同じ種類のウェブデータを必要とするわけではありません。永続データセットは、定義された構造化情報のコレクションを繰り返し分析する際に役立ちますが、他のAIアプリケーションはライブ情報へのアクセスを必要とします。インフルエンサーの例では、ランキング用に1,000件のプロフィールデータセットを保持しつつ、アウトリーチの前に候補に挙がったインフルエンサーの最新投稿をMCPでチェックすることができます。
Bright Data MCPは、補完的なライブデータレイヤーを提供します。ウェブデータセットを最初にSnowflakeに保存する代わりに、エージェントはMCPを介してBright DataのAPIベースのソリューションと対話し、現在のウェブコンテンツを検索、スクレイピング、操作できます。
これにより、Bright Data + Snowflakeの統合には2つのデータ取り込みパターンが生まれます:再現可能な分析のための永続的でフィルタリングされたデータセットと、時間的制約のある質問のためのライブウェブアクセスです。
Bright Data MCPアプリもSnowflake Marketplaceから直接利用可能であることに注意してください:
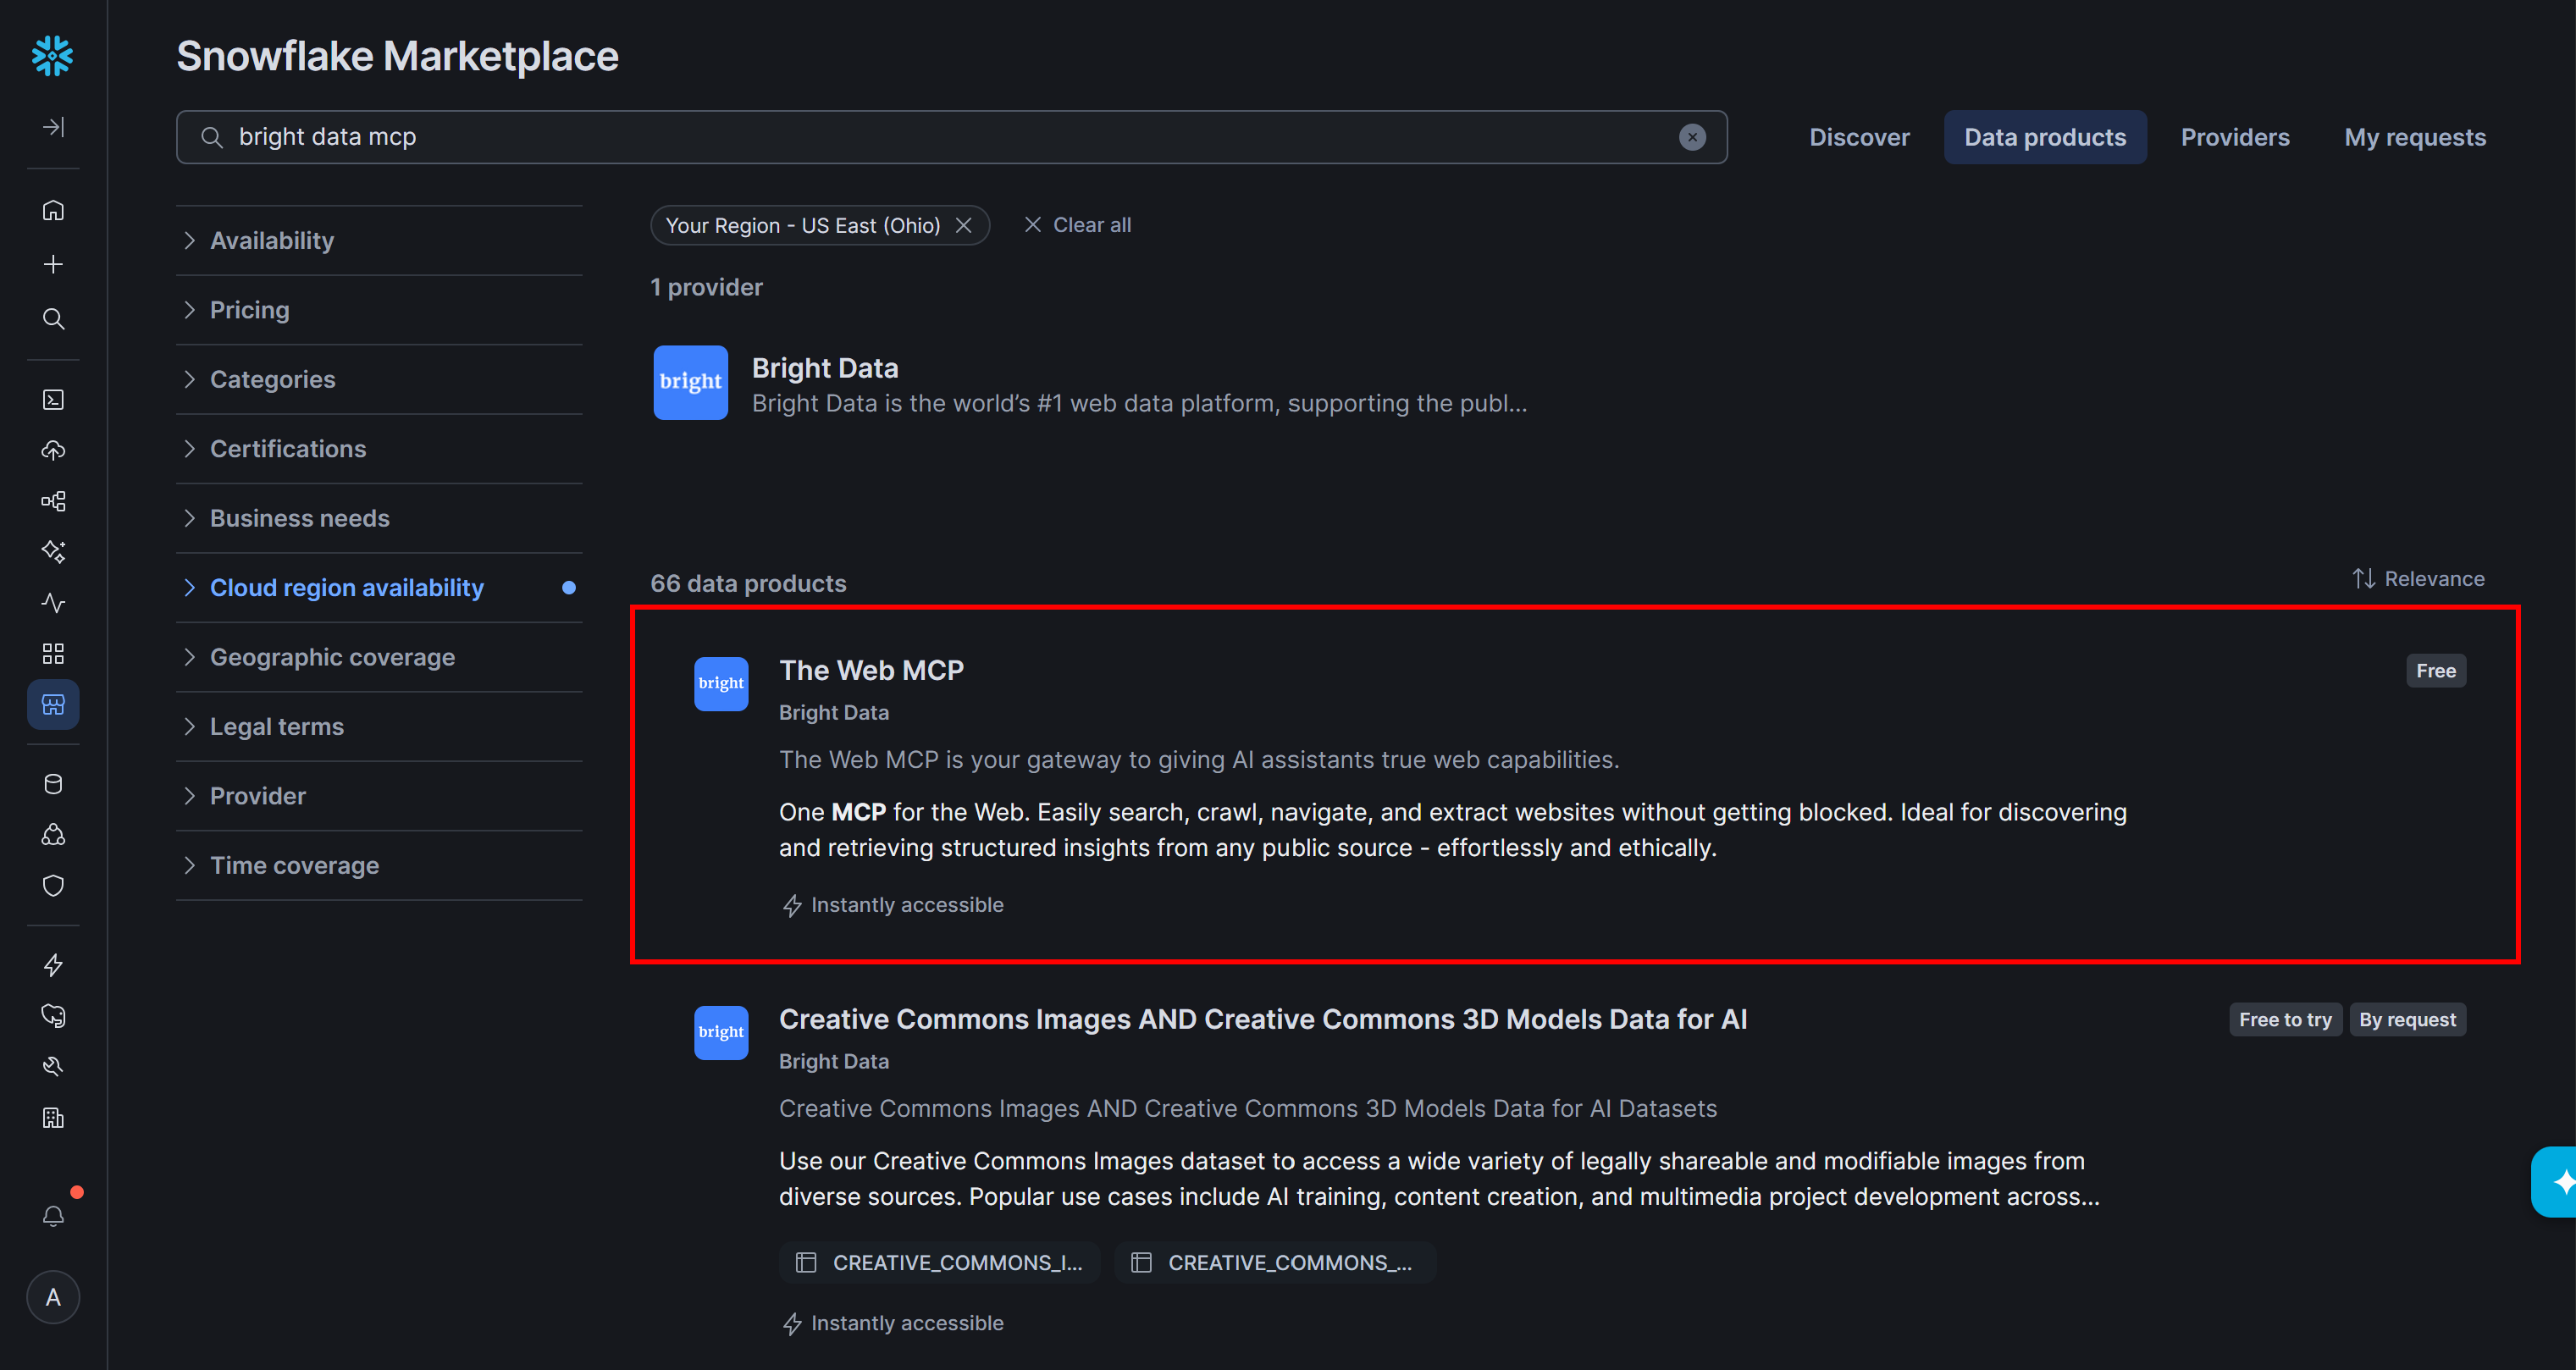
あるいは、MCPサーバーを手動でセットアップすることもできます。
Bright Data MCPがサポートする最も興味深いシナリオの一部を以下に示します:
| ユースケース | Bright Data MCPの機能 |
|---|---|
| ページコンテンツの取得 | Markdownスクレイピングツール |
| 最新情報に基づくグラウンディング | 検索エンジンクエリツール + Markdownスクレイピングツール |
| 構造化情報の抽出 | プラットフォーム固有の抽出ツール |
| 動的ウェブサイトとの対話 | ブラウザ自動化 |
要するに、データセットは保存されたスナップショットに対する再現可能な分析を提供し、Bright Data MCPはエージェントにウェブへのライブアクセスを提供します。多くの成熟したアーキテクチャでは、両方を使用しています。
Bright DataとCoCo CLIを接続する
Bright Data MCPとエージェントスキルは、CoCo CLIのSnowflakeベースの機能を、エンタープライズグレードのウェブアクセスで拡張できます。これは、Snowflakeの操作をリアルタイムのウェブリサーチ、スクレイピング、ブラウザ自動化と統合できるAIアシスタントが欲しい場合に役立ちます。
詳しいガイダンスについては、Bright DataによるSnowflake CoCo CLIに関する専用記事をご覧ください。
結論
このブログ記事では、Bright Data + Snowflakeの統合が、信頼性の高いウェブデータ取得とエンタープライズ分析・AIをどのように結びつけるかを学びました。
Bright Dataは、大規模に意味のあるウェブデータを取得するためのインフラを提供し、そのフィルタリングとカスタマイズ機能により、Snowflakeに取り込む前にそのデータを精緻化できます。これにより、不要なデータが下流のストレージや計算に入り込むのを防ぐことができます。
データセットがSnowflakeに入ると、既存のデータと組み合わせて、分析やAIワークロード全体で使用できます。最新情報に依存するワークロードについては、Bright Data MCPにより、エージェントが単独で、あるいはハイブリッドアーキテクチャの中で永続データセットと組み合わせて、推論時にライブウェブデータを取得できます。
Bright DataとSnowflakeは共に、ウェブデータからAI対応インテリジェンスへの柔軟な道筋を提供します:適切な取り込みパターン(永続データセット、ライブMCPアクセス、またはその両方)を選択し、ビジネスデータがすでに存在する環境にデータを取り込み、Analyst、Search、Agentsなどのcortex AI機能で活用してください。
今すぐBright Dataアカウントを作成し、AI活用分析のために関連するウェブデータをSnowflakeに取り込み始めましょう!