このガイドでは、以下の内容をご紹介します:
- AIウェブスクレイピングツールとは何か
- ユースケースに最適なAIスクレイピングツールを選ぶための重要な要素
- 2026年に利用可能なトップ9のAIウェブスクレイピングツール
- 各ソリューションを一目で評価できる比較表のまとめ
さっそく見ていきましょう!
AIウェブスクレイピングツールとは?
AIウェブスクレイピングツールは、人工知能を使ってウェブサイトからのデータ抽出を自動化します。AIを活用したスクレイピングAPIを提供するクラウドプラットフォーム、PythonやJavaScriptのライブラリ、またはビジュアルワークフローを中心に構築されたノーコード製品など、さまざまな形態があります。
AIを活用したスクレイピングが従来のスクレイパーより優れている点は、レイアウト変更に対してコードを頻繁に更新することなく適応できる能力であり、メンテナンスを削減し精度を向上させます。トレードオフとして、AI処理によりレイテンシが増加し、LLMベースの抽出が関与する場合には幻覚的な出力が生じることがあります。
一般的に、現代のAIウェブスクレイピングツールには以下のような機能が含まれます:
- 特定のデータフィールドを指定するための自然言語プロンプト
- LLMプロバイダー(OpenAI、Anthropic、Geminiなど)との連携
- 人気ウェブサイトやマーケットプレイス向けの事前構築済みコネクタ
- 動的なシングルページアプリケーション向けのJavaScriptレンダリング
- スクレイピングブロックを回避するためのアンチボットバイパスとプロキシ管理
トップAIスクレイピングツールの選定方法
主要なAIウェブスクレイピングソリューションを評価する際に念頭に置くべき重要な要素は以下の通りです:
- 機能:シンプルなページ抽出からサイト全体のクローリングや構造化データパイプラインまで、ツールがサポートする機能と特性の範囲。
- 性質:ツールが商用SaaS製品か、オープンソースか、またはその両方を提供するハイブリッドかどうか。
- 対応プログラミング言語:ソリューションが連携する言語やフレームワーク、ノーコードの選択肢があるかどうか。
- 対応AIプロバイダー:ツールが接続するAIモデル、または独自のAIを内部で使用しているかどうか。
- 価格:公開時点で確認された、各ツールの公式ウェブサイトに掲載されているプランと価格。
- GitHubスター数:オープンソースプロジェクトのコミュニティ採用状況。成熟度と勢いのシグナルとして。
トップ9 AIウェブスクレイピングツール
以下はトップ9のAIスクレイピングツールのTL;DR比較表で、その後に各ツールの詳細レビューが続きます:
| ツール | 種類 | オープンソース | ノーコード | 開始価格 | GitHubスター数 |
|---|---|---|---|---|---|
| Bright Data | フルインフラ | ✔️ (MCP、LangChain連携) | ✔️ | $0.75/1kレコードから | N/A |
| Firecrawl | デベロッパーAPI | ✔️ | ❌ | 無料〜$599/月 | 125k+ |
| Crawl4AI | オープンソースライブラリ | ✔️ | ❌ | 無料 | 66.7k+ |
| Browse AI | ノーコードプラットフォーム | ❌ | ✔️ | $19/月(年払い) | N/A |
| Apify | アクターマーケットプレイス | ✔️ (アクター) | ✔️ | 無料〜$999/月 | N/A |
| ScrapeGraphAI | オープンソース+API | ✔️ | ❌ | 無料〜$425/月 | 26.3k+ |
| Diffbot | エンタープライズAI | ❌ | ✔️ | 無料〜$899/月 | N/A |
| Browserbase | クラウドブラウザインフラ | ✔️ (Stagehand SDK) | ❌ | 無料〜$99/月 | N/A |
| Octoparse | ノーコードデスクトップ+クラウド | ❌ | ✔️ | 無料〜$69/月 | N/A |
1. Bright Data
Bright Dataは、パフォーマンス、スケール、コンプライアンスのために構築されたウェブデータインフラです。50,000+の顧客に信頼されており、レジデンシャル、データセンター、ISPプールにわたる1億以上のIPを持つ世界最大級のプロキシネットワークに支えられた、フルスイートのAIスクレイピングツールを提供しています。
このインフラは、AIエージェント、RAGパイプライン、モデルトレーニング、および特定分野のインテリジェンス収集のために、リアルタイムかつLLM対応のウェブデータを提供するよう設計されています。すべてのスクレイピング製品は業界最先端のアンチボットバイパス技術に支えられているため、ブロックの管理ではなくアプリケーション開発に集中できます。
Bright Dataで利用可能なAIスクレイピングツールには以下が含まれます:
- SERP API:AIエージェントとRAGシステム向けに最適化された、Google、BingなどのリアルタイムかつLLM対応の検索エンジン結果。
- Unlocker API:CAPTCHAやボット検出システムを大規模にバイパスし、あらゆる公開ウェブページへのシームレスなアクセスを実現。
- Agent Browser:動的コンテンツの読み込みと組み込みのアンロック機能を備えた、マルチステップのエージェントベースワークフロー向けサーバーレスステルスブラウザ。
- AI Scraper Studio:ノーコードビジュアルビルダーで任意のウェブサイト向けカスタムスクレイピングエンドポイントを構築・デプロイし、大規模にオンデマンドで構造化データを提供。
- Dataset Marketplace:モデルトレーニング、知識グラフ開発、即時デプロイのための、すぐに使える継続的に更新された構造化データセット。
オープンソース連携には、LangChainパイプライン向けのlangchain-brightdataと、Model Context ProtocolベースのAIエージェント向けの@brightdata/mcpが含まれます。
価格:
- AI Scraper Studio:$0.75/1,000レコードから(25%プロモーション割引、通常価格$1/1k)
- Unlocker API:$1/1,000リクエストから
- Agent Browser:$5/GBから
- レジデンシャルプロキシ:$2.50/GBから(50%プロモーション割引、通常$5/GB)
- データセンター・プロキシ:$0.90/IPから
- クレジットカード不要の無料トライアルあり
2. Firecrawl
Firecrawlは、任意のURLをクリーンなLLM対応のMarkdownまたは構造化JSONに変換する、開発者ファーストのウェブスクレイピングAPIです。125,000以上のGitHubスターを獲得し、リリース以来開発者コミュニティで最も広く採用されているAIスクレイピングツールの一つになっています。
FirecrawlはJavaScriptレンダリング、CAPTCHAの課題、動的コンテンツを自動的に処理するため、AIパイプラインやLLMアプリケーションへの統合が容易です。APIはPython、Node.js、Go、Rust、およびREST経由で任意の言語で利用可能です。Bright Dataのツールとの比較については、Bright Data対Firecrawlをご覧ください。
主な機能には以下が含まれます:
- スクレイプ:1回のAPI呼び出しで任意のURLをMarkdown、HTML、または構造化JSONに変換
- クロール:サブページ全体のリンクを辿りながらウェブサイト全体を再帰的にスクレイプ
- 検索:結果からの即時コンテンツ抽出を伴うウェブ検索
- 抽出:自然言語スキーマを使用したLLM駆動の構造化データ抽出
- JavaScriptレンダリング:SPAおよび動的ページへの完全なヘッドレスブラウザサポート
価格:
- 無料:1,000クレジット/月(1クレジット=1ページ)
- Hobby:$16/月(年払い):5,000クレジット/月
- Standard:$83/月(年払い):100,000クレジット/月
- Growth:$333/月(年払い):500,000クレジット/月
- Scale:$599/月:1,000,000クレジット/月
- Enterprise:カスタムクレジットとレート制限
3. Crawl4AI
Crawl4AIは、LLMフレンドリーなウェブスクレイピングのために特別に設計されたオープンソースのPythonライブラリです。66,700以上のGitHubスターを獲得し、現在利用可能なオープンソーススクレイピングプロジェクトの中で最も急成長しているものの一つです。
汎用スクレイパーとは異なり、Crawl4AIはAIワークフロー向けに一から構築されています:トークン効率に最適化されたクリーンなMarkdownを出力し、RAGインジェスト用のチャンキング戦略をサポートし、抽出パイプラインを通じて人気のLLMプロバイダーと直接統合します。
主な機能には以下が含まれます:
- 非同期ファーストアーキテクチャ:高スループットの並行スクレイピングのためのasyncioとPlaywrightに基づいて構築
- LLM最適化Markdown出力:AI取り込みのためのクリーンなコンテンツを生成するため、ナビゲーション、広告、定型文を除去
- 抽出戦略:CSSセレクタ、XPath、LLMベースの抽出、コサイン類似度コンテンツフィルタリング
- マルチブラウザサポート:Playwright経由のChromium、Firefox、WebKit
- JavaScript実行:抽出前にカスタムJSを実行し、動的コンテンツや遅延読み込みページを処理
- AIプロバイダー統合:抽出パイプラインを通じたOpenAI、Anthropic、Gemini、Ollama、Groqなど
価格:Crawl4AIはApache 2.0ライセンスの下で完全に無料かつオープンソースです。マネージドインフラや専用サポートを必要とするチーム向けに、オプションのクラウドおよびサポートティアも利用可能です。
4. Browse AI
Browse AIは、コードを一行も書かずに任意のウェブサイトからデータを抽出・追跡できるノーコードのウェブスクレイピングおよびモニタリングプラットフォームです。繰り返しのデータ収集ワークフローを自動化するために、大手企業のチームに信頼されています。
Browse AIのビジュアルトレーニングモードでは、ポイント&クリックでAIに抽出するデータフィールドを教えることができます。設定が完了すると、ロボットはスケジュールに従って実行し、結果をGoogleスプレッドシート、Airtable、またはZapier、Make、Webhookを介した7,000以上のインテグレーションのいずれかに直接送信します。
主な機能には以下が含まれます:
- 250以上の事前構築済みロボット:LinkedIn、Amazon、Twitter/Xなどの人気サイト向けのすぐに使えるスクレイパー
- ウェブサイトモニタリング:コンテンツが更新されたときに通知するAI駆動の変更検出
- 7,000以上のインテグレーション:Googleスプレッドシート、Airtable、Zapier、Make、Slackなどへのネイティブ接続
- バルクスクレイピング:URLリストまたはCSV入力を使用して1つのタスクで複数のURLを実行
- APIアクセス:REST API経由でプログラム的にロボットの実行をトリガーして結果を取得
価格:
- Starter:$19/月:12,000クレジット/年
- Professional:$69/月:60,000クレジット/年
- Team:$500/月:カスタマイズされたクレジットとチーム制限
- 月払いは若干高い料金で利用可能
5. Apify
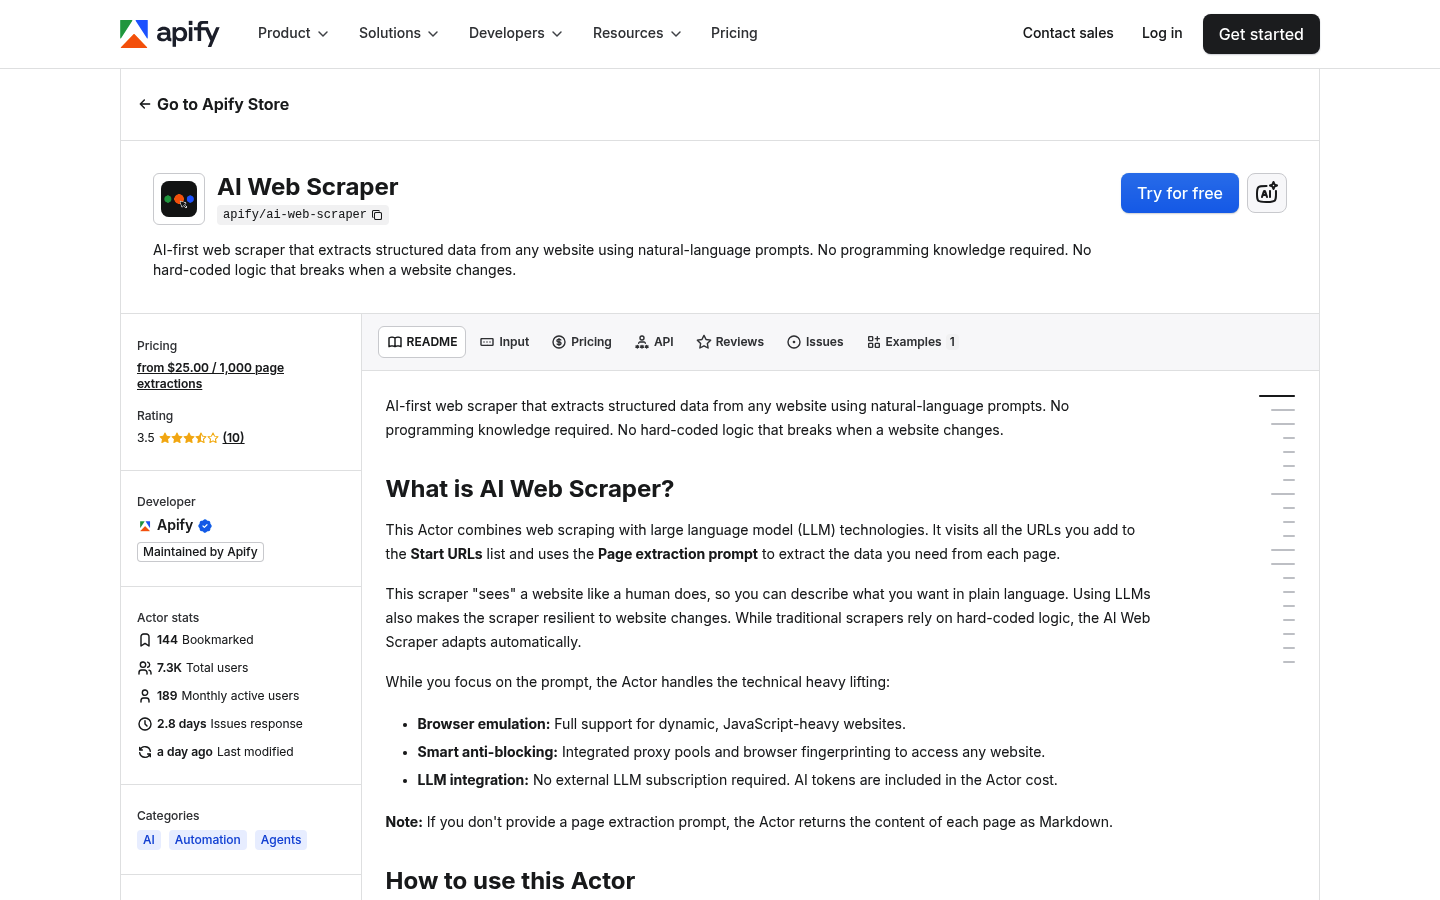
Apifyは、スケジュール設定、API経由のトリガー、またはパイプラインへの連結が可能な33,000以上の再利用可能な「アクター」(クラウドで実行されるサーバーレスプログラム)のマーケットプレイスを中心に構築されたフルスタックのウェブスクレイピングおよび自動化プラットフォームです。
その際立ったAI機能はAI Web Scraper Actorで、自然言語プロンプト(例:「このページから製品名と価格を抽出して」)を受け入れ、コードやCSSセレクタを必要とせずに構造化JSONを返します。これにより、Apifyは非技術系ユーザーにもアクセスしやすくなる一方、JavaScriptまたはPythonでカスタムアクターを構築する開発者にとっても高度に拡張可能です。
主な機能には以下が含まれます:
- 33,000以上のアクター:ソーシャルメディアからeコマース、不動産まであらゆる主要プラットフォーム向けの事前構築済みスクレイパー
- AI Web Scraper:コード不要の自然言語駆動抽出
- スケジューラとWebhook:cronスケジュールでアクターを実行するか、プログラム的にトリガー
- データセットストレージ:結果を永続化してエクスポートするための組み込みキーバリューストアとデータセット
- プロキシ管理:すべての実行にわたる統合されたレジデンシャルおよびデータセンタープロキシローテーション
価格:
- 無料:$0:$5分のプラットフォームクレジット、$0.20/コンピュートユニット
- Starter:$29/月:$29分のプラットフォームクレジット、$0.20/コンピュートユニット
- Scale:$199/月:$199分のプラットフォームクレジット、$0.16/コンピュートユニット(割引料金)
- Business:$999/月:$999分のプラットフォームクレジット
6. ScrapeGraphAI
ScrapeGraphAIは、自然言語プロンプトを使用してあらゆるウェブページから構造化データを抽出するためにLLMを使用するAIネイティブのウェブスクレイピングライブラリとクラウドAPIです。オープンソースライブラリは26,300以上のGitHubスターを獲得しており、商用APIはSOC 2 Type II認定を受けています。
ScrapeGraphAIの際立った特徴の一つは、LLMプロバイダーの柔軟性です:OpenAI、Anthropic、Google Gemini、Azure、Groq、Ollama(ローカルモデル)などをサポートしています。これにより、特定のモデルの好みやオンプレミス要件を持つチームにとって実用的な選択肢となっています。
主な機能には以下が含まれます:
- スクレイプ:オプションのステルスモードを使用して任意のURLをクリーンなMarkdown、HTML、またはスクリーンショットに変換
- 抽出:自然言語スキーマを使用したウェブページからのLLM駆動の構造化データ抽出
- 検索:1回の呼び出しで統合されたコンテンツ抽出を伴うウェブ検索
- クロール:設定可能な深さでページごとの抽出を伴うサイト全体のクローリング
- モニタリング:変更のためのウェブページ追跡とWebhook通知の受信
- 複数のAIプロバイダー:OpenAI、Anthropic、Gemini、Azure、Groq、Ollamaなど
価格:
- 無料:$0:500クレジット/月
- Starter:$17/月:10,000クレジット/月
- Growth:$85/月:100,000クレジット/月
- Pro:$425/月:750,000クレジット/月
- Enterprise:カスタムクレジットと専用サポート
7. Diffbot
Diffbotは、テンプレート設定なしに任意のウェブページのタイプ(記事、製品、人物、組織、レビュー、イベント)を自動的に識別し、完全に構造化されたJSONを返すエンタープライズグレードのAI抽出プラットフォームです。2012年に設立され、市場で最も確立されたAIウェブデータ企業の一つです。
ページレベルの抽出を超えて、Diffbotは310億以上の実世界のエンティティを含むナレッジグラフを運営しており、エンティティ解決、関係マッピング、大規模なナレッジベース構築を含むユースケースに適しています。
主な機能には以下が含まれます:
- 自動タイプ検出:設定なしで記事、製品、人物、イベントなどのページタイプを識別
- ナレッジグラフ:エンティティ解決とセマンティッククエリのための310億以上のエンティティと関係データ
- Crawl API:ドメイン全体をクロールし、発見されたすべてのページに抽出ルールを適用
- Natural Language API:テキストからのNLP駆動のファクトと関係抽出
- コーディング不要:サポートされているページタイプに対してセレクタ設定なしのREST API
価格:
- 無料:$0:10,000クレジット/月(1クレジット=1ページ抽出)
- Startup:$299/月:250,000クレジット/月($0.001/クレジット)
- Scale:$899/月:1,000,000クレジット/月($0.0009/クレジット)
- Enterprise:カスタムクレジット割り当てと価格
8. Browserbase
Browserbaseは、AIエージェントと自動化ワークフロー向けに設計されたクラウドホスト型ヘッドレスブラウザインフラです。従来の意味でのスクレイピングAPIというよりも、インフラレベルでステルスモードとプロキシローテーションが組み込まれた、Playwright、Puppeteer、またはSelenium経由でエージェントやスクリプトが制御するスケーラブルなリモートブラウザを提供します。
Browserbaseは、大規模で信頼性が高く観察可能なブラウザセッションを必要とするAIエージェント開発者に特に役立ちます。セッションリプレイとデバッグツールにより、各ブラウザセッションで何が行われたかを完全に把握でき、複雑なマルチステップワークフローの障害診断に不可欠です。
主な機能には以下が含まれます:
- ステルスブラウザ:組み込みのフィンガープリント管理とボット検出回避機能を備えたクラウドブラウザ
- Playwright/Puppeteer/Selenium互換:コード変更不要のローカルヘッドレスブラウザのドロップイン代替
- セッションリプレイ:デバッグと監査のための各ブラウザセッションの完全なビジュアルリプレイ
- 統合プロキシ:すべての有料プランに含まれるGB課金のレジデンシャルプロキシローテーション
- Stagehand SDK:自然言語ブラウザ自動化のためのBrowserbaseに基づいて構築されたオープンソースAIエージェントフレームワーク
価格:
- 無料:$0:プロトタイピング用の限定セッション
- Developer:$20/月:その後$0.12/ブラウザ時間
- Production:$99/月:その後$0.10/ブラウザ時間、5GBプロキシ込み
- Enterprise:専用インフラによるカスタム価格
9. Octoparse
Octoparseは、Windows/Macデスクトップアプリケーションとクラウドサービスの両方として提供される確立されたノーコードウェブスクレイピングプラットフォームです。2014年から市場に存在しており、コードを書かずに構造化データを必要とするビジネスアナリスト、市場調査担当者、オペレーションチームに広く利用されています。
Octoparseはビジュアルスクレイパーにページを読み込む際にデータフィールドとページネーションパターンを自動的に検出するためにAIを使用し、セレクタを手動で設定する場合と比較してセットアップ時間を大幅に削減します。250以上のテンプレートのライブラリには、多くの人気ウェブサイトとデータタイプがすぐに使える形でカバーされています。
主な機能には以下が含まれます:
- ビジュアルポイント&クリックスクレイパー:CSSセレクタやXPathなし:ライブページで必要なデータをクリックするだけ
- 250以上のテンプレート:Amazon、LinkedIn、Tripadvisorなど主要サイト向けの事前構築済みスクレイパー
- 自動ページネーション検出:AIが複数ページのデータセットを自動的に識別して処理
- クラウド抽出:Octoparseのクラウドサーバーで24時間365日タスクを実行し、Excel、CSV、JSON、またはデータベースにエクスポート
- IPローテーション:大規模実行中のブロックを軽減するための組み込みプロキシローテーション
- スケジュール実行:手動介入なしに固定スケジュールでスクレイパーを実行するよう設定
価格:
- 無料:$0:10スクレイピングタスク、50,000行/月エクスポート、ローカル実行
- Standard:$69/月から:100タスク、クラウド抽出、3つの同時クラウド実行
- Enterprise:$399から:カスタムタスク制限、専用クラウドリソース、優先サポート
- すべての有料プランに5日間の返金保証
まとめ
2026年のAIウェブスクレイピングの状況は大きく多様化しており、あらゆるレベルで強力な選択肢があります:Crawl4AIやScrapeGraphAIのようなオープンソースPythonライブラリから、Bright DataやDiffbotのようなフルエンタープライズプラットフォーム、そして非技術系ユーザー向けのBrowse AIやOctoparseのようなノーコードツールまで。
適切なツールは優先事項によって異なります。最大のスケール、信頼性、最も広いプロキシインフラへのアクセスが必要な場合、Unlocker API、Agent Browser、Web Scraper APIをカバーするBright Dataのスイートが最も完全な選択肢です。開発者向けのLLMパイプラインには、FirecrawlとCrawl4AIが最新のAIフレームワークとの最高の統合体験を提供します。既製のアクターマーケットプレイスを必要とするチームには、Apifyの33,000以上の事前構築済みスクレイパーがデータまでの時間を大幅に短縮します。
どのツールを選択しても、プロキシローテーションとアンチボットバイパスをネイティブに処理できることを確認してください:これらはもはや本番スクレイピングワークフローにとってオプションではありません。