Zillowのスクレイピングとは、価格モデル、投資分析ツール、市場ダッシュボードのために、Zillowの公開ページから物件情報、価格、不動産記録を収集することです。各ページには主要なデータがJSONとして埋め込まれています。
ZillowはデフォルトのPythonリクエストをブロックしますが、それは比較的簡単な問題です。より難しいのは、スクレイパーが気づかずに見逃してしまうデータです。ほとんどの物件ページにはHTMLに価格履歴が含まれておらず、1回の検索は984件の物件で止まり、これはヒューストンの販売物件のわずか6%に過ぎません。
このガイドでは、Pythonを使ったZillowのスクレイピング方法、価格履歴を含むすべての物件情報を取得する方法、そしてマネージド型スクレイパーの方がコストを抑えられる場合の判断基準を解説します。
要点まとめ
- ブラウザのTLSフィンガープリントを使用する。 ZillowはChromeヘッダーを使っていても、PythonデフォルトのTLSフィンガープリントをブロックします。Chromeになりすました
curl_cffiでは430ページ中429ページで成功しました。 - ページに埋め込まれたJSONを読み取り、価格履歴は別途取得する。 ほとんどの物件ページでは、HTMLのみを対象とするスクレイパーが行わない2回目のリクエストで価格履歴を読み込んでいます。
- 1回の検索は984件で止まるため、大規模な検索は分割する。 または、1つのURLからフォートウェインの全1,295件の物件を見つけたBright DataのZillow Scraper APIを使用します。
- ステータスコードだけでなく完全性もチェックする。 取得した行数をZillowが報告する合計数と比較し、失敗した行を再試行し、価格履歴のない過去の販売済み物件にフラグを立てます。
スクレイピング可能なZillowデータとその取得場所
スクレイパーはZillowの4つの主要なソースからデータを取得でき、Zillowのrobots.txtはそれぞれを異なる扱いにしています。
| データ | Zillow上のソース | robots.txtの記載内容 |
|---|---|---|
| 物件情報項目:価格、ベッド数、Zestimate、写真、担当エージェント | 物件ページHTML内の__NEXT_DATA__ JSON |
/homedetails/ページでは許可 |
| 価格履歴、税履歴、学区情報 | 通常、ページ読み込み後に送信される/graphql/リクエスト |
/graphql/は禁止 |
| 検索結果、1ページあたり41件 | /fort-wayne-in/2_p/のような都市ページ、または内部のasync-create-search-page-stateエンドポイント |
都市ページは許可、エンドポイントと?searchQueryState=URLは禁止 |
| 更新された物件情報 | robots.txtからリンクされたサイトマップ(latest.xml.gzなど) |
クローラー向けに公開 |
ZillowのページはNext.jsで構築されており、各ページには主要なデータが__NEXT_DATA__スクリプトタグ内にJSONとして埋め込まれていました。ページをレンダリングしなくてもこのJSONを読み取ることができます。この埋め込みデータの仕組みについては、Next.jsサイトのスクレイピングガイドで解説しています。
1件の物件情報と1回の検索のリクエストは、次のような流れになります。
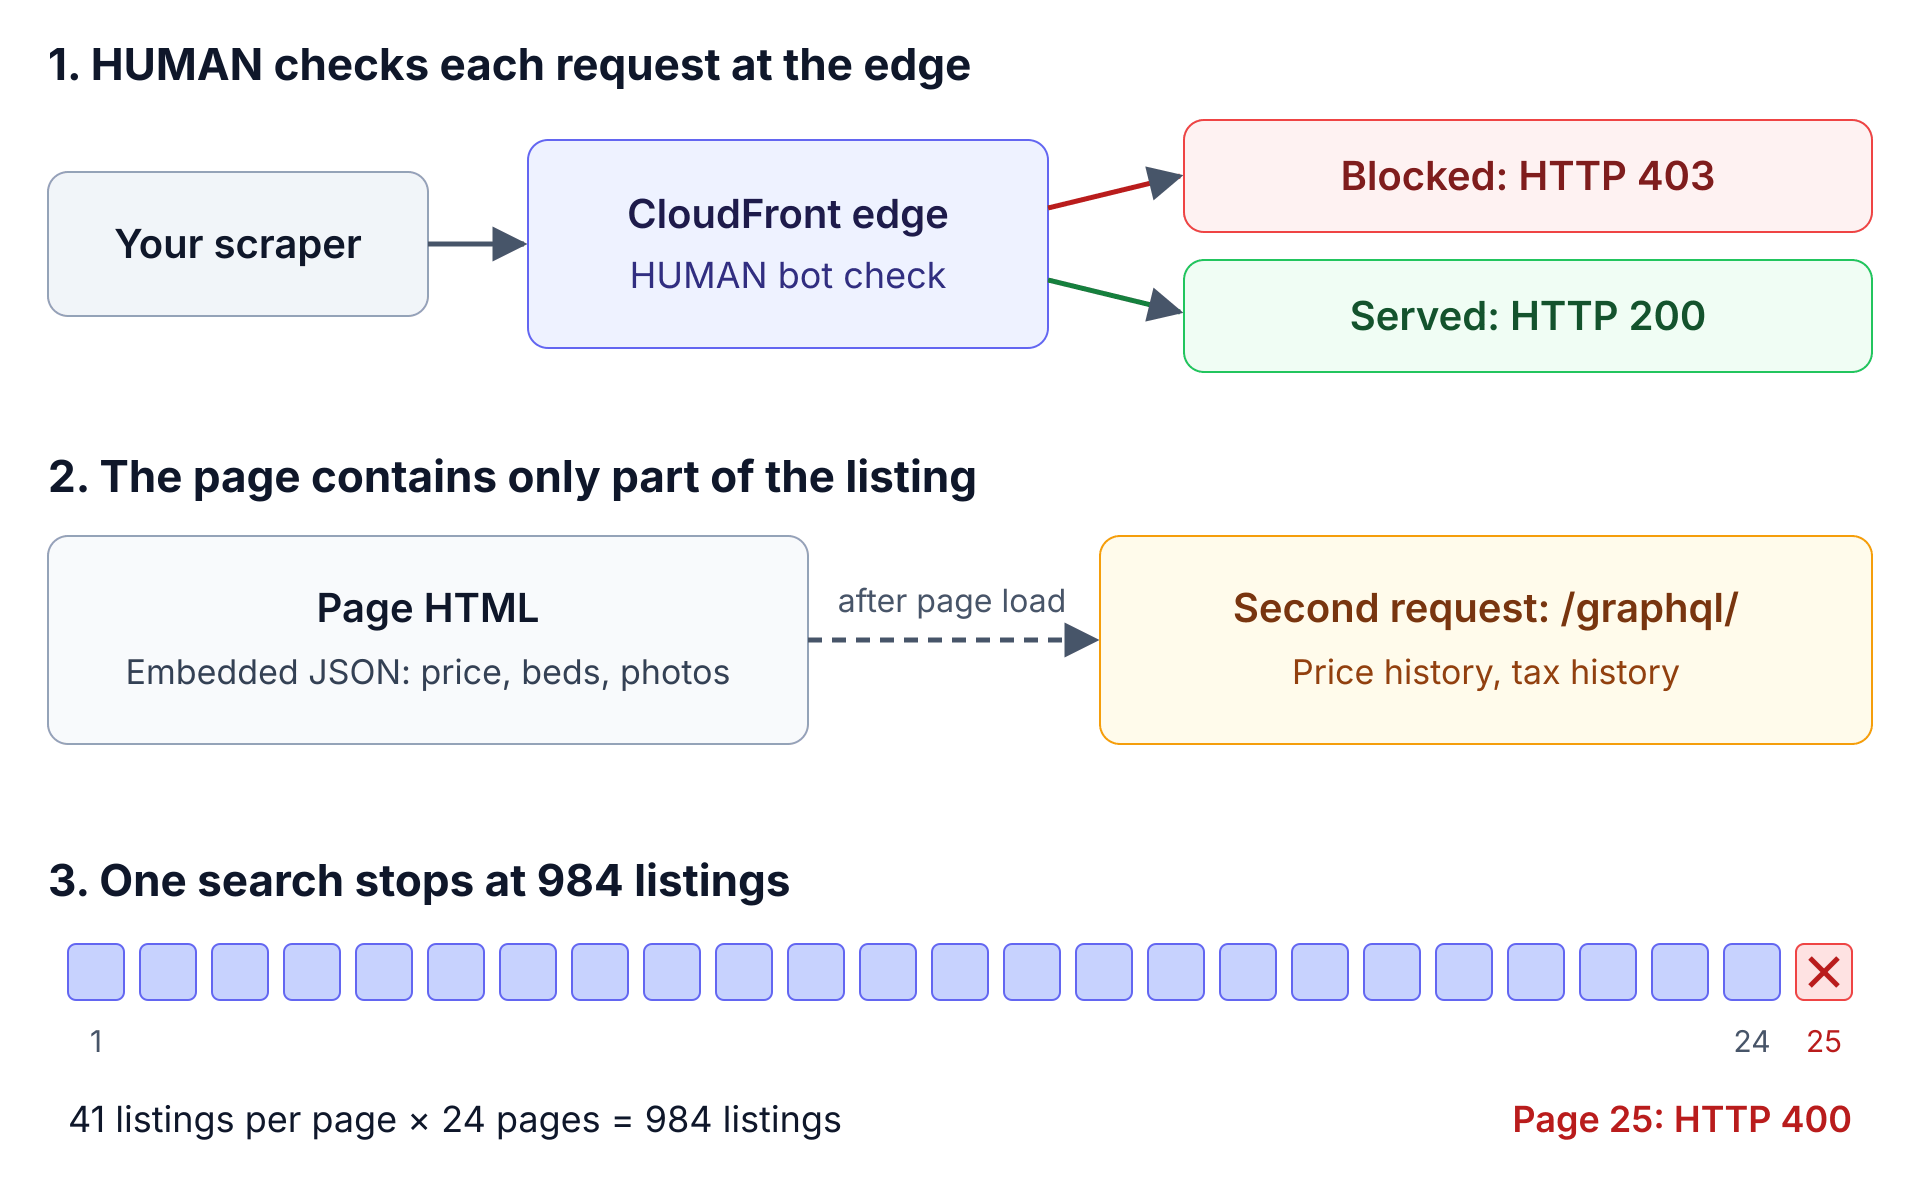
HUMANのボットチェックはHTMLが生成される前にエッジ側で実行され、価格履歴はページ読み込み後に読み込まれます。パーサーがHTMLのみを読み取る場合、ブロックされたページを空のページと誤認する可能性があり、ほとんどの物件で価格履歴を見逃します。
物件ページと価格履歴
物件情報のJSONは二重エンコードされているため、2回パースする必要があります。props.pageProps.componentProps.gdpClientCacheフィールドは文字列値を持ち、その文字列自体がJSONオブジェクトでした。そのキーはZillowの内部GraphQLクエリの名前でした。
販売中、取引終了、Zillow Showcaseの各物件タイプはそれぞれ独自のGraphQL操作名を使用していました。ForSalePriorityQueryには101フィールド、NotForSalePriorityQueryには122フィールド、ViewShowcasePriorityQueryには78フィールドがありました。パーサーが1つの操作名のみを想定している場合、他のものでは失敗します。代わりにキャッシュ内のすべてのエントリをマージすれば、1つのパーサーで3種類すべての物件タイプを処理できます。
ほとんどの物件では、価格と税履歴がそのJSONに含まれていませんでした。販売中の物件20件について、Bright DataのZillow Scraper APIはそれぞれ1件から18件の価格履歴イベントを返しました。同じページのHTMLにはこれらのイベントは一切含まれていませんでした。スクレイパーがHTMLのみを読み取る場合、これらの物件は価格履歴がないものとして記録され、エラーも発生しません。
ブラウザはページ読み込み後に履歴をリクエストしていました。販売中の物件の場合、そのリクエスト(ForSaleNonPriorityQuery)は21年分の税履歴を含む145の物件フィールドを返しました。取引終了済みのページでは異なるリクエストが使用され、ページがハッシュで呼び出す永続化GraphQLクエリでした。
検索ページと984件の上限
検索結果の1ページ分には__NEXT_DATA__ブロック内に41件の物件が含まれていましたが、HTMLカードとしてレンダリングされたのはそのうち9件のみでした。CSSセレクタでカードをパースすると、残りの32件を見逃します。古いZillowチュートリアルで使われていたarticle.list-cardなどのカードセレクタは、どの要素にも一致しませんでした。
Zillowは各検索にも制限を設けていました。1,000件を超える結果を報告する検索でも、独自のページネーションは20ページで止まりました。
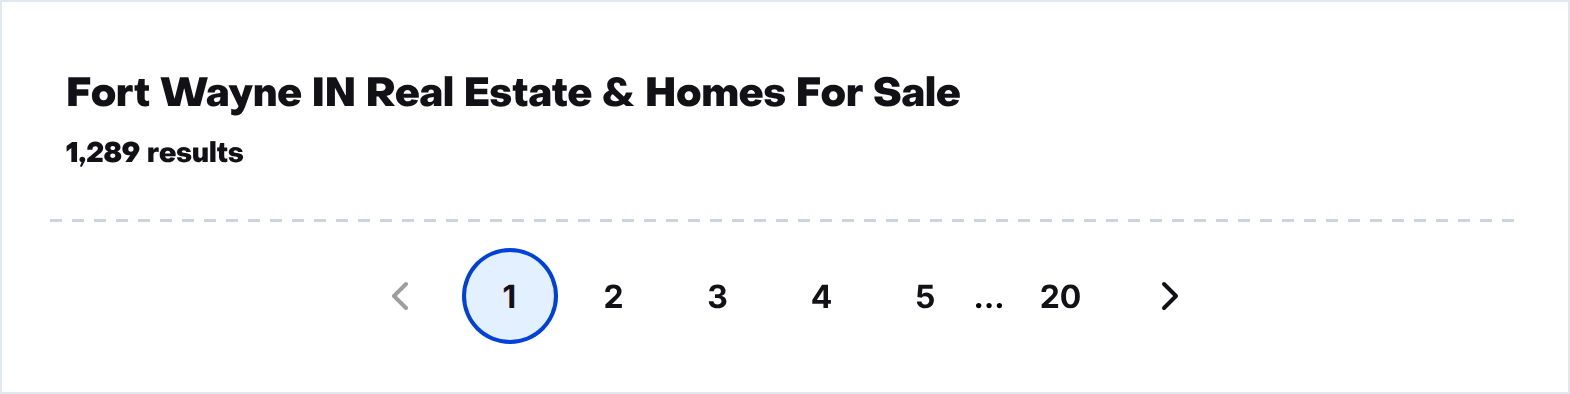
Zillowのフォートウェイン検索結果リストの上部と下部。合計件数(ここでは1,289件)は物件の追加・削除に応じて変化しますが、ページ番号は依然として20ページで止まっていました。
41件×20ページで820件となり、これは一部のスクレイピングツールが文書化している上限です。しかし、URLで直接リクエストすると21~24ページ目でもそれぞれ41件ずつ追加の物件が返され、25ページ目はHTTP 400エラーを返しました。そのため、1回の検索は984件に達し、これはフォートウェインの販売物件1,295件の76%、ヒューストン市の15,410件の6%に相当しました。それでも各レスポンスは常に完全な合計数を報告していたため、その数値を取得したデータと比較してください。
マークアップではなくJSONをパースすれば、1ページあたり9件ではなく41件すべての物件を取得できます。
ZillowがデフォルトのPythonリクエストをブロックする理由
Zillowのボット対策は、旧PerimeterXであるHUMAN Securityによるものでした。これを示す2つの手がかりがありました。ブロックページにはPerimeterXのアプリIDPXHYx10rg3が記載されており、robots.txtは/captchaPerimeterX/と/HYx10rg3/を禁止していました。
拒否はZillow自身のサーバーからではなく、Zillowの前段にあるコンテンツ配信ネットワーク(CDN)であるCloudFrontから返されていました。ブロックされたレスポンスはすべてHTTP 403で、x-cache: LambdaGeneratedResponseとx-px-blocked: 1が付与されていました。また、通常のページに含まれるx-envoy-upstream-service-timeヘッダーが欠けていました。スクレイパーは、ページをパースせずにこのx-px-blockedヘッダーをチェックすることでブロックを検知できます。
ブロックされたリクエストの様子
ChromeのUser-Agentを使ったcurlリクエストは拒否されました。
curl -s -o /dev/null -D - \
  -A "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36" \
  "https://www.zillow.com/homedetails/25875-Fox-Tail-Trl-South-Bend-IN-46628/77039629_zpid/"
エッジは0.32秒で応答し、5,952バイトの「Press & Hold」ページを返しました。
HTTP/2 403
server: CloudFront
content-length: 5952
x-px-blocked: 1
x-cache: LambdaGeneratedResponse from cloudfront
Playwrightから起動したヘッドレスChromiumも同じブロック(HTTP 403、x-px-blocked: 1)を受け、HUMANのチャレンジページがレンダリングされました。
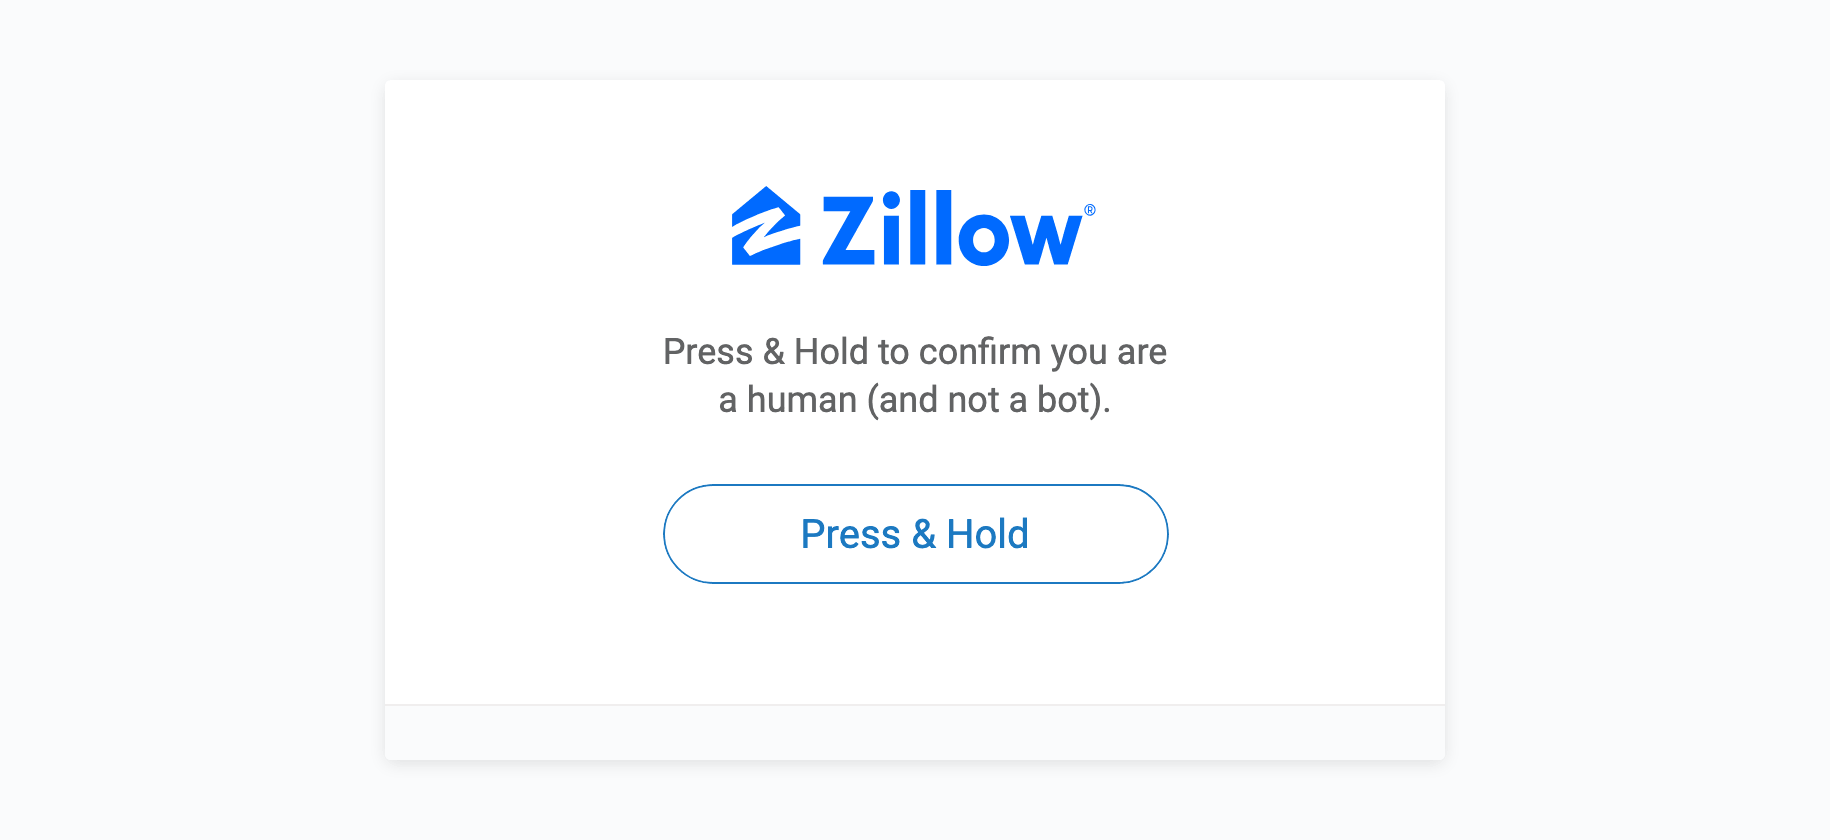
スクレイパーがこのページを受け取った場合、エッジ側で拒否されており、ページには物件データが含まれていません。
独自の回避コードを書かずにこのページに対処するには、Bright DataのZillow CAPTCHAソルバーを使用してください。
Zillowのボットチェックを通過するPythonクライアント
同じIPから、curlが拒否された数秒後に、curl_cffiは同じ物件情報の取得に成功しました。このライブラリはChromeのTLSハンドシェイクとヘッダーになりすまします。
python - <<'EOF'
from curl_cffi import requests

url = "https://www.zillow.com/homedetails/25875-Fox-Tail-Trl-South-Bend-IN-46628/77039629_zpid/"
r = requests.get(url, impersonate="chrome")
print(r.status_code, len(r.content))
EOF
HTTP 200と730,803バイトのHTMLが出力されました。
200 730803この2つのリクエストは、ヘッダーとTLSフィンガープリントの両方で異なっていました。TLSフィンガープリントとは、クライアントが接続を開く際に提示する暗号スイートと拡張機能のパターンです。サイトがこれらのフィンガープリントをどのようにボット検知に使うかについては、TLSフィンガープリンティングのガイドで解説しています。
Zillowがブロックしていない1つのレジデンシャルIPから、6種類のクライアントがそれぞれ物件ページと検索ページを取得し、両方で同じ結果になりました。
| クライアント | TLSフィンガープリント | 結果 |
|---|---|---|
Python requests、デフォルトヘッダー |
Python (OpenSSL) | 403 |
Python requests、ChromeのUser-Agentとブラウザヘッダー |
Python (OpenSSL) | 403 |
httpx、ブラウザヘッダー |
Python (OpenSSL) | 403 |
curl_cffi、impersonate="chrome" |
Chrome | 200 |
curl_cffi、impersonate="firefox" |
Firefox | 200 |
curl_cffi、impersonate="safari" |
Safari | 403 |
クライアントがPythonのTLSフィンガープリントを使用している場合、ブラウザヘッダーを追加しても効果はありません。Safariプロファイルも両方のページで拒否されたため、頼る前に各なりすましプロファイルをZillowに対してテストしてください。HTTP/1.1を強制した場合もChromeプロファイルは成功したため、HTTP/2の設定が決め手ではありませんでした。
ヘッダーとIPの評価が依然として重要な理由
Zillowはまた、リクエストのHTTPヘッダーが本物のブラウザのものに見えるかどうかもチェックします。プロキシがChromeのTLSフィンガープリントとリクエストごとに新しい米国IPを使用した場合、結果を左右したのはヘッダーのみでした。
PythonデフォルトのUser-Agentは5回中5回拒否され、ChromeのUser-Agentのみでは5回中5回成功しました。sec-ch-uaクライアントヒントを含まないChromeの完全なヘッダーセットは、10回中4回拒否されました。これは、Zillowが固定ルールではなく、各リクエストにリスクスコアを付与していることを示唆しています。
IPの評価も重要です。1つのレジデンシャルIPから約20件のリクエストが送信され、そのほとんどはZillowが拒否するクライアントからのものでした。その後、Zillowは数分前には成功していたChromeプロファイルも拒否するようになり、ブロックは6分以内に解除されました。
ChromeのTLSフィンガープリントと再利用されたCookieを使ったセッションは異なる挙動を示しました。そのようなセッション5つで、430件の物件リクエストのうち429件がページを返しました。唯一の失敗はHTTP 502であり、ブロックではありませんでした。HUMANは、1つのIPから12分間に250件送信された場合を含め、430件中1件も拒否しませんでした。
そのため、拒否されたことは即座に再試行する合図ではなく、そのIPを一時停止する合図として扱ってください。必要なプロキシIPの数を決める前に、IPごとのブロック率を測定しましょう。IPローテーションやブロック率を低く保つその他の方法については、ブロックされないウェブスクレイピングのガイドをご覧ください。
PythonとEcurl_cffiでZillowをスクレイピングする
以下のスクレイパーは、ページが使用しているのと同じJSONを読み取ります。Python 3.10以降とcurl_cffiが必要で、こちらはcurl_cffiを使ったウェブスクレイピングのガイドで紹介しています。仮想環境にライブラリをインストールしてください。
python3 -m venv .venv
source .venv/bin/activate  # Windowsの場合: .venv\Scripts\activate
pip install curl_cffiこのスクリプトzillow_diy.pyは、フォートウェインの検索ページを取得し、そこから3件の物件情報を読み取ります。
"""ブラウザのTLSフィンガープリントとページに埋め込まれたJSONでZillowをスクレイピングする。"""
import json
import re
import time

from curl_cffi import requests

NEXT_DATA = re.compile(
    r'<script id="__NEXT_DATA__" type="application/json">(.*?)</script>', re.S
)
# Chrome TLS + 対応するヘッダー。IPごとに1つのセッションを保持する
session = requests.Session(impersonate="chrome")


def next_data(url: str) -> dict:
    resp = session.get(url, timeout=30)
    match = NEXT_DATA.search(resp.text)
    # ブロックは403か200のcaptchaページの場合があるため、ステータスではなくデータの有無をテストする
    if resp.headers.get("x-px-blocked") or not match:
        raise RuntimeError(f"no page data for {url} (HTTP {resp.status_code})")
    resp.raise_for_status()  # Zillowの404ページにも__NEXT_DATA__が含まれる
    return json.loads(match.group(1))


def search_page(city: str, page: int) -> tuple[list[dict], int]:
    """サーバーレンダリングされた検索結果1ページ分と、Zillowが報告する合計件数。"""
    url = f"https://www.zillow.com/{city}/{page}_p/"
    cat1 = next_data(url)["props"]["pageProps"]["searchPageState"]["cat1"]
    return cat1["searchResults"]["listResults"], cat1["searchList"]["totalResultCount"]


def listing(url: str) -> dict:
    """物件情報のサーバーレンダリング部分:gdpClientCacheは二重エンコードされたJSON。"""
    props = next_data(url)["props"]["pageProps"]["componentProps"]
    cache = json.loads(props["gdpClientCache"])
    record = {}
    for query_result in cache.values():  # 例: ForSalePriorityQuery{...}
        record.update(query_result.get("property") or {})
    return record


if __name__ == "__main__":
    cards, total = search_page("fort-wayne-in", 1)
    print(f"page 1: {len(cards)} listings of {total} reported")
    for card in cards[:3]:
        time.sleep(2)
        home = listing(card["detailUrl"])
        history = home.get("priceHistory") or []
        print(home["zpid"], home["homeStatus"], home["price"], home["bedrooms"], "bd",
              home["livingArea"], "sqft | priceHistory:", len(history))
python zillow_diy.pyで実行すると、1ページ目で41件の物件が見つかり、開いた3件のうち2件には価格履歴がありませんでした。
page 1: 41 listings of 1295 reported
73145681 FOR_SALE 649900 4 bd 5124 sqft | priceHistory: 3
73159210 FOR_SALE 699900 4 bd 4132 sqft | priceHistory: 0
73110917 FOR_SALE 239900 3 bd 1468 sqft | priceHistory: 0
最初の物件はShowcase物件で、価格履歴がHTMLに含まれていました。他の2件については、Zillow Scraper APIがそれぞれ2件と3件の価格履歴イベントを返しましたが、HTMLには0件でした。2秒の待機時間を含め、実行全体には約11秒かかりました。
この方法には2つの制限がありました。まず、フォートウェインの都市ページの24ページ目はまだ41件の物件を返しましたが、25ページ目はHTTP 400エラーを返しました。1回の検索が到達できる件数より多い物件数がある都市の場合、より小さな検索が必要です。次に、不足している価格履歴は/graphql/からのみ取得できました。
都市を分割するには通常、/homes/と?searchQueryState=URLを使う郵便番号フィルタリングや条件付き検索が必要で、不足している価格履歴には/graphql/リクエストが必要です。Zillowのrobots.txtはこの3つすべてを禁止しているため、それらを呼び出すかどうかはチームのコンプライアンス判断となります。これらのルールの読み方と遵守方法については、ウェブスクレイピングにおけるrobots.txtのガイドで解説しています。
複数のIPからこのスクレイパーを実行するには、Bright Dataのレジデンシャルプロキシをセッションに渡してください。エンドツーエンドの暗号化接続については、ポート44445用にverify="brightdata_root_ca_44445.crt"でBright Dataの証明書を読み込んでください。
レジデンシャルIPは同意した実在の人々から提供されているため、Bright Dataのレジデンシャルプロキシを利用するには事前に承認された企業のKYC確認が必要です。この審査は特定のユースケースを承認するものなので、申請時にはZillowのパイプラインについて説明してください。KYC確認がない場合は、Web Unlocker APIがブロック解除を代行し、次のセクションで紹介するZillow Scraper APIが価格履歴付きの物件レコードを返します。
Zillow Scraper APIでZillowをスクレイピングする
Zillow Scraper APIはBright Dataのインフラ上で収集を実行し、ブロック解除とパースを代行し、JSONレコードを返します。配信されたレコードごとに料金が発生し、新規アカウントには毎月更新される5,000の無料クレジットが付与されます。以下のZillowスクレイパーが含まれており、以降のセクションでは物件情報、価格履歴、検索ページ、Full Propertiesスクレイパーと呼びます。
| スクレイパー | データセットID | 入力 | 出力 |
|---|---|---|---|
| Zillow物件情報リスティング | gd_lfqkr8wm13ixtbd8f5 |
物件URL、検索URL、または場所フィルター | 物件ごとに1レコード、最大139フィールド |
| Zillow価格履歴 | gd_lxu1cz9r88uiqsosl |
物件URL | 価格履歴イベントごとに1行 |
| Zillow物件検索ページ | gd_m71oxpvxwr113ehqg |
searchQueryState付きの検索URL |
検索結果ごとに1行、26フィールド |
| Zillow Full Properties Information | gd_m794g571225l6vm7gh |
物件URLまたは検索URL | 物件ごとに1レコード、price_historyのようなsnake_case形式のフィールド名 |
4つすべてが同じAPIリクエストでURLによる収集に対応しているため、変更が必要なのはデータセットIDのみです。Bright DataはZillow画像スクレイパーAPIや、不動産スクレイパーAPIシリーズの他の不動産サイト向けスクレイパーも提供しています。コントロールパネルでは、物件情報スクレイパーに3つの入力方法と同期・非同期モードが表示されます。
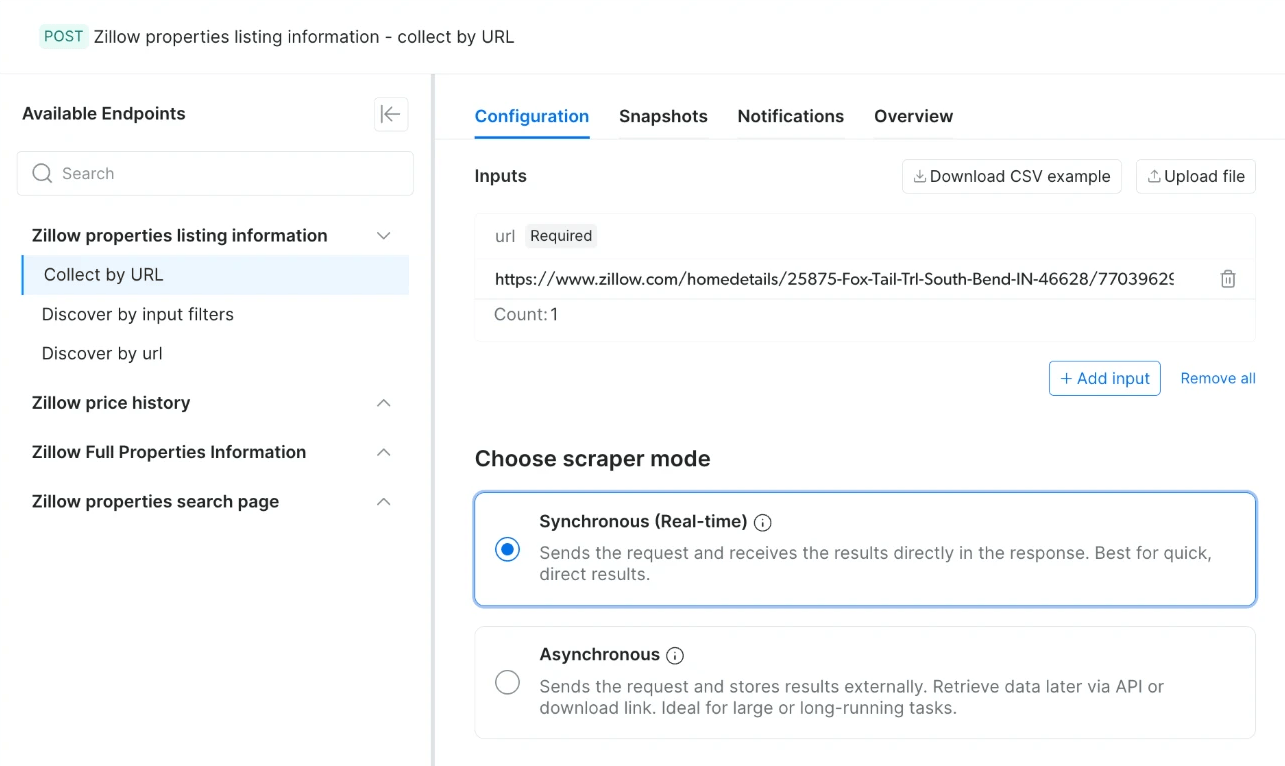
左パネルには上記の表と同じ4つのスクレイパーが表示されています。
物件情報と価格履歴を収集する
以下のスクリプトzillow_api.pyを実行するには、requestsパッケージ(pip install requests)とコントロールパネルから取得したAPIトークンが必要です。そのcollect()関数は同期エンドポイントを呼び出し、ジョブが1分以上かかる場合はポーリングに切り替えます。
"""Bright DataのZillow Scraper APIで物件情報、価格履歴、ディスカバリーを行う。"""
import os
import time

import requests

API = "https://api.brightdata.com/datasets/v3"
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_TOKEN']}"}
LISTINGS = "gd_lfqkr8wm13ixtbd8f5"       # Zillow物件情報リスティング
PRICE_HISTORY = "gd_lxu1cz9r88uiqsosl"   # Zillow価格履歴、イベントごとに1行


def collect(dataset_id: str, urls: list[str]) -> list[dict]:
    """同期呼び出しごとに最大20URL。1分を超えるジョブは202を返す。"""
    params = {"dataset_id": dataset_id, "include_errors": "true", "format": "json"}
    resp = requests.post(f"{API}/scrape", headers=HEADERS, params=params, timeout=120,
                         json={"input": [{"url": u} for u in urls]})
    if resp.status_code == 202:
        return wait_and_download(resp.json()["snapshot_id"])
    resp.raise_for_status()
    return resp.json()


def discover(search_url: str) -> list[dict]:
    """1つのZillow検索内のすべての物件情報を、完全なレコードとして収集する(非同期)。"""
    resp = requests.post(f"{API}/trigger", headers=HEADERS, timeout=60,
                         params={"dataset_id": LISTINGS, "include_errors": "true",
                                 "type": "discover_new", "discover_by": "url"},
                         json={"input": [{"url": search_url}]})
    resp.raise_for_status()
    return wait_and_download(resp.json()["snapshot_id"])


def wait_and_download(snapshot_id: str, poll_s: int = 15) -> list[dict]:
    while True:
        resp = requests.get(f"{API}/progress/{snapshot_id}", headers=HEADERS,
                            timeout=60)
        resp.raise_for_status()
        status = resp.json()["status"]
        if status == "ready":
            break
        if status in ("failed", "canceled"):
            raise RuntimeError(f"snapshot {snapshot_id} ended as {status}")
        time.sleep(poll_s)
    while True:  # ファイルの準備中はダウンロードが202を返す
        resp = requests.get(f"{API}/snapshot/{snapshot_id}", headers=HEADERS,
                            params={"format": "json"}, timeout=300)
        if resp.status_code != 202:
            resp.raise_for_status()
            return resp.json()
        time.sleep(10)


if __name__ == "__main__":
    homes = collect(LISTINGS, [
        "https://www.zillow.com/homedetails/25875-Fox-Tail-Trl-South-Bend-IN-46628/77039629_zpid/",
    ])
    for h in homes:
        print(h["zpid"], h["homeStatus"], h["price"], "| zestimate", h.get("zestimate"),
              "| priceHistory", len(h.get("priceHistory") or []),
              "| taxHistory", len(h.get("taxHistory") or []),
              "| collected", h.get("timestamp"))
    events = collect(PRICE_HISTORY, [
        "https://www.zillow.com/homedetails/2506-Gordon-Cir-South-Bend-IN-46635/77050198_zpid/",
    ])
    for e in events:
print(e["zpid"], e["date"][:10], e["event"], e["price"], e["source"])BRIGHTDATA_API_TOKENをエクスポートした状態で、2つの呼び出しは合計35~65秒かかりました。
77039629 FOR_SALE 359000 | zestimate 351600 | priceHistory 1 | taxHistory 21 | collected 2026-09-27T11:30:53.846Z
77050198 2023-03-03 Sold 265000 IRMLS
77050198 2023-02-03 Pending sale 264900 IRMLS
77050198 2023-02-01 Listed for sale 264900 IRMLSこの物件レコードは、Zillow自身のページが読み込む内容と一致しており、1件の価格履歴イベントと21年分の税履歴がありました。timestampは、Bright Dataがリクエスト中にリアルタイムで収集したことを示していました。
2軒目の物件、2506 Gordon Cirの3件のイベントは、Zillowページ上の価格履歴テーブルと一致しています。
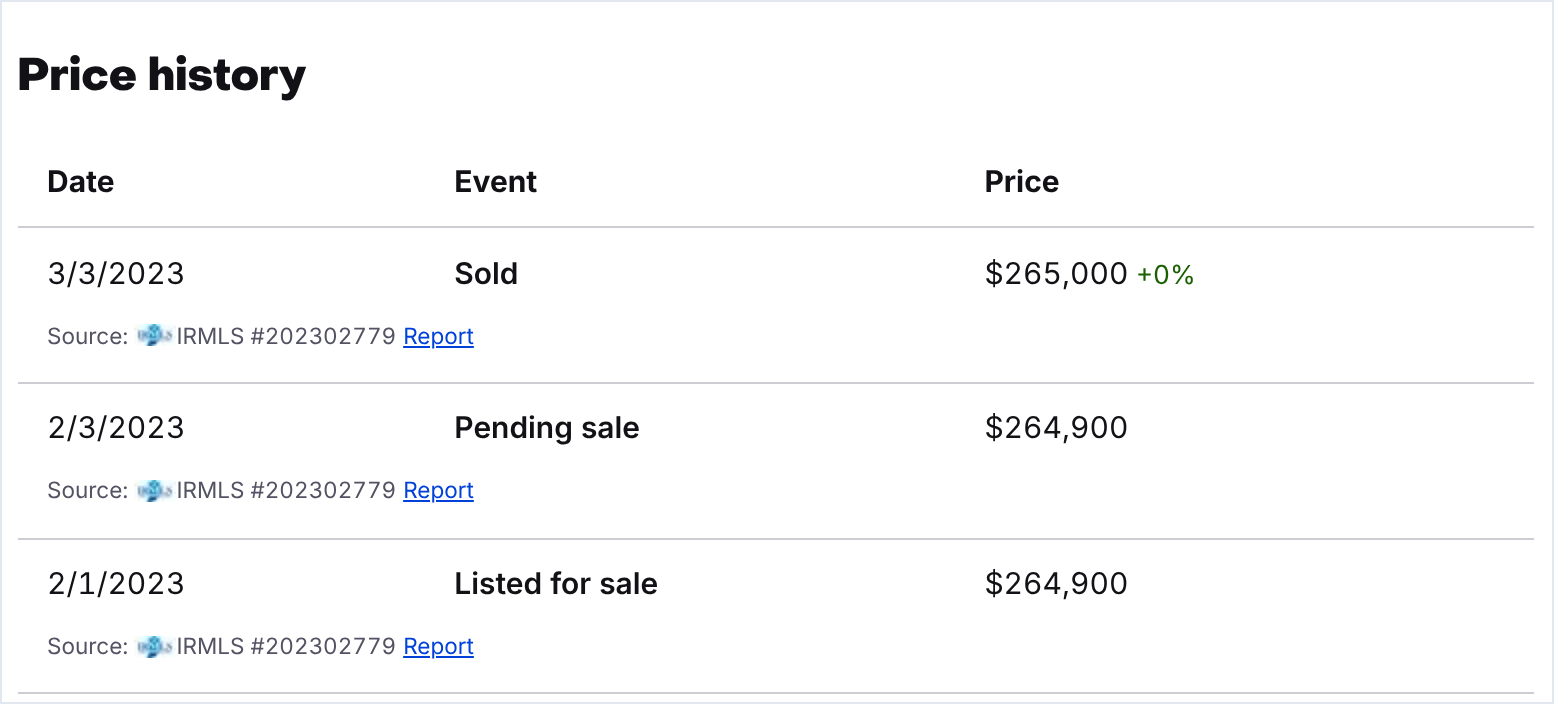
各行にはそのソース、すなわち地域のマルチプルリスティングサービス(MLS)が記載されており、API出力ではsourceフィールドに保持されています。
同期/scrapeエンドポイントは最大20URLを受け付け、ジョブが1分以内に完了すればデータを直接返します。より長いジョブの場合は、代わりにHTTP 202とスナップショットIDを返します。フォートウェインの物件20件のバッチには約4分かかったため、スクリプトが何かを出力するまで数分のポーリングを見込んでおいてください。より大きなバッチには、次のセクションでディスカバリーに使用する非同期/triggerエンドポイントを使用してください。
検索内のすべての物件情報を検出する
ディスカバリーは1つの検索URLから完全な物件レコードを収集でき、自作スクレイパーを止めていた984件の上限を超えることができます。上記のdiscover()関数は、フォートウェインの都市URLhttps://www.zillow.com/fort-wayne-in/を、物件情報スクレイパーのDiscover by URL入力方法を使って非同期/triggerリクエストで送信します。13~17分で、Zillowが報告した件数と同じ1,295行が返されました。代わりに小規模なサンプルが欲しい場合は、zillow_diy.pyのsearch_page()から最大20件の物件URLをcollect()に渡してください。
例えばテスト実行時など、各検索URLが返すレコード数を制限するには、JSONボディとして{"input": [...], "limit_per_input": 50}を送信してください。ポーリングの代わりに、/triggerに結果をウェブフックやS3に配信させることもでき、各スナップショットは30日間ダウンロード可能なままです。
価格、ベッド数、住所など検索結果のフィールドのみが必要な場合は、検索ページスクレイパーの方が高速です。searchQueryState付きのフォートウェイン検索URLから、65秒で1,154件のユニークな物件情報が返されました。すべての物件情報が必要な場合はディスカバリーを使用してください。
取引終了済み物件の価格履歴を取得する
販売中の物件については、物件情報スクレイパーのpriceHistoryは4件中4件でZillow自身のページと一致しました。取引終了済みの物件には、Full Propertiesスクレイパーを使用してください。取引終了済みの物件6件中6件で、snake_case形式のprice_history配列として価格履歴が返され、物件ごとに1レコードでした。
同じ6軒の物件について、価格履歴スクレイパーはイベントごとに1行を返しました。37秒で28行です。両方の出力は完全に一致しました。
課金は配信されたレコードごとに発生するため、5件のイベントがある物件は、価格履歴スクレイパーでは5レコード分、Full Propertiesでは1レコード分の課金となります。フォートウェインの物件は平均5件のイベントがあり、最大で29件でした。そのため、取引終了済みのURLはFull Propertiesスクレイパーに送信し、priceHistoryではなくprice_historyを読み取ってください。イベントごとに1行欲しい場合は価格履歴スクレイパーを使用してください。
ターミナルやAIエージェントから同じスクレイパーを実行する
Bright Data CLIは、物件情報スクレイパーをパイプラインコマンドとして実行でき、単発のジョブやコーディングエージェントに適しています。npm install -g @brightdata/cliでインストールし、一度bdata loginを実行すれば、1つのコマンドで物件情報を取得できます。
bdata pipelines zillow_properties_listing \
  "https://www.zillow.com/homedetails/25875-Fox-Tail-Trl-South-Bend-IN-46628/77039629_zpid/"
3分以内に、APIと同じレコードが、次のように始まる1行のJSONとして出力されました。
[{"zpid":77039629,"city":"South Bend","state":"IN","homeStatus":"FOR_SALE","address":{"city":"South Bend","streetAddress":"25875 Fox Tail Trl","zipcode":"46628","state":"IN"},"bedrooms":3,"bathrooms":2,"price":359000,"yearBuilt":1996,AIアシスタントがModel Context Protocol(MCP)を使用している場合、Bright Data MCPサーバーは同じスクレイパーをweb_data_zillow_properties_listingツールとして公開しています。このツールを使用するには、サーバーのbusinessツールグループを有効にしてください。各レコードにはtimestampが含まれているため、エージェントは価格を提示する前にその鮮度を確認できます。
同じサーバーを使った完全なエージェントの構築例については、CrewAIで不動産AIエージェントを構築するガイドをご覧ください。
Zillowデータを完全かつ最新の状態に保つ
レコードがデータウェアハウスに到達する前に、各実行結果をZillowが報告する合計数と照合してください。以下のチェックでは、エラー行、重複する物件情報、不足している価格履歴にもフラグを立てます。更新された物件情報のサイトマップを使えば、繰り返しの実行を小規模に保てます。
すべてのレコードを検証する
200レスポンスはリクエストが成功したことを示すだけで、データが完全であることは示しません。この検証スクリプト(validate.pyとして保存)は、エラー行を分離し、重複する物件情報を削除し、以前に売却されたが価格履歴のない物件にフラグを立てます。また、24時間以上前に収集されたレコードを古いものとしてカウントし、取得したレコード数をZillowの報告する合計数と比較します。
"""Zillowレコードがウェアハウスに到達する前に実行するチェック。"""
from datetime import datetime, timedelta, timezone


def validate(rows: list[dict], reported_total: int | None = None,
             max_age_h: int = 24) -> dict:
    errors = [r for r in rows if r.get("error_code") or r.get("error")]
    records, seen = [], set()
    for r in rows:
        if r in errors or r.get("zpid") in seen:
            continue
        seen.add(r.get("zpid"))
        records.append(r)
    # 以前に売却された物件には価格履歴があるはずなので、履歴の欠如はギャップであり、事実ではない。
    history_gaps = [r["url"] for r in records
                    if (r.get("lastSoldPrice") or r.get("dateSoldString"))
                    and not r.get("priceHistory")]
    cutoff = datetime.now(timezone.utc) - timedelta(hours=max_age_h)
    stale = [r["url"] for r in records
             if datetime.fromisoformat(r["timestamp"].replace("Z", "+00:00")) < cutoff]
    report = {"records": len(records), "error_rows": len(errors),
              "duplicates": len(rows) - len(errors) - len(records),
              "history_gaps": history_gaps, "stale": len(stale),
              "retry": [e.get("input", {}).get("url") for e in errors]}
    if reported_total:
        report["coverage"] = round(len(records) / reported_total, 3)
return reportrun_pipeline.pyスクリプトは、フォートウェインのディスカバリーを実行してから、行を検証します。
"""1つのZillow検索内のすべての物件情報を検出し、その結果を検証する。"""
import json
import time

from validate import validate
from zillow_api import discover

start = time.time()
rows = discover("https://www.zillow.com/fort-wayne-in/")
report = validate(rows, reported_total=1295)  # Zillowの合計数、例えばsearch_page()から取得
print(f"{len(rows)} rows in {round((time.time() - start) / 60, 1)} min")
counts = {k: (len(v) if isinstance(v, list) else v) for k, v in report.items()}
print(json.dumps(counts))
json.dump(rows, open("fort_wayne.json", "w"))
ディスカバリーは1,295行を返し、検証スクリプトはそのうち1,270件をレコードとして保持しました。
1295 rows in 12.9 min
{"records": 1270, "error_rows": 25, "duplicates": 0, "history_gaps": 0, "stale": 0, "retry": 25, "coverage": 0.981}
カバレッジは、Zillowが報告した1,295件のうち98.1%でした。この実行では重複はなく、価格履歴チェックに失敗したレコードもありませんでした。このチェックは以前に売却された物件のみにフラグを立てるため、新築計画のように元々価格履歴がない物件は無視されます。
データ内のSold価格の欠如が、必ずしもスクレイピングエラーとは限りません。ヒューストンの8件の物件では、販売価格が公開記録にならないテキサス州の特性上、2件のSoldイベントのどちらにも価格がありませんでした。
価格履歴チェックでフラグが立てられたURLはFull Propertiesスクレイパーに送信し、retryのURLを再送信してください。それでも完全なレコードが不足している物件については、検索ページスクレイパーの結果に価格、ベッド数、住所が含まれています。
変更があった物件情報のみを更新する
Zillowのrobots.txtには、物件ステータスごとにサイトマップインデックスが記載されていました。エージェント経由の販売物件インデックスにはlatest.xml.gzサイトマップが含まれていました。このスクリプトchanged_listings.pyは、Web Unlocker APIを通してそれを読み取り、インディアナ州の物件情報を保持します。実行前に、コントロールパネルでWeb Unlockerゾーンを作成し、その名前をスクリプトに記入してください。
"""robots.txtからリンクされたサイトマップから、1つの州で最近変更されたZillow物件情報を一覧表示する。"""
import gzip
import os
import re

import requests

SITEMAP = "https://www.zillow.com/xml/sitemaps/us/hdp/for-sale-by-agent/latest.xml.gz"
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_TOKEN']}"}


def unlock(url: str, attempts: int = 2) -> bytes:
    # "web_unlocker"を自分のWeb Unlockerゾーン名に置き換えてください
    payload = {"zone": "web_unlocker", "url": url, "format": "raw", "country": "us"}
    for _ in range(attempts):  # 一時的なエラーの場合は1回再試行する
        resp = requests.post("https://api.brightdata.com/request", headers=HEADERS,
                             json=payload, timeout=180)
        # Web Unlockerはこのヘッダーにターゲット自身のステータスコードを返す
        if resp.headers.get("x-brd-status-code") == "200":
            return resp.content
    raise RuntimeError(f"{url}: {resp.headers.get('x-brd-status-code')} "
                       f"{resp.headers.get('x-brd-error')}")


body = unlock(SITEMAP)
# ファイルはすでにデコードされた状態で届く場合がある
xml = (gzip.decompress(body) if body[:2] == b"\x1f\x8b" else body).decode()
entries = re.findall(r"<loc>([^<]+)</loc>\s*<lastmod>([^<]+)</lastmod>", xml)
indiana = [(url, mod) for url, mod in entries if re.search(r"-IN-\d{5}/", url)]
dates = [mod for _, mod in entries]
print(f"{len(entries)} changed listings nationwide, {len(indiana)} in Indiana")
print("oldest change:", min(dates), "| newest:", max(dates))
print(indiana[0][0])
このファイルには、全米で5万件の変更された物件情報がリストされており、そのうち1,014件がインディアナ州のものでした。
50000 changed listings nationwide, 1014 in Indiana
oldest change: 2026-09-24T14:08:00Z | newest: 2026-09-27T07:51:00Z
https://www.zillow.com/homedetails/600-W-Cyprus-Cir-Bloomington-IN-47403/94517948_zpid/サイトマップファイルは最大5万件のURLをリストでき、この5万件の変更は約3日間にわたっていました。そのため、毎日の実行では、前回の実行以降に変更された自分のエリアの物件情報のみを再収集でき、コストを低く抑えられます。それらを一度に20URLずつ、または1回の/triggerジョブでcollect()に送信してください。このファイルには何が変更されたかが記載されており、Zillow上のすべての物件が記載されているわけではありません。
4つの販売物件インデックスのサイトマップには、検索ページスクレイパーが見つけたフォートウェインの1,154件の物件のうち749件、つまり65%がリストされていました。217件の新築物件は1件も表示されていませんでした。再収集すべき対象の判断にはサイトマップを使用し、存在するものの発見にはディスカバリーを使用してください。
各アプローチの規模別コスト
ページを取得する最も安価な方法が、必ずしも完全なデータセットを取得する最も安価な方法とは限りません。以下の各アプローチはいずれもZillowのデータを返しましたが、完全性と、残された作業量が異なります。価格は公開時点のリスト料金であり、最新の料金は料金ページでご確認ください。
| アプローチ | 支払い内容 | 結果 | 残りの作業 |
|---|---|---|---|
自社IPでのcurl_cffi |
自社サーバーとプロキシトラフィック | 430ページ中429ページで成功、検索は984件に制限、HTMLには通常価格履歴なし | フィンガープリントの更新、IPの評価、検索の分割、価格履歴 |
| Web Unlocker API | 成功したリクエスト1,000件あたり1.50ドル | 物件ページ10件中10件成功、中央値4.5秒 | パース、検索の分割、価格履歴 |
| Browser API | 1GBあたり8ドル | 物件1件あたり3.97MB、約0.03ドル、価格履歴もレンダリングされる | ブラウザスクリプト、パース |
| Zillow Scraper API | レコード1,000件あたり1.50ドル | 1つのURLからフォートウェインの全1,295件の物件情報を発見、販売中・取引終了済み双方の価格履歴を取得 | 検証 |
| Zillowデータセット | レコード1,000件あたり最大2.50ドル、最低注文額250ドル | マーケットプレイスに1億3,742万件の不動産レコード、ほとんどが取引終了済み物件 | 更新スケジュールの選択 |
Web Unlockerは成功したリクエストに対してのみ課金され、x-brd-status-codeヘッダーにターゲットサイトのステータスコードを返すため、コード内でこのヘッダーを確認してください。例えば、存在しない物件へのリクエストはx-brd-status-code: 404を返しました。Browser APIは追加コードなしで価格履歴テーブルをレンダリングし、完全なブラウザセッションが必要なページに適しています。
自作アプローチには、表の価格には表れない保守コストもあります。クライアント向けに毎日Zillowスクレイパーを運用しているある開発者は、Zillowがアップデートを行うたびに四半期ごとに動かなくなると報告しています。Zillowのページを見ればその理由がわかります。各物件タイプはJSON内で独自のGraphQL操作名を使っており、article.list-cardのような古いチュートリアルのカードセレクタは何にも一致しませんでした。
データセットは異なる目的を持っています。Bright DataのZillow物件情報データセットには1億3,700万件を超える不動産レコードが含まれています。そのほとんどは取引終了済みの物件であり、販売中の物件だけでなくすべての不動産が必要な評価モデルや調査に適しています。購入者は毎日、毎週、毎月、またはカスタムスケジュールで更新を受け取ることができ、Scraper APIはオンデマンドで現在の物件情報を収集します。
単一ページの取得コストではなく、ディスカバリー、物件詳細、価格履歴、再試行を含めたパイプライン全体のコストを比較してください。社内でスクレイパーを運用する場合の全体コストについては、マネージド型とDIY型のウェブスクレイピングの比較ガイドで試算しています。
まとめ
Zillowのページを取得するには、ブラウザのTLSフィンガープリントを持つクライアントが必要です。各検索が984件で止まり、ほとんどの物件ページが2回目のリクエストで価格履歴を読み込むため、完全なデータを取得する方がより難しい課題です。価格履歴が不要な小規模エリアでの単発ジョブには、curl_cffiスクレイパーで十分です。スケジュールに沿って価格履歴付きのすべての物件情報が必要な場合は、Bright DataのZillow Scraper APIが両方を代行してくれます。
Bright Dataの無料アカウントを作成し、自分の市場の1つの検索URLでディスカバリーを実行して、取得した行数をZillowの報告する合計数と比較してみてください。
よくある質問
Zillowからデータをスクレイピングできますか?
はい、クライアントがブラウザのTLSフィンガープリントを使用している場合は可能です。PythonのrequestsライブラリはHTTP 403を受け取りますが、Chromeになりすましたcurl_cffiはページを取得できます。物件情報の項目は各ページに埋め込まれたJSONにあるため、パーサーはHTMLレイアウトに依存せずにそれらを読み取ることができます。
なぜZillowはすべての物件情報を表示しないのですか?
Zillowは各検索に制限を設けています。ページネーションは20ページを表示しますが、サイトは1ページあたり41件で24ページ分を提供するため、1回の検索は最大でも984件にしか到達しません。大きなエリアはより小さな検索に分割するか、1つのURLからフォートウェインの全1,295件の物件情報を見つけたBright DataのZillow Scraper APIを使用してください。
Zillowの価格履歴データを取得するにはどうすればよいですか?
Bright DataのZillow Scraper APIを使用してください。その販売中物件のレコードには価格履歴が含まれており、Full Propertiesスクレイパーは取引終了済みの物件についてもそれを返します。ほとんどの物件ページは2回目のリクエストで価格履歴を読み込むため、HTMLのみを対象とするスクレイパーはそれを見逃します。郵便番号別の市場動向については、Zillow Researchが無料のCSVを公開しています。
Zillowにはオープンなapiがありますか?
いいえ。MLS物件情報、公的記録、Zestimateに関するZillow GroupのAPIは承認が必要で、1日あたりの呼び出し回数を制限し、データの保存も制限されています。Zillow Researchは市場レベルのデータのみを無料のCSVで提供しています。物件レベルのデータについては、Bright DataのZillow Scraper APIが物件情報と価格履歴を構造化されたJSONとして返します。
Zillowを無料でスクレイピングするにはどうすればよいですか?
Chromeになりすます無料のPython HTTPクライアントであるcurl_cffiを使い、物件ページをゆっくり取得して、埋め込まれたJSONをパースしてください。この方法は1回の検索につき984件で止まり、ほとんどの価格履歴を見逃します。新規Bright Dataアカウントには、クレジットカード不要で毎月5,000の無料クレジットが付与され、これはZillow Scraper APIの5,000レコード分に相当します。
コーディングなしでZillowをスクレイピングするにはどうすればよいですか?
マネージド型スクレイパーのノーコードダッシュボードを使用してください。Bright Dataのコントロールパネルで、Zillow Scraper APIを開き、物件URLまたは検索URLを貼り付けて実行を開始します。その後、レコードをJSONまたはCSVとしてダウンロードします。市場全体が必要な場合は、スクレイピングの代わりに既製のZillowデータセットを購入することもできます。
ChatGPTはウェブスクレイピングができますか?
ChatGPTはスクレイパーのコードを書くことができますが、他のツールなしで大規模にZillowのデータを収集するようには設計されていません。AIエージェントは、Bright Data MCPサーバー内のZillow物件情報ツールを呼び出すことで構造化された物件情報を取得し、返されたJSONを処理します。エージェントが価格を提示する前に、各レコードのタイムスタンプを確認してください。