Etsyのスクレイピングとは、Etsyの公開ページから出品・ショップ・レビューのデータを収集することを意味します。Etsyは2025年の年次報告書で1億件以上の商品と560万のアクティブな出品者を報告しています。EtsyはDataDomeを使用しています。直接リクエストを送ると403とブロックページが返されます。最初に試される2つの対策は通常、ChromeのUser-AgentとTLSなりすましです。どちらも403を返します。本ガイドでは、何が403を変化させるか、robots.txtが何をブロックするか、そしてどの抽出上の問題がエラーを出さずにEtsyのデータセットを破損させるかを示します。
要約
- EtsyはFastlyの背後でDataDomeを動かしています。DataDomeは独自のレスポンスヘッダーにリスクスコアを入れます。クローラーを書く前にリクエストを採点できます。
- 試した9種類のトランスポートすべてをEtsyは拒否しました。ヘッド付きブラウザは最初のページを2.2秒で読み込みました。Etsyは2回目のリクエストを拒否しました。
- robots.txtはキーワード検索と販売履歴を禁止し、サイトマップなしと宣言しています。出品ページとショップページはそこでは開いたままでした。ただしEtsyの規約はより厳しいものです。
- 通貨と価格は出口IPに従います。当社のデータセットのサンプルには19種類の通貨がありました。その列のフィルタリングされていない平均値は227倍も高すぎました。
自動化されたリクエストに対してEtsyが返すもの
まずは拒否の内容を読んでください。リクエストを再試行しないでください。単純なリクエストで、どのベンダーがエッジで動作していて、そのベンダーがあなたをどう採点したかがわかります。どの出品URLでも機能します。これは出品者のものなので、すでに削除されている可能性があります:
curl -sD - -o /dev/null https://www.etsy.com/listing/753913297/smoky-quartz-ring-rose-gold-ring-womenサーバーは以下のヘッダーとともに403を返します:
HTTP/2 403
server: DataDome
x-datadome: protected
x-datadome-riskscore: 0.9230727100377928
accept-ch: Sec-CH-UA,Sec-CH-UA-Mobile,Sec-CH-UA-Platform,Sec-CH-UA-Arch,Sec-CH-UA-Full-Version-List,Sec-CH-UA-Model,Sec-CH-Device-Memory
set-cookie: datadome=ovuDEZ4S0taK1jDAOvZ9W3Uq2qUujN_iPPE3uXp7~r3msKXSvMFPp4j30em5IvR0...
via: 1.1 varnish
x-served-by: cache-del-vibw2260027-DEL
このブロックには3つの事実が含まれます。Etsyは、古いガイドが今も報告しているAkamai Bot Managerではなく、DataDomeを使用しているため、DataDomeの検出レイヤーを前提に計画を立ててください。FastlyはEtsyの前段で動作しており、ViaとX-Served-Byのヘッダーがそのホップを示しています。X-DataDome-riskscoreは、1.0が最悪とするスケールで、リクエストがどれほどボットらしく見えたかというDataDomeのスコアです。Etsyはベンダーを切り替える可能性があるため、この3つの事実をもとに計画を立てる前に、このコマンドを再実行してください。
そのヘッダーは、比較対象となる数値を与えてくれます。当社のテストでは、スコアは決定論的でした。同じリクエストの6回のインターリーブされたサンプルはすべて0.9230727100377928を返しました。このスコアは、リクエストのシグネチャ、呼び出し元のIP、そしてクッキーを返し始めた後のdatadomeクッキーを追跡するものであり、実行中のリクエスト数のカウントではありません。そのため、あなた自身の数値は異なる可能性があり、別のアドレスではクライアント構成間のランキングも異なる場合があります。
本文は、当社の実行では776バイトで、ct.captcha-delivery.com/c.jsを読み込むDataDomeのブロックページです。そのブロックページには、出品データではなくチャレンジスクリプトが含まれているため、パーサーがそれを読み込むとエラーではなく空のフィールドが返されます。埋め込まれた設定には't':'fe'、つまりDataDomeのデバイスチェックが含まれており、そのフェッチは永久的な禁止ではなく、実際のブラウザなら答えられるチャレンジを受け取りました。't'フィールドは現在のグレードを表し、グレードが変わると別の値を取るため、'fe'を前提とせず自分自身の値を読み取ってください。
すべてのリクエストを、3つのヘッダーのみを持つ1つの最小限のクライアントから送信し、パスのみを変更しました。試した出品コンテンツのパスはすべて同じ403と同じ0.482のスコアを返した一方、/robots.txtと解決不能なURLは保護されていないApacheに到達しました:
path                                       HTTP server     riskscore
/                                          403  DataDome   0.482
/listing/753913297/smoky-quartz-ring...    403  DataDome   0.482
/shop/AnemoneJewelry                       403  DataDome   0.482
/legal/terms/                              403  DataDome   0.482
/robots.txt                                200  Apache     -
/nonexistent-path-xyz                      404  Apache     -
つまり、DataDomeが保護しているパスでは、URLではなく呼び出し元を採点しています。
GooglebotのUser-Agentを使ったリクエストはDataDomeを回避し、代わりにレート制限機構に到達しました。Apacheはnicki_という参照文字列とともに429 Too Many Requestsを返しました。少なくとも1つの宣言された検索エンジンのエージェントは、DataDomeとは別の独自のレート制限機構に到達します。
ヘッダーとTLSフィンガープリントだけでは不十分な理由
リスクスコアがあることで、数値が低いほどボットらしさが少ないとされる、ヘッダーに関する一般的なアドバイスをテストできます。IPとURLを固定し、requestsクライアントのリクエストヘッダーのみを変化させて、DataDomeが返したスコアを記録しました:
headers sent                                         score    HTTP
requests, library default headers                    0.977    403
+ Chrome User-Agent only                             0.923    403
full 12-header Chrome set                            0.503    403
User-Agent + accept + sec-fetch-site (3 headers) 0.482 403この表には2つの結果が含まれています。ChromeのUser-Agentを追加しても、リクエストの他の部分が依然としてrequests由来だったため、グレードはほとんど動きませんでした。また、3ヘッダーのセットは、12ヘッダーのフルセットよりも良いスコアとなったため、このターゲットではヘッダー数よりも一貫性のほうが重要でした。
これら3つのヘッダーは0.482のスコアとなったため、acceptの値を正確にコピーしてください:
User-Agent:      Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36
                 (KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36
accept:          text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,
                 image/webp,image/apng,*/*;q=0.8,application/signed-exchange;v=b3;q=0.7
sec-fetch-site:  none
フルセットから1つずつヘッダーを削除し、各変化を記録しました。プラス記号はスコアが悪化したことを意味します:
run                              score     change
full set (baseline)              0.503
minus accept                     0.845     +0.342
minus user-agent                 0.784     +0.281
minus sec-fetch-site             0.669     +0.166
minus every sec-ch-ua* header 0.503 0.000DataDomeは独自のAccept-CHレスポンスヘッダーで7つのクライアントヒントを広告しています。当社のフルセットにはそのうち3つが含まれていましたが、すべてのsec-ch-uaヘッダーを削除しても何も変わりませんでした。acceptヘッダーは、User-Agentよりもスコアを大きく動かしました。
TLSなりすましは通常次のステップなので、単独でテストしました。各実行では同じ3つのヘッダーを送信し、TLSとHTTP/2のフィンガープリントのみを変更しました。以下のJA4値は、Etsyからのものではなくcurl_cffi由来のものであり、そのライブラリがプロファイルを更新するたびに変化します:
transport                             JA4                      riskscore  HTTP
python requests (OpenSSL, HTTP/1.1)   t13d1712h1_ab0a1bf427ad  0.482      403
curl_cffi impersonate=chrome110       t13d1516h2_8daaf6152771  0.663      403
curl_cffi impersonate=chrome116       t13d1516h2_8daaf6152771  0.663      403
curl_cffi impersonate=chrome124       t13d1516h2_8daaf6152771  0.503      403
curl_cffi impersonate=chrome131       t13d1516h2_8daaf6152771  0.503      403
curl_cffi impersonate=chrome133a      t13d1516h2_8daaf6152771  0.503      403
curl_cffi impersonate=firefox133      t13d1716h2_5b57614c22b0  0.503      403
curl_cffi impersonate=safari17_0      t13d2014h2_a09f3c656075  0.663      403
curl_cffi impersonate=safari17_2_ios t13d2014h2_a09f3c656075 0.663 403この表には、Chrome、Firefox、Safariそれぞれ1つずつ、合計3種類の異なるフィンガープリントが含まれています。プレーンなrequestsをHTTP/1.1で使った場合でも、この3つすべてより良いスコアでした。この列にはJA4の最初の2部分のみが表示されています。3番目の部分は拡張機能のリストをエンコードしており、ここでプレフィックスを共有するChromeのプロファイル間で異なります。
トランスポートは、最良の実行と最悪の実行の間でスコアを0.181動かしましたが、どの実行もページを返しませんでした。テストしたどのフィンガープリントも単独では不十分でした。
そのため、このターゲットではTLSフィンガープリントは労力に見合いません。各プロファイルからHTTP/2のフレームを読み返し、エンジンごとに異なる疑似ヘッダーの順序も含めました:
profile      SETTINGS                       | window   | pri | pseudo-header order
chrome131    1:65536;2:0;4:6291456;6:262144 | 15663105 | 0   | m,a,s,p
firefox133   1:65536;2:0;4:131072;5:16384   | 12517377 | 0   | m,p,a,s
safari17_0   2:0;4:4194304;3:100            | 10485760 | 0   | m,s,p,a
これら3つのハンドシェイクは正しいコピーであり、Etsyは3つすべてを拒否しました。つまりDataDomeはハンドシェイク以外の何かで判定しています。
実際にチェックを実行しているもの
ヘッド付きブラウザでは、DataDomeのチャレンジはスライダーとして表示され、その4つの理由のうち2つは、呼び出し元のIPと開発者ツールの使用です:
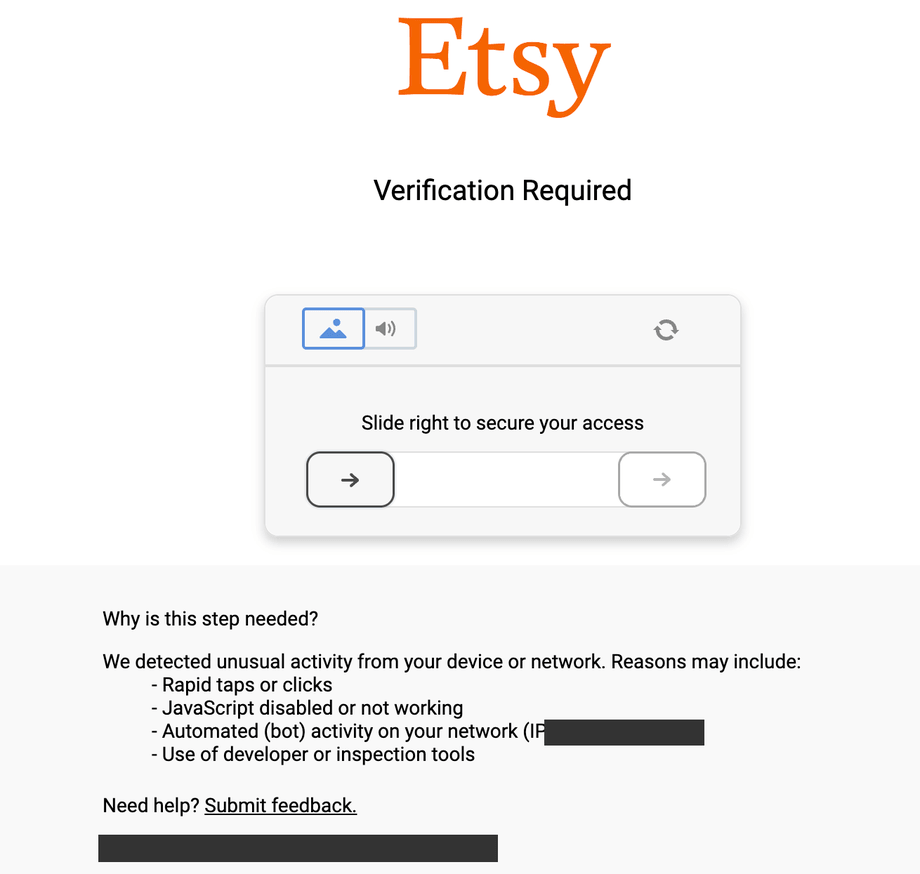
そのc.jsローダーは14KBで、iframeのURLを構築し、2回目のページをフェッチします。その2回目のページには、取得した日に596KBのインラインスクリプトが含まれていました。そのモジュール名から、何を再実装しなければならないかがわかります:
detection-js/dist/vm-obf.js     the detection engine, VM-obfuscated
detection-js/dist/captcha.js    challenge coordination
./picasso                       canvas-based device-class fingerprinting
./mouseMaths                    pointer-movement analysis
./slidercaptcha ./hash ./helpers ./bean検出モジュールは、同じファイル内にバンドルされたインタープリター用のバイトコードとして保存されています。そのため、バンドルのテキスト検索ではwebdriver、cdc_、headless、_phantomのいずれも見つかりません。バイトコードバンドルは、プローブが実行されているかどうかに関わらずこれらの文字列を隠すため、検索結果は何も教えてくれません。
取得したビルドは自身を1.34.0と報告し、自身の実行時間を計測し、その所要時間をシグナルとして送信していました。そのビルドはまた、続行する前にDevToolsを閉じるよう求めるコンソール警告もログに記録していました。このエンジンはEtsyではなくDataDomeのリリースサイクルに従うため、あなたが確認する頃には別のバージョンと別のモジュールリストになっていると想定してください。これらの名前の背後にあるアーキテクチャは、それよりもずっとゆっくりと変化します。
チェックリクエストには16個のフィールドがあり、ブラウザ環境をuserEnv、ddCaptchaEnv、plv3にエンコードしています。
ここから2つの実際的な結論が得られます。requestsからその出力を再現するには、バージョン文字列がインクリメントされ続ける難読化されたVMを再実装する必要があります。そしてDataDomeは、実際のブラウザエンジンがページをレンダリングした後にのみ存在するキャンバス出力とポインター移動を収集しています。DataDome専用のアンブロッキングは、そのブラウザエンジンをサービスとして実行し、ブロックではなくレンダリングされたページを返すよう構築されています。
その2つ目の結論はテスト可能なので、ステルスパッチなし、プロキシなしのプレーンなPlaywright Chromiumを実行しました。各モードは、上記のすべてのトランスポートが拒否された同じアドレスから3回ずつ実行しました:
headless=True (default)        403  403  403     1,530 B    0.5s
headless=True --headless=new   403  403  403     1,530 B    0.4s
headless=False (headed)        200  200  200   532,049 B    2.2s   Product JSON-LD present
両方のウィンドウは、プロキシなしで1台のマシンから実行されたため、ヘッド付きウィンドウはローカル通貨で価格を表示します:
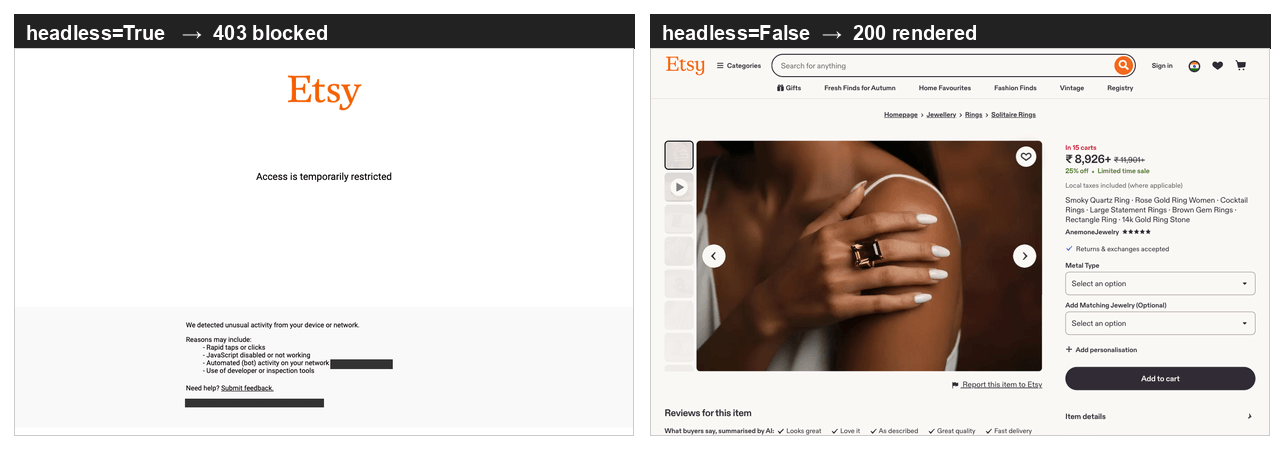
ヘッドレスChromiumは独自のUser-AgentにHeadlessChromeを含めているため、これらの行はウィンドウの見た目以上の点で異なっています。ページを手動で確認したり、数ページを取得したりする場合は、ヘッド付きブラウザが最も簡単な答えです。アンブロッキングインフラは最初の1回以降のリクエストのために構築されており、1回だけのフェッチでは、ヘッド付き実行はそれを経由するよりもおよそ10倍速くなります。
1つのブラウザがクローラーにはならない理由
1つのブラウザページで12件の出品を2秒間隔で1件ずつ読み込んだところ、成功1件、拒否11件という結果になりました:
#1   200   444,123 B
#2   403     1,527 B
#3-12 403   ~1,530 B each
ナビゲーション間でブラウジングコンテキストを破棄すると200が復活したため、拒否はアドレスではなくセッション状態に起因していました。同じテスト期間の後の方では、その対策が効かなくなりました。その後Etsyは、コンテキストがどれだけ新しいかに関わらず、そのアドレスからのすべてのリクエストを拒否しました。
成功率が全リクエスト成功からゼロへと変化している間、リスクスコアは動きませんでした。3ヘッダーの実行は、最初の計測から数時間・数百件のリクエストを経た後でも、小数点以下4桁まで0.4822のままでした。
X-DataDome-riskscoreヘッダーは一度に1件のリクエストを採点するものなので、1つの変更をテストするには有用ですが、クロールの監視には使えません。これを監視するパイプラインは、何も収集できていないのに成功を報告します。
数ページ以上を収集するには、新しいブラウジングコンテキストと、DataDomeがまだ拒否していないアドレスの2つが必要です。ナビゲーション間でコンテキストを破棄するのはコストが低いため、そこから始めてください。ただし、この対策はDataDomeがそのアドレスを拒否するまでしか持ちません。レジデンシャルプロキシは、ローテーションに使えるアドレスのプールを提供します。
Web Unlockerは両方を実行してくれ、さらに下にあるスクリプトは無料枠内に収まります。Browser APIは、あなたのPlaywrightコードが操作するホスト型ブラウザの中で両方を処理します。
robots.txtとEtsy規約が許可していないこと
何かを構築する前に、自分自身でEtsyのROBOTS.TXTを読んでください。このファイルはキーワード検索を禁止しており、Etsyは予告なしにこれを書き換えます。私たちが読んだとき、そのファイルは1,818行の長さがあり、*、AdsBot-Google-Mobile、Spinn3rの3つのユーザーエージェントグループのみを宣言していました:
User-agent: *
Disallow: /search?*q=
Disallow: /search/?*q=
Disallow: */shop/*/sold*
Disallow: */listing/*/favoriters*
Disallow: /api/
Allow:    /search/shops
このワイルドカードグループは、すべてのロケールバリアントでキーワード検索結果を禁止しています。このグループは、他の2つのグループが名指ししていないすべてのクローラーを対象としています。売却済み出品の履歴とお気に入り登録者数も禁止されており、これらはEtsyが公開している中で最も明確な需要シグナルの一部です。出品ページとショップページにはDisallowルールがないため、どちらも開いたままです。
このファイルはSitemap:ディレクティブを宣言しておらず、/sitemaps.xmlは空の本文で403を返します。これら2つの欠如は、上記のDisallowルールと同じくらい重要です。どちらも1行で確認できるチェックで、繰り返す価値があります。Etsyは予告なしにどちらも復活させる可能性があるためです。これらが欠落している限り、Etsyが開放しているページから出品を発見しなければなりません。
私たちが読んだ時点では、Etsyはファイル内のどこにもAIクローラーを名指ししておらず、llms.txtやai.txtも公開していませんでした。この欠如は、このセクションの中で私たちが確認して以来変化している可能性が最も高い点です。
いずれにせよ、DataDomeはそれらのクローラーをエッジで拒否します。GPTBotとClaudeBotはいずれも403を受け取り、どちらも当社のテストで0.9814のスコアとなり、ChromeのUser-Agentで同じアドレスが記録した0.923よりも高い値でした。同じヘッダーを持つ無意味なUser-Agent文字列も同じスコアだったため、DataDomeはクローラー名ではなく、既知のブラウザが存在しないことを採点しています。
2025年8月26日に最終更新されたEtsy利用規約には、明示的な許可なしに「本サービスのいかなるページもクロール、スクレイピング、またはスパイダーしない」ことに同意すると記されています。
あなたの収集レイヤーが、あなたの代わりにrobots.txtを強制しているかどうか、そしてどの時点で判断を下しているかを確認してください。レジデンシャルのアンブロッキングエンドポイントは、リクエストごとに判断を下します。KYC確認が未完了のアカウントでは、禁止されている検索パスへのリクエストに対して、ルールとKYCフォームが返されます:
Residential Failed (bad_endpoint): Requested site is not available for immediate
residential (no KYC) access mode in accordance with robots.txt. To get full
residential access for targeting this site, fill in the KYC form:
https://brightdata.com/cp/kyc同じアカウントは、エラーなしで/shop/AnemoneJewelryをフェッチし、レスポンスは983,937バイトでした。このエンドポイントはあなたが読んだのと同じrobots.txtを読み取り、許可されたパスを提供し、禁止されたパスはプロキシではなくコンプライアンス審査にルーティングします。構築を始める前に、あなたのユースケースが禁止されたパスを必要とするかどうかを決めてください。
フェッチ層を自分で構築する場合、その判断をコードの中で行うことになり、ターゲットごとのrobots.txt処理を自分で所有し保守することになります。
Etsy公式APIが返すもの、省略しているもの
このAPIは正規のパスなので、却下する前にそれが何をするか確認してください。公式APIとスクレイピングの選択は一般的な話ですが、Etsyにおいては、仕様が省略しているフィールドに左右されます。OpenAPI仕様を直接取得し、76のパスを数えたところ、そのうち31のGETオペレーションはアプリケーションキーのみが必要で、出品者のOAuthは不要でした。これらの合計はEtsyがエンドポイントを追加・削除するたびに変動するため、この段落ではなくそのファイルから再カウントしてください。
v3 APIに関する一般的な主張は、3つの点で誤っています。findAllListingsActiveは削除されておらず、keywords、min_price、max_price、taxonomy_id、shop_location、currency、buyer_countryを受け付け、1回の呼び出しあたり最大limitは100です。getReviewsByListingとgetReviewsByShopは、アプリキーだけでレビュー本文を返します。getShopは、任意のショップについてtransaction_sold_count、review_count、review_average、num_favorers、listing_active_countを返します。
この仕様は1つの需要フィールドを持ち、それ以外は省略しています。getListingはアプリケーションキーのみが必要で、ShopListingWithAssociationsスキーマ上で、1日1回更新される累積閲覧数であるviewsを返します。文書全体を検索しても、検索ボリューム、インプレッション、コンバージョン率、出品ごとの売上のためのフィールドは見つかりません。カウントした時点でShopListingスキーマには50個のプロパティがあり、その中にはnum_favorers、quantity、priceが含まれていましたが、売上数はありませんでした。カウントは仕様に照らして再確認してください。ただし、まだ売上フィールドは登場していません。
出品ごとの取引には実際にエンドポイントがあり、getShopReceiptTransactionsByListingがそれですが、transactions_rというOAuthスコープが必要で、これはショップのオーナーが自分のショップに対してのみ付与できるものです。あなたが運営していないショップについては、Etsyはショップレベルの生涯売上を履歴なしの現在の合計として公開しているのみで、出品ごとの数字は一切ありません。
このギャップが、Etsy周辺のサードパーティツール市場を説明しています。一部の製品は、自分たちが運営していないショップについて、出品ごとの売上推定値やキーワード検索ボリュームを販売しています。私たちが読んだ仕様の中には、あなたが所有していないショップについてこれらの数値を返すものは何もないため、そのデータはこのAPIの外部から来ているはずです。
Etsyはアプリケーションキーごとに、秒単位と日単位でレート制限を適用しています。x-limit-per-secondとx-limit-per-dayのレスポンスヘッダーが両方を報告し、どちらかを超えると、Etsyはretry-afterとともに429を返します。
レート制限のページは、その数値をデフォルト値ではなく「例の値」とラベル付けしています。私たちが読んだ時点では、以前の「1日10,000件、1秒間に10件」という組み合わせはそのページから消えていました。あなた自身の制限はDeveloper Portalから読み取ってください。
PythonでEtsyの出品ページとショップページをスクレイピングする
Etsyの出品ページにはschema.orgのJSON-LDが埋め込まれているため、抽出ステップにはCSSセレクターが不要で、Etsyがその周辺のマークアップを変更しても壊れません。フェッチステップにはインフラが必要で、2つの方法があります。アンブロック済みのAPIはどこからでも動作し、アカウントが必要です。ローカルブラウザはアカウント不要で、数ページに適しています。
以下のスクリプトは1つのライブラリと2つの環境変数が必要です:
python3 -m venv .venv && source .venv/bin/activate
pip install requests
export BRIGHTDATA_API_KEY="your-api-token"
export BRIGHTDATA_ZONE="web_unlocker"
このトークンはBright Dataのコントロールパネルから取得します。そのトークンを使ったすべてのリクエストは、あなたのアカウント残高を消費するため、コミットされたスクリプトではなく環境変数に保管してください。
2つ目の値は、Web Access → Add API → Web Unlocker APIの下で作成します。リクエストのペイロードではこれをzoneと呼んでいますが、これを設定したときのコントロールパネルではAPIと表示されていたため、パネル内で「zone」を検索しても何も見つかりませんでした。BRIGHTDATA_ZONEは、スクリプトのデフォルトがweb_unlockerであるため、あなたがそこに入力した名前と一致している必要があります。このフォームは、その名前が永久的であると警告しています:
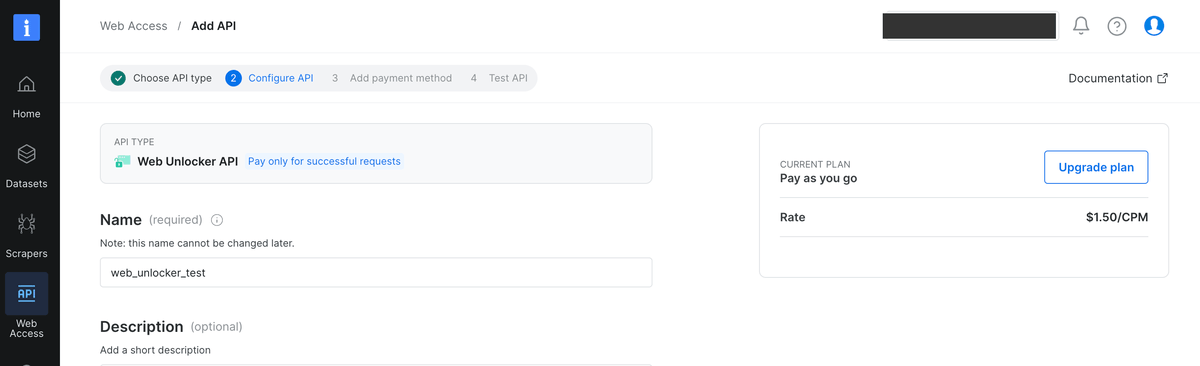
このキャプチャ内のゾーンはweb_unlocker_testという名前なので、スクリプトのデフォルトではそれを見逃します。あなたが入力した名前にBRIGHTDATA_ZONEを設定するか、web_unlockerを使ってデフォルトをそのままにしてください。Web Unlockerクイックスタートでは両方が文書化されており、私たちがこれを設定した際にはカードなしで無料枠から開始しました。Web Unlockerの料金ページには、現在の無料枠と、それを超えた場合の従量課金レートが、成功した1,000件のリクエストあたりの単価として記載されています。パネルではそのレートをCPMとして表記しています。
このスクリプトは、Web Unlockerのエンドポイントを通じてリクエストを送信し、結果をパースします:
import json
import os
import re
import requests

API_KEY = os.environ.get("BRIGHTDATA_API_KEY")
ZONE = os.environ.get("BRIGHTDATA_ZONE", "web_unlocker")
ENDPOINT = "https://api.brightdata.com/request"

LD_JSON = re.compile(
    r'<script[^>]*type\s*=\s*[\'"]application/ld\+json[\'"][^>]*>(.*?)</script\s*>',
    re.S | re.I,
)


def fetch_html(url, country="us"):
    """Return the rendered HTML for an Etsy URL, or raise on failure."""
    # Checked here rather than at import, so the browser path below runs
    # without an account.
    if not API_KEY:
        raise SystemExit("BRIGHTDATA_API_KEY is not set, see the exports above")
    response = requests.post(
        ENDPOINT,
        headers={"Authorization": f"Bearer {API_KEY}"},
        json={"zone": ZONE, "url": url, "format": "raw", "country": country},
        timeout=90,
    )
    response.raise_for_status()
    body = response.text
    # A quota error arrives as HTTP 200 with a short text body, and a block page
    # arrives as HTTP 200 of valid HTML. Neither contains ld+json, which is the
    # content this actually wants, so test for that rather than for either error.
    if not LD_JSON.search(body):
        raise RuntimeError(f"no ld+json in response, most likely blocked: {body[:200]!r}")
    return body


def product_jsonld(html):
    """Pick the Product block by @type. Every listing we opened had four."""
    for block in LD_JSON.findall(html):
        try:
            parsed = json.loads(block.strip())
        except json.JSONDecodeError:
            continue
        for node in parsed if isinstance(parsed, list) else [parsed]:
            if node.get("@type") == "Product":
                return node
    return None


def parse_listing(node):
    """Flatten a Product node, keeping the offer's range rather than its lowest price."""
    offer = node.get("offers", {})
    # schema.org allows a list of offers and a single priceSpecification object,
    # and Etsy serves both, so normalize before indexing into them.
    if isinstance(offer, list):
        offer = offer[0] if offer else {}
    specs = offer.get("priceSpecification", [])
    if isinstance(specs, dict):
        specs = [specs]
    base = next((s for s in specs if "priceType" not in s), {})
    was = next(
        (s for s in specs if "Strikethrough" in str(s.get("priceType", ""))), {}
    )
    # Not every listing carries a priceSpecification. Without this fallback a
    # single-variant listing records a null price and raises nothing.
    # A range arrives three ways: nested in priceSpecification, as AggregateOffer's
    # own lowPrice and highPrice, or not at all. Try them in that order.
    low = base.get("minPrice") or offer.get("lowPrice") or offer.get("price")
    high = base.get("maxPrice") or offer.get("highPrice") or offer.get("price")
    # availability is the only field that marks a dead listing, and JSON-LD lets it
    # arrive as a bare term, an array, or an @id object. Normalize before comparing.
    avail = offer.get("availability") or ""
    if isinstance(avail, list):
        avail = avail[0] if avail else ""
    if isinstance(avail, dict):
        avail = avail.get("@id", "")
    rating = node.get("aggregateRating", {})
    return {
        "sku": node.get("sku"),
        "title": node.get("name"),
        # Etsy serves a dead listing as a full HTTP 200 page that still
        # carries a price, so availability is the only field that says so.
        "availability": str(avail).rsplit("/", 1)[-1],
        "currency": offer.get("priceCurrency"),
        "price_min": low,
        # high can be a bundle maximum rather than the item's, where a listing
        # has an add-on axis. Count the axes before trusting it as a maximum.
        "price_max": high,
        "list_price": was.get("price"),
        # True only where the variations differ in price. Same-price variants
        # read false, so this is a price-spread test, not a variation test.
        "has_variations": None if low is None else low != high,
        "rating": rating.get("ratingValue"),
        "review_count": rating.get("reviewCount"),
        "shop": node.get("brand", {}).get("name"),
    }


if __name__ == "__main__":
    url = (
        "https://www.etsy.com/listing/753913297/"
        "smoky-quartz-ring-rose-gold-ring-women"
    )
    node = product_jsonld(fetch_html(url, country="us"))
    if node is None:
        raise SystemExit("no Product block on page: blocked, or the layout changed")
    print(json.dumps(parse_listing(node), indent=2))
実際の出品に対してこのスクリプトを実行したところ、フラット化されたレコードが返されました。この価格帯は、個別に価格設定された多数のバリエーションを持つ1つの出品から来ています:
{
  "sku": "753913297",
  "title": "Smoky Quartz Ring · Rose Gold Ring Women · Cocktail Rings · ...",
  "availability": "InStock",
  "currency": "USD",
  "price_min": "89.25",
  "price_max": "5613.75",
  "list_price": "119.00",
  "has_variations": true,
  "rating": "4.5",
  "review_count": 99,
  "shop": "AnemoneJewelry"
}
同じ出品に対する3回の実行で、フェッチには23〜27秒かかり、540KB〜750KBのデータが返されました。これらの数値は、アンブロッキングステップのコストです。ブロックのサブ秒単位のタイミングではなく、その範囲のレイテンシを見込んでおいてください。
数ページだけが必要で、アカウントを開設したくない場合、ローカルブラウザはほぼ同じ量のコードで同じ結果に到達できます。そのブラウザは、DataDomeがまだ拒否していないアドレスから動作します。ディスプレイが必要なので、サーバー上で実行する場合は、ヘッドレスモードではなく、Xvfbのようなバーチャルディスプレイのもとでヘッド付きで実行してください。PlaywrightとChromiumを一度だけインストールします:
python3 -m venv .venv && source .venv/bin/activate   # skip if already active
pip install playwright requests
playwright install chromium次に、同じ2つのパース関数を保ちつつ、フェッチ部分を入れ替えます。これは__main__ブロックの上の、他の関数とともに置いてください:
from playwright.sync_api import sync_playwright


def fetch_html_browser(url):
    """Fetch one page with a visible browser, since headless returns a 403."""
    with sync_playwright() as p:
        browser = p.chromium.launch(headless=False)
        context = browser.new_context(locale="en-US")
        page = context.new_page()
        page.goto(url, wait_until="domcontentloaded", timeout=45000)
        html = page.content()
        browser.close()
        # Same rule as the guard above: test for the content you want. A block
        # page is valid HTML, so only the missing ld+json shows it.
        if not LD_JSON.search(html):
            raise RuntimeError("no ld+json on page, most likely a block page")
return html__main__ブロック内の1行を変更するだけで、他は何も変えません:
node = product_jsonld(fetch_html_browser(url)) # was: fetch_html(url, country="us")私たちの実行では535,247バイトが返され、同じ2つの関数で問題なくパースされました。このページはまたINRで価格設定されていました。これは、あなたのマシン上のブラウザが自分自身のアドレスから出て行くためであり、ブラウザ経由のパスにはcountry引数がありません。その引数がなければ出口の国を設定できないため、このパスはデータセットではなく数ページに適しています。
上記のコードは、モデルに送信するのではなくページをパースします。Etsyはフィールドを構造化データとして公開しているため、それらを読み取ることは決定論的で、事実上無料です。計測した出品では、Productブロックを選択してフラット化するのに中央値で0.3ミリ秒かかります。
代わりに同じページを言語モデルに渡すと、生HTMLで179,599トークンとなり、1つの商品のために200Kトークンのコンテキストウィンドウのほとんどを占めることになります。先にマークアップを除去すれば、それは5,352トークンにまで、97%削減されます。この比率は、モデルの選択よりも重要です。
しかし、マッチしなくなったパーサーはエラーではなく空のフィールドを返しますが、モデルであれば少なくとも何か間違っていても目に見える結果を生成します。そのため、schema.orgを公開しているサイトでは決定論的なパスを選んでください。そして、節約した時間を使って、パーサーが引き続き期待するフィールドを返しているかを確認してください。
ショップページにも、異なるタイプの下に同様に4つのこうしたブロックがあり、そのうちの1つは出品URLがどこから来るかを示しています。/shop/{shop_name}は、ショップを記述するOrganizationノードと、itemListElementが完全な出品URLを保持するItemListノードを返します。shop_itemlistは@typeでItemListを選択するため、代わりにOrganizationを使った同じ関数はショップ自体のフィールドを返します。テストしたショップでは、numberOfItemsは1,842と読み取れた一方、1ページは36件のURLを返し、?page=2は重複なく別の36件を返しました。
この列挙器はショップ名を入力として受け取るため、ショップ名のソースが必要で、禁止されている検索パスに触れずに機能するソースが3つあります。すでに追跡しているショップ、上記のfindAllListingsActiveエンドポイント、または準備済みのデータセットを使用できます。そのエンドポイントはアプリケーションキーのみでkeywordsを受け付け、返すすべての出品にshop_idを含めています。
その範囲全体と、宣言された終端を超えてページをフェッチしました:
page  2    36 items
page 25    36 items
page 51    36 items
page 52     6 items      51 x 36 + 6 = 1,842
page 53    no ItemList block
page 60 no ItemList block合計は、ショップが宣言している1,842と一致します。終端を超えると、Etsyは約420KBの完全なページを返し続けますが、ItemListは含まれていません。
Etsyはエラーも終了の目印となる空配列も返さないため、どちらかを待つループは、一見問題なく見えるページに対して永遠にページングし続けてしまいます。代わりに、ブロックが欠けている時点で終了し、宣言された件数で作業を確認させてください。ページネーションされた収集の一般的なパターンは、この2つのシグナルのいずれかを前提としているため、ここでは当てはまりません。
どちらの関数も、LD_JSONとfetch_htmlを使用するため、以前の関数と同じファイルに属します。列挙器は20分かかるため、実行していないエントリーポイントはコメントアウトしてください:
def shop_itemlist(html):
    """Pick the ItemList block. The first block on a shop page is a video."""
    for block in LD_JSON.findall(html):
        try:
            parsed = json.loads(block.strip())
        except json.JSONDecodeError:
            continue
        for node in parsed if isinstance(parsed, list) else [parsed]:
            if node.get("@type") == "ItemList":
                return node
    return None


def enumerate_shop(shop_name, country="us"):
    """Page a shop until the ItemList stops appearing, and hand back the declared
    count so the caller can check it."""
    base = f"https://www.etsy.com/shop/{shop_name}"
    urls, declared, page = [], None, 1
    while True:
        suffix = "" if page == 1 else f"?page={page}"
        try:
            node = shop_itemlist(fetch_html(base + suffix, country=country))
            if node is None:
                break
            declared = node.get("numberOfItems", declared)
            urls += [item["item"]["url"] for item in node["itemListElement"]]
        except (RuntimeError, requests.RequestException, KeyError, TypeError,
            AttributeError) as err:
            print(f"stopped at page {page}: {err}", flush=True)
            break
        print(f"page {page}: {len(urls)} of {declared}", flush=True)
        # Breaking on the declared count here would make the comparison below
        # vacuous, so page until the ItemList block stops appearing.
        page += 1
    return urls, declared


if __name__ == "__main__":
    urls, declared = enumerate_shop("AnemoneJewelry")
    print(len(urls), "collected,", declared, "declared")
この列挙器は、上記で計測したページに対して53回のフェッチを行い、1,842件のURLを返し、合計をショップが宣言している件数と照合します。読み込みが短いとURLが少なくなり何もエラーを出さないため、実行のたびにこれら2つの数値を比較してください。
このtryは、フェッチだけでなくパースもカバーする必要があります。53件のリクエストからなるループは、レート制限のレスポンスを受け取るには十分な長さであり、1つの不正なitemListElementも、失敗したリクエストと同じ損害を与えます。ガードがなければ、どちらか一方がページ30でエラーとなり、それまでに収集したすべてのURLを破棄してしまいます。両方をキャッチすることで、失われた実行ではなく短い読み込みで済み、件数の比較がそれを示してくれます。Pythonでの失敗したリクエストの処理は標準的なパターンに従っており、Etsy固有の部分は、パースをガードの内側に置くことだけです。
上記で計測したレイテンシでは、53回のフェッチは20〜24分で、無料の月間枠のうち53件のリクエストを1つのショップのために使うことになります。1,842件の出品を持つショップで使う前に、まず小さなショップで列挙器を実行し、ページ数が増えていくのを確認してください。ゾーンに利用上限も設定しておき、うまくいかなかった実行が残高ではなく上限で止まるようにしてください。
私たちは、Web Scraper APIのEtsyショップエンドポイントを通じて、バッチジョブとして同じディスカバリーを実行しました。出品URLではなくショップに対してジョブを実行し、比較のために50件のレコードに制限しました。そのジョブは168.9秒で50件の出品を返しました。つまり1件あたり約3.4秒で、重複もロケールプレフィックス付きURLもありませんでした。
そのショップ全体を収集するには、53回の列挙フェッチと1,842回の出品フェッチ、つまり合計1,895回のリクエストと、シングルスレッドでおよそ13時間かかります。開始する前に、この1,895を現在の無料枠と照合してください。その枠を超えると、同じ作業は成功した1,000件あたりの従量課金レートで課金されます。
ここでもcountryを固定してください。同じショップをそれなしでフェッチしたところ、/de/listing/のURLとドイツ語のタイトルが返ってきました。それらのURLは、すでに/listing/形式で保存されている商品に対して、別のキーとしてデータセットに入ってしまいます。
Etsyのデータセットを静かに破損させる抽出上の問題
ここで挙げる各問題は、HTTP 200を返し、例外を発生させません。5つのうち4つはもっともらしいが誤った行を書き込み、5つ目は空の行を書き込みます。その代わり、数カ月後に誤った数値を発見することになります。データ品質指標は、データが保存された後にこの種の失敗を捕まえてくれますが、誤った行を書き込まないほうがコストは安く済みます。
出品ページには1つではなく4つのJSON-LDブロックがあります。私たちが開いたすべての出品で、EtsyはProduct、VideoObject、BreadcrumbList、FAQPageを、すべてapplication/ld+jsonタイプで、4つの別々のscriptタグに含めていました。ページのソースでは、これらは4行連続で表示されます:
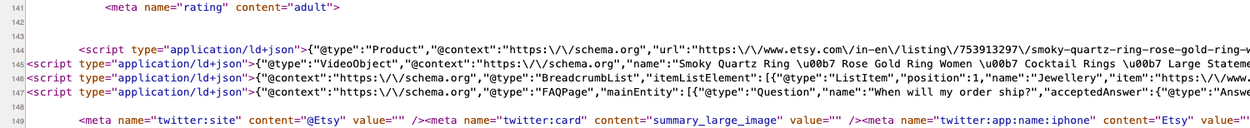
find()を呼び出して最初のマッチを採用するコードは、出品ページでは機能しますが、ショップページでは気づかれないままビデオブロックを返してしまいます。位置ではなく@typeで選択してください。PythonでJSONデータをパースする仕組みについて、それ以外は何も変わりません。
ショップページにも独自の4つのブロックがありますが、順序が異なります:
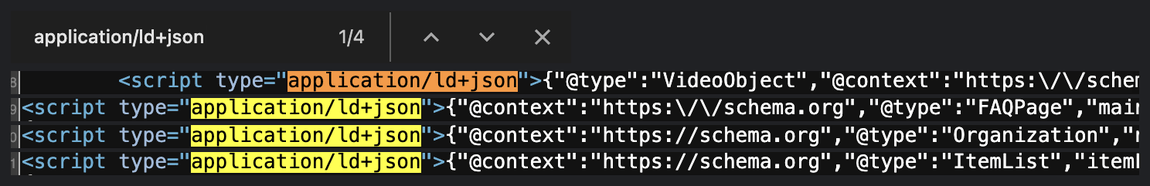
テストしたショップでは、最初のブロックは動画で、欲しいItemListは最後にあるため、最初のマッチを採用すると失敗します。上記のスクリプトは、代わりに@typeで選択しています。
バリエーションのある出品では、offers.priceは価格帯の最低価格であり、価格帯全体ではありません。テストした出品では、offers.priceは89.25と読める一方、offers内にネストされたpriceSpecificationのエントリはminPriceを89.25、maxPriceを5613.75と宣言していました。offers.priceを読むパーサーは、最も安いバリエーションを記録し、価格帯を取り落とします。代わりにmaxPriceを保存することも解決策にはなりません。なぜなら、この出品ではmaxPriceは商品単体ではなく、セットの価格だからです。
同じURLをバリエーションを有効にして収集したところ、バリアントごとに1件ずつ、合計61件の個別レコードが得られ、価格は89.25から1,871.25までの範囲でした。あなたの表の1つの出品行は、21倍の価格帯にまたがる61種類の購入可能なSKUを表しています。
ページ上の2つ目のドロップダウンは、その範囲をさらに掛け合わせます:
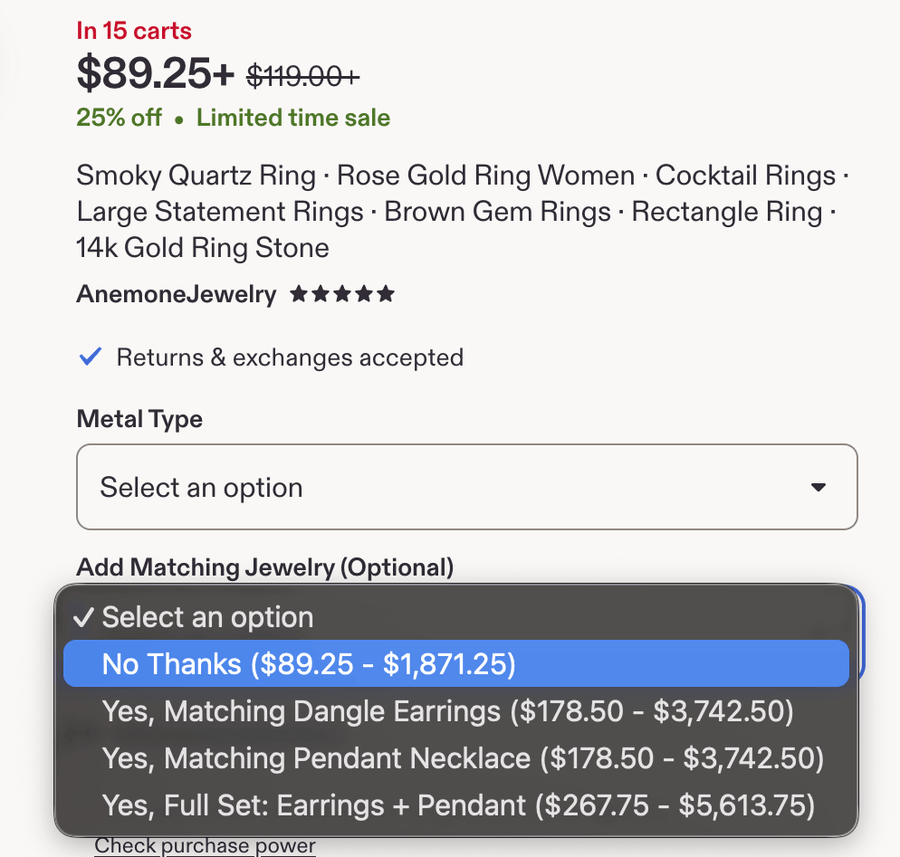
この2つの最大値は異なるものを測っており、この出品には2つのバリエーション軸があります。Metal Typeは14kゴールドフィルドの89.25から、3種類のソリッドゴールドオプションの1,871.25までです。Add Matching Jewelry (Optional)は、その範囲をさらに掛け合わせます。No Thanksは89.25から1,871.25、いずれかの単体マッチングピースは178.50から3,742.50、Full Set: Earrings + Pendantは267.75から5,613.75です。
宣言されたmaxPriceは、ソリッドゴールドのリングに両方のマッチングピースを加えたもので、3点を1つの価格でまとめたものです。バリエーションの抽出は、リング単体を返し、No Thanksの行とセントの単位まで一致しました。
つまり、出品がアドオン軸を持つ場合はいつでも、maxPriceは商品自体ではなくセットの最大値です。これをもとに構築された価格系列は、気づかないうちにセットを追跡しています。範囲を商品自体の価格として保存する前に、バリエーション軸の数を数えてください。これらはJSON-LDには含まれていないため、レンダリングされたページから読み取るか、バリエーションの抽出を取得してください。
同じpriceSpecification配列には、StrikethroughPriceとタグ付けされた2番目のエントリも含まれているため、セール価格と定価が並んで表示され、違いはschema.orgのURLだけです。そのエントリにも独自のminPriceとmaxPriceがあります。スクリプトが記録するlist_priceは、定価の範囲の中で最も低い価格であり、offers.priceが現在の範囲の最低価格であるのと同様です。
ロケールは出口IPに従い、通貨記号以上のものが変化します。私たちは、出口国だけを変えて、同じ1時間以内に1つの出品を3回フェッチしました:
country   currency   price    variation range      title
us        USD        89.25    89.25 - 5613.75      Smoky Quartz Ring, Rose Gold Ring Women
de        EUR        95.71    95.71 - 5058.76      Rauchquarzring, Damenring aus Roségold
gb        GBP        82.77    82.77 - 4338.22      Smoky Quartz Ring, Rose Gold Ring Women
同じ出品が、出口国ごとに異なってレンダリングされます:
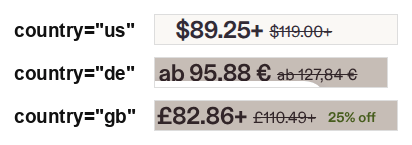
これらのキャプチャは、3行の計測よりも後のフェッチから取得したもので、ドル建ての数字だけが同じままでした。ドイツ語版のページでは、最低価格をab、つまり「〜から」とも表記しており、他の2つのページでは+が同じことを示しています。
この3回のフェッチは、同じSKU、評価、レビュー件数を、3つの異なる通貨で3つの異なる価格として返しました。最低価格と最高価格の比率は、3行の間で異なっており、米国の行では62.9倍に対し、52.9倍と52.4倍だったため、これらのフェッチの間に為替レート以上のものが動いています。ドイツの出口は、機械翻訳されたタイトルも返しましたが、2つの英語ロケールは元のタイトルを保持していました。
地理を無視したローテーションプールは、3つの通貨が混在した価格系列と、言語が混在したテキストコーパスを生成しますが、パイプライン内の何も問題を報告しません。収集実行ごとに出口国を固定し、すべての価格とともに通貨を保存してください。
同じ問題は、準備済みのデータにも現れます。ダウンロードした1,000件のサンプルには19種類の通貨があり、109行がUSD以外の通貨で、そのうち14行はベトナムドンで価格設定されていました。このサンプルは更新されるため、あなたのコピーはこれらの合計とは異なります。あなた自身のコピーで同じ比較を実行してください。
通貨列を読まずに価格列を平均化すると、平均値が水増しされます:
mean(final_price), all rows          31,238.84   n=991
mean(final_price), currency = USD       137.57   n=882
                                        ~227x
median(final_price), all rows            26.00
この列では、991行のうち14行が合計の87%を占めていますが、109行がUSD以外であり、そのすべてに対処が必要です。クエリは実行され、列はきれいなfloat値であるにもかかわらず、答えは2桁も間違っています。中央値はほとんど動きません。なぜなら、USD以外の行は列の中で小さな割合を占めるに過ぎないからです。平均値と中央値がこれほど食い違う場合、それはテールが重いことを示しているに過ぎません。通貨列でグループ化することで、混在した単位と通常の偏りを切り分けられます。
さらに下で引用する2026年3月のマーケットプレイス出品に関するarXivの論文は、いかなる分析を実行する前に、サンプルをUSDで価格設定された出品に限定しました。これは、収集中にではなく収集後に問題を解決するやり方です。そのようにフィルタリングすることは、他の通貨の出品を変換するのではなく除外するため、平均値が記述する母集団自体も変えてしまいます。
この問題は、エージェント経由のパスで最も見えにくくなります。私たちは、URLのみを受け付けるスキーマを持つMCPサーバー経由でこの出品をフェッチしたところ、CZKで価格設定されたチェコのストアフロントが返ってきました。国を固定したREST呼び出しは、同じ出品を89.25 USDとして報告します。
原因はフェッチそのものではなく、ツールのインターフェースにあります。国やロケールのパラメータを設定する手段がないため、サーバーが使っている出口をそのまま受け入れることになります。そのようなサーバーをエージェントに接続する前に、その挙動を確認してください。なぜなら、出口が下流のすべての答えの通貨を決めてしまうからです。
そのため、Etsyのデータは固定されたロケールで自分自身のストアに収集し、質問ごとにライブでフェッチするのではなく、エージェントにそのストアを読ませるようにしてください。毎回気づかないうちに異なる通貨で答えるエージェントは、答えられないエージェントよりも悪いものです。
削除済みの出品も、価格の付いた完全なページです。Etsyは、期限切れや売り切れの出品に対して404を返しません。私たちは2007年の出品を取得し、HTTP 200、465,563バイト、完全なProductブロック、そしてpriceは13.00 USDという結果を得ました。
このページは完全にレンダリングされ、売り切れバナーと価格の両方を表示します:
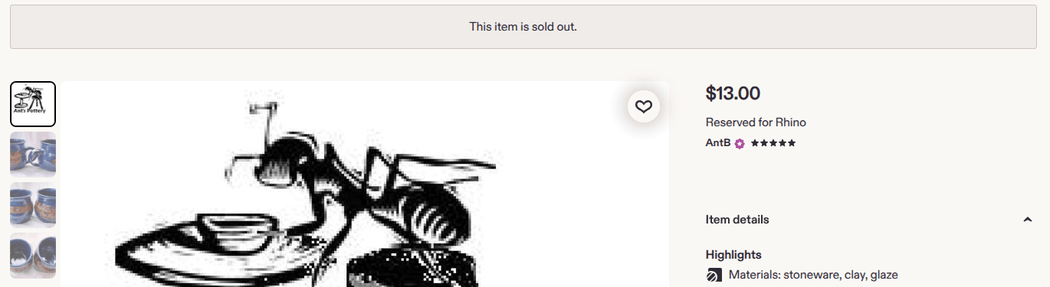
offers.availabilityは価格と矛盾する唯一のフィールドで、schema.org/OutOfStockと読み取れます。これをスキップするパーサーは、削除済みの商品を満額で記録してしまうため、上記のスクリプトはそのフィールドを読み取っています。
そのフィールドは、ページ上よりも準備済みのデータにおいて信頼性が低くなります。同じコピーでは、1,000行のうち74行が売り切れの出品であり、74行すべてでavailabilityが空であったにもかかわらず、65行にはそれでも数値の価格が表示されていました。その痕跡は、保存されたURLにあるshow_sold_out_detailパラメータです。availabilityがInStockと読み取れる行だけを残すと、ほとんどの行でこのフィールドが欠落しているため、798件の生きている行が破棄されてしまいます。
2xxのレスポンスは、データがあることを意味しません。この問題はペイロードではなく収集レイヤーにあり、テスト中に上記のスクリプトでそれを目にしました。アンブロッキングエンドポイントは、本文の中で自ら説明します。アカウントがリクエストレート制限に達すると、Your system is sending too many of this type of requestと読める111バイトのプレーンテキスト本文とともに200を返しました。ステータス行は成功のままなので、raise_for_status()は通過し、パーサーはProductブロックを見つけられず、ループはただの1つの例外もなく空の行を書き込みます。
Web Scraper APIは、設計上同じケースを処理します。その同期コレクトエンドポイントは、1分以内にレコードを返し、それより長いジョブは非同期で継続します。同じエンドポイントは、ジョブがその1分を超えると、snapshot_idとretry-afterとともに202を返すため、準備ができた時点で結果を収集できます。これはAPIリファレンスに文書化されています。どちらのレスポンスも成功ステータスなので、レコードリストにインデックスする前にステータスコードで分岐してください。
fetch_html内のガードは2行で、いずれかのエラーではなく、ld+jsonを含むページかどうかをテストしています。実際のショップに対して列挙器を実行したところ、3つ目のケース、つまり空の本文を伴う200が見つかりましたが、同じガードが何の変更もなくそれを捕まえました。そのため、すでに見たエラーに対してではなく、欲しいコンテンツに対してレスポンスをテストしてください。ベンダーのエラーテキストは安定したインターフェースではないためです。使用しているフェッチ層が何であれ、同等のものを書いてください。成功ステータスはペイロードを保証しないからです。
1つの動作例は、問題が存在することを証明するだけで、それがよくあることだとは証明しません。私たちは、価格帯とストライクスルーの問題を、両方のディスカバリーパスから得た100件の出品に対して確認しました。98件/100件にバリエーションが存在し、同じ98件でinitial_priceがfinal_priceと異なっています。どちらの問題も、後回しにできるエッジケースではありません。この100件は、Etsyのカテゴリー全体からのランダムサンプルではなく、上記の2つのディスカバリーパスを経由したものです。そのため、98という数字は、サイト全体の割合ではなく、ジュエリー出品における最低ラインとして読んでください。
同じチェックは、上で使用した出品が1つの点で珍しいことも示しています。その出品には99件のレビューがありますが、このクロールでは中央値は1件、公開されているデータセットサンプルでは0件です。
スクレイパーを保守する代わりに管理されたデータセットを購入すべきタイミング
スクレイパーを自分で構築することはでき、上記のコードがほとんどを占めます。問題は、どの失敗を自分自身で処理したいかです。
私たちは、今度はショップから発見するのではなくURLで収集して、同じ出品を再びWeb Scraper API経由で実行しました。生のProductブロックの14フィールドに対して58フィールドが返され、追加のフィールドは上記の問題のほとんどを処理してくれます:
raw JSON-LD (geo=us)          Web Scraper API
-----------------------------------------------------
price 89.25 (range minimum)   final_price 89.25
119.00 (StrikethroughPrice)   initial_price 119
not present                   discount_percentage 25
not present                   listing_has_variations true
not present                   reviews_count_shop 15129
not present                   is_star_seller false
4 embedded reviews            6 top_reviews
14 fields 58 fieldsその抽出器を入力URLごとに設定し、価格帯の問題のためにall_variationsをtrueに設定します:
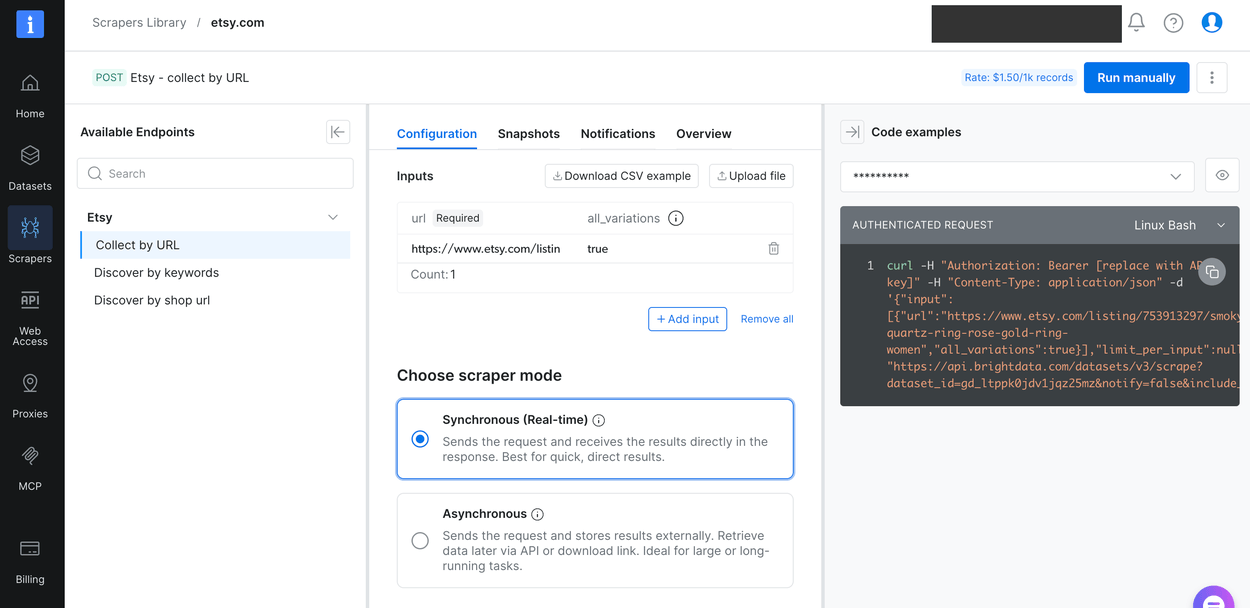
両方のパスで差分を取った6つのフィールドは完全に一致しており、それらは通貨、課金価格、定価、評価、商品レビュー件数、発送元でした。どちらのパスを信頼する前にも、このチェックを実行してください。
時間の比較は逆転し、モードがその差の大きさを決めます。同期エンドポイント経由では、構造化抽出は1件のレコードに対しておよそ50秒かかりましたが、生のフェッチは27秒でした。これはバイトをそのまま返すのではなく、レンダリングして正規化しています。50秒という時間は、上記の1分のタイムアウトの中で約10秒の余裕しか残しません。このエンドポイントは、1つのURLに対して今すぐ答えを得るために構築されています。
代わりに同じスクレイパーをバッチジョブとして実行したところ、上記の50件のレコードが1件あたり3.4秒で得られました。各レコードは、生のフェッチにかかる27秒のおよそ1/8のコストです。バッチモードでは、202は処理すべきエラーではなく、想定されたレスポンスです。
繰り返し行うクロールでは、構造化パスは、返されるフィールドについて、セレクターの保守、ロケールの固定、価格帯の処理をあなたのチームから取り除いてくれます。1件の出品だけを見れば、どちらのモードを選んでも、こちらのほうが遅くなります。上記の差分は価格処理が解決していることを示しており、50件のレコードの実行ではロケールプレフィックス付きURLは見られませんでした。セレクターの保守は、どの1回の実行でもテストできない唯一の部分です。構造化パスは、現在の無料枠とWeb Scraper APIの料金ページに記載された1,000件あたりのレコードレートで、Web Unlockerと同じ方式で課金されます。
同じサンプルには1種類ではなく2種類のレコードが含まれているため、購入側では両方に備えてください。1,000行のうち、128行はフィールドセット全体を持ち、残りの872行はdescription、product_category、store_countryを含む12個のフィールドが空です。
この分割は出品の古さを反映しており、2025年後半以降に出品された商品には完全なレコードが付きます。そのため、数年にわたる一括抽出は、1つのファイルの中に両方の種類が混在します。コーパスが古くなるにつれて、この比率は完全なレコードのほうへシフトしていくはずです。注文の規模を決める前に、あなた自身が必要とする列に対してフィールドのカバレッジを確認してください。決めた後ではいけません。
レビュー数についても、注文する前に同様のチェックが必要です。取得したコピーでは、1,000件の出品のうち753件がレビューなしだったため、中央値はゼロです。上位10%の出品が、全レビューの98%を占めています。1出品あたり平均52.5件という数字は、ファイル全体を説明するものであり、あなたが開くどの出品にも当てはまりません。
このレビューの偏りは通貨のケースと似て見えますが、修正方法が異なる別の失敗です。上記の通貨のケースは単位の誤りであり、平均値が間違っています。レビュー数は偏りであり、この場合、合計に対しては平均値は正しいものです。1,000件の出品のランダムサンプルは、合計でおよそ52,500件のレビューを返すはずなので、一括コーパスを計画する際には平均値を使ってください。パイロット規模のサンプルでは、この集中度により推定値の信頼性が下がります。
カバレッジは別の問題です。1,000件のうち753件がゼロであるため、購入する行のうちレビューがあるのは約25%にすぎません。
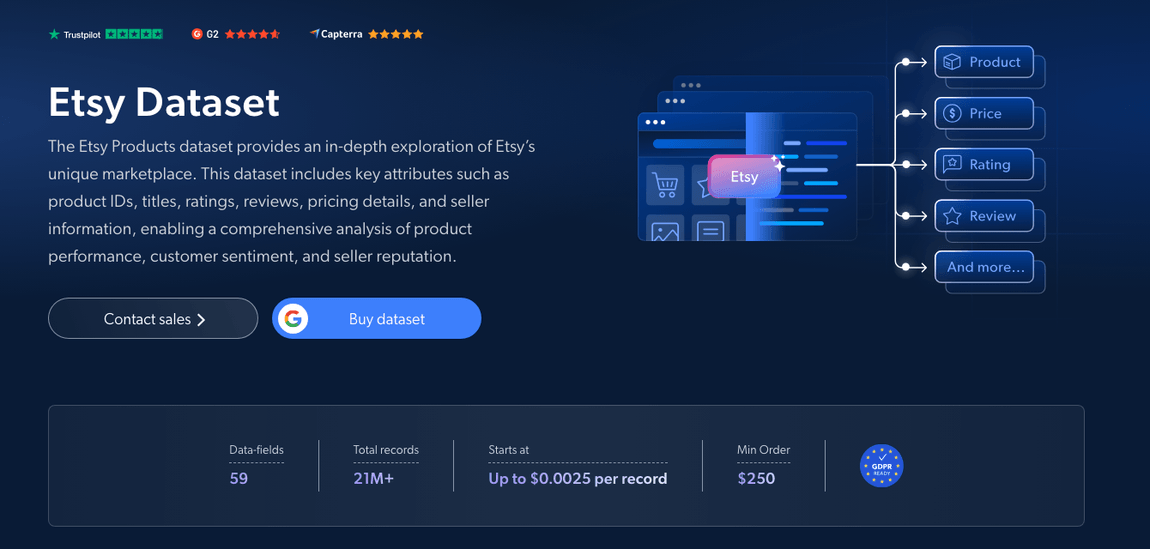
必要なデータがライブではなく履歴的なものであれば、準備済みのデータセットはクロールをスキップできます。Etsyデータセットのページには、現在のフィールド数、レコード総数、レコードごとの価格、最低注文数が記載されており、この4つの数字が購入側の計算根拠になります。
そのページのレコードごとの数字は一回限りのレートであり、半年ごとから毎日までの更新スケジュールは、それを割り引いたサブスクリプションとして提供されます。データがどれだけ新しいかも重要です。このページでは、事前収集されたレコードは数日から数カ月前のものと説明されている一方、オンデマンドの収集ではチェックアウト前にその期限を設定できます。更新スケジュールとボリュームレベルは、データセットのページ自体で選択します。
これらの数値は予告なく変わるため、予算を立てる前にページから読み取り、2つの料金ページを同じように扱ってください。データセットページには、サマリー行の下にレコードのサンプルが表示されており、アクセスをリクエストするまでぼかされています:
ここでは、ベンダーの主張よりも1つの外部参照点のほうが価値があります。同じ論文であるMecha-nudges for Machinesは、付録Bでそのデータの出所を記録しています。著者らは、生データが「Etsy商品出品の構造化データセットを提供するBright Data社から入手した」と述べています。彼らの抽出データは「2025年11月12日に収集され、同日に配信された」とのことです。彼らは500万件と106万件の出品からなる2つのスナップショットを説明しています。この付録は検証可能であり、ベンダーの事例紹介はそうではありません。
ここでのルールは狭いものです。URLで列挙できる数千件の出品が必要で、1つのロケールを固定することを受け入れられるなら、スクレイパーを構築してください。URLのリストを作ること自体が難しい部分であるか、クロールを動かし続ける必要がある場合は、収集レイヤーを購入してください。価格帯とストライクスルーのフィールドがすでに分離された状態で届くため、データセットが価格関連の作業に使われる場合も購入してください。通貨列は、どちらのパスでもフィルタリングが必要です。
上記で計測したショップでは、構築には1,895回のリクエストと、1,842件の出品に対してシングルスレッドでおよそ13時間かかります。購入側は、準備済みレコードの最低注文数です。この2つの数字は直接比較できません。なぜなら、構築コストはショップごとであり、購入コストは複数のショップに分散させられる最低限度額だからです。
最終的な考察
Etsyは、まさにその公開ページ上でschema.orgのJSON-LDを公開しながらも、通常のフェッチをブロックするため、抽出は短い作業であり、アクセスこそが作業の大半を占めます。トランスポートがアクセスを決めるわけではありません。なぜなら、ヘッド付きブラウザは、チューニングされた9種類のHTTPクライアントが読み込めなかったページを読み込みましたが、Etsyはその同じブラウザの2回目のリクエストを拒否したからです。そのため、工学的な課題は、どうやってブラウザのように見せるかではなく、どうやって収集を続けるかです。どちらのパスを選んでも、データの失敗はアクセスの失敗よりもコストがかかります。なぜなら、通貨が混在した列や満額で表示される削除済みの出品はきれいにパースされ、数カ月後に発見することになるからです。クローラーを書く前に、1つの出品を生のフェッチと構造化抽出器の両方で取得し、フィールドを差分比較し、その結果に構築か購入かを決めさせてください。
よくある質問
Etsy用のAPIはありますか?
はい。Etsy Open API v3は、数えた時点で76のパスを掲載しており、そのうち31のGETオペレーションはアプリケーションキーのみが必要です。出品、ショップ、レビュー、分類情報を返します。あなたが運営していないショップについては、多くのデータプロジェクトが必要とする出品ごとの売上、キーワード検索ボリューム、コンバージョン率、履歴を省略しています。
Etsy APIは無料ですか?
API自体には公開された価格はありませんが、アクセスは承認と、アプリケーションキーごとに設定されたレート制限に依存します。Etsyは誰がより高い制限を得られるかを決定し、追加の条件や料金を課す場合もあります。実質的なコストは、料金ではなくレート制限です。
なぜ私のEtsyスクレイパーはブロックされているのですか?
EtsyはDataDomeを使用しており、短いブロックページと、1.0が最悪とするスケールであなたのリクエストを採点するX-DataDome-riskscoreヘッダーとともに403を返します。このスコアは、あなたの呼び出し元IPとリクエストのシグネチャに従います。当社のテストでは、ヘッダーの編集はスコアを下げ、ChromeのTLSなりすましはスコアを上げましたが、どちらもページは返りませんでした。
Etsyはウェブスクレイピングを許可していますか?
Etsyの明示的な許可なしには認められません。規約のほうがより厳しい文書です。robots.txtは、すべてのロケールバリアントでキーワード検索、売却履歴、お気に入り登録者を禁止し、出品ページとショップページは開いたままにしています。Etsyは予告なしにそのファイルを書き換えるため、構築する前に最新版を読んでください。
PythonでEtsyをスクレイピングできますか?
はい。出品ページにはschema.orgのJSON-LDが埋め込まれているため、抽出にCSSセレクターは不要です。@typeがProductであるapplication/ld+jsonブロックを選び、offerオブジェクトをフラット化してください。フェッチこそが難しい部分であり、大量に収集するには新しいブラウジングコンテキストとローテーションするアドレスが必要です。
Etsyの売上データはどうすれば入手できますか?
売上はショップレベルでのみ公開されています。getShopエンドポイントは、ショップ全体の生涯合計であるtransaction_sold_countを返します。あなたが運営していないショップについて、それを出品ごとに分解するものは何もないため、ツールが示す出品ごとの数字は別の場所から来ています。それらは推定値として扱い、ショップの合計と照合してください。
Etsyにはクロール用のサイトマップがありますか?
私たちが最後に確認した時点ではありませんでした。robots.txtファイルはSitemap:ディレクティブをゼロ件宣言しており、/sitemaps.xmlは空の本文で403を返します。サイトマップがない状態では、ショップページ、API のfindAllListingsActiveエンドポイント、または準備済みデータセットからURLを発見する必要があります。この3つのいずれも、禁止されている検索パスには触れません。
EtsyはGPTBotのようなAIクローラーをブロックしていますか?
私たちが確認した時点では、名指しではされていませんでした。robots.txtファイルは3つのユーザーエージェントグループのみを宣言しており、そのいずれもAIクローラーではなく、Etsyはllms.txtもai.txtも公開していません。それでもDataDomeはGPTBotとClaudeBotを拒否し、どちらもChromeのUser-Agentが記録した0.923よりも悪い0.9814というスコアでした。無意味な文字列も同じスコアでした。