データパイプラインアーキテクチャとは、データをソースから人、モデル、エージェントへと移動させるシステムの設計です。データがどのように収集され、保存され、検証され、変換され、提供されるかを定義します。
公開ウェブサイトがソースである場合、小売業者が価格の代わりに国選択ページを提供していても、パイプラインは成功として記録することがあります。1つの家庭用回線から、4つのオープンソースクライアントそれぞれが13の検索・一覧ページを3回ずつ取得しました。88件の成功レスポンスのうち、39件は使用可能なデータを含んでいませんでした。
このガイドでは、各ステージの設計方法、パターンの選択方法、これらの失敗の検出方法、そして構築するか購入するかの判断方法を示します。
要約
- ブロックページではなく、期待するデータの有無を確認する。ブロックページ検出器は、データのない39件の成功レスポンスのうち、わずか8件しか検出できませんでした。
- 各フィールドをその固有の粒度でモデル化する。Amazonは1つのレビュー合計を商品リストのバリエーション全体で共有するため、行の合計により20商品のレビュー数が23%過大に表示されました。
- 大量の場合、LLMにパーサーを書かせ、すべてのページを読ませない。あるAmazonページのメインコンテンツは、12フィールドのレコードの19倍のトークンを使用しました。
- 収集ツールを受理レコードあたりのコストで比較する。取得テストでは、88件の成功レスポンスのうち39件にデータがなかったため、データ契約に合格した行のみをカウントしてください。
データパイプラインアーキテクチャ図とステージ
典型的なデータパイプラインアーキテクチャには5つのステージがあります。各ステージは1つの役割を担い、次のステージがその出力を検証できます:
- 収集。データベースにはチェンジ・データ・キャプチャを、SaaSツールにはAPI呼び出しを、ウェブサイトにはHTTPまたはブラウザリクエストを使用して、各ソースからデータを取得します。
- 生データの保存。パースを行う前に、届いたままの状態でオブジェクトストレージにデータを書き込みます。メダリオン・アーキテクチャでは、この生データがブロンズ層を形成します。
- 検証。必須フィールド、型、範囲を列挙したデータ契約に照らして、すべてのレコードを確認します。失敗したレコードは、理由コードとともに隔離先へ送ります。
- 変換。ウェアハウスまたはレイクハウスでデータの重複排除、結合、モデル化を行います。シルバーテーブルには検証済みの行が保持され、ゴールドテーブルはすぐに使用できる状態です。
- 提供。結果をダッシュボード、アプリケーション、モデル、AIエージェントに届けます。
Airflow、Dagster、Prefectなどのオーケストレーターが各ステージをスケジュールします。モニタリングでは、これらすべてにわたって鮮度、量、フィールド充足率、受理レコードあたりのコストを追跡します。
データパイプライニングとは、パイプラインを構築・運用する作業全般を指す一般的な用語であり、「データパイプ」はパイプライン自体を指す略称です。ETL(抽出、変換、ロード)はその中の1つのパターンであり、ELTは別のパターンで、まず生データをロードしてからウェアハウス内で変換します。
ビッグデータパイプラインアーキテクチャは、ストレージと計算を別々にスケールさせる必要がある量において、同じ5つのステージを使用します。そのため通常、データはオブジェクトストレージとオープンなテーブル形式で保持されます。
公開ウェブデータには、収集する価値のあるURLを見つける発見ステップが加わり、SERP APIが検索結果からこれを実行できます。収集には、Bright DataのWeb Scraper APIが公開ウェブサイトから構造化されたレコードを返します。Web Unlockerはボット対策を処理し、独自のパーサーを書くチームには生のページを返します。
このデータパイプラインアーキテクチャ図は、公開ウェブサイトがソースの1つである場合に各ステージがどのようにつながるかを示しています:
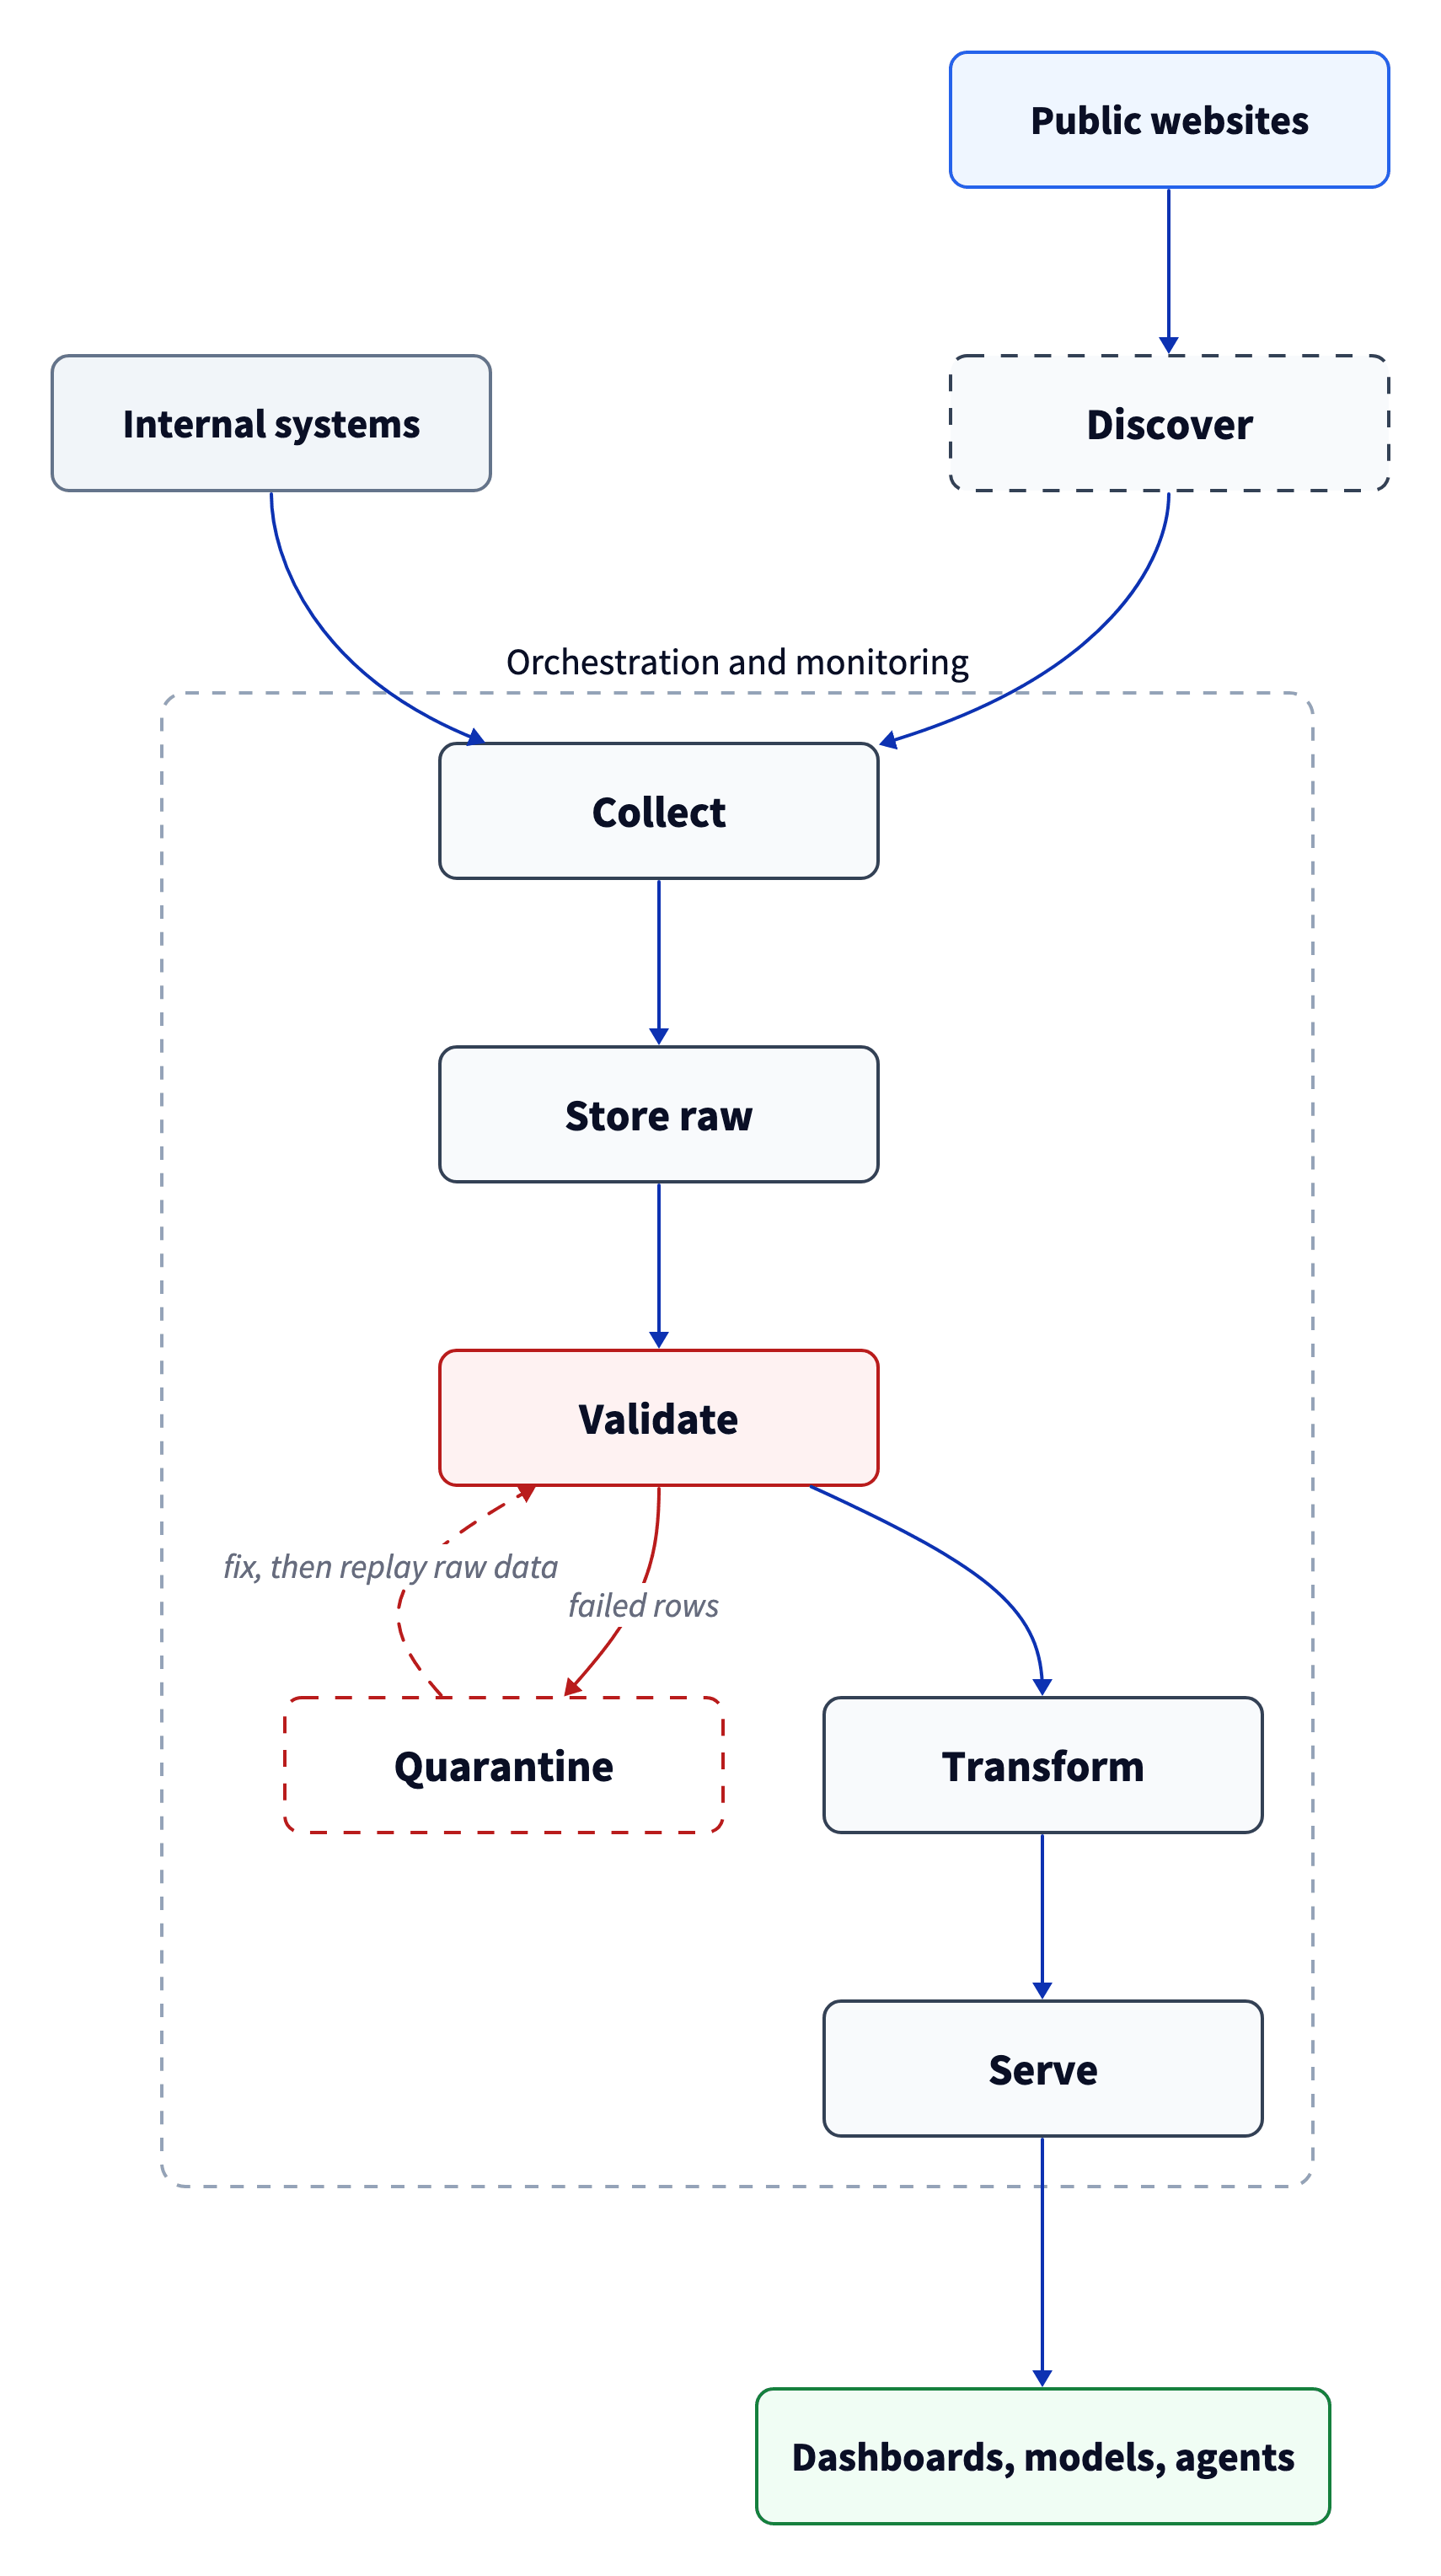
ウェブソースは、検証ステージと隔離経路で最も多くの作業を増加させます。
バッチ、ストリーミング、ハイブリッド、オンデマンドのデータパイプラインアーキテクチャ例
適切なパターンは、意思決定にどれだけ速く新しいデータが必要かによって決まります。
バッチ。ある小売業者は毎晩5万商品分の競合価格を収集し、再価格設定エージェントが朝にそれを読み込みます。Web Scraper APIは、Amazon S3、Google Cloud Storage、Snowflakeなどの宛先に各実行結果を直接届けることができます。
ストリーミング。あるブランドチームはSNS投稿とニュースを監視します。言及は数時間で価値を失う可能性があるからです。Kafkaがイベントを運び、Flinkなどのストリームプロセッサが時間窓ごとにカウントを計算し、コネクタが結果をIcebergテーブルに書き込みます。Sparkを使った実例については、ウェブデータによるSpark Structured Streamingのガイドを参照してください。
ハイブリッド。ある投資リサーチチームは、履歴用に求人情報の日次バッチを保持し、短い監視対象リストの商品について価格変動をストリーミングします。従来の設計では、これを2つの別々の経路として実行していました。これはラムダ・アーキテクチャとして知られています。多くの新しいスタックでは、ストリームをIcebergテーブルに書き込むため、バッチとストリーミングのジョブが同じデータを読み込みます。
オンデマンド。あるショッピングエージェントは、ユーザーからの問い合わせ時に1つの商品のライブ価格と在庫を確認します。パイプラインは、意思決定が許容する期限より古くない限り、最新の検証済みの行を提供します。古い場合は、同期型Web Scraper APIリクエストが1回の呼び出しで最新のレコードを返し、パイプラインはそれを同じ契約に照らして確認します。ライブ取得にはユーザーが許容できるタイムアウトを設定し、期限切れの場合は保存された行とその経過時間とともに回答してください。
最新のデータパイプラインアーキテクチャのデフォルト設定
新しいデータパイプラインの設計は、各レイヤーについて以下のデフォルト設定から始めてください:
| レイヤー | デフォルト | 理由 |
|---|---|---|
| ストレージとテーブル | オブジェクトストレージ内の生ファイル、Apache Icebergなどのオープン形式のテーブル | Snowflake、Databricks、オープンソースエンジンが同じIcebergテーブルを読み込むため、1つのデータコピーですべてに対応できる |
| 変換 | バージョン管理されたSQLモデル、dbtなどのツールで構築 | モデルは他のコードと同様にコードレビューとテストを受けられる |
| オーケストレーション | サポートされているリリースのAirflow、Dagster、またはPrefect | 開始前にサポート期間を確認してください。Airflow 2は2026年4月にサポート終了を迎えました |
| データ契約 | Open Data Contract Standard(ODCS)などの形式で、各テーブルごとの契約ファイル | ODCSはAIエージェントがデータをどう使用できるかも記載できるため、使用ルールが型と所有者とともに保存される |
| エージェントアクセス | ガバナンスされたテーブル上のModel Context Protocol(MCP)インターフェース | ほとんどのエージェントフレームワークがMCPをサポートしており、Linux Foundationのプロジェクトがこれを維持している |
まだAWS Data Pipelineを使用している場合は、移行を計画してください。AWSは2024年に新規顧客向けの受付を終了しました。
公開ウェブデータが異なるデータ取り込みパイプラインを必要とする理由
内部ソースとは異なり、公開ウェブサイトはその変更をチームと調整しません。予告なしにマークアップやボット対策を変更したり、地域やクライアントによってコンテンツを変えたり、データなしで成功ステータスを返したりすることがあります。内部ソースは通常、スキーマ移行や新しいAPIバージョンなど、計画された方法で変化します。
成功ステータスはデータが届いたことを保証しない
2xxステータスはサーバーが応答したことを示すにすぎません。13の検索・一覧ページに対する取得テストは、2xxステータスが何を隠し得るかを示しています。ページは小売、旅行、求人、不動産、レビュー、検索のサイトから取得されました。
4つの一般的なオープンソースクライアントそれぞれが、インドの家庭用インターネット回線から、プロキシなしで各ページを3回取得しました。レスポンスは、そのサイトの一覧を示すHTMLパターンを含んでいる場合にのみデータとしてカウントされました。空の成功レスポンスの割合はクライアントとネットワークによって異なるため、以下のようなコンテンツチェックで測定してください。
| クライアント | 2xxレスポンス | データなしの2xxレスポンス | 3回の取得のいずれかでデータがあったサイト(13件中) |
|---|---|---|---|
Python requests、デフォルトヘッダー |
15 | 9 | 2 |
Python requests、Chromeヘッダー |
24 | 10 | 5 |
Chromeをなりすますcurl_cffi |
29 | 9 | 7 |
| ヘッドレスChrome(Playwright) | 20 | 11 | 3(通常のUser-Agentで再実行した場合は8) |
すべてのクライアントを通して、88件の成功レスポンスのうち39件は使用可能なデータを含んでおらず、そのうち27件はHTTP 200、12件はHTTP 202でした。ステータスコードは失敗した取得にフラグを立てることはできても、良好な取得を確認することはできませんでした。
39件のうちの1件は、小売業者がインドの家庭用回線に対して検索結果の代わりにHTTP 200で提供したこのページでした:
そのレスポンスの保存されたHTMLからレンダリングしたもの。
これらの失敗はエラーのようには見えませんでした。「press-and-hold」や「unusual-traffic」ページなど、一般的な8つのブロックページのシグネチャから構築した検出器は、39件のうちわずか8件しか検出できませんでした。残りは、リストが対象としていないチャレンジページ、小売業者の国選択ページ、JavaScriptのみのページ、そして結果が空の670KBのページでした。
670KBのページは、結果が空である点を除いては完全なように見えました:
ヘッドレスChromeがHTTP 202で受け取ったページを、保存されたHTMLからレンダリングしたもの。レスポンスサイズのチェックだけではこれを通してしまったでしょう。
同じ検出器は、49件の良好なレスポンスのうち12件をブロックと誤って判定しました。2つのサイトでは、ボット対策スクリプトが通常の一覧ページで読み込まれており、そのタグがシグネチャの1つと一致しました。ブロックページを検出するのではなく、期待するデータの有無をテストしてください。
ボット対策はクライアントを実際のブラウザと比較する
サイトは、TLSフィンガープリントとヘッダーを実際のブラウザと比較することで、HTMLが送信される前にクライアントを識別できます。フィンガープリントチェックでは、Web UnlockerのTLSフィンガープリントは最新のインストール済みChromeのそれと一致しました。テスト当時、curl_cffiなりすましライブラリにおける最新のChromeターゲットは、インストール済みChromeより5メジャーバージョン遅れていました。ヘッドレスChromeは、User-AgentにHeadlessChromeを含んでいる間は13サイト中わずか3サイトからしかデータを取得できず、通常のUser-Agentでは8サイトからデータを取得できました。
その家庭用回線からは、13サイト中5サイトがどのオープンソースクライアントにもデータを返しませんでしたが、このテストはクライアントとネットワークを切り分けてはいません。アクセスを維持し続けるには、ブラウザのリリース、フィンガープリント、ヘッダー、IPレピュテーションの変化を追跡し続ける必要があります。その作業のために人を雇うか、ページ用のWeb Unlockerやフルブラウザセッション用のBrowser APIを通じて購入するかのいずれかです。
エージェントも同じ防御に直面する
取得テストの13のURLに対して、Claude CodeのWebFetchツールは1回の実行でそのうち2件から一覧を返しました。残り11件のリクエストのうち、7件はエラーステータスを返しました。
残りの4件は、チャレンジページ、国選択ページ、空のページ、エラーメッセージを返しましたが、すべて成功ステータスでした。エージェント自身がコンテンツを確認する必要があります。
ライブアクセスのために、エージェントはSERP APIとWeb Unlockerを通じて検索とページ取得を実行するBright Data MCP Serverを使用できます。
一部のサイトでは、エージェントが自身を識別し、合意された条件のもとでアクセスを得ることもできます。Cloudflare上のサイトは、Web Bot Authでリクエストに署名するエージェントを検証できます。Really Simple Licensing(RSL)標準では、サイトがライセンス条項を公開できます。サイトがどちらかを提供している場合は、それを使用することを計画してください。
HTTPステータスだけでなく、収集ツールが報告する内容を確認する
Web Unlockerは、各取得の結果を2つのレスポンスヘッダーで報告します。x-brd-status-codeにはターゲットサイトのステータスが含まれます。x-brd-errorには、Web Unlockerエラーコードに記載されている通り、取得が失敗した際の理由が含まれます。取り込みコードは、これらのヘッダー、API呼び出し自体のステータス、そしてコンテンツに基づいて何をすべきかを判断する必要があります。
このチェックをcontent_check.pyとして保存してください。無効なキーやゾーンにはエラーを発生させ、それ以外の場合はactionフィールドにaccept、retry、またはquarantineを返します:
import os, re, requests

# One marker per source, a pattern that appears only when real records are present.
MARKERS = {
    "amazon_search": r'data-component-type="s-search-result"',
    "walmart_search": r'"usItemId"',
}


def fetch_and_check(source: str, url: str, min_hits: int = 5) -> dict:
    r = requests.post(
        "https://api.brightdata.com/request",
        headers={"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"},
        json={"zone": "web_unlocker", "url": url, "format": "raw", "country": "us"},
        timeout=(15, 240),
    )
    # A bad key or zone name. A retry won't fix it.
    if r.status_code in (400, 401, 403):
        r.raise_for_status()
    # The fetch failed or reached a rate limit. Retry later.
    if r.headers.get("x-brd-error") or r.status_code == 429 or r.status_code >= 500:
        reason = r.headers.get("x-brd-error") or f"HTTP {r.status_code}"
        return {"source": source, "action": "retry", "reason": reason[:60]}
    hits = len(re.findall(MARKERS[source], r.text))
    action = "accept" if hits >= min_hits else "quarantine"
    return {
        "source": source,
        "action": action,
        "target_status": r.headers.get("x-brd-status-code"),
        "marker_hits": hits,
        "bytes": len(r.content),
    }


if __name__ == "__main__":
    amazon = "https://www.amazon.com/s?k=noise+cancelling+headphones"
    walmart = "https://www.walmart.com/search?q=noise+cancelling+headphones"
    print(fetch_and_check("amazon_search", amazon))
    print(fetch_and_check("walmart_search", walmart))
これを実行するには、Bright Data コントロールパネルのWeb Accessの下で、その製品用のWeb Unlockerゾーン(名前付きの設定)を作成してください。新規アカウントは月額の無料クレジットを受け取れ、このガイドのスクリプトを実行するには十分です。
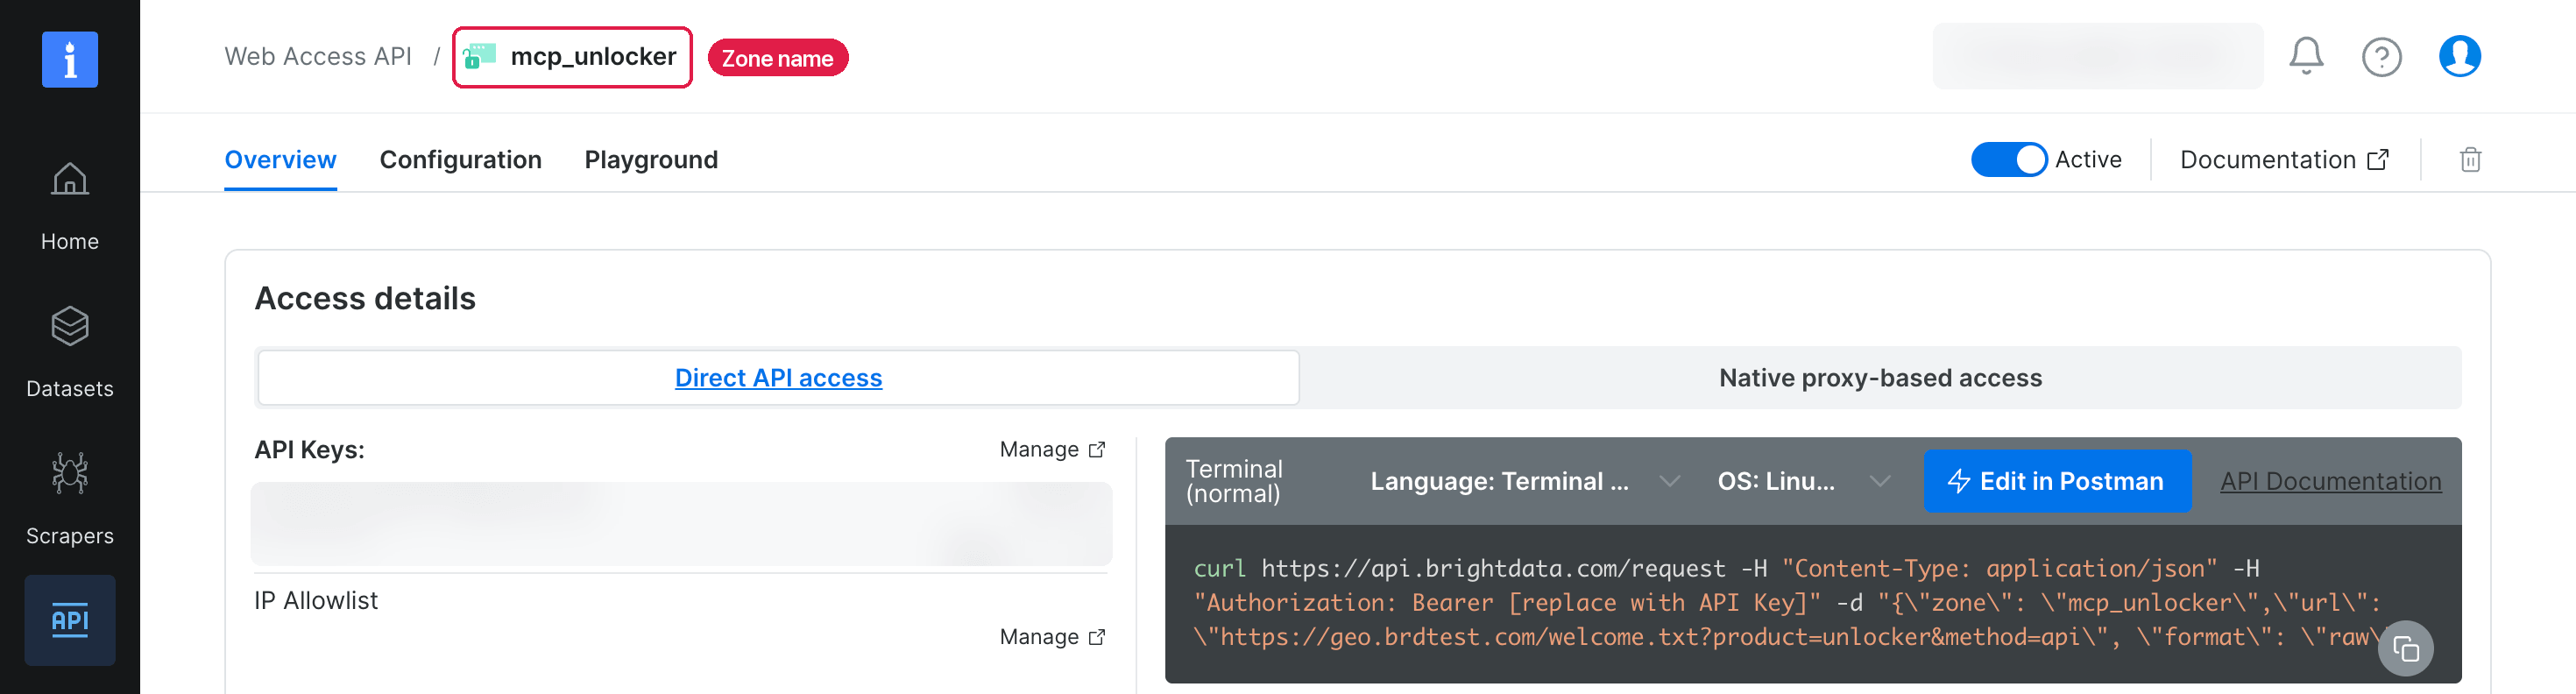
コントロールパネルのAccount settingsでAPIキーを作成し、BRIGHTDATA_API_KEYという名前の環境変数に保存してください。web_unlockerをあなたのゾーン名に置き換えてください。名前はゾーンのページの上部に表示され、そのページのリクエスト例でもそれが使用されています:
pip install requestsの後、python content_check.pyを実行してください。サンプル実行では両方のページが受理されました:
{'source': 'amazon_search', 'action': 'accept', 'target_status': '200', 'marker_hits': 16, 'bytes': 1516805}
{'source': 'walmart_search', 'action': 'accept', 'target_status': '200', 'marker_hits': 395, 'bytes': 1535496}
パイプラインは、失敗のたびに待ち時間を長くするバックオフを使ってretryの取得を繰り返します。quarantineのページは、ソースが変更された可能性があるため、人または分類器に送られます。フロントエンドは予告なしに変更される可能性があるため、あるソースが突然データを返さなくなった場合は、まずそのマーカーがページのHTML内にまだ存在するかを確認してください。
ウェブソース向けの参考データ取り込みパイプライン
以下の参考パイプラインは、構造化されたレコードを返すWeb Scraper APIを使用するため、検証はページのパースではなくフィールドを確認します。
発見で得られた結果をフィルタリングする
1つのヘッドホンモデルに対する検索で、SERP APIはGoogleの7件のオーガニック結果、AI Overview、動画、People Also Askを別々のJSONフィールドとして返しました。Googleは7件のうちわずか3件の小売業者ページをランク付けしており、そのうちの1件は別の製品(同じモデルのイヤホン版)を販売していました。AI Overviewの価格に関する記述は、最初の情報源として小売業者ではなくYouTubeのレビューを引用していました。AIの回答は確認すべき主張として扱い、ドメインやモデル番号などの識別子で結果をフィルタリングしてください。
パイプラインの構築と実行
このパイプラインは、フィルタリングされた発見結果のような商品URLのリストを受け取ります。Web Scraper APIの/triggerエンドポイントでジョブを開始し、/progressで追跡し、/snapshotでレコードをダウンロードします。include_errors=trueにより、APIは失敗した各入力をerror_code付きの独自のレコードとして報告します。
Pythonでは、Bright Data SDKがこれら3回の呼び出しをスクレイパーごとの1回の呼び出しに置き換えます。以下のスクリプトはエンドポイントを直接呼び出すため、各ステージが見える状態を保ち、どのオーケストレーターとも連携します。pipeline.pyとして保存してください。その関数は図中のステージに沿っており、テーブル用にcollect()、store_raw()、validate()、model()、フラグ用にdomain_checks()があります:
"""Reference web data pipeline that collects, stores raw, validates, models, and checks.

Collection: Bright Data Web Scraper API (async trigger + snapshot download).
Storage: a local folder in place of object storage (bronze), DuckDB for silver and gold.
"""
import json, os, sys, time, pathlib, datetime as dt
import duckdb, requests
from pydantic import BaseModel, Field, ValidationError

API = "https://api.brightdata.com/datasets/v3"
# Replay needs no key.
HEADERS = {"Authorization": f"Bearer {os.environ.get('BRIGHTDATA_API_KEY', '')}"}
DATASET = "gd_l7q7dkf244hwjntr0"  # Amazon products, collect by URL
LAKE = pathlib.Path("lake")


def collect(inputs: list[dict]) -> str:
    """Trigger an async collection and wait for it. Returns the snapshot ID."""
    params = {"dataset_id": DATASET, "include_errors": "true"}
    r = requests.post(
        f"{API}/trigger", headers=HEADERS, json=inputs, params=params, timeout=60
    )
    r.raise_for_status()
    snapshot_id = r.json()["snapshot_id"]
    deadline = time.time() + 3600  # fail after an hour, so the orchestrator can alert
    while time.time() < deadline:
        url = f"{API}/progress/{snapshot_id}"
        p = requests.get(url, headers=HEADERS, timeout=60).json()
        if p["status"] == "ready":
            summary = {k: p.get(k) for k in ("records", "errors", "error_codes")}
            print("progress:", summary)
            return snapshot_id
        if p["status"] in ("failed", "canceled"):
            raise RuntimeError(f"snapshot {snapshot_id} ended as {p['status']}")
        time.sleep(15)
    raise TimeoutError(f"snapshot {snapshot_id} not ready after 1 hour")


def store_raw(snapshot_id: str) -> pathlib.Path:
    """Write the snapshot unchanged to an immutable, partitioned path."""
    url = f"{API}/snapshot/{snapshot_id}"
    r = requests.get(url, headers=HEADERS, params={"format": "ndjson"}, timeout=300)
    # Anything but 200, such as 202 while the snapshot builds, isn't data.
    if r.status_code != 200:
        raise RuntimeError(
            f"snapshot {snapshot_id} not downloadable: HTTP {r.status_code}"
        )
    day = dt.datetime.now(dt.timezone.utc).date()
    path = LAKE / "bronze/amazon_products" / f"dt={day}" / f"{snapshot_id}.ndjson"
    path.parent.mkdir(parents=True, exist_ok=True)
    if not path.exists():  # a stored snapshot is never rewritten
        path.write_bytes(r.content)
    return path


class Product(BaseModel):
    """The data contract, which defines what downstream tables can receive."""
    asin: str = Field(pattern=r"^[A-Z0-9]{10}$")
    parent_asin: str | None = None
    title: str = Field(min_length=3)
    final_price: float = Field(gt=0, lt=100_000)
    currency: str = Field(pattern=r"^[A-Z]{3}$")
    rating: float | None = Field(default=None, ge=0, le=5)
    reviews_count: int | None = Field(default=None, ge=0)
    buybox_seller: str | None = None
    timestamp: dt.datetime


def validate(path: pathlib.Path) -> tuple[list[dict], list[dict]]:
    """Split a raw file into accepted rows and quarantined rows with a reason."""
    accepted, quarantined = [], []
    for line in path.read_text().splitlines():
        rec = json.loads(line)
        if rec.get("error_code"):  # failed input, reported per record
            quarantined.append({"input": rec.get("input"), "reason": rec["error_code"]})
            continue
        try:
            row = Product(**rec).model_dump()
            row["snapshot_file"] = path.name  # lineage back to the raw bytes
            accepted.append(row)
        except ValidationError as e:
            fields = ",".join(str(x["loc"][0]) for x in e.errors())
            reason = f"contract:{fields}"
            quarantined.append({"input": rec.get("url"), "reason": reason})
    return accepted, quarantined


def model(accepted: list[dict]) -> duckdb.DuckDBPyConnection:
    """Load silver idempotently, then build gold tables at the right grain."""
    con = duckdb.connect(str(LAKE / "warehouse.duckdb"))
    con.execute("SET TimeZone = 'UTC'")  # store and show every observation in UTC
    con.execute("""CREATE TABLE IF NOT EXISTS silver_prices (
        asin TEXT, parent_asin TEXT, title TEXT, final_price DOUBLE,
        currency TEXT, rating DOUBLE, reviews_count BIGINT, buybox_seller TEXT,
        observed_at TIMESTAMPTZ, snapshot_file TEXT,
        PRIMARY KEY (asin, observed_at))""")
    # The primary key makes a rerun a no-op instead of a duplicate.
    for r in accepted:
        con.execute(
            "INSERT OR IGNORE INTO silver_prices VALUES (?,?,?,?,?,?,?,?,?,?)",
            [r["asin"], r["parent_asin"] or r["asin"], r["title"], r["final_price"],
             r["currency"], r["rating"], r["reviews_count"], r["buybox_seller"],
             r["timestamp"], r["snapshot_file"]],
        )
    con.execute("""CREATE OR REPLACE VIEW latest_prices AS
        SELECT * FROM silver_prices
        QUALIFY row_number() OVER (PARTITION BY asin ORDER BY observed_at DESC) = 1""")
    # Price belongs to the variant. Reviews belong to the parent listing.
    con.execute("""CREATE OR REPLACE VIEW gold_parent_reviews AS
        SELECT parent_asin, max(reviews_count) AS reviews_count, max(rating) AS rating,
               count(DISTINCT asin) AS variants_seen
        FROM latest_prices GROUP BY parent_asin""")
    return con


def domain_checks(con: duckdb.DuckDBPyConnection) -> None:
    """Compare each product with its previous observation. Flag, never drop."""
    con.execute("""CREATE OR REPLACE TABLE flags AS
        WITH obs AS (
            SELECT *,
                lag(final_price) OVER w AS prev_price,
                lag(currency) OVER w AS prev_currency,
                lag(reviews_count) OVER w AS prev_reviews,
                lag(buybox_seller) OVER w AS prev_seller
            FROM silver_prices WINDOW w AS (PARTITION BY asin ORDER BY observed_at))
        SELECT asin, observed_at, 'price_moved_over_30pct' AS flag FROM obs
            WHERE abs(final_price - prev_price) / prev_price > 0.3
        UNION ALL SELECT asin, observed_at, 'currency_changed' FROM obs
            WHERE currency <> prev_currency
        UNION ALL SELECT asin, observed_at, 'reviews_went_down' FROM obs
            WHERE reviews_count < prev_reviews
        UNION ALL SELECT asin, observed_at, 'reviews_jumped_over_50pct' FROM obs
            WHERE reviews_count > prev_reviews * 1.5
        UNION ALL SELECT asin, observed_at, 'buybox_seller_changed' FROM obs
            WHERE buybox_seller <> prev_seller""")


if __name__ == "__main__":
    # --replay loads every bronze file into the tables again, with no new crawl.
    if sys.argv[1] == "--replay":
        raws = sorted(LAKE.glob("bronze/amazon_products/*/*.ndjson"))
    else:
        inputs = json.load(open(sys.argv[1]))
        snapshot_id = sys.argv[2] if len(sys.argv) > 2 else collect(inputs)
        raws = [store_raw(snapshot_id)]
    for raw in raws:
        ok, bad = validate(raw)
        con = model(ok)
        print(f"{raw.name}: accepted={len(ok)} quarantined={len(bad)}")
        for q in bad:
            print("quarantine:", q)
    domain_checks(con)
    print(con.sql(
        "SELECT count(*) AS rows, count(DISTINCT asin) AS asins FROM silver_prices"
    ))
    print(con.sql(
        "SELECT * FROM gold_parent_reviews WHERE variants_seen > 1 ORDER BY parent_asin"
    ))
    print(con.sql("SELECT * FROM flags ORDER BY asin"))
スクリプト内のDATASETの値は、Bright Dataが保守している事前構築済みスクレイパーの1つであるAmazon商品スクレイパーのIDです。コントロールパネル内のそのページでは、zipcode入力フィールドの隣のリクエスト例にそのIDが表示されています:
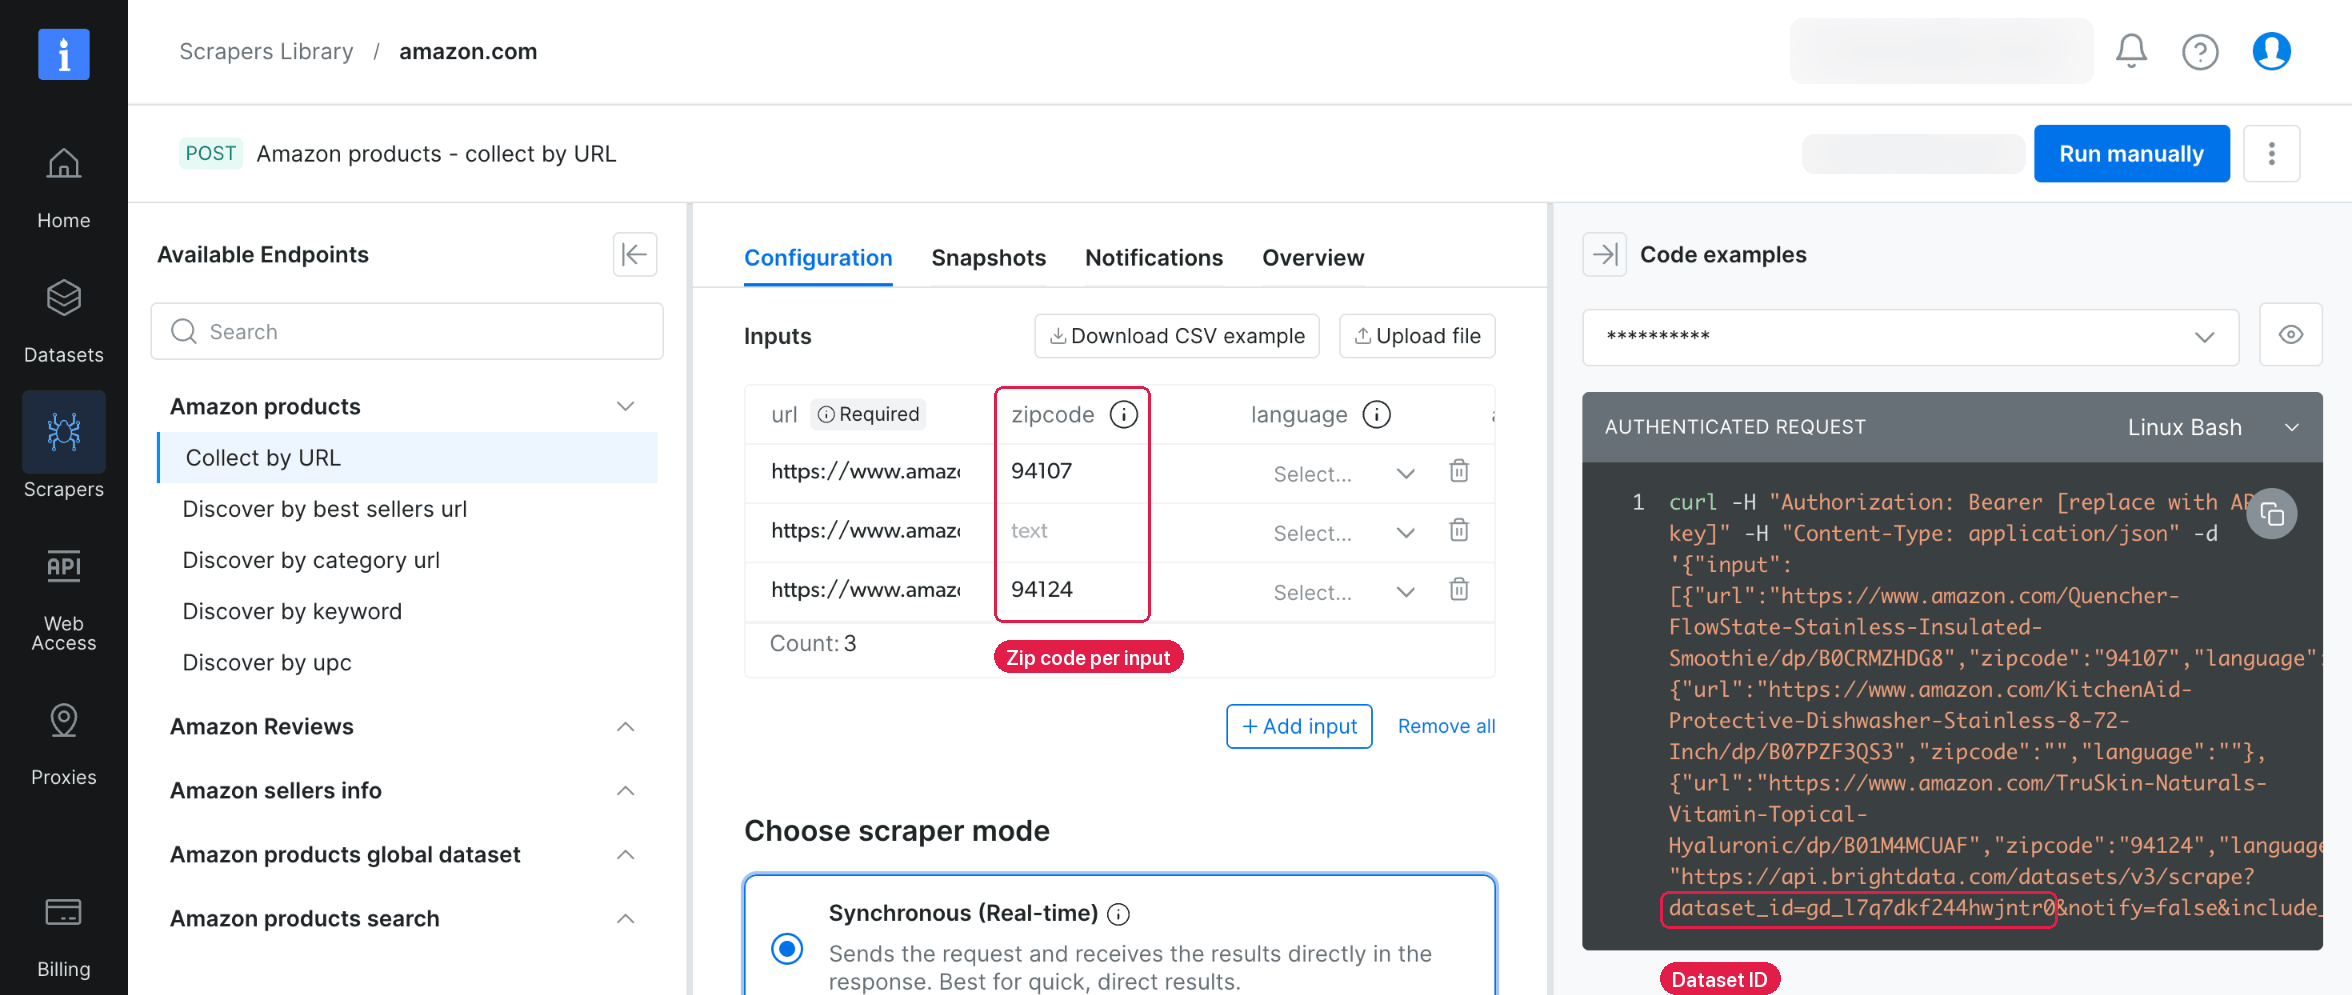
ページのリクエスト例は、同じ呼び出しでレコードを返す同期型の/scrapeエンドポイントを使用しています。スクリプトでは代わりに/triggerを使用しており、これはバックグラウンドで大規模なバッチを実行し、結果をスナップショットとして届けます。
Python 3.10以降では、入力を[{"url": "https://www.amazon.com/dp/<ASIN>", "zipcode": "<ZIP>"}]形式でinputs.jsonとして保存してください。ここで<ASIN>はAmazonの商品IDです。その後、以下を実行してください:
pip install requests pydantic duckdb
export BRIGHTDATA_API_KEY="your_api_key"
python pipeline.py inputs.json
python pipeline.py --replay
最初のpythonコマンドは1回の実行を収集して読み込みます。--replayコマンドは、APIを呼び出さずに、保存されたすべての生ファイルをテーブルに再度読み込みます。以下の出力は、20のAmazon商品と意図的に無効にした1つのIDの監視対象リストから、約2時間間隔で2回収集し、その後再生したものです:
sd_mvgo38o997m0dxre9.ndjson: accepted=20 quarantined=1
quarantine: {'input': {'url': 'https://www.amazon.com/dp/B0ZZZZZZZZ', 'asin': '', 'zipcode': '', 'language': ''}, 'reason': 'dead_page'}
sd_mvgsyvcx1fcvvspadf.ndjson: accepted=20 quarantined=1
quarantine: {'input': {'url': 'https://www.amazon.com/dp/B0ZZZZZZZZ', 'asin': '', 'zipcode': '', 'language': ''}, 'reason': 'dead_page'}
┌───────┬───────┐
│ rows  │ asins │
│ int64 │ int64 │
├───────┼───────┤
│    40 │    20 │
└───────┴───────┘

┌─────────────┬───────────────┬────────┬───────────────┐
│ parent_asin │ reviews_count │ rating │ variants_seen │
│   varchar   │     int64     │ double │     int64     │
├─────────────┼───────────────┼────────┼───────────────┤
│ B0FMZYMXNR  │          3015 │    4.2 │             3 │
│ B0GKGDTLG2  │           668 │    4.5 │             6 │
│ B0H1QVR9JS  │         17115 │    4.3 │             2 │
└─────────────┴───────────────┴────────┴───────────────┘

┌────────────┬────────────────────────────┬───────────────────────────┐
│    asin    │        observed_at         │           flag            │
│  varchar   │  timestamp with time zone  │          varchar          │
├────────────┼────────────────────────────┼───────────────────────────┤
│ B0FDKQZ18F │ 2026-10-20 14:53:09.044+00 │ buybox_seller_changed     │
│ B0HJ5K8WN4 │ 2026-10-20 14:53:11.293+00 │ reviews_jumped_over_50pct │
└────────────┴────────────────────────────┴───────────────────────────┘
デモをシンプルに保つため、これらの実行では郵便番号を設定していませんが、本番環境の実行では設定すべきです。シルバーテーブルは20商品すべての両方の観測結果を保持しました。再び再生しても、プライマリキーが重複行をブロックするため、テーブルは40行のままでした。
問題を早期に発見する設計上の選択
- 生データは一度だけ書き込み、決して編集しない。生ファイルを保持しておけば、フィールドを追加する際に新たなクロールは不要です。
Product契約とsilver_pricesテーブルに追加し、lake/warehouse.duckdbを削除して、--replayを実行してください。スクリプトの買い物ボックス出品者フィールド(デフォルトのカートに入れるボタンで勝つ販売者を記録するもの)はこの方法で追加されました。 - HTTP 200以外のダウンロードは拒否する。多くの非同期APIと同様に、スナップショットエンドポイントはジョブがまだ実行中の間はHTTP 202を返します。このチェックを省略するコードは、待機メッセージをデータとして保存してしまいます。その後契約がそれを隔離しますが、メッセージには必要なフィールドが何もないためです。
- 契約チェックの後にフラグを追加し、フラグの立った行は決して削除しない。スキーマチェックは、価格が欠落していることは検出しますが、価格が間違ったパックサイズに紐づいていることは検出しません。上記の出力では、ドメインチェックが買い物ボックス出品者の変更と、27から52に増加したレビュー数にフラグを立てました。カウントは、3回目の実行で15から14に減少するなど、サイトが削除したレビューのように減ることもあります。
- 隔離に理由コードを保持する。
dead_pageの行は、入力URLが消滅したことを意味し、入力リストの所有者がそれを削除します。contract:の行は、フィールドが欠落しているか範囲外であったことを意味し、データエンジニアがソースを確認します。 - すべてのタイムスタンプにタイムゾーンを保持する。タイムゾーンのない列は、14:53 UTCの観測を現地時間の20:23として保存してしまい、ソース間の比較が崩れます。
TIMESTAMPTZとUTCを使用してください。
パイプラインを本番環境で実行する前に
社内外を問わず、データを使う人は通常、各納品をカバレッジ、鮮度、来歴、再現性で判断します。以下の方法はこれら4つの指標を支えます:
- すべての納品とともに実行サマリーを送信する。入力、受理された行、隔離の理由、フラグを一覧表示し、ユーザーがデータセットの対象範囲を正確に把握できるようにしてください。送信した入力しか実行指標はカバーできないため、サイトのサイトマップなど独立した参照とカバレッジを照合することも行ってください。
- 各ソースのベースラインに対してアラートを出す。実行の受理率やフィールドの充足率がベースラインを下回った際にアラートを送信してください。各フィールドには、直近7回分の実行の移動中央値など、その最近の履歴から設定された独自のベースラインが必要です。
- 各フラグに深刻度を設定する。アナリストが目にする前に、エージェントが間違った価格を使用してしまうことがあります。価格や通貨のフラグが立った行はエージェントが読み込めないようにブロックし、小幅なレビュー数の減少など、より深刻度の低いフラグは人に送ってください。ルールは予測した誤りしか検出できないため、受理された行の日次サンプルをソースページと抜き取り照合することも行ってください。
- チェック自体を測定する。偽陽性、偽陰性、手動レビュー率、ソースごとのインシデントを追跡してください。取得テストのブロックページ検出器は良好なページをブロックと誤って判定したため、各チェックにはそれ自体のエラー率が必要です。
- 契約ファイルを1つにまとめる。取り込みコードとテーブルテストは同じファイルを読み込むべきです。オープンソースの
datacontract-cliのようなツールは、ODCSファイルをテーブルに対して直接テストします。 - 収集ツールに通知させる。Web Scraper APIのトリガーは、
notifyをtrueに設定したendpointにWebhook URLを受け付けるため、スナップショットの準備が整ったらオーケストレーターが検証を開始できます。 - 生データの保存に予算を確保する。ある2.4MBのAmazonページはgzip圧縮で449KBになったため、毎日10万件の生ページを収集すると、1日あたり約45GBのストレージが追加されます。同じ商品のフルJSONレコードは圧縮前で24KBで、そのページの約100分の1のサイズでした。各生レスポンスボディを、ステータスとヘッダーとともにJSONまたはWARCアーカイブファイルに保存し、古いファイルはコールドストレージに移動してください。
ウェブサイトが使用する粒度で各フィールドをモデル化する
テーブルの粒度とは、1つの行が何を表すか、例えば1つの商品バリエーションか1つの親リストかということです。スクレイピングされたレコードは1行のように見えますが、そのフィールドは異なる対象を記述していることがあります。マーケットプレイスでは、価格は通常、正確なバリエーションに属します。評価とレビュー数は、しばしば、すべての色とサイズをグループ化する親リストに属します。
監視対象リストにあるヘッドホンの1つのAmazonリストでは、レビュー合計が対象の色のオプションの上に表示されています:
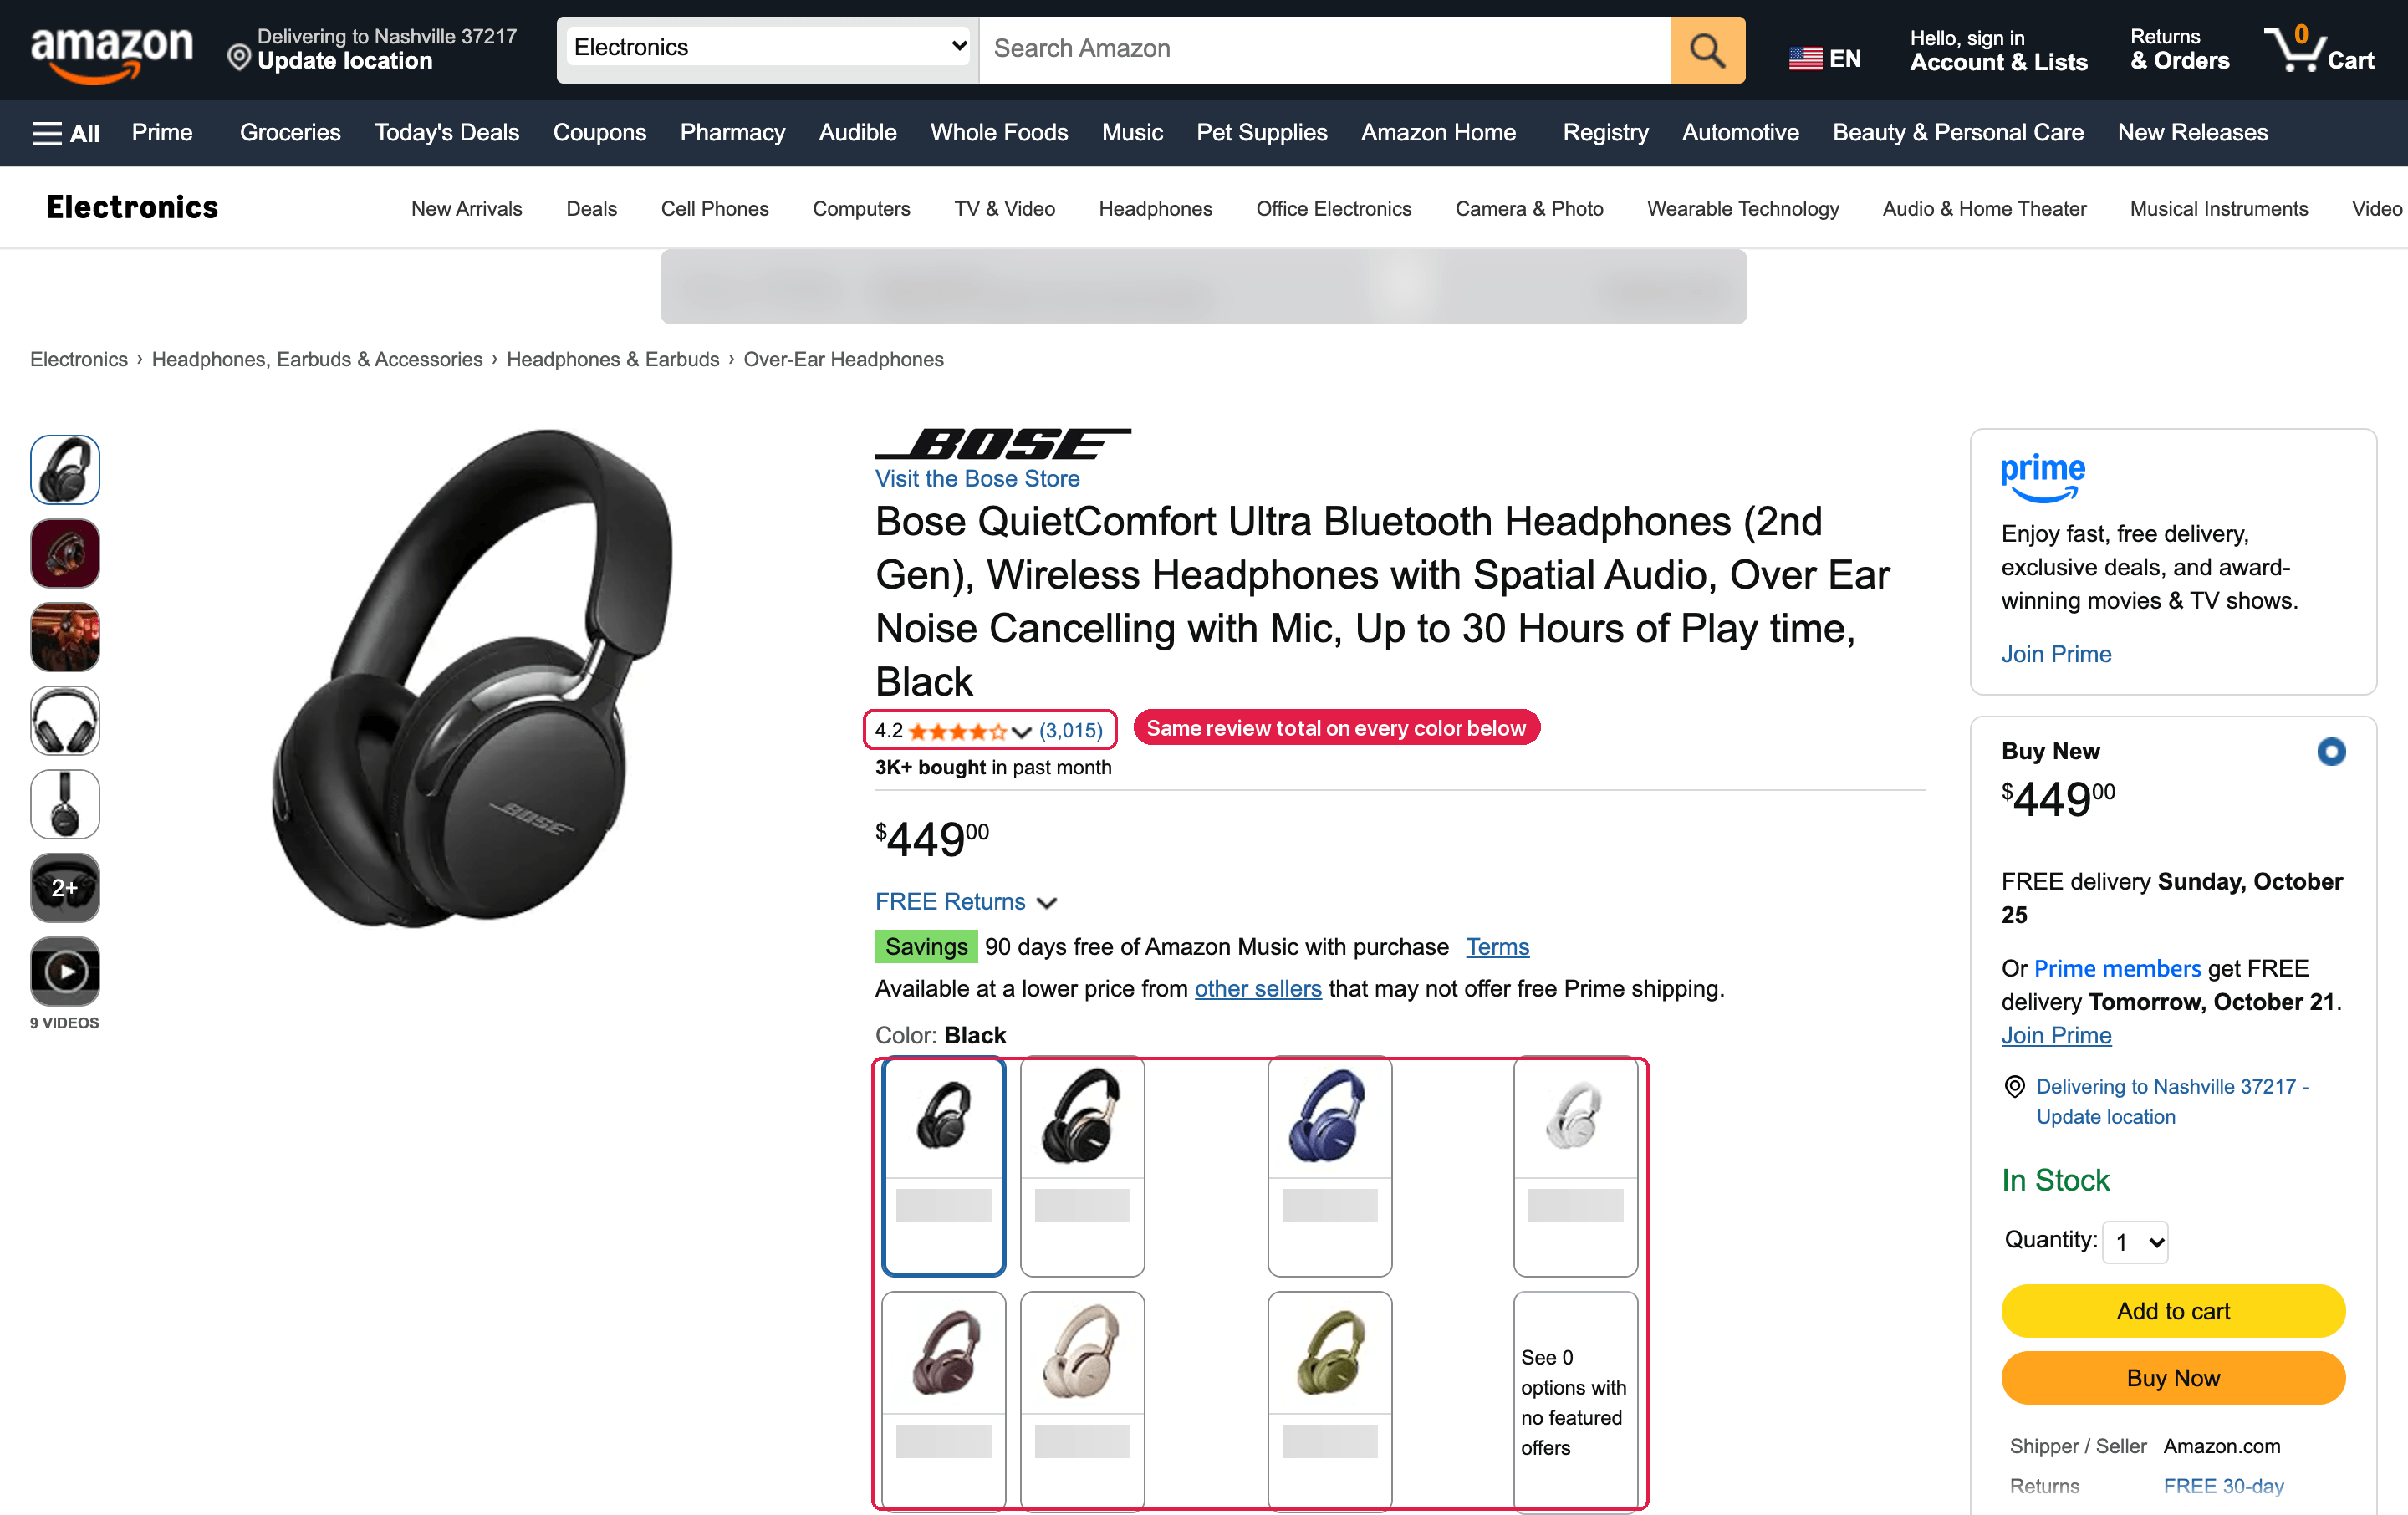
収集されたままのリストを、保存されたHTMLからレンダリングしたもの。監視対象リストの3色はそれぞれ同じ3,015件の評価を報告していました。
20商品の監視対象リストでは、11商品がわずか3つの親リストのバリエーションにすぎず、例えば1対の耳あてには6バージョンがありました。そのため20商品は実質わずか12の親リストに属していました。行ごとの合計では、Boseヘッドホンの3,015件の評価が色ごとに1回ずつ、合計3回カウントされてしまいます。各Web Scraper APIレコードにはparent_asinが含まれているため、これをGROUP BYすれば各レビュー合計を一度だけカウントできます:
-- Wrong grain: one review total per variant row
SELECT sum(reviews_count) AS naive_variant_sum FROM latest_prices;

-- Right grain: one review total per parent listing
SELECT sum(reviews_count) AS parent_grain_sum, count(*) AS parents
FROM gold_parent_reviews;
lake/warehouse.duckdbでは、2つのクエリは以下を返しました:
┌───────────────────┐
│ naive_variant_sum │
│      int128       │
├───────────────────┤
│            139537 │
└───────────────────┘

┌──────────────────┬─────────┐
│ parent_grain_sum │ parents │
│      int128      │  int64  │
├──────────────────┼─────────┤
│           113052 │      12 │
└──────────────────┴─────────┘
行レベルの合計はレビュー数を23%過大に示していました。耳あてのバリエーションの価格が$12.95から$14.99まで幅があったため、価格を親レベルで保存することもできません。各フィールドの粒度をデータ契約に書き込み、粒度ごとに1つのゴールドテーブルを構築してください。
所在地も粒度の一部です。オファーや配送予定は購入者の所在地によって変わる可能性があります。すべての入力に郵便番号または国を設定し、各レコードとともにそれを保存してください。Amazon商品スクレイパーは各入力にzipcodeを受け付けます。
価格はしばしば複数のフィールドで構成されます。例えばcoupon_descriptionフィールドには、20商品中1件にまとめ買いオファーが含まれていました。他の5件では、価格割引ではないAmazon Musicの無料トライアルが含まれていました。上記のBoseのスクリーンショットにあるSavingsバッジは、そうしたトライアルの1つです。
定価、セール価格、取引の種類、クーポンテキストを別々に保存し、割引としてカウントする前にクーポンをパースしてください。型も宣言してください。JSONは$449を449と書き込みますし、サンプルから型を推定するローダーは価格を整数にしてしまうことがあります。
小売業者をまたいで商品を照合する
タイトルの照合は、ヘッドホンのペアを同じ商品名を共有するイヤホンと結び付けてしまう可能性があるため、識別子で照合してください。しかし識別子はしばしば欠落しているか一貫性がありません。20件のAmazonリストのうち、ページにUPC(Universal Product Code)が表示されていたのはわずか7件でした。Sonyも1つの基本モデルを、WH-CH720N/PとWHCH720N/Wという2つの異なる表記で記載していました。
そのため、確信度の高い順に照合してください。UPCなどのGTIN(Global Trade Item Number)から始めます。次に、ブランドと正規化されたモデル番号を試し、その後、確信度のしきい値付きでタイトル照合を試します。モデル番号は区切り文字と色のサフィックスを除去して正規化してください。
20商品のうち、UPCもモデル番号も持たなかったのはわずか6件で、そのすべてが1つの商品のバリエーションでした。そのため、人によるレビューが必要だったのは、その1つの商品のタイトル照合だけでした。
データの変化速度に合わせて更新スケジュールを設定する
ウェブデータは異なる速度で価値を失うため、更新スケジュールはそれに合わせるべきです。1つのレコードのフィールド同士でさえ、変化する速度は異なります。監視対象リストの毎時実行は、その度合いを示しています:
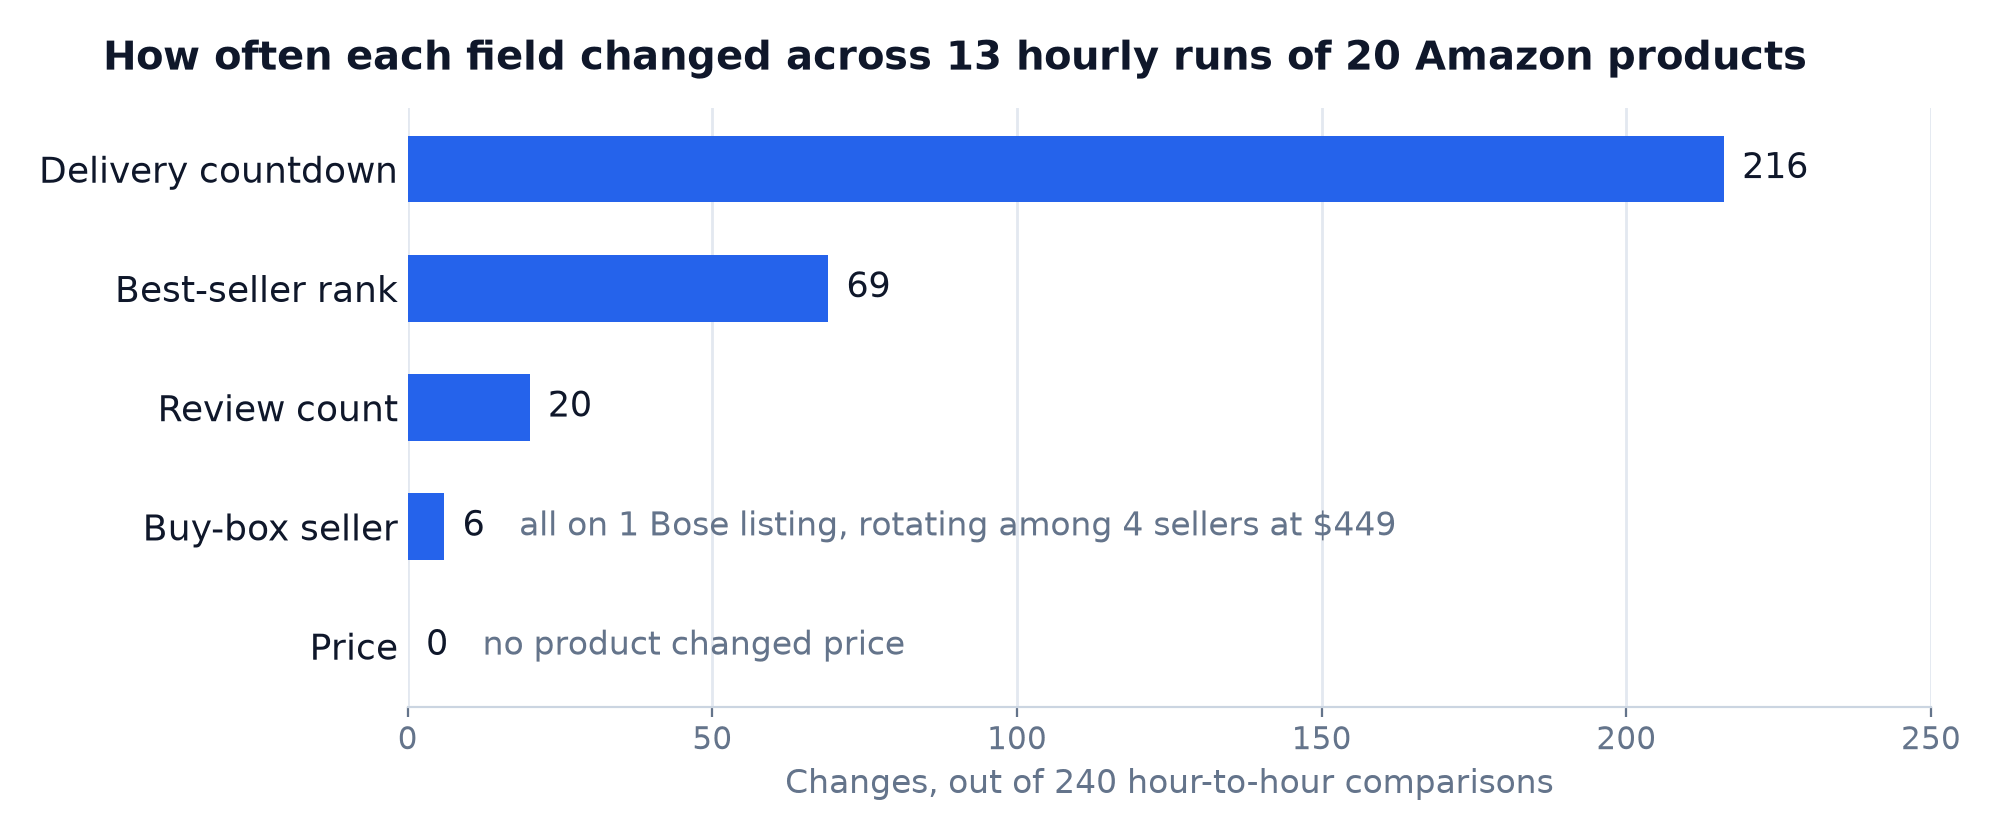
Web Scraper APIで収集。配送カウントダウンは、Amazonの「あと2時間44分以内に注文」というメッセージです。
あるBoseのリストでは、価格が$449のままである一方で、買い物ボックスが4つの販売者の間を6回移動していました。価格だけを追跡するモニターでは、すべての変化を見逃していたことでしょう。
商品を重要フィールドの変化速度でグループ化し、各グループに独自の収集スケジュールを与えることで、データが変化する場所に支出を回してください。買い物ボックスが重要な商品については、さまざまな時間帯に1日に数回小さなジョブを実行し、それ以外は日次ジョブにしてください。
増分クロールは、サイトマップ内のlastmod日付などのシグナルを使って、変更された可能性の高いページのみを再収集することで、鮮度のコストを下げます。収集後は、契約が使用するフィールドのハッシュを比較し、後続のステージが変更されたレコードのみを再処理するようにしてください。
取得テストでは、再取得のたびに生HTMLのハッシュが異なっていました。毎時実行の240回の1時間ごとの比較のうち、全レコードのハッシュは239回変化していました。それらの変化のほとんどは配送カウントダウンによるものでした。タイムスタンプ以外の8つの契約フィールドのハッシュは26回しか変化しておらず、それぞれがレビュー数または買い物ボックス出品者の実際の変化でした。
中央値の経過時間が低くても、少数の非常に古いレコードを隠している場合があります。そのため、鮮度はソースごとのp50とp99の経過時間の分布として測定し、p99に対してアラートを出してください。
AIとエージェントのためのデータパイプラインアーキテクチャ
AIパイプラインは同じ5つのステージを使用し、通常は提供ステージにモデルまたはエージェントが位置します。
大量のソースにはLLMにパーサーを書かせる
主な問題は、大規模言語モデルがすべてのページからデータを抽出すべきかどうかです。o200k_baseトークナイザーでカウントした1つのAmazon商品ページが、この答えに役立ちます:
| 同じ商品ページの形式 | バイト数 | トークン数 |
|---|---|---|
| 生HTMLとしての全ページ | 2,446,738 | 911,129 |
| マークダウンとしての全ページ | 236,088 | 97,977 |
| 生HTMLから抽出したメインコンテンツのみ | 17,339 | 3,252 |
| 全フィールドを含むフルJSONレコード | 23,923 | 7,692 |
| 絞り込んだJSONレコード(12フィールド) | 501 | 171 |
全ページのマークダウンは1ページを読むエージェントには適していますが、大量の場合、チームは通常、抽出前にページをメインコンテンツに絞り込みます。この方法で絞り込んでも、ページは12フィールドのレコードの19倍のトークンを使用していました。入力100万トークンあたり$0.10という例では、1日10万ページでモデル入力のコストが約$33になります。代わりに12フィールドのレコードを読む場合は約$2になります。
いずれの数値も収集のコストを含んでおらず、各経路はそれぞれ異なる料率でそれを負担します。そのため、トークンコストだけでなく総コストを比較してください。抽出されたメインコンテンツは保証アップセルで始まっており、それを読むモデルは依然として誤った価格やバリエーションを選んでしまう可能性があります。Web Scraper APIのレコードは価格とバリエーションを別々のフィールドとして届けるため、モデルがページのテキストからそれらを拾い出す必要がありません。
アプローチは量とリスクで選んでください。1日に何千回も収集するソースについては、モデルにパーサーを書かせ、壊れたときに修正させてください。その後は通常のコードがそのパーサーをすべてのページで実行し、同じページに対して同じ出力を返します。Scraper Studioは、このパターンをサービスとして実行し、平易な言葉のプロンプトからスクレイパーを構築し、サイトが変更された際にはワンクリックで自己修復します。
レイアウトが頻繁に変わる低ボリュームのサイトについては、ページごとのLLM抽出がパーサーの維持よりも低コストになる場合があります。いずれにしても、出力は同じ契約に照らして確認してください。
検証が失敗した場合、コーディングエージェントはパーサーの修正を提案し、ブロンズ層の生ページに対してそれを再生できます。再生は、その修正がいくつの隔離された行を回復するか、そしてどの受理済みの行が変化したかを示し、マージする前に人間が両方をレビューします。
検証済みテーブルからエージェントに提供する
エージェントにとって、ライブの取得はテーブルの読み込みよりもリスクが高くなります。ブロックされた取得は、ユーザーが待っている間にエージェントのタスクを止めてしまう可能性があるためです。例えば2026年9月、Cloudflareは広告を表示するページにおいて、新しく追加されたドメインのデフォルト設定を変更し、AIエージェントと学習用ボットをブロックするようにしました。そのため、まずは契約の使用ルールを含むMCPインターフェースを通じて、検証済みテーブルからエージェントに提供してください。
エージェントには、プロンプトインジェクションのチェックも必要です。テーブル内のレビューやタイトルのフィールドを含むページのテキストには、エージェントを狙った指示が含まれている可能性があるためです。ライブ読み込みについては、Bright DataのMCP Serverにはデフォルトで有効なコンテンツゲートがあります。サーバーの設定を変更する指示のように見えるページのテキストを返す前に、ユーザーに確認を求めます。
AIの回答をデータソースとして追跡する
AIアシスタントの回答は、どの検索結果よりも先に購入者に届く可能性があるため、これもデータソースです。あるテストでは、同じ買い物に関する質問に対するChatGPTの最初のおすすめは、5回の実行のうち3回がBoseで、2回がSonyでした。そのため各プロンプトを複数回サンプリングし、結果が比較可能であり続けるようすべての実行で国を同じに保ってください。Web Scraper APIのAIチャットスクレイパーは、ChatGPT、Copilot、Gemini、Perplexity、Grokから、引用元付きの構造化されたJSONとして回答を収集します。
収集レイヤーを自作するか購入するか
ストレージ、変換、オーケストレーションを含む、ほとんどのデータパイプラインインフラは、確立されたツール上で動作します。保護されたウェブサイトからの収集は異なります。ブラウザとボット対策が変化するたびに対応を変える必要があるためです。
リクエストあたりではなく、受理レコードあたりのコストを比較してください。Web Unlockerは成功した結果に対してのみ課金し、Web Scraper APIは届けられたレコードに対してのみ課金します。総支出を契約に合格したレコード数で割ってください。
自作の場合は、プロキシ、パーサーの修正、ブロック解除に費やしたエンジニアの工数を含めてください。どちらの場合も、誤った価格に基づく再価格設定の決定など、悪い納品がもたらすコストをカウントしてください。
自社のURLで収集ツールをベンチマークする
多くの調達チームがベンダー評価の実証実験で行うように、ベンチマークからこれらのコストを得てください。現在の収集ツールと各候補を、同じURLに対して、実際にパイプラインが使用するネットワークと同時実行数で、数日間実行してください。各候補を同じ指標で比較してください:
| 指標 | カウント方法 |
|---|---|
| 受理レコード | ソースごとに、データ契約に合格した行 |
| 理由別の失敗 | ブロック、チャレンジ、空ページや誤った地域のページなど、コンテンツチェックに失敗した成功レスポンス |
| 受理レコード1,000件あたりのコスト | リトライ、プロキシ、以下のエンジニア工数を含むすべての支出を、受理された行1,000件あたりで算出 |
| レイテンシ | バッチジョブおよびライブ取得についての、納品までのp50とp95の時間 |
| エンジニア工数 | テスト期間中にブロック、パーサーの修正、アラートに費やした時間 |
Bright Dataの月額無料クレジットで、自社URLのサンプルに対する最初のテストをカバーできます。
ソースごとに判断する
1つのパイプラインは通常、保護されていないサイトと保護されたサイトが混在するため、各ソースについて個別に判断してください。ベンチマーク中に自社のクライアントがコンテンツチェックに失敗するサイトは保護されたサイトとしてカウントしてください:
| 状況 | 自作 | 購入 |
|---|---|---|
| 保護されていない少数のサイトを、時々収集する | はい | 無料クレジットから始め、量が増えるにつれて従量課金制に移行する |
| 保護されたサイトを、スケジュールに沿って収集する | ブラウザのリリースを追跡するチームがあり、通常はレジデンシャルプロキシを使う場合のみ | Web UnlockerまたはBrowser APIがアクセスを処理するため、チームはパーサーを書くだけで済む |
| ページではなくレコードが必要なサイト | サイトが自社製品にとって中心的でない限り、価値がないことが多い | Web Scraper APIが構造化されたJSONを返し、Scraper Studioがプロンプトからカスタムスクレイパーを構築する |
| 必要だが自分で収集する必要のないデータ | いいえ | スケジュールに沿って新規または更新されたレコードのみ更新されるデータセット、または既に収集されたページ用のWeb Archive API |
| ライブで閲覧・検索するエージェント | 小規模な社内ツールのみ | SERP APIとWeb Unlockerを使用するMCP Server |
データ契約はまた、収集ツールを簡単に変更できるようにするため、新しいものを試すリスクが低くなります。下流のテーブル、フラグ、アラートは契約のフィールドのみに依存します。切り替えるには、収集ステージを新しい収集ツールに接続し、自社URLでベンチマークを再実行するだけです。サイトは時間とともに防御を変化させるため、各ソースの受理率を追跡し続けてください。
予算計画のために、Web Scraper API料金ページには現行の従量課金制の料金とボリュームプランが掲載されています。データ品質指標のガイドは、コストを比較する前に「受理済み」を定義するのに役立ちます。
コンプライアンスと来歴
ログインせずに、各サイトが処理できるリクエストレートで、公開データのみを収集してください。個人データは法的根拠がある場合にのみ収集し、再公開または学習に使用するものの著作権の状況を確認してください。
各レコードとともに、ソースURL、収集時刻、方法、コードバージョン、適用された利用規約を含む来歴を保持してください。そうすれば、どのレコードがどこで、どのように収集されたかを示すことができます。
Bright DataはISO 27001認証とSOC 2 Type IIレポートの両方を保持しており、どちらもセキュリティ概要に掲載されています。
テストの実施方法
すべてのテストは、時間とともに変化する実際のサイトとサービスに対して実行されました:
| テスト | 設定 |
|---|---|
| 取得テスト | 4つのオープンソースクライアントそれぞれが13の検索・一覧ページを3回ずつ取得。クライアントは、デフォルトヘッダー付きPython requests、Chromeヘッダー付きrequests、Chrome 150をターゲットとしたcurl_cffi、Playwrightによるヘッドレスchrome 155。すべてインドの家庭用インターネット回線から、プロキシなしで実行。レスポンスは、そのサイトの一覧を示すHTMLパターンを含む場合にデータとしてカウントされ、別の検出器が8つのブロックページシグネチャを確認。通常のUser-Agentによるヘッドレスの再実行では各ページを2回取得。 |
| フィンガープリントチェック | Web Unlocker、Python requests、curl_cffi(Chrome 150ターゲット)、インストール済みChrome 155からのTLSハンドシェイクを、tls.peet.ws上で比較 |
| エージェントの取得 | 同じ13のURLを、Claude Codeのエージェントが使用するWebFetchツールを通じて1回実行 |
| 参考パイプライン | 20のAmazon商品と意図的に無効にした1つのID、Web Scraper API、約2時間間隔の2回の実行とその約17時間後の3回目 |
| 毎時実行 | 同じ20商品、1時間間隔の13回の実行、240回の1時間ごとの比較 |
| 発見 | SERP APIを通じた1つのヘッドホンモデルのGoogle検索 |
| トークン数 | Web Unlocker(HTMLとマークダウン)とWeb Scraper API(JSON)を通じた1つのAmazon商品ページ、o200k_baseトークナイザー、trafilatura 2.3で抽出したメインコンテンツ |
| AIの回答 | Web Scraper APIを通じてChatGPTに送った1つの買い物に関する質問、国を設定しない状態での5回の実行 |
最後に
データパイプラインが公開ウェブサイトから収集する場合、レスポンスは成功ステータスでありながらデータがないことがあり、1つのレコードが複数の粒度を混在させていることがあります。
生データは変更せずに保存し、コンテンツをデータ契約に照らして確認し、通常と異なる変化にフラグを立て、エージェントが提案したパーサーの修正はマージする前に再生してください。収集レイヤーがリクエストよりもエンジニアの工数でコストがかかっている場合は、Web Scraper APIがそのステージをチームの代わりに担うことができます。まずは最も信頼性の低いソースに対してコンテンツチェックを実行し、その成功レスポンスのうち使用可能なレコードを含むものがいくつあるかを数えることから始めてください。その後、同じURLを無料のBright DataアカウントでWeb UnlockerまたはWeb Scraper APIに通し、受理レコードあたりのコストを比較してください。
よくある質問
データパイプとは何ですか?
「データパイプ」は、データパイプラインの略称であり、データをソースからそれを使用するツールへと移動させるシステムを指します。典型的なものは、データを収集、保存、確認、変換、提供します。データパイプラインアーキテクチャはその設計であり、各ステージ、ツール、そしてそれらの間のチェックを定義します。
データパイプライニングとは何ですか?
データパイプライニングとは、データをソースからそれを使用するツールへと移動させるデータパイプラインを構築・運用する実践です。この作業は、データの収集、保存、確認、変換、提供に加え、各ステージのスケジューリングとモニタリングをカバーします。これは、チップ内でプロセッサーのステップを重ね合わせるCPUの命令パイプライニングとは異なります。
データパイプラインの5つのステップとは何ですか?
典型的なデータパイプラインの5つのステップは、収集、生データの保存、検証、変換、提供です。収集はソースからデータを取得し、生データの保存はそれを変更せずに保持します。検証はデータ契約に照らしてそれを確認し、変換はそれをテーブルにモデル化し、提供はダッシュボード、モデル、またはエージェントにそれを届けます。
最新のデータパイプラインアーキテクチャとは何ですか?
最新のデータパイプラインアーキテクチャは、通常、生データをオブジェクトストレージに保存し、Apache Icebergなどのオープンな形式でテーブルを保持します。dbtなどのツールでデータを変換し、Airflowなどのオーケストレーターでステージをスケジュールします。データ契約がテーブルに入るものを制御し、エージェントはModel Context Protocol(MCP)を通じてそれらを読み込むことができます。
データパイプラインの例にはどのようなものがありますか?
ウェアハウスに読み込まれる競合価格の夜間バッチがよくある例です。ブランドモニタリングのために数分で処理されるSNS投稿のストリームも別の例です。ハイブリッドは日次履歴を保持しつつ、短い監視対象リストの変化をストリーミングし、オンデマンドパイプラインはエージェントが問い合わせた際にライブデータを取得します。これら4つすべてが同じ5つのステージを使用します。
AIはデータパイプラインを作成できますか?
はい、コーディングエージェントはパイプラインのコードの大部分を書くことができ、人間が各変更をレビューします。収集については、Bright DataのScraper Studioが平易な言葉のプロンプトからスクレイパーを構築します。ページごとのLLM抽出は、各出力がデータ契約に合格すれば機能しますが、より多くのトークンを使用します。あるAmazonページのメインコンテンツは3,252トークンで、12フィールドのレコードの171トークンに対してこれだけ使用しました。
データ取り込みパイプラインとは何ですか?
データパイプラインの最初の部分であるデータ取り込みパイプラインは、ソースからデータを収集し保存します。ウェブソースにはコンテンツチェックが必要です。13サイトに対するオープンソースクライアントのテストでは、88件の成功レスポンスのうち39件がデータを含んでいませんでした。ボット対策のあるサイトについては、Bright DataのWeb Unlockerがページを返すか、Web Scraper APIが構造化されたレコードを返します。
ビッグデータパイプラインとは何ですか?
ビッグデータパイプラインとは、ストレージと計算を別々にスケールさせる必要がある量のために構築されたデータパイプラインです。通常、データをオブジェクトストレージに保存し、Apache IcebergやDelta Lakeなどのオープンなテーブル形式で保持します。SparkやFlinkなどの分散エンジンがそれを処理します。