従来のウェブスクレイピングは、特定のウェブサイトのレイアウトに合わせた複雑で時間のかかるコードを書く必要があり、サイトが変更されると簡単に壊れてしまいます。ScrapeGraphAIは大規模言語モデル(LLM)を活用して情報を抽出し、人間のように解釈するため、レイアウトではなくデータに集中できます。LLMとScrapeGraphAIを統合することで、データ抽出が強化され、コンテンツの集約が自動化され、リアルタイム分析が可能になります。
この記事では、ScrapeGraphAIを使ったウェブスクレイピングの方法を学びます。その前に、時間とコストを節約できるBright Dataのソリューションをご紹介します。
Bright Dataのウェブスクレイピングソリューション
Bright Dataは、効率的でスケーラブル、かつコンプライアンスに準拠したデータ抽出に最適化された、包括的なウェブスクレイピングソリューション群を提供しています。
- Web Scraper API
- すぐに使えるデータセット
- カスタムデータセット
これらのソリューションは、高速かつ正確でスケーラブルなデータ収集を可能にし、小規模なアプリケーションからエンタープライズレベルのニーズまで、あらゆる規模のプロジェクトに最適です。
ScrapeGraphAIを使ったLLMウェブスクレイピングの実装
このチュートリアルを始める前に、以下の前提条件が必要です。
- Python 3.xがインストールされていること。
- Ope nAIアカウントがあること。このチュートリアルでは、ScrapeGraphAIでデータをスクレイピングするためにOpenAIのLLMを使用します。Anthropic、Googleなどの他のモデルや、Llama、Mistral AIなどのオープンソースモデルを使用することも可能ですが、このチュートリアルでは人気があり設定が簡単なGPT-4を使用します。
Pythonでのウェブスクレイピングに馴染みがない場合は、このウェブスクレイピングチュートリアルを参考にしてください。
環境のセットアップ
最初に行う必要があるのは、仮想環境を作成することです。ターミナルを開き、プロジェクトディレクトリに移動します。
python -m venv venv
次に、仮想環境を有効化します。macOSとLinuxでは、以下のコマンドを使用できます。
source venv/bin/activate
Windowsでは、以下のコマンドを使用できます。
venvScriptsactivate
仮想環境を有効化したら、ScrapeGraphAIとその依存関係をインストールする必要があります。
pip install scrapegraphai
playwright install
playwright installコマンドは、Chromium、Firefox、WebKit用の必要なブラウザをセットアップします。
環境変数を安全に管理するために、python-dotenvをインストールします。
pip install python-dotenv
APIキーなどの機密情報を保護することが重要です。コードファイルとは別に保つため、環境変数は.envファイルに保存することをお勧めします。
プロジェクトディレクトリに.envという新しいファイルを作成し、OpenAIキーを指定する以下の行を追加します。
OPENAI_API_KEY="your-openai-api-key"
このファイルは、Gitなどのバージョン管理システムにコミットすべきではありません。これを防ぐために、.envを.gitignoreファイルに追加してください。
ScrapeGraphAIでデータをスクレイピングする
このチュートリアルでは、まずウェブスクレイピング技術の練習専用のデモサイトであるBooks to Scrapeから商品データをスクレイピングします。このウェブサイトはオンライン書店を模倣しており、さまざまなジャンルの本を価格、評価、在庫状況とともに提供しています。
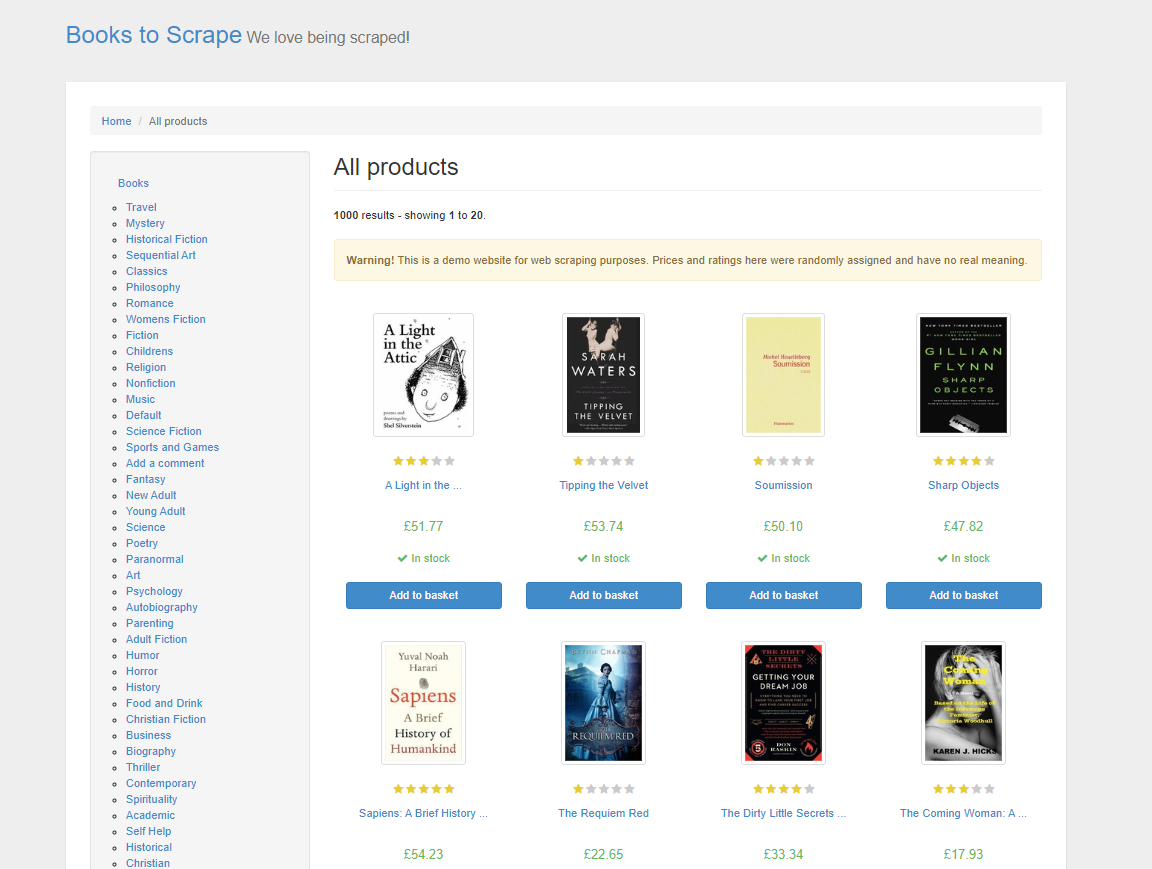
従来のHTMLウェブスクレイピングでは、ページのHTMLを分析し、要素やタグを手動で検査して必要なデータを見つける必要がありました。このプロセスは時間がかかり、ウェブ構造についてのしっかりした理解が必要です。ScrapeGraphAIを使えば、プロンプトを使って必要なデータを指定するだけで、LLMがそれを抽出するのに十分な知能を持っています。
ScrapeGraphAIは、さまざまなスクレイピングニーズに対応する異なるタイプのグラフを提供しています。これらのグラフは、スクレイピングプロセスがどのように構成され、何を達成しようとしているかを定義します。以下は、いくつかの異なるグラフの簡単な概要です。
- SmartScraperGraphは、プロンプトとURLまたはローカルファイルを指定する単一ページ用スクレイパーです。指定した情報を抽出するためにLLMを使用します。
- SearchGraphは、プロンプトに基づいて検索エンジンの結果から情報を抽出する複数ページ用スクレイパーです。
- SpeechGraphは、SmartScraperGraphにテキスト読み上げ機能を追加し、抽出したコンテンツのオーディオファイルを生成します。
- ScriptCreatorGraphは、プロンプトとURLを受け取り、結果を生成する代わりに、指定されたURLをスクレイピングできるPythonスクリプトを出力します。
これらのグラフが正確なニーズに合わない場合、ScrapeGraphAIでは異なるノードを組み合わせてカスタムグラフを作成し、特定の要件に合わせてスクレイピングプロセスをカスタマイズすることもできます。
適切なタイプのグラフを選択することに加えて、特にプロンプトとモデル選択に関して、スクレイパーを適切に設定する必要があります。プロンプトは、抽出すべきデータを正確に理解するためにLLMを導くものであり、明確で明示的であることを確認してください。さらに、適切なLLMモデルを選択することで、スクレイパーがウェブサイトのコンテンツをどれだけうまく処理し解釈するかが決まります。地域制限のあるコンテンツをよりスムーズにスクレイピングするためのプロキシや、プロセスを効率的かつ高速に保つためのヘッドレスモードなど、他のオプションを設定することもできます。適切な設定は、最終的にスクレイピングされたデータがどれだけ正確で関連性があるかを決定します。
スクレイパーコードを書く
スクレイパーコードを書くには、app.pyという新しいファイルを作成し、以下のコード行を追加します。
from dotenv import load_dotenv
import os
from scrapegraphai.graphs import SmartScraperGraph

# Load environment variables from .env file
load_dotenv()

# Access the OpenAI API key
OPENAI_API_KEY = os.getenv('OPENAI_API_KEY')

# Configuration for ScrapeGraphAI
graph_config = {
    "llm": {
        "api_key": OPENAI_API_KEY,
        "model": "openai/gpt-4o-mini",
 }
}

# Define the prompt and source
prompt = "Extract the title, price and availability of all books on this page."
source = "http://books.toscrape.com/"

# Create the scraper graph
smart_scraper_graph = SmartScraperGraph(
 prompt=prompt,
 source=source,
 config=graph_config
)

# Run the scraper
result = smart_scraper_graph.run()

# Output the results
print(result)
このコードは、環境変数を扱うためのosやdotenvなどの必須モジュールと、スクレイピングに使用されるScrapeGraphAIのSmartScraperGraphクラスをインポートします。次に、dotenvを介して環境変数を読み込み、APIキーなどの機密データを安全に保ちます。次に、コードは使用するモデルとAPIキーを指定したスクレイピング用のLLM設定を作成します。この設定は、サイトのURLとスクレイピングプロンプトとともに使用され、SmartScraperGraphを定義するために使われます。これはrun()メソッドを使用して実行され、指定されたデータを収集するプロセスをトリガーします。
このコードを実行するには、ターミナルを開いてpython app.pyを実行します。出力は以下のようになるはずです。
{
    "books": [
        {
            "title": "A Light in the Attic",
            "price": "£51.77",
            "availability": "In stock"
        },
        {
            "title": "Tipping the Velvet",
            "price": "£53.74",
            "availability": "In stock"
        }, ...
       ]
}
注:コードの実行に問題が発生した場合、ScrapeGraphAIの基盤となる依存関係である
grpcioパッケージを手動でインストールする必要があるかもしれません。以下のコマンドでこれを行うことができます。
pip install grpcio
ScrapeGraphAIはウェブスクレイピングのデータ抽出部分を簡単にしますが、CAPTCHAやIPブロックなど、対処方法を知っておく必要のある一般的な課題がまだいくつか存在します。
ブラウジング動作を模倣するために、コードにタイマー付きの遅延を実装できます。検出を回避するためにローテーションプロキシを利用することもできます。さらに、Bright DataのCAPTCHA解決ツールやAnti CaptchaなどのCAPTCHA解決サービスをスクレイパーに統合して、CAPTCHAを自動的に解決することができます。
ご注意ください:常にウェブサイトの利用規約に準拠していることを確認してください。個人使用のためのスクレイピングは一般的に許容されますが、データの再配布は法的な影響を及ぼす可能性があります。
ScrapeGraphAIでプロキシを使用する
ScrapeGraphAIでは、IPブロックを回避し、地域制限のあるコンテンツにアクセスするためにプロキシサービスをセットアップできます。無料のプロキシサービスを使用することも、独自のカスタムプロキシサーバーを設定することもできます。
無料のプロキシサービスを使用するには、以下をgraph_configに追加します。
graph_config = {
    "llm": {
        "api_key": OPENAI_API_KEY,
        "model": "openai/gpt-4o-mini",
 },
    "loader_kwargs": {
        "proxy": {
            "server": "broker",
            "criteria": {
                "anonymous": True,
                "secure": True,
                "countryset": {"US"},
                "timeout": 10.0,
                "max_tries": 3
 },
 },
 }
}
この設定は、ScrapeGraphAIに条件に合った無料のプロキシサービスを使用するよう指示します。
Bright Dataのようなプロバイダーからのカスタムプロキシサーバーを使用するには、サーバーのURL、ユーザー名、パスワードを挿入して、以下のようにgraph_configを変更します。
graph_config = {
    "llm": {
        "api_key": OPENAI_API_KEY,
        "model": "openai/gpt-4o-mini",
 },
    "loader_kwargs": {
        "proxy": {
            "server": "http://your_proxy_server:port",
            "username": "your_username",
            "password": "your_password",
 },
 }
}
カスタムプロキシサーバーを使用することには、特に大規模なウェブスクレイピングにおいて、いくつかの利点があります。プロキシの場所を制御できるため、地域制限のあるコンテンツをスクレイピングできます。さらに、カスタムプロキシは無料プロキシと比較してより信頼性が高く安全であり、IPがブロックされたりレート制限を受けたりする可能性を減らします。
データのクリーニングと準備
データをスクレイピングした後、特にAIモデルに取り込む予定がある場合は、クリーニングと前処理を行う必要があります。クリーンなデータは、モデルが正確で一貫性のある情報から学習することを保証し、これがパフォーマンスと信頼性に直接影響します。データクリーニングには通常、欠損値の処理、データ型の修正、テキストの正規化、重複の除去が含まれます。
以下は、先ほどスクレイピングしたデータをpandasを使ってクリーニングする方法の例です。
import pandas as pd

# Convert the result to a DataFrame
df = pd.DataFrame(result["books"])

# Remove currency symbols and convert prices to float
df['price'] = df['price'].str.replace('£', '').astype(float)

# Standardize availability text
df['availability'] = df['availability'].str.strip().str.lower()

# Handle missing values if any
df.dropna(inplace=True)

# Preview the cleaned data
print(df.head())
このコードは、本の価格から通貨記号を削除し、在庫状況を小文字に変換して標準化し、欠損値があれば処理することでデータをクリーニングします。
コードを実行する前に、データ操作のためのpandasライブラリをインストールする必要があります。
pip install pandas
コードを実行するには、ターミナルを開いてpython app.pyを実行します。出力は以下のようになるはずです。
                                   title  price availability
0                   A Light in the Attic  51.77     in stock
1                     Tipping the Velvet  53.74     in stock
2                             Soumission  50.10     in stock
3                          Sharp Objects  47.82     in stock
4  Sapiens: A Brief History of Humankind  54.23     in stock
これはスクレイピングしたデータをクリーニングする方法の一例にすぎません。クリーニングプロセスは、データとトレーニングされるLLMのユースケースによって異なります。データをクリーニングすることで、言語モデルが構造化され意味のある入力を受け取ることが保証されます。AIプロジェクトでのデータ活用方法についてさらに学びたい場合は、AIのためのデータをご検討ください。
このチュートリアルのすべてのコードは、このGitHubリポジトリで入手できます。
結論
ScrapeGraphAIはLLMを使用してウェブスクレイピングへの適応的なアプローチを提供し、ウェブサイト構造の変化に対応しながらデータをインテリジェントに抽出します。しかし、ウェブスクレイピングのスケーリングには、IPのブロック、CAPTCHAの解決、法的コンプライアンスの維持など、課題が伴います。
これらの課題を克服するために、Bright DataはAIおよび機械学習プロジェクト向けに調整された包括的なウェブスクレイピングソリューション群を提供しています。これには、Bright DataのWeb Scraper API、プロキシサービス、サーバーレススクレイピングが含まれます。これに加えて、Bright Dataは100を超える人気ウェブサイトからのデータが詰まったすぐに使えるデータセットも提供しています。
今すぐ始めましょう!