B2Bデータプラットフォームである ZoomInfo のスクレイピングとは、ログインなしで表示される企業プロフィールを収集することを指します。営業チームやデータチームは、ZoomInfo の企業データを使って、業界、従業員数、収益、技術分野などの情報で CRM アカウントを充実させます。
他サイトからのリファラーがない状態で、新しいレジデンシャルIPから送信した最初の32件のリクエストはすべて、ZoomInfo の「Press & Hold」チャレンジページを受け取りました。テストでは、最初のページを取得できたIPは、中央値で3ページ後にブロックされました。
本ガイドでは、企業ページを大規模に取得する方法、アカウントとプロフィールのマッチング方法、データ抽出の方法、そしてZoomInfoスクレイパーを購入すべきタイミングの判断方法を解説します。
要約
- IPあたり約3ページという測定結果となったため、10万件のZoomInfoページを収集するには3万3千以上のセッションが必要です。 5回目のリクエスト時点で、14セッション中12セッションがCloudflareの429エラーを受け取りました。
- ZoomInfoには重複した企業プロフィールが存在しました。 あるドメインの検索では3つの企業IDが返され、重複したものには異なる従業員数と収益が記載されていました。
- ZoomInfoの埋め込みJSONには丸められていない数値が含まれていました。 Web Unlockerが返したAviagenのページのJSONには従業員数6,776人と記載されていましたが、プロフィール表示では5K〜10Kとなっていました。
- Bright DataのZoomInfo Scraper APIがブロック回避を代行します。 1つのディレクトリURLから、45件の構造化された企業レコードが返されました。
ZoomInfoがログインなしで表示する内容
ZoomInfoの公開ページでは、詳細な企業データと人物に関する基本データが表示されていました。メールアドレス、直通電話番号、完全な連絡先リスト、技術スタックの全リストにはアカウントが必要でした。ログアウト状態のスクレイパーは、業界や従業員数などのファーモグラフィックデータを収集しました。公開サイトには以下のような主要なページタイプがありました。
| ページタイプ | URLパターン | 表示される内容 |
|---|---|---|
| 企業プロフィール | /c/{slug}/{id} |
業界、従業員数、収益の推定値、本社所在地、電話番号、ウェブサイト、SICコードおよびNAICSコード、一部の技術情報、資金調達情報、管理職レベル別の従業員数 |
| 企業ディレクトリ | /companies-search/{filters} |
所在地と業界でフィルタリングされた、1ページあたり9社の企業 |
| 人物プロフィール | /p/{name}/{id} |
氏名、役職、勤務先 |
| その他のページ | /pic/、/hq/、/tech/、/executives/、/competitors/ |
従業員ディレクトリ、本社詳細、特定技術を利用する企業、役員情報、競合企業 |
人物プロフィールページ、従業員ディレクトリ、企業ページ上の人物リストには個人データが含まれており、GDPRの対象となる場合があります。ログイン後のページはZoomInfoの利用規約の対象となり、アカウント保有者がそれに同意しています。私たちのスクリプトは公開されている企業レコードのみを収集し、人物に関するフィールドは除外しています。
ZoomInfoへの最初のリクエストがブロックされる理由
ZoomInfoはページの前段に2つのボット対策システムを配置しており、ブロックされたレスポンスにはそれぞれどのシステムが送信したかが示されていました。スクレイパーとZoomInfoの間に挟まるプロキシは、これらのシステムが見るTLSフィンガープリントも変化させます。テストでは、セッションの最初のリクエストには外部のリファラーが必要でしたが、そのセッションのCookieを伴う後続のリクエストには不要でした。
各ボット対策システムには固有のシグネチャがある
ディレクトリページを含むzoominfo.comのページへのリクエストはCloudflareを経由してルーティングされ、2022年にPerimeterXと合併したHUMAN Securityによってチェックされていました。両システムとも、ブロックされたレスポンスには固有のシグネチャを付けており、実際の企業ページにもシグネチャがありました。
| レスポンス元 | ステータスとページ | 判断基準となるシグナル |
|---|---|---|
| HUMAN Security | 403、「Access to this page has been denied」と「Press & Hold」ボタン | 403ステータスとボディ内のpx-captcha |
| Cloudflare | 429、「Just a moment…」 | cf-mitigated: challengeレスポンスヘッダー |
| ZoomInfoのオリジン | 200、企業ページ | 企業データを含む<script id="ng-state"> |
ページタイトルではなく、これらのシグナルに基づいて判断してください。企業ページにも_pxAppIdが含まれていたため、その存在だけではHUMANがリクエストをブロックしたことを意味しません。Cloudflareのドキュメントによれば、あらゆる種類のチャレンジページにはcf-mitigated: challengeヘッダーが付与されるとされています。
ng-stateスクリプト内に埋め込まれたJSONは、実際の企業ページを最も確実に示すものでした。レスポンスがこのJSONを持っている場合にのみ、成功と判断してください。
プロキシがTLSフィンガープリントに与える影響
私たちはBright Dataのレジデンシャルプロキシゾーン(名前付きプロキシ設定)を使用しました。このゾーンはサイトへの独自のTLS接続を開始します。3種類のクライアントから、TLSフィンガープリントチェッカーであるtls.peet.wsへリクエストを送信し、最初はプロキシなし、次にそのゾーンを経由して送信しました。
| クライアント | プロキシなしのJA4 | プロキシ経由のJA4 |
|---|---|---|
| Chrome 150をなりすましたcurl_cffi | t13d1516h2_8daaf6152771_806a8c22fdea |
t13d1516h2_8daaf6152771_d8a2da3f94cd |
| Firefox 147をなりすましたcurl_cffi | t13d1717h2_5b57614c22b0_3cbfd9057e0d |
t13d1516h2_8daaf6152771_02713d6af862 |
| システムcurl 8.7.1 (LibreSSL) | t13d497h2_0d8feac7bc37_7395dae3b2f3 |
t13d1516h2_8daaf6152771_02713d6af862 |
プロキシ経由では、3つのJA4フィンガープリントすべてがt13d1516h2_8daaf6152771から始まっており、これはChromeをなりすましたcurl_cffiと最初の2つの部分が同じでした。これらの部分はTLS 1.3、15種類の暗号スイート、16個の拡張機能、HTTP/2をエンコードしています。つまりプロキシは、3つのクライアントすべてに対してChromeライクなTLSフィンガープリントを提示していたのです。Chromeなりすましは、プロキシを経由してもHTTP/2フィンガープリントを保持していたため、TLSとHTTP/2の両方のフィンガープリントをChromeのように見せるために使用してください。
TLSなりすましに時間を費やす前に、どのホップがTLSを終端しているかを確認してください。プロキシが接続をトンネリングするだけの場合、サイトはクライアント自身のハンドシェイクを見ることになります。いずれの場合も、TCP接続は出口ノードから開始され、そのSYNパケットには独自のTTL、ウィンドウサイズ、オプション順序が含まれます。macOSのUser-AgentがWindowsのTCPスタック経由で届くこともあり、TCPフィンガープリントを読み取るボット対策システムはこの不一致を検出できます。
ZoomInfoが最初のリクエストをどう判断するか
HUMANのチャレンジページはブラウザ内でセンサースクリプトを実行し、そのスクリプトが_px3などのリスクCookieを設定していました。スクレイパーの最初のリクエストはこれらのCookieを一切持たないため、サイトはリクエストとそれが到達した接続のみで判断することになります。
新しい米国のレジデンシャルIPから、リファラーなしでCookieを持たない企業ページへのリクエストを32件送信し、4種類のクライアントがそれぞれ8件ずつ送信しました。クライアントはシステムcurl、Chromeの完全なヘッダーセットを付与したcurl、Chromeをなりすましたcurl_cffi、HTTP/2を使うhttpxでした。32件すべてがHUMANの403エラーと以下の「Press & Hold」ページを受け取りました。
ZoomInfoは、リファラーなしでCookieを持たないリクエストに対してこのチャレンジページを返しました。
プロキシゾーン経由の場合、Cloudflareは4種類のクライアントすべてに対してプロキシのTLSハンドシェイクを見ていました。自宅の回線からは、Cloudflareは各クライアント自身のハンドシェイクを見ていました。その回線で試した6種類のクライアントすべての最初のリクエストは同じ403エラーを受け取りました。つまり、リファラーなしの最初のリクエストでは、TLSハンドシェイクが結果を変えることはありませんでした。
外部リファラーは結果を変えました。Chromeをなりすましたcurl_cffiからのCookieなしリクエストは、Refererヘッダーが他サイトを指している場合、18回中16回成功しました。リファラーにはGoogle、Bing、DuckDuckGo、LinkedIn、example.comを使用しました。失敗した2件のうち、1件はHTTP 502を受け取りました。
sec-fetch-site: cross-siteヘッダーを持つがRefererヘッダーを持たないCookieなしリクエストは、3回中3回ブロックされました。同一オリジンのリファラーを持つCookieなしリクエストも3回中3回ブロックされました。テストでは、最初のリクエストは検索結果などの他サイトからのクリックのように見える必要がありました。
Googleリファラーを使用した場合、成功率は同時実行数やUser-Agentによっても変化しました。
- ローテーションIPを使った6並列のリクエストでは、45件中14件のcurl_cffiリクエストが成功しました。
- 1件ずつリクエストし、毎回6秒の間隔を空けた場合、20件中13件が成功し、3件がリダイレクトを受け取りました。
curlやpython-requestsのUser-Agentを使ったリクエストは29回中29回ブロックされました。- 6並列のリクエストでは、ChromeのUser-Agentを使ったシステムcurlリクエストは15件中4件が成功しました。
1件ずつリクエストした場合でも20件中7件が失敗したため、自前で構築したスクレイパーでも、再試行、新規セッション、監視が必要です。
1つのIPが取得できるZoomInfoページ数
セッションが最初のページを取得すると、ZoomInfoは同じIPに対してさらに数ページしか提供しませんでした。各セッションは、プロキシのスティッキーセッション設定により1つのレジデンシャルIPを維持し、最初のリクエストにGoogleリファラーを付与しました。その後、最初にブロックされたリクエストまでの企業ページ数をカウントしました。
最初のページを取得できた14セッション全体で、中央値では最初のブロックされたリクエストまでに3件の企業ページを読み込めました。5回目のリクエスト時点で、14セッション中12セッションがCloudflareの429エラーを受け取っていました。最初の429エラーの後、そのセッションの以降のすべてのリクエストも429エラーを受け取りました。調査した429エラーのいずれにもRetry-Afterヘッダーは付与されていませんでした。
以下のセッションでは、ページ間の遅延を2秒または15秒にしても件数は変わりませんでした。
| クライアント | ページ間の遅延 | リクエストごとの結果 |
|---|---|---|
| HTTPクライアント | 15秒 | OK、OK、以降8回は429 |
| HTTPクライアント | 15秒 | OK、OK、OK、以降7回は429 |
| HTTPクライアント | 2秒 | OK、OK、OK、以降7回は429 |
| 実際のChrome | ページ読み込み時間 | OK、OK、OK、以降5回は「Just a moment…」 |
Chromeセッションでは、navigator.webdriverを隠した状態のヘッドフルChromeを、別のスティッキーセッション経由で実行しました。最初の3ページはそれぞれ6〜9秒で読み込まれました。その後の5ページそれぞれでは、ブラウザがcf_clearanceというクリアランスCookieを持っていたにもかかわらず、約15秒経過してもCloudflareのチャレンジが表示され続けていました。
最初のレスポンスのCookieを保持したセッションでは、後続のリクエストに外部リファラーは不要でした。後続のリクエストは、ブラウザがするように、前のZoomInfoページを自身のリファラーとして指定できました。
Cookieをクリアしても件数はリセットされませんでした。毎回リクエスト前にCookieをクリアし、毎回Googleリファラーを送信した4セッションのうち、3セッションが3ページ後に429エラーを受け取りました。つまり、この制限はCookieではなくIPに紐づいていました。
フォーラムのスレッドでは、ボット対策Cookieは出口IPに紐づけられていると書かれていますが、私たちのHTTPクライアントが受け取ったCookieではそれを再現できませんでした。_pxhd、_cfuvid、contextual_signup_testを含むCookieジャーを、あるIPから新しいIPへ移動させたところ、5件中4件のリクエストが成功しました。同じ時間帯の他の新規IPからのCookieなしリクエストは5件中2件成功しました。両グループともGoogleリファラーを送信していました。
この図は、スクレイパーから企業ページまでの経路と、各ボット対策システムからのレスポンスを示しています。
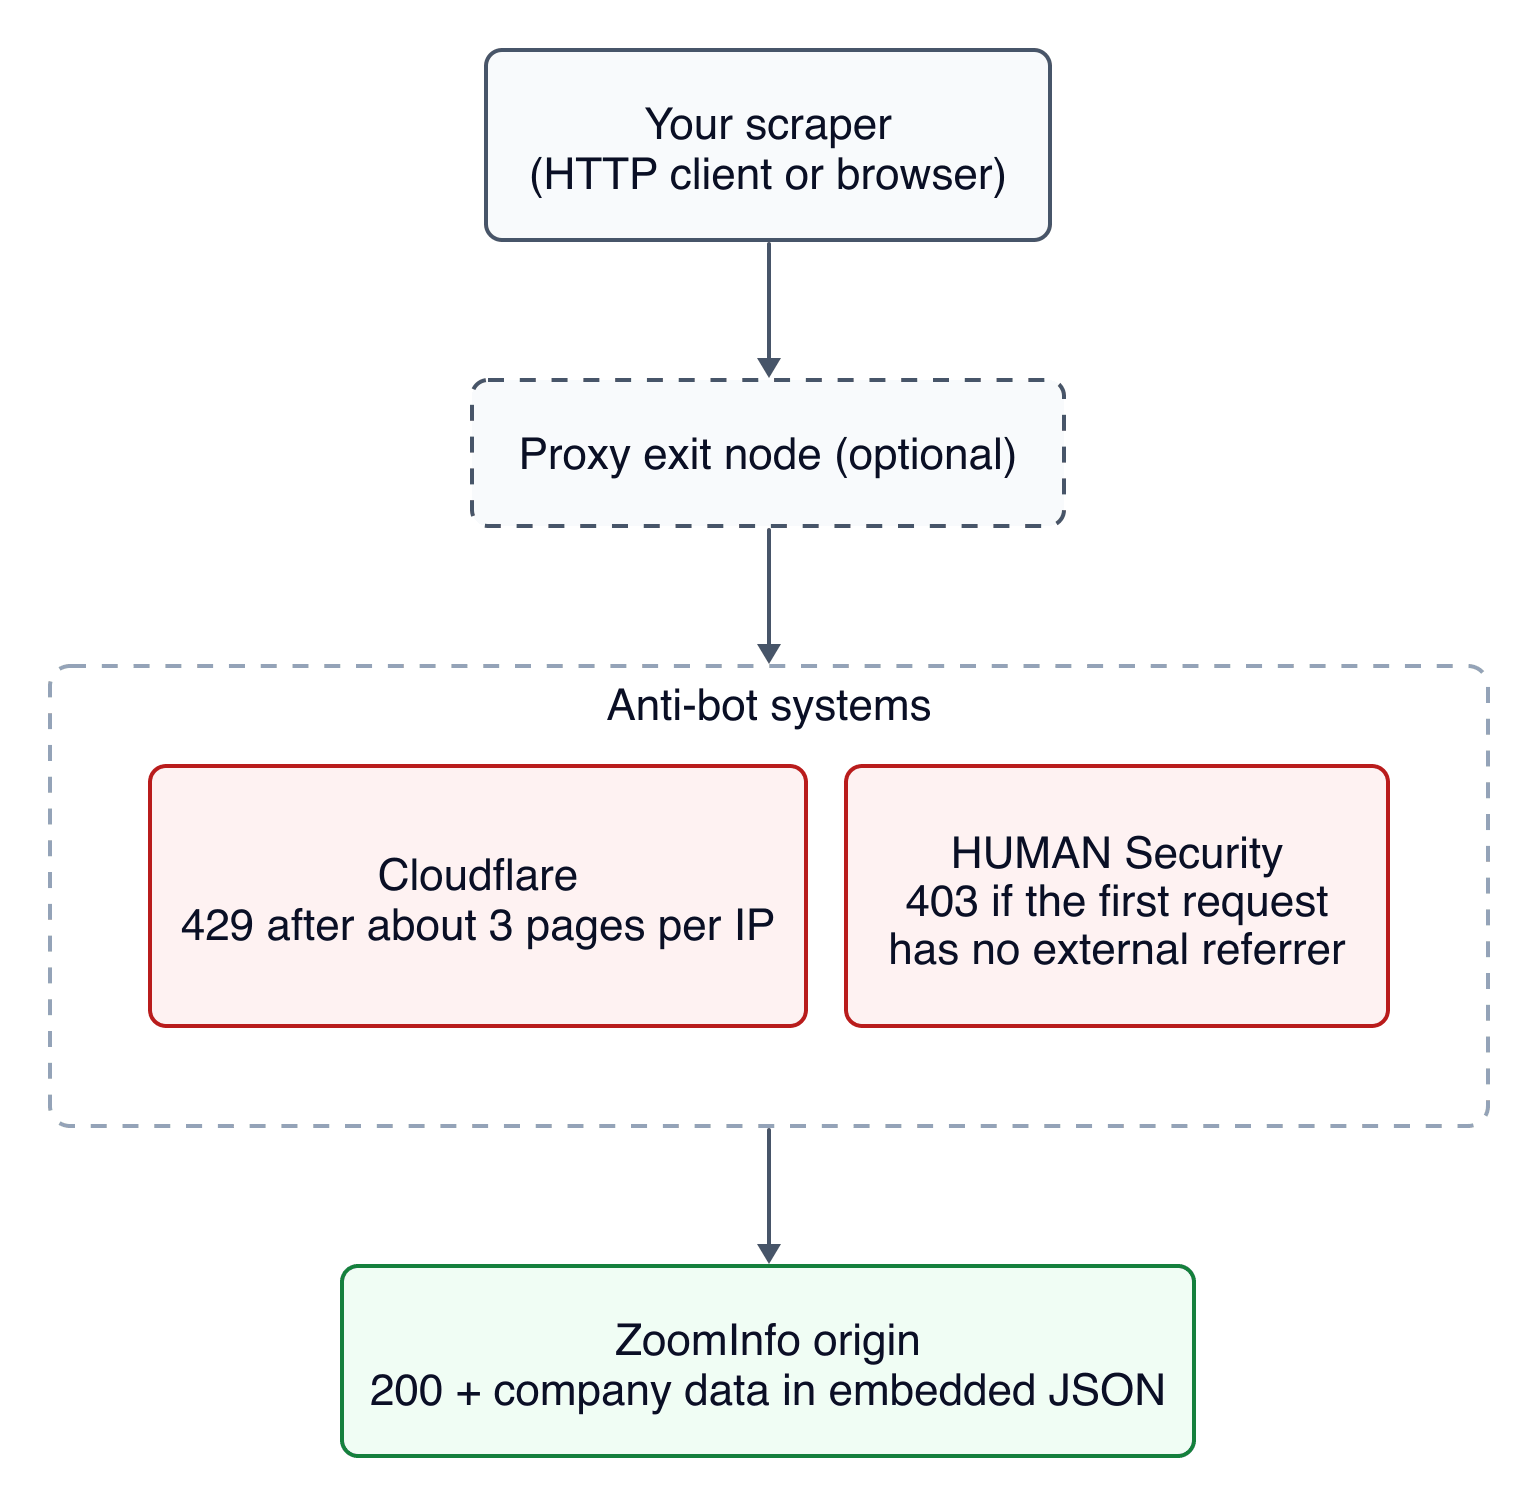
ブロックされたリクエストは企業データを返さないため、ブロック率が高いほどレコードあたりのリクエスト数が増加します。
IPあたり約3ページという条件下では、月間10万件の企業ページを収集するには、最初のページを取得できるセッションが3万3千以上必要になります。最初のリクエストがブロックされるたびに、新たなセッションを開始する必要があります。Bright DataのWeb Unlockerは、これらのセッションを代わりに処理してくれます。
ZoomInfoページから企業データを抽出する
ZoomInfoの企業ページはサーバーレンダリングされたAngularアプリケーションでした。サーバーはページのデータを<script id="ng-state" type="application/json">に書き込んでいました。このスクリプトはAngularのTransferState APIに由来するもので、ブラウザが再取得せずにデータを再利用できるようにするものです。Walmartの場合、このスクリプトは84KBのJSONを保持しており、そのpageDataオブジェクトには42個のキーがありました。
埋め込みJSONには、表示されているページよりも正確な数値が含まれていました。Aviagenのプロフィールでは従業員数を範囲で、収益を小数点以下1桁に丸めて表示していました。
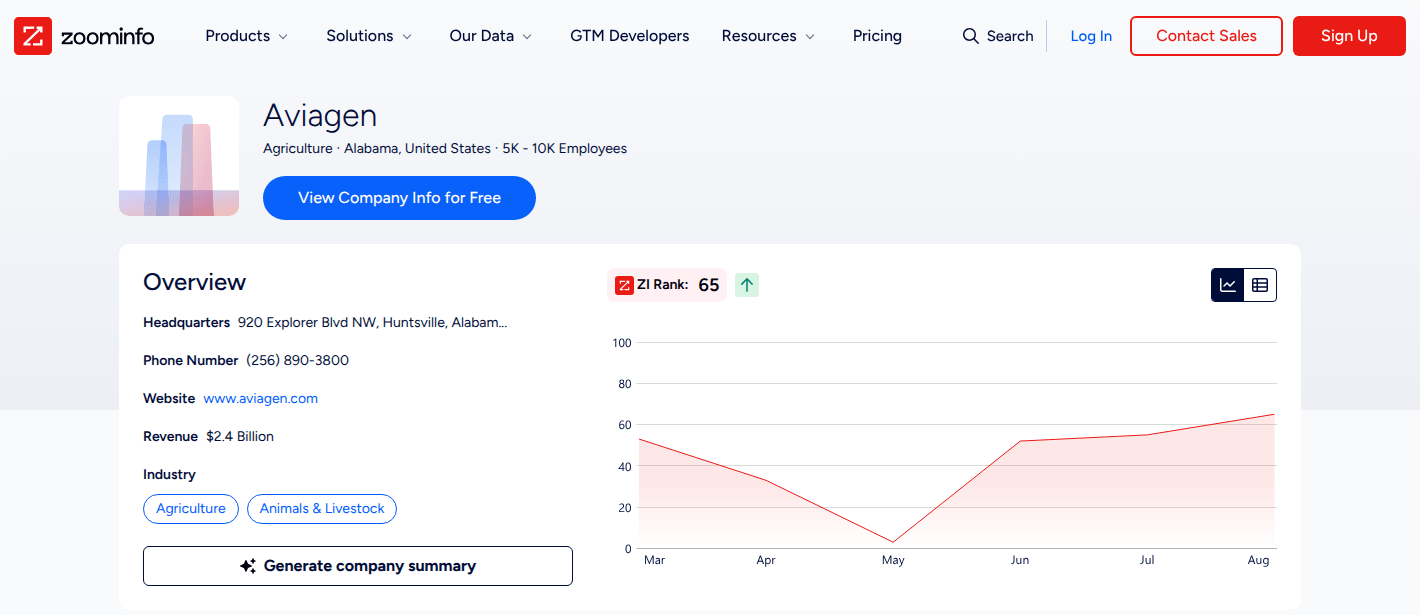
Aviagenの表示されているプロフィールには、従業員数「5K – 10K」、収益「24億ドル」と表示されていました。
同じページのJSONには丸められていない数値が含まれていました。
<script id="ng-state" type="application/json">
{"pageData": {
  "companyId": 9047889,
  "name": "Aviagen",
  "numberOfEmployees": "6776",
  "about": {"revenue": "2413885", ...},
  ...
}}
</script>
ZoomInfoは収益を千ドル単位で保存していたため、Aviagenの2413885は2,413,885,000ドルを意味します。倍率を確認するには、1社の埋め込みJSONとその表示プロフィールを比較してください。
他の企業ページでも範囲として表示されている一方、埋め込みJSONには丸められていない数値が含まれていました。Walmartのページ内のFAQブロックには従業員数「10K+」と記載されていましたが、JSONには2,100,000と記録されていました。収益が「5百万ドル未満」と表示されている5社の小規模企業について、JSONの推定値は366,000ドルから4,474,000ドルの範囲でした。
企業データ自体が変わっていなくても、一部のフィールドは取得のたびに変化していました。Walmartのページを数分の間隔で2回取得したところ、pageDataのキーのうちちょうど3つが異なっていました。
picには、一部が異なる9人の従業員セットが保持されていました。copilotContentには、同じ10個のマーケティングテンプレートが新しい順序で保持されていました。intentsには5件のエントリがあり、そのうち2件がrandomLocationという値を持ち、両方の値が変化していました。
ページ内にこれらのフィールドがあると、ページ全体をハッシュ化すると、実際には変化していない企業もクロールのたびに変化したように見えてしまいます。parse_zoominfo.pyとして保存されるこのパーサーは、埋め込みJSONを読み取り、単位を変換し、IDを文字列として保持し、企業フィールドのみをハッシュ化します。
import hashlib
import json
import re
from urllib.parse import urljoin

STATE = re.compile(r'<script[^>]*id="ng-state"[^>]*>(.*?)</script>', re.S)
LD_JSON = re.compile(
    r'<script[^>]*type="application/ld\+json"[^>]*>(.*?)</script>', re.S
)


def _state(html: str) -> dict | None:
    match = STATE.search(html)
    return json.loads(match.group(1)) if match else None


def _int(value) -> int | None:
    return int(value) if value and str(value).isdigit() else None


def _zi_rank(html: str) -> int | None:
    for block in LD_JSON.findall(html):
        data = json.loads(block)
        if isinstance(data, dict) and data.get("@type") == "Organization":
            for prop in data.get("additionalProperty", []):
                if prop.get("name") == "ZI Rank":
                    return prop.get("value")
    return None


def parse_company(html: str) -> dict | None:
    state = _state(html)
    page = (state or {}).get("pageData") or {}
    if not page.get("companyId"):
        return None  # チャレンジページ、空のシェル、または別のテンプレート
    about = page.get("about") or {}
    overview = page.get("overview") or {}
    revenue_k = _int(about.get("revenue"))  # 千米ドル単位で保存されている
    domain = (page.get("url") or "").lower().removeprefix("www.")
    return {
        "id": str(page["companyId"]),  # 文字列として扱う:人物IDはint32を超える
        "name": page.get("name"),
        "domain": domain or None,
        "employees": _int(page.get("numberOfEmployees")),  # 丸められていない数値
        "revenue_usd": revenue_k * 1000 if revenue_k is not None else None,
        "founded": _int(page.get("foundingYear")),
        "ticker": overview.get("ticker"),
        "sic": overview.get("sic") or [],
        "naics": overview.get("naics") or [],
        "industries": [i["name"] for i in about.get("industries") or []],
        "hq": page.get("address"),
        "phone": about.get("phone"),
        "tech_used": sorted(t["name"] for t in page.get("techUsed") or []),
        "management_levels": {
            m["title"]: m["value"] for m in page.get("mgtl") or []
        },
        "zi_rank": _zi_rank(html),
        # 人物に関するフィールド(executives、pic、hierarchyOrgChart)は除外。
    }


# intents、pic、copilotContentは同一ページの2回の取得間で変化したため、
# ハッシュからは除外する。
STABLE = ("name", "domain", "employees", "revenue_usd", "industries",
          "hq", "phone", "sic", "naics", "ticker", "tech_used")


def content_hash(record: dict) -> str:
    stable = json.dumps({k: record.get(k) for k in STABLE}, sort_keys=True)
return hashlib.sha256(stable.encode()).hexdigest()[:16]parse_companyは、チャレンジページや空のページなど、企業データを持たないページに対してはNoneを返します。Walmartの2回の取得結果では、content_hashは同じ値b4ffe1810bbb1c8cを返しましたが、生のHTMLのSHA-256は異なっていました。
ZoomInfoの企業URLを大規模に収集する
ZoomInfoのrobots.txtには1つのサイトマップのみが記載されており、それにはマーケティングページのみが含まれていました。企業ページや人物ページ用のサイトマップは見つからなかったため、URLリストは他の3つの方法から構築する必要があります。
ディレクトリページ
各/companies-search/ URLには、所在地と業界のフィルターに一致する企業が一覧表示され、pageNumクエリパラメータでページを選択しました。アラバマ州の農業リストには合計1,962社が表示されていました。1〜5ページ目は、それぞれリクエストしたページを返しました。6ページ目と10ページ目へのリクエストは、HTTP 200で1ページ目の企業と、埋め込みJSON内のpageNum: 1を返しました。
そのリストの1ページ目は以下の通りです。
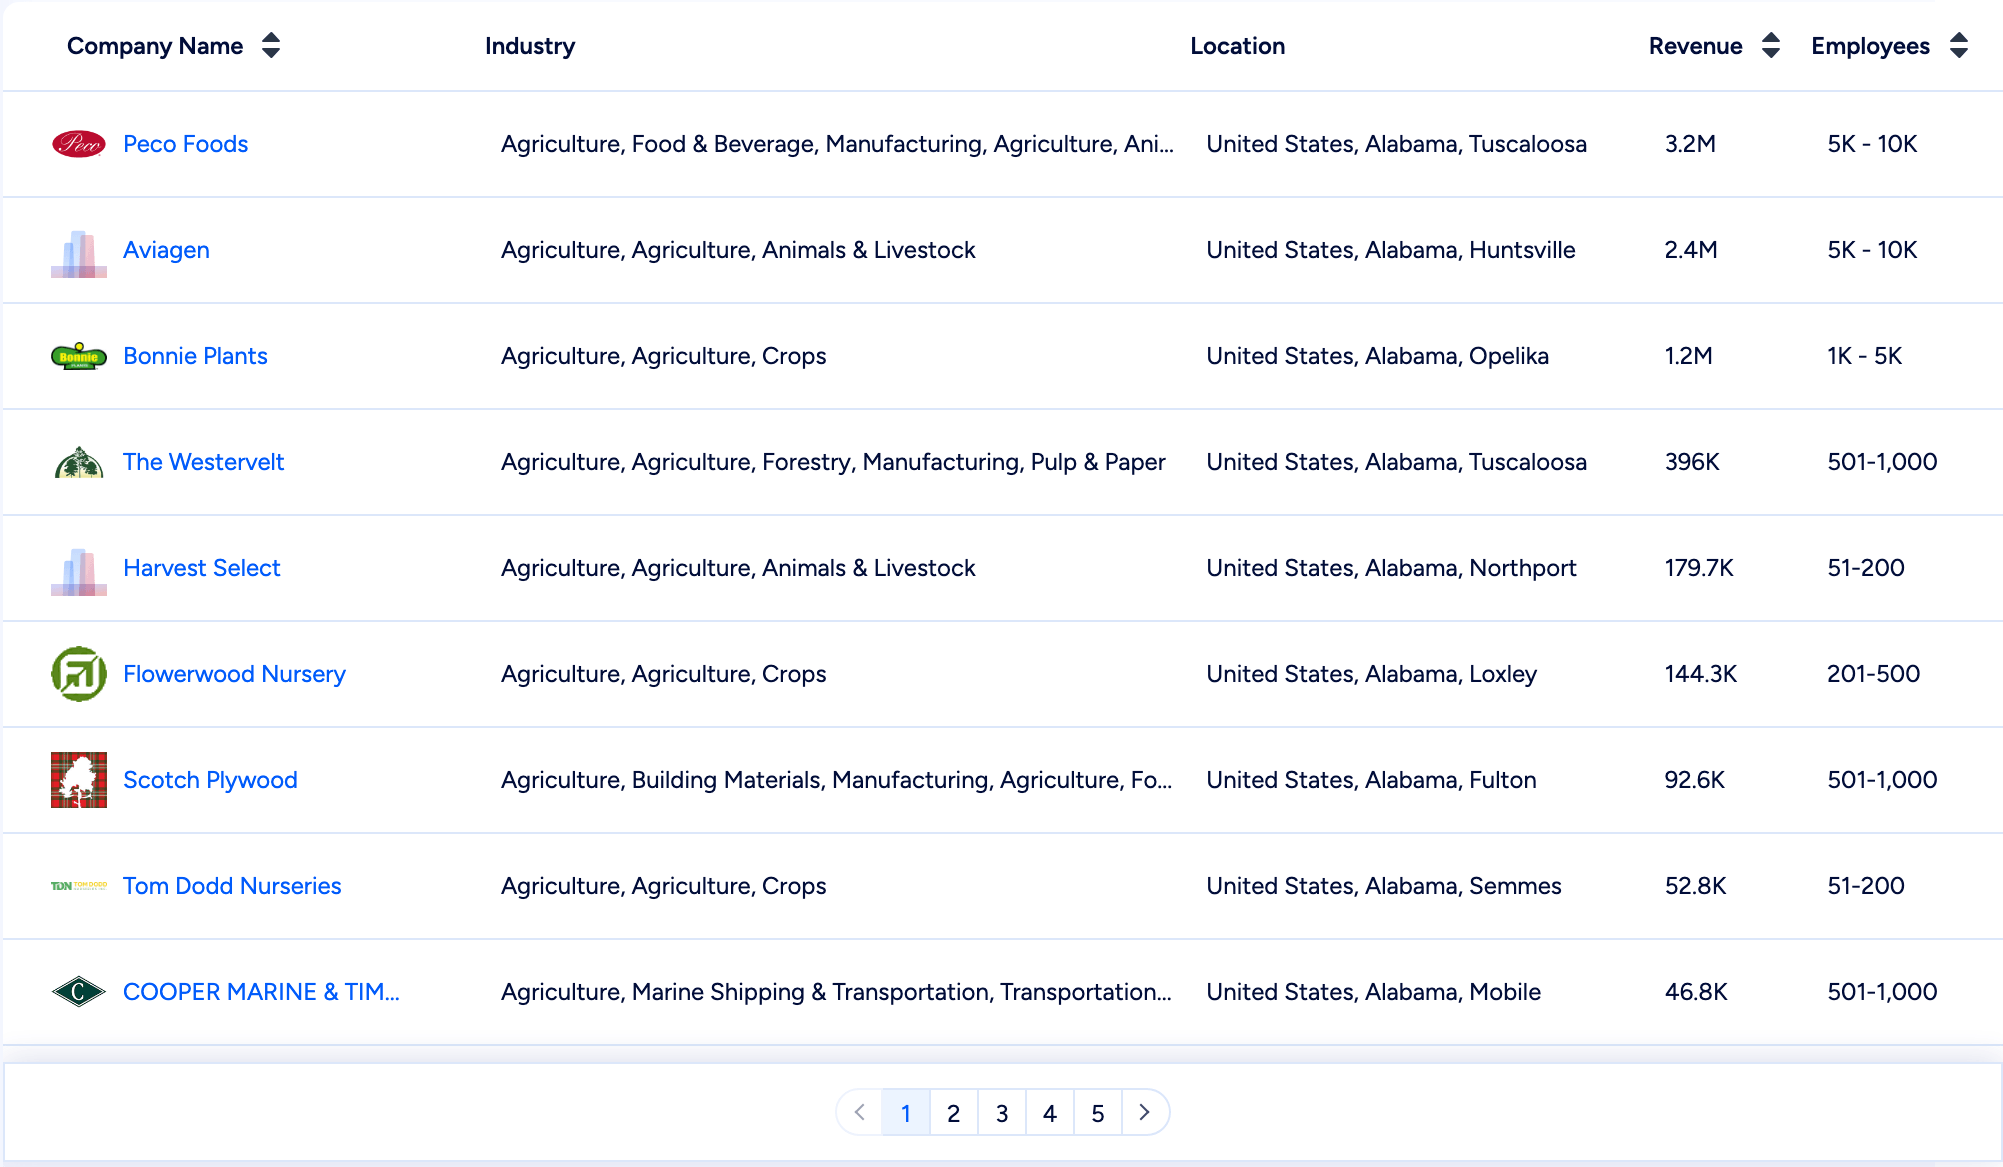
ページネーションは5ページを示していました。収益列は千ドル単位であったため、Aviagenの2.4Mはそのプロフィールにある24億ドルと一致します。
ステータスコードのみをチェックするページネーターは、1ページ目の企業を新しい結果として再び収集してしまいます。このガードをparse_zoominfo.pyに追加してください。これは埋め込みJSON内のページ番号とリクエストしたページ番号を比較します。
def directory_page(html: str, requested: int) -> list[str] | None:
    state = _state(html) or {}
    if state.get("pageNum") != requested:
        return None  # 到達可能なページを超えると、ZoomInfoは1ページ目を再度返す
    rows = (state.get("aiSearchResults") or {}).get("data") or []
    return [urljoin("https://www.zoominfo.com", row["companyUrl"])
for row in rows]directory_pageは1ページあたり9件の企業URLを返し、6ページ目に対してはNoneを返しました。つまり、このフィルターでは5ページのみが到達可能であり、1,962社のうち約45社しか保持していませんでした。より多くの企業にアクセスするには、大きなフィルターを米国の州や業種のサブカテゴリーごとに分割し、各小フィルターが45社以下になるようにしてください。Bright DataのZoomInfo Scraper APIもZoomInfoのディレクトリページをクロールし、記載されている企業を構造化レコードとして返すことができます。
既知の企業に関する検索結果
Bright DataのSERP APIを経由して送信されるsite:zoominfo.com/c example.comのようなクエリは、あるドメインの候補プロフィールを見つけることができます。brightdata.comの場合、このクエリは3つの異なる企業IDを返しました。検索したドメインと一致するウェブサイトを持つ候補を保持してください。
企業ページ間のリンク
多くのプロフィールには類似企業が一覧表示されており、Bright DataのZoomInfo Scraper APIはそれらをsimilar_companiesフィールドとして返しました。クローラーはシードURLのリストから開始し、これらのリンクをたどってさらに多くの企業を見つけることができます。
重複プロフィールと安定したID
重複はZoomInfo自身のデータ内に存在していたため、3つのソースのいずれもそれを返す可能性があります。brightdata.comの場合、追加のプロフィールが1つあり、本来のプロフィールと同じ住所を記載していましたが、ウェブサイトのドメインは異なっていました。その従業員数と収益の推定値も本来のプロフィールとは異なっていました。
ドメインでの結合ではその重複を見逃しますし、名前での結合は無関係な企業とも一致してしまう可能性があります。minimax.comの検索では、名前に「Minimax」を含む9件のプロフィールが返され、そのうちいくつかは無関係な企業でした。エンティティのマッチングはドメインまたは本社の住所で行い、一方のみが一致してもう一方が一致しないプロフィールのみをレビューしてください。ZoomInfoの数値IDを主キーとして保持してください。
企業URLではスラッグが変わることがありますが、追跡したリダイレクトでは数値IDが維持されていました。あるサンプルでは、20件の企業URLのうち3件が301リダイレクトを返したため、それぞれが同じボット対策システムを経由してもう1回リクエストを必要としました。入力/c/walmart-inc/155353090に対して、Scraper APIは同じIDを保持した正規URL/c/walmart/155353090を返しました。Web Unlockerも同じリダイレクトをたどり、Walmartのページを返しました。
ZoomInfoデータを大規模に収集する3つの方法
月間10万件の企業ページ、IPあたり約3ページという条件では、自前のパイプラインには3万3千以上のセッションと継続的なエンジニアリング作業が必要になります。Bright DataのZoomInfoデータ抽出オプションは、ブロック回避済みのページから完成済みレコードまで、そうした作業のさまざまな部分を代わりに処理します。
| Web Unlocker | ZoomInfo Scraper API | ZoomInfoデータセット | |
|---|---|---|---|
| 送信するもの | ページのURL | 企業またはディレクトリのURL | フィルター条件 |
| 取得できるもの | ページ全体のHTML | 構造化されたJSONレコード | ファイル内の完成済みレコード |
| テスト結果 | 企業ページが埋め込みJSONを保ったまま届いた | 企業レコードが届き、ディレクトリURLのページネーションも代行された | サンプルファイルで完全なスキーマが確認できた |
| 配信方法 | 同期または非同期リクエスト | API、クラウドストレージ、またはWebhook経由のスナップショット | スケジュールに基づく更新ファイル |
| パース | 自前で実装 | 含まれる | 含まれる |
適切な選択肢は、必要な出力によって異なります。
- 独自のURLリストに対する構造化レコード。 Scraper APIを使用してください。
- 丸められていない従業員数と収益。
parse_companyとともにWeb Unlockerを使用してください。 - すでに収集済みの広範なカバレッジ。 データセットを使用してください。
クリックやスクロールが必要なページには、Bright DataのBrowser APIが、PlaywrightやPuppeteerで操作できるホスト型Chromeを提供します。クリック操作が不要な企業ページの場合、Web Unlockerの方がシンプルな選択肢です。ブラウザを操作する必要がなく、HTMLを直接返してくれるためです。AIエージェント向けには、Bright DataのZoomInfo MCPサーバーにより、Claude DesktopやCursorなどのクライアントが同じ公開企業プロフィールを収集できます。
始めるには、Bright DataアカウントとAPIキーを作成してください。Web Unlockerの場合、コントロールパネルでゾーン(名前付きWeb Unlocker設定)も作成してください。新規アカウントにはBright DataのAPIをテストするための無料クレジットが付与されます。
これらのスクリプトにはPython 3.10以降が必要です。完全なファイルはGitHub上のBright Dataのzoominfo-scraperリポジトリにあります。キーとゾーンを一度だけ設定してください。
pip install httpx
export BRIGHTDATA_API_KEY="your_api_key"
export BRIGHTDATA_UNLOCKER_ZONE="your_web_unlocker_zone"
各スクリプトは起動時にキーを読み込むため、キーが設定されていないスクリプトはリクエストを送信する前に停止します。
Web Unlockerはパース用にページを返す
Web UnlockerはBright Dataのブロック回避APIです。URLを送信すると、Web Unlockerがプロキシ、ブラウザレンダリング、チャレンジ処理を行い、ページを返します。テストでは、ZoomInfoの企業ページのブロックを解除し、埋め込みJSONを保ったままHTMLを返しました。そのため、parse_companyはそのHTMLに対して変更なしで動作します。
Web Unlockerは、ターゲット自身のステータスをx-brd-status-codeレスポンスヘッダーで報告し、x-brd-errorに詳細を報告するため、パイプラインは結果に応じて分岐できます。デフォルトでは、成功したリクエストのみに課金され、このデフォルトを変更する設定はドキュメントに記載されています。
fetch_pages.pyとして保存されたこのフェッチャーは、一度に5件のURLを処理し、各URLを最大3回試行し、レコードをcompanies.jsonlに保存します。
import json
import os
import sys
import time
from concurrent.futures import ThreadPoolExecutor
from datetime import datetime, timezone

import httpx

from parse_zoominfo import content_hash, parse_company

API = "https://api.brightdata.com/request"
KEY = os.environ["BRIGHTDATA_API_KEY"]
ZONE = os.environ["BRIGHTDATA_UNLOCKER_ZONE"]


def fetch(url: str, attempts: int = 3) -> dict:
    error = None
    for attempt in range(1, attempts + 1):
        try:
            resp = httpx.post(
                API,
                headers={"Authorization": f"Bearer {KEY}"},
                json={"zone": ZONE, "url": url, "format": "raw"},
                timeout=180,
            )
            # APIはこれら2つのヘッダーでターゲット自身の結果を報告する
            target = resp.headers.get("x-brd-status-code")
            record = parse_company(resp.text) if target == "200" else None
        except (httpx.HTTPError, ValueError) as exc:  # タイムアウトまたは不正なJSON
            error = f"{type(exc).__name__}: {exc}"
        else:
            if record:
                record["fetched_at"] = datetime.now(timezone.utc).isoformat()
                record["hash"] = content_hash(record)
                return {"url": url, "ok": True, "attempts": attempt,
                        "record": record}
            error = resp.headers.get("x-brd-error") or f"target {target}"
        if attempt < attempts:
            time.sleep(2 ** attempt)
    return {"url": url, "ok": False, "attempts": attempts, "error": error}


if __name__ == "__main__":
    urls = [line.strip() for line in open(sys.argv[1]) if line.strip()]
    with ThreadPoolExecutor(max_workers=5) as pool, \
            open("companies.jsonl", "a") as good, \
            open("failures.jsonl", "a") as bad:
        for result in pool.map(fetch, urls):
            (good if result["ok"] else bad).write(json.dumps(result) + "\n")
print("saved" if result["ok"] else "not saved", result["url"])urls.txtに1行ずつ記載された3件の企業URLに対し、python fetch_pages.py urls.txtは以下を出力しました。
saved https://www.zoominfo.com/c/bright-data/430599389
saved https://www.zoominfo.com/c/peco-foods-inc/82428957
saved https://www.zoominfo.com/c/aviagen-group/90478893社すべてが保存されました。以下はcompanies.jsonl内のAviagenエントリの企業フィールドです。
{
  "id": "9047889",
  "name": "Aviagen",
  "domain": "aviagen.com",
  "employees": 6776,
  "revenue_usd": 2413885000,
  "founded": 1923,
  "ticker": null,
  "sic": ["02", "025"],
  "naics": ["11", "112"],
  "industries": ["Agriculture", "Animals & Livestock"],
  "hq": {
    "street": "920 Explorer Blvd NW",
    "city": "Huntsville",
    "state": "Alabama",
    "country": "United States",
    "zip": "35806"
  },
  "phone": "(256) 890-3800",
  "tech_used": ["ClickDimensions", "Freshservice", "PHP", "Zingfit"],
  "management_levels": {
    "C-Level": 14,
    "VP-Level": 28,
    "Director": 108,
    "Manager": 998,
    "Non-Manager": 1229,
    "Top Contacts": 1316
  },
  "zi_rank": 65
}Aviagenのプロフィールでは、これらのemployeesとrevenue_usdの値が、ヘッダーと概要セクションにそれぞれ「5K – 10K」、「24億ドル」として表示されていました。
ZoomInfo Scraper APIはレコードを返す
Bright DataのZoomInfo Scraper APIは、ブロック回避とパースの両方を処理します。Collect by URLエンドポイントは企業URLを受け付け、Discover by search_urlはディレクトリURLを受け付け、そのページに記載されている企業を収集します。コントロールパネルには両方のエンドポイントが表示され、同期モードと非同期モードが選択できました。
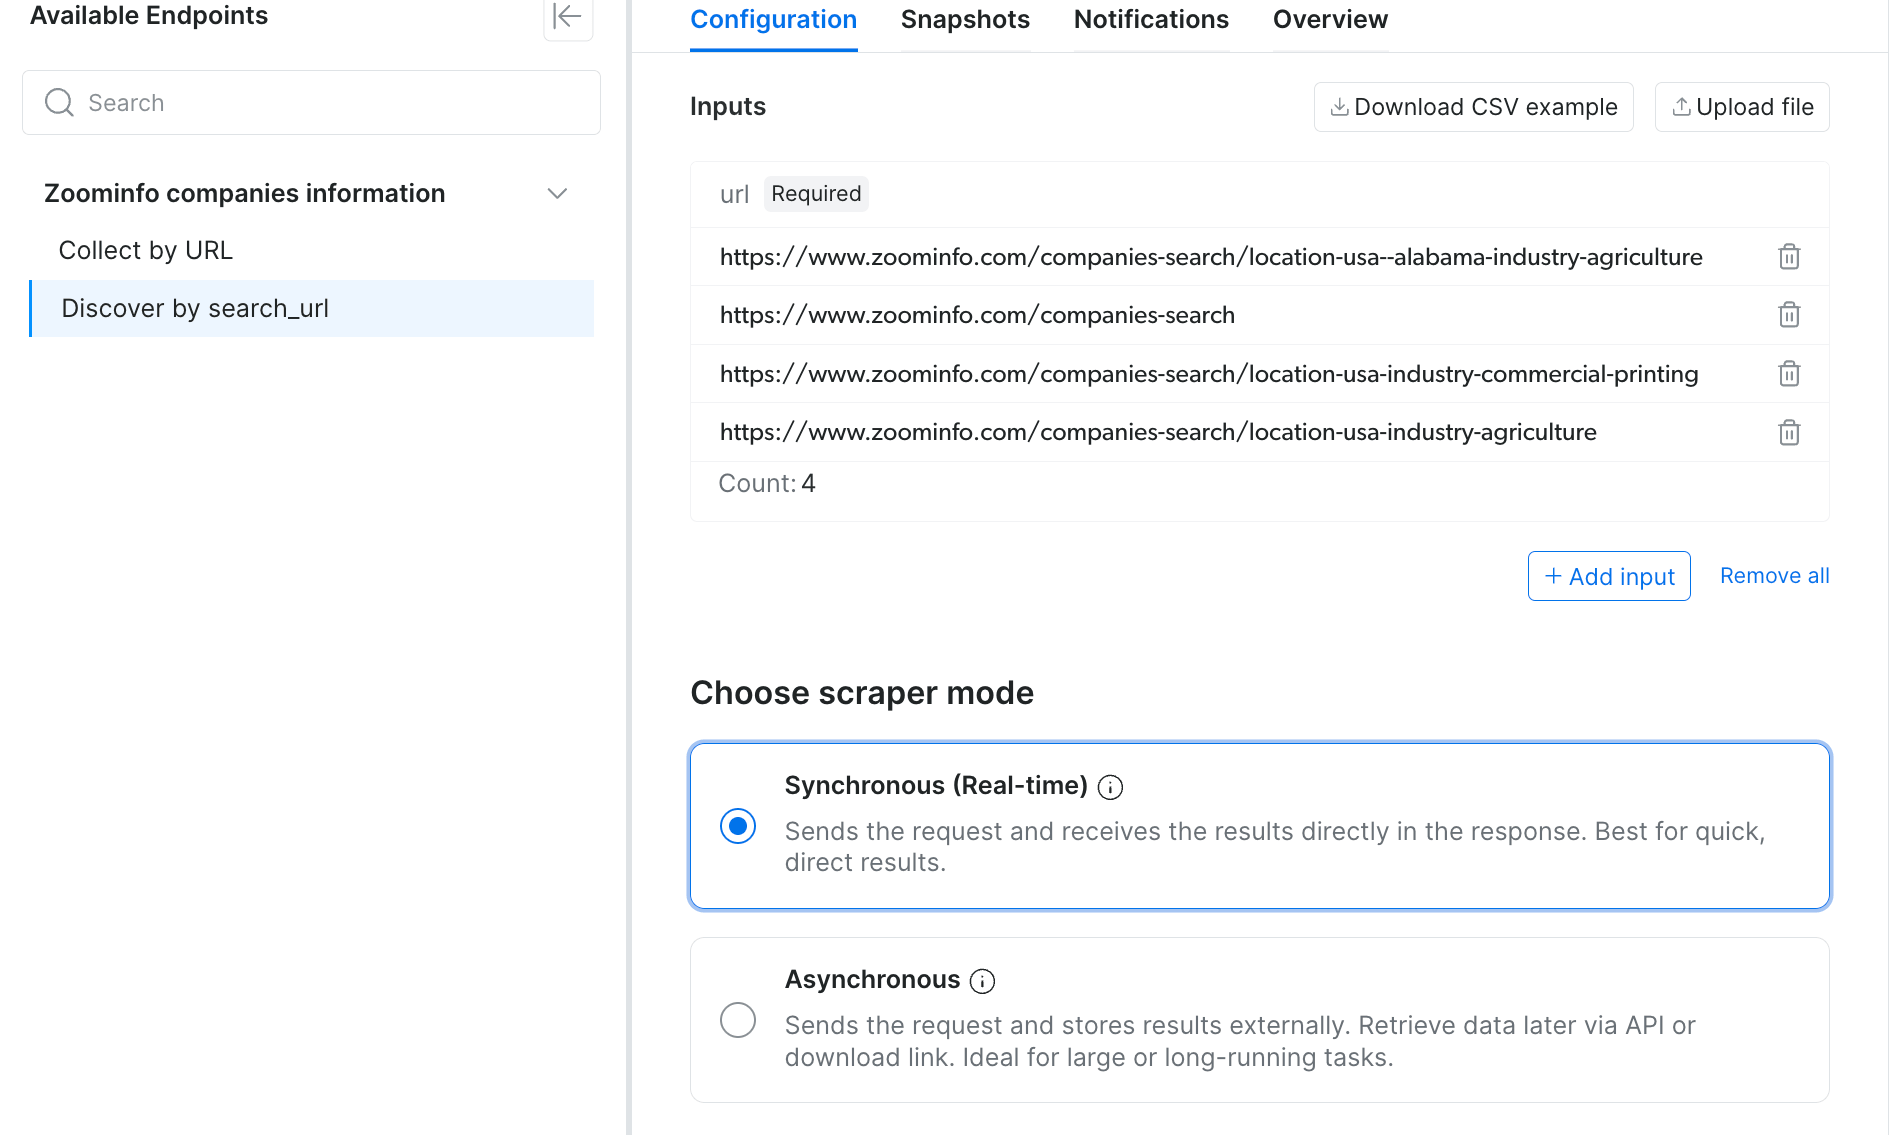
Discover by search_urlは、このようなディレクトリURLを受け付け、そのページに記載されている企業を返します。
バッチ処理には、ジョブをバックグラウンドで実行しスナップショットIDを返す非同期の/triggerエンドポイントを使用してください。同期の/scrapeエンドポイントは小規模なテスト用にレコードを直接返しますが、応答時間の上限を超える長時間のジョブはスナップショットに移行します。
40件のURLをまとめたバッチでは、最初のレコードは1分以内に届きました。大規模なバッチの場合は、APIに結果をクラウドストレージまたはWebhookに配信させてください。最後の入力が完了すると各スナップショットが送信されるため、APIをポーリングする必要がありません。
Discover by search_urlはページネーションを代わりに処理してくれます。アラバマ州のディレクトリURLのみから、45件の企業レコードが返されました。各レコードには、その取得元のディレクトリURLが付与されていました。より大規模なフィルターの場合は、米国の州や業種のサブカテゴリーごとにディレクトリURLを送信してください。
scraper_api.pyクライアントはジョブをトリガーし、スナップショットの準備が整うまでポーリングし、その後ダウンロードします。このclean関数は従業員数の範囲をemployees_minとemployees_maxに変換し、「5百万ドル未満」のような収益範囲にフラグを立てます。また、人物に関するデータを保持する経営陣、組織図、CEOのフィールドも除外します。--discoverを付けると、クライアントはディレクトリURLをDiscover by search_urlに送信します。
import json
import os
import re
import sys
import time

import httpx

BASE = "https://api.brightdata.com/datasets/v3"
DATASET_ID = "gd_m0ci4a4ivx3j5l6nx"  # Zoominfo companies information
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"}


def trigger(urls: list[str], discover: bool = False, limit: int = 50) -> str:
    params = {"dataset_id": DATASET_ID, "include_errors": "true"}
    if discover:  # ディレクトリURL:このジョブがページネーションを処理する
        params |= {"type": "discover_new", "discover_by": "search_url",
                   "limit_per_input": limit}
    resp = httpx.post(f"{BASE}/trigger", params=params, headers=HEADERS,
                      json=[{"url": u} for u in urls], timeout=60)
    resp.raise_for_status()
    return resp.json()["snapshot_id"]


def wait(snapshot_id: str, every: int = 30) -> dict:
    while True:
        try:
            progress = httpx.get(f"{BASE}/progress/{snapshot_id}",
                                 headers=HEADERS, timeout=60).json()
        except (httpx.HTTPError, ValueError):  # ネットワークエラー後に再試行
            progress = {}
        if progress.get("status") in ("ready", "failed"):
            return progress
        time.sleep(every)


def download(snapshot_id: str, tries: int = 30) -> list[dict]:
    for _ in range(tries):
        try:
            resp = httpx.get(f"{BASE}/snapshot/{snapshot_id}",
                             params={"format": "json"}, headers=HEADERS,
                             timeout=300)
            if resp.status_code == 200 and resp.content.strip():
                return resp.json()
        except (httpx.HTTPError, ValueError):  # タイムアウトまたは不完全なファイル
            pass
        time.sleep(10)  # スナップショットファイルが利用可能になるまで待機
    raise RuntimeError(f"snapshot {snapshot_id} is not available yet")


def employee_range(text: str | None) -> tuple[int | None, int | None]:
    # "11-50" -> (11, 50)、"1K - 5K" -> (1000, 5000)、"10K+" -> (10000, None)
    if not text:
        return None, None
    nums = [int(float(n) * (1000 if k else 1)) for n, k
            in re.findall(r"([\d.]+)\s*(K?)", text.replace(",", ""))]
    if not nums:
        return None, None
    if len(nums) == 1:
        return nums[0], None if "+" in text else nums[0]
    return nums[0], nums[1]


def clean(row: dict) -> dict:
    row["employees_min"], row["employees_max"] = employee_range(
        row.get("employees_text"))
    # 従業員数はemployees_textの範囲から取得する
    row["employees"] = row["total_employees"] = None
    row["revenue_is_range"] = (row.get("revenue_text") or "").startswith("<")
    row["stock_symbol"] = (row.get("stock_symbol") or "").strip() or None
    row["id"] = str(row["id"])
    for field in ("leadership", "org_chart", "ceo"):  # 人物に関するデータ
        row.pop(field, None)
    return row


if __name__ == "__main__":
    urls = [a for a in sys.argv[1:] if a.startswith("http")]
    snapshot = trigger(urls, discover="--discover" in sys.argv)
    progress = wait(snapshot)
    summary = {k: progress.get(k) for k in ("status", "records", "errors")}
    print(json.dumps(summary))
    rows = download(snapshot)
    # idを持ち、エラーがない行のみを保持する
    good = [clean(r) for r in rows if r.get("id") and not r.get("error")]
    bad = [r for r in rows if r.get("error") or not r.get("id")]
    json.dump(good, open("records.json", "w"), indent=2)
    json.dump(bad, open("errors.json", "w"), indent=2)
print(f"{len(good)} records saved to records.json")urls.txtの3件の企業URLを引数として渡すと、クライアントは以下を出力しました。
{"status": "ready", "records": 3, "errors": 0}
3 records saved to records.jsonスナップショットには3件すべてのレコードが保持されており、クライアントはそれらをrecords.jsonに保存しました。各レコードには、収益、業界、技術情報、ウェブサイト、本社所在地、電話番号などの企業フィールドが含まれていました。
ZoomInfoデータセットは収集済みのレコードを配信する
ZoomInfoデータセットは、すでに収集済みでスケジュールに基づいて更新される、同じフィールドを持つレコードを配信します。現在のレコード数、更新頻度、価格についてはデータセットページを確認し、購入前にサンプルを確認してください。ZoomInfoのサブスクリプションとどちらを選ぶべきか判断するには、Bright DataとZoomInfoの比較をお読みください。
購入前にフィルタリングしてください。このデータセットのフィルターを使えば、URLに/c/を含む企業ページなど、必要なレコードのみを選択できます。経営陣や組織図の列は人物に関するデータを保持しているため、法的根拠がない限り除外してください。
データセットは収集時点でのレコードを保持しており、更新のたびに最新化されます。更新頻度を決めるには、同じ企業のサンプルを1か月の間隔を空けて2回収集し、変化したレコードの数を数えてください。
CRMのドメインをZoomInfoプロフィールと照合する
CRMはZoomInfoのURLではなくドメインを保持しています。find_profiles.pyとして保存されたこのスクリプトは、Bright Data経由で各ドメインをGoogle検索します。fetch_pages.pyのfetchを使って上位3件のプロフィールを取得し、domainがCRMのドメインと一致する最初のレコードを保持します。引用符なしの検索で一致が見つからない場合、スクリプトはドメインを引用符で囲んで再検索します。
import json
import os
import re
import sys
from concurrent.futures import ThreadPoolExecutor
from urllib.parse import quote_plus

import httpx

from fetch_pages import fetch

API = "https://api.brightdata.com/request"
KEY = os.environ["BRIGHTDATA_API_KEY"]
# あればSERP APIゾーン、なければWeb Unlockerゾーン
ZONE = (os.environ.get("BRIGHTDATA_SERP_ZONE")
        or os.environ["BRIGHTDATA_UNLOCKER_ZONE"])
PROFILE = re.compile(r"https://www\.zoominfo\.com/c/[^/?#]+/\d+")
# 各クエリでそれぞれ異なるプロフィールが見つかったため、両方試す
QUERIES = ("site:zoominfo.com/c {}", 'site:zoominfo.com/c "{}"')


def candidates(query: str, top: int = 3) -> list[str]:
    url = f"https://www.google.com/search?q={quote_plus(query)}&brd_json=1"
    for _ in range(3):
        try:
            resp = httpx.post(
                API,
                headers={"Authorization": f"Bearer {KEY}"},
                json={"zone": ZONE, "url": url, "format": "raw"},
                timeout=120,
            )
            results = resp.json().get("organic", [])  # パース済み結果
        except (httpx.HTTPError, ValueError):  # タイムアウトまたは空のボディ
            continue
        links = [row.get("link", "") for row in results]
        found = (PROFILE.match(link) for link in links)
        return list(dict.fromkeys(m.group(0) for m in found if m))[:top]
    return []


def find_profile(domain: str) -> dict | None:
    for query in QUERIES:
        for url in candidates(query.format(domain)):
            result = fetch(url)
            # ウェブサイトがCRMドメインと一致する場合のみプロフィールを保持する
            if result["ok"] and result["record"]["domain"] == domain:
                return result["record"]
    return None


if __name__ == "__main__":
    domains = [d.strip().lower().removeprefix("www.") for d in sys.argv[1:]]
    with ThreadPoolExecutor(max_workers=5) as pool, \
            open("matches.jsonl", "a") as out:
        records = pool.map(find_profile, domains)
        for domain, record in zip(domains, records, strict=True):
            out.write(json.dumps({"domain": domain, "record": record}) + "\n")
print(domain, record["id"] if record else "no match")4つのCRMドメインに対して、python find_profiles.py aviagen.com pecofoods.com brightdata.com walmart.comは以下を出力しました。
aviagen.com 9047889
pecofoods.com 82428957
brightdata.com 430599389
walmart.com no match
一致した各ドメインについて、スクリプトは完全な企業レコードを返しました。引用符なしの検索ではAviagenとBright Dataが見つかり、引用符付きの検索ではPeco Foodsが見つかりました。Walmartのプロフィールはどちらの検索結果にも現れなかったため、スクリプトは誤った企業を返す代わりに「一致なし」を返しました。一致しなかったドメインは、名前検索やレビューキューに回してください。
CRMに届く前にすべてのレコードを検証する
ZoomInfoおよびBright DataのAPIから確認した各レスポンスには、それぞれ固有の対応が必要です。
| レスポンス | 意味 | 対応 |
|---|---|---|
ng-state内に企業データを含む200 |
実際の企業ページ | パースして保存 |
| 301リダイレクト | URLが変更された | 新しいURLを保存し、IDをキーとして使用 |
ボディにpx-captchaを含む403 |
HUMANがリクエストをブロックした | 新しいセッションで再試行 |
cf-mitigated: challengeを含む429 |
CloudflareのIPあたりのリクエスト上限に達した | IPをローテーションし、そのIPでの再試行を停止 |
| Cloudflareヘッダーなしの429 | Bright Dataの自動スロットリング(成功率低下によりトリガー) | リクエスト頻度を下げ、失敗しているリクエストを修正 |
| ボット対策のシグネチャがない502 | 一時的なアップストリームエラー | バックオフを伴い再試行 |
Web Unlockerのx-brd-status-codeヘッダー |
ターゲットサイト自身のステータス | 200の結果は保存し、それ以外は回数制限付きで再試行 |
/scrapeからのScraper APIの202 |
ジョブがスナップショットに移行した | スナップショットIDをポーリング |
pageNumがリクエストより小さいディレクトリページ |
到達可能な最終ページを超えている | ページネーションを停止し、フィルターを絞り込む |
ステータスチェックは失敗したページを検出し、フィールドチェックは不良なレコードを検出します。
- IDは文字列として保持する。 調査したデータ内のZoomInfoの人物IDは-2,135,143,530から17,773,369,573の範囲であったため、符号付きまたは符号なしの32ビット整数のいずれにも収まりません。
- 従業員数は範囲または埋め込みJSONから読み取る。
cleanからのemployees_minとemployees_max、またはJSONからのnumberOfEmployeesを使用してください。 - 収益の範囲にマークを付ける。 「5百万ドル未満」のような値は範囲であり、JSONには推定値が保持されていました。
- 業界コードを分割する。 「54,541」のような値には、セクターコードとサブセクターコードが含まれていました。
- CEOフィールドが空であることを想定する。 ZoomInfoは、確認したすべての公開ページでCEOフィールドを空のままにしていました。
- バッチごとの入力率を追跡する。 あるフィールドの入力率が急に低下した場合、ZoomInfoがテンプレートを変更した可能性があります。
データクリーニングについては、不正確なウェブスクレイピングデータの修正に関するガイドで詳しく解説しています。
大規模なZoomInfoスクレイピングのコスト
各選択肢には異なる課金単位があり、それぞれの価格ページで現在の料金が確認できます。
| 選択肢 | 課金対象 | その他のコスト |
|---|---|---|
| Web Unlockerと自前のパーサー | デフォルト設定での成功したリクエスト | URL発見、パース、重複排除、ホスティング |
| ZoomInfo Scraper API | 配信されたレコード | 重複排除とストレージ |
| ZoomInfoデータセット | ファイル内のレコード | 重複排除とストレージ |
| レジデンシャルプロキシと自前のスタック | 帯域幅 | セッション、再試行、パース、重複排除、それらを運用するエンジニアリング |
測定した企業ページは圧縮後で42〜55KBであったため、10万ページで約4〜6GBの帯域幅を使用します。大量の利用の場合は、各価格ページでボリュームプランを確認してください。
レジデンシャルプロキシは最も高い自由度を提供します。このサイズのページでは、帯域幅の料金はエンジニアリングコストと比べて小さいものです。自前のスタックでは、ブロックされた最初のリクエスト、再試行、IPあたり約3ページという条件下での追加セッションの分も費用がかかります。また、ZoomInfoがボット対策ルールやページ構造を変更した際にスタックを維持するエンジニアも必要です。
IsraelTechポッドキャストのインタビューで、Bright DataのCEOであるOr Lenchner氏は「繰り返し常に規模が必要な時こそ、私たちが必要とされる」と述べています。少量のデータについては、Lenchner氏はチームが自前で収集することを勧めています。マネージド型とDIY型スクレイピングの比較では、それぞれのアプローチのコストを一覧にしています。
まとめ
ZoomInfoのページは丸められていないファーモグラフィックデータを埋め込みJSONとして保持していましたが、テストでは、ボット対策システムが各最初のリクエストをチェックし、約3ページ後にIPをブロックしていました。JSONのおかげで抽出作業自体は比較的小さなタスクとなったため、大規模運用ではセッション管理、URL発見、重複排除に最も多くの作業が必要になります。私たちのスクリプトは公開されている企業データのみを収集します。連絡先情報にはアカウントが必要であり、人物に関するデータには法的根拠が必要な場合があるためです。
Bright DataのWeb UnlockerとZoomInfo Scraper APIはセッション管理を代行し、ZoomInfoデータセットはBright Dataがすでに収集済みのレコードを配信します。自社のアカウントのサンプルでZoomInfo Scraper APIをテストし、そのレコードをCRMと比較してみてください。
よくある質問
ZoomInfoをスクレイピングできますか?
はい、ログインなしで読み込まれる企業ページについては可能です。連絡先情報にはアカウントが必要でした。公開されている企業ページは埋め込みJSONとしてデータを保持していました。テストでは、他サイトからのリファラーがない場合、ZoomInfoは最初の32件のリクエストすべてをブロックしたため、新しいセッションは必ずリファラー付きで開始してください。
ZoomInfoからデータをスクレイピングするにはどうすればよいですか?
各企業のプロフィールURLを見つけ、公開ページを取得し、その埋め込みJSONからデータを読み取ってください。テストでは、IPは中央値で3ページしか取得できなかったため、多数のセッションを想定して計画してください。Bright DataのZoomInfo Scraper APIが、セッション管理とパースを代行します。
ZoomInfo APIは存在しますか?
はい。ZoomInfoはAPI経由で自社データベースへのアクセスを販売しています。公開企業プロフィールについては、Bright DataのZoomInfo Scraper APIがそれらのページを収集し、構造化レコードとして返します。Bright DataのZoomInfoデータセットは、すでに収集済みでスケジュールに基づいて更新される、同じフィールドを持つレコードを配信します。
ZoomInfoのデータは古いのですか?
一部のレコードは古い可能性があるため、CRMに届く前に確認してください。あるドメインの検索では3つのZoomInfo IDが返され、そのうちの1つは従業員数が異なる重複でした。重複を排除し、入力率を比較し、フィールドの変化頻度に応じて更新してください。
ZoomInfoを無料で使用できますか?
部分的には可能です。zoominfo.comの企業プロフィールページはアカウントなしで読み込めましたが、HTML内では連絡先情報や一部のセクションが有料限定とマークされていました。ZoomInfoは月間クレジットが制限された無料のLiteプランも提供していました。新規Bright Dataアカウントには、それらのページでZoomInfo Scraper APIをテストするための無料クレジットが付与されます。
無料のZoomInfoスクレイパーはありますか?
はい。GitHub上のBright Dataのオープンソースzoominfo-scraperリポジトリには、Bright DataのAPIを使用するPythonスクリプトがあります。テストでは、curlやpython-requestsのUser-Agentを使ったリクエストは、Googleリファラーを付けていても29回中29回ブロックされました。Bright DataのAPIが、これらのスクリプトのブロック回避を代行します。