このガイドでは、Codexと一緒にインストールする価値のある10のコマンドラインツールを紹介します。最初はBright Data CLIです。これはCodexが設計上抱えているブラインドスポットを解決します。サンドボックスにはネットワークアクセスがありません。
ここで紹介するすべてのツールは非対話的に実行でき、モデルが解析できる出力を行い、無人で実行しても安全です。キーボード操作が必要なツールは除外されています。最後近くのセクションでは、人気のあるCodex向けツールがなぜ選外になったかを説明しています。両方のエージェントを使用している場合、Claude Code向けの比較リストでも同じ内容を扱っています。
TL;DR:10のCLIとそれぞれが解決すること
| # | CLI | Codexに対して解決すること | インストール |
|---|---|---|---|
| 1 | Bright Data CLI | 実際のウェブアクセス:ブロック解除、SERP、40以上の構造化パイプライン、ブラウザ制御、Scraper StudioによるAIスクレイピング | npm i -g @brightdata/cli |
| 2 | ripgrep | Codexがすでに優先し、自動承認する検索 | brew install ripgrep |
| 3 | fd | 手書きのfind構文なしでファイルを検索 |
brew install fd |
| 4 | ast-grep | 正規表現の代わりに構文でマッチするリファクタリング | brew install ast-grep |
| 5 | jq | codex exec --jsonやその他のJSONのスライス |
brew install jq |
| 6 | gh | PR、Issue、CIの実行とGitHub API | brew install gh |
| 7 | uv | 数秒でPythonのインストール、実行、ロックファイル | curl -LsSf https://astral.sh/uv/install.sh | sh |
| 8 | mise | オフラインエージェントフェーズでも生き残るピン留めされたツールチェーン | curl https://mise.run | sh |
| 9 | gitleaks | エージェントがコミットする前にシークレットをブロック | brew install gitleaks |
| 10 | Firecrawl CLI | 開発者向けドキュメント検索インデックスを持つ第2のウェブCLI | npm i -g firecrawl-cli |
Codexに適したCLIの条件とは
多くの「ベストターミナルツール」リストは人間向けに最適化されています。エージェントには異なる要件があり、その不一致は見た目以上に重要です。対話型セッションで愛用しているツールがCodexには役に立たないことがあります。シンプルで地味なバイナリが変革的な効果をもたらすこともあります。インストールしようとしているものは、まずこれらの基準で確認してください。
- 非対話的に実行できること。Codexは確認プロンプトに答えたり、フルスクリーンインターフェースを操作したりできません。キー入力を待つものはタイムアウトするまでターンを停止させます。
- 構造化された出力を行うこと。
--jsonフラグはテキストの壁をエージェントが正確にフィルタリングして推論できるものに変えます。散文形式の出力は3ステップ後に表面化する解析ミスを招きます。 - トークン効率が良いこと。ツールが出力するすべてのバイトはコンテキストウィンドウのバイトです。静音モード、フィールド選択、ページネーションでセッションを安価に長く保ちます。
- 正直な終了コードを返すこと。Codexは終了ステータスから次の行動を部分的に決定します。失敗時に0で終了するツールはエージェントを誤った方向へ自信を持って進ませます。
- サンドボックスで動作すること。これはCodex固有の条件です。コマンドはデフォルトでネットワークアクセスのないOS強制サンドボックス内で実行されます。毎回インターネットにアクセスするツールは毎回承認プロンプトを発生させます。意図的な設定でこれを修正でき、このガイドの最後のセクションでその方法を説明します。
インストールする前に知っておく価値のある関連する詳細があります。Codexには安全として扱うコマンドの組み込みリストがありません。サンドボックス外でプロンプトなしに実行されるセットは、あなたが書くルールだけから来ます:Codexが起動時に~/.codex/rules/からスキャンする.rulesファイル、および信頼されたプロジェクトの<repo>/.codex/rules/からです。そのセットは空から始まるため、以下のすべてのツールはルールがカバーするまでプロンプトを出します。TUIでコマンドを承認すると、CodexはあなたのためにルールをA~/.codex/rules/default.rulesに書き込みます。これがツールチェーンの事前承認がインストールの一部である理由です。
他のリストが扱わないギャップ:Codexはデフォルトでオープンウェブにアクセスできない
Codexは意図的にネットワークから遮断されており、多くのガイドはこれを完全にスキップしています。OpenAI自身のセキュリティドキュメントは率直に述べています:デフォルトではエージェントはネットワークアクセスをオフにして実行されます。デフォルトのworkspace-writeサンドボックスは、設定で有効にするまでオフのままです。エージェントがホストにアクセスする必要があるとき、代わりに停止して承認を求めます。これは健全なセキュリティデフォルトです。同時に、Codexが自力で調査できることの最大の制限でもあります。
組み込みのウェブ検索は人々が想定するよりも狭いです。Codexはデフォルトでキャッシュされた検索を有効にし、任意のページをライブで取得するのではなく、OpenAIが管理するインデックスから回答します。1回の実行に--searchを渡すか、config.tomlにweb_search = "live"を設定して、ライブ結果に切り替えることができます。それでも、検索はホストされたツールです。結果を返しますが、認証済みページ、JavaScriptレンダリングされたアプリ、Cloudflareの背後にあるページは返しません。
同じ境界はクラウドにも適用されます。Codexクラウド環境では、セットアップフェーズで依存関係をインストールするためにネットワークにアクセスできます。その後、エージェントフェーズはその環境のインターネットアクセスを有効にしない限りオフラインで実行されます。つまり、このパターンはローカルとリモートの両方で成立します。Codexはウェブについて推論でき、確実に取得することはできません。
これはCodexの欠陥ではありません。信頼性の高いウェブアクセスはモデルの問題ではなくインフラの問題です。プロキシ、ブラウザフィンガープリント管理、CAPTCHAの解決で解決されます。それがまさに、このリストの最初のツールが構築された目的です。
1. Bright Data CLI:サンドボックス内からの実際のウェブアクセス
Bright Data CLIは1つのバイナリの背後にフルのウェブデータスタックを置きます。1回のbrightdata loginでツールを認証し、必要なプロキシゾーンをプロビジョニングします。その後、スクレイピング、検索、構造化抽出、ブラウザ制御はすべて追加のセットアップなしで機能します。これはCodexができることを変える唯一のツールです。残りはCodexの速度を変えるだけです。コマンドはbrightdataで、ショートハンドエイリアスとしてbdataも使用できます。
npm install -g @brightdata/cli      # またはインストールなしで実行:
npx -p @brightdata/cli brightdata --version
brightdata login                    # ブラウザOAuth、またはヘッドレスボックスでは --device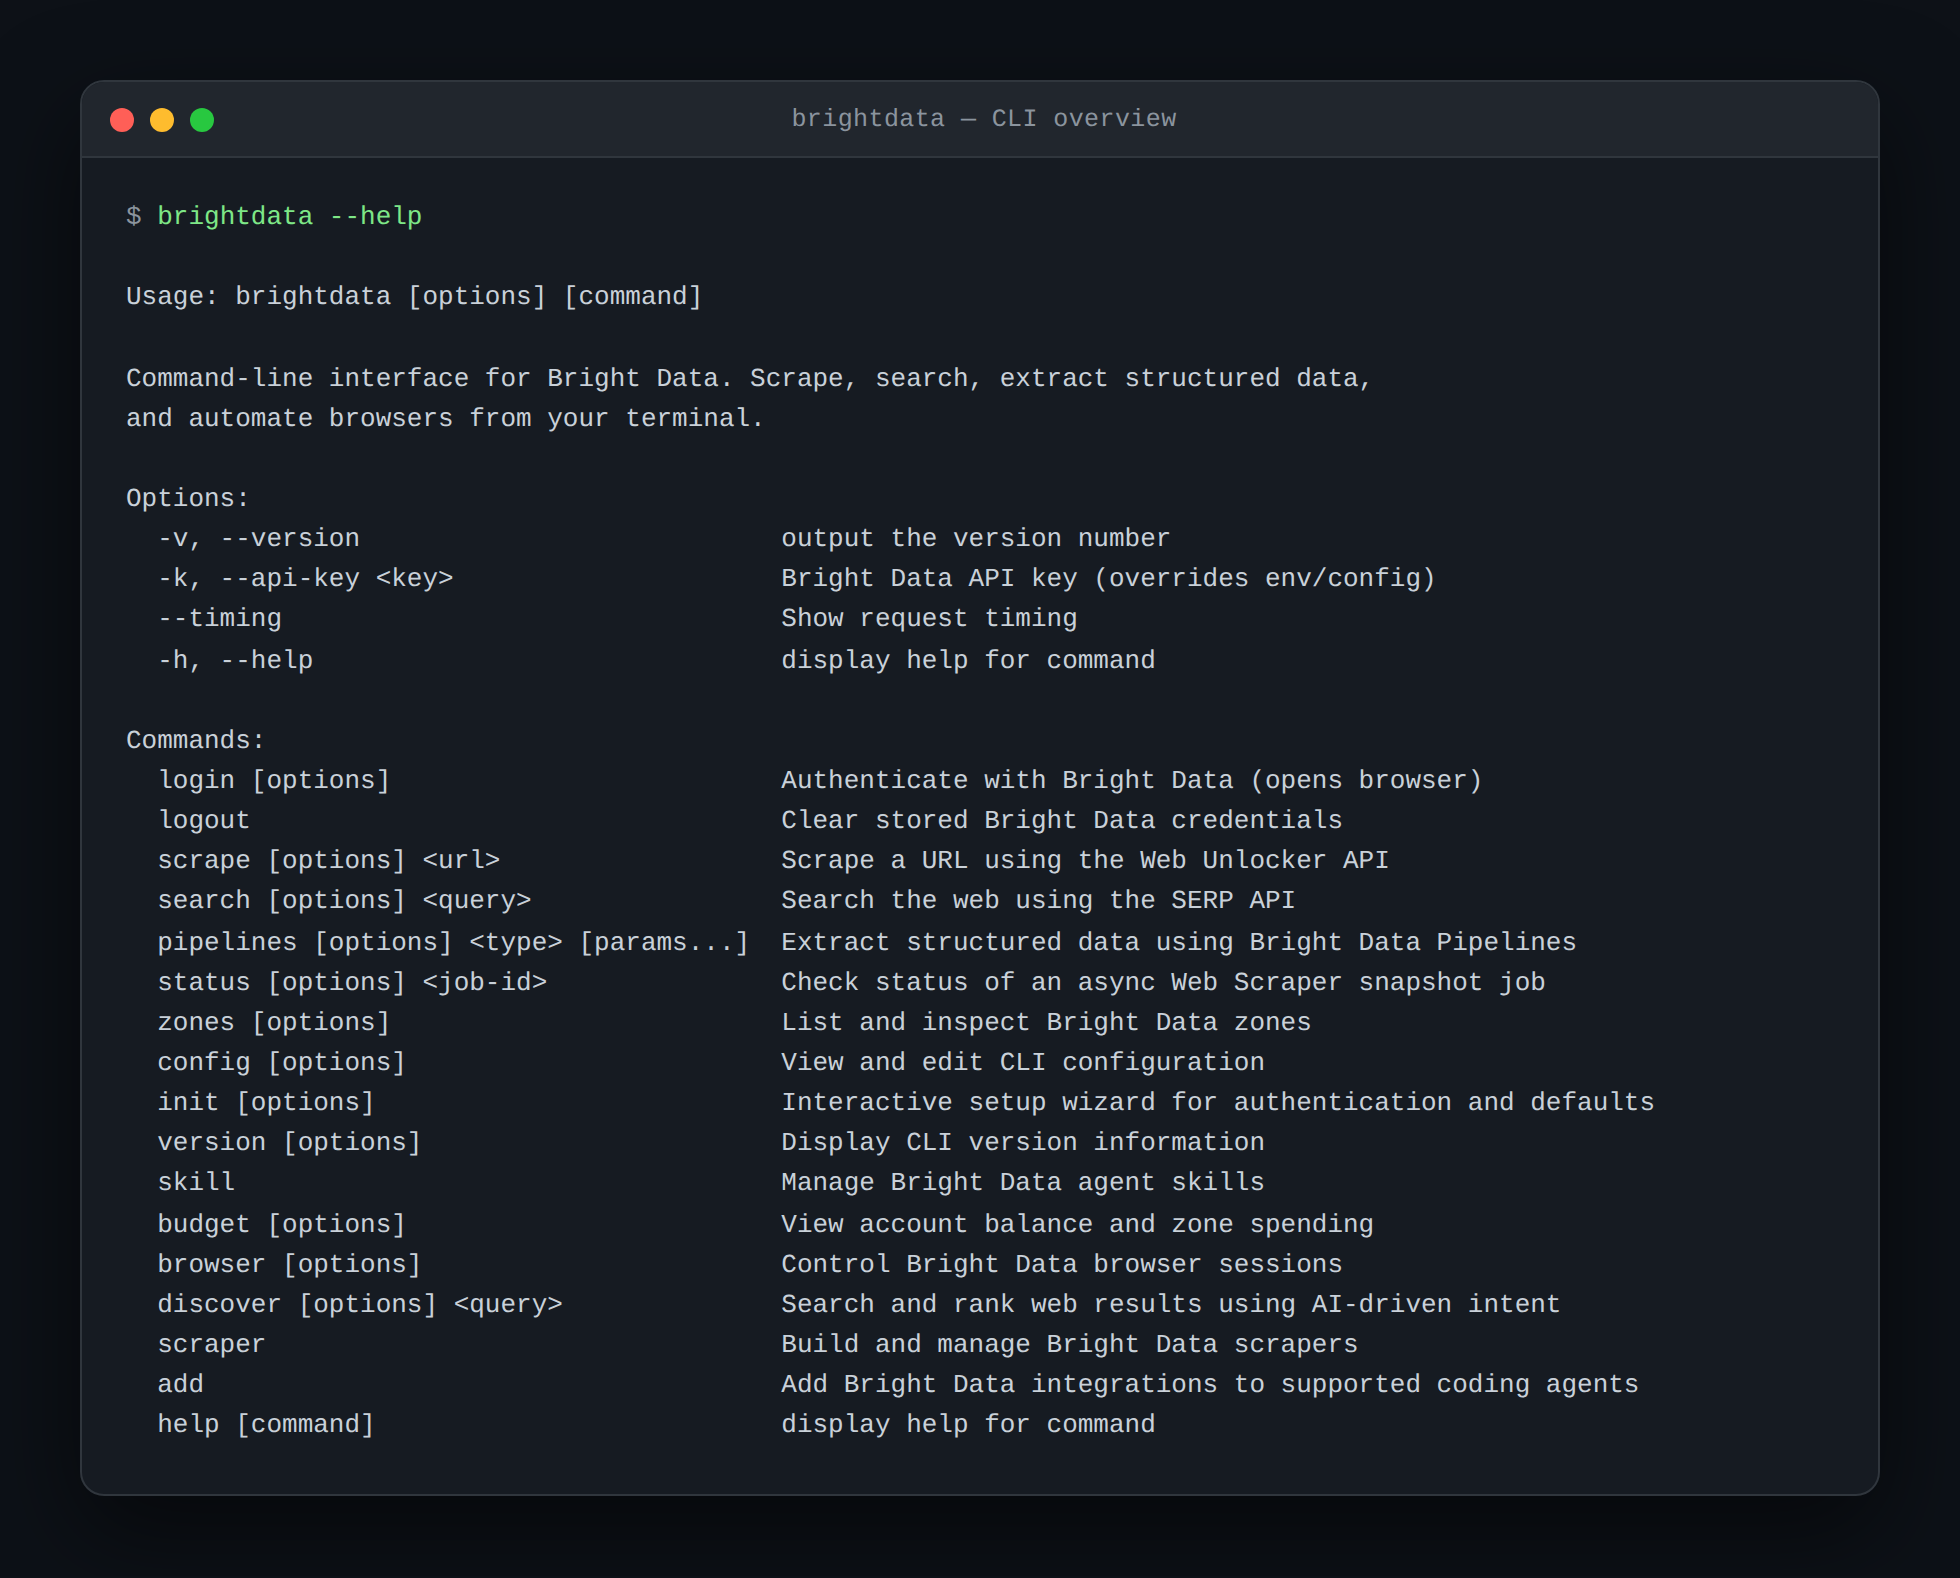
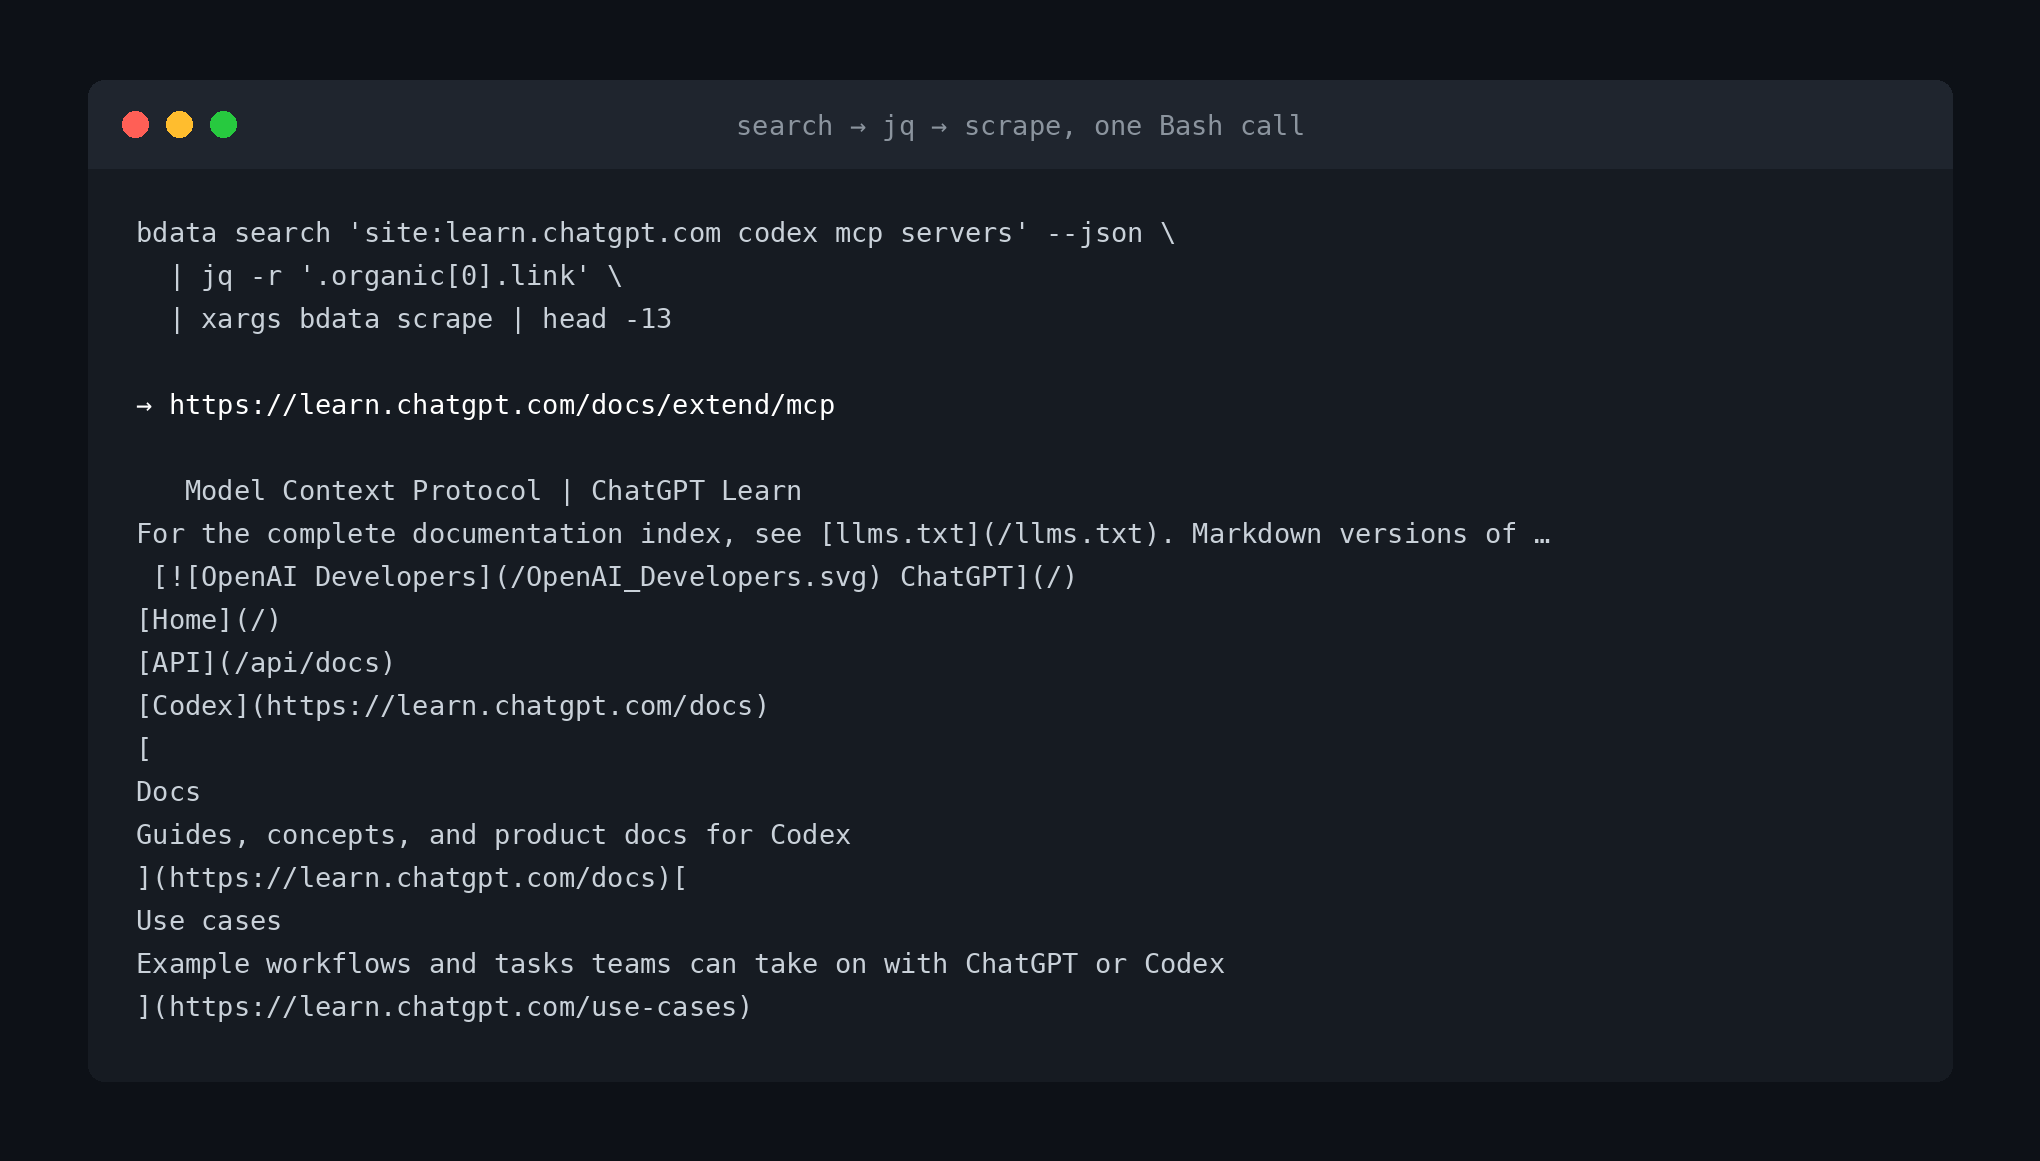
保護されたページを含む何でもスクレイピング。brightdata scrapeはWeb Unlockerを通じて実行され、そのCAPTCHAの解決ソリューション、JavaScriptレンダリング、アンチボットシステムを自動的に処理します。出力はMarkdown、HTML、JSON、またはスクリーンショットにできます。リクエストは国別にジオターゲティングしたり、モバイルユーザーエージェントで送信したりできます。これはページが地域によって異なる場合に重要です。
brightdata scrape https://example.com                          # クリーンなMarkdown
brightdata scrape https://example.com --country de --mobile    # ジオとデバイスターゲティング
brightdata scrape https://example.com -f json --pretty -o page.jsonキャッシュインデックスの制限なしで検索。brightdata searchはSERP APIを通じてGoogle、Bing、またはYandexをクエリします。Googleはオーガニック結果、広告、People Also AskとともStructured JSONを返します。結果は国と言語でローカライズでき、組み込みの検索ではできません。出力をjqに直接パイプすると、エージェントは処理するリンクのクリーンなリストを取得します。
brightdata search "typescript best practices" --json | jq -r '.organic[].link'
brightdata search "restaurants berlin" --country de --language de
brightdata search "AI regulation" --type news既知のプラットフォームでは解析を完全にスキップ。brightdata pipelinesはWeb Scraper APIを通じて40以上の既製エクストラクターを通じて構造化レコードを返します。Amazonの商品、LinkedInプロフィール、YouTubeコメント、Zillow物件情報、GitHubリポジトリファイルはすべてメンテナンスされたエクストラクターを持っています。エージェントはレコードタイプとURLを要求し、JSONを返します。セレクターを書く必要はなく、サイトがリデザインされても修正するものはありません。
brightdata pipelines list                                          # すべてのタイプを確認
brightdata pipelines amazon_product "https://amazon.com/dp/B09V3KXJPB" --pretty
brightdata pipelines youtube_comments "https://youtube.com/watch?v=..." 50 --format csv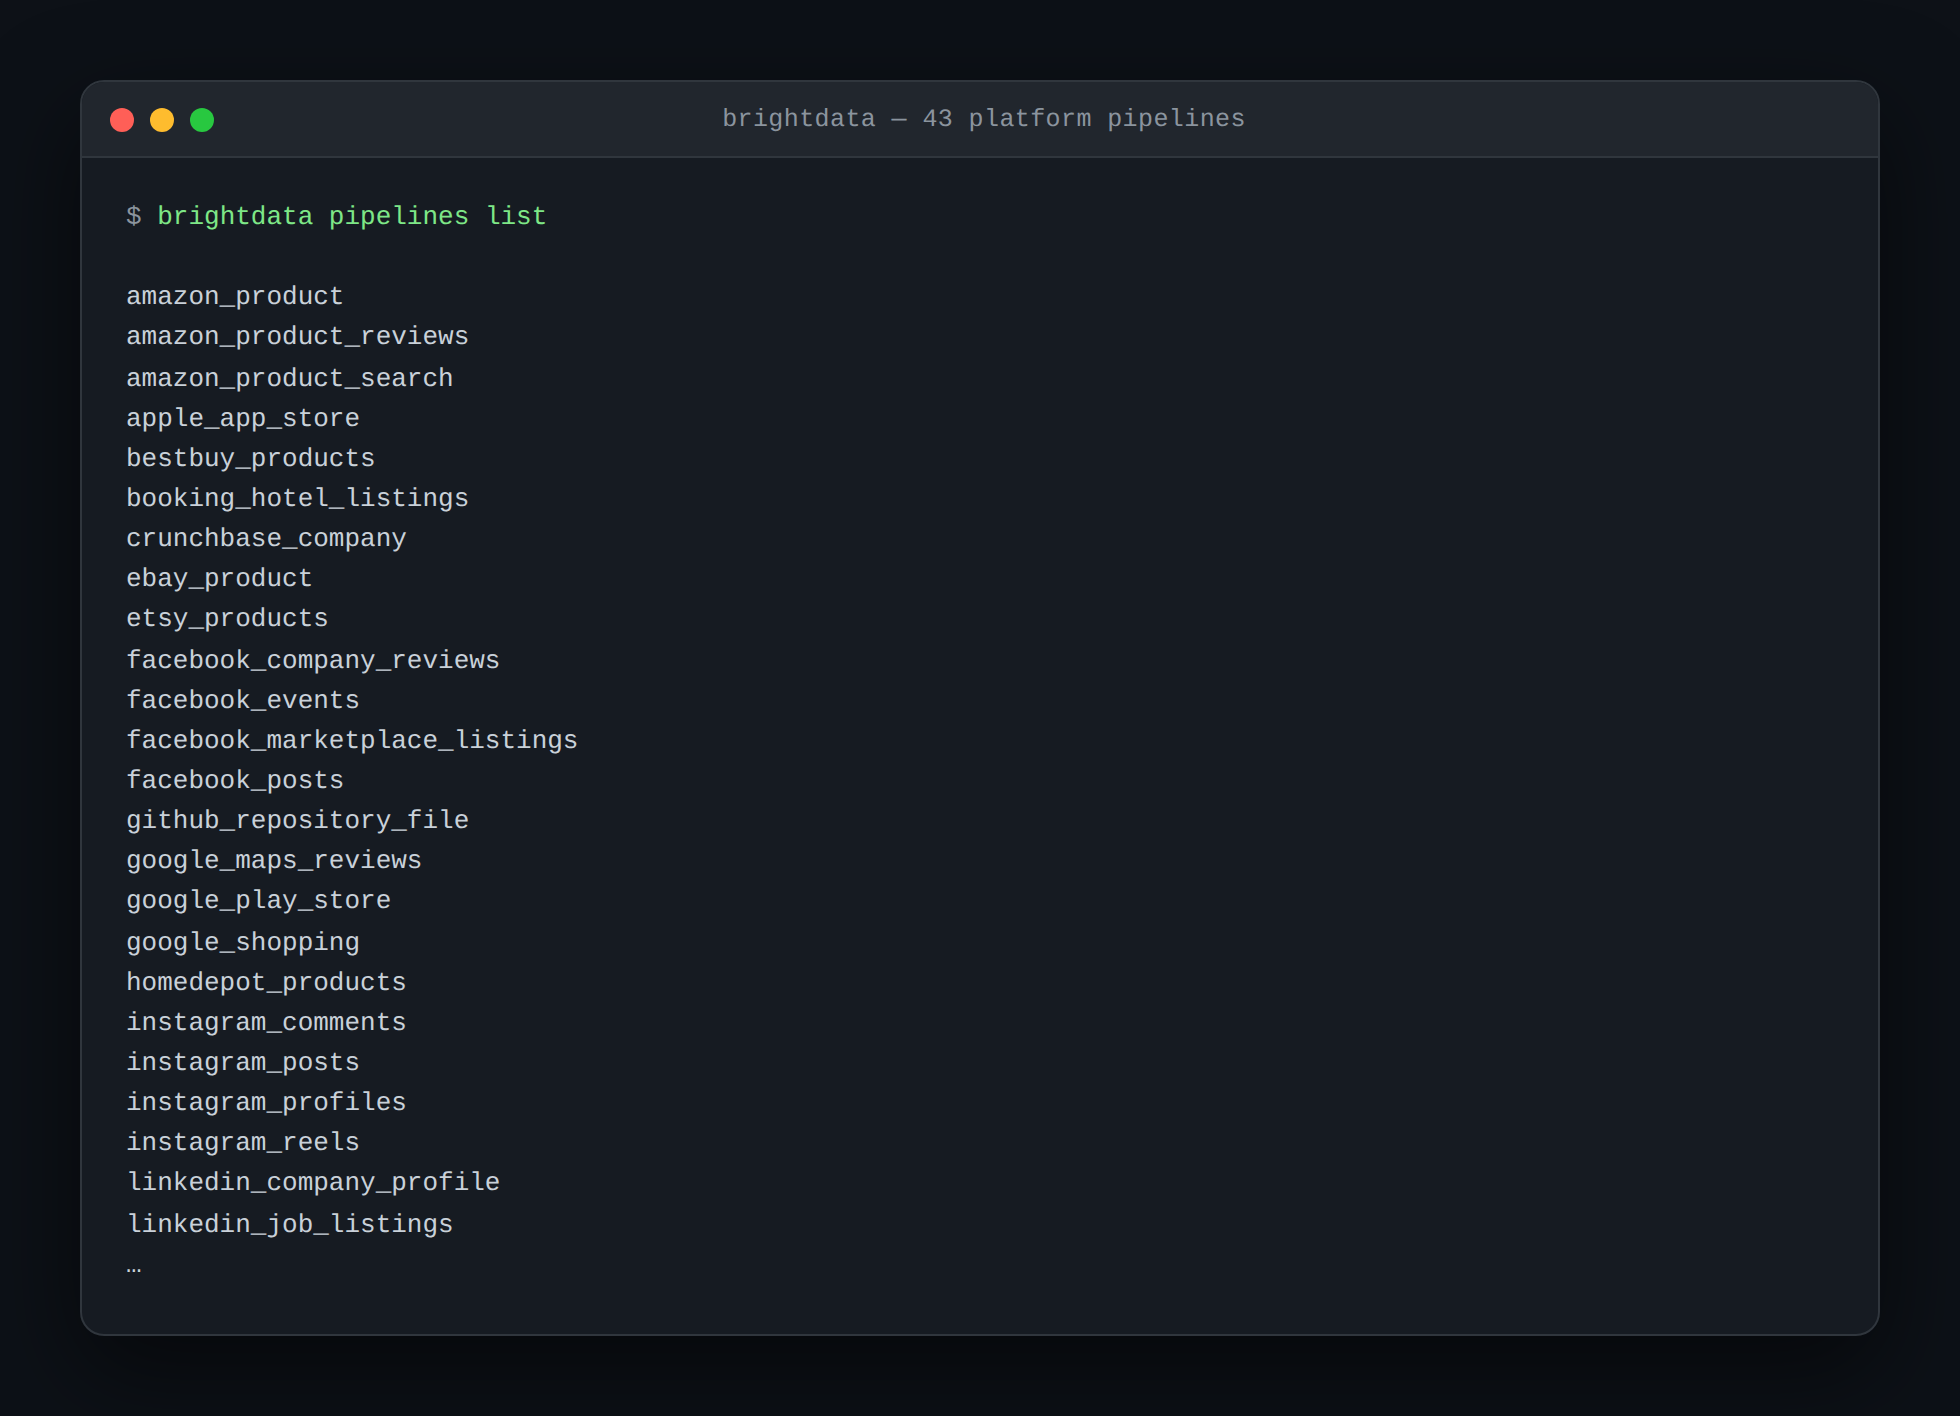
クリックが必要なページでは実際のブラウザを操作。brightdata browserサブコマンドはBrowser APIを通じてクラウドブラウザセッションを開き、ナビゲート、クリック、入力、スナップショットを行います。セッションには名前が付けられるため、エージェントは複数のターンにわたって1つを開いたままにできます。これはマルチステップフォームなど、単一のフェッチでは到達できないフローをカバーします。
サンドボックス内で機能させる。これはCodex固有の部分です。CLIはデフォルトのサンドボックスが拒否するアウトバウンドネットワークアクセスが必要です。それを有効にし、ネットワークプロキシ機能を使ってそのアクセスを狭く保ちます。プロキシはドメインルールを強制し、ルールを追加するだけでは起動しません。結果として、エージェントはBright Dataにのみアクセスできます。
# ~/.codex/config.toml
[sandbox_workspace_write]
network_access = true

[features.network_proxy]
enabled = true
domains = { "**.brightdata.com" = "allow" }CLIはシェルコマンドよりもツールコールを好む場合、Bright Data MCPサーバーをCodexにインストールします。スコープに注意してください。Codexの場合、エントリは[mcp_servers]テーブルの下の~/.codex/config.tomlに書き込まれ、信頼されたプロジェクトの.codex/config.tomlでサーバーを1つのプロジェクトにスコープすることもできます。
brightdata add mcp --agent codex --global料金は月5,000クレジットの無料ティアから始まり、クレジットカードは不要です。これらのクレジットはWeb Unlocker、SERP API、Web Scraper API、Scraper Studio全体で共有される単一のプールです。最初の3つでは1クレジットが1リクエストまたは1レコードです。クレジットは毎月1日にリセットされ、繰り越しはありません。何も支払う前に実際のターゲットでツールを適切に評価するには十分です。
2. ripgrep:Codexがすでに求めている検索
ripgrepはこのリストで最も省略できないツールです。Codexはすでにそれを期待するように書かれているからです。この指示はエージェントのコアプロンプトに組み込まれています。そのプロンプトはgrepよりもrgとrg --filesを優先するよう指示します。検索はエージェントループで最も頻繁なアクションであり、rgの単一のprefix_ruleでプロンプトなしに実行し続けられます。このバイナリ1つで高速なセッションと遅いセッションが分かれます。
デフォルトで.gitignoreを尊重し、バイナリをスキップします。また、grepが必要とする時間のほんの一部で大きなリポジトリを検索します。無駄なマッチが少なければ、それを読むために費やすトークンも少なくなります。
rg -n "TODO" src/                      # 行番号、gitignore対応
rg --files -g '!dist'                   # ビルド出力を除いた候補ファイルのリスト
rg -n --json "createUser" | head -20 # 解析が必要な場合の構造化マッチ知っておく価値のある注意点があります。ルールはフラグではなくコマンドプレフィックスでマッチするため、rgを許可するルールはどんな引数でも許可します。より狭いルールが必要な場合は、Codexにオプションを検査させるのではなく、プレフィックス自体をより具体的にしてください。codex execpolicy checkを使って、依存する前にルールが実際に何を決定するかを確認してください。
3. fd:find構文を書かずにファイルを検索
fdはripgrepの補完ツールで、質問の残り半分をカバーします。ripgrepはファイル内のテキストを検索し、fdはファイル自体を検索します。高速で.gitignoreを尊重し、findが期待する述語の羅列ではなくプレーンなパターンを取ります。この最後の点はエージェントにとって重要です。手書きのfind呼び出しは静かに間違った結果をもたらす一般的な原因です。述語の位置が間違うと、式全体の意味が変わります。
fd -e ts UserProfile                # 名前に一致するすべてのTypeScriptファイル
fd -H -t f '\.env'                  # 隠しファイルを含む、ファイルのみ
fd -e py -x wc -l                   # 結果ごとにコマンドを実行
fdはCodexにルールがないすべてのコマンドと同様に、最初の実行時にプロンプトを出します。このガイドの最後に示すように、一度ルールを追加すれば、その摩擦は永遠に消えます。
4. ast-grep:正規表現の代わりに構文でリファクタリング
正規表現によるリファクタリングはエージェントが静かにダメージを与える場所です。安全に見えるパターンがコメント、文字列リテラル、ベンダー依存関係内の類似した名前のシンボルにマッチします。ast-grepはファイルを解析し、代わりに構文ツリーをマッチします。関数呼び出しのパターンは実際の呼び出しにのみマッチします。パターンは検索する言語で書かれるため、エージェントは何もエスケープする必要がありません。また、言語サーバーなしで実行されるため、起動コストがなく、プロジェクトごとに設定するものもありません。
ast-grep --lang ts -p 'useEffect($$$)'                    # すべての呼び出しを検索
ast-grep --lang py -p 'except: $$$'                       # 裸のexceptを検索
ast-grep --lang ts -p 'foo($A)' -r 'bar($A)' --json       # 書き換え、機械可読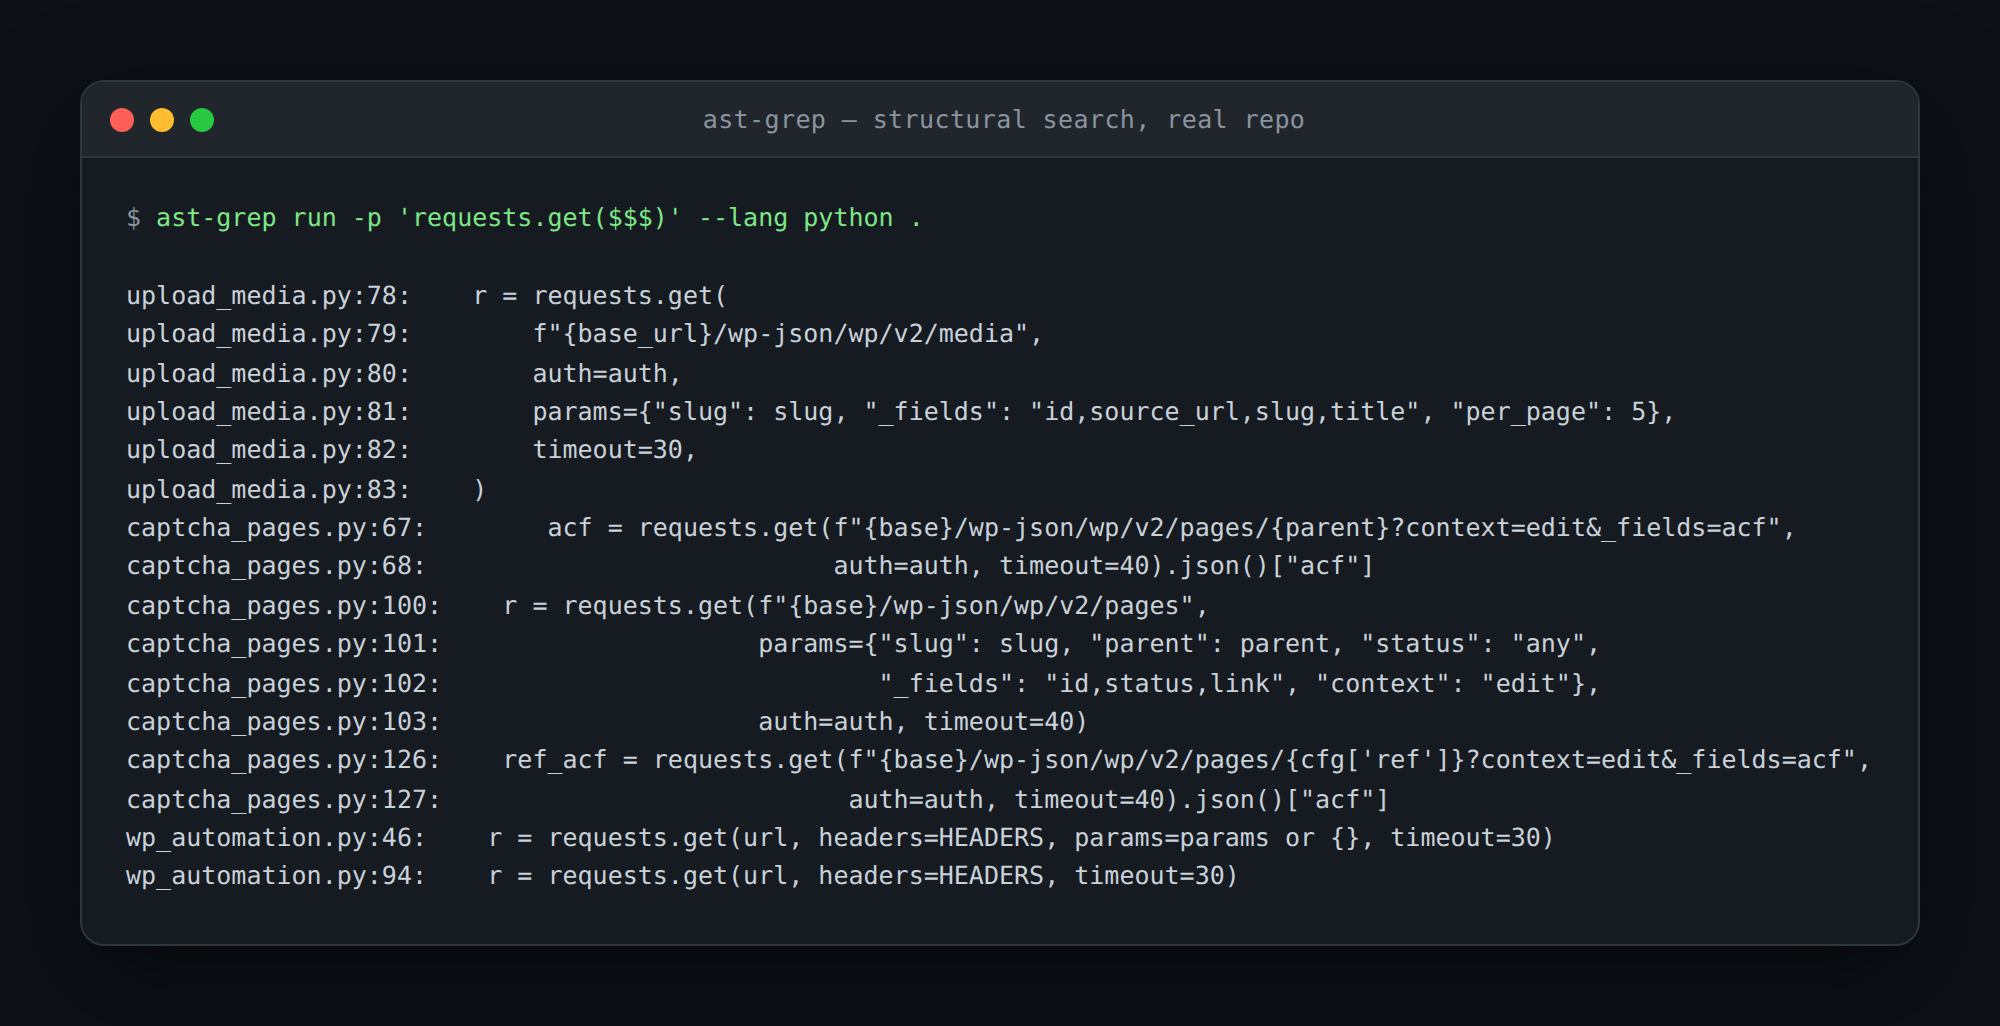
プロジェクトはエージェントがそれを使うようにする方法をドキュメント化しています。推奨されるアプローチはAGENTS.mdの1行です。エージェントにast-grepがインストールされていることを伝えます。そして、構造的検索はデフォルトでast-grep --lang [language] -p '<pattern>'を使用すべきと記述します。そのヒントがなければ、ほとんどのモデルは習慣から正規表現にフォールバックします。
5. jq:JSONをコンテキストウィンドウから遠ざける
jqはあらゆるエージェントツールチェーンで場所を得ており、Codexでは2倍の価値があります。最初の理由は通常のものです。APIレスポンス、ロックファイル、CI出力は大きく、エージェントは通常200フィールドのうち3フィールドを必要とします。コンテキストウィンドウに入る前にスライスすることで、セッションを安価に保ち、モデルの注意をタスクに集中させます。
2番目の理由は、Codex自体がJSONを話すことです。codex exec --jsonを実行するとstdoutがJSON Linesストリームになります。コマンド実行、ファイル変更、MCPコール、ウェブ検索を含むすべてのイベントがそこに入ります。OpenAI自身のドキュメントはそのストリームを直接jqにパイプしています。Codexをスクリプト化する場合、このペアリングが結果を読む方法です。
# 非対話型実行から最終エージェントメッセージのみを取り出す
codex exec --json "summarize the repo structure" \
  | jq -r 'select(.type=="item.completed") | .item | select(.type=="agent_message") | .text'

# 大きなAPIレスポンスを重要なものだけにスライス
cat response.json | jq '{id, status, items: [.items[] | .name]}'
6. gh:仕事のGitHub側半分
実際の作業の大部分はエディタにはありません。失敗したCIログを読んだり、レビュアーが何を求めたかを確認したりすることです。そしてプルリクエストを開くことです。GitHub CLIはCodexに、重要なコマンドに--jsonを付けた1つの認証済みバイナリを通じてそれらすべてを提供します。それなしでは、エージェントはローカルのgit履歴からリポジトリの状態を推測します。リモートが進むと、その推測は壊れます。
gh pr list --json number,title,headRefName
gh run view --log-failed                    # CIが失敗した正確な理由を読む
gh api repos/{owner}/{repo}/issues --paginate | jq -r '.[].title'これはネットワークを必要とするツールの最も明確なケースです。設定するまで承認プロンプトを期待してください。OpenAIのルールドキュメントはgh pr viewを実例として使用しており、摩擦がいかに一般的かがわかります。どのプレフィックスを静かにしたいか、どれが常に確認すべきかをプレフィックスごとに決めてください。読み取りは通常許可しても安全で、書き込むものはプロンプトの価値があります。
7. uv:待ち時間なしのPython
Pythonのツーリングはエージェントループ内で複合的に悪化する方法で遅いです。すべてのインストール、環境作成、依存関係の解決は無駄な時間です。エージェントは人間よりもはるかに頻繁にこれら3つを行います。uvはそれらのステップをほぼ瞬時のものに縮めます。また、プロジェクトを作成せずにその依存関係でスクリプトを実行します。これがほとんどの一時的なエージェントタスクの形です。
uv run --with httpx script.py       # 一時的な環境、プロジェクト不要
uv sync --frozen                    # ロックファイルが固定したものを正確にインストール
uv add ruff && uv run ruff check .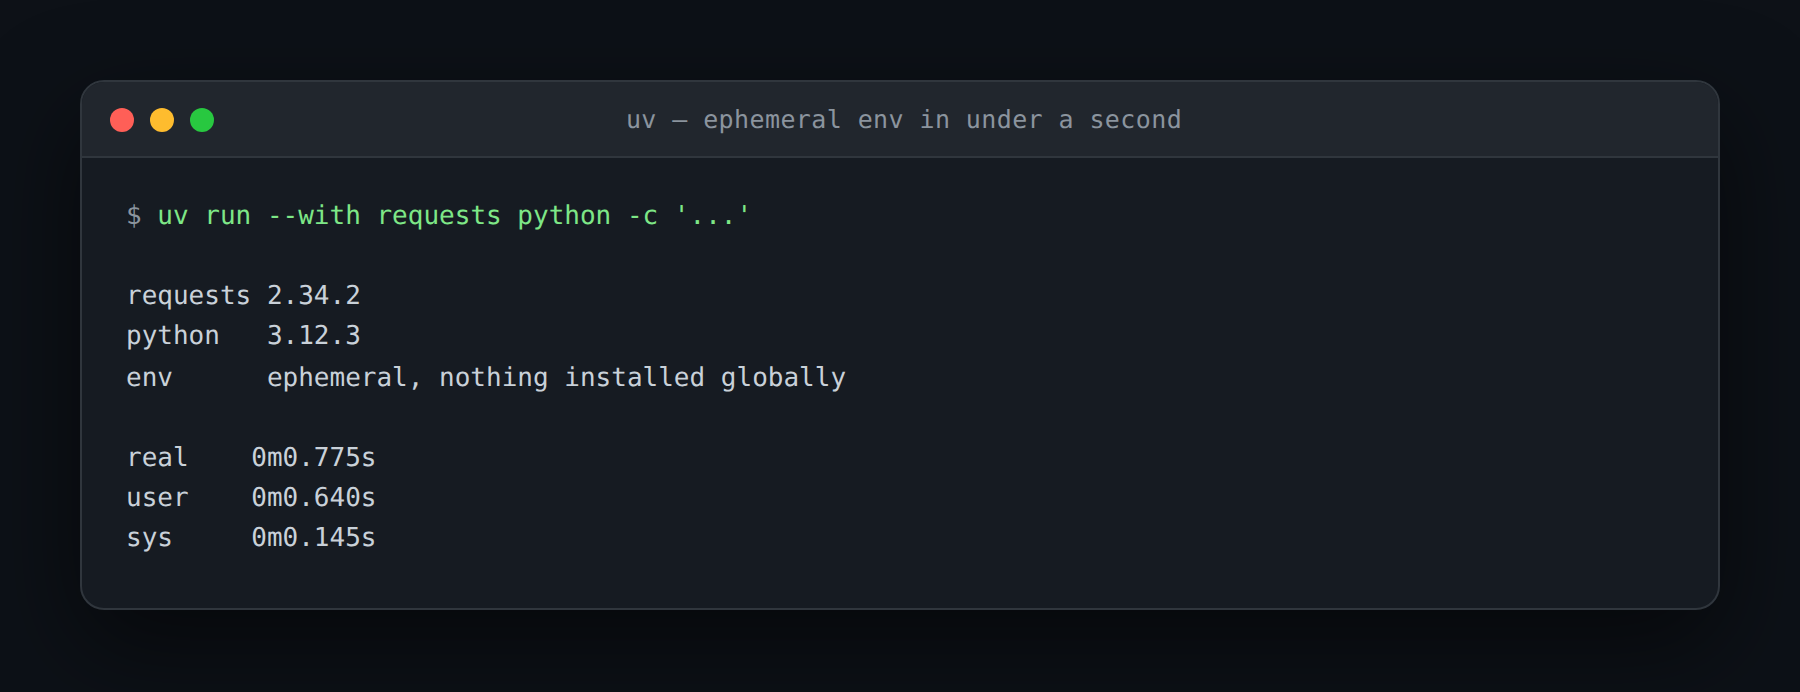
ロックファイルの習慣はCodexでは他の場所よりも重要です。uv sync --frozenはロックファイルの更新を拒否するため、エージェントはあなたがピン留めした正確なバージョンをインストールします。これにより解決ステップがネットワークリクエストになるのを防ぎます。また、無関係なタスクの下に依存関係のバンプが忍び込むのも防ぎます。
8. mise:オフラインエージェントフェーズでも生き残るツールチェーン
miseはCodexの動作方法のために存在するエントリです。mise.tomlファイルにプロジェクトごとの言語ランタイムとCLIツールをピン留めし、1つのコマンドですべてをインストールします。Node、Python、Go、Ruby、Rustが組み込まれています。npm、PyPI、GitHubリリースのものも同様にピン留めできます。1つのファイルが環境全体を記述し、エージェントはバージョンを指示されなくても再作成できます。
mise use --global node@26 [email protected]    # ピン留めとインストール
mise install                             # mise.tomlがピン留めするすべてをインストール
mise exec -- npm test # ピン留めされたツールチェーンをPATHに入れて実行効果はクラウドで現れます。Codexクラウド環境はセットアップフェーズでネットワークにアクセスでき、その後デフォルトでオフラインでエージェントフェーズを実行します。エージェントが必要とするものはすべてそのスイッチの前に存在しなければなりません。セットアップスクリプトにmise installを入れることで、ネットワークが切れたときにすべてのピン留めされたツールがすでにディスク上にあります。同じロジックはローカルにも適用され、ランタイムが欠けているとタスクの途中で承認プロンプトになります。
9. gitleaks:コミット前のガードレール
エージェントは素早くコードを書き、時にはそのコードにキーが含まれることがあります。テストフィクスチャに貼り付けられたトークンかもしれません。生成された設定ファイルの接続文字列かもしれません。gitleaksはワーキングツリーまたはgit履歴を大きなルールセットに対してスキャンし、何かを見つけると非ゼロで終了します。その終了コードが重要な部分です。なぜならそれがCodexが実際に行動するシグナルだからです。
gitleaks dir . -v --redact                                  # ワーキングツリーをスキャン
gitleaks git --report-format json --report-path leaks.json  # 履歴をスキャン、機械可読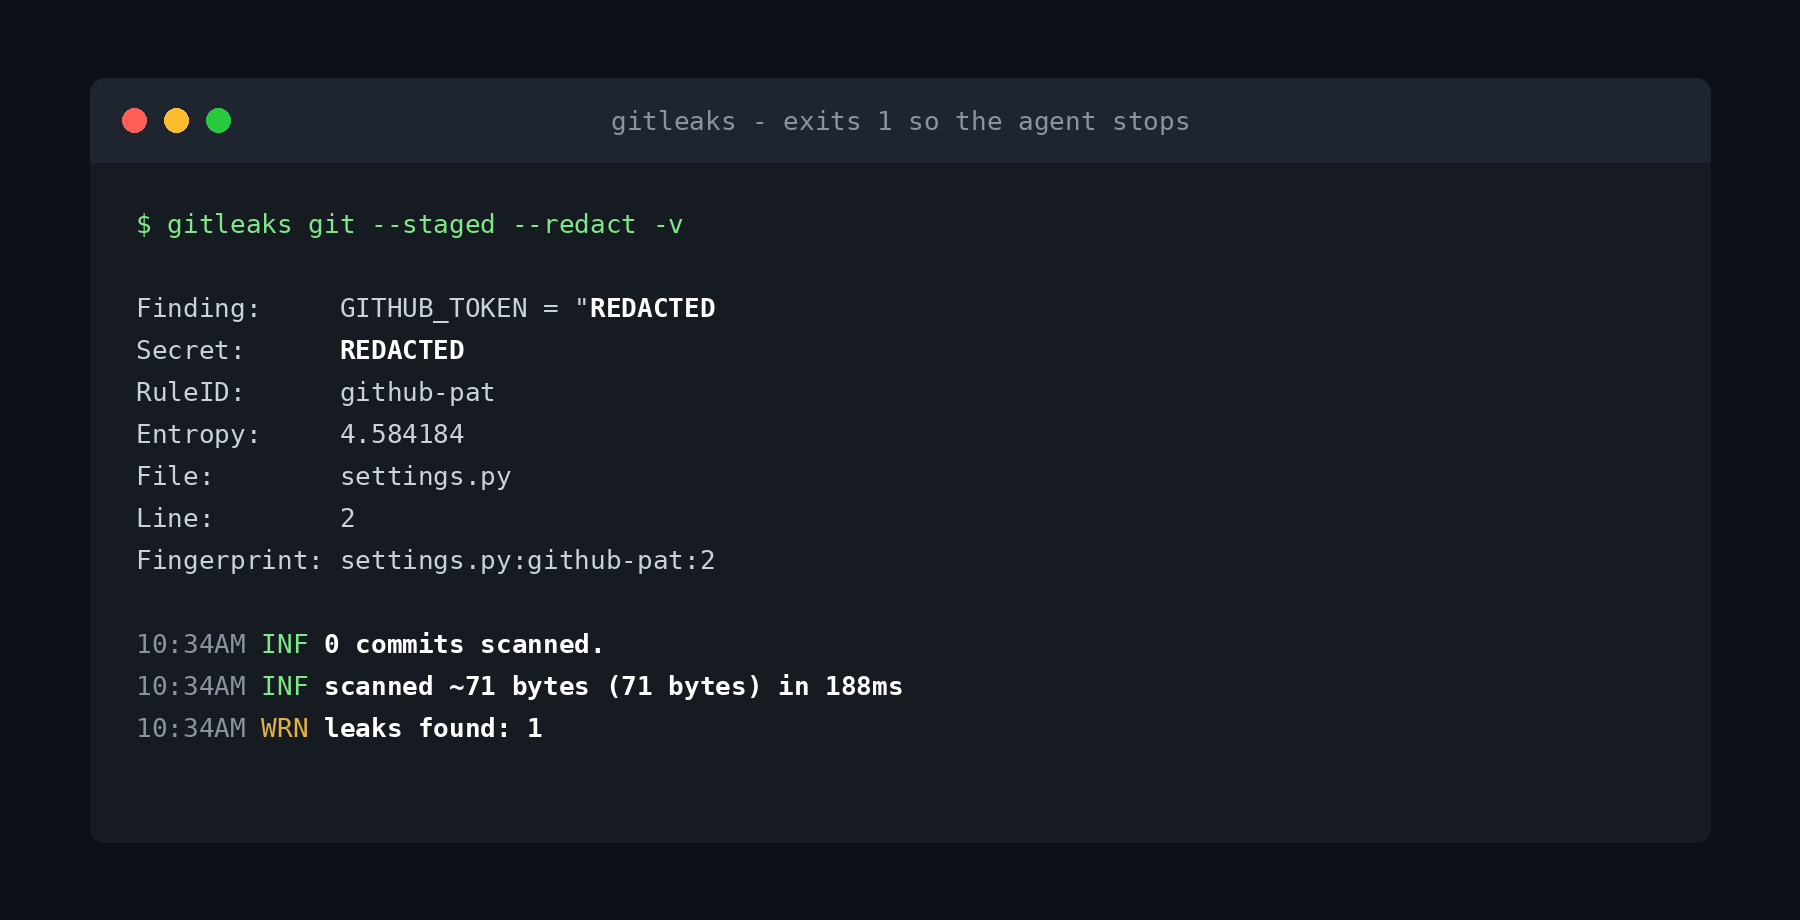
pre-commitフックに組み込むとガードレールが自動になります。エージェントはフックが通るまで繰り返します。これは最初に書き込みをブロックしようとするよりもクリーンです。メンテナンスに関する注意点があります。プロジェクトは現在機能完了と自称しており、将来のリリースはセキュリティパッチに限定されています。作者はBetterleaksという後継者に移行しました。ルールとバイナリは今でも良く機能します。今日インストールして、エコシステムがどこに落ち着くかを注視してください。
10. Firecrawl CLI:知っておく価値のあるもう1つのウェブCLI
Firecrawlはこのリストの最初のツールに最も近い競合相手であり、本当に優れています。そのCLIはscrape、crawl、map、searchをカバーし、AI駆動の抽出のためのagentコマンドも含みます。2つの機能が際立っており、今日のBright Dataには同等のものがありません。firecrawl developerはGitHub Issue、マージされたプルリクエスト、README、ドキュメントサイトのキュレートされたインデックスを検索します。これはコーディングエージェントの最も一般的な質問に一般的なウェブ検索よりも適しています。firecrawl monitorは定期的なスクレイピングをスケジュールし、各結果を最後のスナップショットと比較します。
npm install -g firecrawl-cli
firecrawl init --agent codex                        # CodexにそのスキルをインストールA
firecrawl developer "tokio select cancellation safety"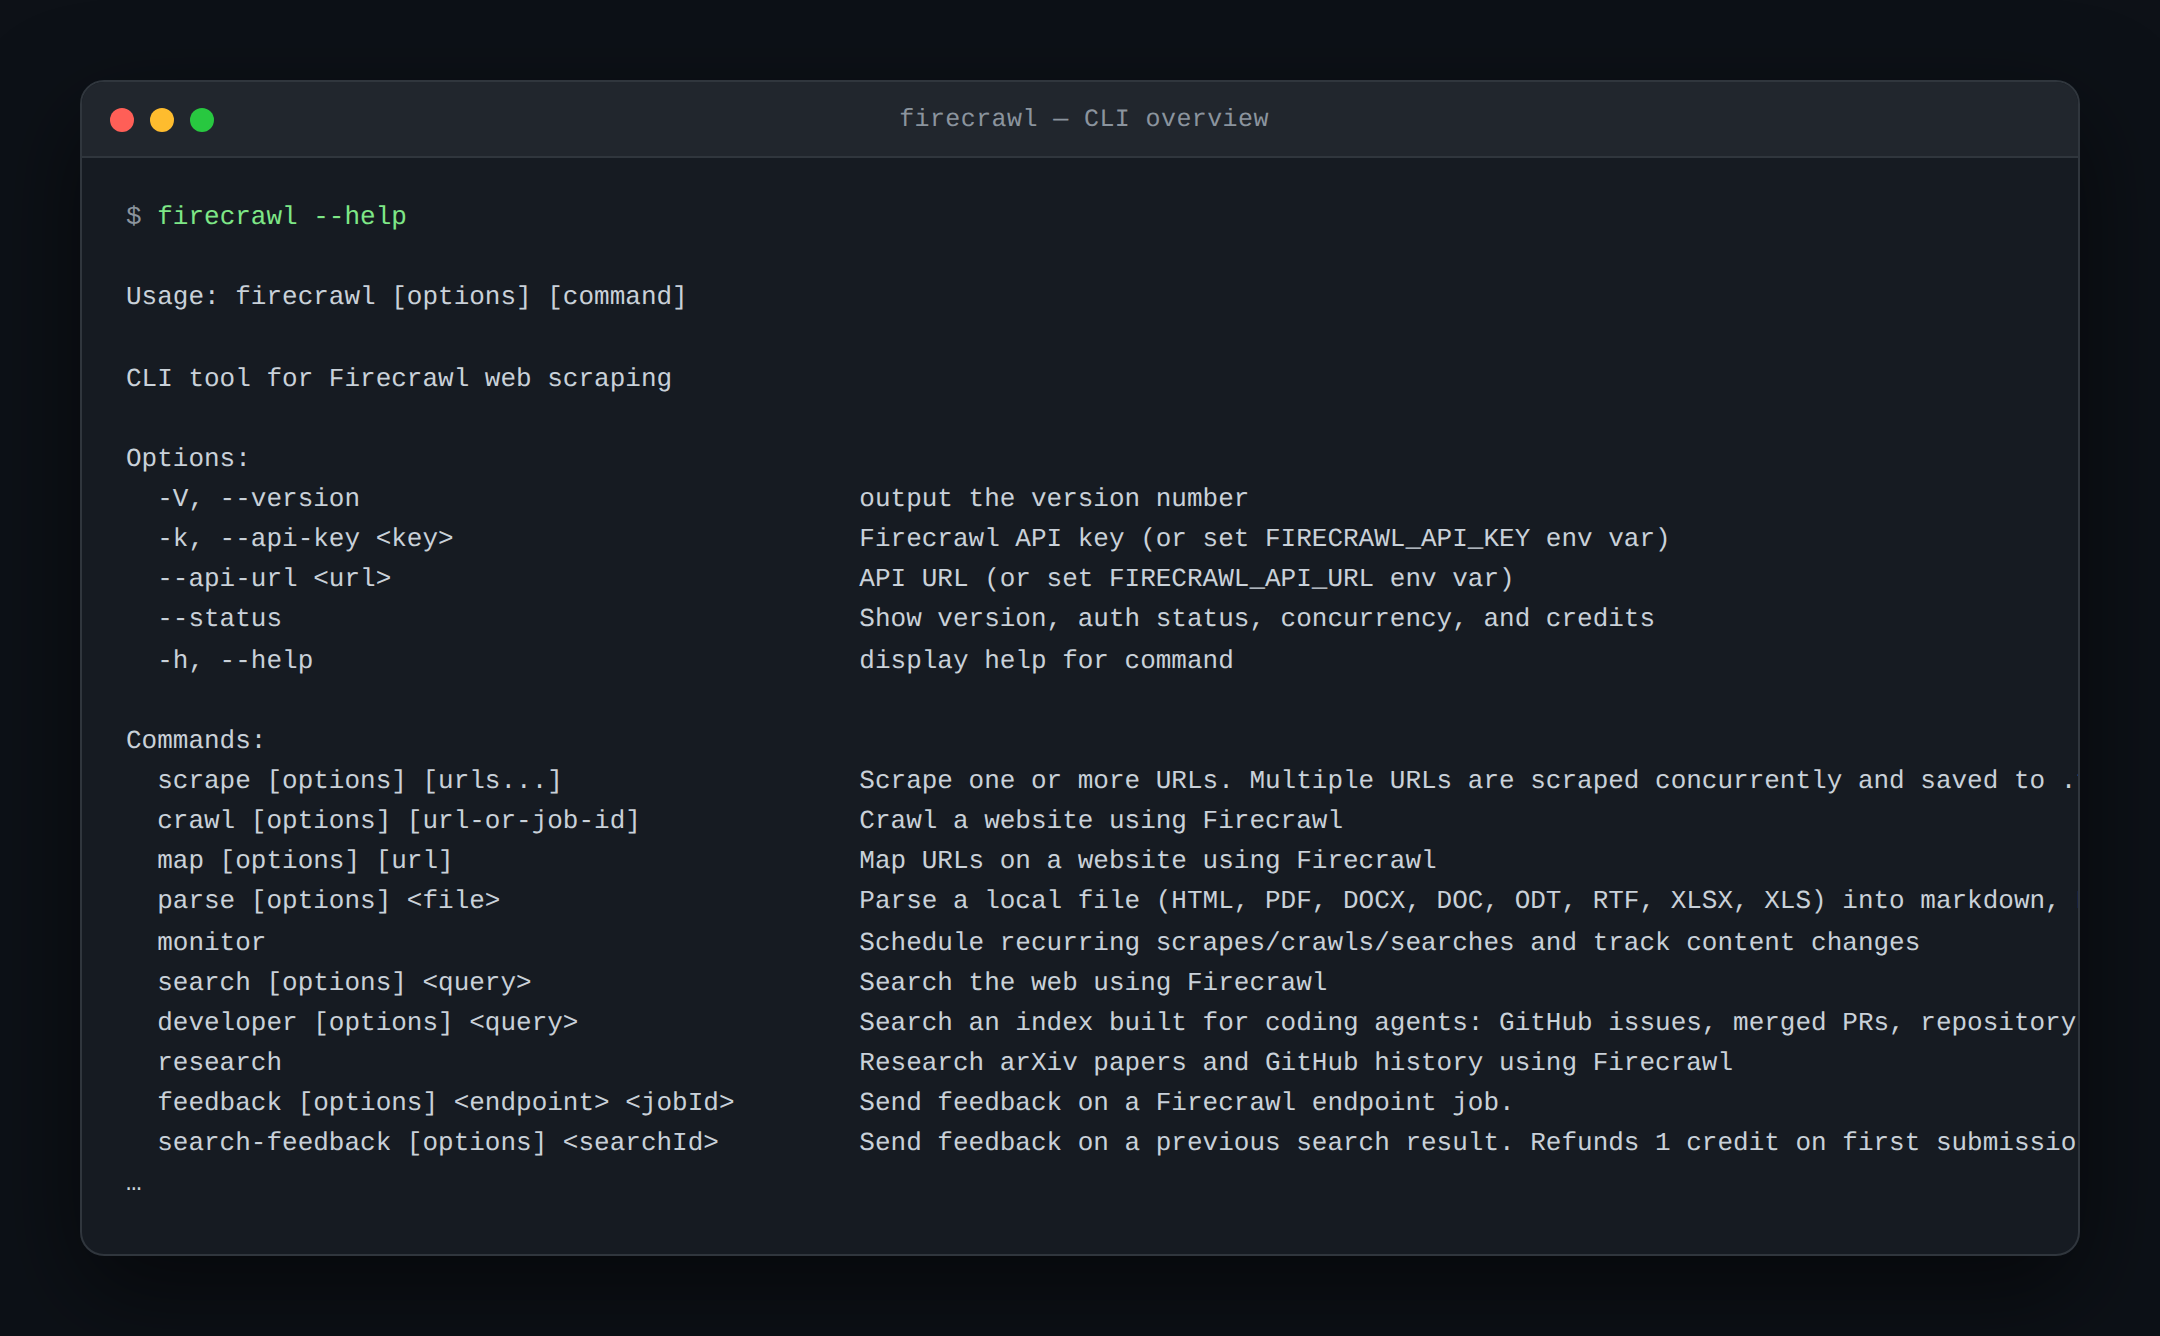
両者が異なるのは取得の深さです。Firecrawlはコーディングエージェントの調査ループ向けに調整されており、Bright Dataは本番データ収集向けに調整されています。AmazonやLinkedInの事前解析済みレコードはBright Data側にのみ存在します。リクエストごとのプロキシゾーンも、サイトのリデザインに耐えるスクレイパーも同様です。多くのチームは両方を実行しています。開発者の調査にはFirecrawlを使用し、大量で持続する必要があるものにはBright Dataを使用します。
インストールすべきでないもの:エージェントが操作できないツール
最も広く共有されているCodexツールベルトは、上記のツールと並んでfzf、bat、eza、zoxide、git-deltaを推奨しています。これらはすべて優れており、いずれもエージェント向けではありません。fzfはキーボードを期待するインタラクティブなファジーピッカーです。batはモデルがプレーンテキストとして読む出力に構文カラーとページングを追加します。ezaとzoxideはCodexが絶対パスでナビゲートするシェルのナビゲーション方法を改善します。git-deltaは人間の目のために美しくdiffをレンダリングし、エージェントはどちらにせよ同じdiffを受け取ります。
同じ理由でlazygitとbtopは除外されます。これらはエージェントがまったくナビゲートできないフルスクリーンインターフェースを描画します。--yesフラグなしに確認を求めるものも同様に除外されます。自分の出力をページングするツールも同様です。
違いはTUIが悪いということではありません。エージェントのインターフェースはstdin、stdout、終了コードです。ツールの価値がそのレンダリングにある場合、それはあなたのためのツールです。価値が出力にある場合、それはエージェントのためのツールです。インタラクティブなものは自分のためにインストールしてください。そして、Codexに非インタラクティブな同等品があることを確認してください。例えば、lazygitの横にgit log --onelineを置くなどです。
ツールの存在をCodexに伝える
ツールをインストールしてもエージェントが使用するとは限りません。Codexは環境について推測できることから動作します。広告されていないバイナリは、エージェントが手書きの劣った代替案を書く間、放置されることがよくあります。これを修正するには2つのことが必要です。ツールが存在することを伝え、それを使用するたびにプロンプトが出ないようにします。
最初はリポジトリルートのAGENTS.mdの短いセクションです。すべてのセッションに読み込まれるため、事実に基づいて簡潔に保ちます。各ツールの仕組みではなく、どのジョブにどのツールを優先するかを記述します。
## 利用可能なCLIツール
- `brightdata`: ウェブアクセス。ウェブ検索で取得できないURLやSERPに使用。
- `rg` / `fd`: テキスト検索とファイル検索。grepとfindより優先。
- `ast-grep`: 構造的検索とリファクタリング。コード編集には正規表現より優先。
- `uv`: Python。`uv run`と`uv sync --frozen`を使用し、素のpipは使わない。2番目はルールファイルです。これはCodexがサンドボックス外で確認なしに実行できるものを決定する方法です。ルールはアクティブな設定レイヤーの隣のrules/フォルダ下の.rulesファイルに存在し、通常は~/.codex/rules/default.rulesです。各prefix_rule()はコマンドプレフィックスにマッチし、allow、prompt、またはforbiddenを返します。最も厳格なマッチングルールが勝ち、Codexはファイルを読み込む際にインラインの例を検証します。
# ~/.codex/rules/default.rules
prefix_rule(
    pattern = ["brightdata", ["scrape", "search", "pipelines"]],
    decision = "allow",
    justification = "Bright Dataを通じた読み取り専用ウェブアクセス",
    match = ["brightdata scrape https://example.com", "brightdata search 'rust async'"],
)

prefix_rule(
    pattern = ["gh", "pr", ["view", "list"]],
    decision = "allow",
    justification = "プルリクエストの読み取りは安全;書き込みは引き続きプロンプト",
)ファイルを編集した後にCodexを再起動し、信頼する前に作業を確認してください。codex execpolicy checkは指定されたコマンドの最も厳格な決定を報告し、マッチしたルールの名前を示します。追加するルールごとに1回実行してください。意図よりも広いプレフィックスは書きやすく、気づきにくいです。
codex execpolicy check --pretty \
  --rules ~/.codex/rules/default.rules \
  -- brightdata scrape https://example.com
よくある質問
これらのCLIツールがあればCodex向けMCPサーバーは必要ですか?
多くの場合、不要です。MCPサーバーのツールスキーマはセッション全体でコンテキストウィンドウに存在します。シェルを通じて呼び出されるCLIは実行されるまで何もコストがかかりません。大きなコマンドサーフェスを持つツールには、CLIとAGENTS.mdの1行が通常より安価な選択肢です。MCPは型付きツールコールが必要な場合や、サービスにCLIがまったくない場合に依然として優れています。
Codex向けCLIツールのリストで有料ツールが1位にランクされているのはなぜですか?
Codexが持っていない機能を追加する唯一のエントリだからです。他のすべては既存の機能を高速化するだけです。サンドボックスはデフォルトでネットワークアクセスをオフにします。組み込みの検索はページをライブで取得するのではなく、キャッシュされたインデックスから回答します。ボット保護されたサイトへのアクセスにはプロキシインフラが必要で、無料ツールでは提供されません。無料ティアはカード不要で月5,000クレジットです。
これらのCLIツールをインストールするとCodexが遅くなりますか?
いいえ。ここにあるものは何も起動時に読み込まれません。各ツールはエージェントが実行するときにのみ呼び出されます。ほとんどはタスクが必要とするターン数を減らすために特別に存在します。
Codex向けCLIツールの最小限の有用なセットは何ですか?
3つだけ欲しい場合はripgrep、gh、jqです。ripgrepはすでにエージェント自身のプロンプトで想定されており、jqはcodex exec --jsonを読む方法です。Codexがページを取得できないためにタスクが停止した最初の時にBright Data CLIを追加してください。
新しいツールを実行するたびにCodexが承認を求めるのを止めるにはどうすればいいですか?
~/.codex/rules/下の.rulesファイルにprefix_rule()エントリを追加してください。信頼するコマンドプレフィックスにdecisionをallowに設定します。依存する前にcodex execpolicy checkで確認してください。ネットワークを必要とするツールには、sandbox_workspace_writeの下にnetwork_accessも設定し、ドメイン許可リストでトラフィックをスコープしてください。
これらのCLIツールはClaude Code、Cursor、Gemini CLIでも動作しますか?
はい。リストされているすべてのツールはCodex固有の依存関係のない標準的なコマンドラインバイナリです。Bright DataとFirecrawlのインストーラーはどちらも複数のコーディングエージェントを検出するため、同じセットアップが複数のハーネスで機能します。