私たちはCC-MAIN-2026-30のCommon Crawlインデックスでtheguardian.comを照会し、185件のレコードを取得しました。コンテンツとなる記事は1件もありません。すべてのレコードはサイト自身のrobots.txtまたはそこへのリダイレクトであり、そのファイルはCCBotを拒否しています。クロールが保持しているのはパーミッションチェックのみです。
Internet ArchiveのWayback MachineとCommon Crawlはどちらも現存しないページのコピーを保持していますが、異なる問いに答えます。Wayback Machineは指定した日付における単一URLを再現します。Common Crawlはリプレイなしで数十億ページをバルクテキストとして提供します。ウェブアーカイブとは両者が属するカテゴリーであり、第三のサービスではありません。同カテゴリーには国立ウェブアーカイブ、Archive-Itなどのサブスクリプションサービス、archive.todayのようなオンデマンドキャプチャサイト、自作のWARCファイルも含まれます。両サービスは過去に関する問いに答えるものであり、指定したサイト群を継続的に収集するものではありません。
TL;DR
- CCBotはJavaScriptを実行しません。クライアントレンダリングのページはシェルとして届きます。
- バルク作業にはCommon Crawlを先に照会し、ミスにはWaybackを使います。既知のURLリストがある場合は逆順で。
- CDXの
digestはペイロードのSHA-1なので、フェッチ前にインデックスでcollapse=digestとcollapse=timestampの差分を取れます。Common Crawlはcollapseを無視します。 - Wayback CDXクライアントは毎分24リクエストで設計してください。共有プールの30/分の80%です。
- どちらもカバレッジ保証やSLAを公表しておらず、指定サイト群を継続収集しません。まず自分のドメインを計測してください。
What the Internet Archive and Common Crawl each store
Waybackのキャプチャはweb.archive.org/web/<timestamp>/<url>としてアドレス指定でき、同一URLが30年にわたって数千件のキャプチャを持つことがあります。デフォルトのリプレイはリンクを書き換えてツールバーを挿入するため、ブラウザでページが表示されます。
Common Crawlの月次クロールはWARCファイル群と派生テキスト・メタデータファイル群のセットであり、公開バケットに公開されています。インデックスはどのファイルのどのバイト範囲に特定URLが含まれるかを示します。
| Wayback Machine | Common Crawl | |
|---|---|---|
| 保存内容 | 個別URLの時系列キャプチャ | 月次クロール全体(WARCと派生テキスト) |
| 答える問い | 1つのURLを複数の日付で | 1つのクロール日付から多数のURL |
| リプレイ | あり(リンク書き換えとツールバー挿入) | なし |
| 全文検索 | なし | なし(ただしWETファイルでテキストをインデックス化可能) |
| バルクエクスポート | なし(APIアクセスのみ) | クロール全体を公開バケットで無料提供 |
| レート制限 | 毎分30リクエスト(CDXとtimemapで共有)Internet Archiveは非公開 | 非公開、「大幅に制限あり」 |
| カバレッジ保証 | なし | なし(ドメインランクでサンプリング) |
CC-MAIN-2026-30は21億4千万ページ、40.5百万ホストにわたる364TiBの非圧縮コンテンツとして発表されており、18日間でクロールされました。Common Crawlはコーパス全体を3千億ページ超と説明し、月に30〜50億ページの新規ページを追加するとしていますが、直近18件のクロールはすべて30億ページ未満です。ジョブのサイジングは単一クロールから行ってください。
Common CrawlのFAQには「現在、JavaScriptは実行されず、Cookieも使用されない」と記されています。CCBotは生のHTTPレスポンスを保存するため、クライアントレンダリングのページはシェルとして届きます。対象ページがブラウザでコンテンツを生成する場合、Common Crawlを前提とした計画を立てる前に1件のキャプチャを確認してください。
各クロールは10万ファイルずつ5つの並列ファイルセットで構成されます。WARCはフルレスポンスを、WATは抽出メタデータとリンクを、WETはプレーンテキストのみを、残り2つはrobots.txtキャプチャと非200レスポンスを格納します。WARCを読むリンクグラフジョブは必要以上に大量のバイトを転送します。
Common Crawlはページの再訪問を約束しないため、多数のURLを多数の日付で取得することはどちらのサービスも答えられない問いです。
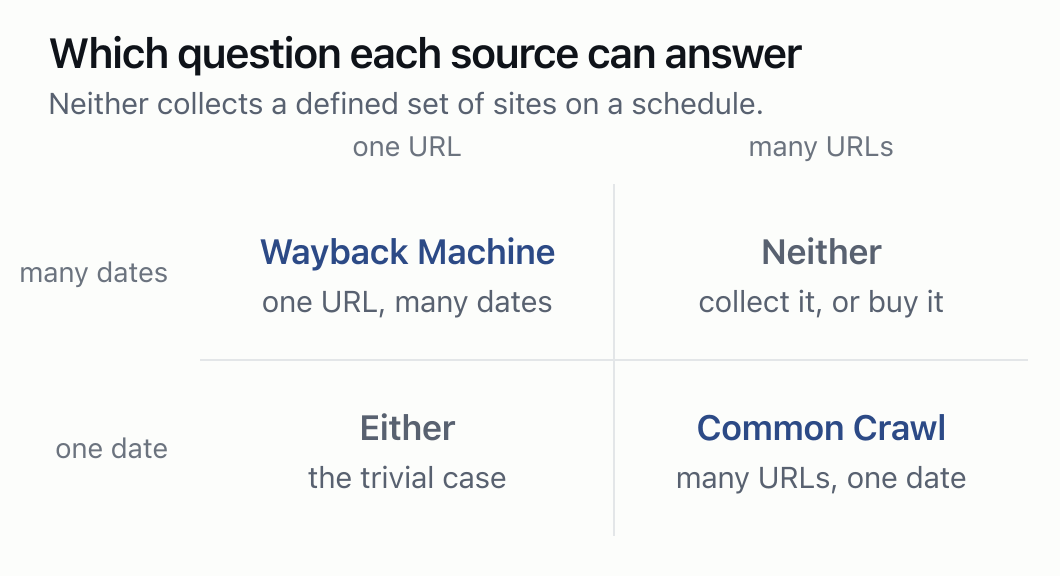
Common CrawlのFAQにはサンプリングポリシーが明記されています。データセットは「ウェブのサンプルであり、特定のウェブサイト全体をアーカイブするのではなく、ランダムに選択されたサブセットを対象とする」とされています。そのメカニズムはFAQではなくCommon Crawlのエンジニアリング講演で解説されています。ドメインレベルの調和中心性ランクが各ドメインのURL取得予算を決定するため、リンクが多いドメインは大きな予算を得て、低ランクのドメインは予算ゼロになる場合があります。
Wayback Machineにはアーカイブされたページコンテンツの全文検索機能がありません。Internet Archiveのヘルプページには「将来的に全文検索エンジンの実装を希望している」と記されています。サイト検索はサイトメタデータに一致するもので、アーカイブページ内のテキストは対象外です。Common Crawlはテキストを提供しますがリプレイはないため、WETファイルから再構成したページは元のページとは異なります。
What a domain lookup returns
プレフィックスマッチングを使って5つのドメインに対して同じクエリを実行しました。
| 照会したドメイン | インデックスレコード数 | robots.txtレコード数 |
コンテンツページ数 |
|---|---|---|---|
nytimes.com/* |
1 | 1 | 0 |
cnn.com/* |
1 | 1 | 0 |
bbc.com/* |
2 | 2 | 0 |
theguardian.com/* |
185 | 185 | 0 |
github.blog/* |
4,700 | 49 | 4,651 |
The Guardianの185件のレコードはrobots.txtとそのhttpリダイレクトという2つのURLのみに解決され、クロール中に再フェッチされています。インデックスレコード数を数えるスクリプトは5つすべてをカバー済みと判定しますが、4つについては誤りです。github.blogの4,651件のコンテンツレコードのうち、3,647件が200を返しました。
マッチタイプによって結果が変わります。SURTの正規化はwww.をベアホストに折り畳みますが、domain/*プレフィックスマッチは他のサブドメインには届きません。cnn.com/*は1件を返し、*.cnn.comは11件を返しました。nytimes.com/*は1件、*.nytimes.comは2件です。どちらの形式でもすべてのレコードはrobots.txtフェッチでしたが、件数はクロールの性質と同様にクエリの性質でもあります。この種の数値を報告する際は必ずマッチタイプも明記してください。
古いクロールIDに対して同じクエリを実行すると、ブロックのおおよその時期を特定できます。このクエリには盲点があります。robots.txtに書かれた内容は見えますが、ネットワークエッジで適用されたブロックや後からのオプトアウトは見えないため、件数ではなくフロアとして読む必要があります。エージェントグループの解決方法についてはスクレイピング向けrobots.txtガイドをご覧ください。
クロールごとのサイズも縮小しています。Common Crawlの公開クロールサイズ統計によると、月次ページ数はCC-MAIN-2025-05の30億3,100万からCC-MAIN-2026-30の21億4,900万へと29.1%減少しています。CC-MAIN-2024-10からCC-MAIN-2026-30までの29クロールを通じて、2024年の10クロールの平均は26億9千万ページ、2025年の12クロールは25億3千万ページ、2026年7月までに公開された7クロールは21億5千万ページです。
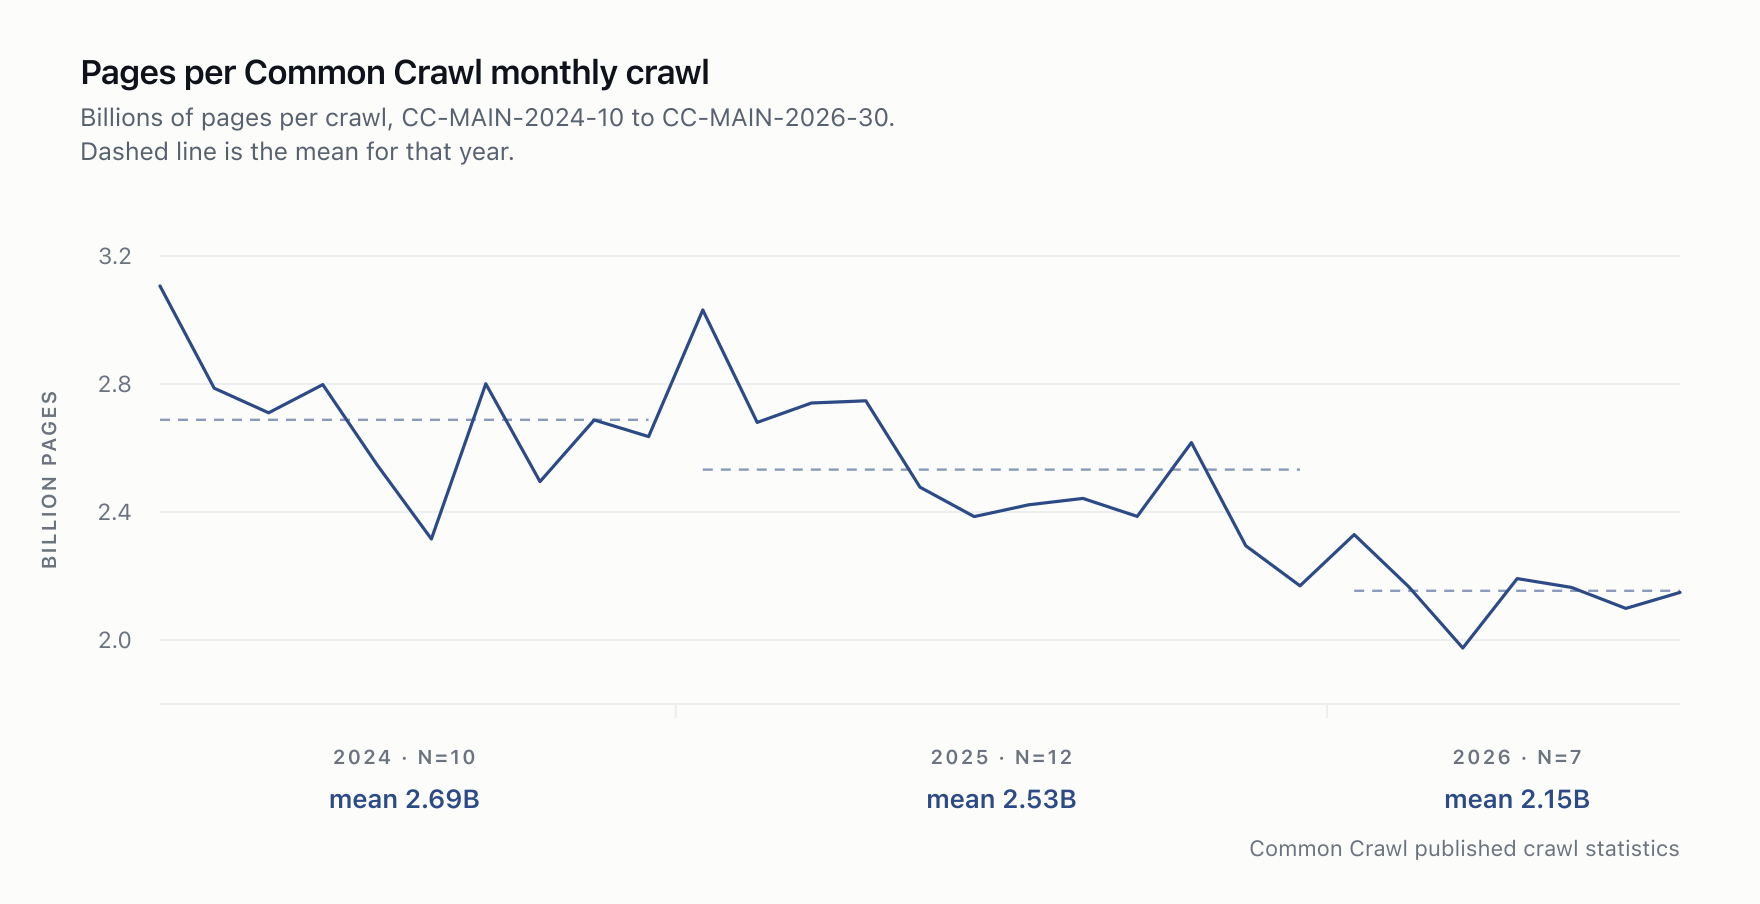
ここでは原因を特定していません。クロールサイズはCommon Crawl内部のインフラ、予算、スケジューリングによって動くのと同程度に、パブリッシャーの行動によっても変動します。この減少は、2024年のクロールを基にサイジングしたコーパスが2026年のものを約4分の1過大評価することを意味します。また、クロールごとの件数は加算できません。連続するクロールは同じフロンティアの多くを再フェッチするため、urlkeyとdigestで重複排除せずに合算すると推定値がさらに膨らみます。
Check your own domains
このスクリプトは最新の公開クロールに対して、テーブルと同じdomain/*プレフィックスマッチを使い、robots.txtフェッチに対するコンテンツレコード数を集計します。インデックスを1ページずつ走査し、切り捨てによりレコードが分割されたページを除外し、ドメインが一度もクリーンに応答しなくても処理を続けます。以下の2ドメインは約70秒かかり、そのほぼすべてが意図的なスリープです。
import http.client, json, time, urllib.error, urllib.parse, urllib.request

DOMAINS = ["theguardian.com", "github.blog"]
# Use your own contact address. One shared UA string arriving from many callers
# is the string an operator blocks.
UA = {"User-Agent": "coverage-check/1.0 ([email protected])"}

def latest_crawl():
    """Common Crawl ships roughly monthly. Hardcoding an ID measures a stale crawl
    and returns a number that looks current."""
    url = "https://index.commoncrawl.org/collinfo.json"
    info = urllib.request.urlopen(urllib.request.Request(url, headers=UA), timeout=60).read()
    return json.loads(info)[0]["id"]        # newest first

CRAWL = latest_crawl()
INDEX = f"https://index.commoncrawl.org/{CRAWL}-index"
print(f"crawl: {CRAWL}")

def fetch(params, tries=3):
    url = f"{INDEX}?{urllib.parse.urlencode(params)}"
    for attempt in range(tries):
        wait = None
        try:
            return urllib.request.urlopen(
                urllib.request.Request(url, headers=UA), timeout=120).read()
        except urllib.error.HTTPError as e:
            if e.code == 404:
                return None               # this crawl never captured the domain
            if e.code not in (429, 500, 502, 503, 504):
                raise
            wait = e.headers.get("Retry-After")   # the server's own number beats ours
        except (urllib.error.URLError, http.client.IncompleteRead, TimeoutError):
            pass                          # dropped connection
        time.sleep(int(wait) if wait and wait.isdigit() else 5 * 2 ** attempt)
    return b""

def coverage(domain):
    """(robots, content) for one domain, or None if the index never answered cleanly."""
    query = {"url": f"{domain}/*", "output": "json", "pageSize": 1}
    head = fetch({**query, "showNumPages": "true"})
    if head is None:
        return 0, 0
    if not head:
        return None
    robots = content = 0
    for page in range(json.loads(head)["pages"]):
        body = fetch({**query, "page": page})
        if not body:
            return None
        # CDXJ is one JSON object per line. Use split, not splitlines(): splitlines()
        # breaks on several characters that are not newlines, which cuts records in half.
        for line in body.split(b"\n"):
            if not line.strip():
                continue
            try:
                record = json.loads(line)
            except json.JSONDecodeError:
                return None               # the page arrived incomplete
            if record.get("url", "").rstrip("/").endswith("/robots.txt"):
                robots += 1
            else:
                content += 1
        time.sleep(5)
    return robots, content

for domain in DOMAINS:
    result = coverage(domain)
    if result is None:
        print(f"{domain}: no clean response")
    else:
        robots, content = result
        print(f"{domain}: {robots + content} records, {robots} robots.txt, {content} content")
    time.sleep(20)
出力結果:
crawl: CC-MAIN-2026-30
theguardian.com: 185 records, 185 robots.txt, 0 content
github.blog: 4700 records, 49 robots.txt, 4651 contentCC-MAIN-2026-30に対して実行すると、2つのドメイン行は上記テーブルを再現します。新しいクロールでは件数が異なります。維持されるべきは形状、つまりtheguardian.comはrobots.txtのみ、github.blogはコンテンツありという傾向です。コンテンツページのないレコードは、そのドメインのページコンテンツがクロールに含まれていないことを意味します。
How to query each source, and what the round trip costs
両サービスともCDXインデックスを公開していますが、レスポンス形式が異なります。Wayback CDXサーバーはJSON配列の配列を返し、Common Crawlのoutput=jsonはCDXJ(1行1JSONオブジェクト)を返します。
Wayback CDXサーバーはキャプチャごとに1行を返します。サーバーサイドでフィルタリングすることでレスポンスをページング可能なサイズに抑えられます。
curl "https://web.archive.org/cdx/search/cdx?url=example.com&output=json&from=2026&limit=3&fl=timestamp,original,statuscode"返される結果:
[["timestamp","original","statuscode"],
["20260101000936","http://www.example.com/","200"],
["20260101002937","https://example.com/","200"],
["20260101004445","https://example.com/","200"]]レンダリングではなくアーカイブページをパースするには、生のキャプチャをリクエストします。タイムスタンプの後にid_を追加すると、ツールバーなし・リンク書き換えなしの元のバイト列が返されます。
curl -sL "https://web.archive.org/web/2026id_/https://example.com/" -o raw.html
curl -sL "https://web.archive.org/web/2026/https://example.com/" -o rewritten.html書き換えられたコピーにはweb.archive.orgへの参照が注入されており、DOM構造を基点とするセレクターが壊れる場合があります。
マッチタイプに加え、CDX行の2つのフィールドと1つのクエリパラメータが、クエリの一致内容、変更検出の可否、コストを決定します。
urlkeyはURLのSURT形式です。https://github.blog/はblog,github)/としてインデックス化されます(ホストを逆順にしてパスを続けます)。プレフィックスおよびレンジクエリは入力したURLではなくそのキーで動作するため、www.の扱いとクエリ文字列の順序がクエリの一致に影響します。
digestはbase32エンコードされたペイロードのSHA-1であり、WARCレコードがWARC-Payload-Digestとして保持する値です。16進数のダイジェストとは一致しません。したがって変更検出はインデックス操作です。同じダイジェストを持つ2行は同じペイロードバイトを持ちます。
collapseはそれを実際に必要なクエリに変換します。Wayback CDXサーバーに2024年のすべてのexample.comキャプチャを要求すると130,115行が返されます。同じクエリにcollapse=timestamp:8を追加すると366行(1日1件)になります。タイムスタンプはYYYYMMDDhhmmss形式なので、8桁に切り詰めると日付で折り畳まれます。collapse=digestでは17,448行(隣接するキャプチャ間の変更ごとに1件)になります。Common Crawlのインデックスはこのパラメータを受け付けますが無視し、どちらの場合も同じ行を返します。
pageとpageSizeによるページネーションは結果行数ではなくインデックスブロック数をカウントします。ブロックサイズは変動します。あるクエリで隣接する2つのブロックはそれぞれ2,032件と4,726件のレコードを返しました。Wayback CDXサーバーにmatchType=domainとpageSize=1でbbc.comを照会すると28,257ページと報告されました。
フィルターがそのブロック内で何にも一致しなかった場合、ページは空で返ることがあります。これは結果セットが終了したことを意味しません。デフォルトのpageSizeは1であり、ドキュメントには最大値が記載されていません。
Common Crawlのインデックスも同様にページネーションしますが、3つの違いがあります。showNumPagesは裸の数値ではなくJSONを返し、デフォルトのpageSizeは1ではなく5であり、ブロックサイズが異なります。ループのサイズは想定のブロックサイズではなくshowNumPagesから決定し、使用するpageSizeでページ数を取得してください。件数はそれによって変わります。
イテレーションには2つの方法があります。デフォルトはリミットモードで、limitと再開キーで結果セットを走査します。ページドモードは代わりにpageとpageSizeを使用します。ページドモードはページ数を事前に把握でき、ワーカーへの分散が可能なために存在します。リミットモードは通常リクエスト数が少なくなりますが、広い日付範囲でキャプチャが少ないURLではタイムアウトするほどスキャンが長くなることがあります。
Common Crawlはフェッチステップを逆転させます。1ページの取得がファイルダウンロードではなく単一のレンジリクエストで完結するのが利点です。インデックスはファイル名、バイトオフセット、長さを提供するため、HTTPレンジリクエストで1レコードだけ取得できます。CDXJは1行1オブジェクトなので、以下のコードはボディ全体をパースせずに1行だけ読みます。
import gzip, json, urllib.error, urllib.parse, urllib.request

url = "https://example.com/"
crawl = "CC-MAIN-2026-30"
q = urllib.parse.quote(url, safe="")

# Common Crawl asks API clients for a properly formed UserAgent. Use your own.
ua = {"User-Agent": "coverage-check/1.0 ([email protected])"}

# Step 1: ask the index which WARC file and byte range holds this page.
index = f"https://index.commoncrawl.org/{crawl}-index?url={q}&output=json&limit=1"
try:
    req = urllib.request.Request(index, headers=ua)
    rec = json.loads(urllib.request.urlopen(req, timeout=60).read().split(b"\n")[0])
except urllib.error.HTTPError as e:
    if e.code != 404:
        # 502, 503 and 504 all mean try again later, not "not captured".
        # Treating them as a miss under-reports coverage.
        raise
    # A URL this crawl never captured returns 404. That is the normal case for a
    # blocked domain, not an error in your code.
    raise SystemExit(f"{url} is not in {crawl}")

# Step 2: fetch only those bytes.
offset, length = int(rec["offset"]), int(rec["length"])
warc = "https://data.commoncrawl.org/" + rec["filename"]
req = urllib.request.Request(warc, headers={**ua, "Range": f"bytes={offset}-{offset + length - 1}"})
record = gzip.decompress(urllib.request.urlopen(req, timeout=60).read())

print(record.decode("utf-8", "replace")[:400])
返されるのはレスポンスヘッダーとページHTMLを含む1つのgzip圧縮WARCレコードです。サンプリングした29件のコンテンツレコードでは、圧縮サイズは7〜45KiBで、約900MiBのファイルからキロバイト単位のデータをレンジリクエストで取得します。同じパスはインデックスサーバーが一覧表示するどのクロールに対しても機能します。
コーパス規模の作業には、Common CrawlのURL IndexがParquet形式で同じインデックスを追加カラム付きで提供しており、s3://commoncrawl/cc-index/table/cc-main/warc/に公開されています。ローカルではDuckDB、AWS上ではAthenaで照会できます。Common Crawlは列指向インデックスを月次クロールあたり約300GBと説明し、2025年9月時点のAthenaフルスキャンコストは約1.50ドルなので、フィルタリングされたほとんどのクエリはそれ以下です。データアクセス自体はAWS Open Dataプログラムで無料であり、data.commoncrawl.orgはAWSアカウント不要ですが、自社クラウドプロバイダーからのエグレスは自己負担です。
Rate limits and quotas you will hit
Common CrawlのFAQによると、CDXエンドポイントは「頻繁に悪用されるため、大幅にレート制限されている」とのことです。HTTP 503はスローダウンを意味し、一時的にブロックされたIPは24時間待つ必要があります。ガイダンスでは、呼び出し間のスリープ、1つのIPからの複数スレッドの回避、プロキシネットワークの回避、RFC 9110に準拠した適切なUser-Agentの送信も求めています。プロキシの条項は注目に値します。FAQのブロックとスレッドのガイダンスはどちらもIPを対象としているため、より多くのアドレスにジョブを分散させると制限を回避することになり、エスカレーションは追加の503ではなくアドレスのブロックです。
Internet ArchiveはSave Page Nowのクォータを公開していますが、読み取りAPIについてはほぼ何も公開していません。Save Page Now 2の仕様には以下の制限が記載されています。
| 制限 | 認証済み | 匿名 |
|---|---|---|
| 1分あたりのキャプチャ数 | 7 | 3 |
| 1日あたりのキャプチャ数 | 30,000 | 200 |
| 1日あたりのアーカイブバイト数 | 5 GB | 2 GB |
| 同一URLの1日あたりのキャプチャ数 | 5 | 5 |
仕様にはこれらの数値を超える有料プランの記載はなく、より多くの利用者はInternet Archiveへのメールを案内しています。仕様では匿名の上限を2GBと500MBの両方で記載しており、変更履歴では認証済みの上限を4GiBに引き下げていますが、テーブルにはまだ5GBと記載されています。
読み取りAPIについては、Internet Archive外部の情報があります。wayback PythonクライアントのメンテナーがInternet Archiveスタッフとの会話をまとめ、その結果をライブラリのデフォルトとしてコード化しました。この記録はInternet Archiveの公式発表ではありません。
/cdx/search/cdxと/web/timemap/エンドポイントは現在、outputパラメータの読み取り方のみが異なる同一サーバー上の1つのサービスであり、単一のレート制限プールを共有しています。そのプールは両方合わせて毎分30リクエストです。カウンターがアドレスとアカウントのどちらをキーとするかは記載がないため、複数のワーカーに分散しても予算が倍増するとは想定できません。mementoエンドポイントはリプレイを提供し、別のプールから使用します。
ライブラリはそれらの制限をデフォルト値としてコード化しています。CDXは0.8 * 30 / 60、リプレイは0.8 * 600 / 60です。Internet Archiveスタッフからクライアントはハード制限の80%で動作するよう求められたためです。つまりCDXは毎分30ではなく24リクエスト、リプレイは480リクエストです。上限ではなくこれらの値を設計の基準にしてください。
archive.org/wayback/availableの可用性エンドポイントは独自の公開制限を持たない第三のサービスなので、無制限ではなく制限ありとして扱ってください。レスポンスにRetry-Afterが含まれる場合はそれを守ってください。含まれない場合、waybackクライアントは再試行前に60秒間一時停止します。
Why archive.today captures cannot be verified on their own
archive.todayはキャプチャ時にブラウザでページをレンダリングし、robots.txtを無視するため、Wayback Machineが保持しないページを保有しています。引用ワークフローはそのカバレッジのためにarchive.todayを採用しました。
archive.todayはWARCではなく変更可能なHTMLを保存するため、ペイロードダイジェストがなく、キャプチャ内部でそれを検証する手段もありません。運営者がアーカイブページを改ざんしたという証拠が提示され、Wikipediaはこのサイトを廃止してスパムブラックリストに追加しました。閉会声明は別の理由を主に挙げています。サイトが訪問者のブラウザをブログへのサービス拒否攻撃に利用するコードを埋め込んでいたとし、改ざんされたスナップショットを追加事項として扱っています。
archive.todayからすでに引用しているものはすべて第二のソースで再検証してください。同じページには、2026年6月時点でも低い呼び出し頻度でコードが存在し続けていると記録されており、サイトを利用する必要がある場合はコンテンツブロッカーを介してロードするよう案内しています。
National archives, formats, and replay tools
Arquivo.pt:ポルトガルの国立ウェブアーカイブはWayback Machineが持たない全文検索APIを運用しています。arquivo.pt/textsearchへのGETリクエストは結果ごとにlinkToExtractedTextを含むJSONを返すため、HTMLパースを省略できます。APIは無料でキー不要、記載されている制限は1つのIPから60秒あたり250リクエストで、全文検索とURL検索で別々に予算化されず共有されます。この制限を超えると永続的なブロックの対象となりますが、Common Crawlのブロックは一時的です。カバレッジはポルトガル語中心で、レイテンシは3件のシングル結果クエリで3秒未満から18秒まで不均一なため、クライアントのタイムアウトは30秒に設定してください。
WARCとWACZ:WARCはアーカイブコンテナで、WARC 1.1を対象とするISO 28500:2017として標準化されています。WARC 1.2は存在しません。WACZはWARCレコードをCDXインデックスと一緒にパッケージ化し、サーバーなしでブラウザ上でリプレイできます。1.2.0ドラフトは公開されていますが、wacz/latestは依然として1.1.1を提供しているため、1.1.1に対して実装してください。
Browsertrix:自分でコントロールできるキャプチャが必要な場合、WebrecorderのクローラーはWACZファイルを生成し、サーバーなしでReplayWeb.pageを通じてブラウザ上でリプレイできます。ホスト型プランはエントリープランが月額30ドルから始まり、クローラーは自分で実行したい場合はオープンソースです。
How to choose
問いの形状から始めてください。特定のURL、バルクテキスト、またはどちらのサービスも提供しないプロパティのいずれかです。
URLと日付が重要な場合はWayback Machineを使用してください。削除されたページの復元、編集前にサイトが何を言っていたかの証明、特定の商品ページの経時追跡、廃止されたドキュメントセットの再構築などに適しています。個別URLの時間的深度においては他の汎用オプションに匹敵するものはありませんが、国立アーカイブはその範囲内で同等になれます。
証拠としての用途の場合は、キャプチャ以上のコストを見込んでください。米国の裁判所はWaybackのキャプチャを認めていますが、プリントアウト単体では自己証明にならないため十分でないことが多いです。裁判所が認めてきた方法はInternet Archiveの宣誓供述書であり、2025年初頭に公開された料金ではリクエストごとに250ドル、URLごとに20ドル、またはPDFなどのダウンロード可能なファイルを含むURLは30ドルです。
多数のページが必要でどれでも構わない場合はCommon Crawlを使用してください。言語コーパス、モデルの事前学習、リンクグラフ分析、多数のホストにわたるセキュリティ研究、ランク偏重サンプルで許容できる測定など。C4、RefinedWeb、FineWeb、Dolmaを含む大規模な公開事前学習コーパスのほとんどがCommon Crawlを利用しています。生のクロールではなくコーパスが必要な場合は、これらの派生物とそのライセンスを先に確認することをお勧めします。LLMトレーニングデータソースの調査も参考にしてください。サンプリングポリシーによりカバレッジが予測不能なため、特定サイトのカバレッジ保証には使用しないでください。
Sichang Steven Heらによる研究では、Common Crawlの約10万サイトを分類し、そのうち6.0%がほとんど人間の入力なしに生成されたテキストに支配されていることを発見しました。2025年前半に初めて確認されたサイトでは、その割合は29.4%で、2022年後半に初めて確認されたサイトの2.1%から上昇しています。
6.0%と29.4%は過小評価の可能性が高いです。著者らは分類器の精度とサイトを生成したモデルのベンチマークスコアとの間に強い負の相関を報告しており、生成器が改善するにつれて分類器が見逃す割合が増加します。
どちらのサービスも提供しないプロパティが必要な場合は国立アーカイブまたは自己運営アーカイブを使用してください。アーカイブコンテンツの全文検索、エンドツーエンドでコントロールできるキャプチャ、他では再現が難しいクライアントレンダリングページなどに適しています。
archive.todayは別の理由で除外されています。事後に変更できるキャプチャは単独では証拠として成立しません。
多数のホストにわたるバルク作業には、まずCommon Crawlで幅広さとコストを優先し、クロールが見逃したものはWayback Machineで補完してください。既知のURLリストの場合は逆順で。Common Crawlの照会のほとんどはミスになり、すべての照会がインデックスに対してリクエストを消費します。そのインデックスの過剰使用に対するペナルティは24時間のブロックです。また、長期的に重要なドメインがある場合は、並行してWARCを生成するクローラーで自前のキャプチャを取ってください。それが可用性をコントロールできるコピーになります。
自前のクローラーを運用するにはストレージ、リプレイインフラ、どちらの公開サービスも請求しないメンテナンス負担がかかります。アクセスを失うと何かが壊れる場所では自前で運用し、残りは公開アーカイブや購入したコレクションを活用してください。
When you need collection instead of an archive
どちらのサービスも定義されたサイト群をスケジュールに従って収集するために構築されていません。Save Page Nowはオンデマンドで収集しており、認証済みで毎分7キャプチャ、未認証では3キャプチャで動作します。
照会した4つのニュースドメインはすべてCC-MAIN-2026-30にコンテンツページがありませんでした。どちらもカバレッジ保証、SLA、エスカレーションできるサポートコミットメントを公表していません。
スケジュールに従って指定サイトを収集し、自分でカバレッジを定義する必要がある場合、それはアーカイブではなくコレクション製品です。クロールは何が存在するかを発見し、ターゲット収集は既知のページをオンデマンドで返します。その違いについてはクロールとスクレイピングの比較ガイドで詳しく解説しています。
収集に対価を払ってもブロックの免除は得られません。パブリッシャーはアーカイブクローラーと同様に商業クローラーも制限します。サイトが防御を変更した際のメンテナンス負担を誰が担うかがベンダーによって変わります。
Bright Dataはターゲット収集を販売しています。Web Scraper APIは1,000レコードあたり1ドルで、毎月最初の5,000件は無料。既成データセットは250ドル最低購入で1レコードあたり0.0025ドルからです。どちらも対応サイトを継続的にカバーします。Wayback Machineの代替にはなりません。その理由は日付範囲にあります。事前収集データは数日から数ヶ月前まで遡れますが、1996年まではさかのぼれないため、2014年にページが何を言っていたかという問いは依然としてアーカイブで調べる必要があります。
Next steps
対象ドメインでカバレッジスクリプトを実行し、同じドメインをWayback CDXサーバーでキャプチャ密度を確認してください。
コンテンツレコードはバルク作業が可能かどうかを示し、キャプチャ密度はURLレベルの履歴が可能かどうかを示します。健全な件数は読み取りであってコミットメントではありません。サンプリングポリシーはフロアを保証せず、クロールごとの合計は2024年以降約4分の1減少しているため、依存する前に再確認してください。
アクセスを失うと何かが壊れる場合は今すぐ重要なものをキャプチャし、残りは収集を購入し、キャプチャしたものはWARCで保持してポータブルな状態を維持し、両方の公開アーカイブは依存するストレージではなく照会するソースとして扱ってください。
Frequently asked questions
Can I use Common Crawl commercially?
利用規約はそれを許可し、リスクはあなたに帰属します。Common Crawlは総責任を100ドルに上限を設け、クロールコンテンツをAIシステムの開発、学習、展開に使用することから生じる請求に対してあなたが補償することを要求しています。Common Crawlは商業利用の前に法的アドバイスを推奨しています。
Can you download all Wayback Machine data?
バルクではできません。Internet Archiveは一般ウェブアーカイブのバルクエクスポートを公開しておらず、アクセスはレート制限されたAPIを通じて行われます。研究規模の分析にはInternet ArchiveがARCH(コンピュートプラットフォーム)を提供していますが、見積もりのみで公開料金はありません。
What rate should I design a Wayback CDX client against?
毎分24リクエストを設計基準にしてください。制限はInternet Archiveが公表していない毎分30リクエストで、CDXとtimemapエンドポイントが1つのサービスになって以来共有されており、waybackクライアントはそのデフォルトとして80%を使用します。リプレイは毎分600の別プールなので、そこでは480を基準にしてください。
Why does a Common Crawl domain lookup return records but no content?
それらのレコードがrobots.txtフェッチだからです。CCBotはアクセスするすべてのホストからrobots.txtをリクエストし、サイトがそれを拒否すると、そのリクエストとそれへのリダイレクトだけがクロールに残ります。ドメインがカバーされていると結論付ける前に返されたURLを分類し、プレフィックスクエリとドメインクエリは異なる件数を返すことがあるため、マッチタイプを明記してください。