AliExpressのスクレイピングでは、価格監視や競合情報に必要な価格、在庫、バリエーション、評価、レビューを収集します。そのほとんどはHTMLに含まれておらず、ページが後から署名付きの内部APIから読み込むためです。
テストでは、単純なリクエストはHTTP 200を返しましたが価格はなく、パイプラインは空の行を成功としてログに記録してしまいます。1つのIPアドレスから、署名付きAPIは十数回のリクエストでブロックを開始しました。
このガイドでは、そのデータを取得する方法、成功に見える失敗を検出する方法、そしてBright DataのAliExpress Scraper APIを大規模に使用する方法を紹介します。
要約
- 古いチュートリアルが解析している
window.runParamsオブジェクトは空です。価格、在庫、SKUデータはmtop.aliexpress.pdp.pc.queryから読み込まれ、これにはMD5署名が必要です。 - ブロックはステータスコードではなくマーカーで検出します。ブロックされたリクエストはHTTP 200、
bxpunishヘッダー、rgv587_flagのようなボディマーカーを返しました。 - 正しい署名でもブロックは防げませんでした。1つのIPアドレスから遅延なしで60回呼び出した2回の実行で、それぞれ7回と15回しかデータを取得できませんでした。
- 大規模の場合は公開されている
/item/商品ページをスクレイピングします。Bright DataのAliExpress Scraper APIは構造化データを抽出し、Browser APIを使えばスクリプトで各ページの完全なAPIレスポンスを読み取れます。
HTTPクライアントでAliExpressをスクレイピングすると何が起こるか
まずは、ブラウザやプロキシなしで送信する1回のHTTPリクエストから始めます。タイムアウトする場合、あなたのネットワークはAliExpressに直接アクセスできず、プロキシか後述するマネージド手法の1つが、アクセス可能なネットワークからリクエストを送信します。
以下はすべて3つのパッケージを使用します。後のセクションのScraper APIスクリプトは、環境変数からBright DataのAPIキーを読み取ります。
pip install curl_cffi playwright requests
export BRIGHTDATA_API_KEY="your-api-key" # PowerShell: $env:BRIGHTDATA_API_KEY="your-api-key"curl_cffiを使って1つの商品ページを取得し、<title>、古いチュートリアルが解析しているwindow.runParamsオブジェクト、そしてページが自身のJavaScriptに渡すブートストラップオブジェクトを読み取ります。この3つの値で、単純なHTTPクライアントで十分かどうかがわかります。
import re
from curl_cffi import requests as cffi

# any product URL that still exists works
ITEM = "https://www.aliexpress.com/item/1005001398867186.html"

# no User-Agent of your own: curl_cffi sends one that matches the browser it impersonates
r = cffi.get(ITEM, impersonate="chrome", timeout=30)
html = r.text

print("status      ", r.status_code)
print("bytes       ", len(html))
print("title       ", repr(re.search(r"<title>(.*?)</title>", html, re.S).group(1)))
print("runParams   ", repr(re.search(r"window\.runParams\s*=\s*(\{.*?\});", html, re.S).group(1)))
print("isCSR       ", re.search(r"isCSR\s*=\s*(\w+)", html).group(1))
print("crawler flag", re.search(r'"crawler":(\w+)', html).group(1))
フェッチは成功します:
status       200
bytes        77226
title        ''
runParams    '{\n                    }'
isCSR        true
crawler flag false
ページはHTMLのシェルで、価格、在庫、SKU、評価、レビューはありません。JavaScriptが実行される前に、シェルにはすでにOpen Graphタグがあります。og:titleには実際の商品名が含まれていますが、<title>は空で、og:image、og:url、og:type(productに設定)も存在します。og:descriptionには汎用的なAliExpressのスローガンしか含まれておらず、ページにはJSON-LDもないため、どちらのソースも商品データを提供しません。
同じ時間に同じURLを読み込むブラウザは、価格、評価、バリエーションをレンダリングします。
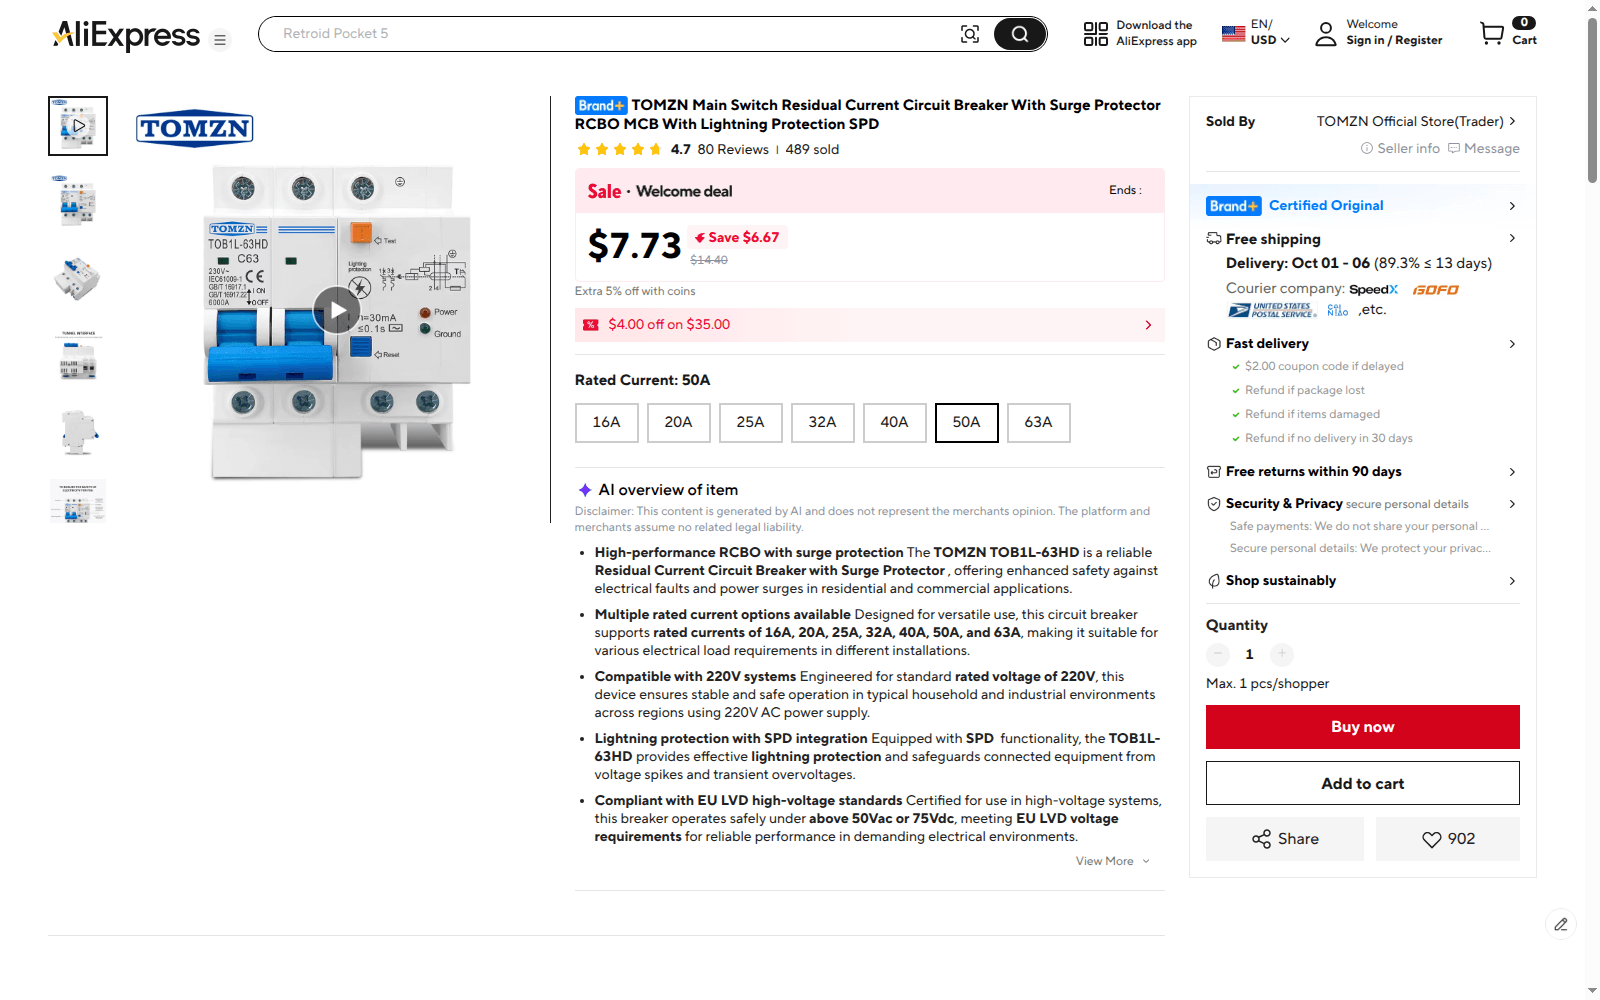
米国に設定した位置情報ターゲティングを使い、Bright DataのBrowser APIでレンダリングしました。AliExpressの内部APIは、この商品について同じ$14.40のリスト価格と4.7の評価を返します。セール価格は一時的なプロモーションによるもので、時間とともに変化します。
そのリスト価格をページソース内で検索しても何も見つかりません。
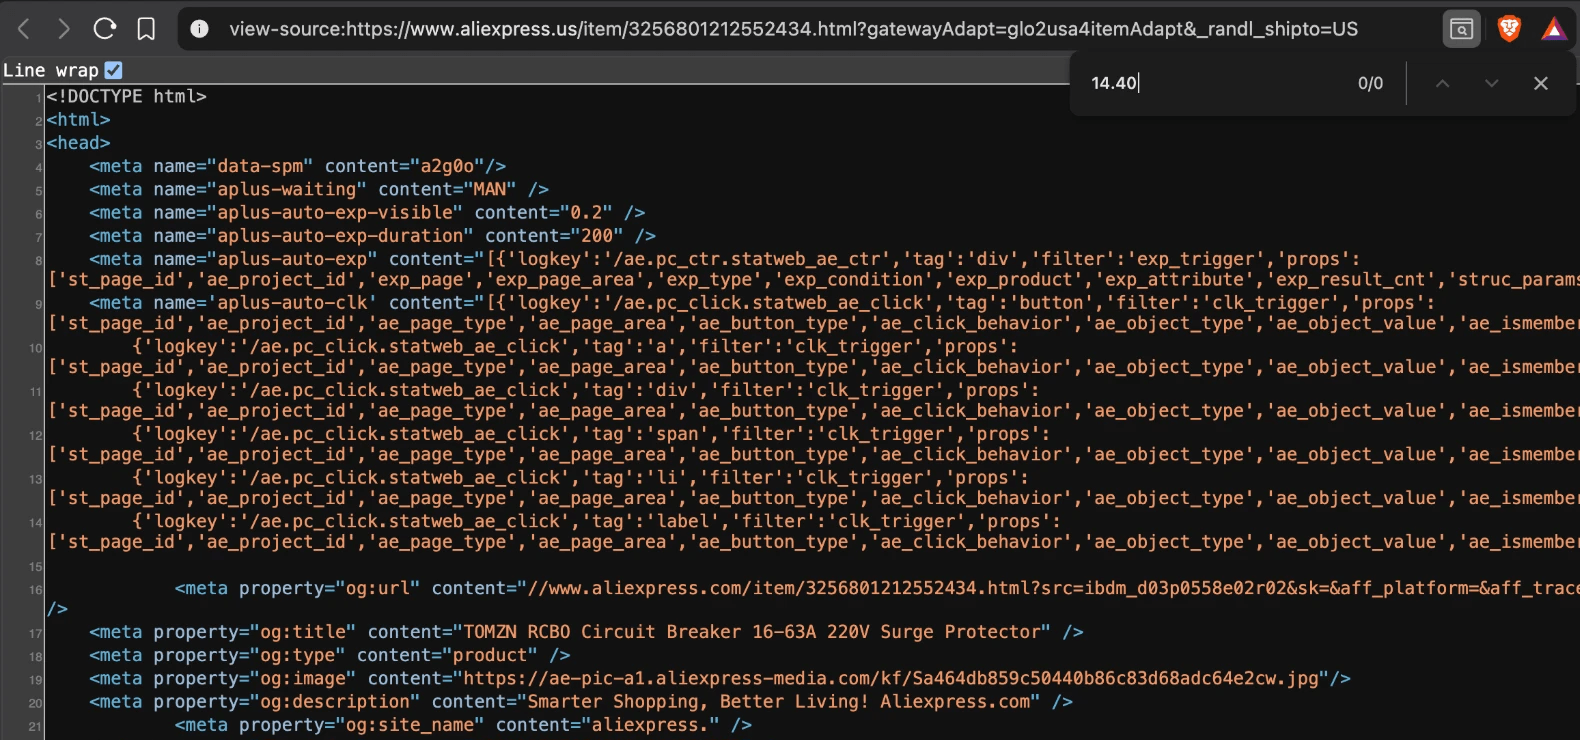
米国のストアフロントでキャプチャしたもので、同じ77KBのシェルが提供されています。
カタログのフィールドは収集コストが低いです。アンブロック処理のない単純なGETリクエストでカタログのフィールドが返ってくるため、レンダリングなしで商品IDをタイトルとメイン画像にマッピングできます。価格と品揃えのパイプラインには、AliExpressの内部APIゲートウェイから取得する価格、在庫、バリエーションデータが必要です。この2つのジョブは別々に計画してください。
curl_cffiにUser-Agentを選ばせます。impersonate="chrome"はバージョンではなくエイリアスです。ライブラリのソースコードでは、curl_cffi 0.16.1はこのエイリアスをDEFAULT_CHROME定数を通じてchrome150にマッピングしており、その定数は新しいプロファイルがリリースされるたびに変わります。ヘッダーを設定しない場合、ライブラリは対応するChrome/150のUser-Agentも送信します。
自分のUser-Agentを渡すと、ライブラリのUser-Agentが置き換えられるため、ハードコードされたChrome/141文字列がChrome 150のTLSハンドシェイクとともに送信されます。この不一致はエラーを発生させないため、気づかずにデプロイできてしまいます。ヘッダーを省略してライブラリにUser-Agentとハンドシェイクをペアにさせるか、プロファイルをバージョンに固定して文字列を一致させてください。TLSクライアントを構築するエンジニアは、不一致のアイデンティティは一貫したものより検出しやすく、User-Agentの方がTLSハンドシェイクよりずっと早く古くなると報告しています。
isCSRフラグはページのレンダリング方法を示します。AliExpressが商品詳細ページをクライアントサイドレンダリング(CSR)に移行したため、値はtrueです。window.runParamsは未使用の空オブジェクトで、正規表現ベースの抽出ツールは依然としてマッチしてしまいます。それを読み取るパーサーはエラーを発生させず、何も返しません。
試したすべてのクライアントでHTTP 200と同じ77KBのシェルが返されました。プロキシなしで1つのレジデンシャルIPアドレスからそのURLに連続して20回リクエストを送信したところ、すべてHTTP 200を返しました。リクエストは0.4秒ごとに1回、User-Agentのローテーションなしで単一セッション内で実行しました。同じURLをpython-requests/2.32.5として、curl/8.7.1として、そして3つのTLS偽装プロファイルとしても取得しました。
GooglebotのUser-Agentを送信すると、ブートストラップオブジェクト内の"crawler"がfalseからtrueに切り替わります。レスポンスは1バイトだけ異なります。このフラグはサーバーレンダリングされたペイロードを追加しなかったため、Googlebotを偽装しても1つの真偽値が変わるだけで他は何も変わりません。
クライアントレンダリングされたマーケットプレイスでは、フェッチを成功としてログに記録する前にデータを確認してください。ステータスコードはHTTPリクエストが成功したことしか示しません。このターゲットでは、データが欠落していてもリクエストは成功していました。
HTTP 200を返すブロック
AliExpressは実際にリクエストをブロックしますが、HTTPステータス行にはそのブロックが表示されません。
サイト自身のrobots.txtは、Googlebot専用のルール内で内部エンドポイントを指定しており、そのエンドポイントは商品データを返す可能性があります。これを直接呼び出し、ボディの前にレスポンスヘッダーを読み取ります。
from curl_cffi import requests as cffi

PID = "1005001398867186"
url = f"https://www.aliexpress.com/aeglodetailweb/api/msite/item?productId={PID}"
r = cffi.get(url, impersonate="chrome", timeout=30,
             headers={"Accept": "application/json",
                      "Referer": f"https://www.aliexpress.com/item/{PID}.html"})

print("status", r.status_code, "bytes", len(r.text))
for k in ("server", "x-rule-name", "bxpunish", "set-cookie"):
    print(f"  {k:12s} {str(r.headers.get(k))[:70]}")
print("body marker:", "rgv587_flag" in r.text, "| x5secdata:", "x5secdata" in r.text)
レスポンスはAlibabaのBaxiaアンチボットシステムからのもので、成功ステータスコードを持っています。
status 200 bytes 2399
  server       Tengine/AServer-Ingress
  x-rule-name  AE_GLOBAL_UNLOGIN
  bxpunish     1
  set-cookie   x5secdata=xffEdBbOh5ArPGTjyI_40B3_06C7jiK2nBFPGlpVzkk2x66w14DH6V
body marker: True | x5secdata: Trueボディはwindow.location経由で_____tmd_____/punish URLにリダイレクトするスクリプトで、window._config_ = {"action":"captcha", ...}を設定します。末尾にはAlibabaのブロックマーカーである<!--rgv587_flag:sm-->があります。x-rule-nameヘッダーには、マッチしたルール名であるAE_GLOBAL_UNLOGINが記載されており、これは認証されていないグローバルトラフィック向けのルールのようです。同じヘッダーは正常でブロックされていないレスポンスでも返ってくるため、単独ではブロックを示しません。
ステータスコードチェックはこのブロックされたレスポンスを受け入れてしまいます。raise_for_status()はエラーを発生させず、status_code == 200チェックはtrueを返します。ダッシュボードがHTTP 2xxレスポンスを成功としてカウントしている場合、行が空であるにもかかわらず健全なパイプラインとして報告してしまいます。
そのため、ブロックはステータスコードではなく、レスポンスヘッダーとボディで検出してください。Alibabaのエラー文字列は予告なく変更される可能性がありますが、専用のレスポンスヘッダーとボディ内のマーカー文字列はチェックコストが低く、拡張も容易です。
BLOCK_MARKERS = ("rgv587_flag", "x5secdata", "_____tmd_____", "FAIL_SYS_USER_VALIDATE")

def is_blocked(resp, min_bytes=1024):
    """True when Baxia responded instead of the application."""
    if resp.headers.get("bxpunish"):
        return True
    body = resp.text
    if len(body) < min_bytes:          # treat a near-empty 200 as a block too
        return True
    return any(m in body[:4096] for m in BLOCK_MARKERS)
私のテストでは、このチェックによってステータスコードでは表示されなかったすべてのブロックを検出できました。パーサーの前に同じチェックを実行し、セレクターを書く前に追加してください。これを行わなければ、このターゲットでのブロックは、パーサーがデータを見つけられない時にしかわかりません。
失敗した各リクエストの理由をログに記録してください。このターゲットでは、ブロックページ、空のシェル、間違った通貨の価格はそれぞれ異なる修正が必要であり、全体の成功率ではこれら3つすべてが隠れてしまいます。出口国ごとに理由も分けてください。間違った通貨の価格は、それでも成功に見えてしまうからです。
商品API呼び出しを自分で署名する
商品フィールドはJSONとして実際に存在します。ブラウザで1つのページを読み込み、そのXHRトラフィックを記録すると、これらのフィールドがページが呼び出すAPIゲートウェイから来ていることがわかります。
ページの読み込みは、acs.aliexpress.com/h5/<api>/<version>/にあるAlibabaのMTOPゲートウェイを呼び出し、それぞれにjsv、appKey、ミリ秒単位のタイムスタンプt、32文字のsignが含まれます。mtop.aliexpress.pdp.pc.queryは価格、在庫、SKU、ストア、評価を返します。レビュー本文は、同じゲートウェイ上の2つ目の署名付き呼び出しであるmtop.aliexpress.review.pc.listから来るため、レビュー収集には商品ごとに2つ目のリクエストが必要です。インラインのブートストラップスクリプトを読むと、ページが複数の商品APIを呼び出せることがわかります。
ページバリアント (viewName) |
プリフェッチAPI |
|---|---|
newDetail |
mtop.aliexpress.pdp.pc.query |
choiceDetail |
mtop.aliexpress.itemdetail.pc.asyncPCDetail |
h5Detail |
mtop.aliexpress.itemdetail.msite |
サンプリングした6つの商品ページすべてがviewName = 'newDetail'でした。モバイル用のmtop.aliexpress.itemdetail.msiteとmtop.aliexpress.itemdetail.pc.asyncPCDetailという他2つのAPIは、アクセスが容易ではありませんでした。両方とも、デスクトップAPIが受け入れるのと同じペイロードで送信した最初のリクエストで、bxpunish: 1とともにFAIL_SYS_USER_VALIDATEを返しました。
各フェッチでviewNameを読み取り、リスティングが異なるページバリアントとしてレンダリングされ始めるタイミングを確認してください。1つのAPI名にハードコードされたスクレイパーは、その変化を見逃してしまいます。ページのブートストラップスクリプトは15,000msのプリフェッチタイムアウトを設定し、自身のXHRを10,000msで中止するため、自分のタイムアウトの上限として10,000msを使用してください。
ブラウザのNetworkパネルでpdp.pc.queryにフィルタすると、ページ自身のリクエストに署名コードに必要なすべての値が含まれています。
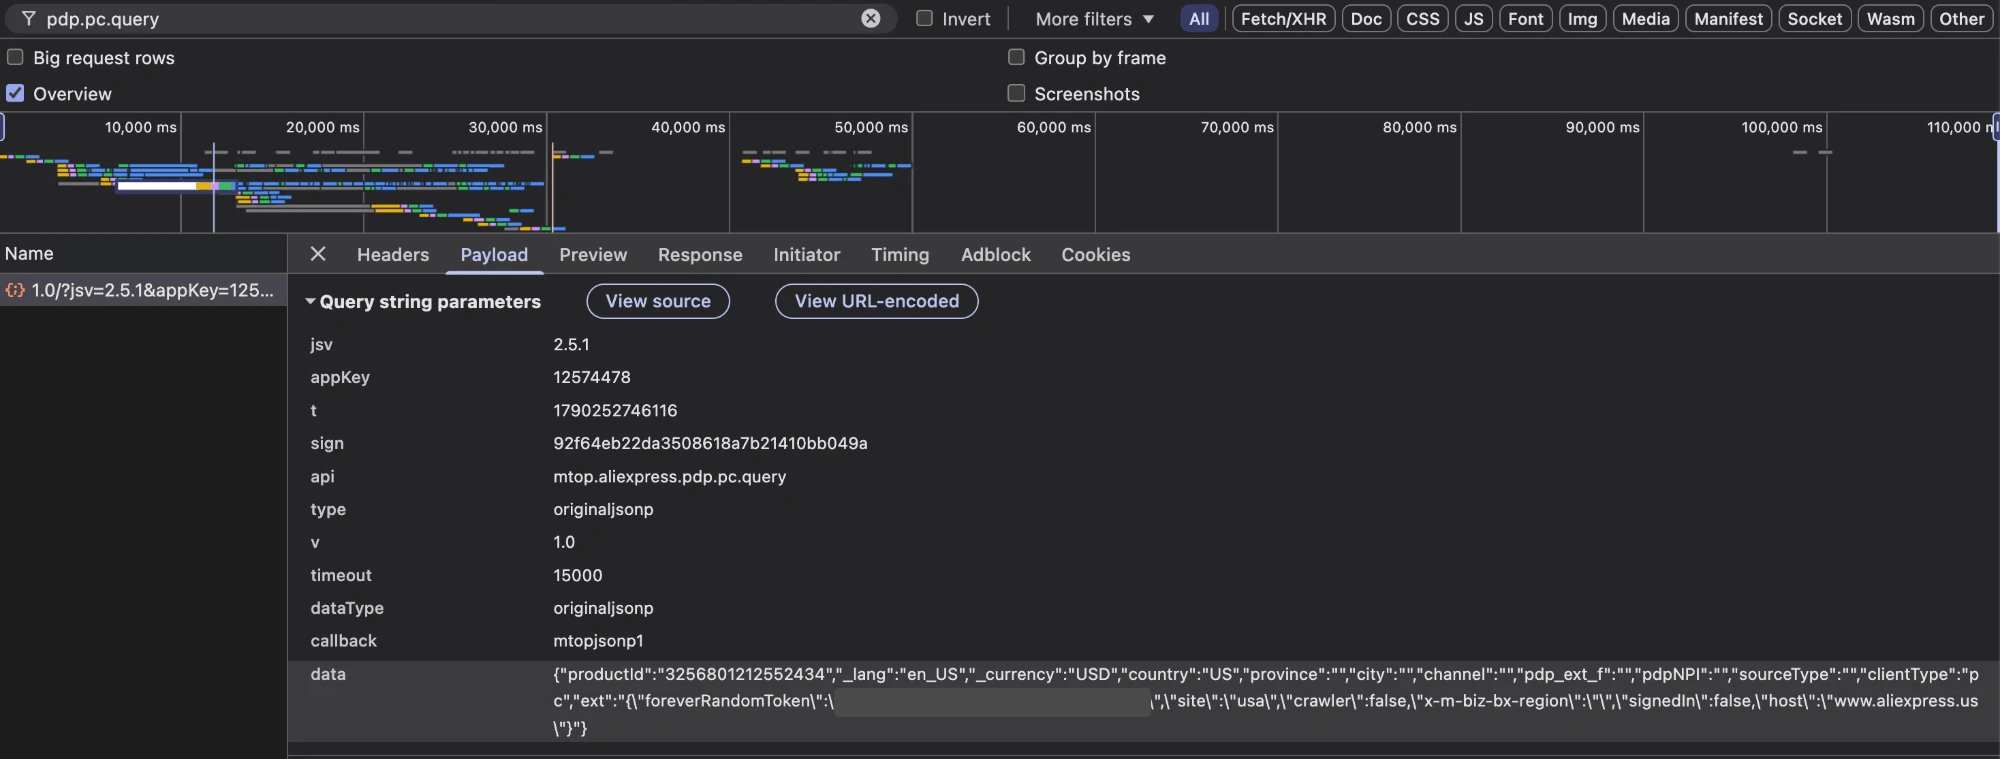
米国のストアフロントでキャプチャしたページ自身の呼び出しで、このリスティングのIDは3256801212552434です。ページはoriginaljsonpを送信し、timeoutとextブロックを追加します。以下の署名コードはjsonpを送信し、両方を省略していますが、ゲートウェイはこの短いリクエストを受け入れました。1つのトークン値は編集済みです。
signの値はAlibabaのH5署名スキームを使用しており、これは1つの関数で再実装できるほど短いものです。このスキームは、セッショントークン、タイムスタンプ、アプリキー、そして正確なリクエストボディをアンパサンドで結合し、その結果をMD5でハッシュ化します。
import hashlib, json, time
from curl_cffi import requests as cffi

APP_KEY, API, VER = "12574478", "mtop.aliexpress.pdp.pc.query", "1.0"
GATEWAY = f"https://acs.aliexpress.com/h5/{API}/{VER}/"

def sign(token, t, data):
    return hashlib.md5(f"{token}&{t}&{APP_KEY}&{data}".encode()).hexdigest()

def pdp(session, product_id, token=""):
    data = json.dumps({"productId": product_id, "_lang": "en_US", "_currency": "USD",
                       "country": "US", "province": "", "city": "", "channel": "",
                       "pdp_ext_f": "{}", "sourceType": "", "clientType": "pc"},
                      separators=(",", ":"))
    t = str(int(time.time() * 1000))
    params = {"jsv": "2.5.1", "appKey": APP_KEY, "t": t, "sign": sign(token, t, data),
              "api": API, "v": VER, "type": "jsonp", "dataType": "jsonp",
              "callback": "mtopjsonp1", "data": data}
    return session.get(GATEWAY, params=params, impersonate="chrome", timeout=30,
                       headers={"Referer": "https://www.aliexpress.com/"})

s = cffi.Session()
first = pdp(s, "1005001398867186")                       # unsigned, returns the token cookie
token = s.cookies.get("_m_h5_tk", "").split("_")[0]
second = pdp(s, "1005001398867186", token)               # signed with that token
print("call 1:", len(first.text), "bytes |", first.text[:60])
print("call 2:", len(second.text), "bytes")
最初の呼び出しはトークンを返し、2回目の呼び出しは商品を返します。
call 1: 151 bytes | mtopjsonp1({"api":"mtop.aliexpress.pdp.pc.query","data":{},"ret
call 2: 103748 bytes呼び出し1はFAIL_SYS_TOKEN_EMPTYと_m_h5_tkを含むSet-Cookieヘッダーを返します。呼び出し2はそのクッキー値の最初の部分で署名されており、JSONP(1つのJSONオブジェクトを包む関数呼び出し)を返します。mtopjsonp1(...)のラッパーを除去すると、タイトル、originalPrice $14.40、salePriceString $6.84、59,924個の在庫、評価4.7、販売者ID 200422816、categoryPath 13/5/141914を含む商品の完全なレコードが得られます。
そのペイロードのごく一部しか必要ありません。レスポンスには27のトップレベルモジュールがあり、そのうち8つに価格や品揃えのパイプラインが保存するフィールドが含まれています。コンパクトなJSONとしてシリアライズすると、これら8つのモジュールは16,494バイトで、結果オブジェクト全体の15.9%です。最大のモジュールはSHIPPINGで34,071バイト、2番目に大きいのはGLOBAL_DATAで23,783バイトです。
署名には、1つのMD5ハッシュ、1つのクッキー、1つの再試行が必要です。他のAlibabaサイト向けにH5署名スキームを再実装したことがあれば、数時間の作業で済むでしょう。では、その署名コードはどのくらいの期間機能し続けるのでしょうか?
1つのIPアドレスから成功する署名付きAPI呼び出しの数
署名付き呼び出しをループで実行すると、その答えがすぐにわかります。このテストでは、10個の商品ID、1つのトークン、1つのレジデンシャルIPアドレスを使用し、呼び出し間に遅延はありません。スクリプトはゲートウェイが返す各retコードをカウントします。
# continues the session from the signing code: pdp(), s and token are defined there
from collections import Counter
import re

# ten product IDs, replace any that were removed
IDS = ["3256812884305776", "1005007712136541", "1005002754717958", "1005002495501001",
       "2255799968025159", "1005008121783683", "3256809736486496", "1005008175462016",
       "1005012238762416", "3256812840307416"]

outcomes, first_fail = Counter(), None
for i in range(1, 61):
    r = pdp(s, IDS[i % len(IDS)], token)
    ret = re.search(r'"ret":\["([^"]+)"', r.text).group(1).split("::")[0]
    key = ret + (" +bxpunish" if r.headers.get("bxpunish") else "")
    outcomes[key] += 1
    if key != "SUCCESS" and first_fail is None:
        first_fail = i
print(dict(outcomes), "| first non-SUCCESS at", first_fail)
ループは7回目の呼び出し後にデータを取得できなくなりました。
{'SUCCESS': 7, 'FAIL_SYS_USER_VALIDATE +bxpunish': 53} | first non-SUCCESS at 8ブロックされた各レスポンスのret配列にもRGV587_ERROR::SMが含まれていました。
ブロックは繰り返されましたが、成功数は変わりました。同じIPアドレスからの2回目の実行では、毎秒6.2リクエストを送信し、各呼び出しのステータスコードとレスポンス長を記録し、60回中15回成功し、最初のブロックはリクエスト12回目でした。60回すべての呼び出しでHTTP 200を返し、ブロックされた45件のレスポンスはすべてちょうど543バイトでした。つまり、容量計画はどちらかの成功数ではなく、ブロックに基づいて立ててください。
新しいセッションでもブロックは解除されませんでした。連続した3つの新しいセッションはそれぞれ空のクッキージャーから開始し、クライアントがトークンを取得する前にブロックされました。空のクッキージャーから60秒待機後に送信されたリクエストも同様にブロックされました。つまり、自動再試行はデータを増やさずにトラフィックを増やすだけであり、プロキシエンジニアはこのような再試行ロジックが目に見えるエラーなしに予算を消費すると警告しています。
このテストでは呼び出し間に遅延を設けませんでした。次に、長いバックオフ、バッチごとの新しいトークン、意図的に遅いリクエストレート、そしてページ自身のリクエストが署名するextブロックなど、本番環境のスクレイパーが追加する変数をテストしてください。そのブロックにはcrawlerフラグとx-m-biz-bx-regionキーが含まれています。
署名はリクエスト7からリクエスト60まで正しいままだったため、さらなるリバースエンジニアリングで60リクエスト中7回と15回という成功数が増える可能性は低いです。これらのテストはセッションを原因から除外します。IPアドレスとフィンガープリントを別々に変更したテストはないため、ブロックはどちらかに依存している可能性があります。アンチボットシステムは1つのフィンガープリントを多数のIPアドレスにまたがってリンクすることもできるため、実践者はIPアドレス、フィンガープリント、クッキーをまとめて変更します。
3つのチェックにより、原因がクライアントではないことが示されます。tls.peet.wsのフィンガープリントエコーで、curl_cffi 0.16.1上の署名コードは、そのマシン上の実際のChromium 152と一致し、同じJA4フィンガープリントであるt13d1516h2_8daaf6152771_806a8c22fdeaと同じHTTP/2フィンガープリントを示しました。curl_cffiとRustライブラリのrnetおよびwreqからの5つのフィンガープリントは、wreqがcurl_cffi 0.16.1より新しいChromeプロファイルを搭載しているにもかかわらず、100件のブロックされたレスポンスとトークンなしという結果を生みました。Patchright、nodriver、CamoufoxはそれぞれそのIPアドレスから8回試行して0回成功した一方、Bright DataのBrowser APIは別の出口IPで同じ分内に商品を返しました。
これら3つのツールが実行された時、そのIPアドレスはすでにブロックされていたため、3つとも同じように失敗しました。このゼロという数字はIPアドレスの評判を示すものであり、ツールのランク付けではありません。
最初のチェックであるtls.peet.wsのTrackMeのフィンガープリントエコーは、1回のリクエストからすべてのフィンガープリントを返します。
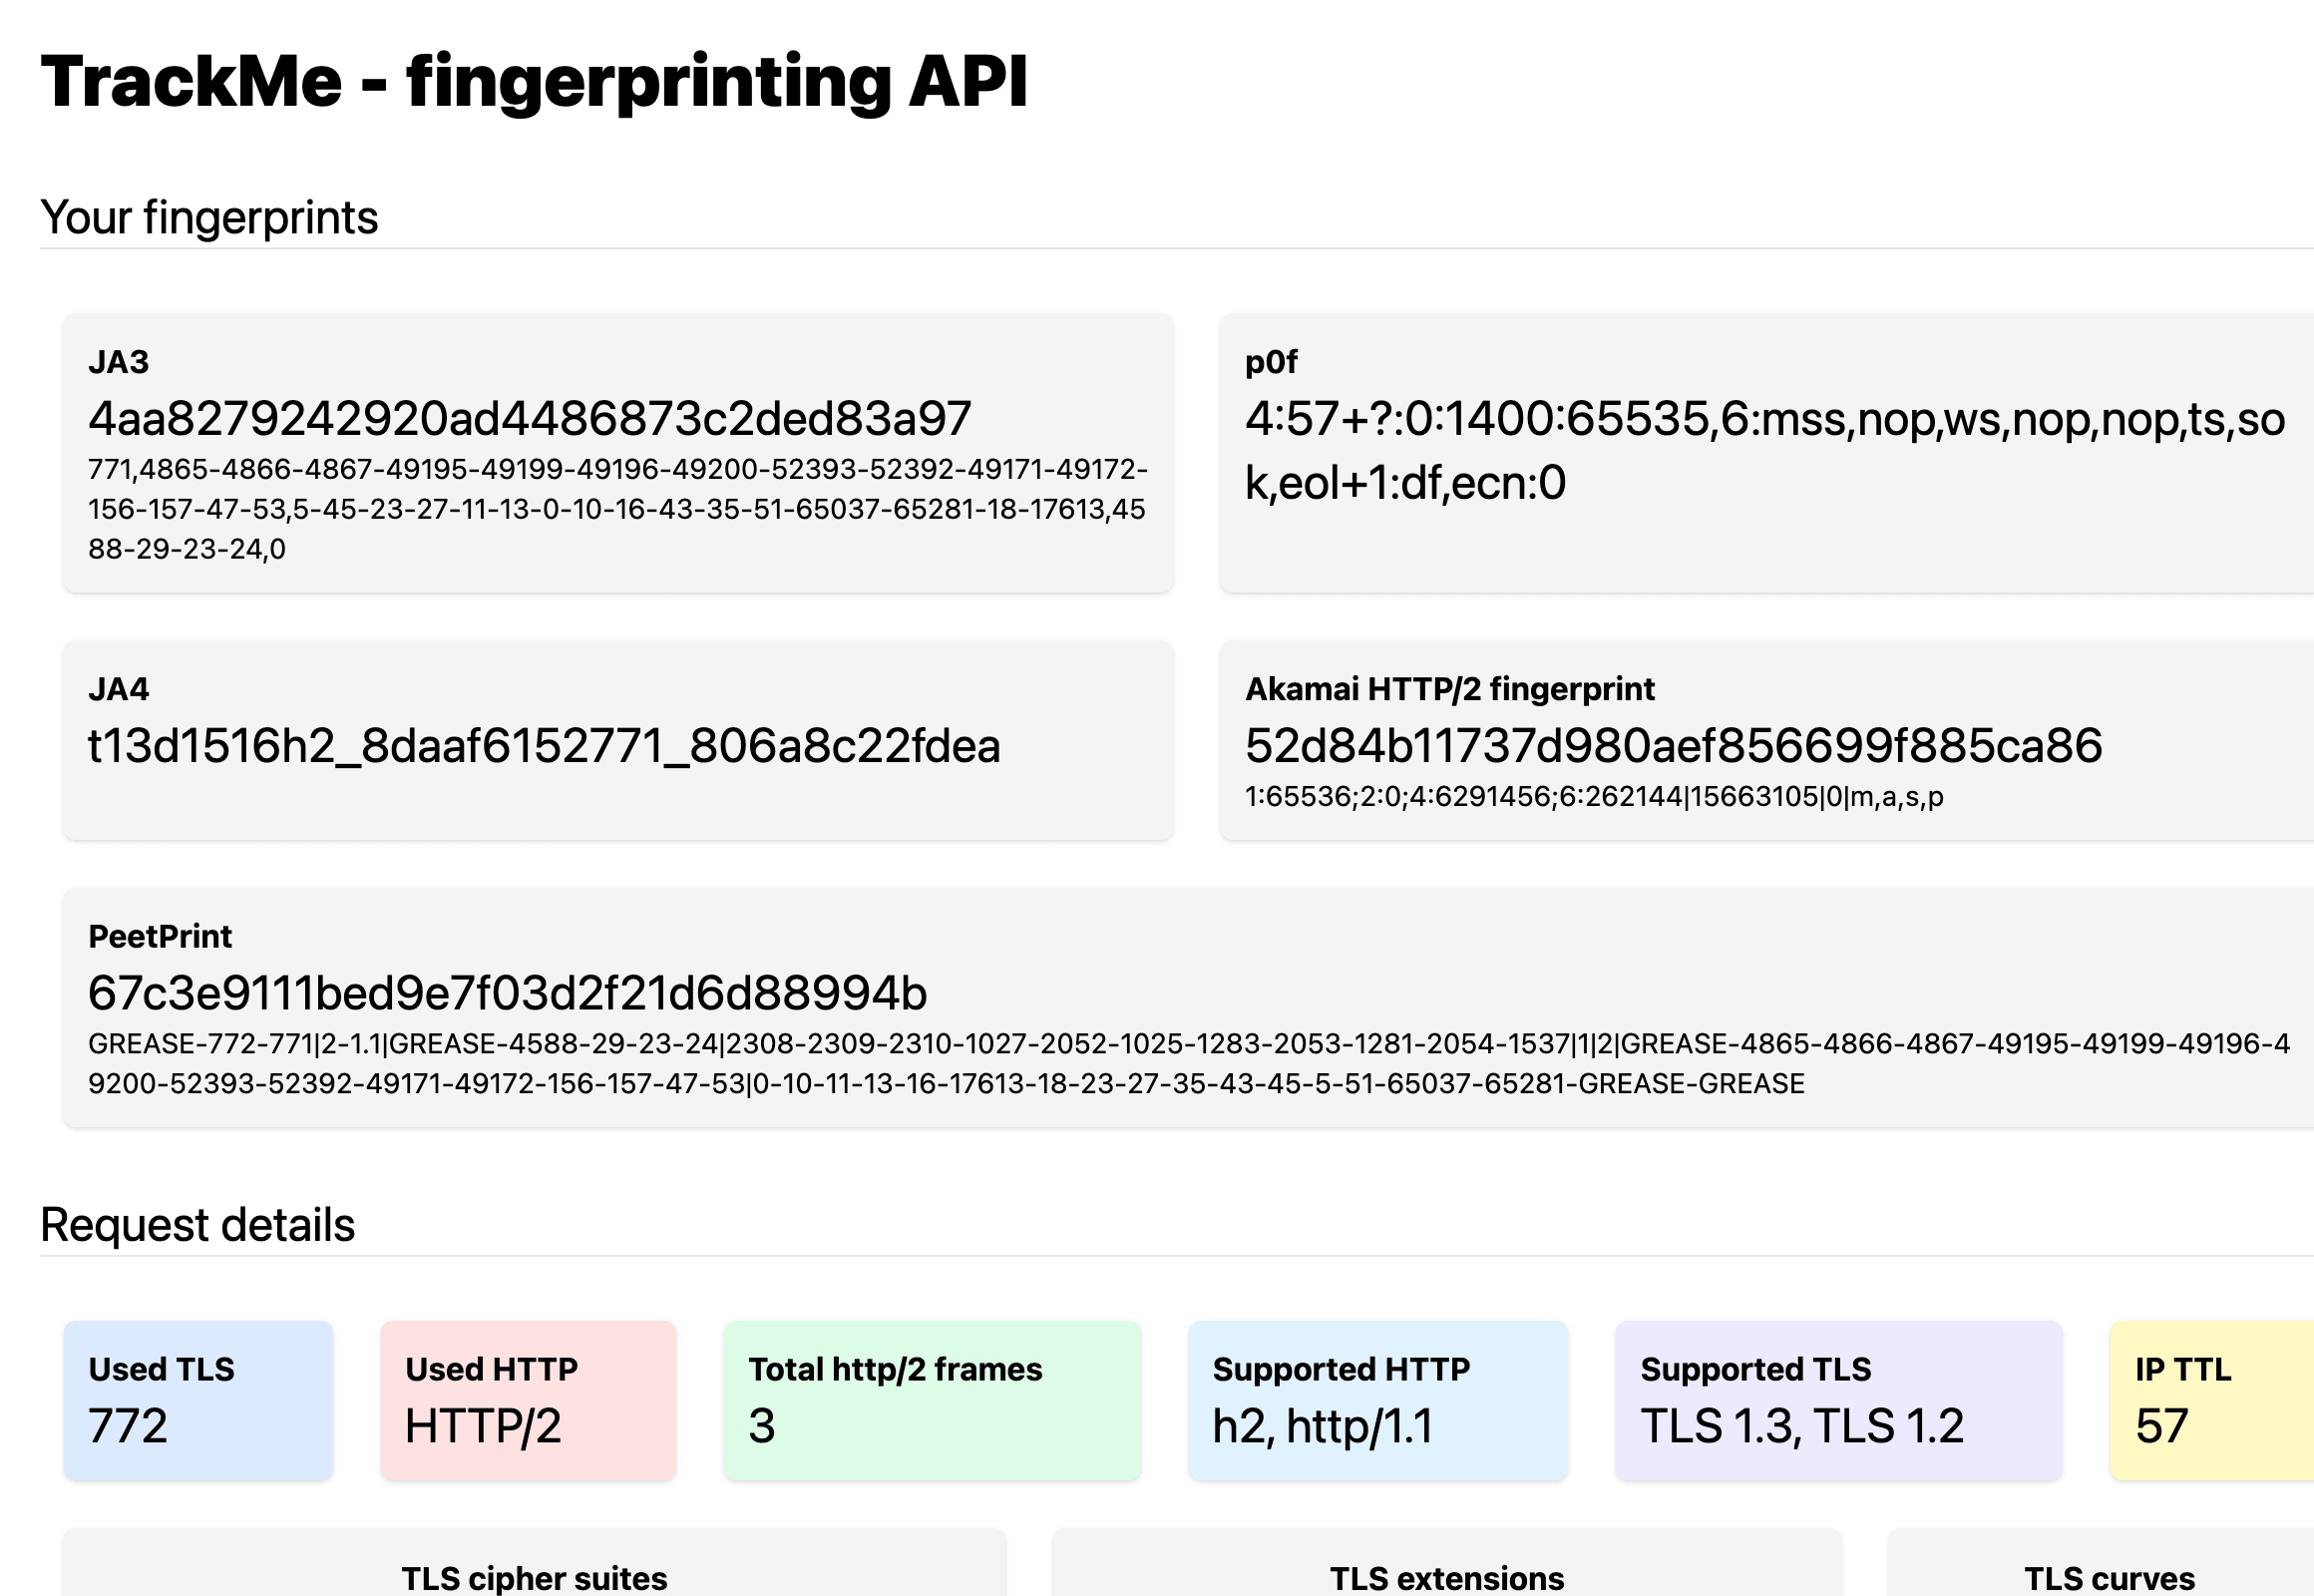
プロファイルがその名前の由来となるブラウザのJA4フィンガープリントとHTTP/2フィンガープリントの両方を再現していることを確認してください。
新しいプロファイルがここで良い一致をしたわけではありません。wreqのChrome 152プロファイルは17の拡張を持つClientHelloを送信しましたが、Chrome 152自身は16でした。プロファイル名のバージョン番号は、送信されるフィンガープリントを保証しないため、信頼する前に各プロファイルをフィンガープリントエコーと照合してください。ここでは、curl_cffiのデフォルトプロファイルが実際のブラウザと正確に一致していました。
署名付きエンドポイントのリバースエンジニアリングはデータの見た目を教えてくれますが、どれだけ収集できるかは教えてくれません。これらのテストでは、より良い署名もより良いブラウザもその量を増やしませんでした。
ページに商品API呼び出しを代わりに署名させる
商品ペイロードを取得する2つ目の方法は、自分のコードからのAPI呼び出しではなく、ブラウザ自動化を使用します。ページはすでに署名付き呼び出しを行っています。レスポンスハンドラーをアタッチし、ページが受け取るレスポンスを読み取ります。Browser API経由では、ページのリクエストもBright Dataのプロキシネットワークを通ります。
ページ自身のレスポンスを読み取ることで、トークン、タイムスタンプ、MD5署名、クッキージャーを自分のコードから排除できます。
import json, re
from playwright.sync_api import sync_playwright

WSS = "wss://brd-customer-<id>-zone-<zone>:<password>@brd.superproxy.io:9222"

def capture_pdp(product_id):
    """Read the response to the call the page already makes."""
    bodies = []

    def keep(response):
        if "mtop.aliexpress.pdp.pc.query" not in response.url:
            return
        try:
            bodies.append(response.text())
        except Exception:
            pass                      # redirects and closed pages have no readable body

    with sync_playwright() as pw:
        browser = pw.chromium.connect_over_cdp(WSS, timeout=150_000)
        ctx = browser.contexts[0] if browser.contexts else browser.new_context()
        page = ctx.new_page()
        page.on("response", keep)
        try:
            page.goto(f"https://www.aliexpress.com/item/{product_id}.html",
                      wait_until="domcontentloaded", timeout=150_000)
            page.wait_for_timeout(13_000)
        except Exception:
            pass                      # keep whatever keep() collected before navigation ended
        browser.close()

    for body in sorted((b for b in bodies if isinstance(b, str)), key=len, reverse=True):
        m = re.match(r"\s*mtopjsonp\d*\((.*)\)\s*$", body, re.S)
        try:
            result = json.loads(m.group(1) if m else body).get("data", {}).get("result")
        except (ValueError, AttributeError):
            continue                  # skip a body that is not JSON, such as an HTML page
        if isinstance(result, dict) and len(result) > 10:
            return result
    return None

result = capture_pdp("1005001398867186")
if result:
print(len(result["PRICE"]["skuIdStrPriceInfoMap"]), "SKUs priced")WSSはBrowser APIゾーンに接続し、その3つのプレースホルダーはそのゾーンのアクセス詳細から取得します。
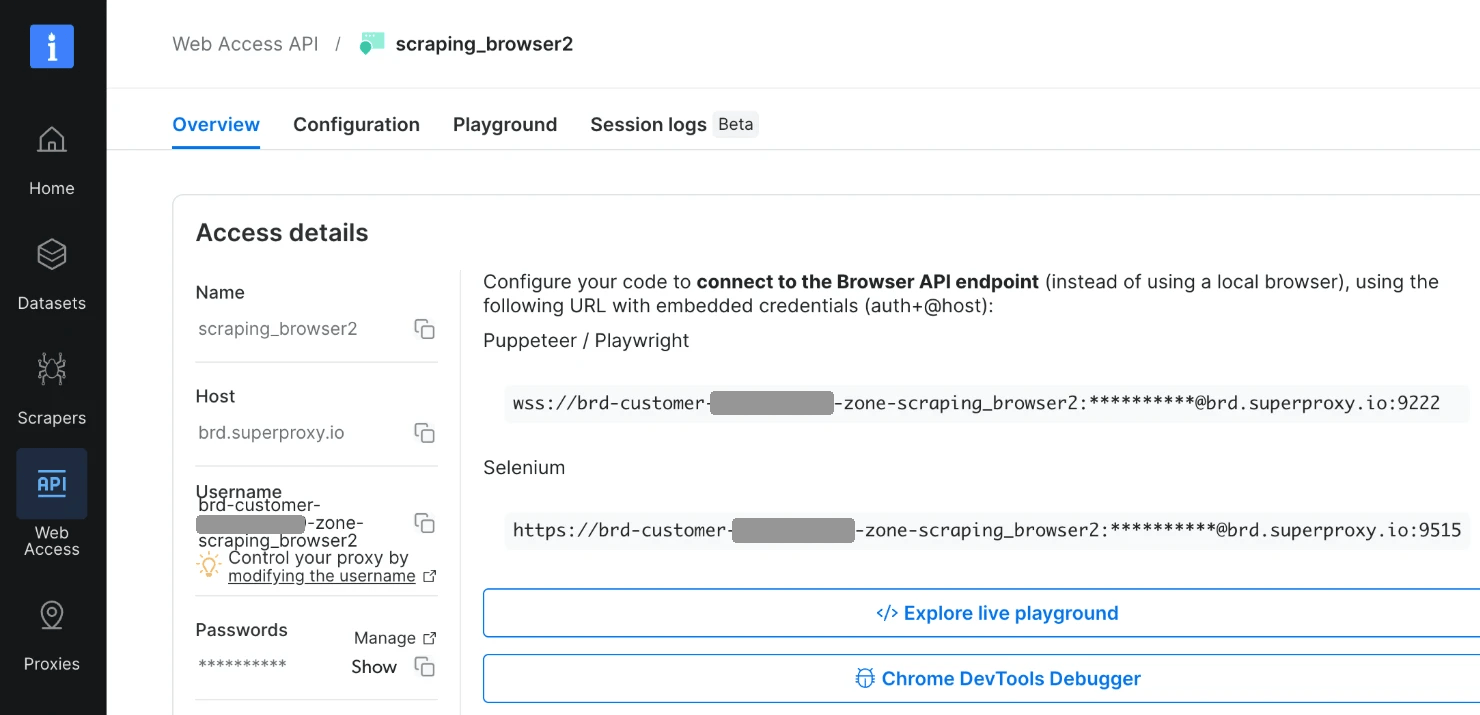
Puppeteer / Playwrightの行がWSSが期待する値で、アカウントID、ゾーン名、パスワードがその3つのプレースホルダーを埋めます。ここではアカウントIDは編集済みで、コントロールパネルはパスワードをマスクしています。
最初のレスポンスだけでなく、すべてのレスポンスを保持してください。ページは1回の読み込みにつきそのエンドポイントを複数回呼び出します。keep()が収集した各レスポンスボディのサイズをログに記録し、どれに商品が含まれているかを確認してください。
3256812884305776  sizes=[151, 170539]          141 SKUs priced
1005007712136541  sizes=[151, 244023]           75 SKUs priced
1005002754717958  sizes=[151, 105852, 106046]   20 SKUs priced
1005002495501001  sizes=[151,  96065]           18 SKUs priced
2255799968025159  sizes=[151,  93982]           15 SKUs priced
1005008121783683 sizes=[151, 63780] 6 SKUs priced151バイトのレスポンスはトークンクッキーを設定します。その後の大きなレスポンスボディには、SKU価格マップを含む商品レコードが含まれています。1回の読み込みに複数の大きなレスポンスがある場合、capture_pdpは最大のものを返します。
AliExpressのrobots.txtファイルが許可する内容
方法を選ぶ前にrobots.txtファイルを読んでください。ディレクティブに馴染みがない場合は、ウェブスクレイピングのためのrobots.txtガイドで説明しています。APIホストとメインホストのファイルでは、ルールが異なります。
$ curl -s https://acs.aliexpress.com/robots.txt
User-agent: *
Disallow: /

$ curl -s https://www.aliexpress.com/robots.txt | grep -E '/item'
Disallow: */aeglodetailweb/api/msite/item?productId*
Disallow: /items/*
Disallow: /item-img/*
Disallow: /item-img/*MTOPゲートウェイは完全に禁止されています。メインホストでは、itemに言及するすべてのルールが別のものに適用されます(/items/*、/item-img/*、そしてaeglodetailwebエンドポイント上のGooglebotルール)。/item/1005001398867186.htmlにはどのルールも適用されない一方、/search/*全体は禁止されています。robots.txtが許可するパスには、Bright Dataのレジデンシャルプロキシ、または以下の方法のいずれかを使用してください。
メインホストのサイトマップとエージェントマニフェストファイルも確認してください。.comのrobots.txtには商品サイトマップが記載されており、最初のサイトマップファイルには31,999の/item/ URLが含まれていたため、サイトマップは商品IDの直接的なソースです。テストでは、6つのエージェントマニフェストパス(/llms.txtと/ai.txt、および/.well-known/配下のagent.json、ai-plugin.json、mcp.json、acp.json)は302で/p/error/404.htmlにリダイレクトされました。
www.aliexpress.us/robots.txtは、サイトマップの行を除いて.comファイルと同じルールを持っていました。サイトは地域によって2つのホスト間で訪問者をリダイレクトするため、これらのルールは両方のホストに適用されます。m.aliexpress.comは独自のAdsBotルールを持つより長いファイルを公開しているため、呼び出すホストを確認してください。
1つのAliExpressホストは例外を公開しており、これはこれらのファイルのいずれかが許可する唯一の署名付きAPIパスです。recom-acs.aliexpress.comはDisallow: /の後にAllow: /h5/mtop.relationrecommend.aliexpressseorecommend.recommend/*を提供しています。意図的に不完全なペイロードで呼び出したところ、そのエンドポイントはbxpunishヘッダーなしでFAIL_SYS_BIZPARAM_MISSEDを返した一方、禁止されているエンドポイントはそのヘッダー付きでFAIL_SYS_USER_VALIDATEを返しました。つまり、robots.txtとアンチボットシステムの両方が同じエンドポイントを許可していました。
商品ページはゲートウェイとは正反対です。AliExpressは一般公開しており、robots.txtはそれを禁止しておらず、3つのBright Data製品それぞれがテストでアクセスできました。Web Unlockerのレンダリング、ゲートウェイのレスポンス、Scraper APIのレコードはすべて、米国ロケールのテストで同じ$6.84のセール価格を持っていました。
サイトが公開しているページをスクレイピングし、IPアドレスとフィンガープリントの処理はインフラに任せてください。この方法は、リデザインや署名の変更の後でも壊れにくい一方、サイトのJavaScriptバンドルからコピーした署名ルーチンは、そのどちらの後でもやり直す必要があります。
AliExpressを大規模にスクレイピングする3つの方法
Bright DataのBrowser API、Web Unlocker、Scraper APIはそれぞれ異なる形式で商品データを提供します。Web UnlockerとBrowser APIの比較で、両者の一般的な違いを説明しています。コントロールパネルのScrapers LibraryでAliExpressを検索すると、このドメイン向けに利用可能なスクレイパーが表示されます。
1回の検索で、ドメインのスクレイパーとすぐに使えるAliExpressデータセットが返されます。
Browser APIは、組み込みのアンブロック機能を備えたマネージドクラウドブラウザでスクリプトを実行し、スクリプトがページが受け取るネットワークレスポンスを読み取れるようにします。CDP経由でPlaywrightをCDP経由で接続し、商品ページを読み込んだところ、ページにはタイトルと価格付きの購入ボックスが表示され、私のスクリプトはその1回の読み込みから171件すべてのレスポンスを読み取ることができました。Browser APIは位置情報ターゲティングもサポートしているため、購入ボックスには選択した出口国の通貨で価格が表示されます。米国の価格には、ゾーンのユーザー名に-country-usを追加してください。
Browser APIの料金はトラフィックのGBあたりなので、ページの重さから実行前に実行コストを見積もることができます。3回の読み込みで、CDPのNetwork.loadingFinishedイベント内の転送バイト数は、商品ページあたり平均3.03 MBで、範囲は2.68 MBから3.47 MBでした。Playwrightのnetworkidleは500msの間リクエストがないことを待ちますが、このページはバックグラウンドでリクエストを送信し続けていました。そのため、capture_pdpはdomcontentloadedを待ち、その後固定時間を待ちます。
Web Unlockerはアンブロック処理を行い、ページをレンダリングし、1つのドキュメントを返します。商品ページの生出力は344,355バイトで、77,226バイトのシェルと比較すると、JavaScriptが実行されたことがわかります。このページのマークダウン出力は21KBから24KBのテキストで、LLMや正規表現で直接読み取れます。Bright Data CLIのbrightdata scrapeコマンドは、デフォルトでマークダウン出力を使用します。
Web Unlockerの料金はリクエストあたりで、成功したリクエストに対してのみ料金が発生します。ストアフロントを選択するには、各リクエストにcountryを設定してください。
AliExpress Scraper APIは構造化データを返します。商品URLを送信すると、タイトル、リスト価格とセール価格、在庫状況、仕様、販売者、評価、レビュー、画像URLなど、すでに抽出されたフィールドを持つレコードを受け取ります。AliExpress Image Scraper APIは画像データに特化しています。Scraper APIの料金は配信されたレコードあたりなので、結果に対してのみ料金が発生します。
| 製品 | 料金単位 | 受け取るもの | 使用するタイミング |
|---|---|---|---|
| Browser API | トラフィックのGB | ブラウザセッションとページのネットワークレスポンス | 各バリエーションの価格など、ページ自身のAPIレスポンスが欲しい場合 |
| Web Unlocker | 成功したリクエスト | 解析するレンダリング済みHTMLまたはマークダウン | すでにパーサーを管理している、またはページをLLMに送信する場合 |
| Scraper API | 配信されたレコード | 構造化された商品レコード | ページではなくレコードが欲しい場合 |
自分でブラウザを実行するのが4つ目の選択肢なので、これも測定しました。3つのステルスブラウザ(Patchright、nodriver、Camoufox)はオープンソースで、1回の読み込みあたり平均14.1秒から15.9秒でした。24回の読み込みのどれも商品データに到達しなかったため、この時間は最小値であり、成功した読み込みではそれを解析する時間も必要になります。
すでにブロックされているIPアドレスでは、3つのステルスブラウザすべてがページのヘッダーとフッターは返しましたが商品データは返しませんでした。各Bright Data製品には組み込みプロキシがあり、自分で実行するブラウザは、Bright DataのAliExpress Proxiesを使用できます。
Scraper APIを大規模に実行する
Scraper APIは1つのエンドポイントでURLを受け付け、別のエンドポイントでレコードを返します。そのコントロールパネルページには、すぐに実行できるリクエストの横に両方のスクレイパーモードが表示されています。
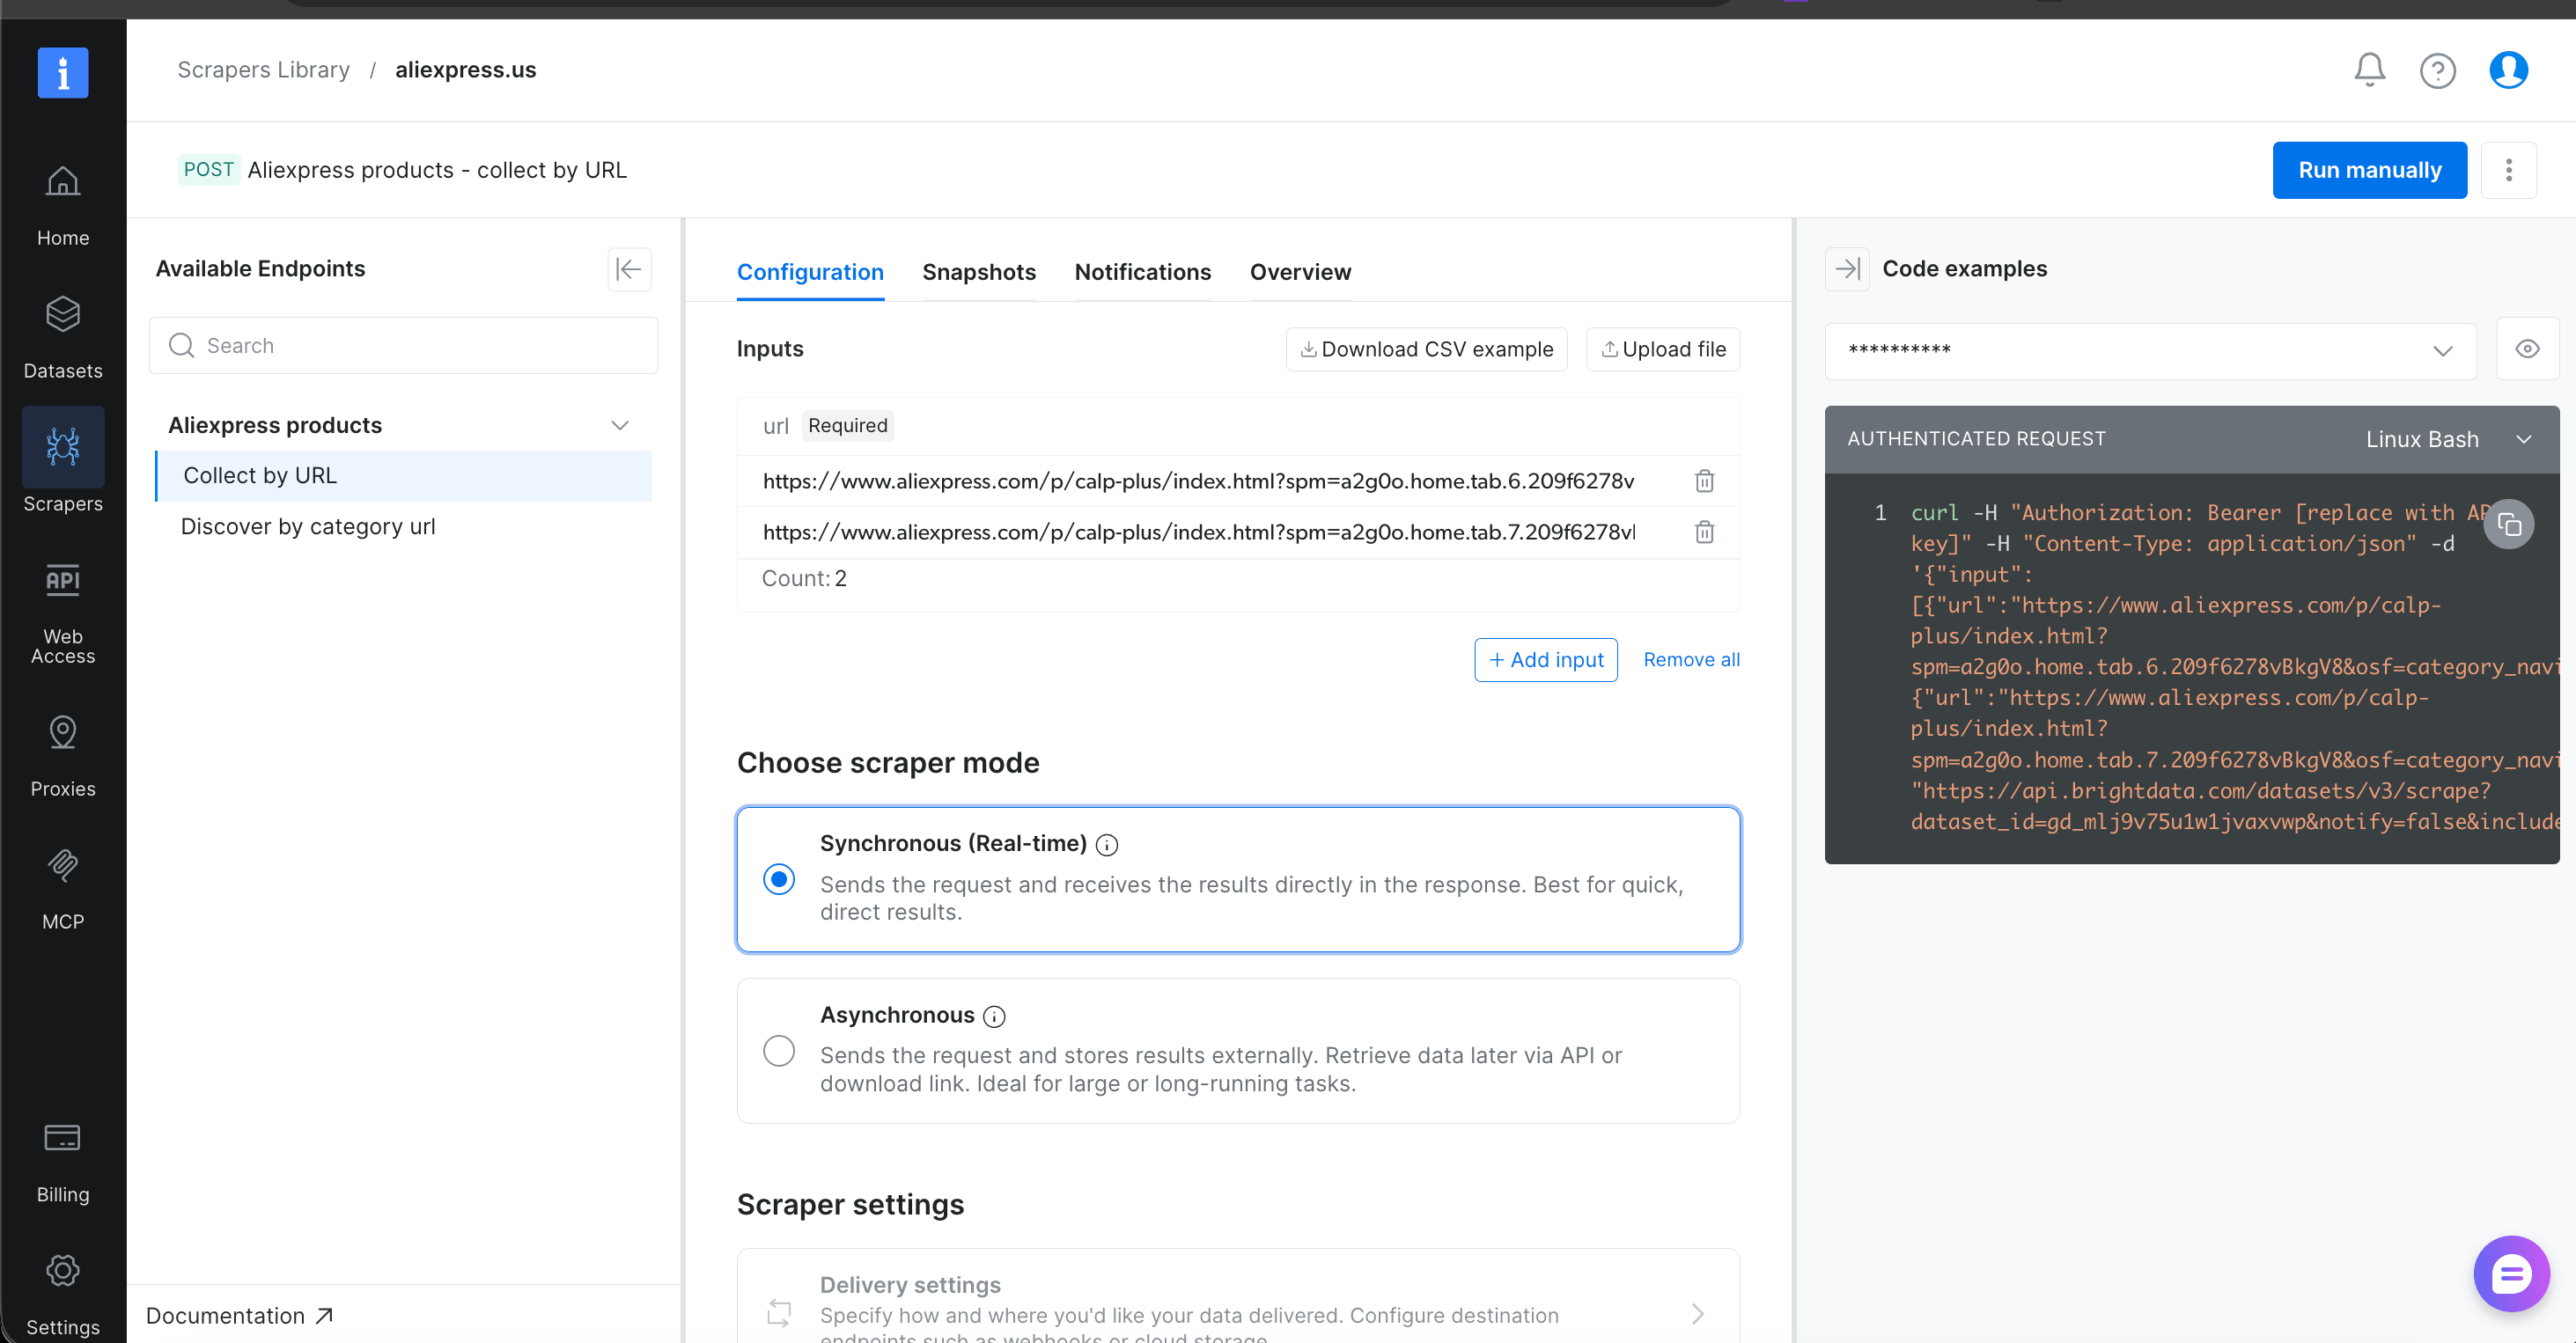
左パネルには、ドメインの2つのエンドポイント、「Collect by URL」と「Discover by category URL」が一覧表示されています。右側のコード例のdataset_idは、以下のスクリプトが使用するのと同じ値です。
同期モードは、収集に時間がかかる場合、snapshot_idを返し、収集はバックグラウンドで続行されます。カタログ全体の場合、非同期収集をチャンクでトリガーし、それぞれの後に進捗を保存してください。これにより、プロセスがクラッシュしても実行が再開され、同じURLに対して二重に料金を支払うことがなくなります。
import json, os, time, requests

API = "https://api.brightdata.com/datasets/v3"
DATASET = "gd_mlj9v75u1w1jvaxvwp"          # AliExpress products
TOKEN = os.environ["BRIGHTDATA_API_KEY"]   # API key from your account settings
CHUNK = 40                                 # larger triggers ran faster per input
H = {"Authorization": f"Bearer {TOKEN}", "Content-Type": "application/json"}

def _await(snapshot, timeout=3600, poll=20):
    deadline = time.time() + timeout
    while time.time() < deadline:
        p = requests.get(f"{API}/progress/{snapshot}", headers=H, timeout=60).json()
        if p.get("status") in ("ready", "failed"):
            return p
        time.sleep(poll)
    raise TimeoutError(snapshot)

def _save(state, state_path):
    with open(state_path, "w") as fh:
        json.dump(state, fh)

def run(urls, state_path="run_state.json", out_path="rows.jsonl"):
    state = {"done": {}, "dead": []}
    if os.path.exists(state_path):
        with open(state_path) as fh:
            state = json.load(fh)

    for n in range(0, len(urls), CHUNK):
        key = str(n // CHUNK)
        done = state["done"].get(key, {})
        if done.get("records") is not None:     # finished means downloaded, not triggered
            continue
        batch, t0 = urls[n:n + CHUNK], time.time()
        snapshot = done.get("snapshot")         # triggered before a crash: reuse that snapshot
        if not snapshot:
            r = requests.post(f"{API}/trigger?dataset_id={DATASET}&include_errors=true",
                              headers=H, json={"input": [{"url": u} for u in batch]},
                              timeout=120)
            r.raise_for_status()
            snapshot = r.json()["snapshot_id"]
            state["done"][key] = {"snapshot": snapshot}
            _save(state, state_path)            # record the trigger BEFORE the wait

        print(f"chunk {key}: collecting {len(batch)} URLs")
        progress = _await(snapshot)
        rows = requests.get(f"{API}/snapshot/{snapshot}?format=json",
                            headers=H, timeout=600).json()
        with open(out_path, "a") as fh:
            for row in rows:
                if row.get("error_code") == "dead_page":   # listing removed on AliExpress
                    state["dead"].append(row["input"]["url"])
                elif not row.get("error"):
                    fh.write(json.dumps(row) + "\n")
        state["done"][key].update(records=progress.get("records"), errors=progress.get("errors"))
        _save(state, state_path)
        print(f"chunk {key}: collected at {(time.time() - t0) / len(batch):.1f}s per input")

    return state

run(["https://www.aliexpress.com/item/1005001398867186.html"]) # pass your full URL listinclude_errors=trueは結果にエラーレポートを追加するため、リスト内のすべてのURLにステータスが付きます。
rows.jsonlの各行は1つの商品レコードです。このスクリプトは最初のレコードからいくつかのフィールドを出力します。
import json

with open("rows.jsonl") as fh:
    row = json.loads(fh.readline())
for key in ("item_id", "title", "brand", "price", "sale_price",
            "availability", "star_rating", "review_count"):
    print(f"{key:13s}", row[key])
print("variants     ", [o["option_name"] for o in row["variants"][0]["variant_options"]])
出力は最初のセクションの回路ブレーカーを示しています:
item_id       1005001398867186
title         TOMZN Main Switch Residual Current Circuit Breaker With Surge Protector RCBO MCB With Lightning Protection SPD
brand         TOMZN
price         $14.40
sale_price    $8.40
availability  in_stock
star_rating   4.7
review_count  80
variants      ['16A', '20A', '25A', '32A', '40A', '50A', '63A']
リスト価格、80件のレビューからの4.7評価、7つの電流定格バリエーションは、最初のセクションでレンダリングされたページと一致しています。セール価格は一時的なプロモーションによるもので、キャプチャごとに異なります。
各チャンクを満杯に保ってください。これらの実行では、40 URLのトリガーは20 URLのものよりURLあたり2.8倍速く完了しました。最後のチャンクは次の実行からURLで埋めて、フルサイズで実行されるようにしてください。数十万のURLの場合、Bright Dataに各スナップショットを配信させ、クラウドストレージやWebhookに送信させることで、結果がポーリングなしで届きます。
同じステートファイルでrun()を再実行すると、0.08秒で完了し、トリガーは送信されず、重複行も書き込まれませんでした。このスクリプトは、待機中にプロセスがクラッシュする前にトリガーされたチャンクも処理します。レコードがすでにダウンロードされている場合にのみチャンクをスキップします。それ以外の場合は保存されたスナップショットを再利用するため、待機中のクラッシュで収集済みのスナップショットが失われることはありません。
価格がどれくらいの頻度で変わるかを測定し、その頻度に収集スケジュールを合わせてください。あるチェックでは、25分間隔で2回、12個の商品をキャプチャしましたが、価格はどれも変わっていませんでした。そのサンプルは価格変更率を示すことはできないため、結果ではなく方法に注目してください。検討している間隔で自分の商品を2回スナップショットすれば、自分のカタログに関する答えが得られます。
Discovery、つまりスクレイパーのcategory別発見エンドポイントは、シードURLから商品を一覧表示します。卸売検索ページ/w/wholesale-ergonomic-chair.htmlをシードとして、type=discover_new&discover_by=category_urlリクエストは最初の実行で商品URLを返しました。シードURLパターンとして/w/wholesale-<keyword>.htmlを使用し、キャリブレーション中はすべてのディスカバリー実行をlimit_per_inputで制限し、返されたURLを収集実行に直接渡してください。
商品サイトマップや商品ページのSEOリンクなど、他の場所から商品IDを収集している場合は、レンダリングなしの単一GETリクエストで、各IDがまだ商品ページを持っているかどうかがわかります。商品ページはog:titleが設定された77.2から77.4KBを返した一方、それらのSEOリンクから収集した3つのIDはog:フィールドがすべて空の75.26KBを返しました。この2KBの差は生のレスポンスで確認できるため、収集をキューに入れる前にog:フィールドが空のIDを除外してください。
価格データを比較可能にする2つのチェック
データにはHTTPレスポンスと同じ検証が必要です。これら2つのチェックはそれぞれ追加コストが低く、ダッシュボードに届く前に比較できない価格をキャッチするのに役立ちます。
割引額は通貨だけでなく出口国によっても変わりました。1つの商品IDをWeb Unlocker経由で6つの出口国からマークダウン形式で取得したところ、それぞれの国で異なるプロモーションが返されました。
| 出口国 | 通貨 | セール価格 | リスト価格 | 割引 |
|---|---|---|---|---|
| 米国 | USD | $6.84 | $14.40 | 52.5% |
| 英国 | GBP | £9.83 | £11.16 | 11.9% |
| ドイツ | EUR | 11,69€ | 13,29€ | 12.0% |
| ブラジル | BRL | R$62,25 | R$68,30 | 8.9% |
| オーストラリア | AUD | AU$18.59 | AU$19.42 | 4.3% |
| カナダ | CAD | C$19.86 | C$20.70 | 4.1% |
パーセンテージですら直接比較はできず、各ページがその理由を示しています。米国の購入ボックスはその価格をEnds :とラベル付けしているため、米国の行はある瞬間にキャプチャされた期間限定セールです。英国のページにはPrice includes VATとある一方、米国のページにはTax excludedとあります。ドイツのページには30-day lowest price before the discountとあり、これはEUの参照価格ルールで、ドイツの割引を小さく見せる傾向があります。
これら3つの違いがあるため、価格シリーズごとに1つの出口国を設定し、それを行に保存して、1つのシリーズはそれ自身とのみ比較してください。Web Unlockerはcountryパラメータで、Browser APIはゾーンのユーザー名に-country-<code>サフィックスで設定します。価格パイプラインではなくプロモーション自体が必要な場合は、AliExpress Promotions Trackerが競合のプロモーションを監視してくれます。
英国のポンド記号は全角のものです。英国のストアフロントは£(U+FFE1 全角ポンド記号)を使用するため、£(U+00A3)で書かれた通貨の正規表現は何にもマッチしません。ドイツとブラジルのストアフロントは価格フィールドで小数点区切りとしてカンマを使用します。リクエストしたストアフロント設定から通貨を解析し、数値の解析は記号とは別に行ってください。
各バリエーションの価格と完全なカテゴリパス
Bright DataのBrowser APIはAliExpressの商品ページからSKU価格マップをキャプチャし、Web UnlockerはフッターからカテゴリのパンくずリストをCまず返します。レビューにも専用のスクレイパー、AliExpress Reviews Scraperがあり、そのレコードには商品IDとURLが含まれます。
ページ自身のレスポンスにはSKU価格マップが含まれています。capture_pdpでログに記録したキャプチャには、141、75、20、18、15、6個のSKUの価格が含まれていました。1つの商品について、価格マップには2.56から10.96までの6つの異なる価格がありました。このマップは、プリセレクトされたSKUとregionフィールドの隣にあるPRICEモジュール内にあります。
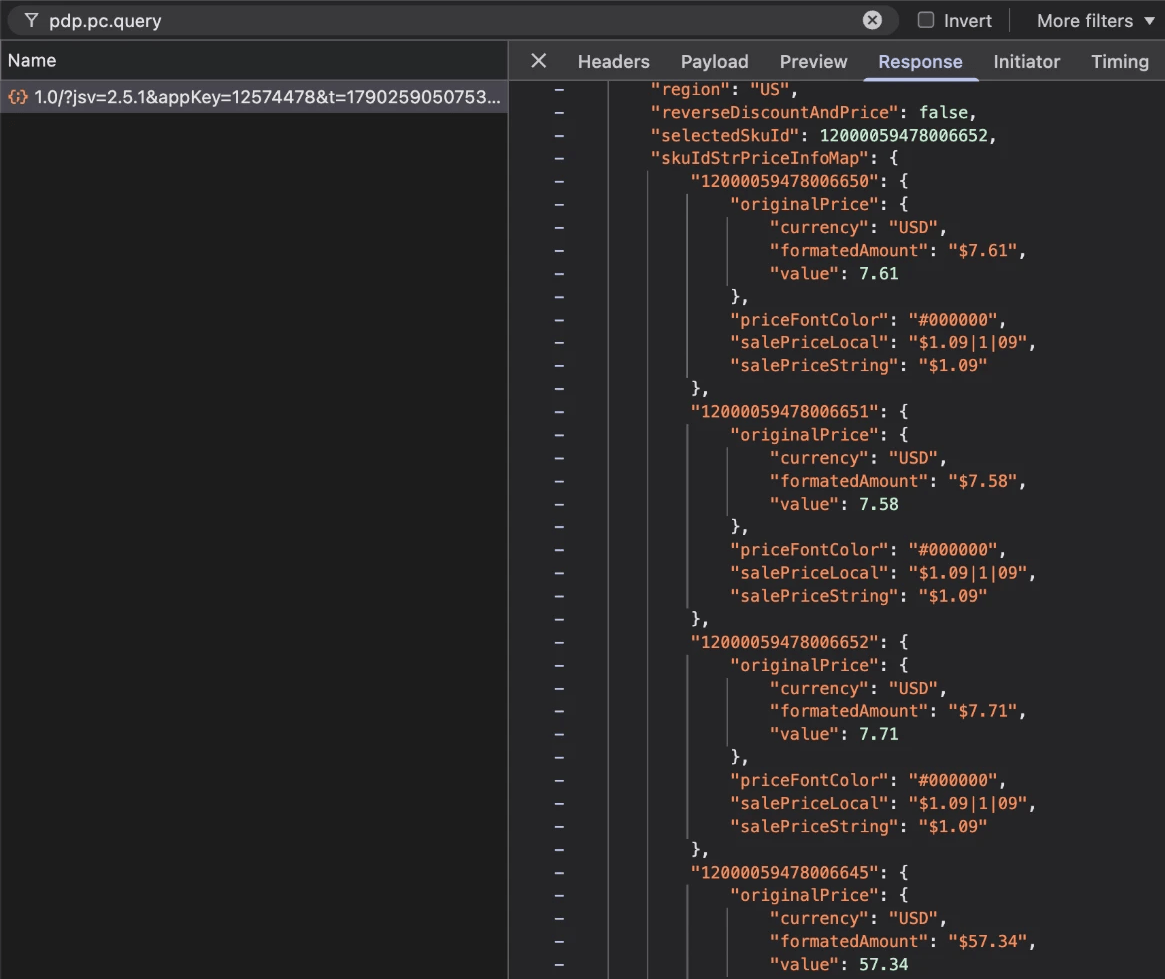
このキャプチャはマルチパックのリスティングからのものです。ページは$1.09の1パックをプリセレクトしており、4番目のエントリは$57.34の10パックなので、このマップには各バリエーションの価格が含まれています。
各バリエーションの価格を取得するには、Browser API経由でcapture_pdpを実行し、PRICE.skuIdStrPriceInfoMapを読み取り、item_idをキーとして保存してください。価格が必要な地域からマップを読み取ってください。それも地域によって異なる可能性があるためです。最初のセクションの回路ブレーカーについて、マップは米国のセッションでは異なるバリエーション価格を持ち、別の地域では7つすべてのバリエーションに単一の価格を持っていました。
Web Unlockerのマークダウンにはカテゴリパスが含まれています。レンダリングされたページはフッターに商品のカテゴリをパンくずリストとして一覧表示し、ゲートウェイのGLOBAL_DATA.globalDataはcategoryPathフィールドに同じパス13/5/141914を持っています。以下のパーサーは、brightdata scrapeがデフォルトで返す形式である、Web Unlockerのマークダウンとして商品ページを読み取ります。
import re

CRUMB   = re.compile(r"^This product belongs to\s.*$", re.M)
CAT_URL = re.compile(r"/category/(\d+)/([a-z0-9-]+)\.html")

def categories_from_markdown(md):
    """Category IDs and URLs from the product page footer."""
    line = CRUMB.search(md)
    if not line:
        return []
    return [{"category_id": cid,
             "url": f"https://www.aliexpress.com/category/{cid}/{slug}.html"}
            for cid, slug in CAT_URL.findall(line.group(0))]

with open("page.md", encoding="utf-8") as fh:    # brightdata scrape <product URL> -o page.md
print(categories_from_markdown(fh.read()))最初のパターンの末尾にある\sは不可欠です。フッターはtoの直後にU+00A0(ノーブレークスペース)を入れているためです。リテラルのスペースで書かれた同じパターンは何にもマッチしません。\sを使うと、パーサーはカテゴリパスを返します。
[{'category_id': '13',     'url': '.../category/13/home-improvement.html'},
 {'category_id': '5',      'url': '.../category/5/electrical-equipments-supplies.html'},
 {'category_id': '141914', 'url': '.../category/141914/circuit-breakers.html'}]
カテゴリパスの取得には商品ごとに1回のWeb Unlockerリクエストが必要です。タクソノミーが必要な商品に対してパーサーを実行し、item_idをキーとして結果を保存してください。フッターの文言は予告なく変わる可能性があるため、パーサーが空のリストを返した場合はまずCRUMBパターンを確認してください。
Scraper Studioはカスタムフィールドリストを処理します。必要なデータを説明すると、そのAIがプロキシとアンブロック機能を組み込んだ、すぐに実行できるスクレイパーを生成し、後から出力フィールドを追加・変更できます。特に価格監視については、AliExpress Price Scraper APIがAliExpressの価格データを収集し、価格の変化を追跡できます。
ページとスキーマの変化の検出
このターゲットで見られた失敗はすべてサイレントだったため、ページ自体を監視してください。ページのブートストラップスクリプトにはビルドバージョンcosmos_prefetch_mtop version 20240605.195626.856が含まれており、そのバージョンが変わると、プリフェッチ設定もそれに伴って変わる可能性があります。フィンガープリントはその変化を直接検出します。それがなければ、自分のスクレイパーはそれをnull値としてしか示しません。
以下の2つのフィンガープリントは3つの段階(HTMLシェル、レンダリングされたページ、配信された行)をチェックし、どちらも商品フィールドの解析には依存していません。
import hashlib, re

def shell_fingerprint(html):
    """From an unrendered GET. Detects a bootstrap or prefetch-config change."""
    view = re.search(r"viewName\s*=\s*'([^']+)'", html)
    api  = re.search(r"api:\s*'(mtop\.[^']+)'", html)
    ver  = re.search(r"cosmos_prefetch_mtop version ([\d.]+)", html)
    return {"viewName": view.group(1) if view else None,
            "prefetch_api": api.group(1) if api else None,
            "gop_version": ver.group(1) if ver else None}

def row_fingerprint(row):
    """From a delivered row. Confirms the field set your pipeline expects."""
    keys = sorted(k for k in row if k not in ("input", "timestamp"))
    return {"fields_sha1": hashlib.sha1(",".join(keys).encode()).hexdigest()[:12]}
実際のキャプチャでは、両方のフィンガープリントが安定した値を返しました。
shell   unrendered GET : viewName=newDetail  api=mtop.aliexpress.pdp.pc.query  gop=20240605.195626.856
shell   rendered DOM   : viewName=newDetail  api=mtop.aliexpress.pdp.pc.query  gop=20240605.195626.856
row     1005012408061151 : fields_sha1=154f2f84da5f
row     1005001398867186 : fields_sha1=154f2f84da5f
row 1005011666876666 : fields_sha1=154f2f84da5fキャプチャしたペイロードの3つ目のフィンガープリントは役立ちそうに見えますが、誤検知を引き起こす可能性があります。モジュールセットのハッシュ化は同じ発想に見えますが、モジュール数は新しいデプロイだけでなく、リスティングやキャプチャの時刻によっても異なりました。キャプチャしたペイロードには28、27、28のモジュールがあり、PRICEのキーセットはそのうち2つの間で異なっていました。
この数は1つの商品内でも変わりました。同じ商品IDは数分間隔の2回のキャプチャで27モジュール、その後26モジュールを返したため、商品ごとの履歴であっても等価性チェックではなく閾値が必要です。アラートはシェルと行のフィンガープリントに基づいて設定してください。これらの値はすべてのキャプチャで同じままだったためです。
代わりにAliExpressデータセットを購入すべき時
これら3つの方法はすべて、すでに持っているURLから始まります。質問が市場全体に関するものであれば、すぐに使えるデータセットから始めてください。
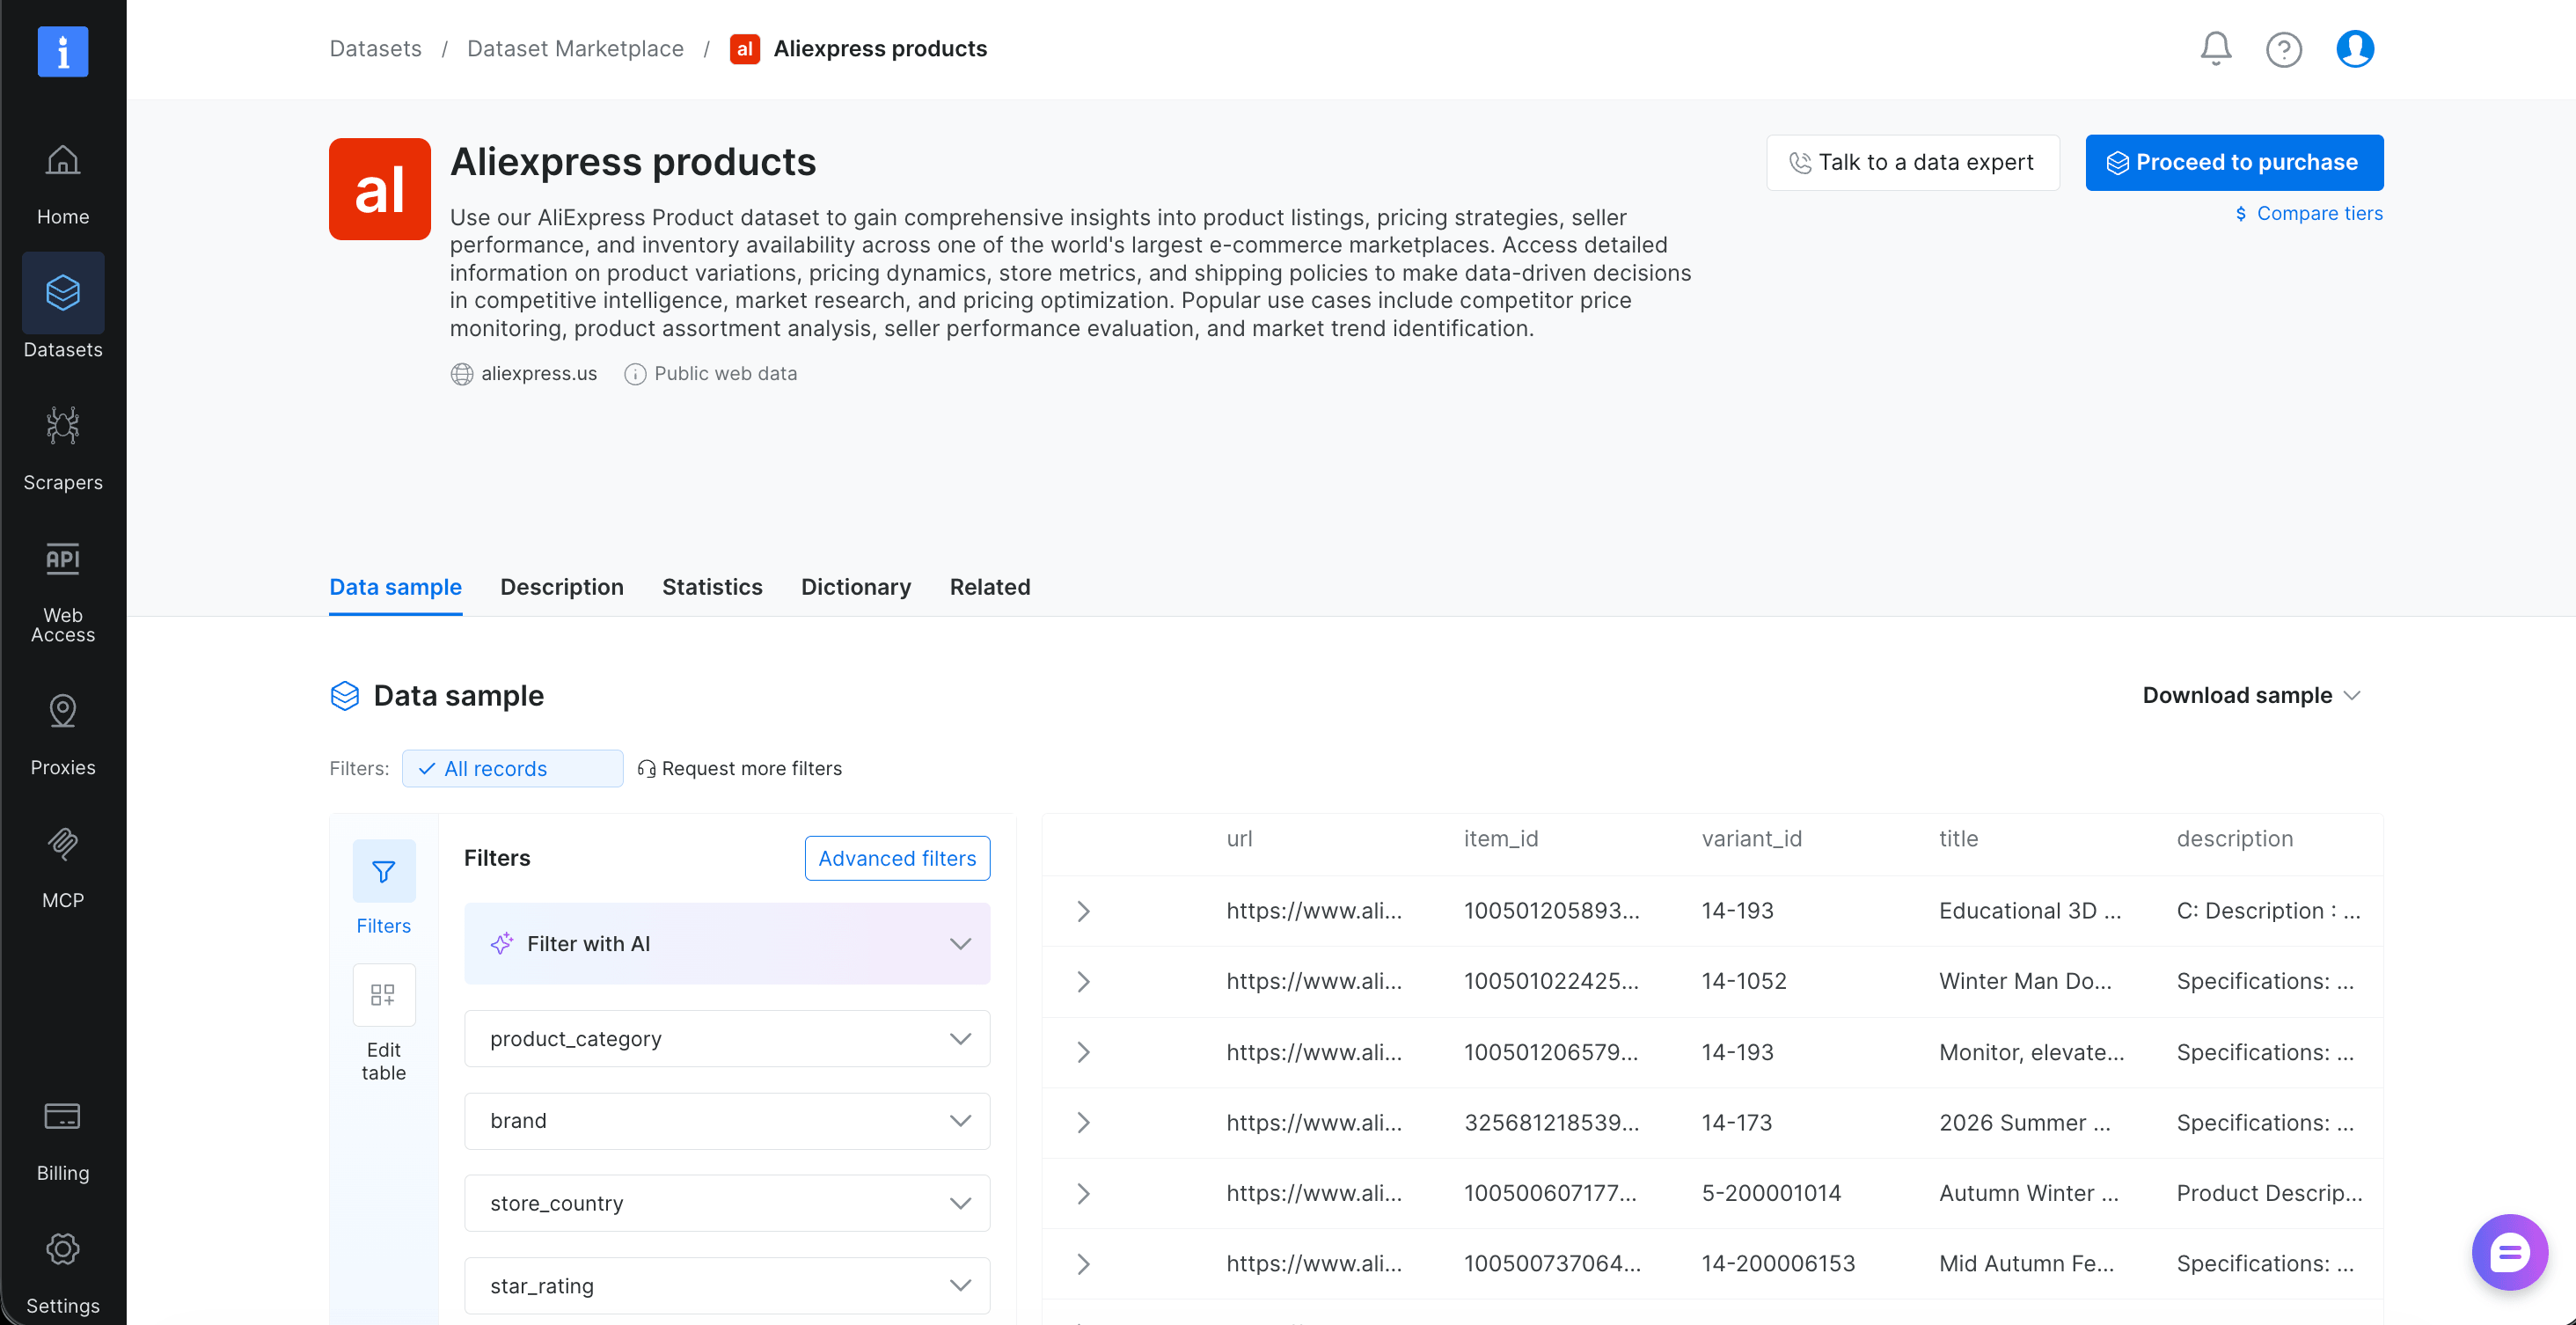
フィルターパネルでは、支払う前にレコードを選択できます。
AliExpressデータセットは選定作業と収集時間を削減します。マーケットプレイスまたはFilter Dataset API経由で必要なレコードにデータセットをフィルタし、フィルタされたスナップショットに対してのみ支払います。これらのレコードはすでに存在するため、待つべき収集実行はありません。1回限りまたは選択した更新スケジュールで購入でき、現在の価格はデータセット料金ページに掲載されています。
注文前に配信サイズを見積もってください。データセットサンプル内のレコードは、配信されるJSONとして平均12.75KBなので、10万レコードあたり約1.3GBを見込んでください。データセットはParquet形式でも配信され、同じサンプルをParquetに変換すると、ほぼ8倍小さくなりました。このサイズの違いは、ファイルをその場でクエリするか、最初にステージングするかを左右する可能性があります。
市場全体の品揃えとカバレッジに関する質問にはデータセットを使い、追跡している特定のリスティングにはScraper APIを使用してください。データセットは選択したスケジュールで更新され、Scraper APIの収集は実行した瞬間の各リスティングを返します。
最後に
AliExpressの署名スキームは1つの関数に収まりますが、テストでは、正しい署名があっても、ゲートウェイは最初の十数回のリクエスト以内に1つのIPアドレスからの呼び出しをブロックしました。ブロックは成功ステータスコードを返すことがあるため、すべてのチェックはbxpunishヘッダーと、価格のようなすべての商品が持つフィールドに基づいて行ってください。サイトのrobots.txtは公開されている/item/パスを禁止していないため、それが大規模にスクレイピングすべきパスです。
Bright DataのAliExpress Scraper APIはそれらの商品ページの構造化レコードを返し、Browser APIは各バリエーションの価格をキャプチャし、AliExpressデータセットは市場全体に関する質問に適しています。クレジットカード不要で月5,000リクエストを含む無料プランから始めてください。自分のカタログから40個のURLでテストし、パイプラインが必要とするフィールドに対してレコードを確認してください。
FAQ
AliExpressには商品データ用のAPIがありますか?
はい、販売者、アフィリエイト、承認されたドロップシッパー向けにあります。AliExpress Open Platformでは、販売者はOAuth 2.0を通じて自身のストア用にアプリを認可でき、アフィリエイトAPIはプロモーション用カタログをカバーします。どちらもマーケットプレイス全体をカバーしているわけではないため、市場レベルの価格データにはeコマースデータ収集が必要です。
AliExpressの商品URLやIDはどうやって取得しますか?
商品URLは/item/<item_id>.htmlのパターンに従い、ディスカバリーは/w/wholesale-<keyword>.htmlから始まります。IDはホストによって異なります。ある商品は.comでは1005001398867186、.usでは3256801212552434というIDを持っています。各商品は地域リダイレクト後の最終URLをキーとしてください。そうすることで2つのIDで現れることがなくなります。
AliExpressの商品データのスクレイピングは無料ですか?
小規模であれば、はい。Bright Dataの無料プランには、クレジットカード不要で月5,000リクエストが含まれており、Scraper API、Web Unlocker、Browser APIをカバーしているため、まず自分のURLでテストできます。Playwrightとcurl_cffiはオープンソースです。本番規模では、主にIPアドレスに対して支払うことになります。1つのIPアドレスから60回の署名付きAPI呼び出しを2回実行したところ、データを取得できたのはそれぞれ7回と15回だったためです。
AliExpress scraper APIの料金はいくらですか?
Bright DataのAliExpress Scraper APIは配信されたレコードあたりで価格設定されており、Web Unlockerは成功したリクエストあたりで価格設定されているため、結果に対してのみ支払います。Browser APIはトラフィックによって価格設定されているため、ページの重さがそのコストを予測します。テストでは商品ページは約3MBでした。現在の価格はBright Dataの料金ページに掲載されています。
AliExpressスクレイパーが空のフィールドを返すのはなぜですか?
最初のHTMLには価格も在庫もないためです。window.runParamsは空オブジェクトで<title>は空なので、セレクターベースの抽出ツールは何にもマッチせずエラーも発生しません。ページのJavaScriptは後でmtop.aliexpress.pdp.pc.queryからフィールドを読み込みます。JavaScriptを実行するか、そのAPIを直接呼び出してください。
AliExpressのスクレイピングでブロックされないようにするには?
Bright DataのScraper APIまたはWeb Unlockerを通じてリクエストを送信してください。これらには組み込みプロキシとAliExpress CAPTCHAの解決機能があります。テストでは、新しいクッキージャーも60秒の待機も、1つのIPアドレスからのブロックを解除しませんでした。ブロックされたリクエストもHTTP 200を返したため、ステータスコードではなくbxpunishヘッダーを確認してください。
AliExpressの価格が変わるのはなぜですか?
プロモーションが一時的なもので、国によって異なるためです。6つの出口国にまたがる1つのテストでは、ある商品の割引はリスト価格に対して52.5%から4.1%までの範囲で、国によって価格に税金が含まれているかどうかも異なりました。価格シリーズごとに1つの出口国を設定し、それを行に保存してください。
AliExpress MCPサーバーはありますか?
はい。Bright DataのMCP Serverは、AIエージェントがscrape_as_markdownとscrape_batchツールを通じてAliExpressの商品ページを取得できるようにし、これらはアンブロック処理を行いマークダウンを返します。テスト呼び出しでは、scrape_as_markdownが商品の価格、評価、バリエーション、カテゴリパスを返しました。AliExpress MCPページで設定方法を説明しています。