Yelpのスクレイピングとは、感情分析、市場調査、営業リードのためにビジネスリスティング、評価、レビューを収集することです。YelpのセルフサーブAPIプランには1ビジネスあたり最大7件のレビュー抜粋しか含まれていませんが、yelp.comでは全文が表示されます。
Yelpのボット保護は、私たちが送信したすべてのPython HTTPリクエストに対してチャレンジページを返しました。ローカルのChromiumブラウザはスライダーCAPTCHAを受け取りました。ビジネスページが読み込まれた場合でも、そのHTMLには全文のレビューテキストがありませんでした。
このガイドでは、Yelpがデータを保存している場所と、Pythonでビジネス詳細と全文レビューを収集する方法を示します。また、Bright DataのYelp Scraper APIを使用すべきタイミングについても説明します。
TL;DR
- Yelpのボット保護であるDataDomeは、TLSなりすましとUSレジデンシャルIPを使用してもPython HTTPクライアントをJavaScriptチャレンジで止めました。Bright DataのWeb Unlocker APIはテスト対象の30件すべてのビジネスページを読み込みました。
- 全文レビューはYelpのGraphQL APIから取得でき、1回の呼び出しで最大49件。あるレストランの582件の推奨レビューは12回の呼び出しで取得できました。
- 永続化クエリIDはYelpがデプロイすると変わることがあり、Browser APIスクリプトが新しいIDを取得します。あるオープンソースのスクレイパーは古いIDを公開していました。
- Bright DataのYelp Scraper APIはパーサーとクエリIDのメンテナンスを代行しますが、レビューあたりの単価は高くなります。またYelpが推奨しないレビューも収集します。
Yelpのスクレイパーをブロックするもの
私たちのテストでは、Yelpのページは商用ボット保護サービスであるDataDomeによって保護されていました。ブロックされたレスポンスにはそのヘッダー(server: DataDomeおよびx-datadome: protected)が含まれ、datadomeクッキーが設定されました。
複数のクライアント設定からYelpのビジネスページへのリクエストを送信しました。クライアントには、ブラウザのTLSハンドシェイクになりすますPython HTTPクライアントであるcurl_cffiが含まれていました。
自宅のブロードバンドでは、どの設定も同じページをリクエストしました。USレジデンシャルプロキシ経由では、各クライアントが12の異なるページをリクエストしました。どの設定もチャレンジを通過できませんでした。
| クライアント | ネットワーク | Yelpが返したもの |
|---|---|---|
requestsとhttpx (HTTP/2) |
米国外の自宅ブロードバンド | 各5件中5件が403 CAPTCHAページ |
Chrome、Safari、またはFirefoxのTLSプロファイルを使用したcurl_cffi |
米国外の自宅ブロードバンド | 各5件中5件が403デバイスチェックページ |
Chrome TLSプロファイルとPython User-Agentを使用したcurl_cffi |
米国外の自宅ブロードバンド | 5件中5件が403 CAPTCHAページ |
requestsとcurl_cffi |
USレジデンシャルプロキシ、リクエストごとに新規IP | 各12件中12件が403デバイスチェックページ |
| ヘッドレスChromiumを使用したPlaywright | 米国外の自宅ブロードバンド | 403 CAPTCHAページ |
| ヘッド付きChromiumを使用したPlaywright | 米国外の自宅ブロードバンド | まずデバイスチェック、その後8秒以内にスライダーCAPTCHA |
これらの設定からの403レスポンスはすべてDataDomeのチャレンジページでした。ページにはvar dd={...}オブジェクトが埋め込まれており、そのオブジェクトのrtフィールドがチャレンジの種類を示していました。値cはCAPTCHAスクリプトを読み込み、iはデバイスチェックページを読み込みました。
自宅接続では、requestsとhttpxはcを取得しました。ブラウザのTLSプロファイルを使用した場合、curl_cffiはiを取得し、Python User-Agentを使用した場合は再びcを取得しました。USレジデンシャルIP経由では、requestsライブラリもiを取得しました。curl_cffiでHTTP/1.1を強制しても同じデバイスチェックページが返されました。
デバイスチェックはJavaScriptを実行し、HTTPクライアントはそれを実行できません。ヘッド付きブラウザはデバイスチェックを実行し、その後このスライダーを受け取りました。
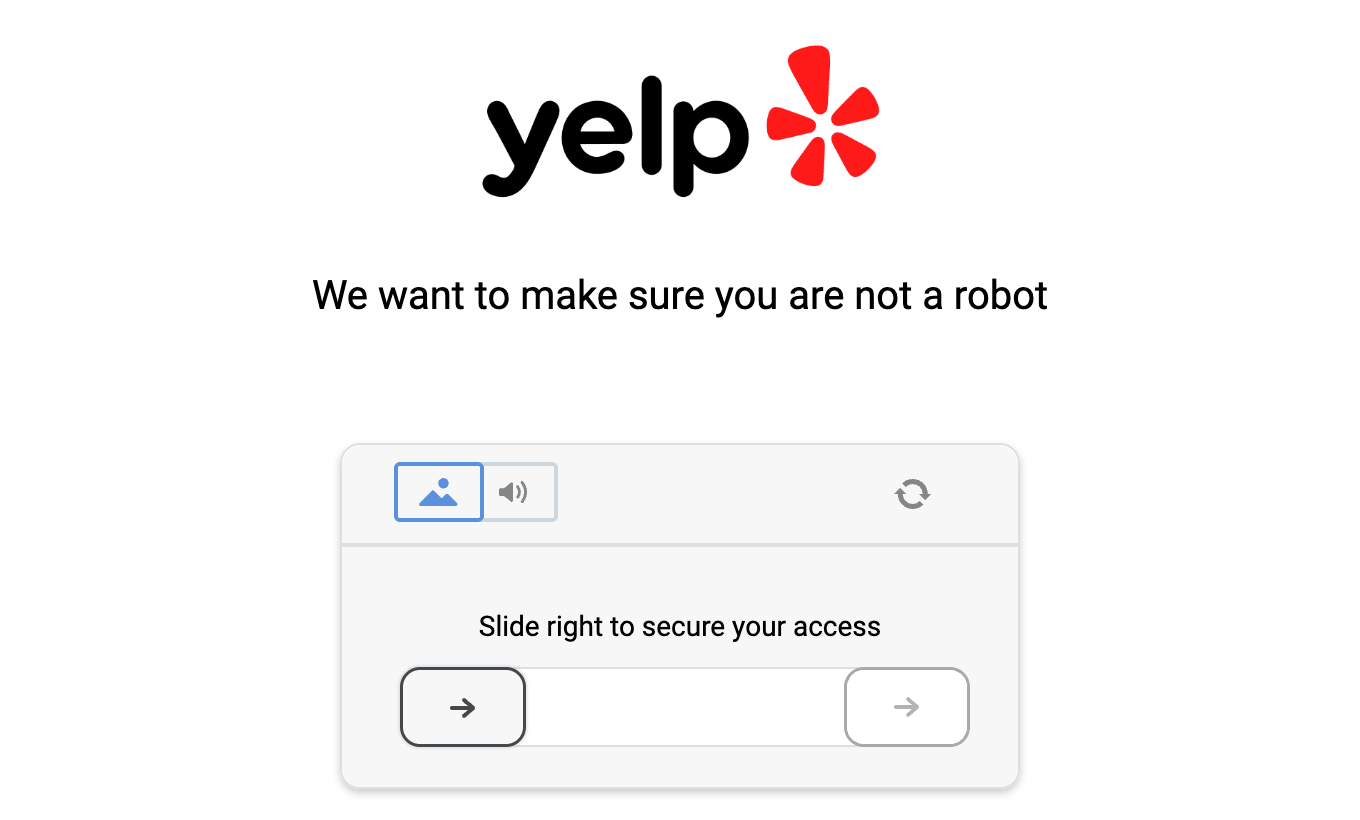
自宅接続上のヘッド付きChromiumセッションでは、ページ読み込みから8秒以内にこのスライダーが表示されました。人間がスライダーをドラッグしなければならない場合、スクレイパーは自動的に実行できません。
HTTPクライアントは、USレジデンシャルIP経由であっても、実行できないJavaScriptチャレンジで止まりました。ブラウザはJavaScriptを実行できましたが、単一の自宅IPを使用し、YelpはそのIPにCAPTCHAページを返しました。Bright DataのWeb Unlocker APIは、ブラウザ環境、IP、そしてDataDomeチャレンジを代わりに処理し、Yelp上のCAPTCHAも含まれます。PythonスクレイパーのすべてのYelpリクエストはこれを使用します。
Yelpがビジネスとレビューのデータを保存する場所
Playwrightで制御するクラウドブラウザであるBright DataのBrowser APIは、Yelpのビジネスページがどのようにデータを読み込むかを示します。1回のページ読み込みログでは、www.yelp.comへ12件のXHRおよびfetchリクエストが送信され、そのうち7件は/gql/batchへのPOSTリクエストでした。データは3つの場所にありました。
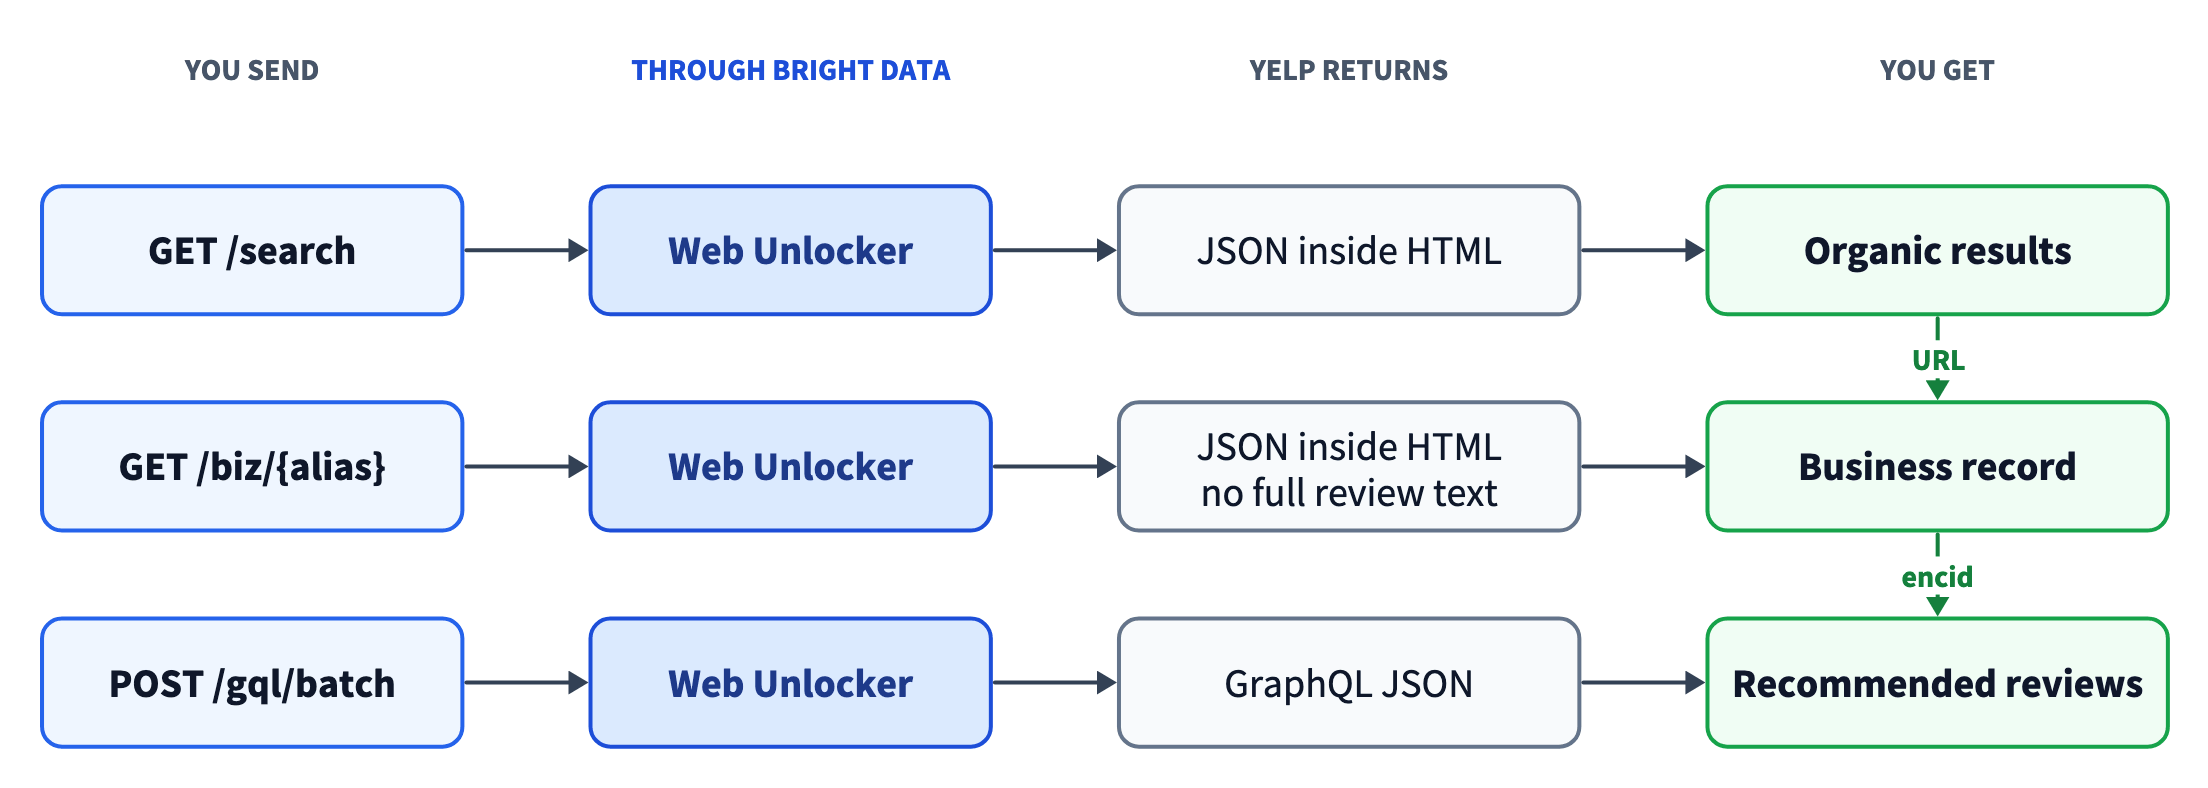
検索ページとビジネスページは、そのデータをHTML内のJSONとして含んでいました。レビューには、ページからのビジネスIDを使用する個別のGraphQL呼び出しが必要でした。
検索ページ
YelpはHypernovaを使用してサーバーで検索結果をレンダリングし、HTML内に2つのJSONオブジェクトを埋め込んでいました。<script data-hypernova-key>タグには結果カードのリストを含むページのプロップが含まれていました。<script data-apollo-state>タグにはApollo Clientキャッシュが含まれていました。両方のJSONオブジェクトはHTMLコメントでラップされており、Apolloキャッシュは HTMLエスケープもされていました(")。
この2つのオブジェクトは各結果をそれぞれに分割していました。オーガニックカードにはbizId、ランク、URLのみが含まれており、名前、評価、レビュー数はBusiness:<bizId>のApolloキャッシュにありました。スポンサー付きカードは逆で、詳細がインラインで含まれ、リンクは/adredirを経由していました。カードのみを読み込むパーサーは、スポンサー付き結果については完全な詳細を取得し、オーガニック結果については名前、評価、レビュー数を取得できません。
レンダリングされた検索ページでは、この2種類のカードは次のように見えました。
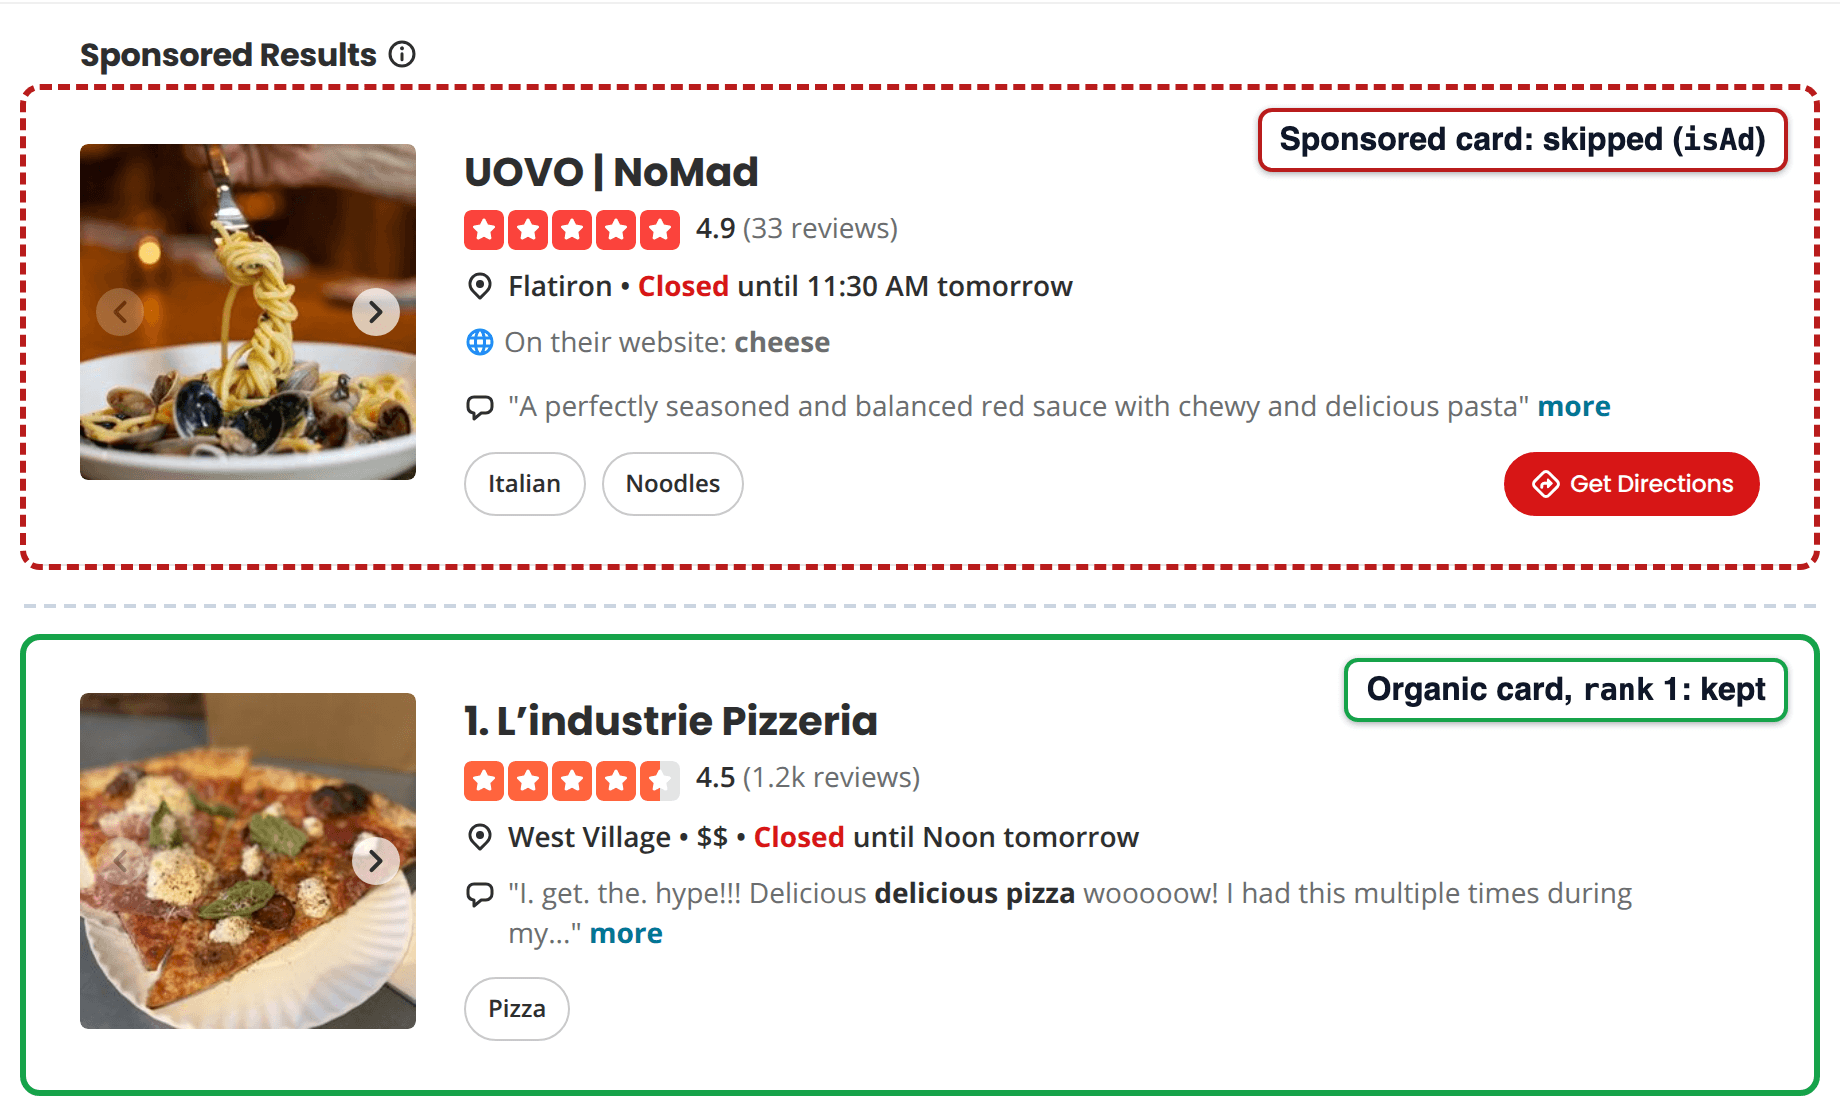
Yelpの検索では、番号付きのオーガニック結果の前にスポンサー付き結果が一覧表示されました。parse_search()は各オーガニックカードのランクを保持し、isAdとマークされたカードをスキップします。
Yelpの検索は結果数も制限していました。ページネーションブロックは、ダラスの「レストラン」を含む確認した4件のクエリすべてでtotalResults: 240を報告し、各ページには10件の結果が表示されました。都市全体の結果を収集するには、近隣地域、カテゴリ、または地図エリアでクエリを分割してください。
ビジネスページ
ビジネスページには同じApolloキャッシュが含まれており、そのキャッシュにはほとんどのビジネスフィールドがありました。ビジネスID(encid)、評価、レビュー数、住所、電話番号、価格帯、カテゴリ、認証ステータス、ウェブサイトが含まれていました。<meta name="yelp-biz-id">タグにもencidが含まれていました。検索カードは同じIDをbizIdと呼び、GraphQLリクエストはencBizIdと呼びます。
L’industrie Pizzeriaのページでは、これらのフィールドはヘッダーとサイドバーに表示されました。
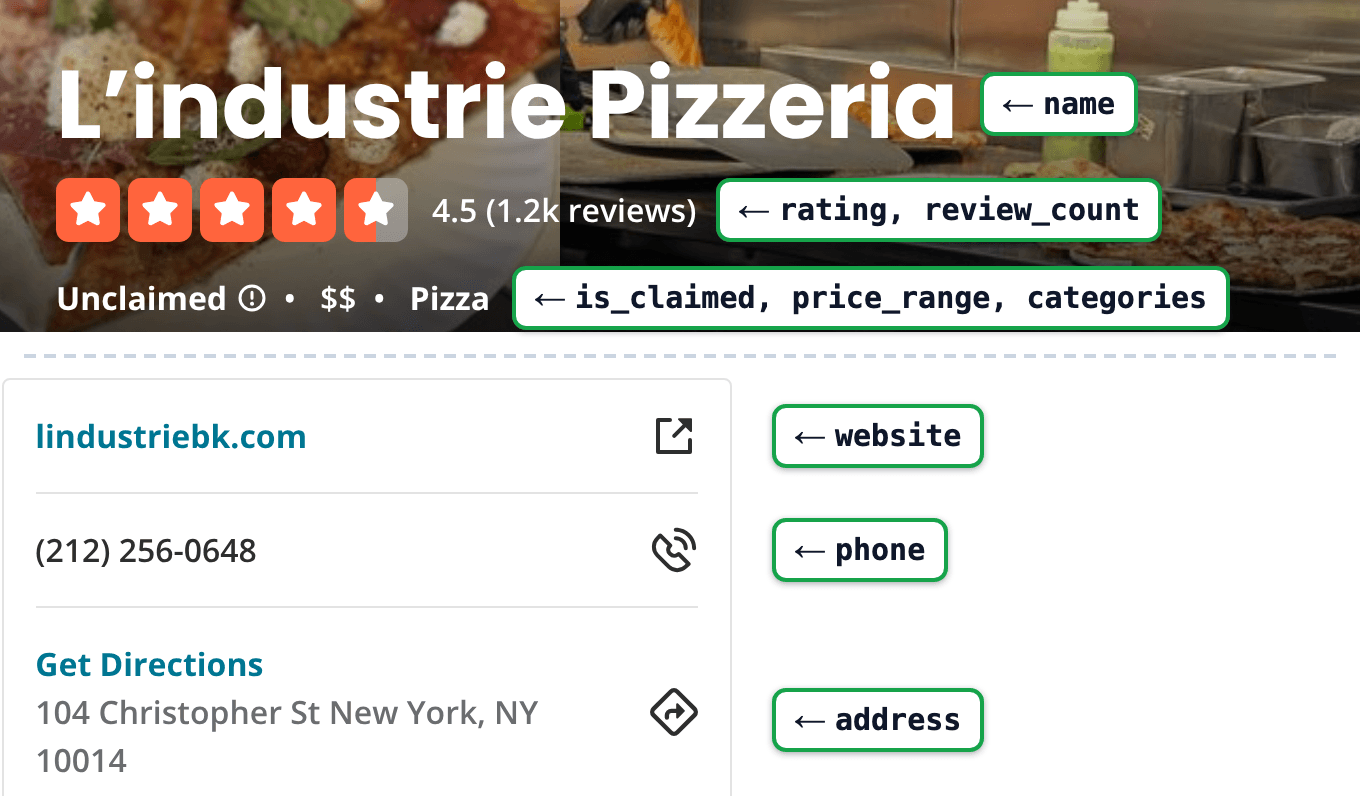
ラベルはparse_business()が返すキーであり、すべての値はページのHTML内のApolloキャッシュから取得されました。ページはレビュー数を1.2kに丸めていましたが、キャッシュには正確な数がありました。
古いガイドではJSON-LDから評価を読み取り、ページ自体からレビューを読み取っていました。保存した19件のビジネスページすべてで、JSON-LDブロックには写真リストとパンくずリストのみが含まれており、ビジネス評価はありませんでした。Apolloキャッシュには、19ページすべてで全文レビューがありませんでした。
これらのページのうち14件では、キャッシュにレビューIDと短いハイライトスニペットがあり、残りの5件にはレビューへの参照がありませんでした。全レビューリストは後で、ブラウザからのGraphQLリクエストを通じて読み込まれました。
GraphQL APIにおけるレビュー
レビューはYelpのGraphQLエンドポイントから取得されました。ページは/gql/batchへ操作のJSON配列を含むPOSTを送信し、GetBusinessReviewFeed操作がレビューリストを返しました。Yelpは永続化クエリを使用していたため、リクエストにはクエリテキストの代わりに64文字の永続化クエリID(documentId)が含まれていました。サーバーは認識しないIDを拒否しました。
レビューのページ2を開くと、このリクエストが送信されました。Chrome DevToolsで表示されています。
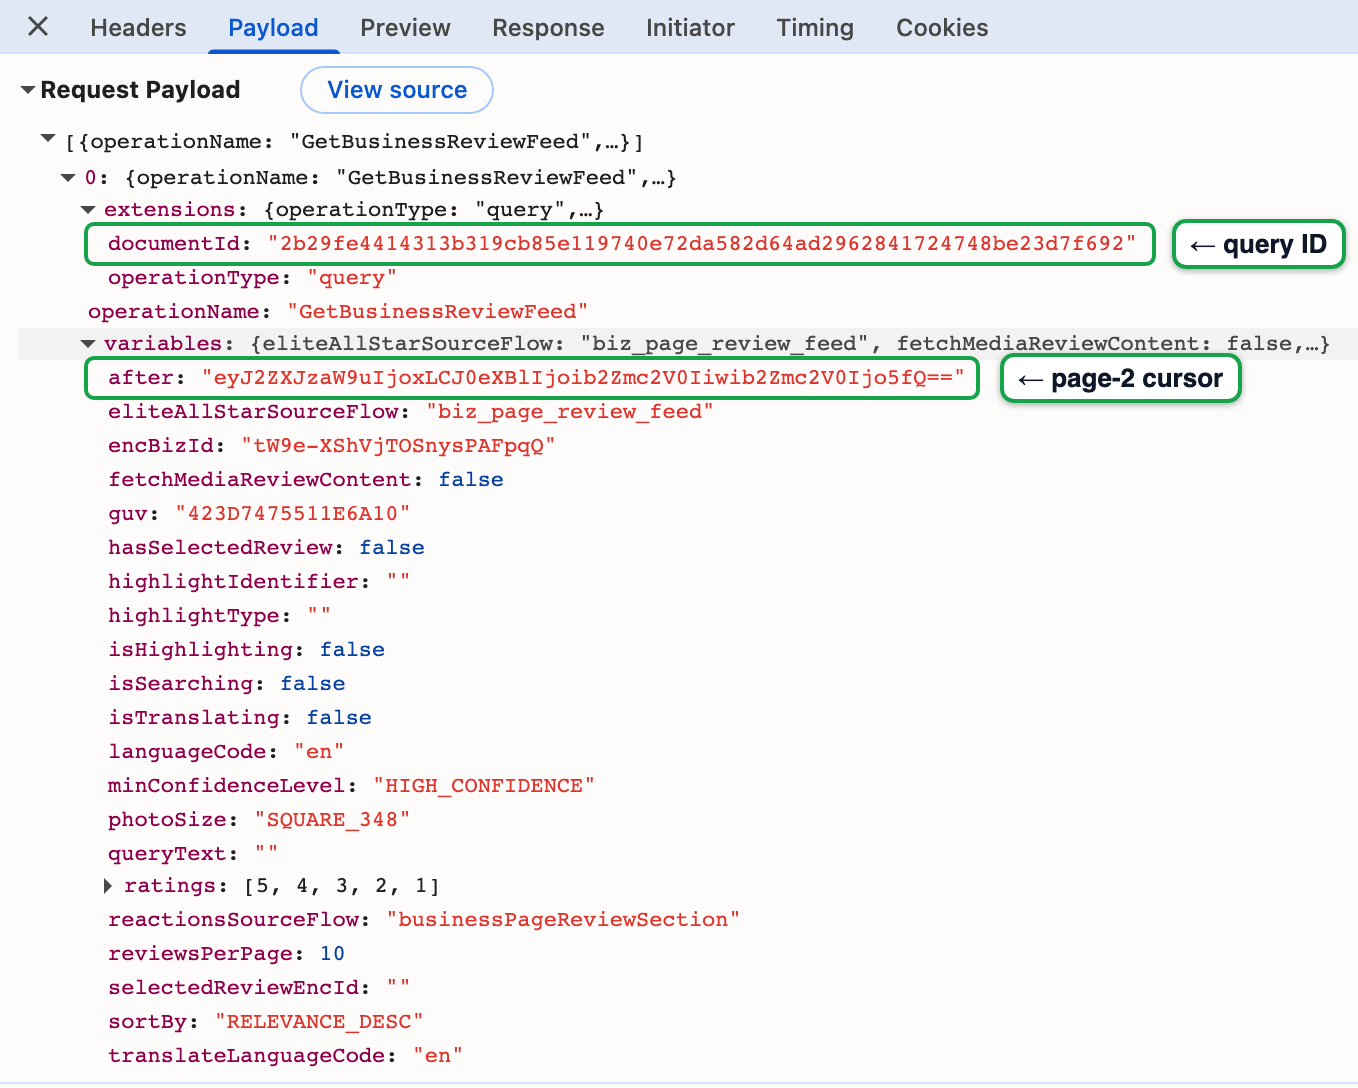
ページ自身のレビューページ2のリクエスト。スクレイパーは同じdocumentIdを送信し、afterカーソルを自分で構築します。
GraphQL APIは私たちのテストで次のように動作しました。
- ページサイズ:
reviewsPerPageは49を受け付けました。50という値はBAD_USER_INPUTエラーを返しました。 - ページネーション:
afterカーソルはbase64エンコードされたJSONでした。ブラウザは1ページあたり10件のレビューをリクエストし、そのページ2のカーソルは{"version":1,"type":"offset","offset":9}にデコードされました。この形式により、各ページのカーソルを自分で構築し、ページを並行して取得できます。 - 並び替えとフィルター:
sortByはRELEVANCE_DESC、DATE_DESC、DATE_ASC、RATING_ASC、ELITES_DESCを受け付けました。ratingsの値を[1]にするとtotalCountが35に減りました。これはGraphQLテストに使用したダラスのレストラン、Ziziki’sの星1つのレビュー数です。 - エラー:検証エラーはHTTP 200レスポンスで返され、各欠落変数が一覧表示されました。未知の
documentIdはブラウザでHTTP 403Forbiddenレスポンスを受け取りました。Web Unlocker経由では、同じリクエストはエラーコードhttp_statusを伴う502を返しました。これはYelpがエラーステータスを返したことを意味します。どちらのレスポンスにもDataDomeのチャレンジページは含まれていなかったため、古いIDはブロックのようには見えません。 - 範囲:
GetBusinessReviewFeedは、ビジネスページが一覧表示する、Yelpの推奨レビューセットを返しました。Yelpによれば、そのソフトウェアは信頼できない、依頼された、または不公平に偏っているとフラグを立てたレビューを別の非推奨リストに移動します。Ziziki’sの場合、totalCountは582、ビジネスヘッダーには583と表示され、ページの折りたたみセクションには39件の非推奨レビューが表示されていました。
Yelpのページでも同じ分割が見られました。レビューのページネーションの下、折りたたみセクションには推奨されなかったレビューの数が表示されていました。
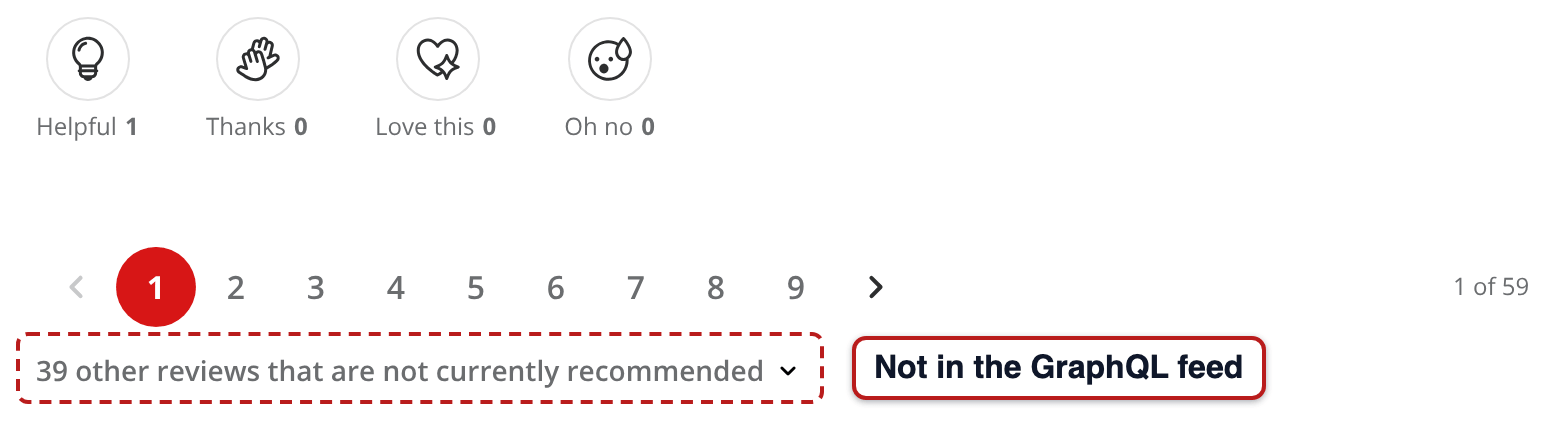
Ziziki’sのページには、1ページあたり10件で59ページ分の推奨レビューが一覧表示され、折りたたみセクションにさらに39件が表示されていました。
documentIdは、Yelpが新しいフロントエンドコードをリリースすると変更されることがあります。人気のあるオープンソースのYelpスクレイパーはdocumentIdを公開していましたが、そのIDはライブページが送信するものともはや一致していませんでした。短いBrowser APIスクリプトrefresh_doc_id.pyは、ライブページから現在のIDを取得するので、Yelpが新しいコードをリリースした後にスクレイパーを更新できます。
PythonでYelpスクレイパーを構築する
スクレイパーはGETでWeb Unlocker経由で検索ページとビジネスページをリクエストします。レビューのGraphQLリクエストは、JSONボディを含むPOSTとして送信されます。
コードはJSONオブジェクトまたは必要なキーが欠落している場合にエラーを発生させます。また、永続化クエリIDが古くなっているか、YelpがGraphQL変数を拒否した場合にもエラーを発生させます。その他の変更は空のフィールドまたはtotalCount未満の行数として現れるため、各実行後に両方を確認してください。
Pythonでのスクレイピングが初めての場合は、基本を説明するPython ウェブスクレイピングガイドから始めてください。Python 3.10以降、requestsパッケージ、Bright Dataアカウントが必要です。Bright DataのWeb Unlockerクイックスタートに従って、各リクエストが参照する名前付き設定であるWeb Unlockerゾーンを作成してください。その後、APIキーを生成してください。
無料プランには、Bright Dataのすべてのスクレイピングapiで共有される月5,000クレジットが含まれます。各Web Unlockerリクエストまたは配信されたYelp Scraper APIレコードは1クレジットを使用します。Web Unlockerは成功したリクエストのみに課金します。依存関係をインストールし、APIキーとゾーン名をエクスポートします。
pip install requests
export BRIGHTDATA_API_KEY="your_api_key"
export BRIGHTDATA_UNLOCKER_ZONE="web_unlocker"
YelpへのWeb UnlockerおよびBrowser APIリクエストには、フルアクセス権を持つアカウントが必要です。本人確認(KYC)を必要としない即時アクセスモードのアカウントは、robots.txtに従います。私たちが読んだ時点では、Yelpのrobots.txtは名前が指定されていないクローラーを許可していませんでした。
KYC確認後、またはアカウントマネージャーを通じてフルアクセスを取得できます。それまでは、Web UnlockerはYelpのURLに対してub_bad_endpoint_robotsエラーを返し、Browser APIはbrobエラーを返します。
Web Unlocker経由でページを取得する
ヘルパーは各URLをWeb Unlockerの/requestエンドポイントに投稿し、ターゲットのレスポンスボディを返します。1つのURLあたり最大3回試行します。これをyelp_scraper.pyの最初の部分として保存してください。
import base64
import html
import json
import os
import re
import time
import urllib.parse
from concurrent.futures import ThreadPoolExecutor

import requests

API_KEY = os.environ["BRIGHTDATA_API_KEY"]
ZONE = os.environ.get("BRIGHTDATA_UNLOCKER_ZONE", "web_unlocker")

# Yelp's GetBusinessReviewFeedオペレーションの永続化クエリID。
# Yelpがデプロイすると変わることがあります。refresh_doc_id.pyがキャプチャします。
REVIEW_FEED_DOC_ID = os.environ.get(
    "YELP_REVIEW_FEED_DOC_ID",
    "2b29fe4414313b319cb85e119740e72da582d64ad2962841724748be23d7f692",
)
PAGE_SIZE = 49  # YelpのGraphQL APIは50をBAD_USER_INPUTで拒否した


class FetchError(Exception):
    pass


def unlock(url, method="GET", body=None, attempts=3):
    """Web Unlocker経由でURLを取得する; ターゲットのレスポンスボディを返す。"""
    payload = {"zone": ZONE, "url": url, "format": "raw",
               "country": "us", "method": method}
    if body is not None:
        payload["body"] = json.dumps(body)
        payload["headers"] = {"content-type": "application/json"}
    last_error = None
    for attempt in range(attempts):
        try:
            r = requests.post(
                "https://api.brightdata.com/request",
                headers={"Authorization": f"Bearer {API_KEY}"},
                json=payload,
                timeout=180,
            )
            # r.status_codeはAPI呼び出し自体についてのものです。
            # ターゲット自体のステータスはx-brd-status-codeにあります。
            status = r.headers.get("x-brd-status-code", str(r.status_code))
            if status == "200" and r.text:
                return r.text
            last_error = f"{status} {r.headers.get('x-brd-error-code')}"
        except requests.RequestException as exc:
            last_error = type(exc).__name__
        if attempt < attempts - 1:
            time.sleep(2 ** attempt)
raise FetchError(f"{url}: {last_error}")30件のYelpビジネスページを対象とした別のテストでは、unlock()がすべてのページを読み込みました。
Apolloキャッシュからビジネス詳細をパースする
このパーサーをyelp_scraper.pyに追加してください。Apolloキャッシュを抽出し、ページの対象ビジネスを見つけ、そのフィールドを単一のレコードにフラット化します。
def embedded_json(page, marker, escaped):
"""Yelpが<script>タグ内で<!-- -->でラップするJSONを返す。"""
m = re.search(
r"<script[^>]*" + marker + r"[^>]*>\s*<!--(.*?)-->\s*</script>",
page,
re.S,
)
if not m:
raise FetchError(f"{marker} missing: soft block or markup change")
raw = html.unescape(m.group(1)) if escaped else m.group(1)
return json.loads(raw)
def apollo_state(page):
# ApolloキャッシュはHTMLコメント内でHTMLエスケープされていた(")。
return embedded_json(page, "data-apollo-state", escaped=True)
def parse_business(page):
state = apollo_state(page)
ref = next(v["__ref"] for k, v in state["ROOT_QUERY"].items()
if k.startswith("business("))
biz = state[ref]
loc = state[biz["location"]["__ref"]]
claim = next((v for k, v in biz.items()
if k.startswith("claimability(")), None) or {}
website = (biz.get("externalResources") or {}).get("website") or {}
return {
"encid": biz["encid"],
"alias": biz["alias"],
"name": biz["name"],
"rating": biz["rating"],
"review_count": biz["reviewCount"],
"price_range": (biz.get("priceRange") or {}).get("display"),
"phone": (biz.get("phoneNumber") or {}).get("formatted"),
"address": loc["address"]["formatted"].replace("\n", ", "),
"neighborhoods": loc.get("neighborhoods"),
"categories": [state[c["__ref"]]["title"] for c in biz["categories"]],
"is_claimed": claim.get("isClaimed"),
"is_closed": biz.get("isClosed"),
"website": website.get("url"),
}
def get_business(url):
return parse_business(unlock(url))Apolloは関連オブジェクトを一度だけ保存し、__refキーでそれらを指すため、パーサーはlocationとcategoriesをたどってそれぞれのエントリに到達します。claimability({"useConsumerClaimability":true})のように一部のキーにはクエリ引数が含まれていたため、コードはそれらのキーをプレフィックスでマッチングします。パーサーは保存した19件のビジネスページすべてをエラーなく読み込みました。
GraphQL APIからYelpレビューをスクレイピングする
Yelpレビューをスクレイピングするには、ビジネスencid、永続化されたdocumentId、クエリが期待する変数とともにリクエストを送信します。yelp_scraper.pyの次の部分は自身でオフセットカーソルを構築するため、最初のページ以降のすべてのページを並行して実行できます。Yelpのカーソルには前のページの最後のレビューのオフセットが含まれていたため、review_page()はstart - 1を渡します。
def review_cursor(offset):
    # Yelpの"after"カーソルは数値オフセットを含むbase64 JSONです。
    raw = json.dumps({"version": 1, "type": "offset", "offset": offset},
                     separators=(",", ":"))
    return base64.b64encode(raw.encode()).decode()


def review_page(encid, start, sort_by="DATE_DESC"):
    variables = {
        "encBizId": encid,
        "reviewsPerPage": PAGE_SIZE,
        "after": review_cursor(start - 1) if start else None,
        "sortBy": sort_by,  # RELEVANCE_DESC, DATE_DESC, DATE_ASC, ...
        "ratings": [5, 4, 3, 2, 1],
        "queryText": "",
        "isSearching": False,
        "selectedReviewEncId": "",
        "hasSelectedReview": False,
        "isTranslating": False,
        "translateLanguageCode": "en",
        "isHighlighting": False,
        "highlightType": "",
        "highlightIdentifier": "",
        "photoSize": "SQUARE_348",
        "fetchMediaReviewContent": False,
        "eliteAllStarSourceFlow": "biz_page_review_feed",
        "reactionsSourceFlow": "businessPageReviewSection",
        "minConfidenceLevel": "HIGH_CONFIDENCE",
    }
    body = [{
        "operationName": "GetBusinessReviewFeed",
        "variables": variables,
        "extensions": {"operationType": "query",
                       "documentId": REVIEW_FEED_DOC_ID},
    }]
    try:
        raw = unlock("https://www.yelp.com/gql/batch", method="POST",
                     body=body)
    except FetchError as exc:
        # Web Unlocker経由では、未知のdocumentIdは502 http_statusとして
        # 返されたため、メッセージはIDの更新を提案します。
        raise FetchError(f"{exc} (outdated documentId? run refresh_doc_id.py)")
    result = json.loads(raw)[0]
    # GraphQLエラーはHTTP 200レスポンスで返されることがあります。
    if result.get("errors"):
        raise FetchError(result["errors"][0]["message"])
    return result["data"]["business"]["reviews"]


def flatten_review(node):
    author = node.get("author") or {}
    # Author fields are personal data, so drop them if you only need sentiment.
    return {
        "review_id": node["encid"],
        "rating": node["rating"],
        "created_at": node["createdAt"]["localDateTimeForBusiness"],
        "text": (node.get("text") or {}).get("full"),
        "language": (node.get("text") or {}).get("language"),
        "author": author.get("displayName"),
        "author_location": author.get("displayLocation"),
        "author_review_count": author.get("reviewCount"),
    }


def get_reviews(encid, max_reviews=None, workers=4):
    first = review_page(encid, 0)
    total = first["totalCount"]
    if max_reviews:
        total = min(total, max_reviews)
    reviews = [e["node"] for e in first["edges"]]
    # オフセットは事前に分かっているため、残りのページは並行して実行されます。
    starts = range(PAGE_SIZE, total, PAGE_SIZE)
    with ThreadPoolExecutor(workers) as pool:
        for page in pool.map(lambda s: review_page(encid, s), starts):
            reviews += [e["node"] for e in page["edges"]]
    unique = {r["encid"]: flatten_review(r) for r in reviews}
return list(unique.values())[:total], first["totalCount"]get_reviews()は、Ziziki’sの582件の推奨レビューすべてを12回のGraphQL呼び出しで収集し、レビューの日付は約20年間をカバーしていました。
ブラウザはguv訪問者IDとlanguageCode値も送信していました。GraphQL APIは私たちのテストではどちらも必要としなかったため、コードはそれらを送信しません。
created_atの値はビジネスの現地タイムゾーンであり、夏時間に応じてダラスの場合は-05:00や-06:00などのオフセットが付いています。都市間でレビューの日付を比較する前に、各値を保存する際にオフセットを保持するか、UTCに変換してください。
検索結果からビジネスを発見する
これまでの関数は、既に持っているビジネスURLから始まります。検索ページはget_business()のビジネスURLとget_reviews()のencid値を提供します。検索関数もyelp_scraper.pyに追加してください。パーサーは各オーガニックカードをそのApolloレコードと結合し、スポンサー付きカードをスキップします。
def parse_search(page):
    props = embedded_json(page, "data-hypernova-key", escaped=False)
    comps = (props["legacyProps"]["searchAppProps"]["searchPageProps"]
             ["mainContentComponentsListProps"])
    state = apollo_state(page)
    hits = []
    for comp in comps:
        section = comp.get("props") or {}
        if comp.get("type") != "searchResultSection":
            continue
        for item in section.get("searchResults", []):
            if item.get("isAd"):
                continue  # スポンサー付きカードをスキップ
            # Apolloキャッシュから詳細を取得; オーガニックカードには欠けている場合がある。
            biz = state.get(f"Business:{item['bizId']}", {})
            hits.append({
                "rank": item.get("ranking"),
                "encid": item["bizId"],
                "name": biz.get("name"),
                "rating": biz.get("rating"),
                "review_count": biz.get("reviewCount"),
                "url": "https://www.yelp.com"
                       + item["businessUrl"].split("?")[0],
            })
    paging = next(c["props"] for c in comps if c.get("type") == "pagination")
    return hits, paging["totalResults"]


def search(term, location, pages=1):
    query = urllib.parse.urlencode({"find_desc": term, "find_loc": location})
    base = f"https://www.yelp.com/search?{query}"
    hits = []
    for n in range(pages):
        # ページ1にはブラウザが読み込む方法と同様にstartパラメータがありません。
        url = f"{base}&start={n * 10}" if n else base
        batch, total = parse_search(unlock(url))
        hits += batch
        if (n + 1) * 10 >= total:
            break
return hitssearch()は、ブラウザが最初に検索を読み込む方法と同じように、ページ1をstartなしで送信します。totalResultsが許可する最後のページで停止するため、Yelpの240件制限に達するクエリには24ページが必要です。
Yelpスクレイパーを実行する
yelp_scraper.pyの最後のブロックは、手順を順番に実行します。2つの検索ページ、1つのビジネスページ、そのビジネスの最新150件のレビューを取得し、レビューをJSON Linesファイルに書き込みます。
if __name__ == "__main__":
    hits = search("Pizza", "Lower Manhattan, New York, NY", pages=2)
    print(f"{len(hits)} organic results")
    for hit in hits[:3]:
        print(hit["rank"], hit["name"], hit["rating"], hit["review_count"])

    business = get_business(hits[0]["url"])
    print(json.dumps(business, indent=2, ensure_ascii=False))

    reviews, reported = get_reviews(business["encid"], max_reviews=150)
    print(f"collected {len(reviews)} of {reported} reviews")
    for r in reviews[:2]:
        print(r["created_at"], r["rating"], r["text"][:60])

    with open("reviews.jsonl", "w") as f:
        for row in reviews:
            f.write(json.dumps({"business": business["alias"], **row}) + "\n")
保存したディレクトリからスクリプトを実行してください。最初の行は、両方の検索ページが読み込まれた後にのみ表示されます。
python yelp_scraper.pyこの実行は、上位の検索結果、ビジネスレコード、最初の2件のレビューを出力しました。
20 organic results
1 L’industrie Pizzeria 4.5 1222
2 Prince Street Pizza 4.3 5720
3 Juliana's 4.4 2997
{
  "encid": "G9hV4H2iGpWD8RoUpjtokg",
  "alias": "l-industrie-pizzeria-new-york",
  "name": "L’industrie Pizzeria",
  "rating": 4.5,
  "review_count": 1222,
  "price_range": "$$",
  "phone": "(212) 256-0648",
  "address": "104 Christopher St, New York, NY 10014",
  "neighborhoods": [
    "West Village"
  ],
  "categories": [
    "Pizza"
  ],
  "is_claimed": false,
  "is_closed": false,
  "website": "http://lindustriebk.com"
}
collected 150 of 1220 reviews
2026-09-25T20:43:26-04:00 4 I arrived here on a Saturday afternoon and man what a line.
2026-09-25T20:37:09-04:00 4 The pizza was like 4.25/5, I came with locals and they said
この実行は7件の課金対象リクエストを使用しました(検索ページ2件、ビジネスページ1件、GraphQL呼び出し4件)。ビジネスページは1,222件のレビューを報告しましたが、GraphQL APIのtotalCountは1,220でした。実行が完了したかどうかを確認する際は、ページ上の数字ではなくtotalCountと行数を比較してください。
Yelpがデプロイしたら永続化クエリIDを更新する
ビジネスページはまだ読み込めるのにレビュー呼び出しが502 http_statusで失敗し始めたら、documentIdが変わった可能性が高いです。このスクリプトをrefresh_doc_id.pyとして保存してください。Browser APIで単一のビジネスページを開き、ページがレビューのGraphQLリクエストを送信するまでスクロールします。そのリクエストからIDを出力するか、30回スクロールしても見つからない場合はNoneを出力します。
import asyncio
import json
import os

from playwright.async_api import async_playwright

# ゾーンのOverviewタブからのBrowser APIエンドポイント、-country-usを追加。
BROWSER_WSS = os.environ["BRIGHTDATA_BROWSER_WSS"]
BIZ_URL = "https://www.yelp.com/biz/zizikis-dallas-2"


async def capture_review_feed_doc_id():
    async with async_playwright() as p:
        browser = await p.chromium.connect_over_cdp(BROWSER_WSS)
        page = await browser.new_page()
        found = asyncio.get_running_loop().create_future()

        def on_request(request):
            if (request.url.endswith("/gql/batch")
                    and "GetBusinessReviewFeed" in (request.post_data or "")
                    and not found.done()):
                ops = json.loads(request.post_data)
                op = next(o for o in ops
                          if o["operationName"] == "GetBusinessReviewFeed")
                found.set_result(op["extensions"]["documentId"])

        page.on("request", on_request)
        await page.goto(BIZ_URL, wait_until="domcontentloaded",
                        timeout=120_000)
        # ページがレビューのGraphQLリクエストを送信するまでスクロールします。
        for _ in range(30):
            if found.done():
                break
            await page.mouse.wheel(0, 1200)
            await page.wait_for_timeout(1500)
        await browser.close()
        return found.result() if found.done() else None


if __name__ == "__main__":
    print(asyncio.run(capture_review_feed_doc_id()))
pip install playwrightでPlaywrightをインストールし、Bright DataのBrowser APIクイックスタートに従ってBrowser APIゾーンを作成してください。その後、BRIGHTDATA_BROWSER_WSSをそのゾーンのエンドポイントに設定し、ユーザー名に-country-usを追加してください。値の形式はwss://brd-customer-<id>-zone-<zone>-country-us:<password>@brd.superproxy.io:9222です。実行すると、スクレイパーが既に使用しているIDが出力されました。
2b29fe4414313b319cb85e119740e72da582d64ad2962841724748be23d7f692出力されたIDが異なる場合は、それをYELP_REVIEW_FEED_DOC_IDとしてエクスポートし、yelp_scraper.pyを再度実行してください。
Browser APIはトラフィックのGBごとに課金され、6回のYelpビジネスページ読み込みは平均で約8MBでした。Web Unlockerは成功したリクエストごとに課金します。Browser APIはたまにdocumentIdを更新する場合にのみ使用し、ページとレビューのリクエストはWeb Unlocker経由で送信してください。
一般的なエラーのトラブルシューティング
表示される内容と、考えられる原因を照合してください。
| 表示される内容 | 考えられる原因 | 対処方法 |
|---|---|---|
401 Noneまたは400 Noneを伴うFetchError |
間違ったAPIキー(401)またはゾーン名(400) | BRIGHTDATA_API_KEYを確認し、BRIGHTDATA_UNLOCKER_ZONEをゾーンの正確な名前に設定してください |
ub_bad_endpoint_robotsを伴うFetchError、またはBrowser APIからのbrob |
アカウントが即時(KYCなし)アクセスモードであり、Yelpのrobots.txtに従っている | KYC確認を完了するか、アカウントマネージャーにフルアクセスを依頼してください |
data-apollo-state missingまたはdata-hypernova-key missingを伴うFetchError |
ソフトブロック(HTTP 200で返されたブロックページ)またはマークアップの変更 | unlock()が返したHTMLを保存し、エラーで名前が示された<script>タグを検索してください |
ビジネスページは読み込めるのにレビュー呼び出しが502 http_statusで失敗する |
新しいdocumentId |
refresh_doc_id.pyを実行し、出力されたIDをエクスポートしてください |
GraphQL検証メッセージを伴うFetchError |
欠落しているか範囲外の変数 | DevToolsのページのペイロードと変数を比較してください |
unlock()からのその他のFetchError |
リクエストが3回すべての試行で失敗した | 後でURLを再試行するか、unlock()のattemptsを増やしてください |
パーサーでの空のフィールド、またはKeyErrorやStopIteration |
YelpのJSONでキー名が変更された | ページのJSONとパーサーが読み取るキーを比較してください |
Bright DataのYelp Scraper APIでYelpスクレイピングを拡張する
自分でスクレイパーを作成すると、それも自分でメンテナンスすることになります。永続化クエリID、変数リスト、パーサーはすべてYelpのフロントエンドに依存しているため、Yelpがフロントエンドの変更をリリースするたびにそれぞれが壊れる可能性があります。
Bright DataのWeb Scraper APIの一部であるYelp Scraper APIは、YelpのURLまたは検索フィルターを受け取り、パース済みのレコードを返します。Bright DataはYelpのフロントエンドが変わるとパーサーをメンテナンスします。Bright Dataは専用のYelp画像スクレイパーとAIエージェント向けのYelp MCPサーバーも提供しています。
Yelp Scraper APIは、私たちのテストでGetBusinessReviewFeedクエリが返さなかった非推奨レビューも収集できます。Yelpの2025年信頼と安全性レポートによると、そのソフトウェアは2025年に投稿されたレビューの17%を推奨しませんでした。
PythonからYelp Scraper APIを実行する
コントロールパネルのスクレイパーライブラリには、Yelpのエンドポイントが一覧表示されています。ビジネスエンドポイントはURL、検索フィルター、境界ボックスを入力として受け付け、レビューエンドポイントはビジネスURLまたは検索フィルターを受け付けます。各エンドポイントは入力のリストを受け付け、同期モードまたは非同期モードで実行されます。
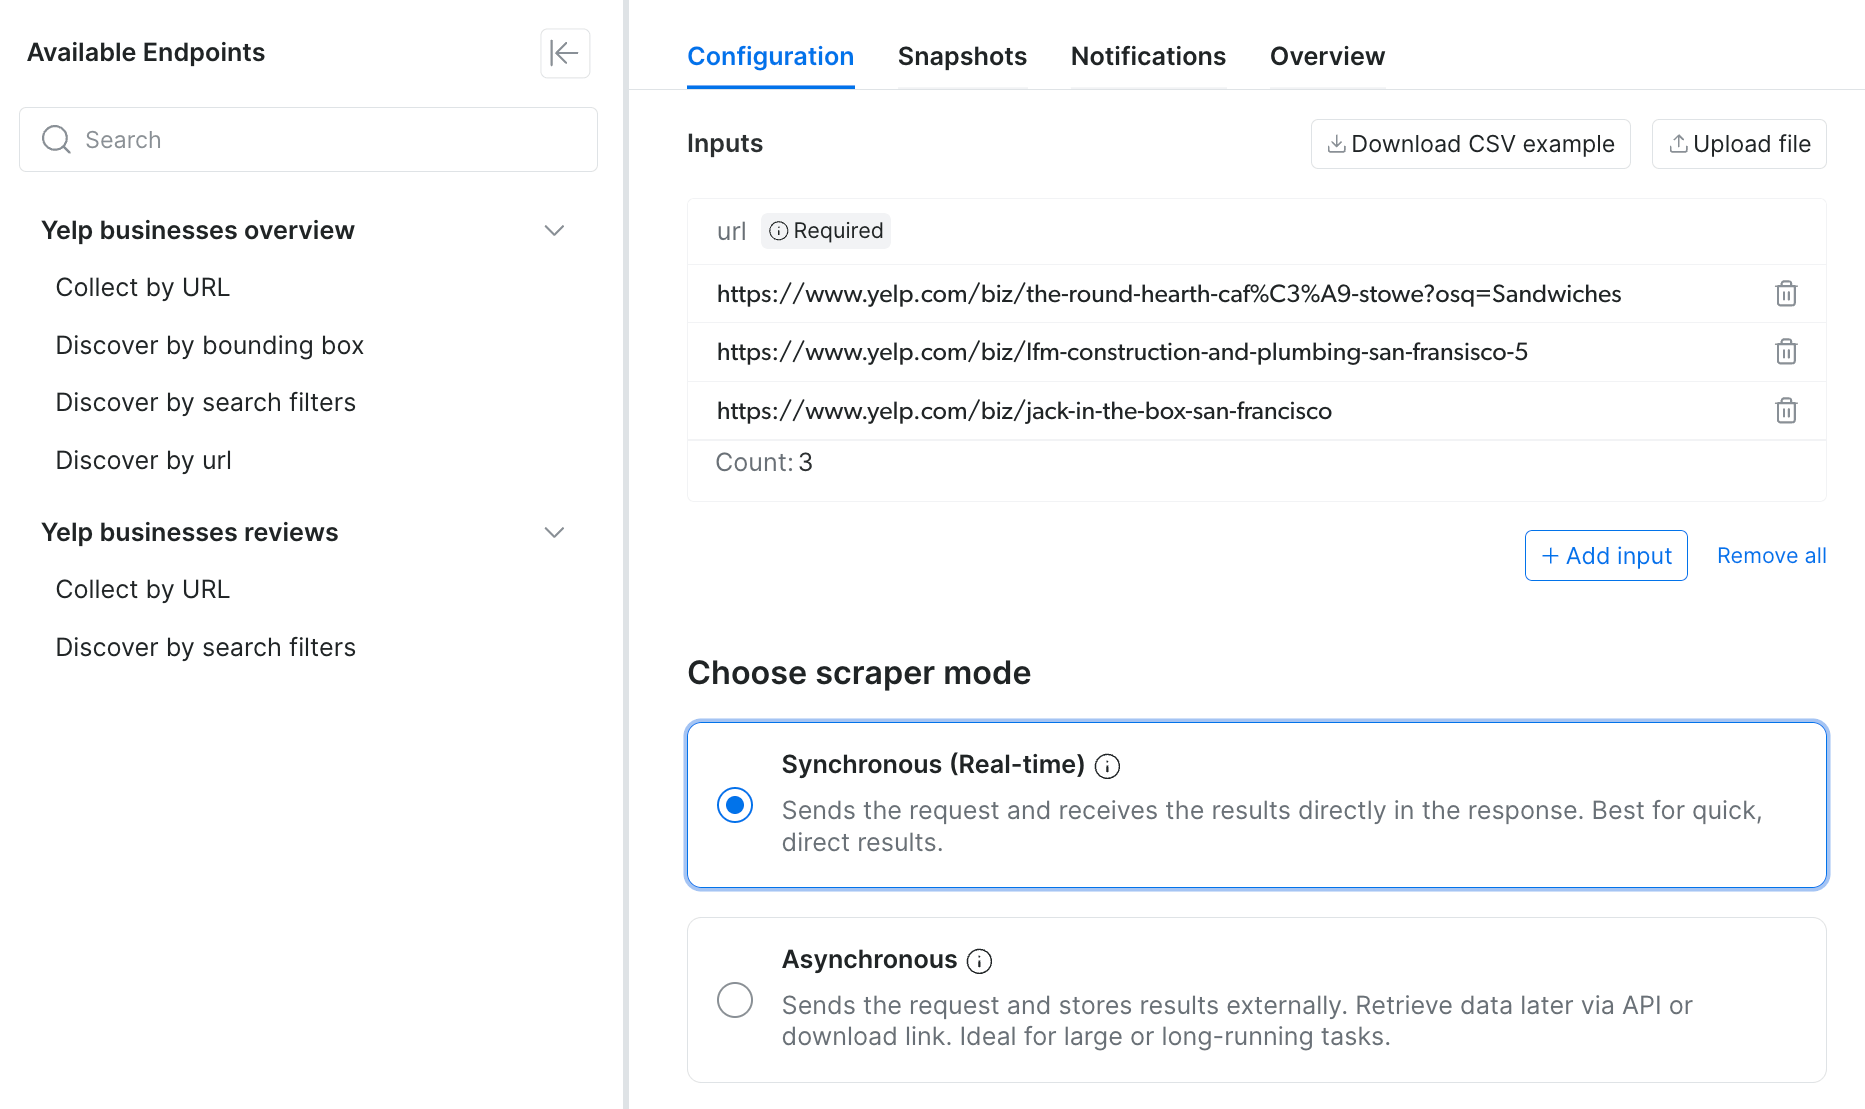
ビジネスレコード用のCollect by URLエンドポイントで、3つの入力例とSynchronousモードが選択されています。1分間の制限を超える同期呼び出しはレコードの代わりにスナップショットIDを返すため、scraper_api.pyは非同期で実行します。
非同期トリガーエンドポイントを通じて、同じスクレイパーをPythonから実行できます。このスクリプトをscraper_api.pyとして保存してください。Scraper API呼び出しはゾーンを使用しないため、BRIGHTDATA_API_KEYのみが必要です。ブルックリン、NYのピザの発見検索を実行し、その後最初の結果の最新20件のレビューを収集します。
import os
import time

import requests

API = "https://api.brightdata.com/datasets/v3"
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"}

YELP_BUSINESSES = "gd_lgugwl0519h1p14rwk"
YELP_REVIEWS = "gd_lgzhlu9323u3k24jkv"


def collect(dataset_id, inputs, limit_per_input=None, poll_every=15,
            **params):
    """Scraper APIジョブをトリガーし、完了を待ち、そのレコードを返す。"""
    body = {"input": inputs}
    if limit_per_input:
        body["limit_per_input"] = limit_per_input
    r = requests.post(
        f"{API}/trigger",
        headers=HEADERS,
        params={"dataset_id": dataset_id, "include_errors": "true",
                **params},
        json=body,
        timeout=60,
    )
    r.raise_for_status()
    snapshot_id = r.json()["snapshot_id"]

    while True:
        progress = requests.get(f"{API}/progress/{snapshot_id}",
                                headers=HEADERS, timeout=60).json()
        if progress["status"] == "ready":
            break
        if progress["status"] in ("failed", "canceled"):
            raise RuntimeError(f"{snapshot_id}: {progress}")
        time.sleep(poll_every)

    records = requests.get(f"{API}/snapshot/{snapshot_id}",
                           headers=HEADERS, params={"format": "json"},
                           timeout=120).json()
    # include_errors=trueの場合、失敗した入力はエラーレコードとして返されます。
    errors = [x for x in records if x.get("error")]
    rows = [x for x in records if not x.get("error")]
    return rows, errors


if __name__ == "__main__":
    rows, errors = collect(
        YELP_BUSINESSES,
        [{"country": "US", "category": "Pizza",
          "location": "Brooklyn, NY, United States"}],
        limit_per_input=5,
        type="discover_new",
        discover_by="search_filters",
    )
    for row in rows:
        print(row["name"], row["overall_rating"], row["reviews_count"],
              row["url"])
    print(f"{len(rows)} businesses, {len(errors)} errors")
    if not rows:
        raise SystemExit("discovery returned no businesses")

    reviews, errors = collect(
        YELP_REVIEWS,
        [{"url": rows[0]["url"], "unrecommended_reviews": False,
          "sort_by": "DATE_DESC"}],
        limit_per_input=20,
    )
    print(f"{len(reviews)} reviews, {len(errors)} errors")
    for r in reviews[:1]:
print(r["date_iso_format"], r["Rating"], r["Content"][:120])YELP_BUSINESSESとYELP_REVIEWSは、コントロールパネルの各スクレイパーのAPI例に表示されている、Bright DataのYelpスクレイパーのデータセットIDです。collect()は15秒ごとに各ジョブの進捗を確認し、ジョブの準備ができたらそのレコードを返します。発見した各ビジネスについて、スクリプトは名前、評価、レビュー数、URLを出力します。その後、レビュー数と最初のレビューの日付、評価、テキストの最初の120文字を出力します。
Yelp Scraper APIは成功した配信のみに課金します。limit_per_inputは入力あたりの最大レコード数を設定します。このスクリプトはビジネスに5、レビューに20を使用しているため、5,000件のレビューを持つビジネスでのテスト実行で5,000件のレコードとして課金されることはありません。ジョブが収集できなかった入力は、再送信の準備ができたその入力を含むエラーレコードとして返されます。
レビュージョブを設定し、そのフィールドをマッピングする
これら3つの詳細は、ジョブが返すレコードとその読み取り方法に影響します。
unrecommended_reviewsは2つのレビューセットのうち1つを選択します。trueの場合、ジョブは非推奨のレビューのみ(recommended_review: false)を返しました。両方のセットを収集するには、各値でビジネスURLを1回ずつ送信してください。trueの入力では日付範囲を空にして、すべての日付から非推奨レビューを収集してください。- 推奨レビューへの日付フィルターはGraphQLのカウントと一致しました。
unrecommended_reviewsをfalseに設定し、start_dateからend_dateまでの日付範囲を指定すると、ジョブは6件のレビューを返しました。GraphQLスクレイパーもその範囲で同じ6件を見つけました。 - Yelpのリアクションラベルは時間とともに変わりました。最近のレコードでは
Helpful、Thanks、Love this、Oh noが使用され、古いYelpレビューではuseful、funny、coolが使用されていました。年ごとにリアクションを比較する前に、両方のセットをマッピングしてください。
繰り返しのジョブの場合、Yelp Scraper APIはwebhook、Amazon S3、Google Cloud Storage、Google Pub/Sub、Microsoft Azure Storage、Snowflake、またはSFTPに配信します。
Yelp API、スクレイパー、データセット:1,000ビジネスの費用
適切な選択肢は、全文レビューが必要かどうか、そして誰がデータ収集をメンテナンスするかによります。この表は、確認時点での定価で、単一のワークロード、各200件のレビューを持つ1,000ビジネスの費用を示しています。
| 選択肢 | 全文レビュー | 1,000ビジネスと200,000件のレビューの費用 | 継続的な作業 |
|---|---|---|---|
| Yelp Places API、Enhancedプラン | いいえ、約160文字の抜粋3件 | 月額$299、含まれる30,000コール以内 | 表示ルールと24時間のキャッシュ制限に従う |
| Yelp Insights API、Premiumプラン | はい | Yelpの営業チームからのカスタム見積もり、ロケーションあたり$0.08から、12ヶ月のローリングベース | Yelpの契約条件に従う |
| Web Unlocker上の自作スクレイパー | はい、推奨レビュー | 1,000件あたり$1.5で、6,000リクエスト(1,000ビジネスページと5,000GraphQL呼び出し)で$9 | Yelpのフロントエンドが変わったら永続化クエリID、変数、パーサーを更新する |
| Bright Data Yelp Scraper API | はい、推奨と非推奨の両方 | 1,000件あたり$1.5で、201,000件のレコードで$301.50 | 入力リストと配信を管理する |
| Bright Data Yelpデータセット | はい、事前収集済み | 1レコードあたり最大$0.0025(最低注文額$250)で、201,000件のレコードで最大$502.50 | 収集作業不要、月次データ更新 |
Web Unlockerの数字が低いのは、各GraphQL呼び出しが最大49件のレビューを返し、Web Unlockerが成功したリクエストのみに課金するためです。Yelp Scraper APIはレコードごとに課金するため、レビューの多いジョブはより高くなります。その価格では、パーサーや永続化クエリIDにエンジニアリング時間を費やすことはありません。
発見にはどちらの選択肢でも費用がかかります。Web Unlockerでは、検索ページごとに10件の結果を示すため、検索ページに対して支払います。Yelp Scraper APIでは、発見レコードに対して支払います。
Bright DataのYelpデータセットは、過去データの補完に適しています。2億件以上のレビューレコードと900万件以上のビジネスレコードを含みます。個別のYelpレストランデータセットも利用可能です。
コントロールパネルの各データセットページには、購入前にフィールド、価格、データサンプルが表示されます。
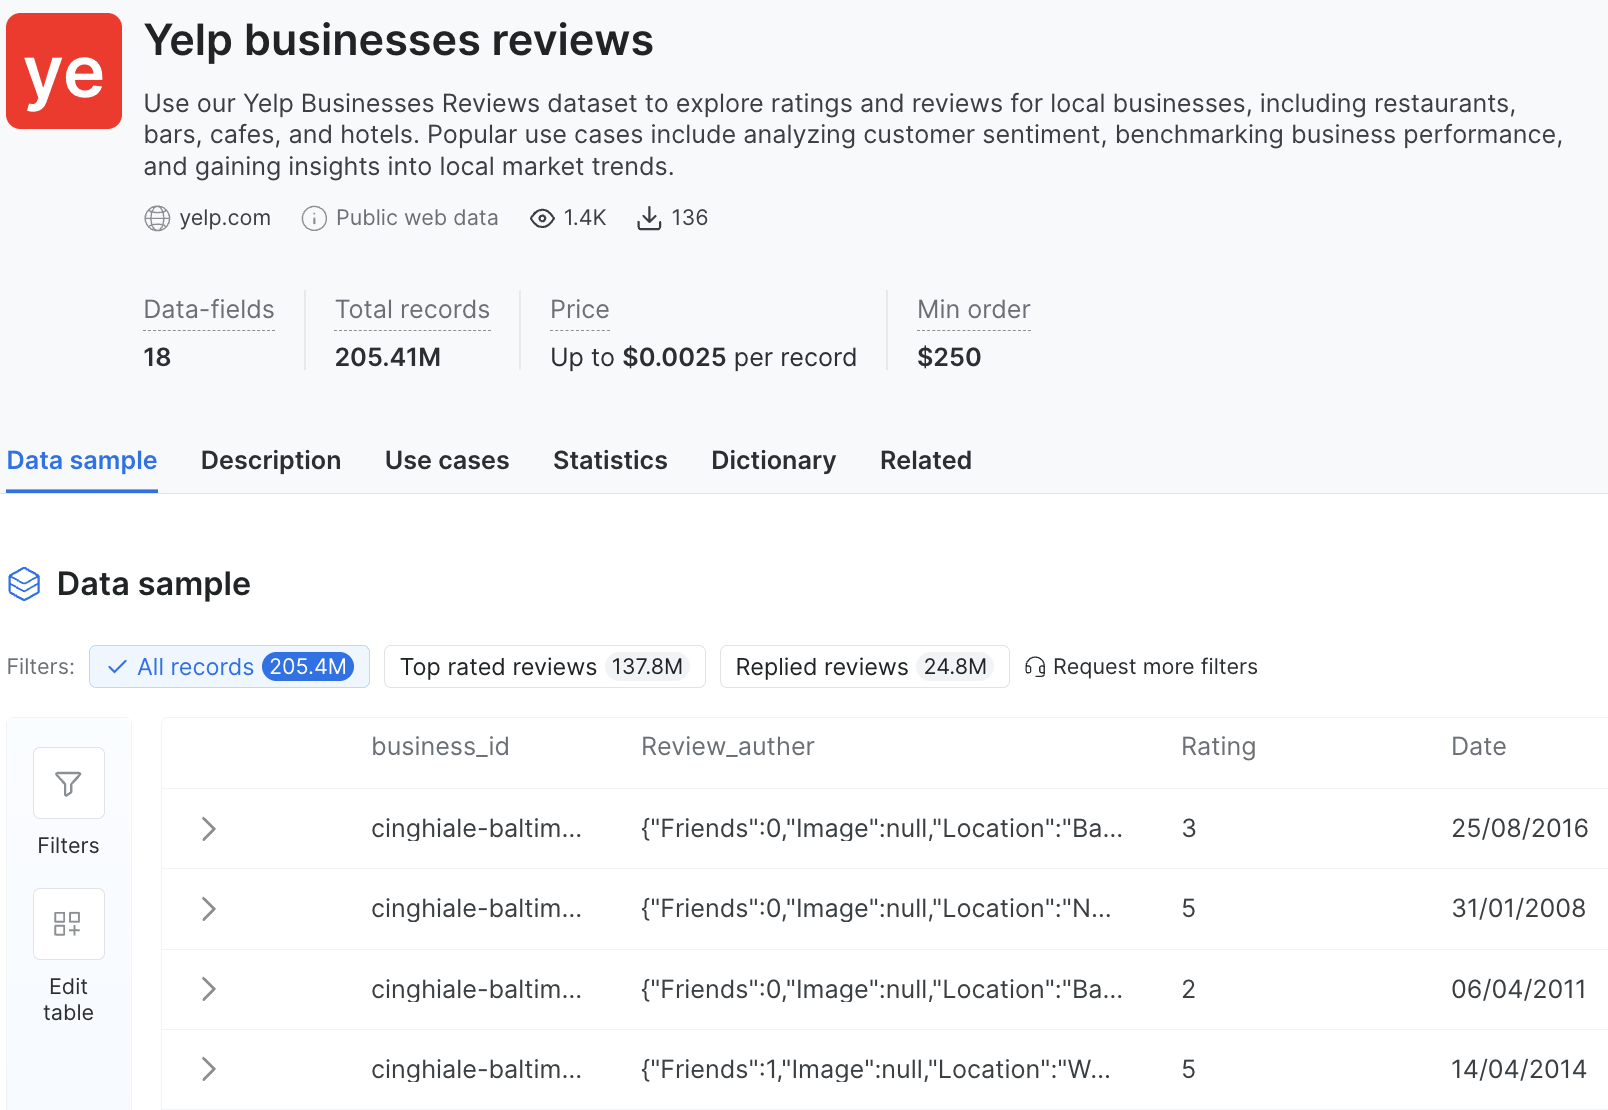
Yelpビジネスレビューデータセット。1レコードあたり最大$0.0025で、最低注文額$250は少なくとも10万件のレビューを購入できます。
まとめ
PythonでのYelpスクレイピングは、すべてのリクエストでWeb Unlockerを使用し、レビューをHTMLではなくGraphQL APIから取得すれば、私たちのテストでうまく機能しました。永続化クエリIDはYelpがデプロイすると変わることがあるため、レビュー呼び出しが失敗し始めたら、まずrefresh_doc_id.pyを実行してください。Bright DataのYelp Scraper APIはパーサーのメンテナンスを処理し、非推奨レビューも追加しますが、レビューあたりの単価は高くなります。Bright DataのYelpデータセットは過去データの補完用の履歴データを提供します。Bright Dataの無料プランで知っているビジネスから始め、より多くのビジネスで実行する前にyelp_scraper.pyの行数とtotalCountを比較してください。
FAQ
Yelpのレビューをどうやってスクレイピングしますか?
GetBusinessReviewFeed永続化クエリIDを使って、YelpのGraphQLエンドポイント/gql/batchからリクエストしてください。なぜなら、私たちのテストではビジネスページのHTMLに全文レビューがなかったからです。各呼び出しは最大49件のレビューを返しました。Yelpのボット保護であるDataDomeが私たちがテストしたPython HTTPクライアントをブロックしたため、呼び出しはBright DataのWeb Unlocker API経由でルーティングしてください。
Yelp APIはすべてのレビューを提供しますか?
私たちが確認した時点では、いいえ提供していませんでした。Yelpのドキュメントには、EnhancedでPlaces APIレビュー抜粋3件、Premiumで最大7件、それぞれ約160文字と記載されていました。全文は、YelpのInsights API Premiumプラン、またはyelp.comが使用するGraphQL API(推奨レビューを返す)から利用可能でした。Bright DataのYelp Scraper APIも、非推奨レビューを含む全文を返します。
Yelp APIを無料で使用できますか?
評価目的のみです。Yelpのドキュメントには、30日間の試用期間中に5,000件の無料Places API呼び出しが記載されており、試用呼び出しは商用利用向けではありませんでした。有料プランは、レビュー抜粋や写真を含まないBaseプランの月額$229から始まりました。
Yelp Fusion APIの費用はいくらですか?
Yelpの価格ページには、Places API(Fusionとも呼ばれる)がBaseで月額$229、Enhancedで$299、Premiumで$643と記載されていました。各プランにはデフォルトで月30,000コールが含まれ、追加コールはプランに応じて1,000件あたり$5.91から$14.13でした。
無料のYelpスクレイパーはありますか?
はい、オープンソースのYelpスクレイパーは無料ですが、私たちのテストでは、Yelpのボット保護であるDataDomeがPython HTTPクライアントをブロックしました。Bright Dataの無料プランには月5,000クレジットが含まれており、5,000件のYelp Scraper APIレコードに十分です。YelpへのWeb Unlockerリクエストには、フルアクセス権を持つアカウントが必要です。
ウェブサイトはスクレイピングを検出できますか?
はい。ボット保護サービスはTLSフィンガープリント、IP、JavaScriptの実行をチェックでき、私たちのテストではYelpはDataDomeを使用していました。Python HTTPクライアントは、ブラウザのTLSフィンガープリントとUSレジデンシャルIPを使用しても、すべてのテストリクエストで403チャレンジページを受け取りました。テスト対象の30件のビジネスページはすべて、Bright DataのWeb Unlocker API経由で読み込まれました。