


プロキシとは、あなたの代わりにインターネットに接続するサーバーのIPアドレスです。ウェブサイトへのリクエストを直接送信する代わりに、プロキシはサーバーを経由してルーティングし、元のIPアドレスと場所を隠します。これによりプライバシーが保護され、追跡やブロックを回避できます。プロキシはセキュリティ強化のためにデータも暗号化します。
この記事では、特にウェブスクレイピングにおいてPythonリクエストでプロキシを使用する方法を学びます。ウェブスクレイピングはウェブサイトからデータを抽出しますが、多くのサイトには制限があります。プロキシはIPと場所を変更することでこれらを回避し、ウェブサイトによる検出やブロックを困難にします。複数のプロキシを使用してリクエストを分散させ、処理を高速化することもできます。
次に、RequestsのPythonパッケージを使用してプロジェクトにプロキシを実装する方法を学びます。
PythonリクエストでプロキシIPアドレスを使用する方法
Pythonリクエストでプロキシを使用するには、ウェブスクレイピング用のPythonスクリプトを作成・実行するためのPythonプロジェクトをコンピュータ上に構築する必要があります。ソースコードファイルを保存するディレクトリ(例:ie web_scrape_project)を作成してください。
このチュートリアルのすべてのコードは、こちらのGitHubリポジトリで公開されています。
パッケージのインストール
ディレクトリを作成したら、ウェブページにリクエストを送信してリンクを収集するために、以下のPythonパッケージをインストールする必要があります:
- Bright Dataのウェブページ
プロキシIPアドレスの構成要素
プロキシを使用する前に、その構成要素を理解しておくことが重要です。プロキシサーバーの主要な構成要素は以下の3つです:
- プロトコルはインターネット上でアクセスできるコンテンツの種類を示します。最も一般的なプロトコルはHTTPとHTTPSです。
- アドレスはプロキシサーバーの場所を示します。アドレスはIP(例:ie
192.167.0.1)またはDNSホスト名(例:ieproxyprovider.com)になります。 - ポートは1台のマシンで複数のサービスが動作する場合に、正しいサーバープロセスにトラフィックを誘導するために使用されます(例:ie ポート番号
2000)。
これら3つの構成要素を組み合わせると、プロキシIPアドレスは次のようになります: 192.167.0.1:2000 または proxyprovider.com:2000。
リクエストにプロキシを直接設定する方法
Pythonリクエストでプロキシを設定する方法はいくつかあり、この記事では3つの異なるシナリオを説明します。この最初の例では、リクエストモジュールにプロキシを直接設定する方法を学びます。
まず、ウェブスクレイピング用のPythonファイルにRequestsとBeautiful SoupパッケージをインポートPythonする必要があります。次に、ウェブページをスクレイピングする際にIPアドレスを隠すためのプロキシサーバー情報を含むproxiesディレクトリを作成します。ここでは、プロキシURLへのHTTPとHTTPS両方の接続を定義する必要があります。
また、データをスクレイピングしたいウェブページのURLを設定するPython変数を定義する必要があります。このチュートリアルでは、URLは https://brightdata.com/です。
次に、request.get()メソッドを使用してウェブページにGETリクエストを送信します。このメソッドはウェブサイトのURLとプロキシという2つの引数を取ります。ウェブページからのレスポンスはresponse変数に格納されます。
リンクを収集するには、Beautiful SoupパッケージでウェブページのHTMLコンテンツをパースします。response.contentとhtml.parserを引数としてBeautifulSoup()メソッドに渡します。
次に、find_all()メソッドにaを引数として使用し、ウェブページ上のすべてのリンクを検索します。最後に、get()メソッドを使用して各リンクのhref属性を抽出します。
以下は、リクエストにプロキシを直接設定するための完全なソースコードです:
# import packages.
import requests
from bs4 import BeautifulSoup

# Define proxies to use.
proxies = {
    'http': 'http://proxyprovider.com:2000',
    'https': 'http://proxyprovider.com:2000',
}

# Define a link to the web page.
url = "https://brightdata.com/"

# Send a GET request to the website.
response = requests.get(url, proxies=proxies)

# Use BeautifulSoup to parse the HTML content of the website.
soup = BeautifulSoup(response.content, "html.parser")

# Find all the links on the website.
links = soup.find_all("a")

# Print all the links.
for link in links:
    print(link.get("href"))
このコードブロックを実行すると、プロキシIPアドレスを使用して定義されたウェブページにリクエストが送信され、そのウェブページへのすべてのリンクを含むレスポンスが返されます:
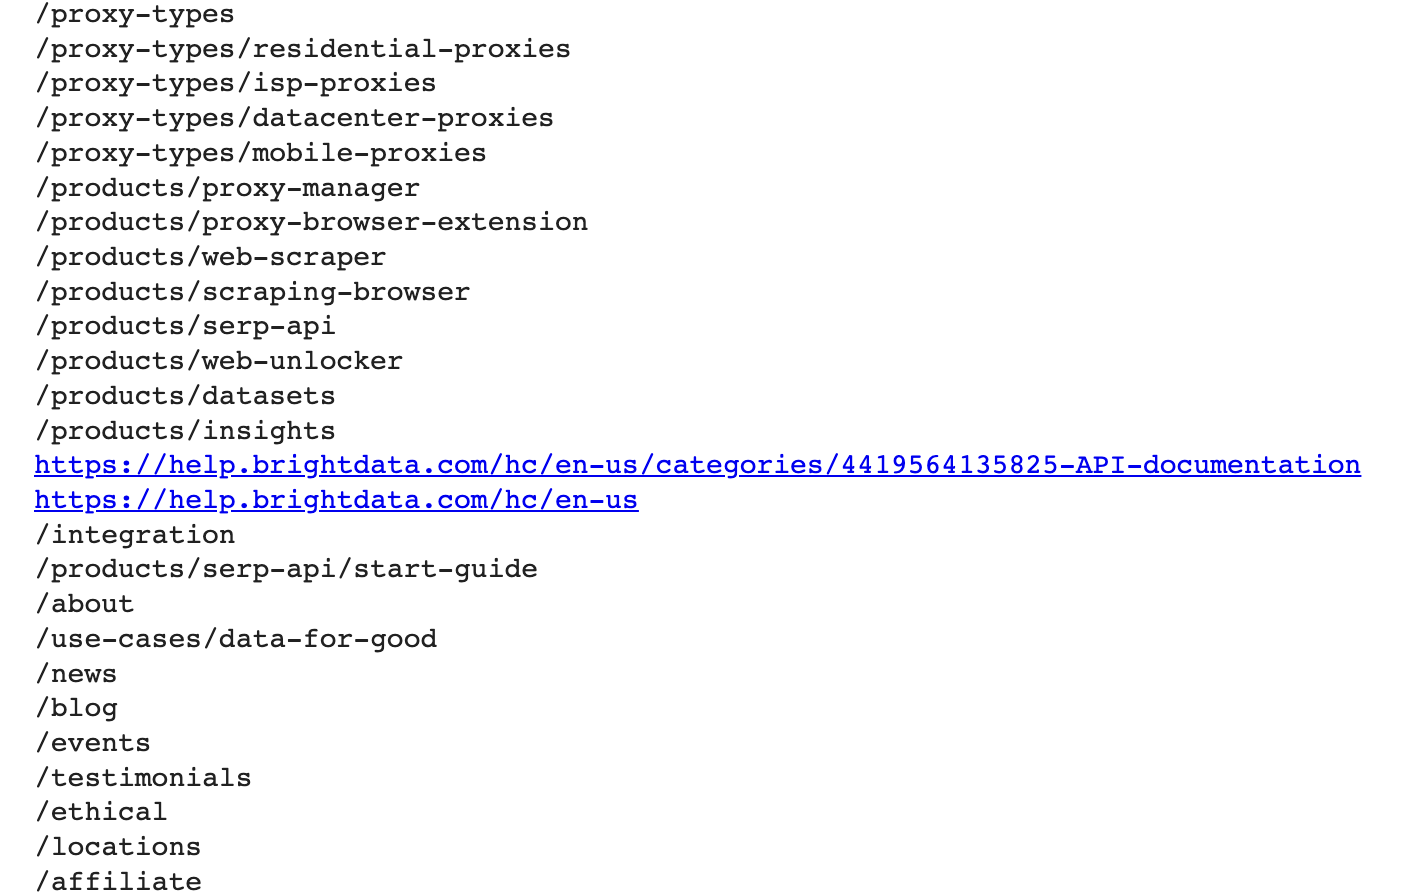
環境変数でプロキシを設定する方法
異なるウェブページへのすべてのリクエストに同じプロキシを使用する必要がある場合があります。そのような場合は、プロキシの環境変数を設定することが合理的です。
シェルでスクリプトを実行するたびにプロキシの環境変数を利用できるようにするには、ターミナルで以下のコマンドを実行します:
export HTTP_PROXY='http://proxyprovider.com:2000'
export HTTPS_PROXY='https://proxyprovider.com:2000'
ここで、HTTP_PROXY変数はHTTPリクエスト用のプロキシサーバーを設定し、HTTPS_PROXY変数はHTTPSリクエスト用のプロキシサーバーを設定します。
この時点で、Pythonコードは数行のコードになり、ウェブページにリクエストを行う際に環境変数が自動的に使用されます:
# import packages.
import requests
from bs4 import BeautifulSoup

# Define a link to the web page.
url = "https://brightdata.com/"

# Send a GET request to the website.
response = requests.get(url)

# Use BeautifulSoup to parse the HTML content of the website.
soup = BeautifulSoup(response.content, "html.parser")

# Find all the links on the website.
links = soup.find_all("a")

# Print all the links.
for link in links:
    print(link.get("href"))
カスタムメソッドとプロキシ配列を使用してプロキシをローテーションする方法
プロキシのローテーションは非常に重要です。同じIPアドレスから大量のリクエストを受け取ると、ウェブサイトはボットやスクレイパーのアクセスをブロックまたは制限することがあります。その場合、ウェブサイトは悪意のあるスクレイピング活動を疑い、アクセスをブロックまたは制限する対策を実施します。
異なるプロキシIPアドレスをローテーションすることで、検出を回避し、複数のオーガニックユーザーとして見せかけ、ウェブサイトに実装されているほとんどのアンチスクレイピング対策を回避できます。
プロキシをローテーションするには、Requests、Beautiful Soup、Randomといういくつかのライブラリをインポートする必要があります。
次に、ローテーションプロセスで使用するプロキシのリストを作成します。このリストはhttp://proxyserver.com:portという形式のプロキシサーバーURLを含む必要があります:
# List of proxies
proxies = [
    "http://proxyprovider1.com:2010", "http://proxyprovider1.com:2020",
    "http://proxyprovider1.com:2030", "http://proxyprovider2.com:2040",
    "http://proxyprovider2.com:2050", "http://proxyprovider2.com:2060",
    "http://proxyprovider3.com:2070", "http://proxyprovider3.com:2080",
    "http://proxyprovider3.com:2090"
]
次に、get_proxy()というカスタムメソッドを作成します。このメソッドはrandom.choice()メソッドを使用してプロキシリストからランダムにプロキシを選択し、選択されたプロキシを辞書形式(HTTPとHTTPSの両方のキー)で返します。新しいリクエストを送信するたびにこのメソッドを使用します:
# Custom method to rotate proxies
def get_proxy():
    # Choose a random proxy from the list
    proxy = random.choice(proxies)
    # Return a dictionary with the proxy for both http and https protocols
    return {'http': proxy, 'https': proxy}
get_proxy()メソッドを作成したら、ローテーションされたプロキシを使用して一定数のGETリクエストを送信するループを作成する必要があります。各リクエストでは、get()メソッドがget_proxy()メソッドで指定されたランダムに選択されたプロキシを使用します。
次に、最初の例で説明したように、Beautiful Soupパッケージを使用してウェブページのHTMLコンテンツからリンクを収集します。
最後に、Pythonコードはリクエスト処理中に発生した例外をキャッチし、エラーメッセージをコンソールに出力します。
この例の完全なソースコードは以下の通りです:
# import packages
import requests
from bs4 import BeautifulSoup
import random

# List of proxies
proxies = [
    "http://proxyprovider1.com:2010", "http://proxyprovider1.com:2020",
    "http://proxyprovider1.com:2030", "http://proxyprovider2.com:2040",
    "http://proxyprovider2.com:2050", "http://proxyprovider2.com:2060",
    "http://proxyprovider3.com:2070", "http://proxyprovider3.com:2080",
    "http://proxyprovider3.com:2090"
]


# Custom method to rotate proxies
def get_proxy():
    # Choose a random proxy from the list
    proxy = random.choice(proxies)
    # Return a dictionary with the proxy for both http and https protocols
    return {'http': proxy, 'https': proxy}


# Send requests using rotated proxies
for i in range(10):
    # Set the URL to scrape
    url = 'https://brightdata.com/'
    try:
        # Send a GET request with a randomly chosen proxy
        response = requests.get(url, proxies=get_proxy())

        # Use BeautifulSoup to parse the HTML content of the website.
        soup = BeautifulSoup(response.content, "html.parser")

        # Find all the links on the website.
        links = soup.find_all("a")

        # Print all the links.
        for link in links:
            print(link.get("href"))
    except requests.exceptions.RequestException as e:
        # Handle any exceptions that may occur during the request
        print(e)
PythonでBright Dataプロキシサービスを使用する
ウェブスクレイピングタスクに信頼性が高く、高速で安定したプロキシをお探しなら、Bright Dataをぜひご検討ください。Bright Dataはウェブデータインフラであり、幅広いユースケースに対応したさまざまな種類のプロキシを提供しています。
Bright Dataは400M+ monthly以上のレジデンシャルプロキシIPと77万以上のデータセンター・プロキシからなる大規模なネットワークを持ち、信頼性が高く高速なプロキシソリューションを提供しています。プロキシサービスはウェブスクレイピング、広告検証、その他の匿名かつ効率的なウェブデータ収集を必要とするオンライン活動の課題を克服するよう設計されています。
Bright DataのプロキシをPythonリクエストに統合するのは簡単です。例えば、データセンター・プロキシを使用して前の例で使用したURLにリクエストを送信できます。
まだアカウントをお持ちでない場合は、Bright Dataの無料トライアルに登録し、詳細を入力してアカウントを登録してください。
完了したら、以下の手順に従って最初のプロキシを作成します:
ウェルカムページでプロキシ製品を見るをクリックして、Bright Dataが提供するさまざまな種類のプロキシを確認します:

データセンター・プロキシを選択して新しいプロキシを作成し、次のページで詳細を入力して保存します:

プロキシが作成されたら、アクセスして使用を開始するための重要なパラメータ(例:ホスト、ポート、ユーザー名、パスワード)を確認できます:
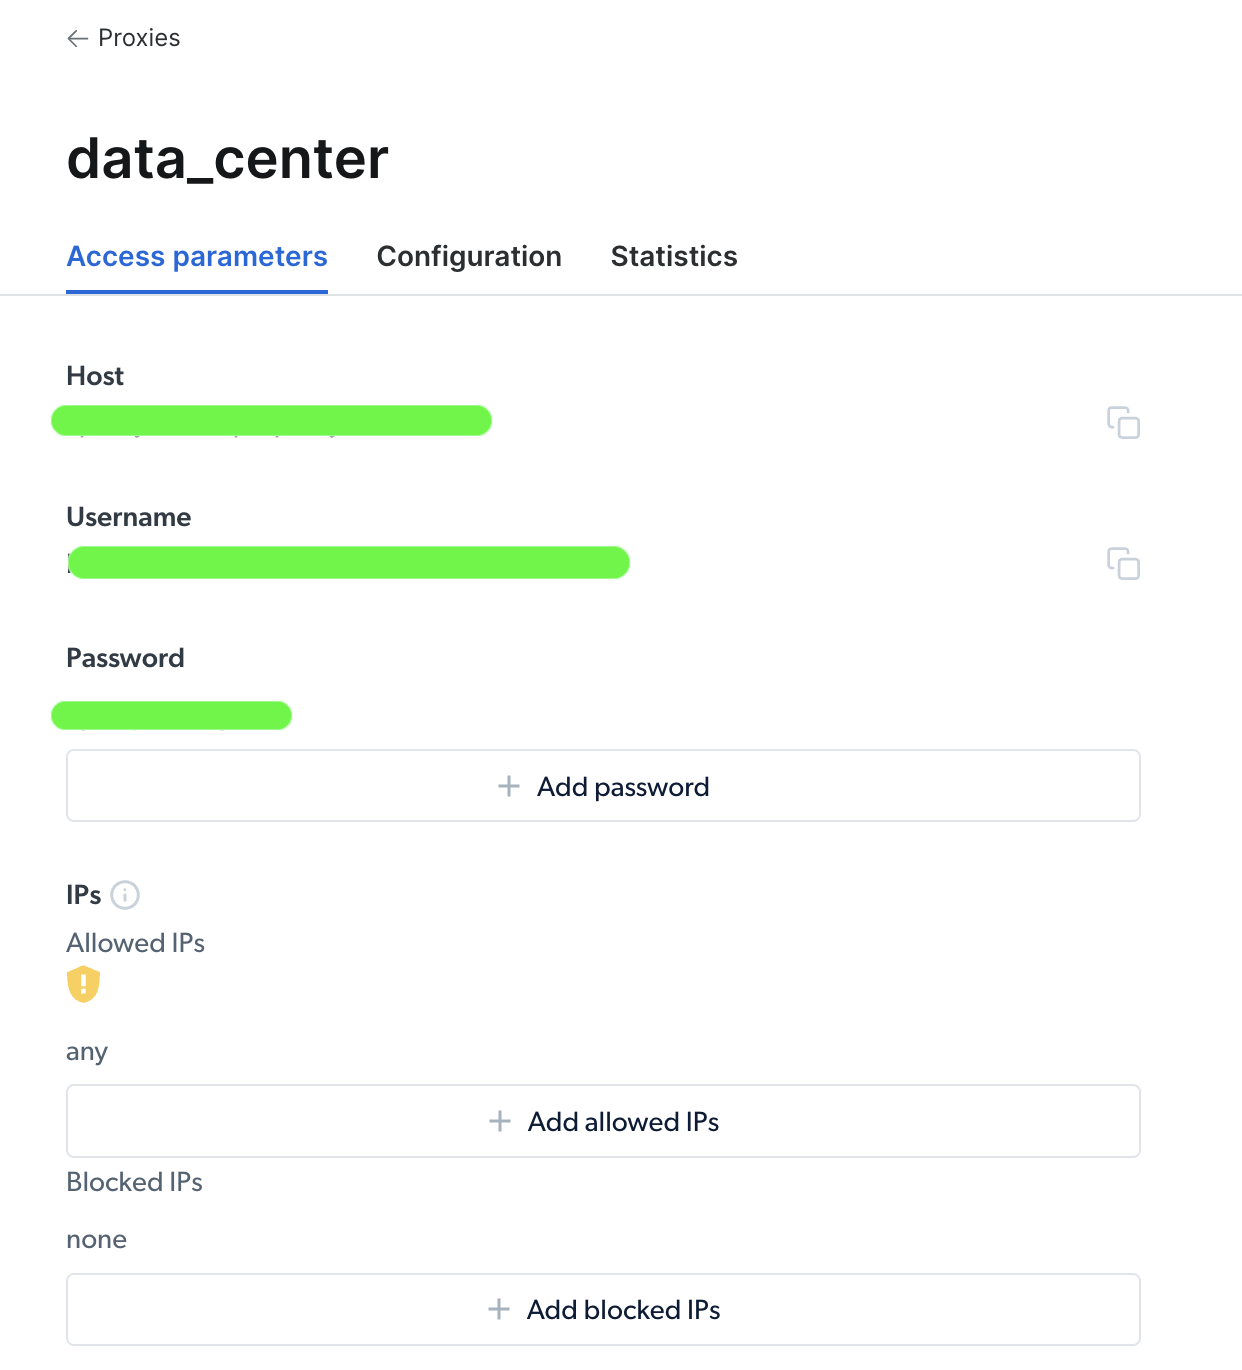
プロキシにアクセスしたら、パラメータ情報を使用してプロキシURLを設定し、RequestsのPythonパッケージを使用してリクエストを送信できます。プロキシURLの形式はusername-(session-id)-password@host:portです。
注意:
session-idはrandomというPythonパッケージを使用して生成されるランダムな数値です。
以下は、PythonリクエストにBright Dataのプロキシを設定するコードサンプルの例です:
import requests
from bs4 import BeautifulSoup
import random

# Define parameters provided by Brightdata
host = 'brd.superproxy.io'
port = 33335
username = 'username'
password = 'password'
session_id = random.random()

# format your proxy
proxy_url = ('http://{}-session-{}:{}@{}:{}'.format(username, session_id,
                                                     password, host, port))

# define your proxies in dictionary
proxies = {'http': proxy_url, 'https': proxy_url}

# Send a GET request to the website
url = "https://brightdata.com/"
response = requests.get(url, proxies=proxies)

# Use BeautifulSoup to parse the HTML content of the website
soup = BeautifulSoup(response.content, "html.parser")

# Find all the links on the website
links = soup.find_all("a")

# Print all the links
for link in links:
    print(link.get("href"))
ここでは、パッケージをインポートし、プロキシのホスト、ポート、ユーザー名、パスワード、session_id変数を定義します。次に、httpとhttpsのキーとプロキシ認証情報を持つproxies辞書を作成します。最後に、proxiesパラメータをrequests.get()関数に渡してHTTPリクエストを行い、URLからリンクを収集します。
以上です!Bright Dataのプロキシサービスを使用して正常にリクエストを送信できました。
まとめ
この記事では、プロキシが必要な理由と、RequestsのPythonパッケージを使用してウェブページにリクエストを送信するためのさまざまな使用方法について学びました。
Bright Dataのウェブインフラを使用すると、世界中の国や都市をカバーする信頼性の高いプロキシをプロジェクトに活用できます。さまざまな種類のプロキシやウェブスクレイピングツールを通じて、特定のニーズに合わせたデータ取得の方法を複数提供しています。
市場調査データの収集、オンラインレビューの監視、競合他社の価格追跡など、Bright Dataはあらゆる作業を迅速かつ効率的に完了するために必要なリソースを提供しています。


