Naverは2026年7月31日にShopping search APIを終了し、公式な代替手段は提供されませんでした。チームは依然としてNaver ShoppingやSmartStoreから価格、ランキング、販売者名が必要だったため、主な選択肢はNaverのページをスクレイピングすることでした。
テストでは、通常のHTTPクライアントはNaverの検索ページから完全な結果を取得できました。しかしNaverのショッピングページは、ブロックページ、CAPTCHA、またはログインリダイレクトを返しました。データはそれらのページ内にJSONとして埋め込まれたまま存在していました。
このガイドでは、PythonでそのJSONを読み取る方法、各ページタイプを取得するBright Dataツール、そして各ツールの課金方法を説明します。
TL;DR
- Bright DataのSERP APIでNaverの検索ページをスクレイピングします。 価格は
discountedSalePriceから読み取ってください。アイフォン17の8枚の価格比較カードのうち6枚でsalePriceが0だったためです。 - Plus Store結果にはWeb Unlockerを、ページネーションにはBrowser APIを使用します。 広告にフラグを立ててください。코카콜라 제로(コカコーラゼロ)の最初の6件のリストはすべて広告で、オーガニックは1件もありませんでした。
- 価格比較検索からShopping APIのほとんどのフィールドを再構築します。 Web Unlockerは10件中10件のクエリで、
lowPrice、brand、カテゴリを含むページのJSONを返しました。 - SmartStore商品URLをNaver Shopping Scraper APIに送信します。 10件のバッチで、各ページと一致する価格を伴うすべての公開リストが返されました。
Naver Shopping search APIの終了
NaverのOpen APIは、価格とデジタル棚監視の公式データソースでした。そのShopping search エンドポイントは1回の呼び出しで最大100商品を返し、無料キーで1日25,000回の呼び出しが可能でした。
Naverの開発者センターの告知では、Shopping、Book、研究文献検索APIが2026年7月31日に終了すると発表されました。告知では、既存のキーは猶予期間なしで動作しなくなるとされました。また、NAVER API HUBを含め、Naverは代替APIを提供しないとも述べられました。
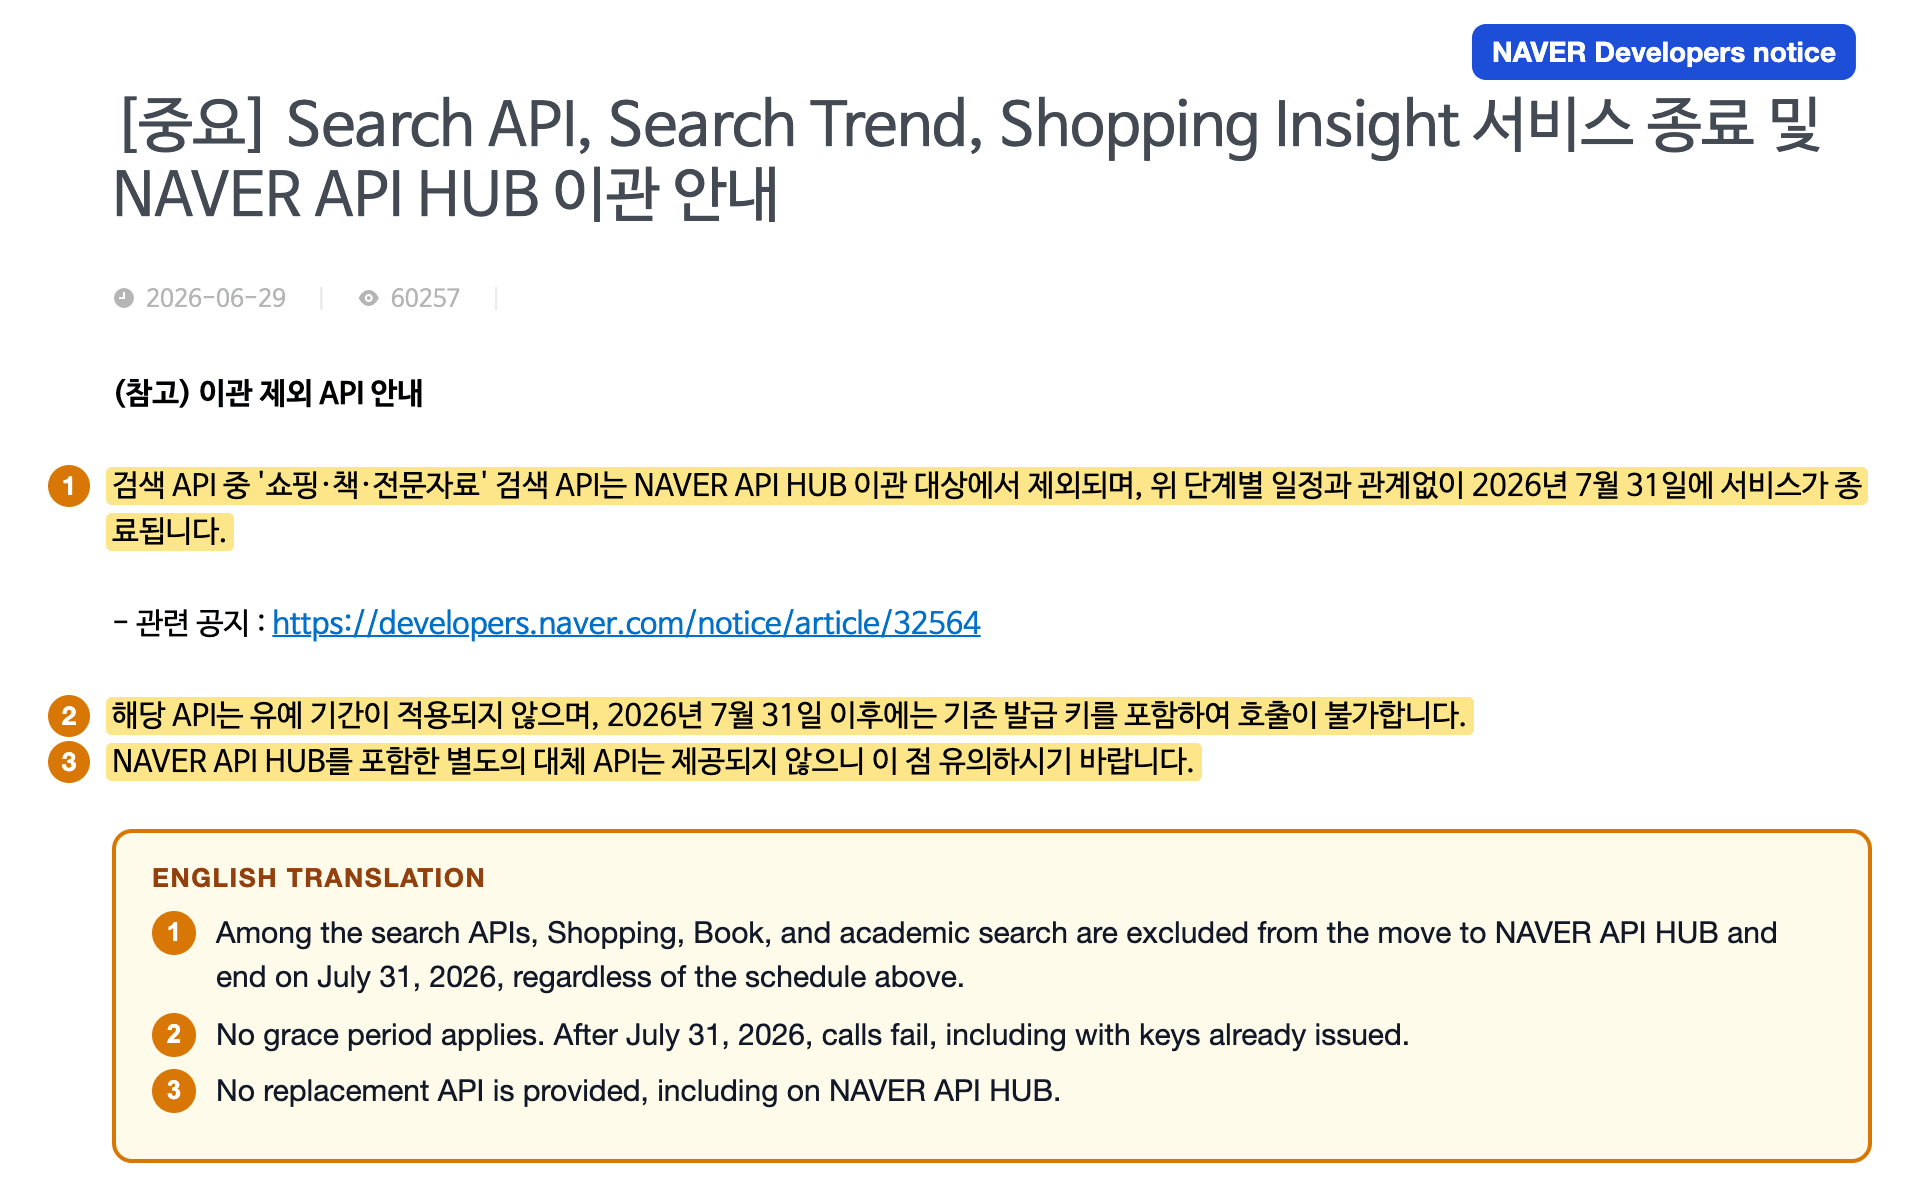
終了日が固定されており猶予期間もないため、このAPIを呼び出していたフィードは2026年7月31日までに新しいソースを必要としていました。
同じ告知で、ブログ、ニュース、ウェブ文書検索を含む他の検索APIは、NAVER Cloud Platform上のNAVER API HUBへ移行するとされました。2026年7月31日より前に発行された開発者センターのキーは、これらのAPIについて2027年6月30日まで動作し続けます。
NaverのOpen API利用規約の下では、これらのAPIも監視フィードとして使用することは想定されていませんでした。規約では、サービス継続のための一時的なキャッシュを除き、結果のコピー、保存、キャッシュを禁止していました。また、結果の第三者への提供や販売、AI入力や学習データとしての使用も禁止していました。
NaverのDataLab Shopping Insight APIは、カテゴリとキーワードごとのクリックトレンドを返していました。各トレンドは最高値が100になるようスケーリングされていました。これらのトレンドは関心が高まったか下がったかを示していましたが、価格は示していませんでした。Naverの公開ページには価格、ランキング、販売者名が表示されていたため、そこで収集します。
各Naverプロパティがスクレイパーにどう反応したか
インドの1つのレジデンシャル接続から、4つのNaverプロパティそれぞれに対して4種類の通常のHTTPクライアントをテストしました。検索とホテルのページは完全なHTMLを返しましたが、ショッピングと商品のページはそれらのクライアントをブロックしました。ブロックされたページについては、表にブラウザとアンブロッカーも含めています。
| Naverプロパティ | 通常のHTTPクライアントが取得した結果 | ブラウザとアンブロッカーが取得した結果 |
|---|---|---|
検索(search.naver.com) |
デフォルトのpython-requests User-Agentでも、約1.5MBの完全な結果ページ | ページ読み込みに不要 |
ショッピング検索(search.shopping.naver.com) |
HTTP 418のブロックページ、HTTP 405のCAPTCHAページ、またはNaverのログインページへの307リダイレクト | ヘッドレスChromeは418、ヘッドフルChromeはCAPTCHA、Web Unlockerは結果を取得 |
SmartStore商品(smartstore.naver.com) |
最初のリクエストで「시스템오류」(「システムエラー」)と題されたHTTP 429ページ | Web UnlockerとBrowser APIは商品ページを取得 |
ホテル(hotels.naver.com) |
Next.jsデータを含む完全なページ | ページ読み込みに不要 |
Naver検索は、CAPTCHAやブロックなしで500件のテストリクエストすべてに対して結果を返しました。最初の200件は約2秒間隔で順次送信されました。残りの300件は、8つの並行ワーカーから毎秒4.9リクエストのバーストとして送信され、バーストの各リクエストは新しいセッションを使用しました。
ショッピング検索の418ページには、アクセスが一時的に制限されていると記載されていました。このページには4つのトリガーが列挙されていました。ショッピングと無関係な外部プロモーションからの訪問、単一IPからのリクエストのバースト、VPNのIP、そして特定のブラウザ拡張機能です。405ページはncpt.naver.comからNaver自身のCAPTCHAスクリプトを読み込みました。
ヘッドフルChromeでは、405ページはwtm.pstatic.netからWebAssemblyモジュールを読み込み、暗号化されたペイロードをncpt.naver.com/v2/tokensに送信しました。その後、ページはレシートCAPTCHAを表示しました。生成されたレシートと、それに関する穴埋め問題です。
ChromeのUser-Agentを持つ通常のHTTPクライアントは、418ではなく405 CAPTCHAを取得しました。curl_cffiがChromeのTLSおよびHTTP/2フィンガープリントに一致させても、405 CAPTCHAは依然として表示されました。ヘッドレスChromeは、最初のドキュメントリクエストで0.5秒後、どのページスクリプトも実行される前に418を取得しました。python-requestsからヘッドフルChromeまで、6種類のクライアントのうちどれもショッピング結果を取得できませんでした。
SmartStoreの429は、新しいクライアントごとの最初のリクエストで現れたため、典型的なレート制限というよりもブロックのように振る舞いました。エラーテキストでは、原因はトラフィックの増加または不安定なネットワークとされていました。
ログインなしで読み込めるページのみを収集してください。ログインリダイレクトの背後にあるデータは公開されていません。アクセスにはNaverアカウントの自動化が必要になるためです。Bright Dataの利用規約でも、ログインの背後にあるデータは除外されています。
各プロパティは別々のターゲットとして扱ってください。
各Naverページに埋め込まれたJSON
テストしたすべてのNaverページは、データをHTML内にJSONまたはJavaScriptオブジェクトとして持っていたため、パーサーにCSSセレクタは不要でした。検索結果ページでは、各ショッピングブロックのデータが独自のJavaScript変数に割り当てられていました。
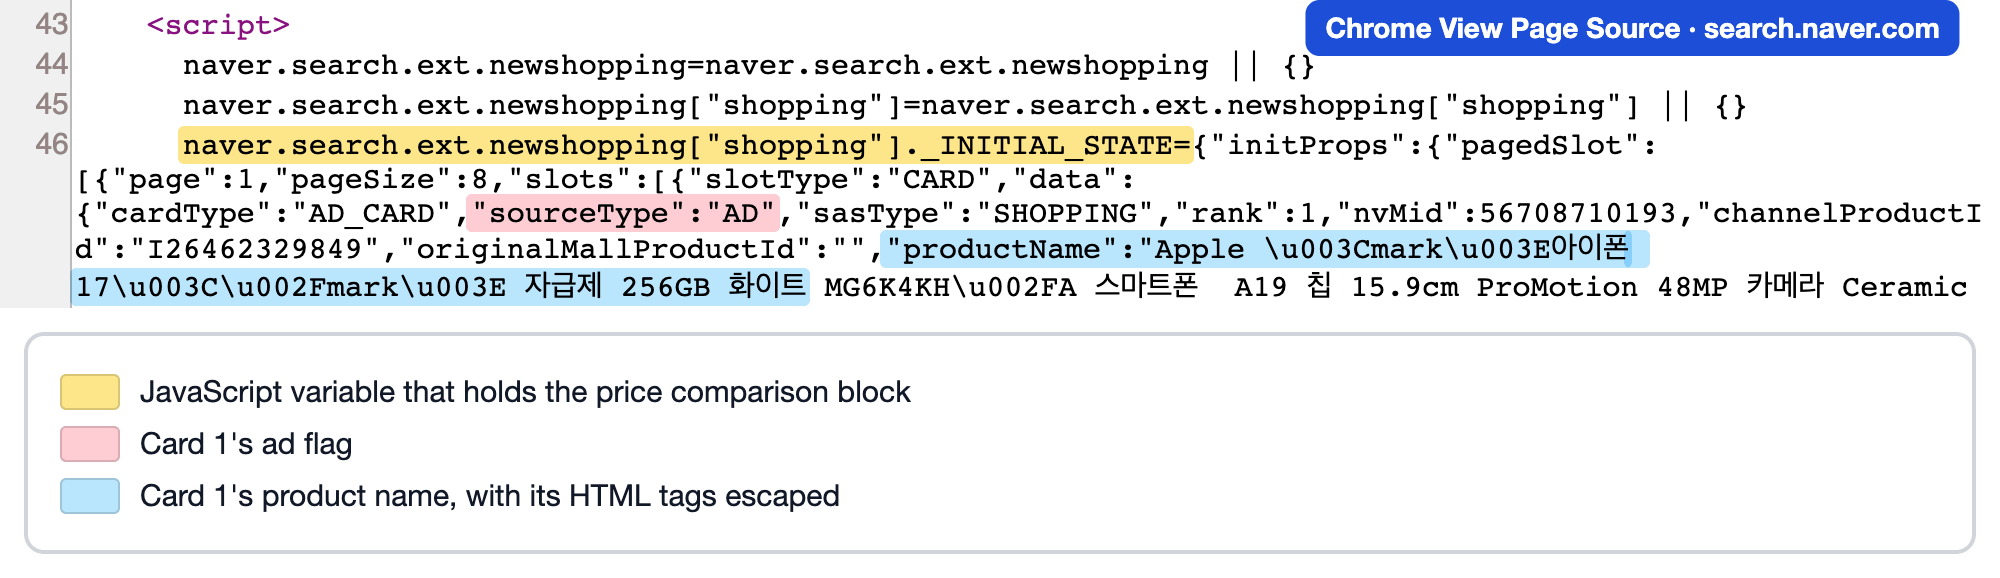
価格比較ブロックのデータは1つのJSONオブジェクトだったため、1回のデコーダー呼び出しでその中のすべてのカードを読み取れました。View Page Sourceでは、その割り当ては32,182文字の1行でした。
各ページはJSONを異なる場所に保存しており、それぞれに独自のパース上の問題がありました。
| ページ | JSONの場所 | パース上の問題 |
|---|---|---|
| 検索結果 | naver.search.ext.newshopping["shopping"]上の_INITIAL_STATEオブジェクト、および["nstore"]上の別のオブジェクト |
아이폰 17の8枚の価格比較カードのうち6枚でsalePriceが0でした。表示されている価格はdiscountedSalePriceにありました。 |
Plus Store検索(/ns/search) |
self.__next_f.pushでプッシュされたReact Server Componentチャンク。キーはinitPagedCompositeCards |
JSONの引用符はHTML内でエスケープされているため、検索する前にチャンクを結合してデコードしてください。 |
価格比較検索(/search/all) |
props.pageProps.compositeList.list[].itemにある__NEXT_DATA__ |
priceは文字列で、lowPriceは整数だったため、使用前にpriceを数値にキャストしてください。 |
| SmartStore商品 | simpleProductForDetailPageにあるwindow.__PRELOADED_STATE__ |
オブジェクトは厳密なJSONではなく、トップレベルのproductキーにゼロが入っていました。 |
パーサーが何も返さなくなったら、まずこれらのパスを確認してください。
レンダリングされたページの方が読みやすく見える場合でも、JSONをパースしてください。Naverのページでは、あるApple製品のレビュー数表示が「9,999+」に上限設定されていました。同じリストの埋め込みJSONには、正確な件数である13,971が保持されていました。
SmartStoreのstateには3つの追加チェックが必要でした。ある商品ページでは、stateは34個の裸のundefined値を持つJavaScriptオブジェクトリテラルだったため、json.loadsがエラーを発生させました。商品のidはURL内の番号と一致しましたが、内部のproductNoは別の番号だったため、商品IDにはidを使用してください。ページには2つのレビュー数もあり、1つは商品用、もう1つはより大きな商品グループ用でした。
以下の関数はオブジェクトを正規化し、生きているリストと削除済みのリストを分離します。
import json
import re

MARKER = "window.__PRELOADED_STATE__="


def smartstore_product(html: str) -> dict | None:
    start = html.index(MARKER) + len(MARKER)
    # The state is a JavaScript object literal, and bare undefined values break json
    text = re.sub(r"(?<=[:\[,])undefined(?=[,\]}])", "null", html[start:])
    state, _ = json.JSONDecoder().raw_decode(text)
    product = state["simpleProductForDetailPage"]
    # None for a deleted listing, an empty id for one behind an authorization check
    return product if product and product.get("id") else None
削除済み商品のURLは依然として「상품이 존재하지 않습니다」(「商品が存在しません」)と題された通常のページを返しました。そのため、ステータスコードのチェックだけでは、そのページを生きているリストとして扱ってしまいます。この関数は、そのページと認証チェックの背後にあるリストに対してNoneを返します。Noneの結果を、監視リストからそのURLを削除する合図として扱ってください。
Naver向けにBright Dataをセットアップする
4つのスクリプトはrequestsでBright DataのREST APIを呼び出し、ページネーションスクリプトはPlaywrightでクラウドブラウザを操作します。必要なものは次のとおりです。
- Bright Dataアカウントと、アカウント設定から取得するAPIキー。
- SERP APIゾーン、Web Unlockerゾーン、Browser APIゾーン。ゾーンとはコントロールパネル内の1つの製品の設定のことで、スクリプトはその名前を使用します。Naver Shopping Scraper APIはAPIキーのみが必要です。
requestsとplaywrightを備えたPython 3.10以降。ページネーションスクリプトはPlaywrightをリモートブラウザに接続するため、ローカルのブラウザをダウンロードする必要はありません。
セキュリティのため、ゾーンはIP Allowlistに登録されたアドレスからのリクエストのみを受け付けることができます。ゾーンへのリクエストがip_forbiddenを返す場合は、あなたのマシンのIPをそのリストに追加してください。
パッケージをインストールし、認証情報をエクスポートしてください。
pip install requests playwright
export BRIGHTDATA_API_KEY="your_api_key"
export BRIGHTDATA_SERP_ZONE="your_serp_zone"
export BRIGHTDATA_UNLOCKER_ZONE="your_unlocker_zone"
export BRIGHTDATA_BROWSER_WSS="wss://brd-customer-<id>-zone-<zone>-country-kr:<password>@brd.superproxy.io:9222"BRIGHTDATA_BROWSER_WSSの値は、ゾーンのAccess details内のPuppeteer / Playwrightに表示されるWebSocket URLです。
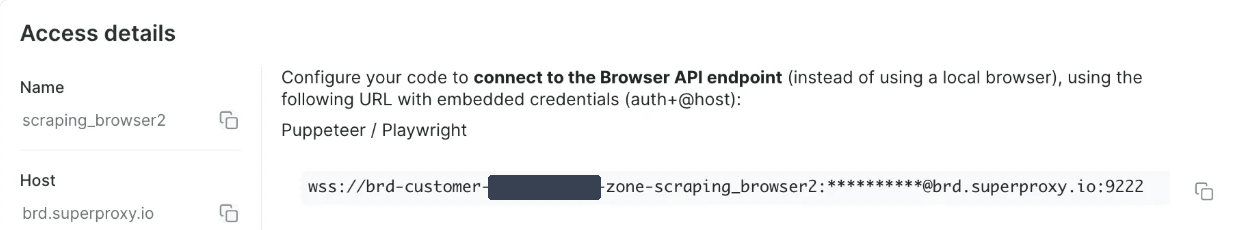
URLにはすでにゾーンのユーザー名とパスワードが埋め込まれています。
韓国のIP経由でリクエストをルーティングするには、ゾーン名の後に-country-krを追加してください。生のHTTPよりSDKを好む場合は、Bright Data Python SDKであるbrightdata-sdkをインストールしてください。
コードを書く前に単一のURLを確認するには、Web Unlocker経由でURLを取得するBright Data CLIを使用してください。
bdata scrape "https://smartstore.naver.com/acnope/products/10444371682" --country kr -f html -o product.htmlこのコマンドは完全なSmartStore商品ページを保存したため、smartstore_product(open("product.html", encoding="utf-8").read())はその商品データを返します。
SERP APIでNaver検索からショッピング結果をスクレイピングする
아이폰 17(iPhone 17)について、Naverのデスクトップ結果ページには2つのショッピングブロックが表示されました。1つは価格比較カード、もう1つはNaver Plus Store商品でした。
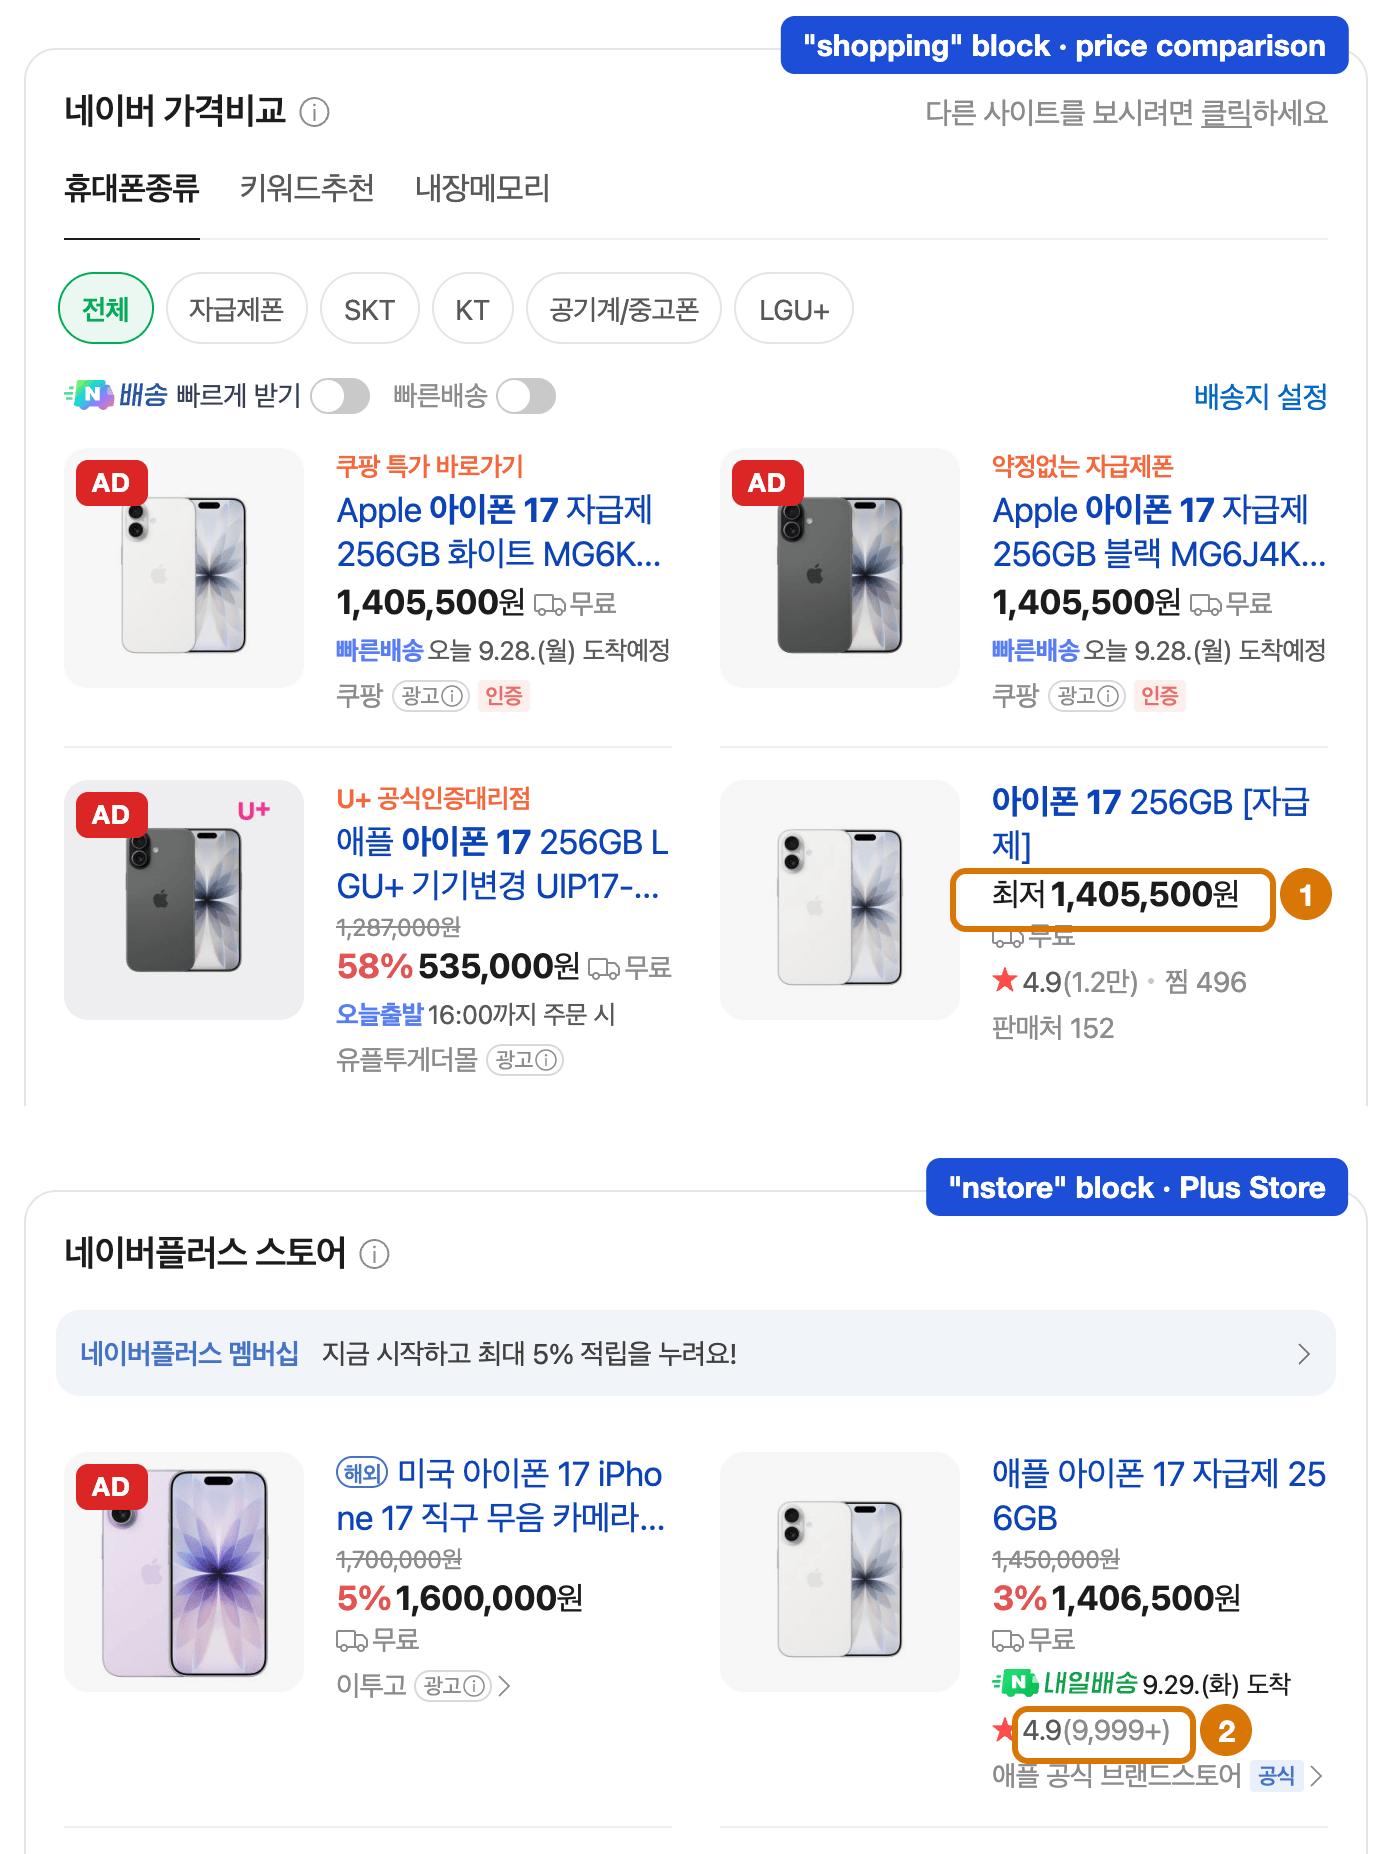
赤いタグは、Naverが광고(広告)とラベル付けしたカードを示しており、パーサーはそれらにis_adのフラグを立てます。マーカー1では、カードは1,405,500원を表示していましたが、そのsalePriceフィールドは0でした。マーカー2では、レビュー数は9,999+と表示されていましたが、JSONには13,971が保持されていました。
Naverを含む検索エンジン結果ページ(SERP)にはSERP APIを、それ以外のサイトにはWeb Unlockerを使用してください。SERP APIは成功したリクエストごとに課金されます。
NaverはSERP APIのリクエストを韓国にジオロケーションしました。その埋め込みJSONは、それらのリクエストに対してKRを記録し、インドからの直接リクエストに対してはインドの都市とともにINを記録しました。
Naverの場合、ゾーンのデータフォーマットをRaw HTMLに設定するか、各リクエストで"data_format": "html"を渡してください。
Raw HTMLは、Naverの埋め込みショッピングJSONを含む完全な結果ページを返しました。
以下のスクリプトは結果ページを取得し、両方のショッピングブロックからすべてのカードを、広告フラグ付きで返します。
import json
import os
import re
from urllib.parse import quote

import requests

API_URL = "https://api.brightdata.com/request"
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"}
SERP_ZONE = os.environ["BRIGHTDATA_SERP_ZONE"]

# Each shopping block on the results page assigns its data to a JS global
STATE = re.compile(r'naver\.search\.ext\.newshopping\["(\w+)"\]\._INITIAL_STATE\s*=\s*')


def fetch_naver_serp(query: str) -> str:
    url = f"https://search.naver.com/search.naver?where=nexearch&query={quote(query)}"
    resp = requests.post(
        API_URL,
        headers=HEADERS,
        # Request the raw page, which contains Naver's embedded shopping JSON
        json={"zone": SERP_ZONE, "url": url, "format": "raw", "data_format": "html"},
        timeout=120,
    )
    resp.raise_for_status()
    if resp.headers.get("x-brd-error") or "_INITIAL_STATE" not in resp.text:
        raise RuntimeError(f"No shopping state for {query!r}: {resp.headers.get('x-brd-error')}")
    return resp.text


def parse_shopping_blocks(html: str) -> list[dict]:
    decoder = json.JSONDecoder()
    rows = []
    for match in STATE.finditer(html):
        block = match.group(1)  # "shopping" = price comparison, "nstore" = Plus Store
        state, _ = decoder.raw_decode(html, match.end())
        props = state["initProps"]
        if block == "shopping":
            items = [slot["data"] for page in props["pagedSlot"] for slot in page["slots"]]
        else:
            items = props["products"]
        for position, item in enumerate(items, start=1):
            rows.append({
                "block": block,
                "position": position,
                "is_ad": item.get("sourceType") == "AD",
                "name": re.sub(r"<[^>]+>", "", item.get("productName", "")),
                # discountedSalePrice holds the displayed price, and salePrice can be 0
                "price": item.get("discountedSalePrice") or item.get("salePrice"),
                "mall": item.get("mallName") or None,
                "reviews": item.get("totalReviewCount"),
                "nv_mid": item.get("nvMid"),
                "channel_product_id": item.get("channelProductId"),
            })
    return rows


if __name__ == "__main__":
    for row in parse_shopping_blocks(fetch_naver_serp("아이폰 17")):
        label = "ad" if row["is_ad"] else "  "
        print(f'{row["block"]:<8} {row["position"]} {label} {row["price"]:>9,} KRW  '
              f'{row["mall"] or "(catalog)":<12} {row["name"][:24]}')
아이폰 17について、スクリプトは8枚の価格比較カードと4つのPlus Store商品を出力しました。
shopping 1 ad 1,405,500 KRW  쿠팡           Apple 아이폰 17 자급제 256GB 화
shopping 2 ad 1,405,500 KRW  쿠팡           Apple 아이폰 17 자급제 256GB 블
shopping 3 ad   535,000 KRW  유플투게더몰       애플 아이폰 17 256GB LGU+ 기기변
shopping 4    1,405,500 KRW  (catalog)    아이폰 17 256GB [자급제]
shopping 5    1,713,000 KRW  (catalog)    아이폰 17 프로 256GB [자급제]
shopping 6    2,006,400 KRW  (catalog)    아이폰 17 프로 512GB [자급제]
shopping 7       29,600 KRW  로트박스         [대여] 애플 아이폰 17 프로 대여 렌탈
shopping 8    2,294,400 KRW  (catalog)    아이폰 17 프로 1TB [자급제]
nstore   1 ad 1,600,000 KRW  이투고          미국 아이폰 17 iPhone 17 직구 무
nstore   2    1,406,500 KRW  애플 공식 브랜드스토어 애플 아이폰 17 자급제
nstore   3    1,790,000 KRW  애플 공식 브랜드스토어 애플 아이폰 17 프로 자급제
nstore 4 1,697,500 KRW 애플 공식 브랜드스토어 애플 아이폰 17 자급제最初の3枚のカードは広告で、3番目は通信契約を必要とする価格を表示しており、SIMフリー端末の価格ではありませんでした。カタログ商品カードにはmallの値がなく、channel_product_idも空でした。これは単一の店舗ではなくNaverの価格比較ページを指していたためです。10件のクエリ全体で、SERP APIはショッピングJSONを含むページを10件中10件で返しました。
同じ日の2回の実行の間で、2つのPlus Storeの順位が入れ替わりました。すべての行にタイムスタンプと広告フラグを保存し、順位トラッキングが変化を報告する前に、キーワードを複数回サンプリングしてください。
Web UnlockerでNaver Plus Store検索結果をスクレイピングする
Naverは2024年にショッピングプラットフォームであるPlus Storeを開始しました。その検索ページでは、通常のHTTPクライアントは418ブロックページ、405 CAPTCHA、またはログインリダイレクトを取得しました。
Bright Dataの自動WebアンブロッカーであるWeb Unlockerは、URLを取得し、成功したリクエストごとに課金されます。韓国のIPを使用すると、最初の50枚のカードが埋め込まれた検索ページが返されました。10件のクエリ全体で、Web Unlockerは10件中10件で結果データを含むPlus Storeページを返しました。
以下の取得関数は韓国のIPをリクエストし、レスポンスに結果データが含まれていることを確認し、バックオフ付きでリトライします。
import json
import os
import re
import time
from collections import Counter
from urllib.parse import quote

import requests

API_URL = "https://api.brightdata.com/request"
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"}
UNLOCKER_ZONE = os.environ["BRIGHTDATA_UNLOCKER_ZONE"]

FLIGHT = re.compile(r"self\.__next_f\.push\((\[.*?\])\)</script>", re.S)
KEY = '"initPagedCompositeCards":'
MARKER = "initPagedCompositeCards"  # quotes are escaped inside the raw HTML


def fetch_plus_store_search(query: str, attempts: int = 3) -> str:
    url = f"https://search.shopping.naver.com/ns/search?query={quote(query)}"
    for attempt in range(1, attempts + 1):
        resp = requests.post(
            API_URL,
            headers=HEADERS,
            json={"zone": UNLOCKER_ZONE, "url": url, "format": "raw", "country": "kr"},
            timeout=180,
        )
        # Naver can redirect to a login page, so check for the result data, not the status
        if resp.ok and MARKER in resp.text:
            return resp.text
        reason = resp.headers.get("x-brd-error") or ("login wall" if "nidlogin" in resp.text else "no data")
        print(f"attempt {attempt} failed: {reason}")
        time.sleep(5 * attempt)
    raise RuntimeError(f"Plus Store search failed for {query!r}")


def parse_search(html: str) -> dict:
    # The page streams React Server Component data in string chunks
    chunks = [json.loads(m.group(1)) for m in FLIGHT.finditer(html)]
    flight = "".join(c[1] for c in chunks if len(c) == 2 and isinstance(c[1], str))
    start = flight.index(KEY) + len(KEY)
    result, _ = json.JSONDecoder().raw_decode(flight, start)
    products = []
    for card in result["data"]:
        item = card.get("card", {}).get("product")
        if not item:
            continue  # banners and promotion slots have no product
        products.append({
            "rank": len(products) + 1,
            "type": item.get("cardType") or "ORGANIC",
            "name": item.get("productName"),
            "price": item.get("discountedSalePrice"),
            "list_price": item.get("salePrice"),
            "mall": item.get("mallName"),
            "reviews": item.get("totalReviewCount"),
            "url": (item.get("productUrl") or {}).get("pcUrl"),
        })
    return {"total": result["total"], "next_cursor": result["cursor"], "products": products}


if __name__ == "__main__":
    page = parse_search(fetch_plus_store_search("코카콜라 제로"))
    mix = Counter(p["type"] for p in page["products"])
    print("total results:", page["total"], "| next cursor:", page["next_cursor"], "| page 1 mix:", dict(mix))
    for p in page["products"][:3] + [p for p in page["products"] if p["type"] == "ORGANIC"][:2]:
        print(json.dumps(p, ensure_ascii=False))
코카콜라 제로(コカコーラゼロ)について、ページ1には50枚のカードのうち47個の商品があり、最初のオーガニックリストは7位でした。
total results: 7746 | next cursor: 33 | page 1 mix: {'AD': 12, 'SUPER_POINT': 2, 'ORGANIC': 31, 'SME_SLOT': 2}
{"rank": 1, "type": "AD", "name": "코카-콜라 제로 CAN 350ml 24개", "price": 21600, "list_price": 35290, "mall": "코카콜라직영몰", "reviews": 96956, "url": "https://smartstore.naver.com/main/products/4660954096"}
{"rank": 2, "type": "AD", "name": "코카-콜라 제로 CAN 190ml 30개", "price": 18000, "list_price": 24790, "mall": "코카콜라직영몰", "reviews": 46451, "url": "https://smartstore.naver.com/main/products/4609271837"}
{"rank": 3, "type": "AD", "name": "코카-콜라 제로 레몬라임 CAN 350ml 48개(2x24입) + 코크 큐브 블럭캘린더 (옵션선택)", "price": 38720, "list_price": 70580, "mall": "코카콜라직영몰", "reviews": 440, "url": "https://smartstore.naver.com/main/products/13689352448"}
{"rank": 7, "type": "ORGANIC", "name": "코카-콜라 제로 라벨프리 PET 370ml 24개", "price": 22880, "list_price": 35300, "mall": "코카콜라직영몰", "reviews": 25197, "url": "https://smartstore.naver.com/main/products/6006925665"}
{"rank": 8, "type": "ORGANIC", "name": "코카-콜라 제로 제로 라벨프리 PET 370ml 18개", "price": 16720, "list_price": 20900, "mall": "코카콜라직영몰", "reviews": 3676, "url": "https://smartstore.naver.com/main/products/11574172085"}
ページそのものでは、最初の6位にオーガニックのリストは1件もありませんでした。
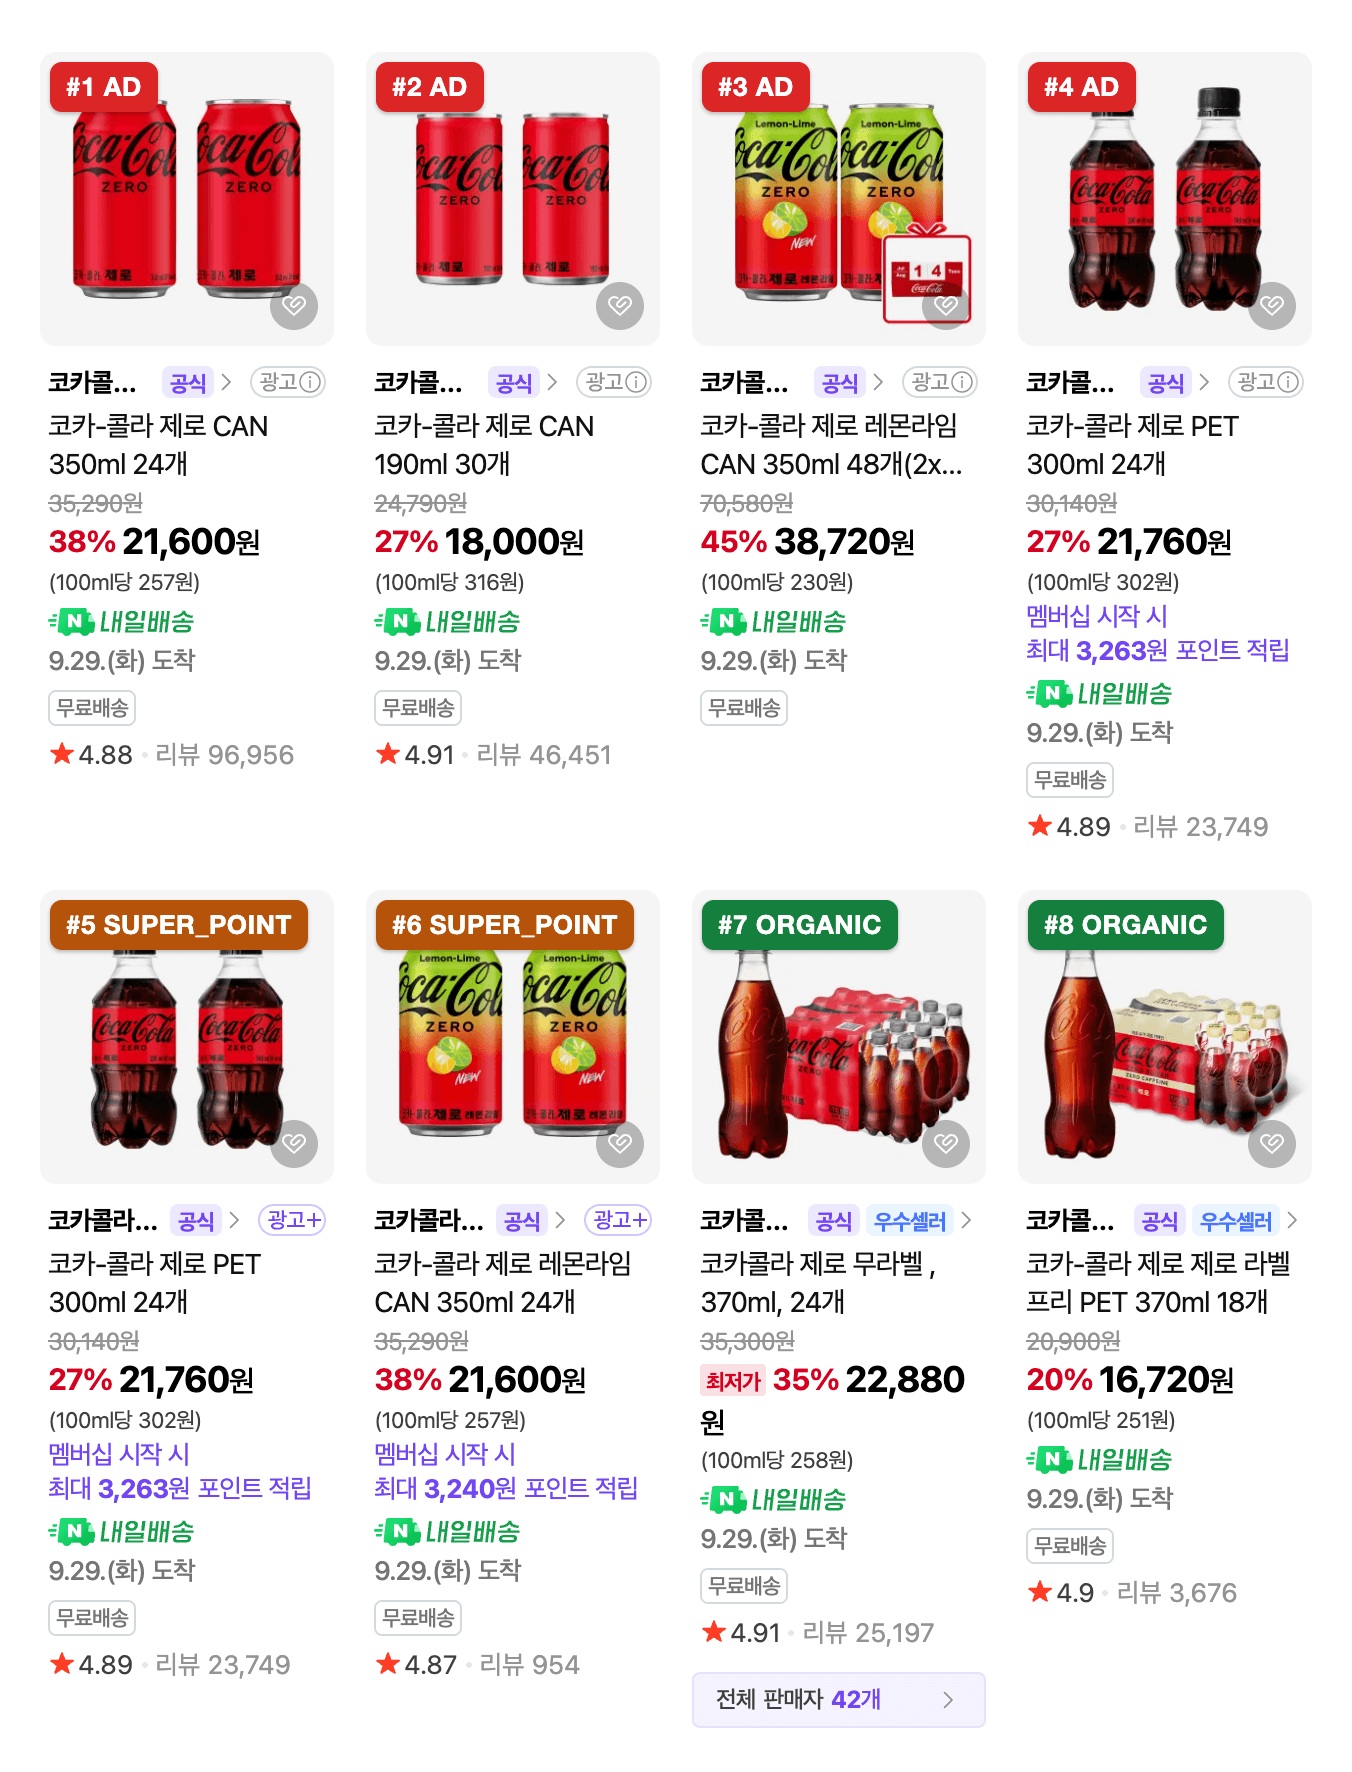
Naverは1位から6位に광고(広告)のラベルを付けており、パーサーはそのtypeをADまたはSUPER_POINTに設定しました。
すべての行にtypeを保持してください。そうすれば棚シェアレポートが広告とプロモーションをオーガニックリストから分離できます。各リストのURLにある商品番号を商品IDとして使用してください。名前は信頼できるIDではありません。このページでは、Naverカタログにリンクした8枚のカードすべてが、保存されたproductNameではなくcatalogNameを表示していたためです。
Browser APIでPlus Store検索結果をページネーションする
Plus Store結果のページ1はHTML内に埋め込まれていましたが、サイトはページ2以降を無限スクロールで読み込みました。これがWeb UnlockerとBrowser APIの違いです。Web Unlockerはページを返し、Browser APIはそれをスクロールできます。ショッパーがスクロールすると、ページはカーソル付きで/ns/v1/search/paged-composite-cardsをリクエストし、各リクエストにはx-wtm-ncaptcha-tokenヘッダーが付与されていました。ページは呼び出しごとに新しいトークンを生成していました。
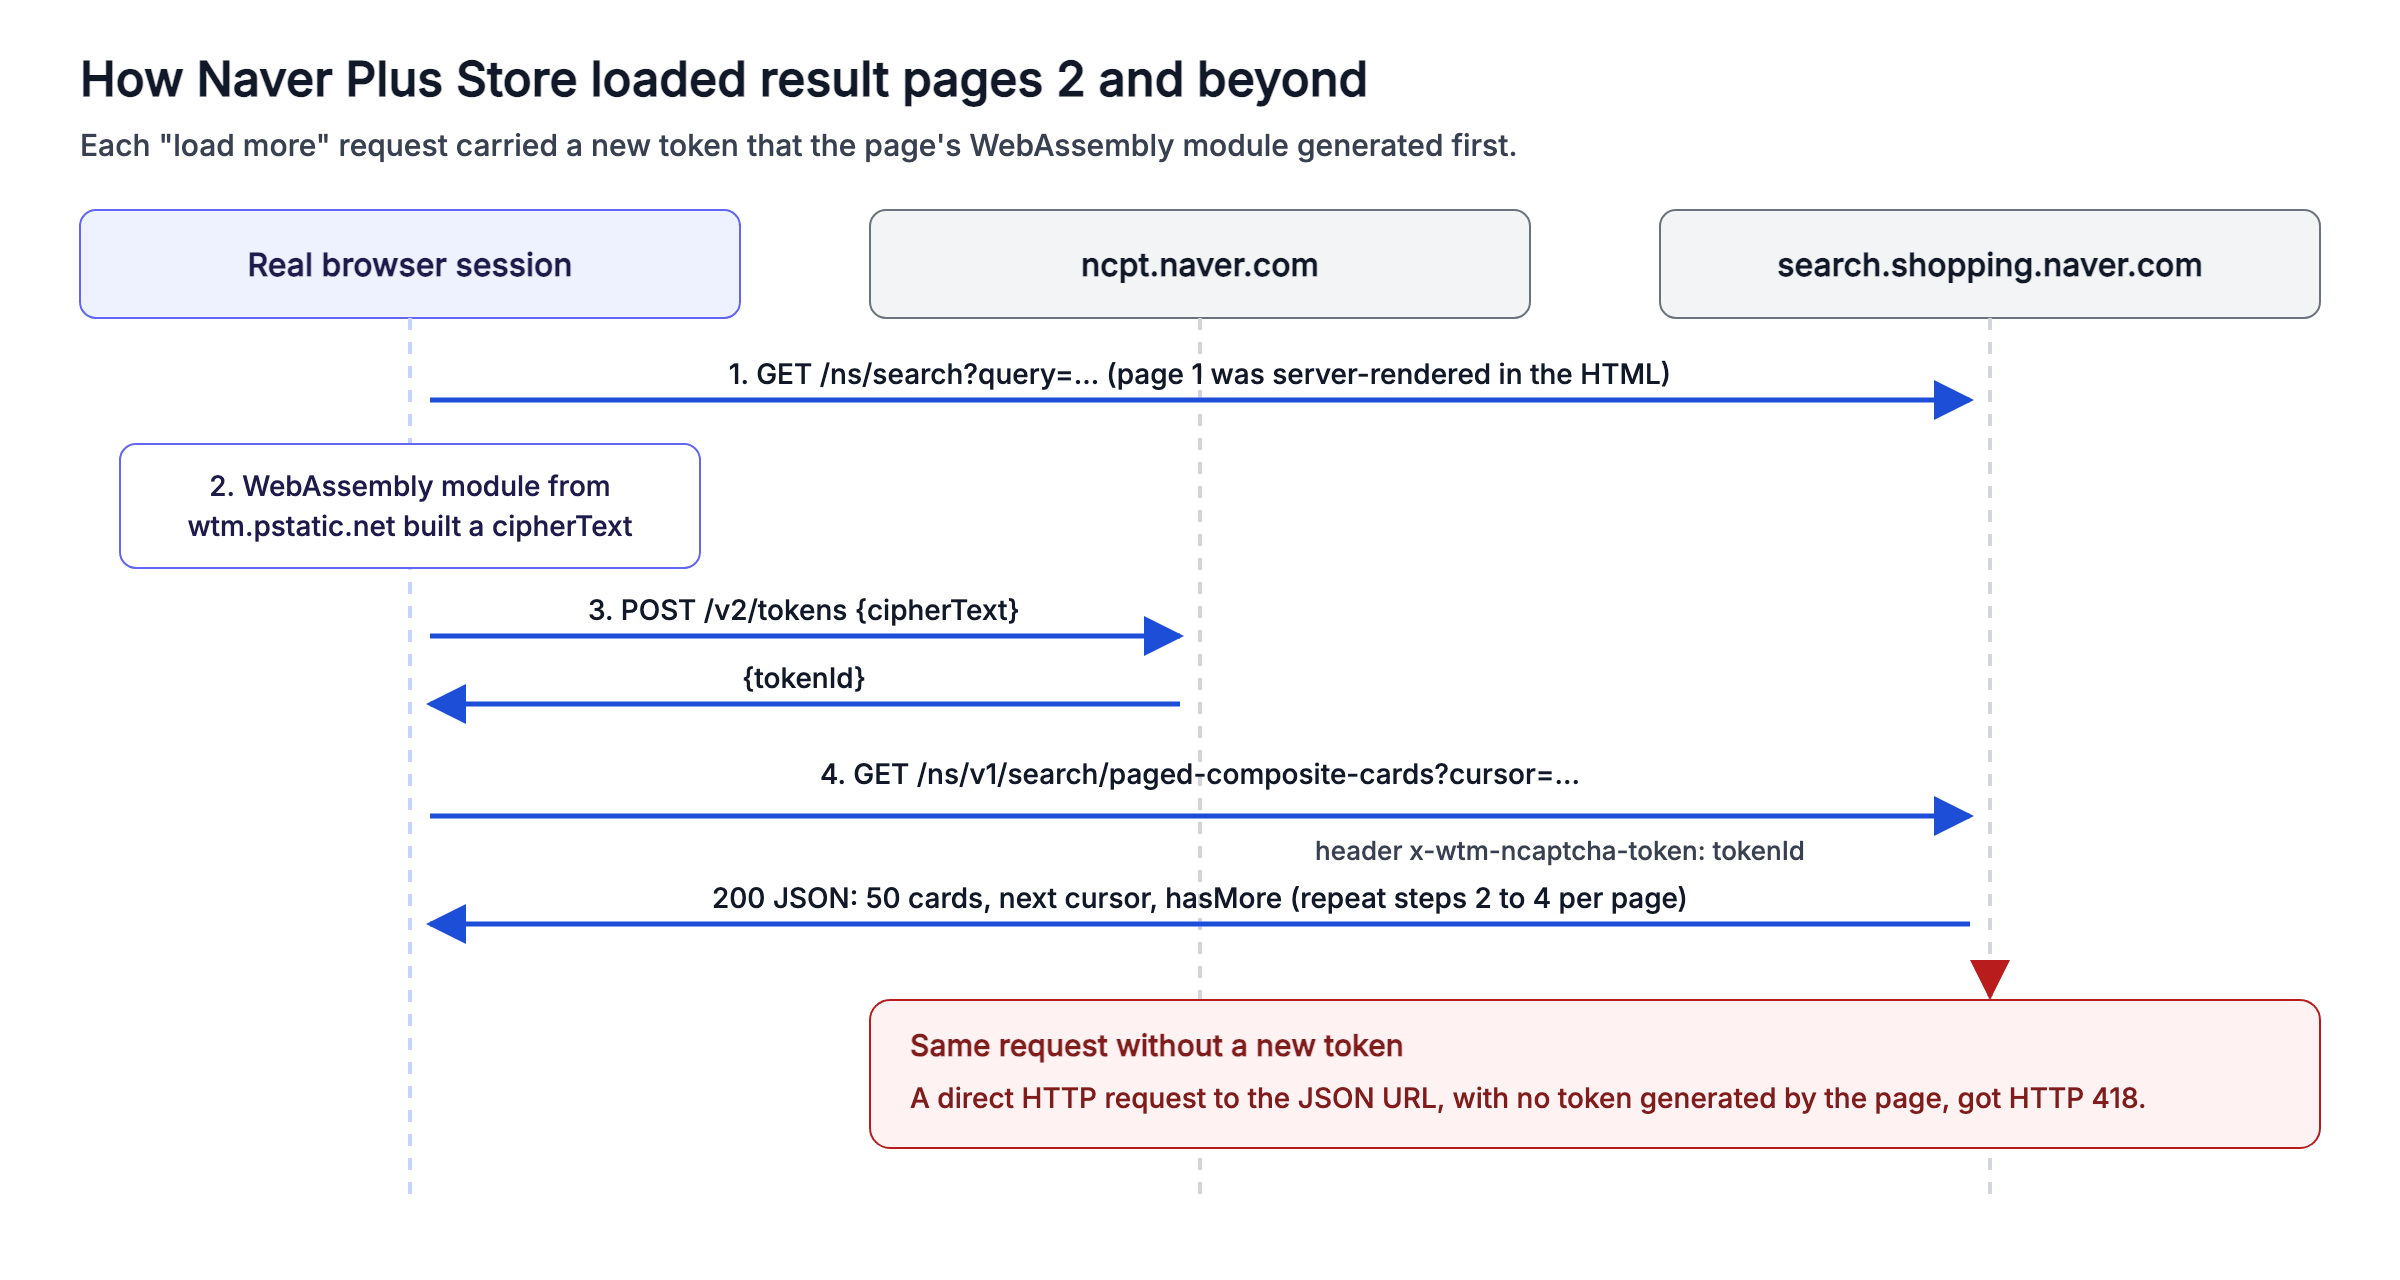
新しいトークンなしでエンドポイントに直接リクエストすると、HTTP 418が返されました。実際のブラウザでページを実行すると、ページ自身のスクリプトが各トークンを生成できました。
Browser APIはBright Dataのクラウド上でChromeを実行し、帯域幅に応じて課金されます。そのブラウザでは、ページ自身のWebAssemblyが各トークンを生成し、コードはJSONレスポンスを読み取るだけで済みました。以下のスクリプトはChrome DevTools Protocol(CDP)経由で接続し、一定でない間隔とポーズでスクロールし、結果の各ページをキャプチャします。
import asyncio
import os
import random
import time
from urllib.parse import quote

from playwright.async_api import async_playwright

# wss://brd-customer-<id>-zone-<zone>-country-kr:<password>@brd.superproxy.io:9222
BROWSER_WSS = os.environ["BRIGHTDATA_BROWSER_WSS"]
PAGED_API = "/ns/v1/search/paged-composite-cards"


async def plus_store_pages(query: str, extra_pages: int = 5, budget_s: int = 120) -> list[dict]:
    """Return result pages 2..N as JSON. The page generates each request's token itself."""
    pages = []
    async with async_playwright() as p:
        browser = await p.chromium.connect_over_cdp(BROWSER_WSS)
        page = await browser.new_page()

        async def on_response(response):
            # The page fetches each new set of cards as JSON while it scrolls
            if PAGED_API in response.url and response.ok:
                pages.append((await response.json())["data"])

        page.on("response", on_response)
        first = await page.goto(f"https://search.shopping.naver.com/ns/search?query={quote(query)}",
                                wait_until="domcontentloaded", timeout=120_000)
        if first.status != 200:
            raise RuntimeError(f"landing page returned {first.status}")
        deadline = time.time() + budget_s
        while len(pages) < extra_pages and time.time() < deadline:
            if pages and not pages[-1]["hasMore"]:
                break
            # Scroll in uneven steps with pauses
            await page.mouse.wheel(0, random.randint(900, 1500))
            await page.wait_for_timeout(random.randint(2500, 4500))
        await browser.close()
    return pages


if __name__ == "__main__":
    result = asyncio.run(plus_store_pages("캠핑의자"))
    for data in result:
        products = [c["card"]["product"] for c in data["data"] if c.get("card", {}).get("product")]
        print(f"page {data['data'][0]['page']}: {len(products)} products, next cursor {data['cursor']}")
캠핑의자(キャンプチェア)について、セッションはページ2から6を収集しました。
page 2: 50 products, next cursor 74
page 3: 50 products, next cursor 112
page 4: 50 products, next cursor 151
page 5: 50 products, next cursor 189
page 6: 50 products, next cursor 239
このスクロールパターンでさらに3回のセッションを行ったところ、それぞれが5ページすべての追加ページを収集しました。スクリプトを調整する際は、不均等なステップとポーズを維持し、セッションがテスト済みのパターンに一致するようにしてください。
価格比較検索からShopping APIのフィールドを再構築する
テストしたページの中で、/search/allにあるNaverの価格比較検索が、廃止されたAPIに最も似ていました。その__NEXT_DATA__には、Shopping search APIが返していた14フィールドのうち12フィールドが含まれていたため、壊れたフィードはほとんどのスキーマを維持できます。
| Shopping search APIのフィールド | 価格比較検索のフィールド |
|---|---|
productId |
id |
title |
productTitle |
link |
単一店舗の商品はmallProductUrl、カタログ商品はNaverの追跡リンクであるcrUrl |
image |
imageUrl |
lprice |
カタログ商品について店舗間の最安値であるlowPrice |
hprice |
マッピングしない:確認したすべての結果でhighPriceは空または「0」でした |
mallName |
mallName。多くの店舗が販売するカタログ商品の場合は空 |
productType |
mallCountから部分的に判定:0より大きい場合はカタログ商品 |
brandとmaker |
brandとmaker |
category1からcategory4 |
category1Nameからcategory4Name |
Web Unlockerは、10件のテストクエリのうち10件で、結果リストを含むこのページを返しました。以下のスクリプトはWeb Unlocker経由でページを取得し、最大3回試行し、各結果のフィールドをAPIの名前にリネームします。
import json
import os
import re
import time
from urllib.parse import quote

import requests

API_URL = "https://api.brightdata.com/request"
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"}
UNLOCKER_ZONE = os.environ["BRIGHTDATA_UNLOCKER_ZONE"]
NEXT_DATA = re.compile(r'<script id="__NEXT_DATA__" type="application/json">(.*?)</script>', re.S)


def fetch_price_comparison(query: str, attempts: int = 3) -> str:
    url = f"https://search.shopping.naver.com/search/all?query={quote(query)}"
    for attempt in range(1, attempts + 1):
        resp = requests.post(
            API_URL,
            headers=HEADERS,
            json={"zone": UNLOCKER_ZONE, "url": url, "format": "raw", "country": "kr"},
            timeout=180,
        )
        # A login page also returns 200, so check for the result list
        if resp.ok and "compositeList" in resp.text:
            return resp.text
        print(f"attempt {attempt} failed: {resp.headers.get('x-brd-error') or 'no result list'}")
        time.sleep(5 * attempt)
    raise RuntimeError(f"Price comparison search failed for {query!r}")


def as_api_items(html: str) -> list[dict]:
    """Rename each result's fields to the ones the Shopping search API returned."""
    data = json.loads(NEXT_DATA.search(html).group(1))
    rows = []
    for entry in data["props"]["pageProps"]["compositeList"]["list"]:
        item = entry["item"]
        rows.append({
            "productId": item.get("id"),
            "title": item.get("productTitle"),
            "link": item.get("mallProductUrl") or item.get("crUrl"),  # catalog products have no store URL
            "lprice": item.get("lowPrice"),  # the lowest price across stores for a catalog product
            "mallName": item.get("mallName") or None,
            "mallCount": item.get("mallCount"),  # above 0 marks a price comparison catalog product
            "brand": item.get("brand"),
            "maker": item.get("maker"),
            **{f"category{i}": item.get(f"category{i}Name") for i in range(1, 5)},
            # adId marks an ad, and entry types other than "product" are promoted slots
            "is_ad": bool(item.get("adId")) or entry["type"] != "product",
        })
    return rows


if __name__ == "__main__":
    rows = as_api_items(fetch_price_comparison("코카콜라 제로"))
    first = next(i for i, row in enumerate(rows) if not row["is_ad"])
    print(f"{len(rows)} results, {sum(r['is_ad'] for r in rows)} ads or promoted slots, first organic at rank {first + 1}")
    print(json.dumps({k: v for k, v in rows[first].items() if k != "link"}, ensure_ascii=False))
코카콜라 제로について、最初の8件の結果は広告またはプロモーション枠で、最初のオーガニックな結果はカタログ商品でした。
56 results, 16 ads or promoted slots, first organic at rank 9
{"productId": "54166199731", "title": "코카콜라 콜라 , 190ml, 30개", "lprice": 13400, "mallName": null, "mallCount": 8702, "brand": "코카콜라", "maker": "코카콜라", "category1": "식품", "category2": "음료", "category3": "청량/탄산음료", "category4": "콜라", "is_ad": false}ページのJSONは広告にもフラグを立てており、これは廃止されたAPIが返していなかった情報です。そのため、新旧のランキングを比較する前にis_adでフィルタリングしてください。
Naver Shopping Scraper APIでSmartStore商品レコードを取得する
商品詳細には、HTMLではなく構造化されたレコードをリクエストしてください。Bright DataのWeb Scraper APIの一部であるNaver Shopping Scraper APIは、送信した各URLに対してSmartStoreスクレイパーを実行します。コントロールパネルでは、そのCollect by URLエンドポイントが商品URLのリストを受け取ります。
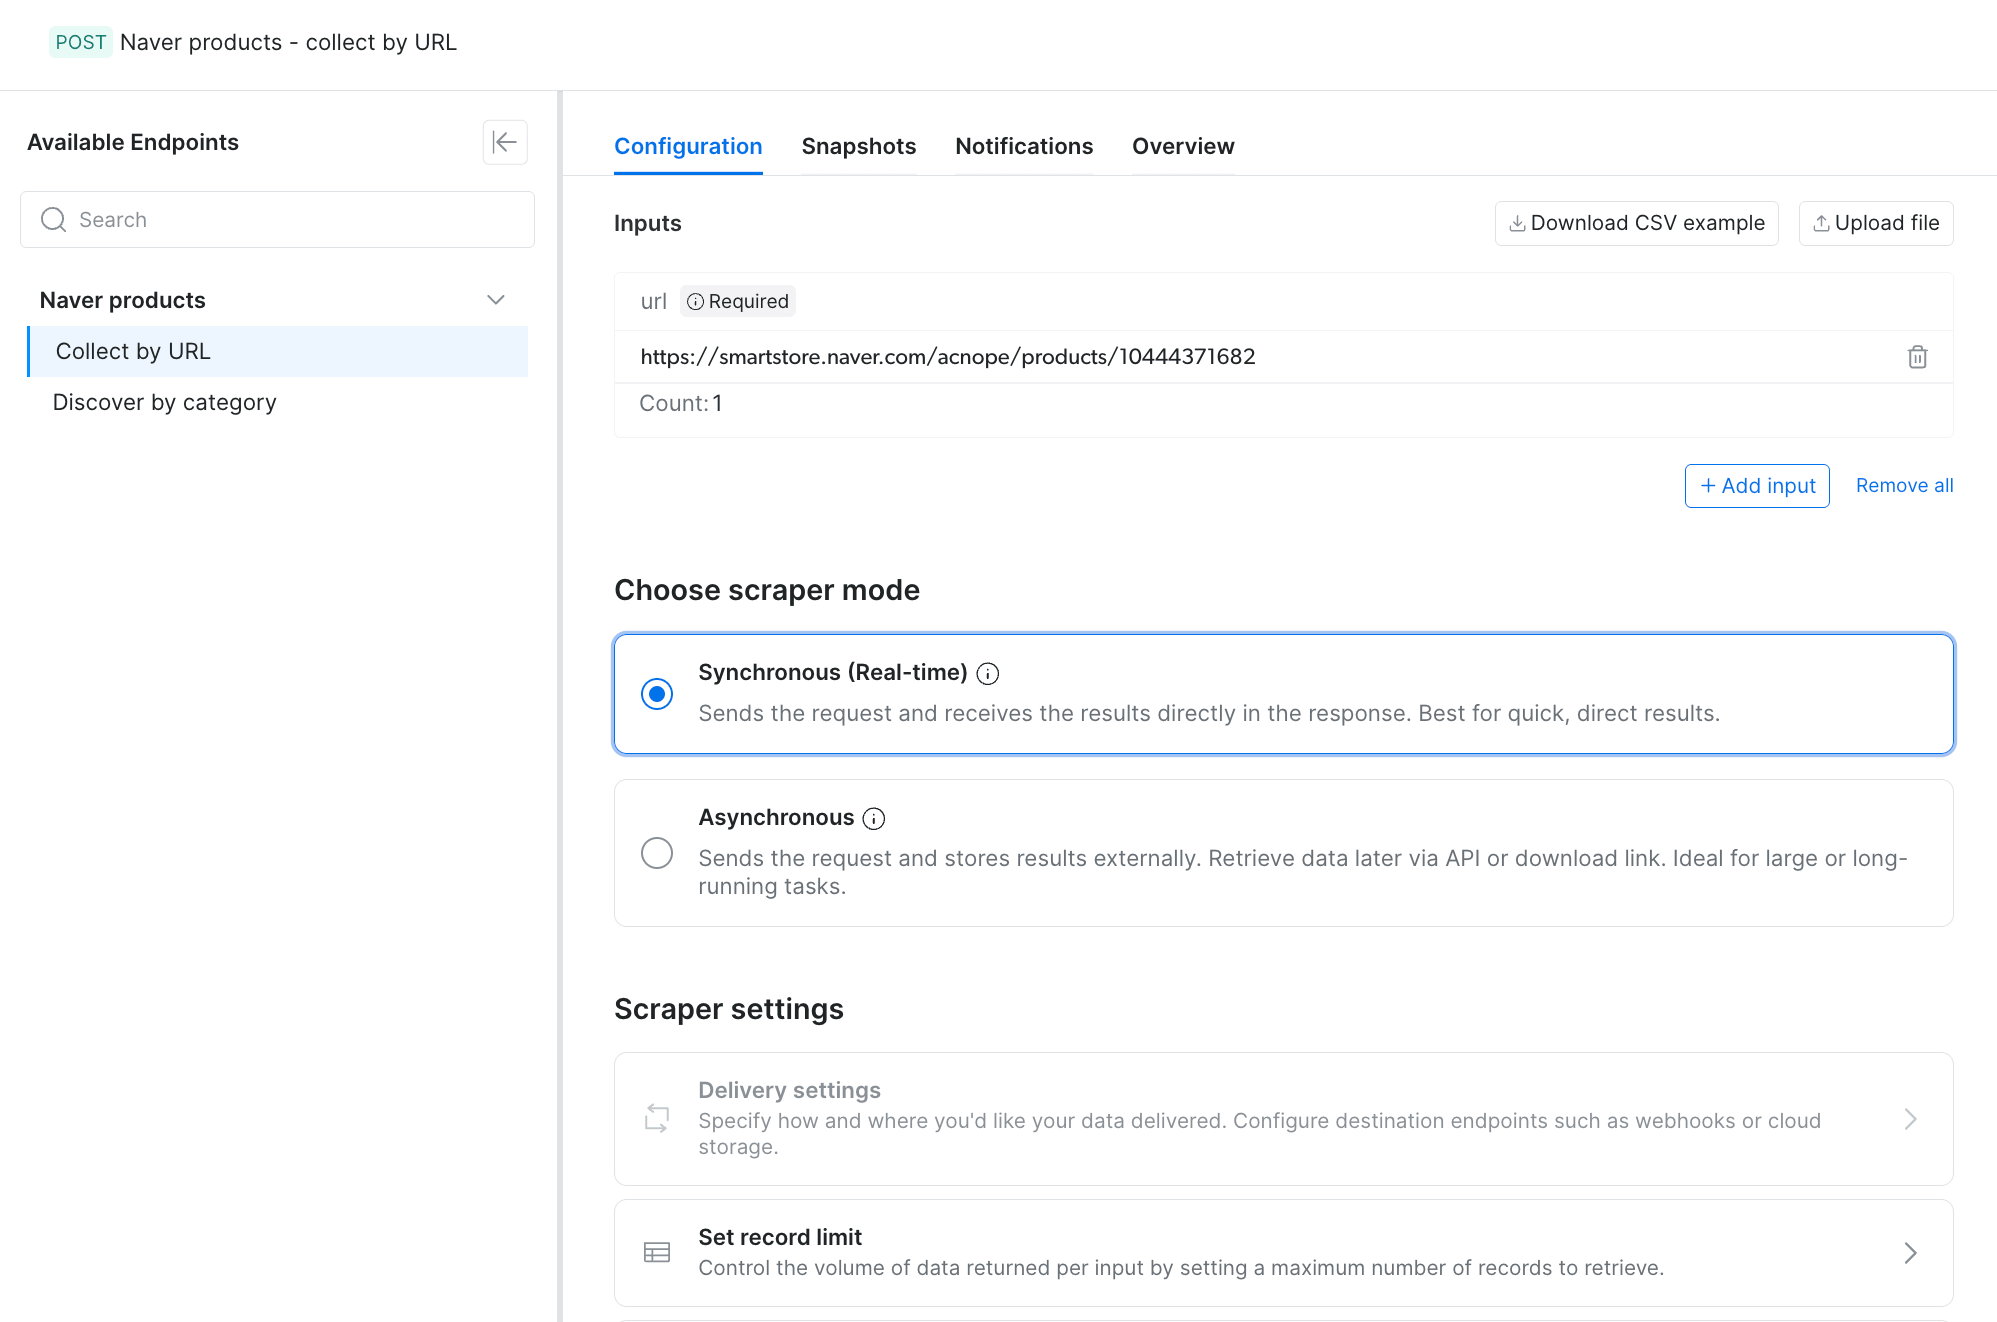
同じエンドポイントはREST API経由でも利用でき、データセットIDはgd_m9qqjxxr1hab7okefjです。
このスクリプトはAPIの3つの詳細に依存しています。ジョブが同期タイムアウト制限より長くかかる場合、/scrapeエンドポイントはポーリング対象となるスナップショットIDとともにHTTP 202を返します。小規模なバッチには/scrapeを使用し、より大きなジョブは、現在のバッチサイズ制限がドキュメントに記載されている非同期の/triggerエンドポイントに送信してください。そしてcustom_output_fieldsはリストしたフィールドのみを返すため、URLが商品を返さなかった理由を確認するためにinput、error、error_codeを追加してください。
以下のスクリプトはバッチを送信し、必要に応じてスナップショットのポーリングに切り替え、各レコードを検証します。
import json
import os
import sys
import time

import requests

API = "https://api.brightdata.com/datasets/v3"
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"}
NAVER_PRODUCTS = "gd_m9qqjxxr1hab7okefj"
# custom_output_fields returns only what you list, so include input and the error fields
FIELDS = ("input|error|error_code|url|product_id|title|original_price|final_price"
          "|discount_rate|total_reviews|sold_out|breadcrumbs|timestamp")


def collect_products(urls: list[str]) -> list[dict]:
    params = {"dataset_id": NAVER_PRODUCTS, "format": "json",  # a JSON array instead of the default NDJSON
              "include_errors": "true", "custom_output_fields": FIELDS}
    body = {"input": [{"url": u} for u in urls]}
    resp = requests.post(f"{API}/scrape", params=params, json=body, headers=HEADERS, timeout=180)
    if resp.status_code == 202:  # the job took longer than the synchronous timeout limit
        snapshot_id = resp.json()["snapshot_id"]
        while True:
            status = requests.get(f"{API}/progress/{snapshot_id}", headers=HEADERS, timeout=60).json()["status"]
            if status == "ready":
                break
            if status == "failed":
                raise RuntimeError(f"snapshot {snapshot_id} failed")
            time.sleep(10)
        while True:  # the snapshot endpoint returns 202 until the file is built
            resp = requests.get(f"{API}/snapshot/{snapshot_id}", params={"format": "json"},
                                headers=HEADERS, timeout=120)
            if resp.status_code != 202:
                break
            time.sleep(10)
    resp.raise_for_status()
    records = resp.json()
    # Keep a list shape even if the API returns a single object
    return records if isinstance(records, list) else [records]


def validate(record: dict) -> dict:
    if record.get("error_code"):
        # dead_page means the listing is gone: drop it from the watch list, don't retry
        return {"url": record["input"]["url"], "ok": False, "reason": record["error_code"]}
    list_price = int(record["original_price"]) if record.get("original_price") else None  # int() also accepts the string form
    price = record.get("final_price")
    ok = isinstance(price, int) and price > 0 and (list_price is None or price <= list_price)
    return {"product_id": record.get("product_id"), "ok": ok, "price": price, "list_price": list_price,
            "reviews": record.get("total_reviews"), "title": (record.get("title") or "")[:40]}


if __name__ == "__main__":
    urls = json.load(open(sys.argv[1])) if len(sys.argv) > 1 else [
        "https://smartstore.naver.com/acnope/products/10444371682"]
    records = collect_products(urls)
    print(f"{len(records)} records")
    for row in map(validate, records):
        print(json.dumps(row, ensure_ascii=False))
10件のSmartStore URLのバッチは、7件すべての公開リストのレコードを返し、残り3件にはエラーコードのフラグを立てました。
10 records
{"url": "https://smartstore.naver.com/bestymall/products/9824862314", "ok": false, "reason": "dead_page"}
{"url": "https://smartstore.naver.com/wonliveshopm/products/12177447319", "ok": false, "reason": "dead_page"}
{"url": "https://smartstore.naver.com/dajunemall/products/12725077707", "ok": false, "reason": "wait_element_timeout"}
{"product_id": "11219337734", "ok": true, "price": 16890, "list_price": null, "reviews": null, "title": "TROLLI 트롤리 올인원 젤리 1kg  사우어 구미캔디"}
{"product_id": "11499596414", "ok": true, "price": 615340, "list_price": null, "reviews": null, "title": "LG전자 2도어 344L 몽블랑 네이처 (M344MB14) 2도어 냉장고"}
{"product_id": "12465433420", "ok": true, "price": 17900, "list_price": 35000, "reviews": 41, "title": "[국산 100%] 꿈에그린X알파플러스 KF94 새부리형 마스크 100매("}
{"product_id": "12332341407", "ok": true, "price": 299000, "list_price": 608000, "reviews": 12, "title": "마이크로소프트  MS office 2024 Home & Business "}
{"product_id": "12385071329", "ok": true, "price": 277000, "list_price": null, "reviews": null, "title": "-ku- 일렉트로룩스 WELL Q8 무선스틱청소기 WQ81-3OMBF"}
{"product_id": "5494837526", "ok": true, "price": 31490, "list_price": null, "reviews": 1, "title": "로슈 아큐첵 인스턴트 혈당계+시험지50매"}
{"product_id": "9280411528", "ok": true, "price": 32200, "list_price": 32250, "reviews": 33, "title": "오딧세이 남성2종 로맨틱 레드 스페셜세트+아이오페 포케터블 토트백 증 정"}
すべての価格、レビュー数、フラグは、Web Unlocker経由で取得した同じ商品ページと一致しました。フラグが立てられた3件のURLは、削除済みリスト2件とNaverの認証チェックの背後にあるリスト1件でした。各実行後にdead_pageのURLを監視リストから削除してください。その他のフラグが立てられたURLはWeb Unlocker経由で取得し、各ページをsmartstore_productでパースしてください。
バッチ内の各URLは、スクリプトのデフォルトであるsmartstore.naver.com/acnope/products/10444371682のように、店舗のURLで始まっていました。Plus Storeカードからこれを構築するには、mallUrl.pcUrlのurlパラメータから店舗URLを読み取り、/products/<channelProductId>を追加してください。
レコードをウェアハウスに読み込む前に、データ契約を確認してください。
- Naver商品データセットのサンプル930件すべてのレコードと、リアルタイムのレコードにおいて、
original_priceは文字列で、final_priceは整数でした。validateが行っているように、比較する前に両方を整数にキャストしてください。 - このバッチでは、
original_priceがnullの場合は割引なしを意味し、total_reviewsがnullの場合はまだレビューがないことを意味しました。 total_reviewsは商品ページ上のレビュー数と一致し、スクリプトのデフォルトURLでは19,581でした。この件数は商品グループ全体のものであり、ページのstateには単一商品についても15,422が保持されていました。- このバッチでは、
product_idは各入力URLの商品番号と一致したため、Plus Store結果とレコードを結合するために使用できます。 custom_output_fieldsは保存するフィールドを制御するため、監視するフィールドのみを保持し、販売者の個人情報は保存しないでください。
リアルタイム収集ではなく履歴やバルクのカバレッジが必要なチームは、レコードごとに価格設定されたNaver商品データセットを取得してください。生のレコードではなく価格とプロモーションのインサイトが必要なチームは、Naver Shopping Price Trackerを利用できます。
Bright Dataには、SmartStoreレビュー、Naver Shoppingレビュー、Naver Hotels専用のスクレイパーもあります。
各Naverページタイプのツールとコストを比較する
Naverの価格とデジタル棚監視における各ジョブは、それぞれ1つのBright Data製品に対応しています。
| ジョブ | Bright Data製品 | テスト結果 | 課金方法 |
|---|---|---|---|
| キーワードに対するNaver検索上のショッピング結果 | Raw HTMLを用いたSERP API | 10件中10件のクエリ | 成功したリクエストごと(SERP API料金) |
| Plus Store結果の1ページ目、50枚のカード | Web Unlocker | 10件中10件のクエリ | 成功したリクエストごと(Web Unlocker料金) |
| Plus Storeのページ2以降 | Browser API | スクロールの一時停止を伴う4つのセッションそれぞれで、5件中5件の追加ページ | 帯域幅1GBごと(Browser API料金) |
| 価格比較検索からの、キーワードに対するShopping APIのフィールド | Web Unlocker | 10件中10件のクエリ | 成功したリクエストごと |
| 既知の商品URLに対する完全なレコード | Naver Shopping Scraper API | 各ページと一致する価格とレビューを伴う、7件中7件の公開リスト | レコードごと(Web Scraper API料金) |
| 履歴またはバルクの商品データ | Naver商品データセット | 930件のサンプルの価格フィールドの型が、リアルタイムのレコードと一致 | レコードごと(データセット料金) |
Web Unlocker経由では、Plus Storeの結果ページは1リクエストとして課金されます。Naver Shopping Scraper APIはレコードごとに課金されるため、コストは送信する商品URLの数に応じてスケールします。私たちのテストでは、50商品の追加5ページを読み込んだBrowser APIセッションは約18MBを使用しました。これらの単位を各料金ページの現在のレートに掛け合わせて予算を見積もってください。
検索ページを使って商品を見つけ、その検索順位を追跡してください。その後、監視するURLをNaver Shopping Scraper APIに送信すれば、追跡する商品のレコードのみに対して料金を支払うことになります。
最後に
Naverのショッピングと商品のページは通常のHTTPクライアントをブロックしましたが、その価格比較検索には依然として廃止されたAPIのほとんどのフィールドが含まれていました。埋め込まれたJSONを読み取り、ステータスコードではなくその中身を確認してください。Naverのログインリダイレクトと削除済みリストは、通常のページとして返されたためです。
発見にはSERP APIとWeb Unlockerを、ページネーションにはBrowser APIを、構造化された商品レコードにはNaver Shopping Scraper APIを使用してください。リアルタイム収集は現在の価格と順位を示し、Naver商品データセットは履歴やバルクの商品データを提供します。まずは、最も監視しているキーワード5件に対して価格比較スクリプトを実行し、その行を既存のフィードテーブルに読み込むことから始めてください。
よくある質問
NaverにはまだショッピングAPIがありますか?
NaverはShopping search APIを2026年7月31日に終了し、NAVER API HUB上に代替は提供されませんでした。類似の代替手段はその価格比較検索で、埋め込まれたデータには最安値、ブランド、カテゴリを含むAPIのほとんどのフィールドが含まれていました。Bright DataのWeb Unlockerは10件中10件のクエリでそれを返しました。
なぜNaver Shoppingは418エラーを返すのですか?
HTTP 418は、アクセスが一時的に制限されたことを示すNaver Shoppingのブロックページでした。4つのトリガーが列挙されていました。ショッピングと無関係な外部プロモーションからの訪問、単一IPからのリクエストのバースト、VPNのIP、一部のブラウザ拡張機能です。PythonのrequestsとヘッドレスChromeはこれを取得しましたが、Bright DataのWeb Unlockerは結果を取得しました。
韓国国外からNaverをスクレイピングできますか?
はい、ショッピングページにはアンブロッカーを使用すれば可能です。インドからは、通常のHTTPクライアントがNaver検索から完全なページを取得できましたが、Naver Shoppingはブロックページ、CAPTCHA、またはログインリダイレクトを返しました。Bright DataのWeb Unlockerはそこで10件中10件のPlus Storeページを返しました。Naverはリクエスト元の国を記録するため、韓国のIPを使用してください。
PythonでNaverをスクレイピングするにはどうすればよいですか?
ページを取得し、CSSセレクタを使う代わりに、HTML内に埋め込まれたJSONをパースしてください。検索ページはショッピングデータを_INITIAL_STATEオブジェクトに保存しており、SmartStoreはwindow.__PRELOADED_STATE__を使用していました。Naver ShoppingはPythonのHTTPクライアントをブロックするため、それらのリクエストはBright DataのWeb Unlocker経由でルーティングしてください。
Naverをスクレイピングするにはどれくらいの費用がかかりますか?
Bright DataのSERP APIとWeb Unlockerは成功したリクエストごとに課金され、Naver Shopping Scraper APIはレコードごとに、Browser APIはGBごとに課金されます。私たちのテストでは、結果ページは1リクエストで、Browser API経由の追加5ページは約18MBを使用しました。現在のレートは料金ページに記載されています。