Walmartをスクレイピングして大規模に収集することで、価格チームはショッパーが見る価格、在庫状況、レビューを、スケジュールに沿って数千ページから取得できます。
Walmartのボットチェックは最初の問題に過ぎません。ローテーションIPから商品ページを取得したところ、Walmartはページごとに異なる店舗向けの価格を設定しました。スクレイパーが郵便番号や店舗を指定しない場合、WalmartはIPアドレスに基づいて店舗を選びます。その結果、価格テーブルには複数の店舗が混在し、エラーも出ません。
本ガイドでは、Walmartの防御策とリスト表示の制限、どの方法を選ぶべきか、そしてPythonで店舗レベルの価格を収集する方法を説明します。
要約
- 店舗によって価格が変わる場合があります。 8つの郵便番号で調べたところ、同じ1ガロンの牛乳の価格は2.42ドルから6.28ドルまで幅がありました。
- リクエストごとに店舗を指定すると機能しました。 店舗IDを指定すると、Bright DataのWalmart Scraper APIは、ブラウザで表示されたのと全く同じ価格を、比較した両店舗について返しました。
- Walmartのカテゴリ一覧はユニーク商品約390点で止まりました。 約2,450点と表示されていましたが実際は389点しか表示されず、9つの価格帯に分割したところ2,069点が見つかりました。
- 200ステータスは成功を意味しませんでした。 Walmartは「ロボットですか、人間ですか?」というチャレンジをHTTP 200で返したため、すべてのレコードの内容と店舗IDを確認する必要があります。
Walmartがスクレイパーを検出する方法
Walmartの商品ページはAkamai、HUMAN、F5のウェブアプリケーションファイアウォール(WAF)によって保護されていました。単一の商品ページのレスポンスのヘッダー、Cookie、ランタイム設定に、この3つすべてが確認できました。
| レイヤー | 検出方法 | スクリプトが受け取ったもの |
|---|---|---|
| Akamaiエッジ | x-ak-protocolおよびserver-timing: ak_pヘッダー、akavpau_p2 Cookie、ブラウザセッション内のBot Manager Cookieであるak_bmscとbm_sv |
Walmartのクライアントヘッダーなしのグラフクエリ(GraphQL)呼び出しに対する418 Access Denied |
| HUMAN(旧PerimeterX) | /px/PXu6b0qd2S/init.jsのファーストパーティセンサーと_pxhd、_px3、_pxvid Cookie |
/blockedへの307リダイレクト、その後ステータス200の「ロボットですか、人間ですか?」の長押しページ |
| F5 WAF | ブラウザセッション内のTS012768cfのようなTSプレフィックスのCookie6個 |
ブロック応答は確認されず |
Playwrightで起動した素のヘッドレスChromeは、試した2回ともHUMANの長押しCAPTCHAに遭遇しました。チャレンジページは通常のWalmartページのように見え、ステータス200を返しました。
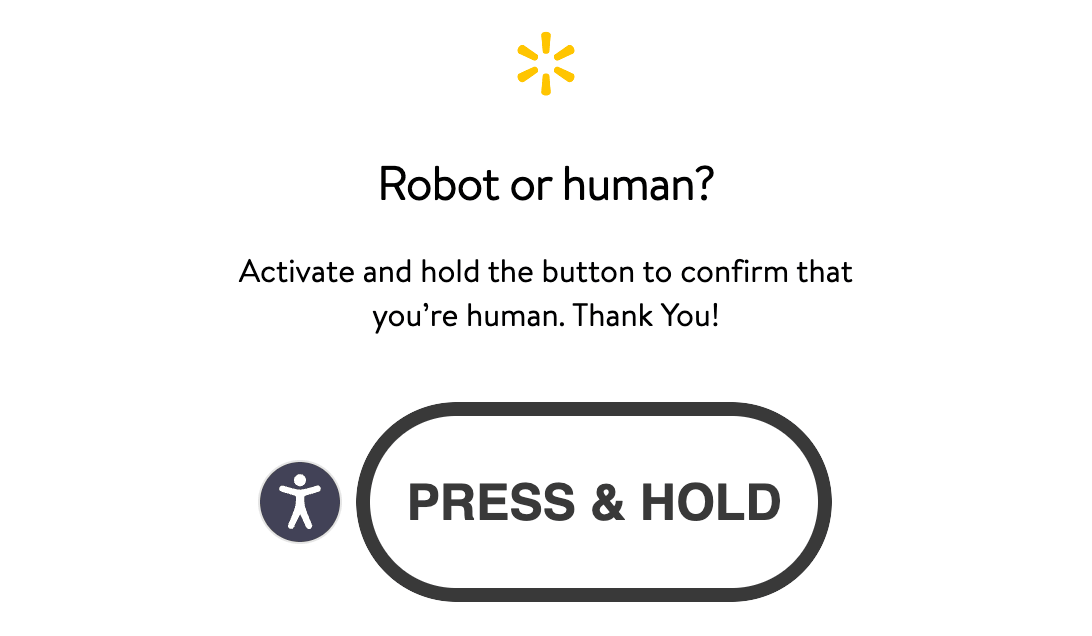
ステータスコードのみを確認するスクレイパーは、このページを成功として保存してしまいます。
同じランタイム設定は、デバイスプロファイリングサービスであるThreatMetrixを、カート、注文、ウォレット、サブスクリプションなどのアカウントページでのみ有効にしていました。そのリストには、価格監視に必要な商品ページ、カテゴリページ、レビューページは含まれていませんでした。
Walmart自身のボットフラグは、リクエストが成功したかどうかを示すものではありませんでした。 各商品ページにはisAkamaiBotなどのフィールドを持つpsychオブジェクトが埋め込まれていました。このフィールドはWalmartが完全に提供したページでも"1"でした。そのため、レスポンスの内容とストアIDで判定する必要があります。
チャレンジが発生したHTTPクライアント
同一IPでも、Walmartがチャレンジを表示するかどうかはHTTPクライアントに依存しました。米国外の家庭用ブロードバンドIPから、同じ5つのWalmart商品URLを6種類のHTTPクライアントでリクエストし、1ラウンドにつき1 URLとしました。各ラウンドでは、クライアントが2秒間隔で1つずつそのURLをリクエストし、それぞれが独自のCookie jarを保持しました。
5つのURLのうち3つはリンク切れでしたが、それでも明確なシグナルが得られました。成功したクライアントはWalmartの404ページを取得し、チャレンジされたクライアントはチャレンジページを取得しました。
| クライアント | 5リクエスト中のチャレンジページ数 |
|---|---|
| LibreSSL付きcurl | 4 |
Python requests |
2 |
HTTP/2付きhttpx |
1 |
Firefoxに偽装したcurl_cffi |
2 |
Chromeに偽装したcurl_cffi |
0 |
Safariに偽装したcurl_cffi |
0 |
実在する商品URLを使った2ラウンドでは、curl、requests、Firefoxプロファイルがチャレンジに遭遇しました。同じラウンドで数秒の差で、ChromeとSafariのプロファイルは商品ページを取得できました。
当社のcurl_cffiガイドでは偽装の設定方法を、TLSフィンガープリンティング記事ではハンドシェイクで露出する情報について解説しています。
Bright Dataのレジデンシャルプロキシを使った米国セッションでは、同じ6つのクライアントが30リクエストを行いましたが、チャレンジページは一度も発生しませんでした。各クライアントは米国のレジデンシャルIPを取得しました。結果はクライアントとプロキシの組み合わせごとに異なるため、実際に運用する並行数でWalmartに対してテストしてください。
Walmartページがデータを保持する場所
Walmartは商品、検索、カテゴリ、レビューページをNext.js pages routerでレンダリングしていました。各ページは__NEXT_DATA__スクリプトタグにデータモデルをJSONとして埋め込んでいました。あるキャンディ商品ページでは、そのJSONは592KBのHTMLのうち401KBを占めていました。以下のJSONパスに重要なフィールドが含まれていました。
- 商品ページ:
props.pageProps.initialData.data.product(価格、在庫状況、販売者、locationオブジェクトを含む) - 検索・カテゴリページ:
props.pageProps.initialData.searchResult.itemStacks[].items(searchResult.aggregatedCountに報告された合計を含む) - レビューページ:
props.pageProps.initialData.data.reviews(独自のページネーションブロックを含む)
このタグにはnonce属性があるため、追加属性を許容するパターンでidによってマッチさせてください。
ブラウザでは、WalmartのGraphQL APIがページに埋め込まれていないデータ、たとえばページのさらに下にある商品詳細などを提供していました。このAPIは永続化クエリを使用しており、これはクライアントがURL内のSHA-256ハッシュで呼び出す保存済みクエリです。
/orchestra/pdp/graphql/ItemByIdBtf/<sha256-hash>/ip/<item-id>Walmartはこれらのグラフクエリ(GraphQL)呼び出しのスクリプトによる再生をブロックしました。Walmartのx-o-*クライアントヘッダーなしで/orchestra/home/graphqlへスクリプトから呼び出すと、Akamaiの418が返されました。ヘッダーを付けた場合は、HUMANによるブロックがステータス412のJSONとして返されました。
これらのヘッダーにはWebアプリのバージョンも含まれており、Walmartのリリースごとに変化するため、古いオープンソースのスクレイパーにハードコードされた値は古くなってしまいます。
以下のスクリプトは、Bright DataのWeb Unlocker APIを通じて商品ページを取得し、商品データとその価格が設定された店舗を読み取ります。Python 3.9以降、requests、BRIGHTDATA_API_TOKEN内のAPIキー、BRIGHTDATA_UNLOCKER_ZONE内のWeb Unlockerゾーン名が必要です。
import json
import os
import re

import requests

API_KEY = os.environ["BRIGHTDATA_API_TOKEN"]
ZONE = os.environ["BRIGHTDATA_UNLOCKER_ZONE"]  # Web Unlockerゾーン名
NEXT_DATA = re.compile(r'<script id="__NEXT_DATA__"[^>]*>(.*?)</script>', re.S)


def fetch(url: str) -> tuple[str, str]:
    """ページのステータスコードとHTMLを返す。"""
    r = requests.post(
        "https://api.brightdata.com/request",
        headers={"Authorization": f"Bearer {API_KEY}"},
        json={"zone": ZONE, "url": url, "format": "raw", "country": "us"},
        timeout=180,
    )
    r.raise_for_status()
    # Web Unlockerはこのヘッダーでターゲットページのステータスコードを報告する
    return r.headers.get("x-brd-status-code", ""), r.text


def parse_product(html: str) -> dict:
    if "Robot or human" in html:
        raise RuntimeError("challenge page, not a product page")
    match = NEXT_DATA.search(html)
    if match is None:
        raise RuntimeError("no __NEXT_DATA__ block in the page")
    data = json.loads(match.group(1))["props"]["pageProps"]["initialData"]
    product = data["data"]["product"]
    location = product.get("location") or {}
    price = (product.get("priceInfo") or {}).get("currentPrice") or {}
    return {
        "us_item_id": product.get("usItemId"),
        "name": product.get("name"),
        "price": price.get("price"),
        "availability": product.get("availabilityStatus"),
        "seller": product.get("sellerName"),
        "store_id": (location.get("storeIds") or [None])[0],
        "zip": location.get("postalCode"),
    }


status, html = fetch("https://www.walmart.com/ip/10450114")
if status != "200":
    raise RuntimeError(f"page status {status}, not 200")
print(status, json.dumps(parse_product(html), indent=2))
ある実行では、スクリプトが一度もリクエストしていない店舗向けに価格設定された実在商品が返されました。あなたの実行結果ではおそらく別の店舗が表示されるでしょう。
200 {
  "us_item_id": "10450114",
  "name": "Great Value Whole Vitamin D Milk, Gallon",
  "price": 3.32,
  "availability": "IN_STOCK",
  "seller": "Walmart.com",
  "store_id": "3081",
  "zip": "95829"
}
Web Unlocker APIは、x-brd-status-codeヘッダーにWalmart自身のステータスコードを報告します。詳細はエラーコードページに記載されています。このスクリプトは、ページを解析する前にそのヘッダーを確認します。
まず埋め込みJSONをパースしてください。ページに埋め込まれていないデータについては、ブラウザセッションからGraphQLを呼び出してください。スクリプトによる呼び出しはブロックされたためです。
Walmartの価格が店舗に依存する理由
WalmartのAffiliate Marketing APIドキュメントには、商品の価格と在庫状況はリクエストの郵便番号と店舗IDに依存すると記載されていました。店頭価格については、Walmartの広報担当者がCNBCに対し、「表示される価格は、どの店舗でも全員同じです」と述べています。各商品ページは特定の店舗向けに価格設定されていました。
ページには「受け取り元」のテキストでその店舗が示されており、価格は店舗によって異なりました。同じ1ガロンの牛乳が、Walmartが割り当てたサクラメントの店舗では3.32ドル、私が手動で選んだアトランタの店舗では3.03ドルでした。
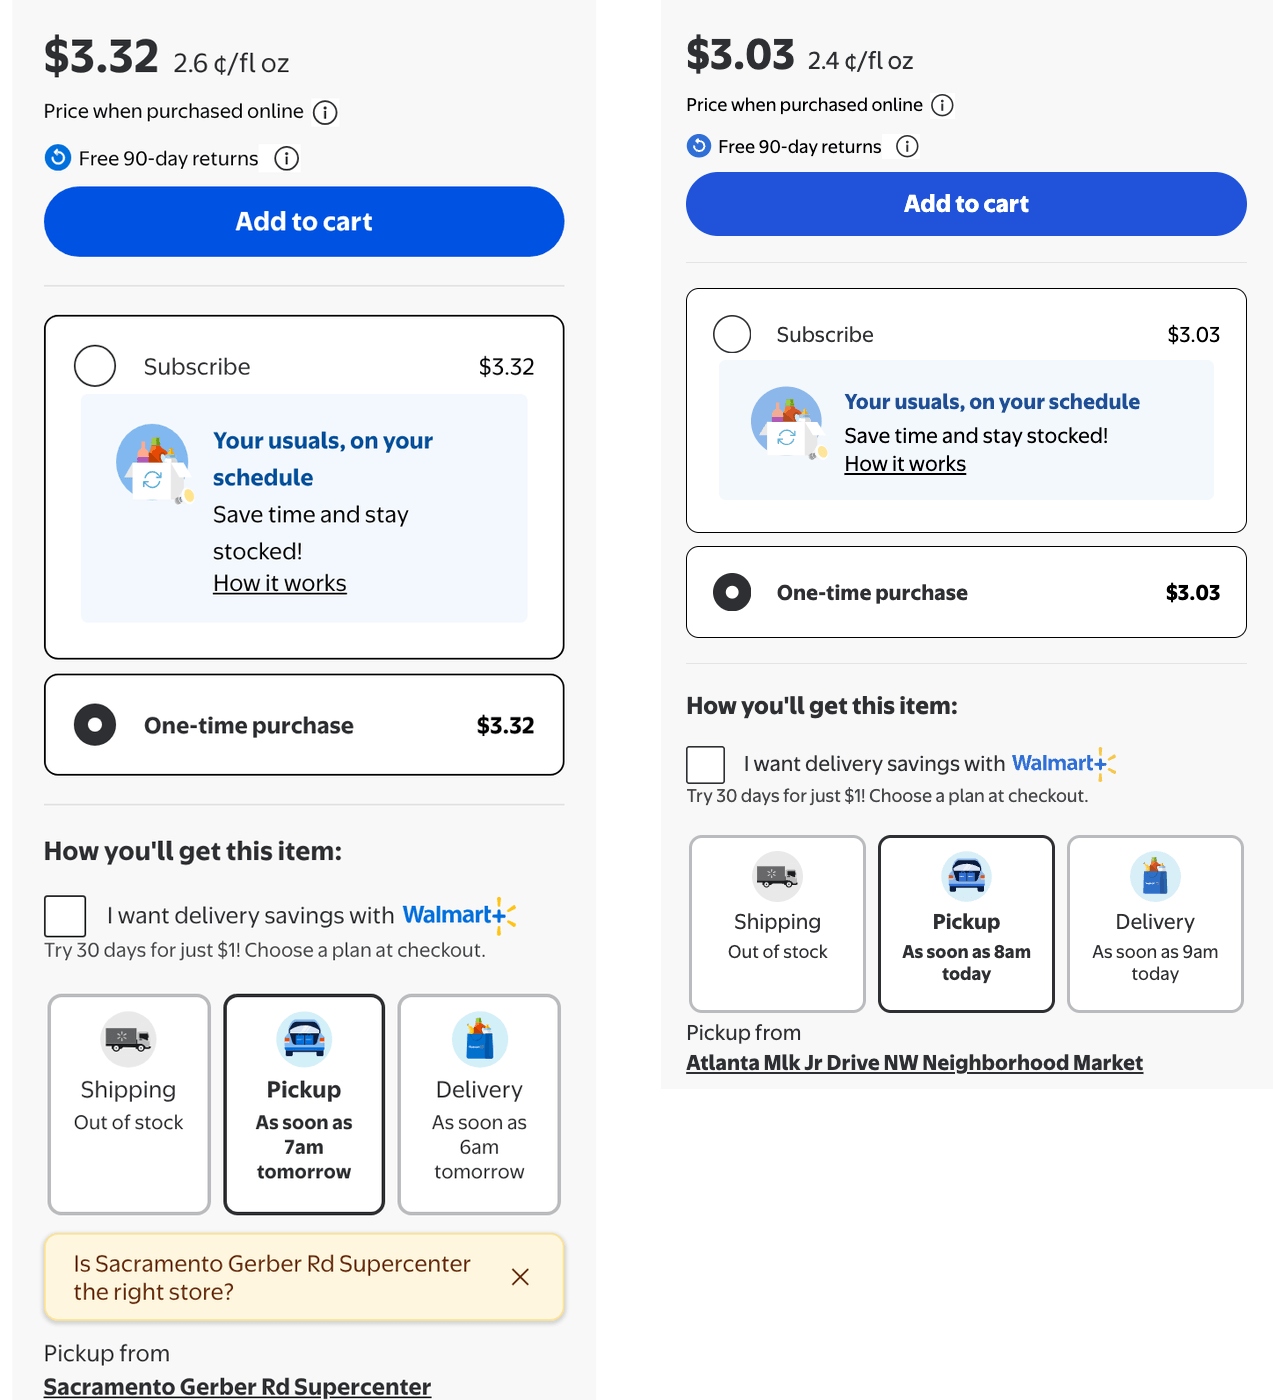
各レコードに店舗情報がなければ、同じ牛乳のこの2つの価格は価格変動のように見えてしまいます。
リクエストに位置情報が含まれない場合、Walmartは店舗を選択し、それをページのlocationオブジェクトに記録し、その選択をIMPLICITとマークしました。一部の接続はデフォルトの店舗、サクラメントの郵便番号95829にある店舗3081を取得しましたが、これはスクリプトの出力に表示された店舗です。Walmartは出口IPに基づいて店舗を決定していたため、ローテーションIPでも店舗が変化しました。
- ローテーションIP:48個の商品ページそれぞれが異なる店舗向けに価格設定されていました。
- その他の接続:米国外のブロードバンドIPと衛星IPはどちらもデフォルトの店舗を取得しました。Walmartは別のセッションをユタ州ビッグウォーター、郵便番号84741と位置特定し、こちらにもデフォルトの店舗を割り当てました。
スクリプトからの店舗指定が信頼できなかった理由
2つの方法を試しましたが、どちらも店舗の選択はWalmartに任されたままでした。
- 位置情報Cookie:
assortmentStoreIdと手作りのlocGuestDataCookieを設定しました。Cookieありの9リクエストのうち6回がチャレンジページとなり、Cookieなしの3リクエストでは0回でした。成功した3回はIPの店舗をそのまま維持しました。 - 出口IPの選択:Walmartは独自のIPジオロケーションを使用していました。そのジオロケーションが標準的なIP検索の郵便番号と一致したのは、11ページ中わずか5ページだけであり、IPの郵便番号は店舗を予測する手がかりにはなりませんでした。
郵便番号や店舗IDが店舗をどう設定するか
Bright DataのWalmart Scraper APIのzipcode入力は、各リクエストの位置を設定します。8つの郵便番号それぞれで4つの食料品項目を収集したところ、同じ1ガロンのGreat Value全乳が8通りの異なる価格を示しました。
| 郵便番号 | レコード内の店舗ID | 価格 |
|---|---|---|
| 60614、シカゴ、IL州 | 5402 | 2.42ドル |
| 75201、ダラス、TX州 | 5823 | 2.46ドル |
| 72712、ベントンビル、AR州 | 100 | 2.72ドル |
| 33177、マイアミ周辺、FL州 | 6397 | 2.92ドル |
| 94103、サンフランシスコ、CA州 | 2648 | 3.32ドル |
| 10001、ニューヨーク、NY州 | 3520、Secaucus Supercenter、NJ州 | 4.07ドル |
| 99504、アンカレジ、AK州 | 4359 | 4.98ドル |
| 96813、ホノルル、HI州 | 3478 | 6.28ドル |
バナナはベントンビルの0.13ドルからホノルルの0.42ドルまで幅がありました。卵は8つの郵便番号すべてで1.67ドルでしたが、そのうち3つでは受け取りができませんでした。価格と同様に、店舗ごとの在庫状況も記録してください。
牛乳よりも値動きが少ないプロテインパウダーでも、店舗を指定することは依然として重要でした。387点の商品を2回収集し、最初は郵便番号なし、次にベントンビルの郵便番号ありで実行しました。最初の実行のレコードは170の異なる店舗から来ており、24点の商品が2回の実行間で価格が変わりました。
郵便番号は店舗ではありません。 マンハッタンの郵便番号10001は、ニュージャージー州のSecaucus Supercenter(店舗3520)に解決されました。Walmartの店舗選択機能は、アトランタの郵便番号30303に対して複数の店舗をリストしました。
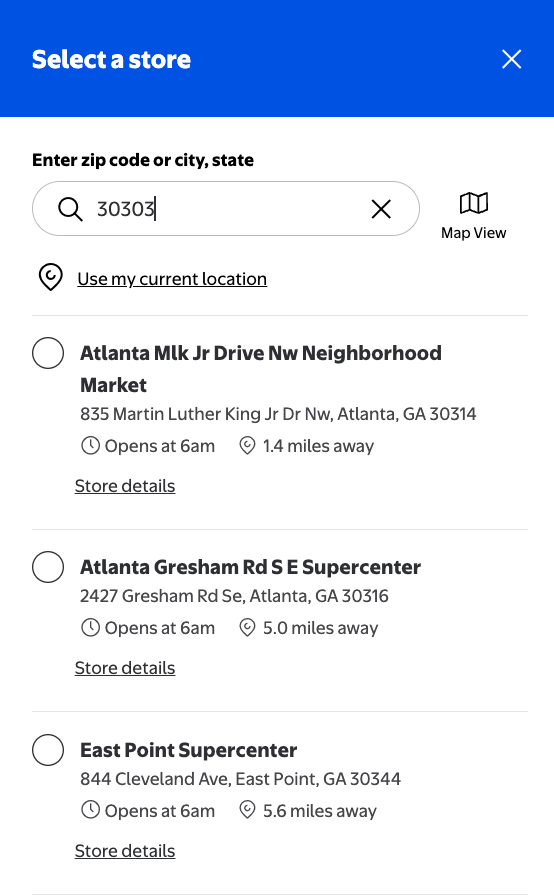
郵便番号30303に対してリストされた最初の3店舗。郵便番号はエリアを指し、店舗IDは特定の店舗を指します。
特定の店舗が必要な場合、Walmart Scraper APIはstore_idも受け付けます。walmart.com上の各店舗のページURLにはそのIDが含まれており、たとえばwalmart.com/store/100-bentonville-arでは100です。Walmartの店舗サイトマップwalmart.com/sitemap_store_main.xmlには、スーパーセンター3,582店舗とネイバーフッドマーケット675店舗を含む店舗タイプ別のこれらのURLがリストされていました。牛乳のスクリーンショットにある2つの店舗を設定したところ、APIはブラウザで表示されたのと同じ価格、サクラメントで3.32ドル、アトランタで3.03ドルを返しました。
同じ郵便番号での再実行は同じ価格を返しました。 シカゴの牛乳は90分以内に実行した後の2回の実行でも再び2.42ドルでした。ベントンビルでは、同時に実行した2つのジョブが、両方のジョブが収集した39商品すべてで同じ価格を返しました。1日後、郵便番号72712は依然として店舗100に解決され、そこの牛乳の価格もまだ2.72ドルでした。
価格ごとに記録すべき情報
スクリーンショットの両方の牛乳価格には、Walmartの「オンライン購入時の価格」というラベルが付いていたため、スクレイピングした価格は各店舗のオンライン価格として扱ってください。
在庫状況は配送方法にも依存します。牛乳のページでは、配送は在庫切れと表示される一方、同じ店舗からの受け取りと宅配は在庫ありと表示されていました。Walmart Scraper APIのレコードには、これに対応する別々の受け取り・宅配フラグがありました。そのFulfillment_typeフィールドには、販売者やWalmart Fulfillment Servicesなど、誰が注文を処理したかが記載されていました。
Walmartの単位価格も単位がそれぞれ異なっていました。同じ1ガロンの商品が、マイアミでは流体オンス当たり0.023というunit_priceを示し、ニューヨークではクォート当たり1.02を示しました。単位価格はパックサイズから再計算してください。この牛乳については、完全なレコードにspecificationsとしてパックサイズが128流体オンスと記載されていました。
価格は時間とともに変化もします。Walmartは単一の四半期で、一時的な値下げを意味する同社の用語である「ロールバック」を11,000件以上報告しています。
すべての価格を店舗ID、郵便番号、タイムスタンプでキー付けし、配送方法ごとに在庫状況を記録してください。リクエストしていない場所向けに価格設定されたレコードは棄却してください。
Walmartのリスト表示とレビューの制限内で作業する方法
Walmartのプロテインパウダーのカテゴリページは約2,450点の商品とmaxPage25を報告していました。1ページ目から10ページ目にはそれぞれ約50の商品枠があり、そのうち約10はスポンサー枠でした。11ページ目以降には商品がありませんでした。
| カテゴリページ | 返された商品枠数 |
|---|---|
| 1から10 | ページ当たり47から50 |
| 11 | ある実行では13、別の実行では0 |
| 12から25 | 0 |
1ページ目から11ページ目までには合計501の枠があり、ユニーク商品389点を保持していました。このページネーション制限はWalmartのリスト表示自体に起因しており、実行したすべてのセッションで同じように現れました。
デスクトップブラウザでは、ページ番号は依然として25まで続いており、12ページ目はWalmartのnot-foundページを返しました。
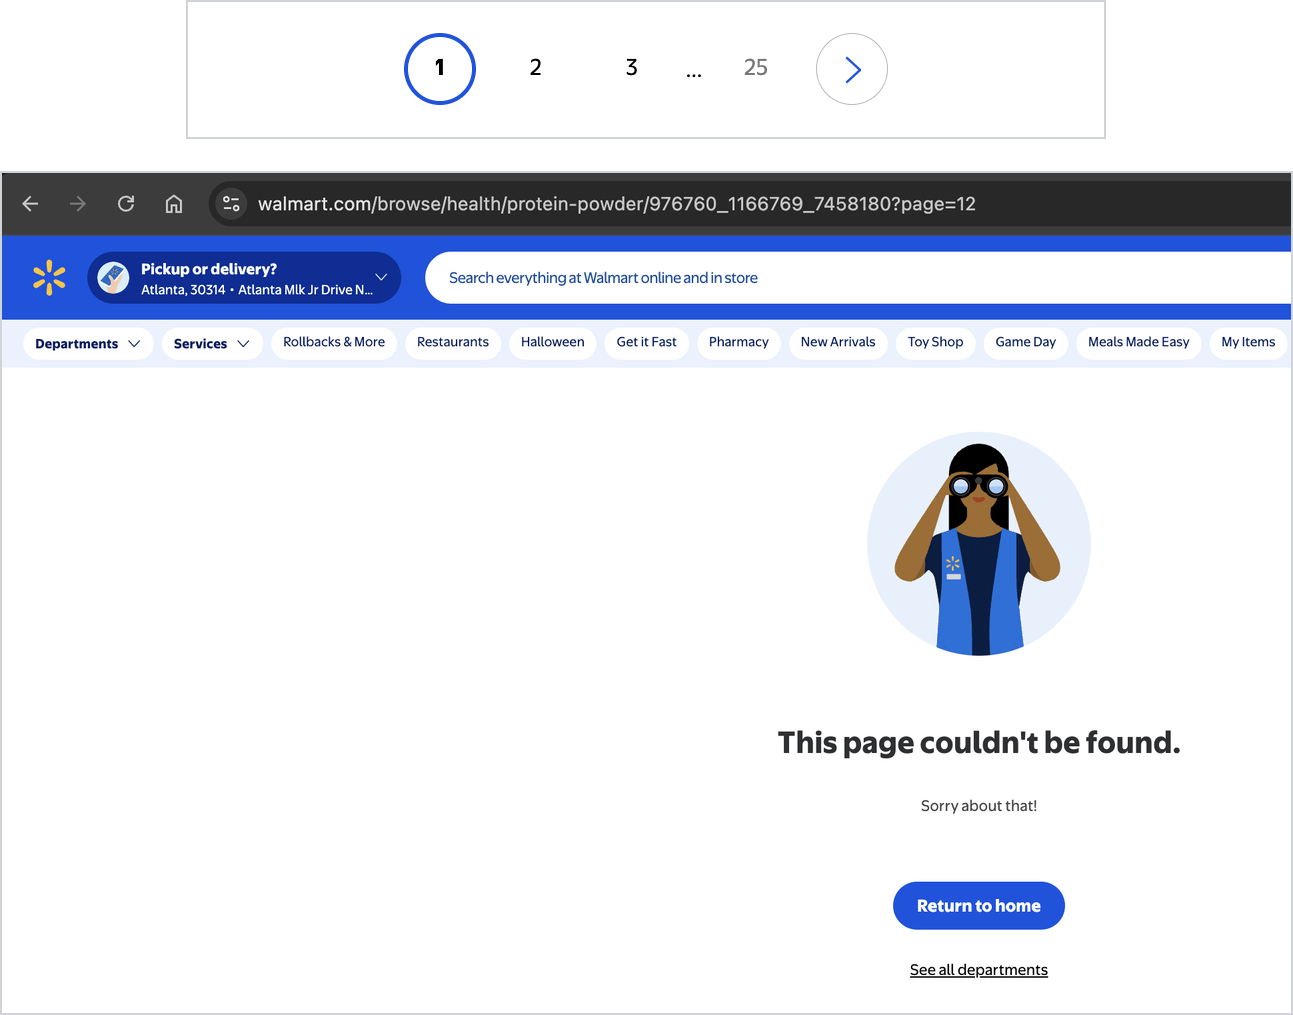
ページ番号を25まで辿るスクレイパーは、11ページ目以降は何も得られませんでした。
カテゴリを価格帯に分割する方法
Walmart Scraper APIのカテゴリ検出では、Walmartの価格フィルターを含むカテゴリURLを受け付けるため、価格帯ごとにカテゴリを収集できます。基準として、フィルターなしのカテゴリURLはユニーク商品393点を返し、リスト表示が示していた389点に近い値でした。
Walmartのmin_priceとmax_priceのURLパラメータでカテゴリを価格帯に分割すると、各範囲が独自の件数を報告しました。最初に15ドル、25ドル、35ドル、50ドル、75ドルでカテゴリを分割しました。次に、500点を超える商品が報告された3つの範囲をさらに42ドル、62ドル、100ドルで分割し、全9範囲で検出を実行しました。
| 価格帯 | Walmartが報告した商品数 | 検出されたユニーク商品数 |
|---|---|---|
| 0ドルから15ドル | 75 | 60 |
| 15ドルから25ドル | 230 | 189 |
| 25ドルから35ドル | 429 | 330 |
| 35ドルから50ドル(2範囲) | 718 | 569 |
| 50ドルから75ドル(2範囲) | 592 | 484 |
| 75ドル以上(2範囲) | 519 | 444 |
9つの範囲全体でユニーク商品2,069点が返され、これは基準値の約5倍でした。いくつかの商品が2つの範囲に現れたため、列の合計は2,076になります。どの範囲も330を超えるユニーク商品を返さなかったため、すべてがページネーション制限を下回っていました。
Walmartが報告した件数は、各行が返したユニーク商品数より17%から30%高い値でした。0ドルから15ドルの範囲では、2つのリストページには62点のユニーク商品しか表示されておらず、Walmartが報告した75点ではありませんでした。検出では60点が返され、ページ上の62点に近い値でした。Walmartの報告件数は上限値として扱ってください。
各範囲がページネーション制限(プロテインパウダーでは約390)を下回るユニーク商品数を返すまで、各カテゴリを価格帯に分割してください。
Walmartの商品サイトマップは、カテゴリ一覧よりもはるかに多くの商品をリストしていました。Web Unlocker APIを通じて、5,916のサイトマップファイルを指す商品サイトマップインデックスを取得しました。最初のファイルだけで、混在したカテゴリからの商品URLが50,000件あり、各URLには最終更新日のみが記載されていました。カタログ全体のURLリストにはサイトマップを使い、追跡対象のカテゴリには価格帯を使ってください。
検索結果とレビューの限界
検索には独自のページ制限がありました。 「laptop」の検索では20,251件の結果が報告されましたが、maxPageは14、1ページ当たり40件であったため、最大560件の結果にしかアクセスできませんでした。可能な場合は、カテゴリまたはサイトマップを通じて商品を発見してください。
シェア・オブ・シェルフ追跡のように、検索結果自体が必要な場合は、レコードにスポンサー結果のフラグが立つWalmart商品検索スクレイパーを使用してください。「protein powder」の検索では568件のレコードが返され、そのうち164件がスポンサー付きでした。これらのレコードのうち、55の商品IDが複数回出現し、そのうち52はスポンサー枠とオーガニック結果の両方として出ていました。シェア・オブ・シェルフでは両方の表示位置を保持し、商品リストでは商品IDで重複排除してください。
レビューにも独自のページネーション制限がありました。 牛乳のページには399,133件の評価が表示され、そのうち27,412件に文章が添えられていました。デフォルトの並び順では、ページネーションは1ページ当たり10件のレビューを表示し、10,000件で止まりました。1001ページ目は失敗せず、1ページ目を再び返したため、空のページを待つのではなく、Walmartが報告するページ数で停止してください。
Walmartレビュースクレイパーは、レビューの順序を指定するsort_by入力を受け付けます。127件の評価があるキャンディ商品の場合、41件すべての文章レビューを返しました。
URLリストを定期的に更新する必要がある理由
古い商品URLの約7分の1はリンク切れでした。 約2年前の商品URL150件のうち、22件が404または410を返し、さらに37件の生きているページには価格がありませんでした。
URLリストを最新に保つのに十分な頻度で検出を再実行し、各ジョブが現存する商品を収集するようにしてください。
Walmartをスクレイピングする方法の選び方
以下の各方法は、生のページアクセスから完成したレコードまで、それぞれ異なる量の作業をあなたの代わりに行います。各商品の価格ページには現在の価格がリストされています。
| 方法 | 何を処理してくれるか | 課金方式 | 店舗選択 | 現在の価格情報 |
|---|---|---|---|---|
| ローテーションレジデンシャルプロキシ+自作パーサー | 自作のクライアントとパーサー向けのローテーションレジデンシャルIP | トラフィックのGB単位 | 出口IPに基づきWalmartが設定 | レジデンシャルプロキシの料金 |
| Web Unlocker API+自作パーサー | アンブロッキング、レスポンスヘッダー内にWalmartのステータスコードを提供 | 成功リクエスト単位 | 出口IPに基づきWalmartが設定 | Web Unlockerの料金 |
| Walmart Scraper API | 検出、収集、店舗フィールド付きのパース済みレコード | 配信レコード単位 | zipcodeとstore_idでリクエストごとに設定 |
Web Scraper APIの料金 |
| Browser API | CAPTCHAソルバー内蔵のフルブラウザ、対話的フロー向け | トラフィックのGB単位 | ページ上で店舗を選択して設定 | Browser APIの料金 |
| Walmartデータセット | 作成済みのWalmart商品、レビュー、販売者データ | レコード単位 | 収集時に設定 | データセットの料金 |
レジデンシャルプロキシとWeb Unlocker APIは生のページを提供するため、パースと店舗検証はあなたのチームが実行します。Walmart Scraper APIは、直接検証できるパース済みレコードを返します。
レジデンシャルプロキシは、各リクエストに対する完全なコントロールを提供します。 クライアント、ヘッダー、パーサーを自由に選べるため、すでに独自のスタックを運用しているチームに適しています。
Web Unlocker APIはアクセスを処理するため、パースに集中できます。 カタログ全体のURLリストのために、Walmartの商品サイトマップも取得しました。
Walmart Scraper APIは、大量の店舗レベルの作業に適しています。 そのzipcodeとstore_id入力が位置を設定し、レコードには価格設定された店舗が報告されるため、パイプラインですべてのレコードを検証できます。
対話的フローにはBrowser APIを使用してください。 フルブラウザを実行するため、ページの探索や新しいエンドポイントのキャプチャに適しています。カタログ規模の大量処理には、Walmart Scraper APIまたはWeb Unlocker APIと組み合わせてください。
データセットはバックフィルとカタログ全体の分析に適しています。 Walmartデータセットは更新スケジュールを選択できます。
エージェントは単一商品のルックアップを実行できます。 Bright Data CLIにはwalmart_productパイプラインがあり、Bright Data MCPサーバーにはweb_data_walmart_productツールがあります。商品URLから、CLIパイプラインはWalmart Scraper APIレコードと同じスキーマのレコードを返しました。
有効レコード当たりのコストで各方法を比較してください。誤った店舗向けに価格設定されたページは、使用可能な店舗レベルのレコードとは言えません。
Walmart Scraper APIで店舗レベルの価格パイプラインを構築する方法
Walmartを大規模にスクレイピングするには、価格帯でURLを発見し、それぞれに郵便番号または店舗IDを設定し、各レコードの店舗IDを確認してください。Walmart Scraper APIには、商品、レビュー、販売者、検索のための個別のスクレイパーがあり、すべて同じREST APIを通じて利用できます。新規アカウントは無料枠から始められます。各スクレイパーには独自のデータセットIDと入力があります。
| スクレイパー | データセットID | 主な入力 | 用途 |
|---|---|---|---|
| Walmart商品 | gd_l95fol7l1ru6rlo116 |
zipcodeと任意のstore_id付きのurl、またはcategory_url、keyword、skuによる検出 |
店舗レベルの価格、商品詳細、画像 |
| Walmart商品ジップコード | gd_m693oc1r1gebnayxq |
zip_codeと任意のstore_id付きのurl、またはカテゴリ・キーワードによる検出 |
受け取り店舗、在庫数量、配送予定時間 |
| Walmartレビュー | gd_mpql1v8g2o8o6l1wzd |
任意のsort_by付きのurl |
文章レビュー |
| Walmart販売者情報 | gd_m7ke48w81ocyu4hhz0 |
販売者ページのurl |
販売者プロフィール |
| Walmart商品検索 | gd_m7khey0wb7wviejgj |
検索ページのurl |
スポンサーフラグ付き検索結果 |
コントロールパネルでは、Walmart商品スクレイパーは各URLに対してzipcodeとstore_idを受け付けました。
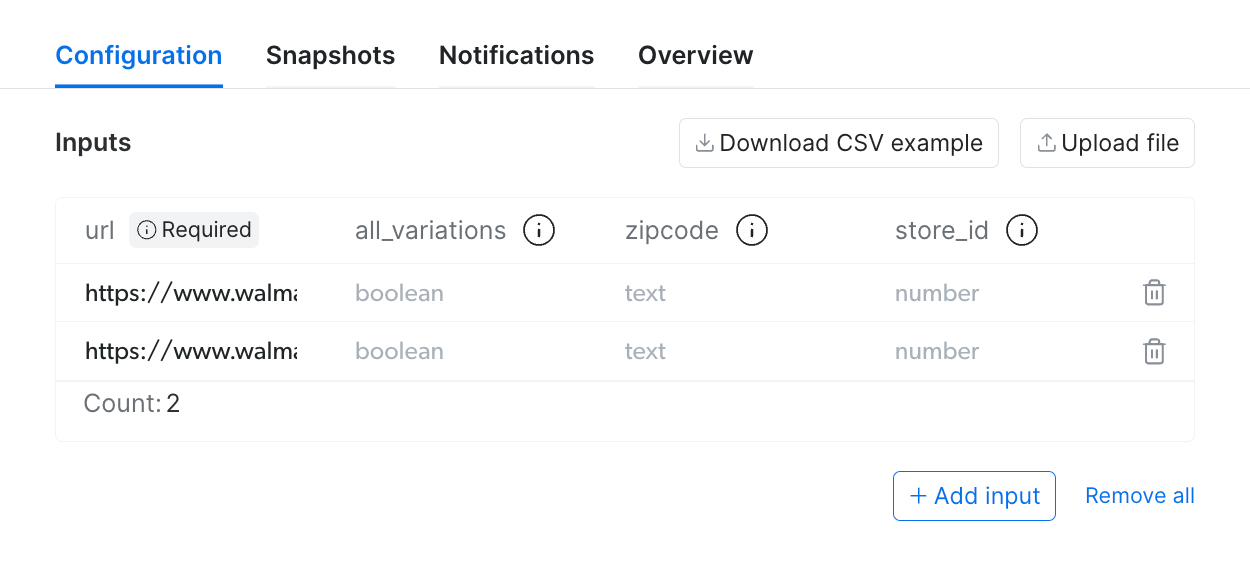
zipcode列とstore_id列が、各レコードに対して店舗をリクエストします。
共有ヘルパーを作成する
これらのヘルパーにはBRIGHTDATA_API_TOKEN内にAPIキーが必要です。post関数はRetry-Afterを尊重するため、非同期リクエストの上限に達した場合、クライアントが待機して再試行します。
import os
import time

import requests

API = "https://api.brightdata.com/datasets/v3"
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_TOKEN']}"}
WALMART_PRODUCTS = "gd_l95fol7l1ru6rlo116"


def post(url, **kwargs):
    """レート制限内に収まるようRetry-Afterを尊重するPOST。"""
    for attempt in range(6):
        r = requests.post(url, headers=HEADERS, timeout=120, **kwargs)
        if r.status_code != 429:
            r.raise_for_status()
            return r
        time.sleep(int(r.headers.get("Retry-After") or 2 ** (attempt + 1)))
    r.raise_for_status()


def wait_and_download(snapshot_id, every=30):
    while True:
        r = requests.get(f"{API}/progress/{snapshot_id}", headers=HEADERS,
                         timeout=60)
        r.raise_for_status()
        status = r.json()["status"]
        if status == "ready":
            break
        if status in ("failed", "canceled"):
            raise RuntimeError(f"{snapshot_id} ended as {status}")
        time.sleep(every)
    while True:  # 202はファイルがまだ組み立て中であることを意味する
        r = requests.get(f"{API}/snapshot/{snapshot_id}", headers=HEADERS,
                         params={"format": "json"}, timeout=300)
        if r.status_code == 200:
            return r.json()
        r.raise_for_status()
time.sleep(10)以下の検出・収集ブロックはpost、wait_and_download、API、HEADERSを再利用するため、3つのブロックすべてを同じファイルに保持してください。
価格帯で商品URLを発見する
これらの関数はカテゴリを価格帯に分割し、ソート済みのユニークURLリストを返します。
def price_ranges(category_url, edges):
    """価格帯ごとに1つの検出入力。

    各範囲がページネーション制限を下回るようedgesを選ぶ。
    """
    sep = "&" if "?" in category_url else "?"
    urls = [f"{category_url}{sep}min_price={lo}&max_price={hi}"
            for lo, hi in zip(edges, edges[1:])]
    return [{"category_url": u, "all_variations": False} for u in urls]


def discover(category_url, edges, per_range=600):
    body = {"input": price_ranges(category_url, edges),
            "limit_per_input": per_range}
    params = {"dataset_id": WALMART_PRODUCTS, "type": "discover_new",
              "discover_by": "category_url", "include_errors": "true"}
    job = post(f"{API}/trigger", params=params, json=body)
    records = wait_and_download(job.json()["snapshot_id"])
    urls = {r["url"].split("?")[0] for r in records if r.get("url")}
return sorted(urls)per_range=600とすると、9つのプロテインパウダー価格帯を対象とした単一の検出ジョブが、ユニーク商品URL2,069件を返しました。
エラーレコードには、Walmartが削除された商品に対して返した410 Goneステータスなど、error_codeとともに説明的なerrorメッセージが含まれていました。discoverはurlを持つレコードのみを保持するため、実行を確認する際は生のスナップショットからエラーレコードを読み取ってください。
店舗レベルのレコードを収集・検証する
次に、郵便番号を付けて各URLを収集し、データウェアハウスに到達する前にすべてのレコードを検証してください。フィールドリストにinput、error、error_codeを含めることで、各レコードがその入力と任意のエラー詳細を保持するようにします。パックサイズから単位価格を再計算する場合はspecificationsを追加してください。
FIELDS = "|".join([
    "product_id", "product_name", "final_price", "currency", "unit_price",
    "available_for_pickup", "available_for_delivery", "store_id",
    "store_name", "store_location", "seller", "timestamp",
    "input", "error", "error_code",  # inputとエラー詳細を保持する
])


def collect(urls, zipcode, store_id=None, webhook=None):
    """郵便番号ごとに1つの非同期ジョブを開始する。スナップショットIDを返す。"""
    params = {"dataset_id": WALMART_PRODUCTS, "include_errors": "true",
              "format": "json", "custom_output_fields": FIELDS}
    if webhook:  # Bright Dataが完成したレコードをこのURLにPOSTする
        params |= {"endpoint": webhook, "uncompressed_webhook": "true",
                   "auth_header": os.environ["WEBHOOK_AUTH_HEADER"]}
    row = {"zipcode": zipcode} | ({"store_id": store_id} if store_id else {})
    body = {"input": [{"url": u, **row} for u in urls]}
    job = post(f"{API}/trigger", params=params, json=body)
    return job.json()["snapshot_id"]


def validate(records, zipcode, store_id=None):
    """リクエストした店舗向けに価格設定されたレコードを保持する。それ以外は理由別に振り分ける。"""
    valid, rejected, seen = [], [], set()
    for rec in records:
        url = rec["input"]["url"]
        if rec.get("error_code"):
            rejected.append((url, rec["error_code"]))
            continue
        where = rec.get("store_location") or ""
        if store_id:  # この場合store_locationは店舗自身の郵便番号を示す
            matched = bool(where) and str(rec.get("store_id")) == str(store_id)
        else:  # store_locationはリクエストした郵便番号を示すべき
            matched = where.endswith(", " + zipcode)
        if not matched:
            rejected.append((url, f"priced for {where or 'no store'}"))
            continue
        try:
            price = float(rec["final_price"])
        except (KeyError, TypeError, ValueError):
            rejected.append((url, "no price, check availability"))
            continue
        key = (rec["product_id"], rec["store_id"])
        if key not in seen:
            seen.add(key)
            valid.append(rec | {"final_price": price})
    return valid, rejected


if __name__ == "__main__":
    category = ("https://www.walmart.com/browse/health/protein-powder/"
                "976760_1166769_7458180")
    edges = [0, 15, 25, 35, 42, 50, 62, 75, 100, 100000]
    urls = discover(category, edges, per_range=5)
    print(len(urls), "product URLs discovered")
    records = wait_and_download(collect(urls, zipcode="72712"))
    valid, rejected = validate(records, "72712")
    print(len(valid), "valid records,", len(rejected), "rejected")
各範囲につき5商品、ベントンビルの郵便番号72712を使った実行で、以下の件数が出力されました。検出・収集ジョブの実行中、スクリプトはその結果をポーリングします。あなたの件数は、パイプラインを実行する日のWalmartのリスト表示に依存するため異なります。
42 product URLs discovered
41 valid records, 1 rejected有効な41レコードはすべてベントンビルの店舗100向けに価格設定されていました。Walmartは残りの商品を価格なしでリストしていました。rejectedリストには、各レコードが棄却された理由が記録されています。
郵便番号のみの場合、store_locationはリクエストした郵便番号を示すため、validateは各レコードをその郵便番号と照合します。特定の店舗の場合は、その店舗が利用可能な郵便番号、たとえば店舗自身の郵便番号とともにstore_idを送信してください。この場合レコードは店舗自身の郵便番号を示すため、validateには同じstore_idを渡し、店舗IDを比較させてください。APIはこの組み合わせをチェックしていたため、ベントンビルの72712とともに送信された、Secaucusの店舗3520は、不一致を指摘するエラーレコードを生成しました。
カタログ規模では、郵便番号72712を使った単一のジョブが、検出された2,069件のURLすべてを実行し、validateがすべてのレコードの報告された位置を確認しました。
大規模にパイプラインを実行する
大規模な運用では、4つの実践がパイプラインをより予測可能にします。
URLをジョブにまとめてバッチ処理する。 ジョブは非同期で実行されるため、wait_and_downloadに結果をポーリングさせてください。すべてのジョブで非同期トリガーを使用してください。ジョブにより多くの時間が必要な場合、同期エンドポイントはポーリング用のスナップショットIDを返すため、非同期で開始すれば単一のコードパスを維持できます。
ユニークな入力数を数える。 APIは重複する入力を重複排除するため、2つの重複を含む34件の入力を持つジョブは32件のレコードを返しました。3つの郵便番号で送信された同じURLは3つの入力としてカウントされ、それぞれが自身の店舗向けに価格設定されました。
再試行前にエラーレコードを確認する。 エラーレコードには原因が明記されているため、リストから無効な商品URLを削除し、残りを再送信してください。
ストレージへ配信する。 collect(urls, zipcode, webhook=URL)を呼び出し、Bearer <secret>のような完全なヘッダー値をWEBHOOK_AUTH_HEADERに設定してください。Bright Dataは完成したレコードをウェブフックURLに、その値をAuthorizationヘッダーとしてPOSTします。配信ガイドには、エンドポイントが送信する確認応答、許可すべき送信元IP、Amazon S3、Google Cloud Storage、Snowflakeなどの配信先について記載されています。
パイプラインに店舗検証を組み込み、ウェアハウス内のすべてのレコードが検証済みの位置情報を持つようにしてください。
結論
Walmartを大規模にスクレイピングすることは、アクセスの問題であると同時に、店舗の位置の問題でもあります。各価格はそれが設定された店舗に帰属するものであり、成功ステータスからはその店舗がどこかは分かりません。すべての収集リクエストに郵便番号または店舗IDを設定し、検出をそれぞれページネーション制限を下回る価格帯に分割してください。
毎日の店舗価格ではなくバックフィルが必要な場合は、Walmartデータセットから始めてください。それ以外の場合は、無料枠でWalmart Scraper APIを通じていくつかの価格帯と郵便番号を実行し、店舗検証が通ったらスケールアップしてください。
FAQ
郵便番号でWalmartの価格をスクレイピングするにはどうすればよいですか?
出口IPに頼るのではなく、各商品URLとともに郵便番号を送信してください。出口IPに頼ると、Walmartはそれを使って店舗を選んでしまいます。郵便番号は別の州の店舗に解決される場合があるため、特定の店舗が必要な場合は店舗IDを追加してください。Bright DataのWalmart Scraper APIは両方を受け付け、各レコードの店舗を報告します。
Walmartには公開APIがありますか?
調査した時点では、WalmartのAPIはパートナー向けでした。Affiliate Marketing APIは、紹介料を得るアプリ向けに郵便番号ごとの価格と在庫状況を返していました。店舗の検索には追加の承認が必要でした。Marketplace APIは販売者自身のカタログのみをカバーしていたため、店舗レベルの価格トラッカーは公開の商品ページを収集します。
Walmartのレビューをスクレイピングできますか?
はい。牛乳の商品ページでは、Walmartのレビューページネーションは1ページ当たり10件のレビューを表示し、デフォルトの並び順では10,000件で止まりました。1001ページ目は再び1ページ目を返したため、Walmartが報告するページ数で停止してください。Bright DataのWalmartレビュースクレイパーは文章レビューを収集し、レビューの順序を指定するsort_by入力を受け付けます。
Walmart商品データセットはありますか?
はい。Bright Dataは、商品、レビュー、販売者向けに、選択可能な更新スケジュールで作成済みのWalmartデータセットを提供しています。これらはバックフィルやカタログ全体の分析に適しています。毎日の店舗レベルの価格については、Walmart Scraper APIを使って郵便番号または店舗IDの現在のレコードを収集してください。