価格監視のために大規模にTarget商品をスクレイピングするには、ページHTMLではなく内部JSON APIから店舗の価格と在庫を読み取る必要があります。
テストでは、タイドポッド31個入りパックは同時刻にシダーラピッズで9.99ドル、シカゴで12.69ドルでした。一部のレスポンスは有効に見えましたが、オンライン価格や親製品の価格帯が含まれていました。米国のIPからは、デフォルト設定のcurlとPythonクライアントによる製品API呼び出し112件中、成功したのはわずか1件でした。
このガイドでは、これらの価格を収集し、不正なレスポンスを検出し、独自のスクレイパーを構築するかTarget Price Scraperを使用するかを判断する方法を示します。
まとめ
- 店舗IDで価格をリクエストする。 ZIPコードを店舗IDにマッピングし、公開APIキーを使ってTargetの製品APIを呼び出します。
- 各価格のロケーションとバリアントを確認する。 ロケーション3991はオンライン価格を示し、親製品は価格帯を返す可能性があるため、バリアントごとに1行保存します。
- レスポンス本文内のブロックを検出する。 ブロックされた呼び出しはHTTP 435を返し、時には有効なJSONとして返されました。
- ロケーションの追跡方法によってツールを選ぶ。 ZIPコードの場合、Bright DataのTarget Scraper APIは20件中20件のチェックで当社のスクレイパーと一致しました。店舗IDまたはチャネル別の在庫には、Web Unlocker APIで独自のコードを実行してください。
Targetの製品データの提供方法
テストでは、スクレイパーはTargetの3つのホストから価格、在庫、製品詳細を読み取ることができました。製品ページのHTMLは価格を含まない唯一のソースでした。Targetは各製品をTCIN(Target.com Item Number)で識別し、これは製品URL内のA-の後の番号です。
3つのホストはすべてTargetのFastly CDNの背後にありました。wwwとredskyホストでは、HUMAN Securityのボットチェックがリクエストをブロックし、データの代わりにブロックレスポンスを返す可能性がありました。
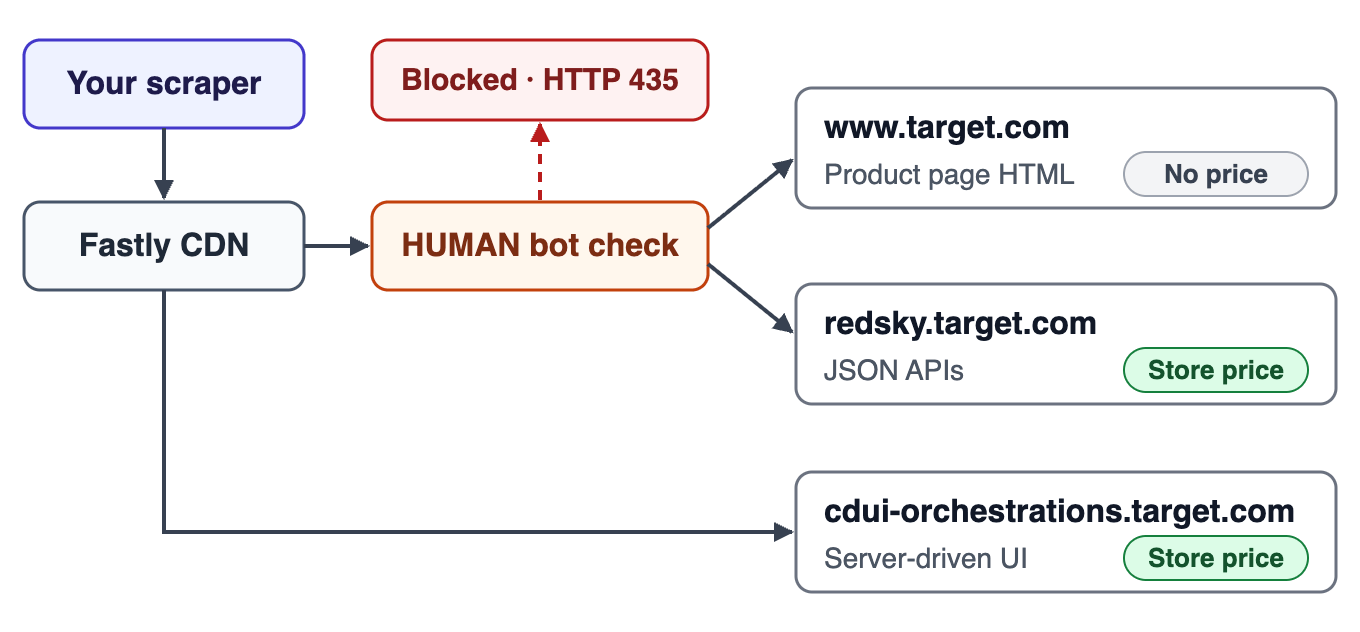
テストでは、ページHTMLには価格がなく、JSON APIとサーバー駆動UIモジュールには店舗価格がありました。
ページHTMLには価格がなかった
製品ページはNext.jsアプリケーションでした。その__NEXT_DATA__スクリプトにはタイトル、説明、画像、レビュー概要がありましたが、価格はありませんでした。ユーザーエージェントがcurl、python-requests、Chrome、HeadlessChromeのいずれであっても、curlでフェッチしたすべてのページでページプロパティにisProductDetailServerSideRenderPriceEnabled: falseが含まれていました。このフラグがtrueになると、HTMLに価格が含まれる可能性があるため、HTMLをパースする前にフラグを確認してください。
同じプロパティは各訪問者をisBot、isAiAgent、isSeoPhantomフラグでラベル付けしていました。Googlebotのような検索エンジンクローラーを装ったリクエストは、schema.org JSON-LDとレンダリング済み価格を含む、異なるキャッシュされたページを受け取りました。
その価格は単一のデフォルトロケーションのものでした。検索エンジンは逆引きDNSでクローラーを検証する方法を公開しているため、サイトは偽装されたクローラーを検出できます。店舗価格には、そのページではなく下記のJSON APIを使用してください。
価格と在庫はJSON APIから取得された
redsky.target.com上のTargetの集約APIは、店舗ごとの価格を返します。呼び出したすべてのエンドポイントはkeyパラメータを必要としました。キーがない場合、APIは"no API key found in request"とともに401を返しました。
このキーは秘密ではなく公開APIキーです。クローラーが受け取ったキャッシュページを除き、保存した各製品ページに28回登場しました。ハードコーディングするのではなく、ホームページなどのTargetページから読み取ってください。
確認したところ、APIホストのrobots.txtはすべてのクローラーを禁止していましたが、メインサイトのrobots.txtは製品ページを許可していました。
これら4つのエンドポイントは、テストしたすべての製品データ業務に十分でした。
| エンドポイント | 返す内容 | テストでの制限とエラー |
|---|---|---|
pdp_client_v1 |
製品、1つのstore_idでの価格、ファミリー内の全バリアント |
存在しなくなったTCINには404 |
plp_search_v2 |
キーワードまたはUPCバーコード番号の検索結果 | countは最大28、offsetは最大1,199 |
nearby_stores_v1 |
ZIPコード周辺の店舗ID | なし |
product_fulfillment_v1 |
配送、受け取り、リクエストされた店舗での店頭在庫、場合によっては近隣店舗の情報 | なし |
このリクエストは、curlとjqを使用して、ニューヨークのチェルシー店(店舗3412)でのParmalat UHT牛乳1カートンの価格を取得します。
KEY=$(curl -s https://www.target.com/ \
  | grep -oE '[0-9a-f]{40}' | sort | uniq -c | sort -rn \
  | head -1 | awk '{print $2}')

REDSKY=https://redsky.target.com/redsky_aggregations/v1/web
Q="key=$KEY&tcin=15078349"
Q="$Q&store_id=3412&pricing_store_id=3412"
Q="$Q&channel=WEB&page=%2Fp%2FA-15078349"
curl -s "$REDSKY/pdp_client_v1?$Q" \
  | jq '.data.product.children[]
| select(.tcin=="15078349") | .price'レスポンス内のlocation_idフィールドは、価格がどの店舗のものかを示します。
{
  "current_retail": 3.89,
  "display_was_now": false,
  "formatted_current_price": "$3.89",
  "formatted_current_price_type": "reg",
  "formatted_unit_price": "$0.12",
  "formatted_unit_price_suffix": "/fluid ounce",
  "reg_retail": 3.89,
  "location_id": 3412,
  "external_system_id": "15078349-3412-3.89-2025080815"
}このTCINは親製品のバリアントであるため、価格はchildren配下にあります。上記の両方のcurlコマンドは、インドからの接続で動作しました。米国のIPからは、テストでTargetのボットチェックがほぼすべてのそのようなリクエストをブロックしました。その場合、レスポンスがJSONではなくHTMLブロックページだったため、jqはパースエラーを出力しました。
Web Unlocker APIは同じリクエストをアンブロッキング層経由で送信し、TargetのJSONを返します。Web Unlocker APIクイックスタートが示すように、まずBRIGHTDATA_API_KEYとUNLOCKER_ZONE環境変数を設定してください。
unlock() {
  curl -s https://api.brightdata.com/request \
    -H "Authorization: Bearer $BRIGHTDATA_API_KEY" \
    -H "Content-Type: application/json" \
    -d "{\"zone\": \"$UNLOCKER_ZONE\",
         \"url\": \"$1\", \"format\": \"raw\"}"
}

KEY=$(unlock https://www.target.com/ \
  | grep -oE '[0-9a-f]{40}' | sort | uniq -c | sort -rn \
  | head -1 | awk '{print $2}')

REDSKY=https://redsky.target.com/redsky_aggregations/v1/web
Q="key=$KEY&tcin=15078349"
Q="$Q&store_id=3412&pricing_store_id=3412"
Q="$Q&channel=WEB&page=%2Fp%2FA-15078349"
unlock "$REDSKY/pdp_client_v1?$Q" \
  | jq '.data.product.children[]
| select(.tcin=="15078349") | .price'unlock関数は、下記の在庫リクエストを含む任意のTarget URLを受け付けます。
ライブページはサーバー駆動UIモジュールをロードしていた
ブラウザのネットワークキャプチャでは、製品ページはpdp_client_v1を呼び出していませんでした。そのレイアウトは、サーバー駆動UIモジュール(サーバーがデータとして送信するページセクション)から来ており、__NEXT_DATA__内かcdui-orchestrations.target.comからのものでした。www.target.com上のdeferred_enrichment呼び出しがロケーション固有のモジュールを追加しました。
cdui-orchestrations.target.comのレスポンスとdeferred_enrichmentモジュールの両方に価格が含まれていました。include_data_source_modules=trueを指定すると、チェルシー店向けのcdui-orchestrations.target.comへのリクエストは、テストした16製品中16製品すべてでpdp_client_v1と同じ価格とロケーションIDを返しました。pdp_client_v1のような、製品ページが呼び出していないエンドポイントは予告なく消える可能性があり、一致するcdui価格はテスト済みのフォールバックを提供します。
Targetスクレイパーが大規模運用で破綻する理由
一部の障害は最初のリクエストで発生しますが、他の障害はジョブに多数の店舗と製品が含まれる場合にのみ現れます。
ブロックはIPとクライアントに依存していた
テストでは、Targetは2022年にPerimeterXと合併したボット検出サービスであるHUMAN Securityを使用していました。ブラウザまたはHTTPクライアントのユーザーエージェントでフェッチしたすべての製品ページは、client.px-cloud.netからHUMANのセンサースクリプトをロードしました。
IPとクライアントのテストでは、各IPソースとクライアントから同じ16個のpdp_client_v1 URLを、3時間にわたって分散した実行で送信しました。本文にHUMANブロックがない200または206を返した場合、呼び出しは成功と見なされました。
| IPソース | クライアント | 成功した呼び出し |
|---|---|---|
| インドのIP | curl | 64件中63件 |
| 米国のIP | curlまたはPython requests、デフォルトユーザーエージェント |
112件中1件 |
| 米国出口IPを使用したWeb Unlocker API | Web Unlocker APIが選択 | 32件中32件 |
インドからは、curlでも成功しました。米国のIPからは、結果はクライアントに依存し、ブラウザ風のヘッダーを使うとより多くの呼び出しが成功しました。Web Unlocker APIはヘッダーとブラウザフィンガープリントを自動的に選択し、このテストではすべての呼び出しが成功しました。
cdui-orchestrations.target.comホストは、米国のIPからPythonのデフォルトユーザーエージェントで、そのホストとpdp_client_v1への呼び出しを交互に行った際に異なる挙動を示しました。cduiホストは8回の呼び出しすべてに応答しましたが、ボットチェックはpdp_client_v1への8回の呼び出しすべてをブロックしました。インドからの接続では、価格を含むcduiレスポンスの転送サイズの中央値は80KBで、pdp_client_v1のレスポンスは9KBでした。cduiホストはテストでブロックを回避しましたが、そのデータ形式はページレイアウトに従っており、任意のページリリースで変更される可能性があります。
テストでは、単一のヘッダーを変更すると成功していた設定が失敗し、HUMANのブロックレスポンスは理由を示しませんでした。一度に1つの変数のみを変更してください。修正を信頼する前に、古い設定と交互に試し、明確な差が見えるまで十分な回数の呼び出しを実行してください。フィンガープリントエコーサービスでTLSフィンガープリントを比較する際は、Chrome風のハンドシェイクが接続ごとにJA3を変化させるため、JA4とHTTP/2フィンガープリントを使用してください。
HUMANは独自のCookieも設定します。確認したところ、そのCookieドキュメントには、_px3の有効期限が5.5分、_pxvidが1年と記載されていました。同じページには、これらのCookieがセッションを維持し、実際のユーザーとボットを区別するのに役立つと記載されていました。セッション全体を通して、各Cookieジャーをそれを受け取ったIPとクライアントで使用するか、Web Unlocker APIにCookie管理を任せてください。
ブロックされた呼び出しは2つの形式でHTTP 435を返した
確認したところ、HUMANのエンフォーサードキュメントには403と429がブロックステータスとして記載されており、各サイトがレスポンスをカスタマイズできるとされていました。Targetでは、ブロックされたAPI呼び出しは代わりにHTTP 435を返し、ブロックレスポンスには2つの形式がありました。
curlの呼び出しはJSONをリクエストしておらず、HTMLチャレンジページを取得しました。ブラウザでレンダリングすると、このページは訪問者にボタンを長押しするよう求めました。
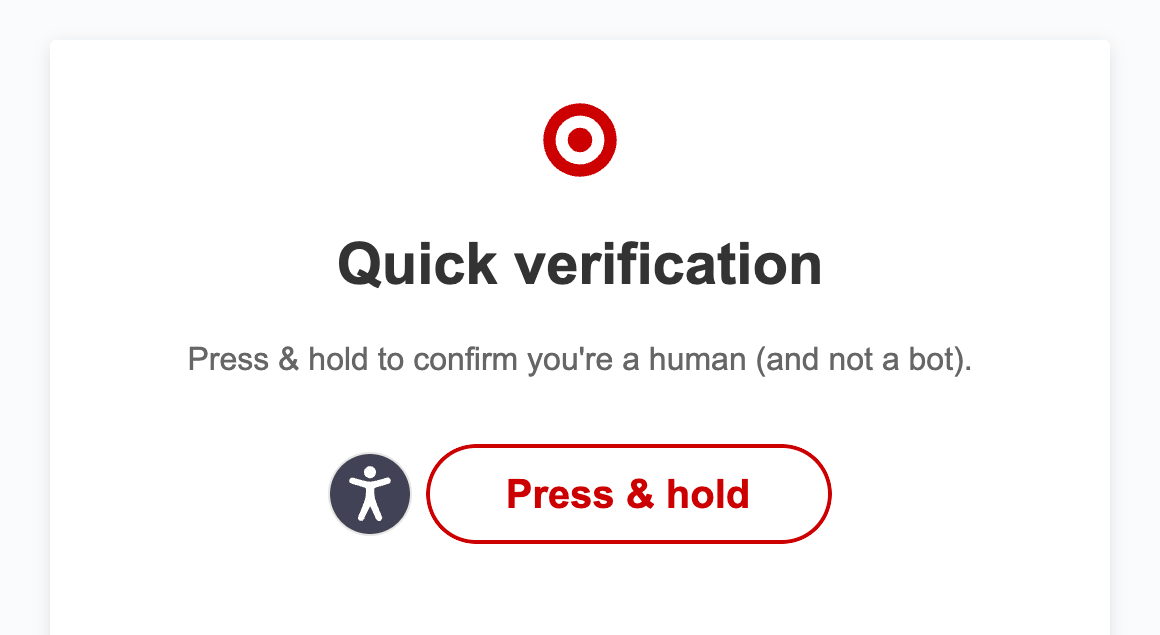
curlの呼び出しがデータの代わりにHTTP 435で受け取ったチャレンジページ。
Pythonのrequestsの呼び出しはJSONをリクエストし、{"appId"から始まる343バイトのJSONオブジェクトを取得しました。有効なJSONかどうかしかチェックしない場合、このブロックは有効なデータのように見えます。両方の形式にはHUMANのcaptchaスクリプトのURLが含まれており、サンプル内の通常のレスポンスにはそれが含まれていませんでした。
def is_human_block(body):
    """HUMAN sends a block as an HTML page or a small JSON object.

    Both formats contain the URL of its captcha script. Normal Target
    pages do not.
    """
return "captcha.px-" in body21件のTargetレスポンスのセットで、このチェックは両方の形式の4件のブロックすべてをフラグし、17件の通常のレスポンスすべてを通過させました。文字列px-captchaだけをチェックするより単純な方法では、レンダリング済みの製品ページをフラグしてしまい、JSONブロックを見逃していたでしょう。
価格は店舗によって異なった
8店舗にわたって、チェックした16製品中12製品に複数の価格がありました。Targetは2,000店舗以上を報告しています。nearby_stores_v1エンドポイントはZIPコードを最寄りの店舗IDにマッピングします。8つのZIPコードそれぞれについて、単一の2分間の実行で最寄り店舗の16製品の価格を収集しました。
6製品、8店舗中5店舗のサブセットが米ドルでの価格差を示しています。これら5店舗には各製品の最低価格と最高価格が含まれています。
| 製品 | ニューヨーク | シカゴ | シダーラピッズ | アンカレッジ | ホノルル |
|---|---|---|---|---|---|
| Parmalat UHTホールミルク、32 fl oz | 3.89 | 3.49 | 3.59 | 4.49 | 3.89 |
| タイドオリジナルポッド、31個入り | 11.19 | 12.69 | 9.99 | 10.59 | 10.59 |
| チェリオス、ファミリーサイズ18オンス | 5.99 | 5.69 | 5.29 | 6.79 | 5.69 |
| マーケットパントリー・クラシックロースト、25.9オンス | 14.69 | 14.19 | 12.89 | 16.99 | 17.59 |
| スターバックス・フォールブレンド、10オンス | 14.39 | 13.59 | 12.79 | 14.29 | 13.59 |
| LEGOクリエイター・スペースシャトル31134 | 7.99 | 7.99 | 7.99 | 7.99 | 7.99 |
マーケットパントリーのコーヒーが最も幅広い範囲を示しました。ホノルルの17.59ドルは、シダーラピッズの12.89ドルより36%高額でした。アンカレッジとホノルルを除いても、16製品中11製品に複数の価格があり、タイドポッドが最も変動が大きく、27%の差がありました。
価格は1日の中でも変動することがあります。同日の2回の実行の間に、シカゴ店は牛乳の価格を3.49ドルから2.97ドルに下げ、pdp_client_v1はそれをsaleとラベル付けしました。カテゴリ内で価格が変わる頻度に基づいて更新レートを設定してください。各行にセールか通常かなどの価格タイプを保持してください。
すべての店舗で価格が同じだった4製品は、LEGOセット2つとAirPodsモデル2つでした。この4製品すべてで、どの店舗をリクエストしてもAPIはロケーション3991からの価格を返しました。ロケーション3991はオンライン価格であり、店舗価格ではないことを示します。
3991を店舗IDとして渡すと、errors配列に"Parameter store_id cannot be digital store 3991."が含まれた206が返されました。インドからの接続では、Targetの製品ページも店舗を3991、ZIPコードを52404に設定していました。
ロケーション3991を利用してリクエストを節約できます。まず、各製品を2つの店舗でリクエストします。両方のレスポンスがロケーション3991を示す場合、その製品は店舗ごとではなく更新ごとに1回だけ収集してください。テストした16製品のうち4製品では、このルールにより更新ごとのリクエストが8回から1回に減りました。
店舗価格を収集するには、Web Unlocker API経由で店舗IDを付けて製品リクエストを送信してください。Target Scraper APIは送信したZIPコードの価格を返します。
親製品は価格帯を返した
Targetは、パックサイズなどの各バリアントを親製品の下の子TCINとしてリストします。検索結果は子TCINを返しましたが、製品エンドポイントは親を返しました。タイドポッドのTCIN 87767249は、価格"$11.19 - $30.99"とともに親79394303を返し、そのchildren配列には31、42、76、112個入りパックがリストされていました。スクレイパーがトップレベルの価格のみを保存すると、4つの価格を持つ製品について価格帯またはその最低値が記録されてしまいます。
価格帯は店舗の差も隠す可能性があります。親レベルでは、以前の実行でPampers Swaddlersが8店舗すべてで"$9.99 - $59.99"と表示されていました。バリアントレベルでは、164枚入りサイズ1パックはニューヨークで47.99ドル、他の7店舗で44.99ドルでした。
1つのリクエストで、リクエストされた店舗のファミリー内のすべてのバリアントが返されます。ファミリーごとに1つのTCINを送信すれば、各店舗のファミリーごとに1リクエスト分の料金で済みます。
検索はオフセット1,199で停止した
検索エンドポイントは、28を超えるcountを"Parameter 'count' cannot be requested with more than 28"で拒否しました。また、1,199を超えるoffsetも拒否したため、1クエリで約1,227件の結果を返すことができました。テストでは「shirts」の検索で131,690件の結果が報告されたため、単一キーワードではそのうち約1%しか返せませんでした。
確認したところ、www.target.comのrobots.txtはすべてのユーザーエージェントに対して検索ページを禁止し、6つのサイトマップインデックスをリストしていました。製品サイトマップインデックスは110ファイルを指しており、ダウンロードした際には2,504,600件の製品URLがリストされていました。サイトマップとカテゴリページから製品を発見し、UPCからTCINへの変換のような一時的な検索には検索APIを使用してください。UPCをキーワードとして使用すると、試した両方のUPCは正確に1製品とそのTCINを返しました。
一部のステータスコードは誤解を招くものだった
Targetは独自の処理が必要な3種類のレスポンスを返し、そのうち2つは誤解を招くステータスコードを持っています。
| レスポンス | 意味 | 対応方法 |
|---|---|---|
errors配列付きの206 |
クエリの一部が失敗し、製品データはまだ存在していた | データをパースし、エラーをログに記録 |
"No product found with tcin"付きの404 |
製品がもはや存在しない | URLをデッドとマークし、再試行をスキップ |
HTMLまたはJSON本文を伴う435 |
HUMANによるブロック | 本文から検出し、そのクライアントを一時停止し、再試行前に待機 |
削除された製品はどの入力リストにも現れる可能性があるため、それに備えて計画してください。テストリストの1製品は"No product found with tcin 1002219928"を返しました。
在庫は店舗あたり3チャネルあった
テストでは、product_fulfillment_v1エンドポイントは配送、店舗受け取り、店頭在庫を別々に報告し、店舗ごとの数量を提供しました。このリクエストは、上記の製品APIリクエストからKEYとREDSKYを再利用し、チェルシー店の牛乳を確認します。
Q="key=$KEY&tcin=15078349&store_id=3412"
Q="$Q&channel=WEB&page=%2Fp%2FA-15078349"
curl -s "$REDSKY/product_fulfillment_v1?$Q" \
  | jq '.data.product.fulfillment | {
      shipping: .shipping_options.availability_status,
      stores: [.store_options[] | {
        store: .location_id,
        units: .location_available_to_promise_quantity,
        pickup: .order_pickup.availability_status,
        in_store: .in_store_only.availability_status
      }]
    }'
チェルシー店は在庫も受け取りも不可でしたが、配送は牛乳が在庫ありと表示しており、近隣の店舗は6個の在庫をリストしていました。
{
  "shipping": "IN_STOCK",
  "stores": [
    {
      "store": "3412",
      "units": 0.0,
      "pickup": "UNAVAILABLE",
      "in_store": "OUT_OF_STOCK"
    },
    {
      "store": "1886",
      "units": 6.0,
      "pickup": "IN_STOCK",
      "in_store": "IN_STOCK"
    }
  ]
}別のリクエストでは、アンカレッジ店は同じ牛乳の2個の在庫をリストしていました。単一のis_availableフラグは3つの別々の値を含むことができないため、各店舗の配送、受け取り、店頭ステータスを保存してください。在庫には、カートリクエストではなく、すでに店舗ごとの数量を返すproduct_fulfillment_v1のような読み取りエンドポイントを使用してください。小売APIをリバースエンジニアリングするエンジニアも、書き込みエンドポイントの方がより保護されていると報告しています。
Web Unlocker APIでTarget店舗の価格をスクレイピングする
Web Unlocker APIは、各サイトごとに選択されたIPとブラウザフィンガープリントを通じて各リクエストをルーティングします。また、ヘッダー、Cookie、CAPTCHA、再試行を処理し、サイトのレスポンスを返します。ボット検出ベンダーは頻繁にチェックを更新しますが、Web Unlocker APIはあなたの代わりにそれらの更新に適応します。パーサーとエンドポイントのロジックは完全に自分で制御できます。
開始するには、APIキーとWeb Unlocker APIゾーン(リクエストとその請求のための名前付き設定)を使ってBright Dataアカウントを作成してください。PythonとPythonのrequestsライブラリも必要で、このスクリプトはPython 3.13で動作します。Web Unlocker APIはセルフサービスで、成功したリクエストのみに課金されます。Web Unlocker APIの料金ページには現在のレートが記載されており、無料プランにはクレジットカード不要で月5,000リクエストが含まれます。
このスクリプトは、ホームページからTargetのAPIキーを読み取り、各ZIPコードを店舗にマッピングします。その後、すべてのバリアントの価格を取得し、有効な行を拒否された行から分離します。
"""Collect Target prices per store through Bright Data's Web Unlocker API.

Usage:
    export BRIGHTDATA_API_KEY=...        # account API key
    export UNLOCKER_ZONE=web_unlocker    # your Web Unlocker API zone
    python target_store_prices.py 15078349,87767249 10001,99501
"""
import collections
import html
import json
import os
import re
import sys
import time
from concurrent.futures import ThreadPoolExecutor
from datetime import datetime, timezone
from urllib.parse import urlencode

import requests

API_KEY = os.environ["BRIGHTDATA_API_KEY"]
ZONE = os.environ.get("UNLOCKER_ZONE", "web_unlocker")
REDSKY = "https://redsky.target.com/redsky_aggregations/v1/web/"
ONLINE_STORE = "3991"  # the location Target's API calls a digital store


def is_human_block(body):
    """HUMAN sends a block as an HTML page or a small JSON object.

    Both formats contain the URL of its captcha script. Normal Target
    pages do not.
    """
    return "captcha.px-" in body


def unlock(url, attempts=3):
    """Fetch a URL through Web Unlocker API and return Target's response."""
    status = None
    for attempt in range(attempts):
        try:
            r = requests.post(
                "https://api.brightdata.com/request",
                headers={"Authorization": f"Bearer {API_KEY}"},
                json={"zone": ZONE, "url": url, "format": "raw"},
                timeout=120,
            )
        except requests.RequestException as error:
            status = type(error).__name__
            time.sleep(2 ** attempt)
            continue
        # Web Unlocker API reports Target's own result in the
        # x-brd-status-code and x-brd-error headers.
        status = int(r.headers.get("x-brd-status-code", r.status_code))
        if is_human_block(r.text):
            status = "blocked"  # a block can arrive with any status code
        elif status in (200, 206):
            return status, r.text
        elif "404" in r.headers.get("x-brd-error", ""):
            return 404, ""  # dead product page: do not retry
        time.sleep(2 ** attempt)
    return status, ""


def web_api_key():
    """Read the web API key that Target embeds in its own pages."""
    status, page = unlock("https://www.target.com/")
    keys = re.findall(r'apiKey\\?"\s*:\s*\\?"([0-9a-f]{40})', page)
    if not keys:
        raise RuntimeError(f"no apiKey in the home page (status {status})")
    return collections.Counter(keys).most_common(1)[0][0]


def store_for_zip(key, zip_code):
    """Resolve a ZIP code to the nearest Target store ID."""
    query = urlencode({"key": key, "place": zip_code, "limit": 1,
                       "within": 100, "channel": "WEB", "page": "/s"})
    status, body = unlock(f"{REDSKY}nearby_stores_v1?{query}")
    try:
        store = json.loads(body)["data"]["nearby_stores"]["stores"][0]
    except (ValueError, KeyError, IndexError) as error:
        raise RuntimeError(f"no store for {zip_code} ({status})") from error
    return store["store_id"], store["location_name"]


def price_rows(key, tcin, store_id, zip_code):
    """Return one row per sellable variant (child TCIN) at one store."""
    query = urlencode({"key": key, "tcin": tcin, "store_id": store_id,
                       "pricing_store_id": store_id,
                       "has_pricing_store_id": "true", "channel": "WEB",
                       "page": f"/p/A-{tcin}"})
    status, body = unlock(f"{REDSKY}pdp_client_v1?{query}")
    error = {"tcin": tcin, "store_id": store_id, "zip": zip_code}
    try:
        product = json.loads(body)["data"]["product"]
    except (ValueError, KeyError, TypeError):
        return [{**error, "error": status or "no_response"}]
    # A child TCIN returns its parent. The parent price is a range, so
    # save each child's price on its own row.
    items = product.get("children") or [product]
    now = datetime.now(timezone.utc).isoformat(timespec="seconds")
    rows = []
    for item in items:
        price = item.get("price", {})
        priced_at = str(price.get("location_id"))
        rows.append({
            "tcin": item["tcin"],
            "parent_tcin": product["tcin"],
            "title": html.unescape(
                item["item"]["product_description"]["title"]),
            "zip": zip_code,
            "store_id": store_id,
            "priced_at": priced_at,
            "scope": "online" if priced_at == ONLINE_STORE else "store",
            "price": price.get("current_retail"),
            "regular_price": price.get("reg_retail"),
            "price_type": price.get("formatted_current_price_type"),
            "collected_at": now,
        })
    return rows


def valid(row):
    """Keep rows with a price from the requested or online store."""
    return (isinstance(row.get("price"), (int, float))
            and row["priced_at"] in (str(row["store_id"]), ONLINE_STORE))


if __name__ == "__main__":
    tcins = sys.argv[1].split(",")
    zips = sys.argv[2].split(",")
    key = web_api_key()
    stores = {z: store_for_zip(key, z) for z in zips}
    jobs = [(t, stores[z][0], z) for t in tcins for z in zips]
    with ThreadPoolExecutor(max_workers=8) as pool:
        results = list(pool.map(lambda job: price_rows(key, *job), jobs))
    # TCINs from one family return the same rows. Keep one row per
    # variant and store, and never let an error replace a row with a price.
    unique = {}
    for row in (r for batch in results for r in batch):
        slot = (row["tcin"], row["store_id"])
        if slot not in unique or "error" in unique[slot]:
            unique[slot] = row
    good = [r for r in unique.values() if valid(r)]
    bad = [r for r in unique.values() if not valid(r)]
    # Append, so every run adds to the price history.
    for name, batch in (("target_prices", good), ("target_rejects", bad)):
        with open(f"{name}.jsonl", "a") as out:
            out.writelines(json.dumps(row) + "\n" for row in batch)
    print(f"{len(good)} valid, {len(bad)} rejected, stores: {stores}")
2つのZIPコードでの2つの入力TCINで、各リクエストがバリアントファミリー全体を返したため、このスクリプトは12行を生成しました。
12 valid, 0 rejected, stores: {'10001': ('3412', 'Chelsea 23rd and 8th'), '99501': ('2371', 'Anchorage NE')}target_prices.jsonlの最初の行は、チェルシー店の牛乳ファミリーを示しています。
{"tcin": "15078348", "parent_tcin": "94758333", "title": "Parmalat UHT 2% Reduced Fat Milk - 32 fl oz", "zip": "10001", "store_id": "3412", "priced_at": "3412", "scope": "store", "price": 3.89, "regular_price": 3.89, "price_type": "reg", "collected_at": "2026-09-27T05:34:07+00:00"}
{"tcin": "15078349", "parent_tcin": "94758333", "title": "Parmalat UHT Whole Milk - 32 fl oz", "zip": "10001", "store_id": "3412", "priced_at": "3412", "scope": "store", "price": 3.89, "regular_price": 3.89, "price_type": "reg", "collected_at": "2026-09-27T05:34:07+00:00"}価格表を生成した実行には128組の製品と店舗の組み合わせ、16製品×8店舗が含まれており、800行を拒否なしで書き込みました。このスクリプトは翌日、8ワーカーで97秒で実行を繰り返し、800件の価格すべてが最初の実行と一致しました。このスクリプトはまた、再試行が必要なペアのためにtarget_rejects.jsonlファイルを保持します。
Web Unlocker APIは、x-brd-status-codeとx-brd-errorヘッダーにTarget自身の結果を報告するため、このスクリプトは両方を読み取ります。削除された製品の場合、x-brd-errorはTargetの404を示し、スクリプトは再試行せずにそれを記録します。
各設計上の選択は、Targetスクレイパーで発生しうる障害に対応しています。
- ページからのキー: ページが引き続き
apiKeyとしてキーを埋め込んでいる限り、キーのローテーション後もスクレイパーは動作し続けます。 - 子ごとに1行: テーブルに親の価格帯が保存されることはありません。
scope列: オンライン価格はonlineとラベル付けされるため、店舗価格と誤認されることはありません。- ブロックチェック: HTMLまたはJSON内のHUMANブロックは、ステータスコードに関わらず
blockedとして記録されます。 - 上書きなし: あるバリアントのエラーが、価格を持つ別のバリアントの行を置き換えることはありません。
- 拒否ファイル: 有効な店舗価格またはオンライン価格のない行は再試行パス用に保存され、削除された製品はその
404を保持します。
このコードはpdp_client_v1とnearby_stores_v1に依存しているため、毎日両方にカナリアリクエストを送信し、レスポンススキーマが変更された場合にアラートを出してください。Pythonで失敗したリクエストを再試行するガイドでは、バックオフについてより詳しく説明しています。
レジデンシャルプロキシで同じコードを実行するには、unlock()内でプロキシ経由のrequests.get()を送信し、単純な404を削除された製品として扱ってください。スクリプトの残りの部分は同じままです。レジデンシャルプロキシでは、クライアントとユーザーエージェントを自分で制御するため、スケールアップする前にそれらと各エンドポイントをTargetに対してテストしてください。
Target Scraper APIでTarget商品を収集する
Target Scraper APIは、Targetに特化したWeb Scraper APIのスクレイパーです。製品URLとZIPコードを送信すると、価格、バリアント、評価、仕様、販売者などのフィールドを含む構造化レコードが返されます。Bright Dataがパースとエンドポイントを維持するため、あなたのコードはレコードを正規化するだけで済みます。Bright Dataは、より絞り込んだ業務用にTarget Price Scraper、Target Reviews Scraper、Target Image Scraperも提供しています。
コンソールは、同期モードと非同期モードの上にスクレイパーの入力フィールドを表示します。フィールドはURL、all_variationsフラグ、ZIPコードです。
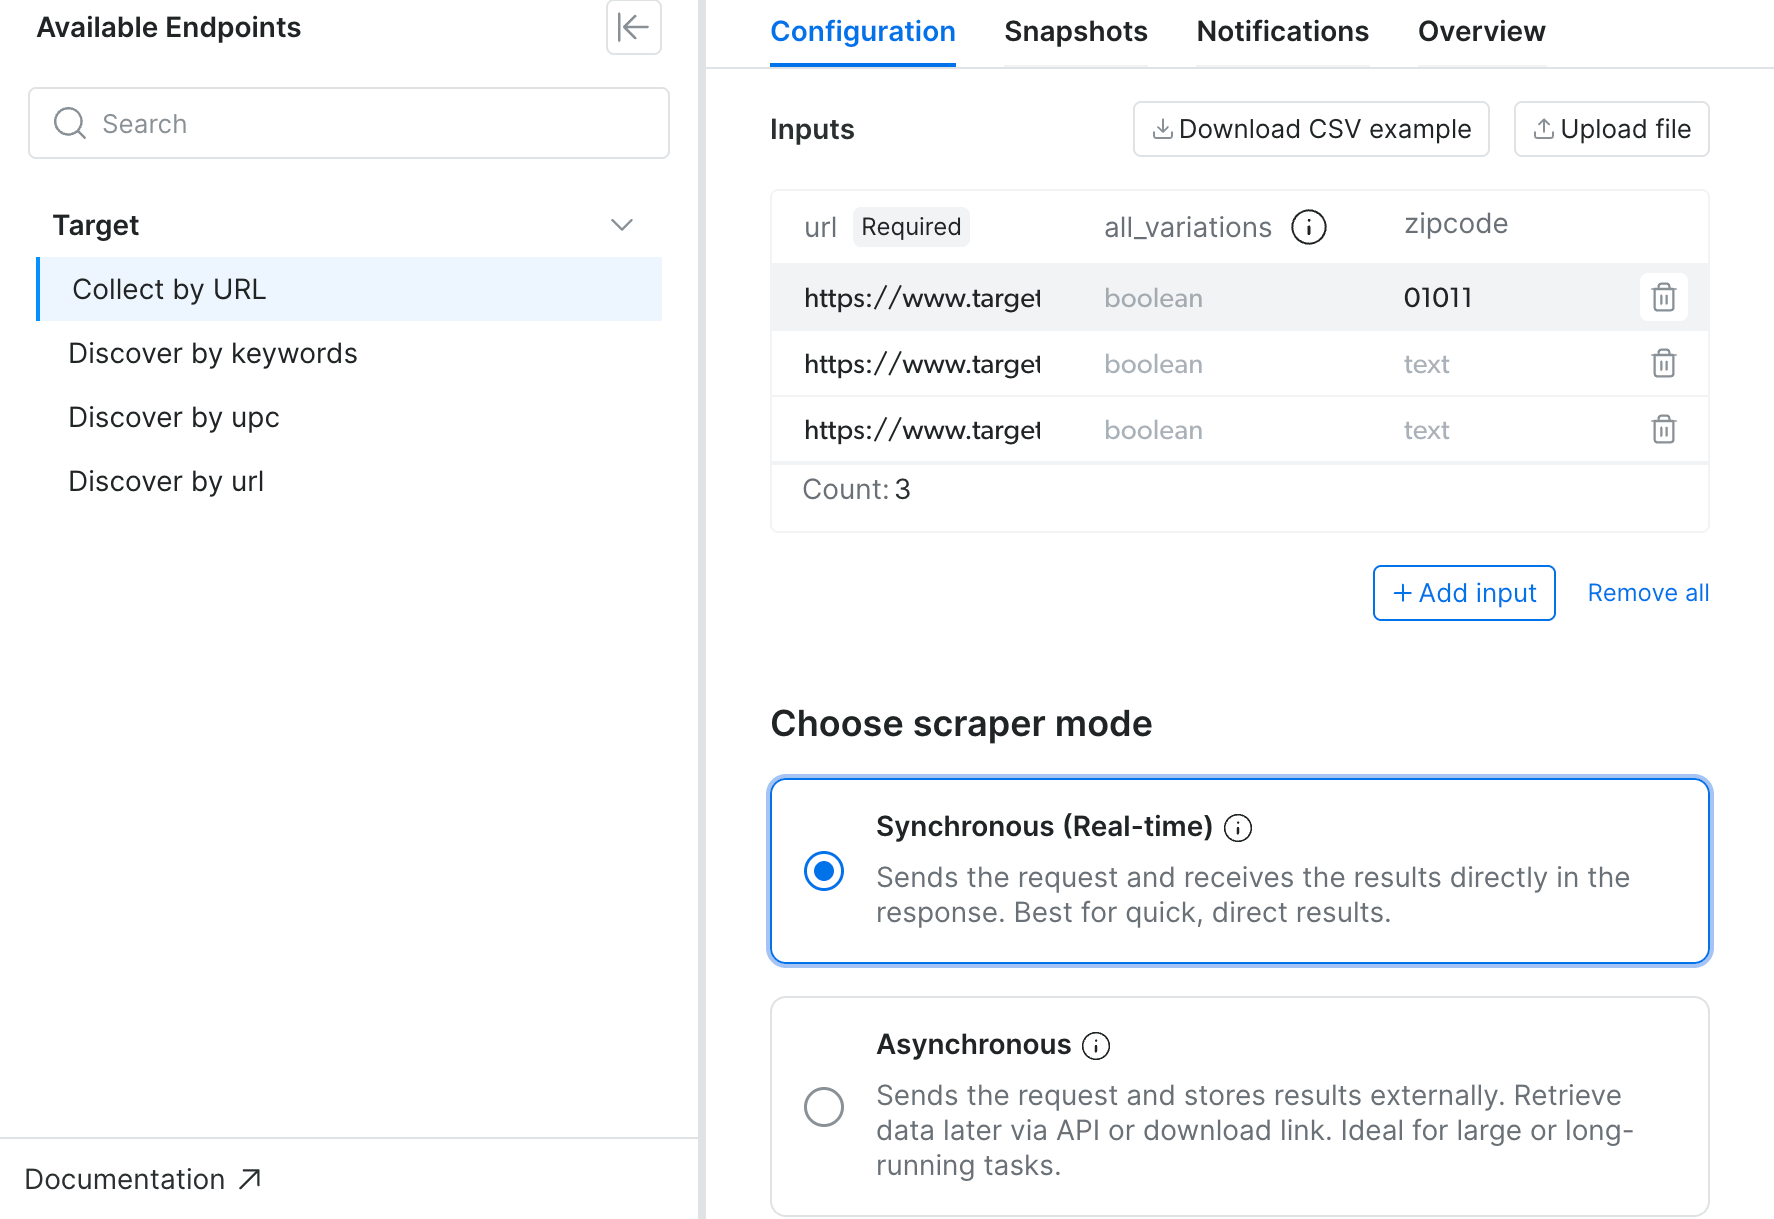
各入力行は単一の製品をリストし、レコードの価格のロケーションを設定するZIPコードを追加できます。
Web Scraper APIは、配信されたレコードにのみ課金します。Web Scraper APIの料金ページには現在のレートが記載されており、無料プランにはクレジットカード不要で月5,000リクエストが含まれます。クライアントライブラリには、pip install brightdata-sdkでBright Data Python SDKをインストールしてください。
下記のスクリプトは非同期ジョブを開始し、それを待機し、レコードをダウンロードし、正規化します。
"""Collect Target product records by URL and ZIP code with the Web Scraper API.

Usage:
    export BRIGHTDATA_API_KEY=...
    python target_scraper_api.py inputs.csv   # columns: url,zipcode
"""
import csv
import json
import os
import re
import sys
import time

import requests

API = "https://api.brightdata.com/datasets/v3"
DATASET_ID = "gd_ltppk5mx2lp0v1k0vo"  # Target products scraper
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"}


def trigger(inputs):
    """Start an asynchronous collection and return its snapshot ID."""
    r = requests.post(
        f"{API}/trigger",
        headers=HEADERS,
        params={"dataset_id": DATASET_ID, "include_errors": "true"},
        json=inputs,
        timeout=60,
    )
    r.raise_for_status()
    return r.json()["snapshot_id"]


def wait(snapshot_id, poll_seconds=15, max_minutes=60):
    """Poll the snapshot until it is ready and return its progress record."""
    deadline = time.time() + max_minutes * 60
    while time.time() < deadline:
        progress = requests.get(f"{API}/progress/{snapshot_id}",
                                headers=HEADERS, timeout=30).json()
        if progress["status"] in ("ready", "failed"):
            return progress
        time.sleep(poll_seconds)
    raise TimeoutError(snapshot_id)


def download(snapshot_id):
    """Download all records, including error records, as a list."""
    r = requests.get(f"{API}/snapshot/{snapshot_id}",
                     headers=HEADERS, params={"format": "json"}, timeout=300)
    r.raise_for_status()
    return r.json()


def normalize(record):
    """Map one record to a flat row, or return None for an error record."""
    if record.get("error_code"):
        return None
    price = record.get("final_price")
    if price is None and record.get("price_range"):
        # A record can have its price in price_range, like "$24.99".
        match = re.fullmatch(r"\$([\d,]+\.\d{2})", record["price_range"])
        price = float(match.group(1).replace(",", "")) if match else None
    origin = record.get("discovery_input") or record.get("input") or {}
    reviewed = bool(record.get("reviews_count"))  # rating 0 means unrated
    url_tcin = re.search(r"/A-(\d+)", record.get("url") or "")
    return {
        "tcin": url_tcin.group(1) if url_tcin else record.get("tcin_id"),
        "parent_tcin": record.get("group_id"),
        "title": record.get("title"),
        "zipcode": origin.get("zipcode") or None,
        "price": price,
        "initial_price": record.get("initial_price"),
        "available": record.get("is_available"),
        "rating": record.get("rating") if reviewed else None,
        "reviews_count": record.get("reviews_count"),
        "collected_at": record.get("timestamp"),
    }


if __name__ == "__main__":
    with open(sys.argv[1], newline="") as f:
        inputs = [{"url": row["url"], "zipcode": row["zipcode"]}
                  for row in csv.DictReader(f)]
    snapshot_id = trigger(inputs)
    progress = wait(snapshot_id)
    records = download(snapshot_id)
    rows = [row for row in map(normalize, records) if row]
    with open("target_records.jsonl", "w") as out:
        out.writelines(json.dumps(row) + "\n" for row in rows)
    print(f"snapshot {snapshot_id}: {len(rows)} rows, "
          f"errors: {progress.get('error_codes', {})}")
入力ファイルには2つのZIPコードでの牛乳に加えて、全国均一価格のLEGOセットとアンカレッジでの112個入りタイドパックが含まれています。最後の行はTargetが削除した製品です。
url,zipcode
https://www.target.com/p/-/A-15078349,10001
https://www.target.com/p/-/A-15078349,60601
https://www.target.com/p/-/A-86216189,99501
https://www.target.com/p/-/A-84114518,99501
https://www.target.com/p/petal-and-pup-skarlett-top/-/A-1002219928,10001このジョブは4件のレコードを返し、削除された製品をdead_pageとしてフラグしました。
snapshot sd_muifuppi1d0g830zfd: 4 rows, errors: {'dead_page': 1}4件の価格すべてが当社のスクレイパーと一致しました。マーケットパントリーコーヒーとタイド31個入りパックはロケーションによって価格が異なりました。これらを8つのZIPコードすべてで、同時刻に当社のスクレイパーと比較しました。
| 製品 | 製品とZIPコードのペア | 異なる価格の数 | 当社スクレイパーと一致 |
|---|---|---|---|
| マーケットパントリー・クラシックロースト、25.9オンス | 8 | 7 | 8件中8件 |
| タイドオリジナルポッド、31個入り | 8 | 5 | 8件中8件 |
| 牛乳、LEGOセット、タイド112個入り(上記の入力ファイル) | 4 | 該当なし | 4件中4件 |
20組すべての製品とZIPコードのペアが、最寄り店舗での当社スクレイパーの価格と一致しました。1日後、入力ファイルの再実行は、当社のスクレイパーが確認したシカゴの新しい2.97ドルのセール価格を返しました。
各レコードには、その価格に使用されたZIPコードと、そのZIPコードでの在庫フラグが含まれます。正規化処理はこれらのフィールドをマッピングします。
- 親ID:
group_idには親TCINが含まれます。 - 起源:
inputには収集されたレコードのURLとZIPコードが含まれます。discovery_inputには、Target Scraper APIが製品自体を発見した際のキーワードまたはカテゴリURL、そしてZIPコードが含まれます。 - 価格: 正規化処理は
final_priceまたはprice_rangeから価格を取得します。 - 未評価製品: レビュー0件の
ratingが0の場合、その製品には評価がないことを意味します。
同期モードまたは非同期モードを選択する
同期/scrapeエンドポイントは、短いジョブの場合はレスポンス内で結果を返し、長いジョブの場合はポーリング用のsnapshot_idを返します。同期リクエストのドキュメントには現在の時間制限が記載されています。スケジュールされたバッチには/triggerを使用してください。どちらのエンドポイントからのsnapshot_idも同じ方法でポーリングできます。
定期的なジョブの場合は、APIが結果を配信するように設定してください。配信オプションには、WebhookやAmazon S3、Google Cloud Storage、Microsoft Azureなどのクラウドストレージが含まれます。/scrapeでは、ドキュメントが示すように、リクエスト本文でlimit_per_inputを設定して入力ごとのレコード数を制限してください。
キーワードやカテゴリで製品を発見する
Target Scraper APIは、あなたの代わりに製品を見つけることもできます。
- キーワード:
limit_per_inputを20に設定した「dog treats」と「shirts」は、エラーなしで40件のレコードを返しました。 - カテゴリURL: 各ZIPコード付きの2つのカテゴリページが40件のレコードを返しました。
上記の正規化処理はすでにdiscovery_inputを読み取るため、同じコードが発見されたレコードを処理します。
セッションとデバッグにはBrowser APIを使用する
Browser APIはリモートChromeを実行し、Chrome DevTools Protocol(CDP)経由でPlaywrightやPuppeteerを、またはWebDriver経由でSeleniumを使って操作できます。Targetでは、HUMANのスクリプトを含め、完全なブラウザセッションとして製品ページをロードしました。ページ全体をロードするため、Browser APIはTargetがフロントエンドを変更した後のネットワークトラフィックをキャプチャするのに適しています。
Bright Data MCP Serverは、Model Context Protocol(MCP)経由でAIエージェントにツールを提供します。そのブラウザツールは、ページをクリックしたり入力したりするワークフロー向けに、エージェントに同じリモートブラウザを提供します。
Browser APIはBrowser APIの料金ページが示すようにGB単位で課金されます。画像とトラッカーをブロックすることで、各セッションを小さく保つのに役立ちます。キャプチャが必要なリクエストを示したら、Web Unlocker APIはページをロードせずにそれらを直接送信できます。
保存されたロケーションCookieがない場合、Targetは当社の米国ブラウザセッションそれぞれに、出口IPの近くの店舗を割り当てました。CDP経由で送信されるBrowser APIのProxy.setLocationコマンドは、選択した座標の近くの出口IPを選択します。スクリプトを実行するには、playwrightをインストールし、Browser APIクイックスタートが示すように、Browser APIゾーンの接続文字列をBROWSER_API_WSS環境変数に設定してください。
import asyncio
import os

from playwright.async_api import async_playwright

# wss://brd-customer-<id>-zone-<zone>:<password>@brd.superproxy.io:9222
WSS = os.environ["BROWSER_API_WSS"]


async def main():
    async with async_playwright() as pw:
        browser = await pw.chromium.connect_over_cdp(WSS)
        page = await browser.contexts[0].new_page()
        cdp = await page.context.new_cdp_session(page)
        # Exit near Manhattan, so Target geolocates the session there.
        await cdp.send("Proxy.setLocation", {
            "lat": 40.7506, "lon": -73.9972, "distance": 10, "strict": True,
        })
        await page.goto("https://www.target.com/p/-/A-15078349",
                        wait_until="domcontentloaded", timeout=120_000)
        # The page renders the price twice, and one copy stays hidden.
        price = page.locator('[data-test="product-price"]').first
        await price.wait_for(state="attached", timeout=60_000)
        cookies = await page.context.cookies("https://www.target.com")
        store = {c["name"]: c["value"] for c in cookies}.get("fiatsCookie")
        print(store, await price.text_content())
        await browser.close()

asyncio.run(main())同じ座標での3回の実行を通じて、Targetはそれらの座標の近くにある3つの異なるニューヨークの店舗を割り当てました。fiatsCookieの値には、店舗ID(DSI)、名前(DSN)、ZIPコード(DSZ)がリストされていました。
DSI_2475|DSN_Bronx%20Terminal|DSZ_10451 $3.59
DSI_3284|DSN_Lower%20East%20Side%20Grand%20and%20Clinton|DSZ_10002 $3.99
DSI_3394|DSN_Upper%20West%20Side%2098th%20and%20Columbus|DSZ_10025 $3.99
各セッションが近隣の店舗を取得したため、このセットアップは大都市圏全体での価格サンプリングに役立ちます。
カタログのバックフィル用にTarget Datasetを購入する
Target Datasetは、スクレイパーを実行せずにフィルタリングして購入できる事前収集済みのTarget製品レコードを提供します。一度に多くの行が必要なカタログバックフィルに適しています。
データセットページには、現在のレコード数、フィールド、料金が記載されています。データセットマーケットプレイスでは、購入前にレコードをフィルタリングしてサンプルをプレビューできます。
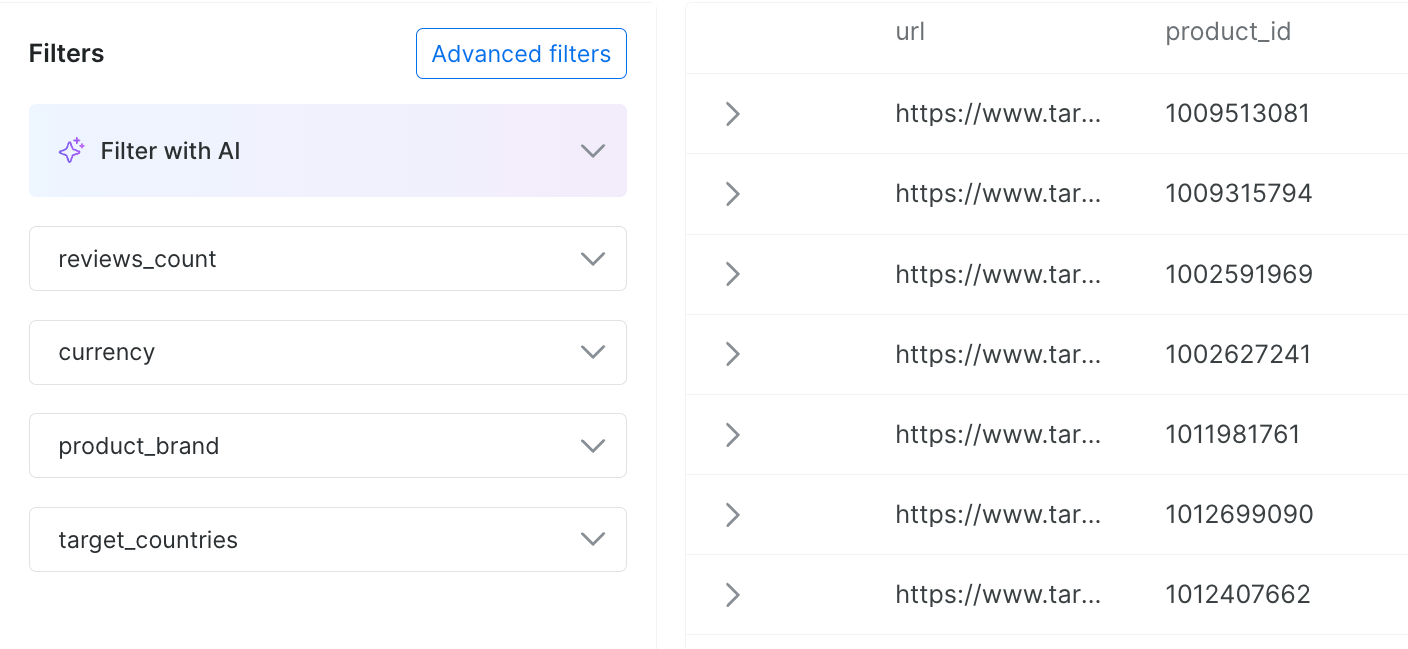
Targetデータセットのフィールドフィルターとそのレコードのサンプル。
読み込む前に、レコードを自身のスキーマにマッピングしてください。
- 製品ID: 各レコードのURL内のTCINを、上記のスクレイパーが使用するのと同じIDとしてテーブルキーに使用してください。
- 評価: レビュー0件の
ratingが0の場合、その製品にはまだ評価がないことを意味します。
ロケーション、量、更新頻度に応じてアプローチを選ぶ
より多くの制御が可能なオプションにはより多くのメンテナンスが必要であり、これはTargetがページやエンドポイントを変更する頻度に応じて増大します。既製のTargetダッシュボードを求めるチームは、Target Price TrackerまたはTarget Inventory Trackerを使用できます。他の小売業者については、ECサイトのウェブスクレイピングガイドをご覧ください。各アプローチは独自の単位で課金され、各製品の料金ページに現在のレートが記載されています。
| アプローチ | 課金単位 | 1回の呼び出しまたはレコードの範囲 | 最適な用途 |
|---|---|---|---|
| Web Unlocker APIを使った自前のコード | 成功したリクエスト | 1つの店舗IDにおける1つのバリアントファミリー | 店舗IDとチャネル別在庫 |
| レジデンシャルプロキシを使った自前のコード | トラフィックのGB数 | 1つの店舗IDにおける1つのバリアントファミリー、テストでは圧縮時約15KB | 呼び出しあたりの低コスト、クライアントの完全な制御 |
| Target Scraper API | 配信されたレコード | 1つのZIPコードにおける1つの製品 | パースとメンテナンスをお任せできる定期収集 |
| Browser API | トラフィックのGB数 | 1つの完全なブラウザセッション | セッションとデバッグ |
| Target Dataset | レコード | 1つの事前収集済み製品レコード | バックフィルとカタログ調査 |
ロケーションの追跡方法で選んでください。ZIPコードで追跡する場合、Target Scraper APIはテストで最寄り店舗の価格と一致し、Bright Dataがそれを維持します。店舗IDとチャネル別在庫を追跡する場合は、Web Unlocker APIまたはレジデンシャルプロキシ上で自前のコードを実行してください。バックフィルには、当社のデータセットとウェブスクレイピングAPIの比較が説明するように、データセットを選んでください。
選択する前に、製品数×店舗数×1日あたりの更新回数×30で月間の量を見積もってください。5,000製品を50店舗で1日1回追跡する場合、月に750万リクエストまたはレコードになります。チャネル別在庫は、TCINと店舗ごとに1つのproduct_fulfillment_v1リクエストを追加します。料金ページの単位あたりのレートを合計に掛けてください。月額プランではそのレートが下がります。
自前のコードは2つの方法で、この見積もりより少ないリクエスト数で済むことがあります。テストした16製品のうち、4製品はすべての店舗で同じ価格だったため、更新ごとに1リクエストだけで済みました。1つの製品APIリクエストはバリアントファミリー全体も返すため、128組の製品と店舗のペアが当社の実行で800行を生成しました。
レジデンシャルプロキシでは、750万件のgzip圧縮されたpdp_client_v1呼び出しが約110GBを転送することになります。レジデンシャルプロキシの料金ページが述べるように、課金はヘッダーと本文をカウントし、当社では1回の呼び出しあたり平均15KBでした。料金に関するFAQでは、トラフィックの測定方法が説明されています。同じpdp_client_v1の本文は、非圧縮では平均134KB、gzipでは14KBだったため、圧縮されたレスポンスをリクエストしてください。
Web Unlocker APIはあなたの代わりにアンブロッキングを処理し、成功したリクエストのみに課金します。IPとクライアントのテストでは、クライアントの調整なしで米国出口IPでのすべての呼び出しが成功しました。Web Unlocker APIとレジデンシャルプロキシの両方を併用することもできます。各エンドポイントのリクエストをその量に合ったオプションで送信し、Targetのボットチェックが変化した際にはそのエンドポイントをWeb Unlocker APIに移行してください。
Target収集の検証と監視
is_human_block()が検出するブロックはエラーとして現れます。有効に見える間違った店舗の価格はデータとして現れるため、エラーがそれをフラグすることはありません。下記のチェックは、有効なデータのように見えたりリクエストを浪費したりする可能性のある障害を検出するのに役立ちます。
| チェック | 確認場所 | 検出対象 |
|---|---|---|
| 価格がゼロより大きい数値である | price |
欠落した価格と価格帯 |
| 価格がリクエストした店舗のものであるか、オンラインとラベル付けされている | location_id, scope |
間違った店舗の価格 |
| 行が子TCINである | tcin, children |
親レベルの価格帯 |
| 本文に期待されるJSONスキーマがあり、HUMANブロックがない | レスポンス本文 | HTMLおよびJSONブロックレスポンス(HTTP 435) |
| 製品がまだ存在する | 404, dead_page |
すべての実行で再試行されるデッドURL |
| 前回の実行からの価格変化がしきい値内である | 価格履歴 | 誤ってパースされた価格や間違った価格 |
すべてのバッチでチェックを実行し、各行をそのTCIN、店舗ID、収集時刻とともに保存することで、履歴を蓄積してください。ブロック、間違った店舗、削除された製品、タイムアウトなどの理由ごとに障害数をカウントしてください。全体の障害率1つだけでは、ある理由による障害の増加を隠してしまう可能性があるため、どの理由であれ率が通常より上昇した際にはアラートを出してください。同じ基準でアプローチを比較できるよう、成功したレコードあたりのコストも追跡してください。
まとめ
Targetは製品データを公開していますが、価格は店舗、バリアント、収集した時間に依存する可能性があります。テストでは、ロケーション3991からのオンライン価格、親の価格帯、JSONブロックレスポンスはすべて有効なデータのように見えました。各行に店舗ID、バリアント、リクエストステータスを保持し、依存しているすべてのエンドポイントに対して毎日カナリアを実行してください。
Web Unlocker APIはアンブロッキングを処理し、自前のコードが店舗とチャネルを制御する一方、Target Scraper APIはパースとメンテナンスも処理します。選ぶには、無料プラン(クレジットカード不要で月5,000リクエスト含む)で両方に自社の製品とZIPコードのサンプルを実行し、価格を比較してください。
よくある質問
Targetには公開の製品APIがありますか?
いいえ、Targetの開発者ポータルはTargetの従業員、Target Plusの販売者、パートナー専用です。ウェブサイトは、そのページから取得したAPIキーを使ってredsky.target.com上の内部JSON APIを呼び出しており、これらのエンドポイントは予告なく変更される可能性があります。Bright DataのTarget Scraper APIは、URLとZIPコードから製品レコードを返します。
店舗ごとのTarget製品価格はどうやって取得しますか?
店舗IDと公開APIキーを付けてTargetの製品APIを呼び出すと、その店舗でのすべてのバリアントの価格を取得できます。別のエンドポイントはZIPコードを最寄りの店舗IDにマッピングします。ロケーションID 3991は、店舗価格ではなくTargetのオンライン価格を示します。Bright DataのTarget Scraper APIは、送信したZIPコードの価格を返します。
店舗別にTargetの在庫を追跡できますか?
はい、テストでは、Targetのproduct_fulfillment_v1エンドポイントは、リクエストされた店舗について数量、配送、受け取り、店頭ステータスを返しました。ニューヨークの店舗は在庫0でしたが、近隣の店舗には6個あり、配送では在庫ありと表示されていました。店舗ごと、チャネルごとに在庫を保存してください。
Targetのデータをスクレイピングするのにいくらかかりますか?
コストは製品数、店舗数、1日あたりの更新回数に応じて増加します。5,000製品を50店舗で毎日追跡すると、月に750万リクエストまたはレコードになります。Bright DataはWeb Scraper APIのレコードを配信時に、Web Unlocker APIのリクエストを成功時に、レジデンシャルプロキシをGB単位で課金します。各料金ページに現在のレートが記載されています。
無料でTarget製品をスクレイピングするにはどうすればよいですか?
Bright Dataの無料プランには、クレジットカード不要で月5,000リクエストが含まれており、Target Scraper APIとWeb Unlocker APIの両方をカバーしているため、自社の製品で価格をテストできます。単純なHTTPリクエストは無料ですが、テストではTargetのボットチェックが米国IPからのデフォルト設定のクライアントをブロックしました。