Node.jsでウェブスクレイピングを行う際、インターネット検閲や遅いプロキシなどの障害に直面することがあります。幸いなことに、node unblockerというソリューションがその解決策となります。
Unblockerは、開発者がインターネット検閲を回避し、地域制限コンテンツにアクセスできるウェブプロキシです。高速なデータ中継、簡単なカスタマイズオプション、複数プロトコルのサポートなど多くの利点を持つオープンソースソリューションです。Unblockerを使用すれば、インターネット制限を克服し、通常はアクセスできないウェブサイトから効率的にデータをスクレイピングできます。
この記事では、Unblockerについて、ウェブスクレイピングプロジェクトでの利点を含めて詳しく説明します。また、地域制限コンテンツをスクレイピングするためのプロキシの作成方法も学べます。
Node Unblockerを使用する利点
Node Unblockerは、ウェブコンテンツへの制限なしアクセスを求めるユーザーにとって価値あるツールとなる、幅広いメリットと機能を提供します。オープンソースソリューションであることに加え、以下のような利点があります:
- 仲介役として機能する
- 高速かつ効率的なデータ中継: Unblockerはバッファリングなしでクライアントにデータを届けることに優れています。そのため、利用可能な最速のプロキシソリューションの一つです。
- 使いやすさ: Unblockerはあらゆるスキルレベルのユーザーに適したユーザーフレンドリーなインターフェースを提供します。プロジェクトにソリューションを統合したい場合、Unblockerは実装が簡単なアクセスしやすいAPIを提供しています。
- 高いカスタマイズ性: Unblockerを使用すると、開発者は特定のスクレイピング要件に応じてプロキシをカスタマイズできます。例えば、リクエストヘッダーやレスポンス処理などのパラメータを設定し、個別化された効率的なスクレイピングプロセスを実現できます。
- 複数プロトコルのサポート: UnblockerはHTTP、HTTPS、WebSocketsなどの様々なプロトコルをサポートしています。この汎用性により、さまざまなスクレイピングシナリオとのシームレスな統合が可能となり、幅広いデータソースとやり取りする柔軟性と利便性を開発者に提供します。
Unblockerの始め方
Unblockerが提供するすべての利点を理解したところで、実際に使い始める時です。始める前に、Node.jsとnpmがシステムにインストールされていることを確認してください。また、プロジェクトをテストするためのウェブブラウザと、ソリューションをホストするための無料のRenderアカウントも必要です。
これらの前提条件を満たしたら、ウェブプロキシを作成します。node-unblocker-proxyという名前のフォルダを作成し、ターミナルで開き、以下のコマンドを実行して新しいNode.jsプロジェクトを初期化します:
npm init -y
次に、以下のコマンドを実行して必要な依存関係をインストールします:
npm install express unblocker
expressはウェブサーバーのセットアップに使用するウェブアプリケーションフレームワークです。node-unblockerはウェブプロキシの作成を支援するnpmパッケージです。
プロキシを作成するスクリプトの作成
すべての依存関係が設定されたら、ウェブプロキシスクリプトを実装します。
プロジェクトのルートフォルダにindex.jsファイルを作成し、以下のコードを貼り付けます:
// import required dependencies
const express = require("express");
const Unblocker = require("unblocker");

// create an express app instance
const app = express();
// create a new Unblocker instance
const unblocker = new Unblocker({ prefix: "/proxy/" });

// set the port
const port = 3000;

// add the unblocker middleware to the Express application
app.use(unblocker);

// listen on specified port
app.listen(port).on("upgrade", unblocker.onUpgrade);
console.log(`proxy running on http://localhost:${port}/proxy/`);
このコードでは、必要な依存関係をインポートし、Expressアプリのインスタンスを作成します。さらに、幅広い設定オプションを使用できる新しいUnblockerインスタンスを作成します。ここではprefixオプションのみを設定し、プロキシされたURLが始まるパスを指定します。
UnblockerはExpressと互換性のあるAPIをエクスポートするため、Expressアプリケーションへの統合は簡単です。Expressアプリインスタンスのuse()メソッドを呼び出してUnblockerインスタンスを渡すだけです。その後、listen()メソッドを使用してExpressアプリケーションを起動します。.on("upgrade", unblocker.onUpgrade)により、WebSocket接続がUnblockerによって正しく処理されます。
プロキシのローカルテスト
プロキシの実装をローカルでテストするには、ターミナルで以下のコマンドを実行します:
node index.js
プロキシ経由で行われた各リクエストの詳細情報を確認したい場合は、
DEBUG=unblocker:* node index.jsコマンドを使用することもできます。
次に、任意のURLにlocalhost/proxy/をプレフィックスとして付けて(例:localhost/proxy/https://brightdata.com/)、ウェブブラウザで開きます。
Bright Dataのホームページが表示されるはずです。ブラウザのNetworkタブを確認すると、すべてのリクエストがプロキシを経由していることがわかります(NetworkタブのDomain列で確認できます):

プロキシをRenderにデプロイする
プロキシのテストが完了したら、デプロイする時です。その前に、プロジェクトのルートフォルダにあるpackage.jsonファイルを開き、scriptsのキーと値のペアを以下のように修正します:
"scripts": {
   "start": "node index"
}
これにより、RenderにホストされたExpressウェブサーバーを起動するコマンドが提供されます。
ウェブプロキシをデプロイするには、プロキシコードをGitHubリポジトリにアップロードします。次に、Renderアカウントにサインインします:
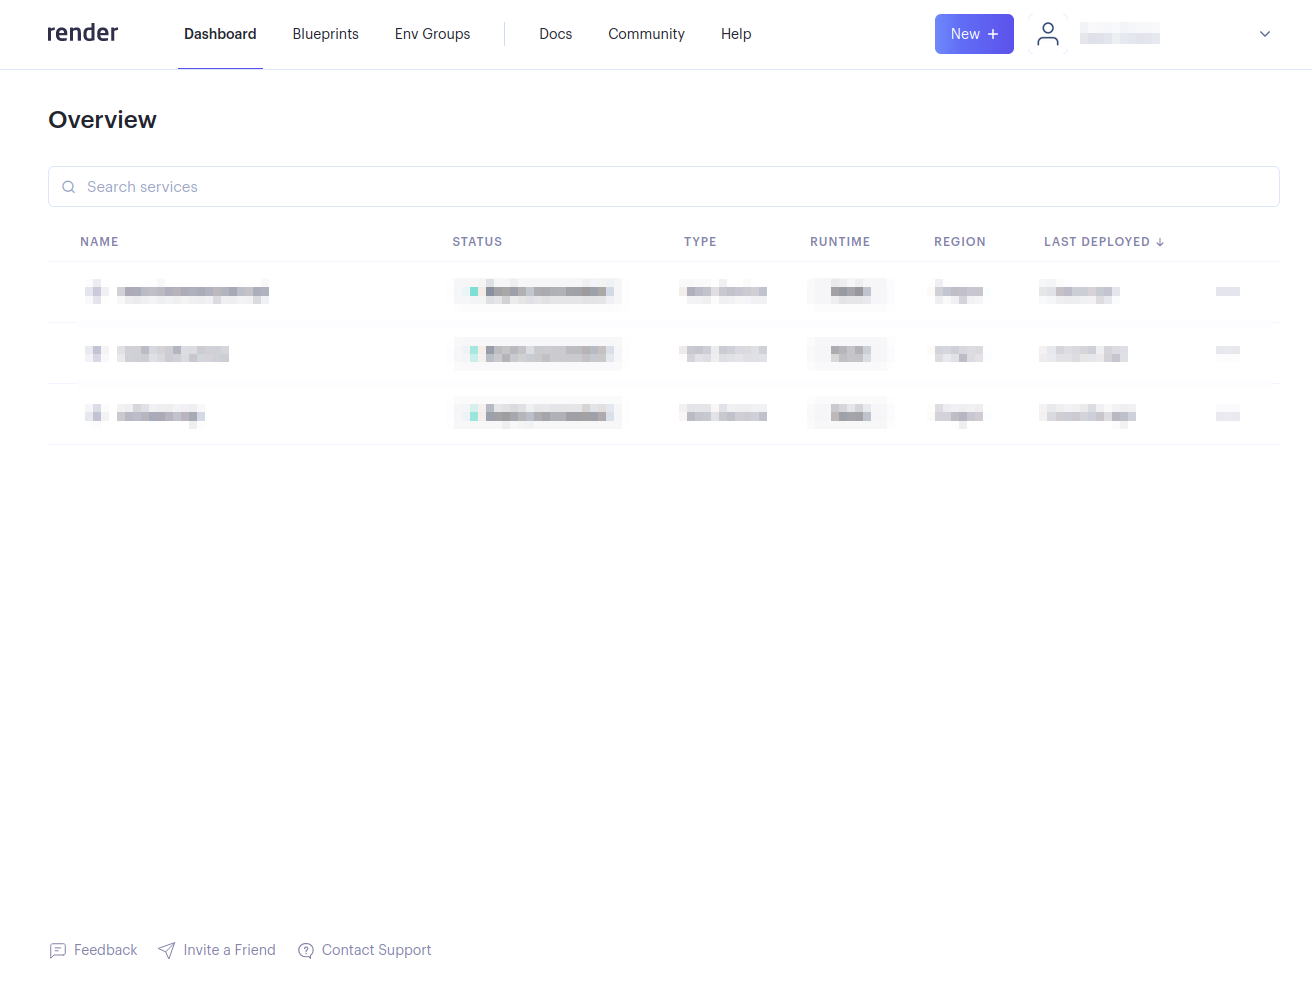
New +ボタンをクリックし、Web Serviceを選択します:

Connectボタンを選択してウェブプロキシリポジトリを接続します。Renderがリポジトリにアクセスできるようアカウントを設定する必要がある場合があります。これは、特定のGitHubリポジトリへのアクセスをRenderに設定していない場合にのみ必要です:
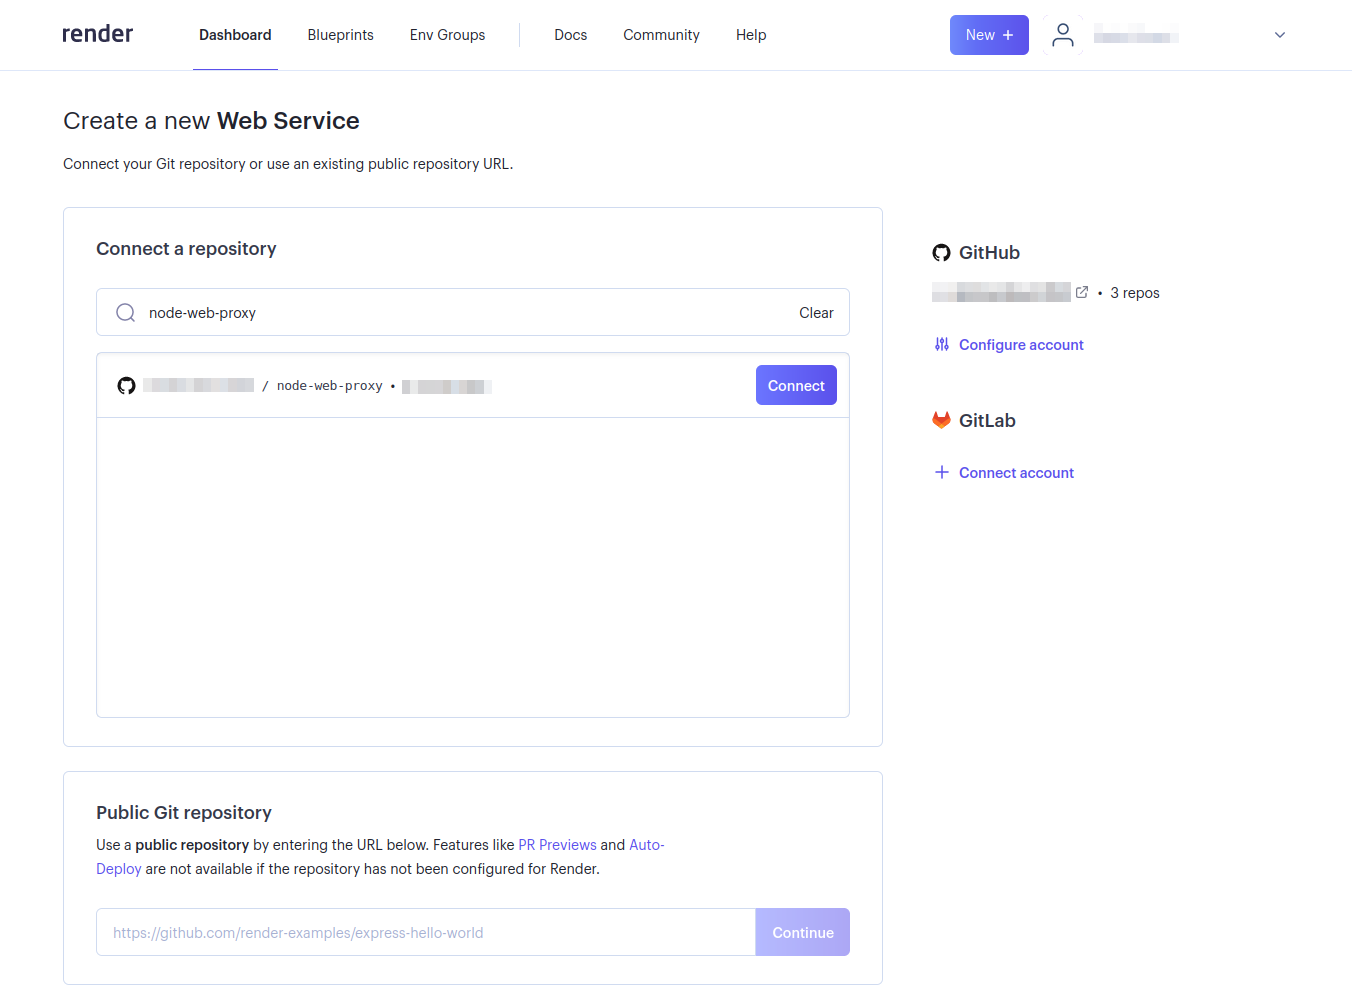
ウェブサービスに必要な詳細を入力し、ページ下部のCreate Web Serviceを選択します:

Yarnを使用する場合はスタートコマンドをそのままにするか、npmを使用する場合は
npm run startに変更できます。
ウェブプロキシのデプロイが完了したら、テストする時です。任意のURLにデプロイされた<DEPLOYED-APP-URL>/proxy/をプレフィックスとして付けて(例:https://node-web-proxy-gvn6.onrender.com/proxy/https://brightdata.com/)、ウェブブラウザで開きます。
ブラウザのネットワークタブを確認すると、すべてのリクエストがデプロイされたプロキシを経由していることがわかります:

プロキシを使用してスクレイピングリクエストを行う
すべてのリクエストがデプロイされたプロキシを経由していることを確認したら、スクレイピングリクエストを行う時です。このチュートリアルではPuppeteerライブラリを使用しますが、CheerioやNightmareなどの他のテストライブラリも使用できます。
Puppeteerがまだインストールされていない場合は、npm i puppeteerを実行してインストールします。次に、プロジェクトのルートフォルダにscrape.jsファイルを作成し、以下のコードを追加します:
// import puppeteer
const puppeteer = require("puppeteer");

const scrapeData = async () => {
   // launch the browser
   const browser = await puppeteer.launch({
    headless: false,
   });

   // open a new page and navigate to the defined URL
   const page = await browser.newPage();
   await page.goto("<DEPLOYED-APP-URL>/proxy/https://brightdata.com/blog");

   // get the content of the webpage
   const data = await page.evaluate(() => {
    // variable to hold all the posts data
    let blogData = [];

    // extract all elements with the specified class
    const posts = document.querySelectorAll(".post_item");

    // loop through the posts object, extract required data and push it to the blogData array
    for (const post of posts) {
        const title = post.querySelector("h5").textContent;
        const link = post.href;
        const author = post
            .querySelector(".author_box")
            .querySelector(".author_box__details")
            .querySelector("div").textContent;

        const article = { title, link, author };

        blogData.push(article);
    }

    return blogData;
   });

   // log the data to the console
   console.log(data);

   // close the browser instance
   await browser.close();
};

// call the scrapeData function
scrapeData();
<DEPLOYED-APP-URL>をRenderにデプロイしたアプリのURLに置き換えることを忘れないでください。
このコードスニペットはPuppeteerを設定し、Bright Dataブログからブログ投稿データをスクレイピングします。Bright Dataウェブサイトのすべてのブログポストカードにはクラス名.post_itemがあります。すべての投稿を取得し、postsオブジェクトをループして各投稿のタイトル、リンク、著者を抽出し、このデータをblogData配列に追加して、最終的にすべての情報をコンソールに記録します。
Node Unblockerに最適なプロキシの選び方
Node Unblockerにプロキシを統合する際は、プロジェクトの要件と予想される課題に合わせた選択が重要です。プロキシを選択する際に考慮すべき主要な点を以下に示します:
- パフォーマンスと信頼性:高速な接続速度と高可用性で知られるプロキシを選択し、シームレスなデータアクセスとウェブスクレイピングの効率を確保します。
- 地理的な柔軟性:幅広い地理的な場所を提供するプロキシを選択します。この機能は地域制限を回避し、ローカライズされたコンテンツにアクセスするために不可欠です。
- IPローテーション:ウェブサイトにブロックされるリスクを軽減するために、ローテーションIPアドレスを提供するプロキシサービスを選択します。この機能により、各リクエストで新しいIPを提示してアクセスを維持できます。
- セキュリティプロトコル:特に機密情報を扱う場合、データの整合性とプライバシーを保護するためにSSL暗号化などの強固なセキュリティ対策を含むプロキシサービスを確認します。
- スケーラビリティ:スクレイピングのニーズが増大するにつれて増加する需要に対応できるかどうかを検討します。リソースのスケーリングの柔軟性は、より大規模または複雑なスクレイピングタスクをサポートするために重要です。
- サポートとドキュメント:包括的なサポートと詳細なドキュメントは、特にNode Unblockerを使用した複雑な設定を行う際に、統合プロセスを大幅に簡素化できます。
これらの要素を慎重に評価することで、現在のニーズに合うだけでなく、スクレイピング活動の将来の成長や変化にも対応できるプロキシサービスを選択できます。
まとめ
Node UnblockerはNode.jsでのウェブスクレイピングに対する強力なソリューションを提供し、開発者がインターネット検閲を回避して地域制限コンテンツにアクセスできるようにします。ユーザーフレンドリーなインターフェース、豊富なカスタマイズオプション、複数プロトコルのサポートにより、ウェブサイトからデータを効率的にスクレイピングするための価値あるツールです。このガイドでは、Unblockerの概要、ウェブスクレイピングプロジェクトでの利点、および使用方法について学びました。
今日のデータ主導の世界では、ウェブスクレイピングは貴重な洞察や情報を収集するための不可欠なツールとなっています。しかし、IPブロック、レート制限、地域制限など、データ収集の取り組みを妨げる多くの課題があります。
Bright Dataはこれらの課題に対処する包括的なインフラを提供しています。レジデンシャル、ISP、データセンター、モバイルIPの広大なネットワークにより、世界中の多様なIPアドレスを通じてスクレイピングリクエストをルーティングできます。これにより、匿名性を確保するだけでなく、地域制限コンテンツへのアクセスやデータ収集を妨げる障害を克服する能力も提供されます。
どのBright Dataプロキシが必要か分からない場合は、今すぐ登録してデータエキスパートの一人にご相談いただき、ニーズに最適なソリューションを見つけてください。