



世界中の50,000+人のお客様から信頼されています。


利用可能な従業員および関連データセット
- JSON/CSV形式のデモデータ
- 新規記録
- データをカスタマイズし、充実させ、フォーマットする
 132.2K+
 15.3K+
従業員 データセットの料金
- クリーンで検証済み
- 毎月更新
- JSON/CSV/Parquet
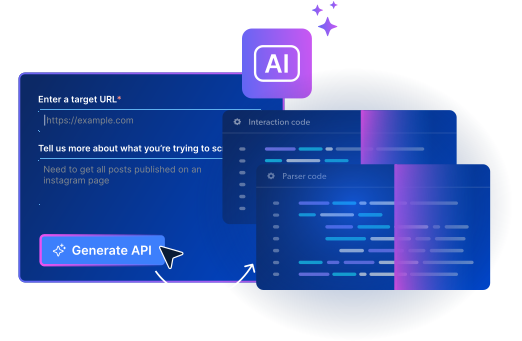
1つのプロンプトで従業員データセットをフィルタリング
必要なものを正確に記述するだけで、AIが数秒で最適なフィルターを適用します。
- データのニーズを平易な言葉で説明
- AIが正確なフィルターを自動適用
- 巨大なデータセットを必要なものだけに絞り込み
- 無関係なデータを省いてコストを削減
- フィルタリングされたデータをお好みの形式でエクスポート

戦略的なコスト削減で価値を最大化

スマートデータ更新
"新規レコード"または"更新レコード"のみにアクセスし、必要な分だけお支払いいただけます。

データセットバンドル
2つ以上のデータセットをまとめて購入することで、限定割引とともにより大きな価値を得られます。

ボリュームディスカウント
大規模なデータセットや更新サブスクリプションを購入する際、大幅な節約でよりお得になります。

エンリッチドデータセット
複数のソースを1つのクリーンなデータセットに統合した構築済みデータセットで、時間とリソースを節約します。
Employee dataset sample
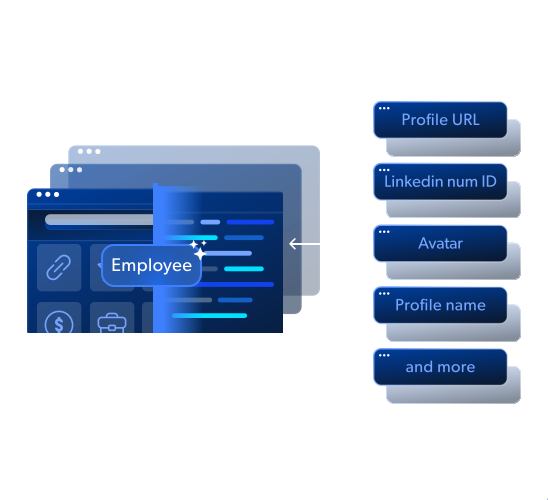
分野に応じて、データポイントには以下が含まれる場合があります:氏名、役職、現在の所属企業、アバター、経歴、学歴、所在地など。
AIエージェントを瞬時に強化
弊社の従業員データセットはAI/LLM最適化済み:明確な構造、充実したドキュメント、コードとLLM/チャットボット統合を容易にするレシピを提供。

構造化されたクリーンなデータ
一貫したスキーマで前処理済みのデータは、AIモデルのトレーニングと推論に最適です。

コード例
AIワークフローへの簡単な統合のための、すぐに使えるPython、Node.js、cURL、PHP、Go、Java、Rubyのスニペット。

ドキュメント
                              curl --request GET
--url https://api.brightdata.com/datasets/snapshots/{id}/download
--header 'Authorization: Bearer '
                              import requests
url = "https://api.brightdata.com/datasets/snapshots/{id}/download"
headers = {"Authorization": "Bearer "}
response = requests.get(url, headers=headers)
print(response.json())
                              const url = 'https://api.brightdata.com/datasets/snapshots/{id}/download';
const options = {method: 'GET', headers: {Authorization: 'Bearer '}, body: undefined};

try {
const response = await fetch(url, options);
const data = await response.json();
console.log(data);
} catch (error) {
console.error(error);
}
                              HttpResponse response = Unirest.get("https://api.brightdata.com/datasets/snapshots/{id}/download")
.header("Authorization", "Bearer ")
.asString();
                              require 'uri'
require 'net/http'

url = URI("https://api.brightdata.com/datasets/snapshots/{id}/download")

http = Net::HTTP.new(url.host, url.port)
http.use_ssl = true

request = Net::HTTP::Get.new(url)
request["Authorization"] = 'Bearer '

response = http.request(request)
puts response.read_body
ご要望に合わせた従業員データセット

データの購読
サブスクライブしてデータセットにアクセスすると、コストが大幅に削減されます。

ファイル出力形式
JSON、NDJSON、JSON Lines、CSV、Parquet。オプションの.gz圧縮。

柔軟なデリバリー
Snowflake、Amazon S3バケット、Google Cloud、Azure、SFTP。

スケーラブルなデータ
インフラ、プロキシサーバー、ブロックを気にすることなく拡張できます。

コスト削減
フィルターやフォーマットオプションを使って、データセットをカスタマイズできます。

コードのメンテナンス
データセットは、ウェブサイトの構造変更に基づいて維持されます。

簡素化された統合
SnowflakeおよびAWSとの統合によるメリット。

年中無休のサポート
データの専門家チームがお手伝いします。

コンプライアンスのリーダー
データは倫理的に取得され、すべての個人情報保護法に準拠しています。
構造化され信頼性の高い従業員データを取得する
データ提供は私たちにお任せください。あなたは他のことに集中できます
大量のウェブデータ
アンブロッキング機能と24時間体制のIPローテーションにより、ウェブサイト上のすべてのデータポイントへのアクセスを保証します。
すぐに使えるデータ
データ収集プロセスのあらゆる側面は、強固なデータ検証プロセスの一環として徹底的に検証されています。
自動化されたデータフロー
カスタムスケジュールを作成してデータ配信を自動化し、データがシームレスにストレージへ流れ込む様子をご覧ください。
企業が従業員データセットを活用する方法
採用活動の改善

労働力の追跡

B2Bデータ

データセットに関するよくある質問
Bright Dataのマーケットプレイスデータセットとは何ですか?
Bright Data Dataset Marketplaceは、信頼性の高い多様な公開オンラインデータソースから収集された、様々なトピックを網羅する高品質データセットの検証済みコレクションです。これらのデータセットは、貴重なビジネスインサイトを提供するために、入念に収集、クリーニング、構造化されています。
Bright Dataを通じて利用可能なデータセットの種類は?
Bright Dataは、AI・LLM、eコマース、金融、旅行、ソーシャルメディアなど多岐にわたる業界の多様なデータセットを提供しています。これらのデータセットはテキスト、画像、動画、構造化データなど様々なデータタイプを網羅し、多様な分析ニーズに対応する包括的なカバレッジを実現します。
マーケットプレイスのデータセットはカスタマイズ可能ですか?
はい、プロジェクトごとに固有の要件があることは承知しています。そのため、データセットのカスタマイズオプションを提供し、ユーザーが時間枠、地理的地域、特定のデータフィールドなどのパラメータに合わせてデータを調整できるようにしています。これにより、お客様が受け取るデータセットがニーズに完全に適合することを保証します。
Bright Dataのデータセットは倫理的に調達されていますか?
Bright Dataは倫理的なデータ収集手法を最優先します。厳格な倫理ガイドラインを遵守し、関連する全ての規制に準拠することで、提供されるデータが倫理的かつ合法的に取得されることを保証します。さらに、Bright Dataはデータ主体およびユーザーのプライバシーとセキュリティの維持に尽力しています。
Bright Dataのデータセットの品質は信頼できますか?
はい。各データセットは厳格な品質保証プロセスを経て、正確性、信頼性、関連性が確保されています。さらに、最新情報を反映するためデータセットを継続的に更新・刷新しており、ユーザーが常に最新のデータにアクセスできることを保証しています。
Bright Dataデータセットの一般的な使用例にはどのようなものがありますか?
一般的な使用例には、機械学習およびAIモデルのトレーニング、製品強化、市場調査、トレンド分析、感情分析が含まれます。
Bright Dataがサポートするデータ形式と配信方法は?
データ形式はJSON、NDJSON、CSV、XLSX、Parquetで利用可能です。データセットはSnowflake、Webhook、Google Cloud、メール、PubSub、Amazon S3、SFTP、Azure経由で配信されます。オンデマンドデータについてはAPI経由でリクエストを開始することも可能です。
最新のデータセットが必要な場合はどうすればよいですか?
問題ありません。チェックアウトに進む前に、取得したいデータの鮮度に関する時間範囲を定義できます。
事前収集データと新規データの相違点は何か?
数日~数か月前のデータを含む即時利用可能なデータセットと、新たに収集したデータから選択できます。
サブスクリプションオプションはありますか?
はい。任意のデータセットを購読し、毎日、毎週、毎月、四半期ごと、または毎年、最新のデータをストレージに直接受け取ることができます。