


プロキシとは、あなたの代わりにインターネットに接続するサーバーのIPアドレスです。リクエストを直接ウェブサイトに送信する代わりに、プロキシはサーバー経由でルーティングし、あなたの元のIPアドレスと位置情報を隠します。これによりプライバシーが保護され、追跡が防止され、ブロックが回避されます。プロキシはまた、セキュリティ強化のためにデータを暗号化します。
この記事では、特にウェブスクレイピングのためにPython Requestsでプロキシを使う方法について学びます。ウェブスクレイピングはウェブサイトからデータを抽出することですが、多くのサイトには制限があります。プロキシはIPと位置情報を変更することでこれらを回避し、ウェブサイトがあなたを検出してブロックすることを難しくします。また、複数のプロキシを使用してリクエストを分散させ、処理を高速化することもできます。
次に、Requests Pythonパッケージを使ってプロジェクトにプロキシを実装する方法を学びます。
Python RequestでProキシを使う方法
Python requestでプロキシを使用するには、コンピューター上に新しいPythonプロジェクトを作成し、ウェブスクレイピング用のPythonスクリプトを作成・実行する必要があります。ソースコードファイルを保存するディレクトリ(例: web_scrape_project)を作成してください。
このチュートリアルのすべてのコードは、このGitHubリポジトリで入手できます。
パッケージのインストール
ディレクトリを作成したら、ウェブページにリクエストを送信しリンクを収集するために、以下のPythonパッケージをインストールする必要があります:
- Bright Dataのウェブページ
プロキシIPアドレスの構成要素
プロキシを使用する前に、その構成要素を理解しておくことが重要です。以下は、プロキシサーバーの3つの主要な構成要素です:
- プロトコル は、インターネット上でアクセスできるコンテンツの種類を示します。最も一般的なプロトコルはHTTPとHTTPSです。
- アドレス は、プロキシサーバーがどこにあるかを示します。アドレスはIP(例:
192.167.0.1)またはDNSホスト名(例:proxyprovider.com)にできます。 - ポート は、1台のマシンで複数のサービスが実行されている場合に、トラフィックを正しいサーバープロセスに誘導するために使用されます(例: ポート番号
2000)。
これら3つの構成要素をすべて使用すると、プロキシIPアドレスは次のようになります: 192.167.0.1:2000 または proxyprovider.com:2000。
Requestsでプロキシを直接設定する方法
Python requestsでプロキシを設定する方法はいくつかあり、この記事では3つの異なるシナリオを見ていきます。この最初の例では、requestsモジュールでプロキシを直接設定する方法を学びます。
まず、ウェブスクレイピング用のPythonファイルにRequestsとBeautiful Soupパッケージをインポートする必要があります。次に、ウェブページをスクレイピングする際にIPアドレスを隠すために、プロキシサーバー情報を含む proxies というディレクトリを作成します。ここでは、プロキシURLへのHTTPとHTTPSの両方の接続を定義する必要があります。
また、データをスクレイピングしたいウェブページのURLを設定するためのPython変数も定義する必要があります。このチュートリアルでは、URLは https://brightdata.com/です
次に、 request.get() メソッドを使用してウェブページにGETリクエストを送信する必要があります。このメソッドは、ウェブサイトのURLとプロキシの2つの引数を取ります。そして、ウェブページからのレスポンスは response 変数に格納されます。
リンクを収集するには、Beautiful Soupパッケージを使用して、 response.content と html.parser を BeautifulSoup() メソッドの引数として渡すことで、ウェブページのHTMLコンテンツをパースします。
次に、 a を引数とした find_all() メソッドを使用して、ウェブページ上のすべてのリンクを見つけます。最後に、 get() メソッドを使用して各リンクの href 属性を抽出します。
以下は、requestsでプロキシを直接設定する完全なソースコードです:
# import packages.
import requests
from bs4 import BeautifulSoup

# Define proxies to use.
proxies = {
    'http': 'http://proxyprovider.com:2000',
    'https': 'http://proxyprovider.com:2000',
}

# Define a link to the web page.
url = "https://brightdata.com/"

# Send a GET request to the website.
response = requests.get(url, proxies=proxies)

# Use BeautifulSoup to parse the HTML content of the website.
soup = BeautifulSoup(response.content, "html.parser")

# Find all the links on the website.
links = soup.find_all("a")

# Print all the links.
for link in links:
    print(link.get("href"))
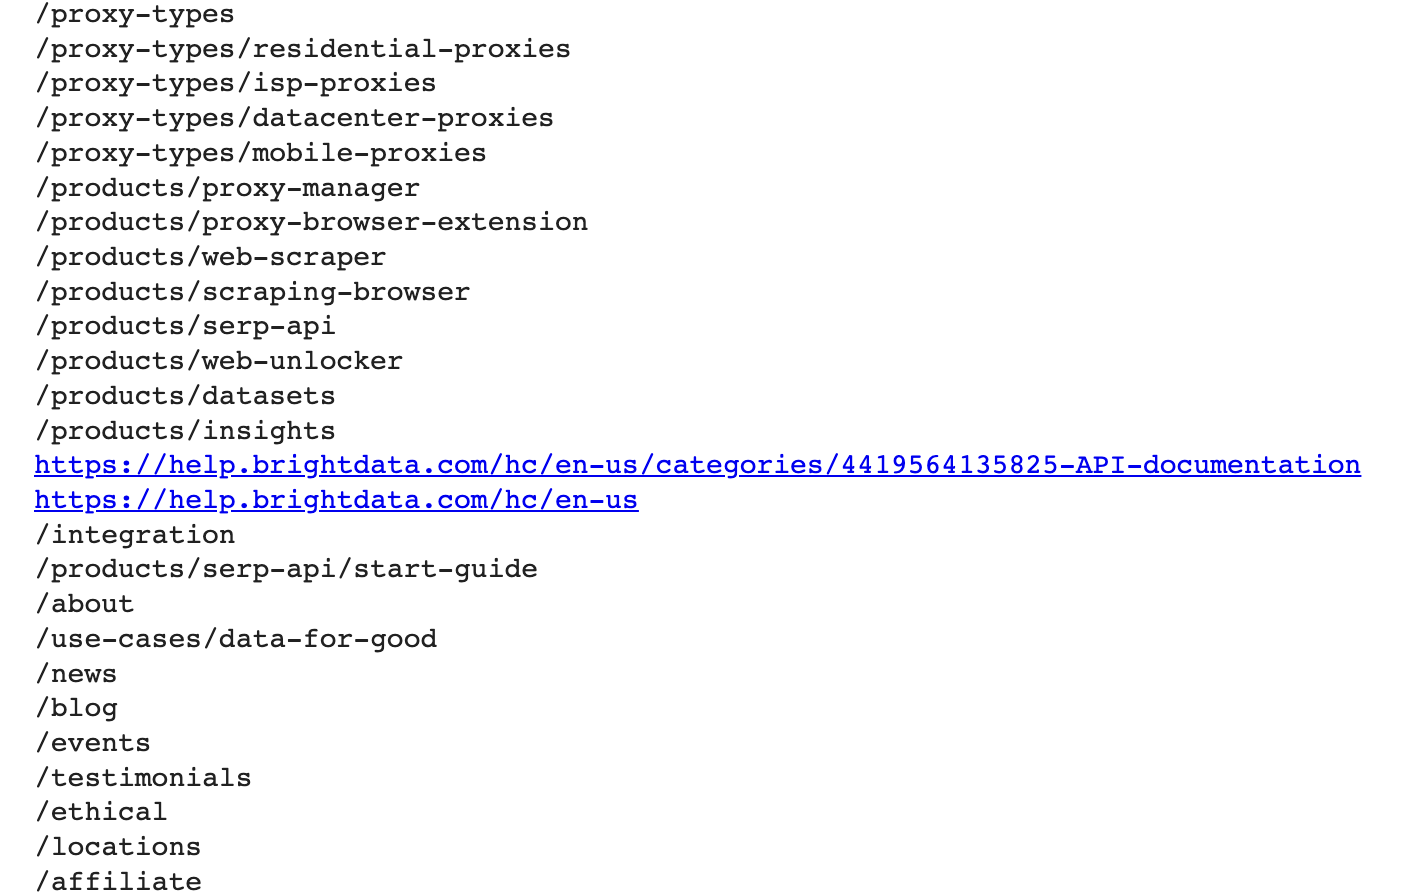
このコードブロックを実行すると、プロキシIPアドレスを使用して定義されたウェブページにリクエストを送信し、そのウェブページへのすべてのリンクを含むレスポンスを返します:
環境変数経由でプロキシを設定する方法
場合によっては、異なるウェブページへのすべてのリクエストに同じプロキシを使用する必要があります。この場合、プロキシの環境変数を設定することが理にかなっています。
シェルでスクリプトを実行するたびにプロキシの環境変数を利用できるようにするには、ターミナルで次のコマンドを実行します:
export HTTP_PROXY='http://proxyprovider.com:2000'
export HTTPS_PROXY='https://proxyprovider.com:2000'
ここで、 HTTP_PROXY 変数はHTTPリクエスト用のプロキシサーバーを設定し、 HTTPS_PROXY 変数はHTTPSリクエスト用のプロキシサーバーを設定します。
この時点で、Pythonコードは数行のコードになり、ウェブページにリクエストを送信するたびに環境変数を使用します:
# import packages.
import requests
from bs4 import BeautifulSoup

# Define a link to the web page.
url = "https://brightdata.com/"

# Send a GET request to the website.
response = requests.get(url)

# Use BeautifulSoup to parse the HTML content of the website.
soup = BeautifulSoup(response.content, "html.parser")

# Find all the links on the website.
links = soup.find_all("a")

# Print all the links.
for link in links:
    print(link.get("href"))
カスタムメソッドとプロキシの配列を使ってプロキシをローテーションする方法
同一のIPアドレスから大量のリクエストを受け取ると、ウェブサイトはボットやスクレイパーへのアクセスをブロックまたは制限することが多いため、プロキシのローテーションは非常に重要です。これが発生すると、ウェブサイトは悪意のあるスクレイピング活動を疑い、その結果、アクセスをブロックまたは制限する対策を実施する可能性があります。
異なるプロキシIPアドレスをローテーションすることで、検出を回避し、複数の自然なユーザーのように見せかけ、ウェブサイトに実装されたほとんどのアンチスクレイピング対策を回避できます。
プロキシをローテーションするには、Requests、Beautiful Soup、Randomというわずかなライブラリをインポートする必要があります。
次に、ローテーションプロセス中に使用するプロキシのリストを作成します。このリストには、次の形式でプロキシサーバーのURLを含める必要があります: http://proxyserver.com:port:
# List of proxies
proxies = [
    "http://proxyprovider1.com:2010", "http://proxyprovider1.com:2020",
    "http://proxyprovider1.com:2030", "http://proxyprovider2.com:2040",
    "http://proxyprovider2.com:2050", "http://proxyprovider2.com:2060",
    "http://proxyprovider3.com:2070", "http://proxyprovider3.com:2080",
    "http://proxyprovider3.com:2090"
]
次に、 get_proxy() というカスタムメソッドを作成します。このメソッドは、 random.choice() メソッドを使用してプロキシのリストからランダムにプロキシを選択し、選択されたプロキシを辞書形式(HTTPとHTTPSの両方のキー)で返します。新しいリクエストを送信するたびにこのメソッドを使用します:
# Custom method to rotate proxies
def get_proxy():
    # Choose a random proxy from the list
    proxy = random.choice(proxies)
    # Return a dictionary with the proxy for both http and https protocols
    return {'http': proxy, 'https': proxy}
get_proxy() メソッドを作成したら、ローテーションされたプロキシを使用して一定数のGETリクエストを送信するループを作成する必要があります。各リクエストにおいて、 get() メソッドは get_proxy() メソッドで指定されたランダムに選ばれたプロキシを使用します。
次に、最初の例で説明したように、Beautiful Soupパッケージを使用してウェブページのHTMLコンテンツからリンクを収集する必要があります。
最後に、Pythonコードはリクエストプロセス中に発生する例外をキャッチし、コンソールにエラーメッセージを表示します。
この例の完全なソースコードは以下の通りです:
# import packages
import requests
from bs4 import BeautifulSoup
import random

# List of proxies
proxies = [
    "http://proxyprovider1.com:2010", "http://proxyprovider1.com:2020",
    "http://proxyprovider1.com:2030", "http://proxyprovider2.com:2040",
    "http://proxyprovider2.com:2050", "http://proxyprovider2.com:2060",
    "http://proxyprovider3.com:2070", "http://proxyprovider3.com:2080",
    "http://proxyprovider3.com:2090"
]


# Custom method to rotate proxies
def get_proxy():
    # Choose a random proxy from the list
    proxy = random.choice(proxies)
    # Return a dictionary with the proxy for both http and https protocols
    return {'http': proxy, 'https': proxy}


# Send requests using rotated proxies
for i in range(10):
    # Set the URL to scrape
    url = 'https://brightdata.com/'
    try:
        # Send a GET request with a randomly chosen proxy
        response = requests.get(url, proxies=get_proxy())

        # Use BeautifulSoup to parse the HTML content of the website.
        soup = BeautifulSoup(response.content, "html.parser")

        # Find all the links on the website.
        links = soup.find_all("a")

        # Print all the links.
        for link in links:
            print(link.get("href"))
    except requests.exceptions.RequestException as e:
        # Handle any exceptions that may occur during the request
        print(e)
PythonでBright Dataのプロキシサービスを使用する
ウェブスクレイピングタスクのために信頼性が高く、高速で安定したプロキシをお探しなら、幅広いユースケースに対応するさまざまな種類のプロキシを提供するウェブデータインフラ、Bright Dataをおいて他にありません。
Bright Dataは400M+ monthlyを超えるレジデンシャルプロキシIPと770,000を超えるデータセンター・プロキシからなる大規模なネットワークを持ち、信頼性が高く高速なプロキシソリューションを提供しています。彼らのプロキシ製品は、ウェブスクレイピング、広告検証、匿名かつ効率的なウェブデータ収集を必要とするその他のオンライン活動の課題を克服するのに役立つよう設計されています。
Bright Dataのプロキシを統合するのは簡単です。例えば、データセンター・プロキシを使用して、前の例で使用したURLにリクエストを送信します。
まだアカウントをお持ちでない場合は、Bright Dataにサインアップし、詳細を追加してアカウントを登録してください。
完了したら、以下の手順に従って最初のプロキシを作成してください:
ウェルカムページで View proxy product をクリックして、Bright Dataが提供するさまざまな種類のプロキシを表示します:

Datacenter Proxies を選択して新しいプロキシを作成し、次のページで詳細を追加して保存します:

プロキシが作成されると、アクセスして使用を開始するための重要なパラメータ(例:ホスト、ポート、ユーザー名、パスワード)を確認できます:
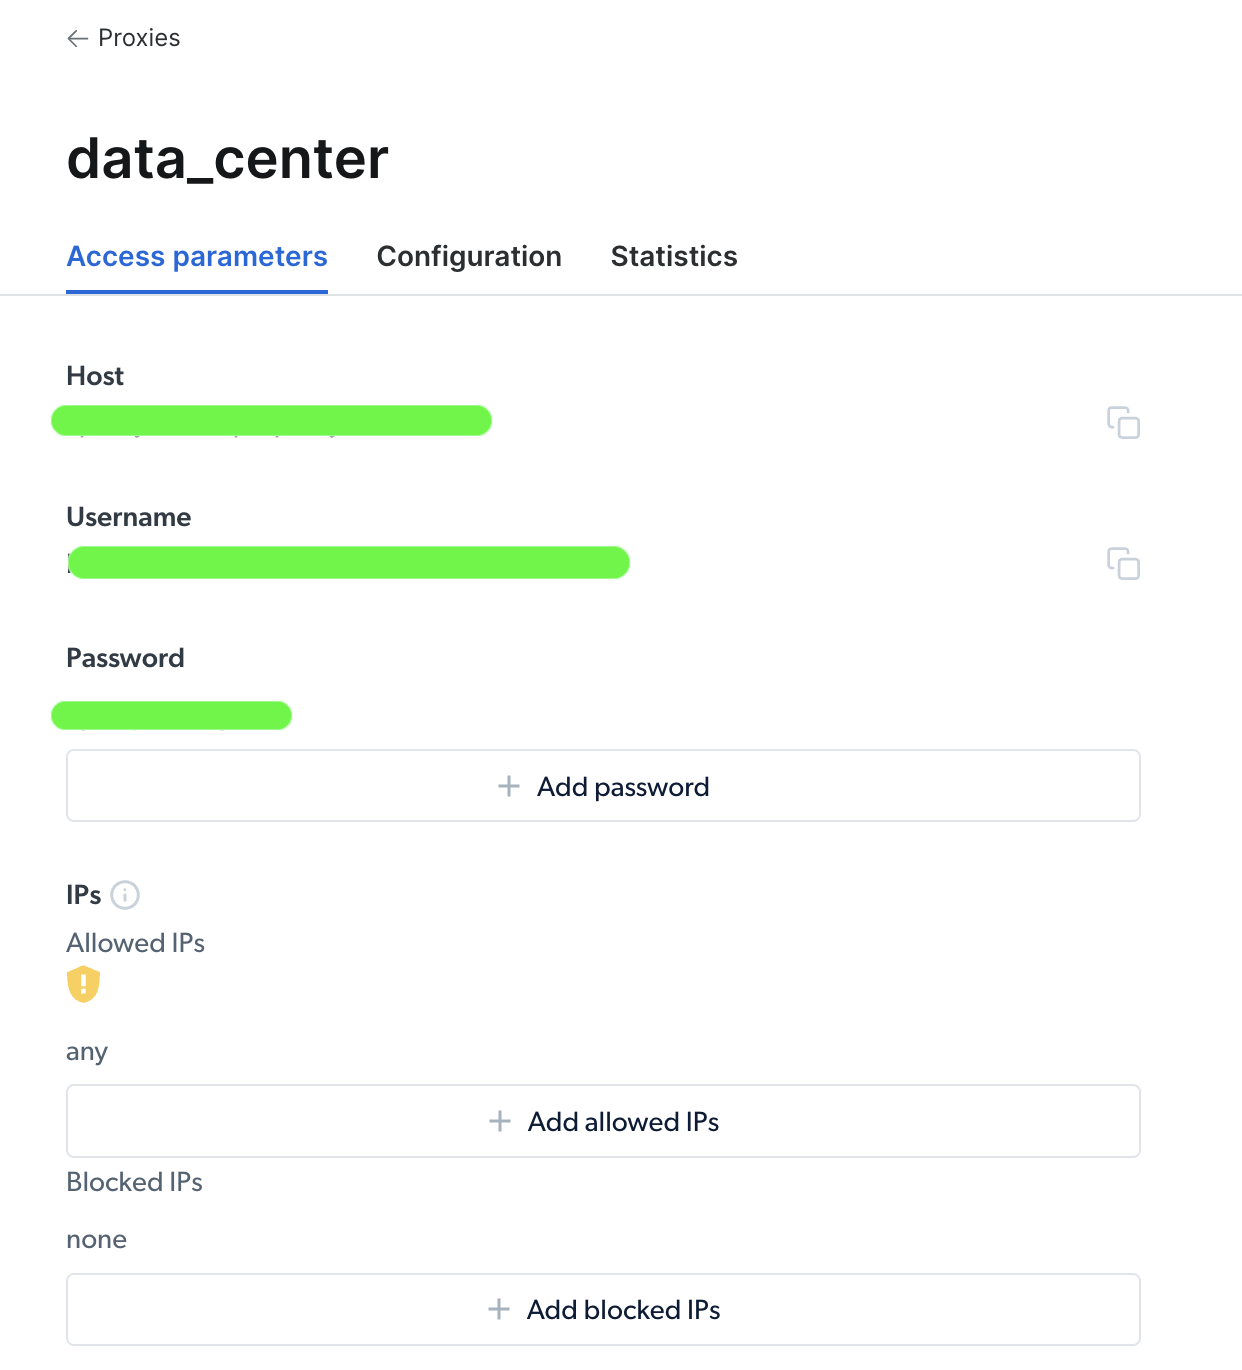
プロキシにアクセスしたら、パラメータ情報を使用してプロキシURLを設定し、Requests Pythonパッケージを使用してリクエストを送信できます。プロキシURLの形式は username-(session-id)-password@host:port です。
注:
session-idは、randomというPythonパッケージを使用して作成されたランダムな数値です。
以下は、Python requestでBright Dataのプロキシを設定するコードサンプルの例です:
import requests
from bs4 import BeautifulSoup
import random

# Define parameters provided by Brightdata
host = 'brd.superproxy.io'
port = 33335
username = 'username'
password = 'password'
session_id = random.random()

# format your proxy
proxy_url = ('http://{}-session-{}:{}@{}:{}'.format(username, session_id,
                                                     password, host, port))

# define your proxies in dictionary
proxies = {'http': proxy_url, 'https': proxy_url}

# Send a GET request to the website
url = "https://brightdata.com/"
response = requests.get(url, proxies=proxies)

# Use BeautifulSoup to parse the HTML content of the website
soup = BeautifulSoup(response.content, "html.parser")

# Find all the links on the website
links = soup.find_all("a")

# Print all the links
for link in links:
    print(link.get("href"))
ここでは、パッケージをインポートし、プロキシのホスト、ポート、ユーザー名、パスワード、session_id変数を定義します。次に、 http と https キーとプロキシの認証情報を含む proxies 辞書を作成します。最後に、 proxies パラメータを requests.get() 関数に渡してHTTPリクエストを行い、URLからリンクを収集します。
これで完了です!Bright Dataのプロキシサービスを使用してリクエストを正常に実行できました。
まとめ
この記事では、プロキシが必要な理由と、Requests Pythonパッケージを使用してウェブページにリクエストを送信するためのさまざまな方法について学びました。
Bright Dataのウェブインフラを使用すれば、世界中のどの国や都市にも対応する、プロジェクトに信頼性の高いプロキシを入手できます。彼らは、あなたの特定のニーズに合わせて、さまざまな種類のプロキシやウェブスクレイピングツールを通じて必要なデータを取得する複数の方法を提供しています。
市場調査データの収集、オンラインレビューの監視、競合の価格追跡など、どのようなニーズであっても、Bright Dataは迅速かつ効率的に作業を完了するために必要なリソースを備えています。


